stopwords-iso) i uporządkowania form fleksyjnych. Liczbę tematów w stm wybierz ze wskaźników i lektury, a wynik zweryfikuj kodowaniem ręcznym próby odpowiedzi.Co daje automatyczna analiza tekstu, a czego nie
Duże badanie ankietowe kończy się często kilkuset odpowiedziami na pytanie otwarte. Ręczne kodowanie według klucza (analiza treści pytań otwartych) albo interpretacja znaczeń (analiza tematyczna) dają najpełniejszy obraz, ale zajmują dużo czasu. Metody obliczeniowe pozwalają szybko zobaczyć, jakie słowa i zestawy słów się powtarzają, i porównać je między grupami. Roberts i in. (2014) zaproponowali do tego strukturalny model tematów (STM), który wiąże tematy z cechami osób odpowiadających.
Automatyczna analiza nie zastępuje czytania odpowiedzi. Grimmer i Stewart (2013) piszą wprost, że metody automatyczne nie zastępują starannego namysłu i uważnej lektury tekstów, a każdy wynik trzeba walidować. Nelson (2020), nawiązując do teorii ugruntowanej, proponuje traktować obliczenia jako pierwszy krok: wykrycie wzorców, potem ich dopracowanie przez jakościową lekturę danych, a na końcu potwierdzenie. Ten wpis pokazuje taki proces w R (jeśli dopiero zaczynasz, zajrzyj najpierw do wpisu R dla początkujących): tokenizację, stopwords, częstości słów, bigramy i model tematów w pakiecie stm. Na każdym etapie wskazujemy, w którym miejscu trzeba wrócić do tekstu.
Przykład: co obciąża pracowników zdalnych i stacjonarnych
W ankiecie wśród 300 pracowników firmy usługowej (150 pracujących zdalnie lub hybrydowo i 150 stacjonarnie) zadano pytanie otwarte: „Co w ostatnim miesiącu najbardziej obciążało Cię w pracy?”. Odpowiedzi są fikcyjne. Napisaliśmy 46 krótkich wypowiedzi na sześć tematów (obciążenie zadaniami, przełożony, samotność w pracy zdalnej, dojazdy i biuro, sprzęt i systemy, wynagrodzenie), a R złożył z nich odpowiedzi z różną częstością tematów w obu grupach (set.seed(2101)). Dzięki temu znamy „prawdziwy” temat każdej odpowiedzi i możemy sprawdzić, jak dobrze odtwarza go model. Przykładowe odpowiedzi:
- „Niejasne zasady premii i zarobki i brak podwyżki.”
- „Szczerze mówiąc, presja czasu i nadgodziny pod koniec miesiąca. Terminy i nadgodziny prawie codziennie.”
- „Najbardziej w domu trudno oddzielić pracę od życia.”
Plik z odpowiedziami możesz pobrać jako CSV (300 wierszy: id, tryb, odpowiedz; kodowanie UTF-8). W prawdziwych danych przed analizą usuń z tekstów informacje identyfikujące, np. nazwiska przełożonych czy nazwy działów (zob. anonimizacja i pseudonimizacja).
Krok 1. Tokenizacja
Tokenizacja dzieli tekst na jednostki, zwykle słowa. Pakiet tidytext zapisuje wynik w formacie „jeden token na dokument na wiersz” (Silge i Robinson, 2016), czyli jako dane uporządkowane, które dalej przetwarzasz zwykłymi funkcjami dplyr i rysujesz w ggplot2. Funkcja unnest_tokens() zamienia litery na małe i usuwa interpunkcję. Z 300 odpowiedzi powstały 2963 słowa w 131 różnych formach. Tę samą pracę wykona pakiet quanteda, który obejmuje cały proces od korpusu przez tokenizację do macierzy dokument–cecha (Benoit i in., 2018). W przykładzie łączymy oba: tidytext do częstości, quanteda do przygotowania macierzy dla modelu tematów.
Krok 2. Polskie stopwords: co jest dostępne offline
Stopwords to słowa funkcyjne („i”, „w”, „się”, „za”), które w każdym tekście są najczęstsze i nic nie mówią o treści. Domyślne źródło list w tidytext::get_stopwords() i quanteda::stopwords() (Snowball) nie ma języka polskiego i zwraca błąd. Polska lista jest w źródle stopwords-iso pakietu stopwords. Ten pakiet instaluje się razem z quanteda, a tidytext korzysta z niego w get_stopwords(). Listy są zapisane w pakiecie, więc działają bez internetu. Zanim jej użyjesz, przejrzyj ją. W zainstalowanej wersji ma 356 słów, z czego 27 ma uszkodzone kodowanie znaków (np. „by䇔 zamiast „być”). Lista zawiera też słowa, które w ankiecie niosą treść: „nie”, „bez” i „bardzo”.
W przykładzie usunęliśmy uszkodzone wpisy, zostawiliśmy w tekście „nie” (bo „nie przekazuje informacji” to co innego niż „przekazuje informacje”) i dopisaliśmy słowa wypełniacze typowe dla tej ankiety: „chyba”, „szczerze”, „mówiąc”, „najbardziej”, „raczej”. Po usunięciu stopwords zostało 1841 słów. Denny i Spirling (2018) pokazują, że takie decyzje wstępnego przetwarzania mogą wyraźnie zmieniać wyniki metod nienadzorowanych, dlatego opisz je w pracy i sprawdź, czy wnioski są na nie odporne.
Krok 3. Odmiana wyrazów
Polszczyzna ma bogatą fleksję: „termin”, „terminy” i „terminów” to dla komputera trzy różne słowa. Rdzeniowanie (stemming) z pakietu SnowballC nie obsługuje polskiego, a lematyzacja wymaga zewnętrznych narzędzi językowych. W małym zbiorze wystarczy własny słownik form najczęstszych słów, przygotowany po przejrzeniu listy częstości. W przykładzie 28 form sprowadziliśmy do form podstawowych, co zmniejszyło liczbę różnych słów ze 101 do 88. Taki słownik dołącz do materiałów uzupełniających, bo jest częścią analizy, tak jak książka kodowa.
Krok 4. Częstości słów w grupach
Najprostszy wynik to odsetek odpowiedzi, w których pojawia się dane słowo. Licz je raz na osobę, a nie wszystkie wystąpienia, bo ktoś, kto trzy razy napisał „terminy”, nie zgłosił trzech problemów. Wtedy odsetek ma ten sam mianownik co w analizie treści.
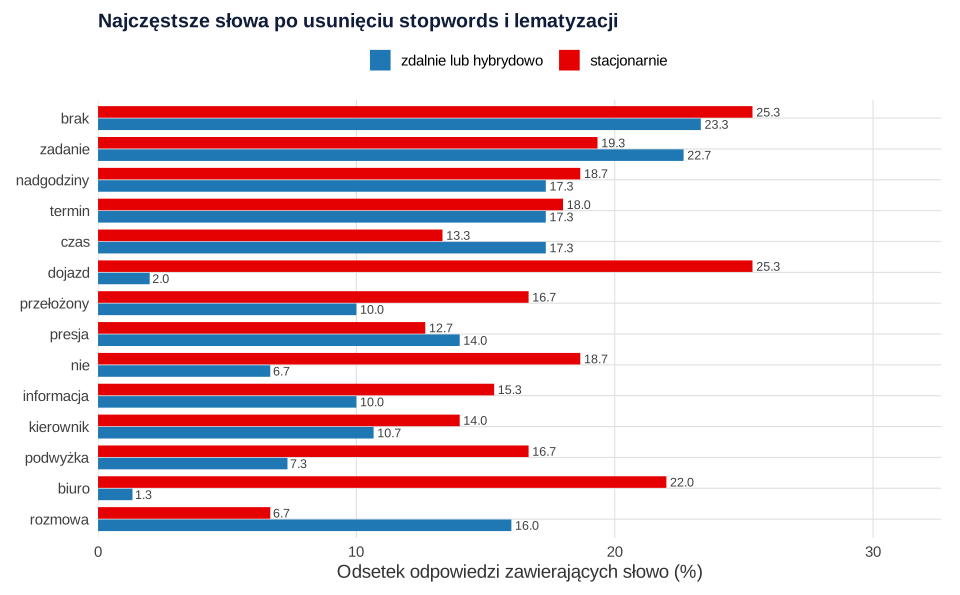
Różnice widać od razu: „dojazd” pojawił się w 25.3% odpowiedzi osób pracujących stacjonarnie i w 2.0% pracujących zdalnie, a „biuro” w 22.0% i 1.3%. Najczęstsze słowo w obu grupach, „brak” (25.3% i 23.3%), samo niewiele jednak mówi. Brak czego? Odpowiedź daje kontekst.
Krok 5. Bigramy, czyli słowo w kontekście
Bigram to para sąsiednich słów. W tidytext tworzysz je tą samą funkcją z argumentem token = "ngrams", n = 2, a potem usuwasz pary zawierające stopwords. Najczęstsze bigramy w przykładzie to „brak podwyżki” (40 razy), „presja czasu” (29), „brak informacji” (23) i „nie przekazuje” (18). Słowo „brak” okazuje się należeć do co najmniej dwóch różnych wątków: wynagrodzenia i komunikacji z przełożonym. Ta obserwacja przyda się przy czytaniu modelu tematów. Tam, gdzie fraza jest stała („open space”, „presja czasu”), można ją połączyć w jeden token (w quanteda funkcją tokens_compound()), zanim zbudujesz model.
Krok 6. Model tematów stm
Model tematów zakłada, że każda odpowiedź jest mieszaniną kilku tematów, a każdy temat to rozkład prawdopodobieństwa słów. Strukturalny model tematów pozwala dodatkowo włączyć do modelu metadane dokumentów, np. grupę, płeć czy warunek eksperymentu, i szacować ich związek z częstością tematów (Roberts i in., 2014). Pakiet stm szacuje go szybkim przybliżeniem wariacyjnym i ma narzędzia do oglądania tematów i szacowania niepewności (Roberts i in., 2019). W przykładzie tryb pracy przewiduje częstość tematów (prevalence = ~ tryb). Do modelu weszło 295 odpowiedzi i 88 słów występujących w co najmniej trzech odpowiedziach. Pięć odpowiedzi „Raczej nic.” po usunięciu stopwords nie zawierało żadnego słowa.
Liczba tematów K to decyzja badacza, a nie wynik. Funkcja searchK() liczy dla kilku wartości K spójność semantyczną (czy najczęstsze słowa tematu występują razem), wyłączność (czy słowa są charakterystyczne dla jednego tematu) i dopasowanie do odłożonych słów. W przykładzie spójność była najlepsza przy K = 5, dopasowanie przy K = 7, a wyłączność rosła z każdym tematem. Wskaźniki zawęziły więc wybór do 5–7, ale go nie rozstrzygnęły. Rozstrzygnęło czytanie tematów i typowych odpowiedzi. Wybraliśmy K = 6.
| Temat | Słowa FREX | Typowa odpowiedź | Nasza etykieta |
|---|---|---|---|
| T1 | system, vpn, awarie, niejasne, premia | „Chyba awarie sprzętu i systemu i VPN i system działają wolno.” | Sprzęt i systemy (z domieszką premii) |
| T2 | samotność, dom, ludzie, kontakt | „…w domu trudno oddzielić pracę od życia i czuję samotność…” | Samotność i brak kontaktu |
| T3 | czas, zbyt, naraz, koniec, miesiąca | „Presja czasu, zadania spływają szybciej, niż je kończę…” | Presja czasu i nadmiar zadań |
| T4 | przełożony, informacja, kierownik, decyzja, wynagrodzenie | „…kierownik krytykuje przy wszystkich i nie przekazuje informacji…” | Przełożony i komunikacja (z domieszką wynagrodzenia) |
| T5 | dojazd, biuro, korek, hałas, godzina | „…open space i hałas nie pozwalają się skupić, codzienne dojazdy do biura…” | Dojazdy i hałas w biurze |
| T6 | termin, nierealne, codziennie, nadgodziny | „Chyba nadgodziny, bo terminy są nierealne…” | Terminy i nadgodziny |
Etykiety nadaje badacz, a nie program. Słowa FREX łączą częstość z wyłącznością, a funkcja findThoughts() wskazuje odpowiedzi najbardziej typowe dla tematu. Czytaj zawsze kilka takich odpowiedzi, a nie jedną. Tabela pokazuje typowe problemy. Obciążenie pracą rozpadło się na dwa tematy (T3 i T6). Wynagrodzenie nie dostało własnego tematu: jego słowa trafiły do tematu przełożonego (wspólne słowo „brak” w „brak informacji” i „brak podwyżki”) oraz do tematu sprzętu.
Związek tematów z trybem pracy szacuje funkcja estimateEffect(), która uwzględnia niepewność oszacowań udziału tematów.
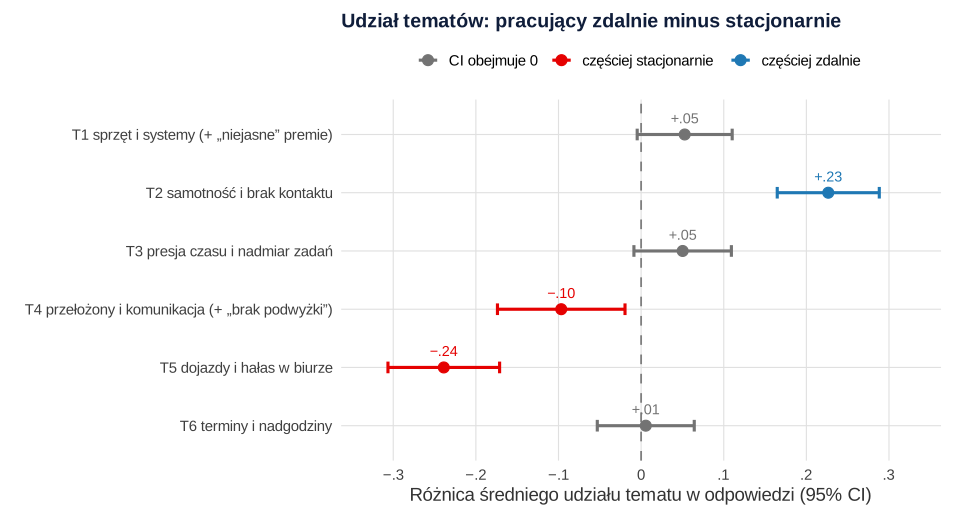
estimateEffect(). Etykiety tematów nadaliśmy po przeczytaniu typowych odpowiedzi. Obliczenia: R (odpowiedzi fikcyjne).Udział tematu „samotność i brak kontaktu” był u pracujących zdalnie wyższy o .23, 95% CI [.16, .29], a tematu „dojazdy i hałas w biurze” niższy o .24, 95% CI [−.31, −.17]. Temat przełożonego był u nich rzadszy o .10, 95% CI [−.17, −.02]. Ten ostatni wynik trzeba jednak czytać z tabelą wyżej: temat T4 zawiera też część odpowiedzi o wynagrodzeniu, więc nie wiadomo, który wątek odpowiada za różnicę. Udziały tematów to proporcje, więc przy wielu tematach rośnie też ryzyko fałszywych alarmów.
Krok 7. Walidacja: wróć do odpowiedzi
Ponieważ odpowiedzi są fikcyjne, znamy ich prawdziwe tematy. Dominujący temat stm zgadzał się z głównym tematem odpowiedzi w 76.3% przypadków. To całkiem dobrze, ale co czwarta odpowiedź trafiła „gdzie indziej”, a z prawdziwymi danymi tego nie wiesz. Dlatego:
- Czytaj. Do każdego tematu przeczytaj kilkanaście typowych i kilka granicznych odpowiedzi. Zapisuj wątpliwości w memo analitycznym. To jeden ze sposobów budowania wiarygodności analizy jakościowej.
- Porównaj z kodowaniem ręcznym. Zakoduj losową próbę odpowiedzi według klucza, nie patrząc na wynik modelu, i policz zgodność, np. kappę Cohena (procedurę opisujemy w zgodności sędziów). Grimmer i Stewart (2013) podkreślają, że walidacja musi być dopasowana do problemu.
- Sprawdź wrażliwość. Powtórz model z inną listą stopwords, bez lematyzacji i z innym K. Jeśli tematy „wędrują”, napisz to (Denny i Spirling, 2018).
- Nie licz tematów jak kategorii. Udział tematu to wynik modelu z niepewnością, a nie odsetek osób, które coś napisały. Odsetki osób daje kodowanie odpowiedzi otwartych.
Model tematów nie odpowiada na pytania o znaczenie i doświadczenie. Pokazuje, jakie słowa występują razem. Dlaczego samotność jest dla kogoś obciążeniem i jak łączy się z innymi wątkami, ustalisz dopiero w lekturze, np. w analizie tematycznej według Braun i Clarke (2006) albo w kodowaniu otwartym, osiowym i selektywnym. Wytyczne GESIS wśród sposobów analizy odpowiedzi otwartych wymieniają obok analizy treści także komputerową analizę słownikową i analizę współwystępowania słów (Züll, 2016). Gdy w jednym badaniu łączysz liczby z interpretacją, opisz to jako badanie mieszane.
Jak opisać analizę w artykule
Opis ma pozwolić powtórzyć analizę: podaj liczbę odpowiedzi, każdy krok przetwarzania, kryterium wyboru K, sposób nadania etykiet i walidację. Słownik form, listę stopwords i kod dołącz do pakietu replikacyjnego.
Jeśli masz kilkaset odpowiedzi otwartych i nie wiesz, czy wystarczy kodowanie ręczne, czy warto dodać model tematów, możemy wspólnie zaplanować analizę w ramach wsparcia dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy fikcyjne odpowiedzi, zapisuje plik odpowiedzi-otwarte-dane.csv (możesz go pobrać tutaj) i liczy częstości oraz bigramy. Drugi buduje macierz dokument–słowo i model tematów. Potrzebujesz pakietów dplyr, tidyr, tidytext, stopwords, SnowballC, quanteda i stm; wszystkie działają bez dostępu do internetu.
1. Odpowiedzi, tokenizacja, stopwords, częstości i bigramy
R
# Fikcyjne odpowiedzi na pytanie otwarte: „Co w ostatnim miesiącu najbardziej obciążało Cię w pracy?”
# 300 pracowników: 150 pracuje zdalnie lub hybrydowo, 150 stacjonarnie (teksty napisane na potrzeby przykładu)
suppressPackageStartupMessages({library(dplyr); library(tidytext)})
fragmenty <- list(
  obciazenie = c("za dużo zadań i za krótkie terminy", "nadgodziny i ciągła presja terminów", "terminy i nadgodziny prawie codziennie",
    "presja czasu, zadania spływają szybciej, niż je kończę", "za dużo obowiązków i zadań naraz", "nadgodziny, bo terminy są nierealne",
    "zbyt wiele zadań, za mało czasu", "presja czasu i nadgodziny pod koniec miesiąca", "ciągle nowe zadania i przesuwane terminy"),
  przelozony = c("brak informacji od przełożonego", "przełożony zmienia decyzje z dnia na dzień", "kierownik nie przekazuje informacji",
    "niejasne oczekiwania przełożonego", "słaba komunikacja z kierownikiem", "kierownik krytykuje przy wszystkich i nie przekazuje informacji",
    "decyzje przełożonego bez żadnej komunikacji", "brak informacji zwrotnej od kierownika"),
  izolacja = c("brak kontaktu z ludźmi", "samotność w domu przy komputerze", "praca w domu bez kontaktu z ludźmi",
    "czuję samotność, brakuje rozmów z ludźmi", "w domu trudno oddzielić pracę od życia", "cały dzień sam w domu",
    "mało kontaktu i rozmów z ludźmi z firmy", "samotność i brak rozmów"),
  dojazdy_biuro = c("długie dojazdy i korki", "hałas w biurze", "dojazdy do biura w korkach", "hałas w open space",
    "w biurze ciągły hałas i rozmowy", "korki, dojazd zajmuje godzinę", "codzienne dojazdy do biura, ponad godzina w jedną stronę",
    "open space i hałas nie pozwalają się skupić"),
  sprzet_it = c("awarie systemu", "wolny laptop i awarie VPN", "problemy z internetem i VPN", "system ciągle się zawiesza",
    "stary sprzęt i wolny laptop", "awarie sprzętu i systemu", "VPN i system działają wolno"),
  wynagrodzenie = c("niskie wynagrodzenie", "brak podwyżki i premii", "pensja za niska do obowiązków", "zarobki i brak podwyżki",
    "niejasne zasady premii", "wynagrodzenie nie rośnie, brak podwyżki"))
p_temat <- rbind(zdalny       = c(.25, .18, .27, .03, .17, .10),
                 stacjonarny  = c(.25, .20, .03, .27, .08, .17))
set.seed(2101)
tryb <- rep(c("zdalny", "stacjonarny"), each = 150)
napisz <- function(gr) {
  if (runif(1) < .04) return(sample(c("Nic szczególnego.", "Trudno powiedzieć.", "Raczej nic."), 1))
  glowny <- sample(names(fragmenty), 1, prob = p_temat[gr, ])                       # główny temat odpowiedzi
  zdania <- sample(fragmenty[[glowny]], sample(1:2, 1, prob = c(.45, .55)))          # 1–2 zdania na ten temat
  if (runif(1) < .25) {                                                               # czasem wątek poboczny
    inny <- sample(setdiff(names(fragmenty), glowny), 1, prob = p_temat[gr, names(fragmenty) != glowny])
    zdania <- c(zdania, sample(fragmenty[[inny]], 1))
  }
  tekst <- paste0(sample(c("", "", "Najbardziej ", "Chyba ", "Szczerze mówiąc, "), 1), paste(zdania, collapse = sample(c(", ", ". ", " i "), 1)))
  tekst <- gsub("\\. (\\w)", ". \\U\\1", paste0(toupper(substr(tekst, 1, 1)), substr(tekst, 2, nchar(tekst)), "."), perl = TRUE)
  attr(tekst, "temat") <- glowny
  tekst
}
odp <- lapply(tryb, napisz)
dane <- data.frame(id = sprintf("r%03d", 1:300), tryb, odpowiedz = unlist(odp),
                   temat_prawdziwy = vapply(odp, function(x) if (is.null(attr(x, "temat"))) "brak_tresci" else attr(x, "temat"), ""))
write.csv(dane[, 1:3], "odpowiedzi-otwarte-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")
head(dane$odpowiedz, 5)

# 1. Tokenizacja: jedno słowo w wierszu (małe litery, bez interpunkcji)
tokeny <- dane %>% select(id, tryb, odpowiedz) %>% unnest_tokens(slowo, odpowiedz)
c(slow = nrow(tokeny), roznych = n_distinct(tokeny$slowo))

# 2. Polskie stopwords: domyślne źródło snowball nie ma polskiego; jest stopwords-iso (pakiet stopwords, offline)
tryCatch(get_stopwords("pl"), error = function(e) cat("snowball:", conditionMessage(e), "\n"))
iso <- get_stopwords("pl", source = "stopwords-iso")$word
c(na_liscie = length(iso), zle_kodowanie = sum(grepl("[äåã]", iso)))
c("nie", "bez", "bardzo", "brak", "zbyt") %in% iso
stop_pl <- setdiff(iso[!grepl("[äåã]", iso)], "nie")                    # usuń zepsute wpisy i zostaw „nie”
stop_pl <- c(stop_pl, "chyba", "szczerze", "mówiąc", "najbardziej", "raczej")  # słowa wypełniacze z tej ankiety

# 3. Rdzeniowanie (stemming) w SnowballC nie obsługuje polskiego, więc zostaje prosta lematyzacja słownikiem
"polish" %in% SnowballC::getStemLanguages()
# Słownik: forma fleksyjna → forma podstawowa (tylko najczęstsze słowa z danych)
lematy <- c(terminy = "termin", terminów = "termin", zadań = "zadanie", zadania = "zadanie", obowiązków = "obowiązek",
  przełożonego = "przełożony", kierownikiem = "kierownik", kierownika = "kierownik", informacji = "informacja", decyzje = "decyzja",
  kontaktu = "kontakt", ludźmi = "ludzie", domu = "dom", rozmów = "rozmowa", rozmowy = "rozmowa",
  dojazdy = "dojazd", korki = "korek", korkach = "korek", biura = "biuro", biurze = "biuro", godzinę = "godzina",
  czasu = "czas", systemu = "system", sprzętu = "sprzęt", premii = "premia", podwyżki = "podwyżka", pracę = "praca", pracy = "praca")
tokeny <- tokeny %>% filter(!slowo %in% stop_pl) %>%
  mutate(lemat = ifelse(slowo %in% names(lematy), lematy[slowo], slowo))
c(form_w_slowniku = length(lematy), slow_po_stopwords = nrow(tokeny), roznych_form = n_distinct(tokeny$slowo), roznych_lematow = n_distinct(tokeny$lemat))

# 4. Częstości: w ilu odpowiedziach pojawia się słowo (liczone raz na osobę), w obu grupach
czestosci <- tokeny %>% distinct(id, tryb, lemat) %>% count(tryb, lemat) %>%
  group_by(tryb) %>% mutate(proc = round(100 * n / 150, 1)) %>% slice_max(n, n = 8, with_ties = FALSE) %>% ungroup()
print(as.data.frame(czestosci), row.names = FALSE)

# 5. Bigramy: pary sąsiednich słów, bez par zawierających stopwords
bigramy <- dane %>% unnest_tokens(bigram, odpowiedz, token = "ngrams", n = 2) %>% filter(!is.na(bigram)) %>%
  tidyr::separate(bigram, c("s1", "s2"), sep = " ") %>% filter(!s1 %in% stop_pl, !s2 %in% stop_pl) %>%
  count(s1, s2, sort = TRUE)
print(head(as.data.frame(bigramy), 10), row.names = FALSE)
Wynik w R
[1] "Niejasne zasady premii i zarobki i brak podwyżki."
[2] "Szczerze mówiąc, presja czasu i nadgodziny pod koniec miesiąca. Terminy i nadgodziny prawie codziennie."
[3] "Stary sprzęt i wolny laptop."
[4] "Najbardziej niskie wynagrodzenie i niejasne zasady premii."
[5] "Najbardziej w domu trudno oddzielić pracę od życia."
   slow roznych
   2963     131
snowball: Language "pl" not found.
See `?stopwords_getlanguages` for more information on supported languages.
    na_liscie zle_kodowanie
          356            27
[1]  TRUE  TRUE  TRUE FALSE FALSE
[1] FALSE
  form_w_slowniku slow_po_stopwords      roznych_form   roznych_lematow
               28              1841               101                88
        tryb      lemat  n proc
 stacjonarny       brak 38 25.3
 stacjonarny     dojazd 38 25.3
 stacjonarny      biuro 33 22.0
 stacjonarny      korek 29 19.3
 stacjonarny    zadanie 29 19.3
 stacjonarny nadgodziny 28 18.7
 stacjonarny        nie 28 18.7
 stacjonarny     termin 27 18.0
      zdalny       brak 35 23.3
      zdalny    zadanie 34 22.7
      zdalny        dom 28 18.7
      zdalny     ludzie 27 18.0
      zdalny       czas 26 17.3
      zdalny nadgodziny 26 17.3
      zdalny  samotność 26 17.3
      zdalny     termin 26 17.3
         s1           s2  n
       brak     podwyżki 40
     presja        czasu 29
       brak   informacji 23
      zadań        naraz 21
     koniec     miesiąca 19
        nie   przekazuje 18
 przekazuje   informacji 18
      wolny       laptop 15
    decyzje przełożonego 14
       open        space 14
2. Model tematów stm i walidacja
R
# Model tematów (stm) na odpowiedziach z przepisu 1; tryb pracy jako zmienna wpływająca na częstość tematów
suppressPackageStartupMessages({library(quanteda); library(stm)})
macierz <- tokeny %>% count(id, lemat) %>% cast_dfm(id, lemat, n)            # macierz dokument × słowo (quanteda)
macierz <- dfm_trim(macierz, min_docfreq = 3)                                 # słowa z co najmniej 3 odpowiedzi
docvars(macierz, "tryb") <- dane$tryb[match(docnames(macierz), dane$id)]
macierz <- dfm_subset(macierz, ntoken(macierz) > 0)
wejscie <- convert(macierz, to = "stm")
c(dokumentow = length(wejscie$documents), slow = length(wejscie$vocab))

# Wybór liczby tematów: spójność semantyczna, wyłączność i wiarygodność na odłożonych słowach
set.seed(2102)
k_wybor <- searchK(wejscie$documents, wejscie$vocab, K = 4:8, prevalence = ~ tryb, data = wejscie$meta, verbose = FALSE)
w <- as.data.frame(lapply(k_wybor$results[, c("K", "semcoh", "exclus", "heldout")], unlist))
print(round(w, 2), row.names = FALSE)

# Model z K = 6 tematami
model <- stm(wejscie$documents, wejscie$vocab, K = 6, prevalence = ~ tryb, data = wejscie$meta,
             init.type = "Spectral", seed = 2103, verbose = FALSE)
labelTopics(model, n = 6)

# Najbardziej typowa odpowiedź dla każdego tematu (do czytania, nie do liczenia)
teksty <- dane$odpowiedz[match(names(wejscie$documents), dane$id)]
for (t in 1:6) cat("Temat", t, ":", findThoughts(model, texts = teksty, topics = t, n = 1)$docs[[1]], "\n")

# Średni udział tematów i różnica zdalny − stacjonarny (estimateEffect z niepewnością theta)
round(colMeans(model$theta), 3)
efekt <- estimateEffect(1:6 ~ tryb, model, metadata = wejscie$meta, uncertainty = "Global")
roznice <- t(sapply(summary(efekt)$tables, function(tb) tb["trybzdalny", ]))
ci95 <- cbind(roznica = roznice[, 1], dolny95 = roznice[, 1] - 1.96 * roznice[, 2], gorny95 = roznice[, 1] + 1.96 * roznice[, 2])
print(round(roznice, 3))
print(round(ci95, 2))

# Walidacja: dominujący temat stm a główny temat odpowiedzi (znany, bo odpowiedzi są fikcyjne)
dominujacy <- apply(model$theta, 1, which.max)
prawdziwy <- dane$temat_prawdziwy[match(names(wejscie$documents), dane$id)]
tab <- table(temat_stm = dominujacy, prawdziwy)
print(tab)
etykieta <- colnames(tab)[apply(tab, 1, which.max)]
cat("Zgodność dominującego tematu stm z głównym tematem odpowiedzi:", round(100 * mean(etykieta[dominujacy] == prawdziwy), 1), "%\n")
Wynik w R
dokumentow       slow
       295         88
 K  semcoh exclus heldout
 4 -112.19   8.97   -3.41
 5  -84.04   9.19   -3.22
 6 -134.88   9.23   -3.37
 7 -117.58   9.36   -3.09
 8 -124.75   9.37   -3.27
Topic 1 Top Words:
 	 Highest Prob: system, vpn, awarie, niejasne, premia, sprzęt
 	 FREX: system, vpn, awarie, niejasne, premia, internetem
 	 Lift: system, działają, wolno, awarie, internetem, niejasne
 	 Score: system, awarie, premia, niejasne, vpn, zawiesza
Topic 2 Top Words:
 	 Highest Prob: samotność, dom, ludzie, rozmowa, kontakt, brak
 	 FREX: samotność, dom, ludzie, kontakt, komputerze, laptop
 	 Lift: komputerze, laptop, oddzielić, wolny, życia, kontakt
 	 Score: samotność, ludzie, dom, kontakt, rozmowa, praca
Topic 3 Top Words:
 	 Highest Prob: zadanie, czas, presja, obowiązek, zbyt, naraz
 	 FREX: czas, zbyt, naraz, koniec, miesiąca, zadanie
 	 Lift: koniec, miesiąca, czas, kończę, spływają, szybciej
 	 Score: czas, zadanie, presja, koniec, miesiąca, zbyt
Topic 4 Top Words:
 	 Highest Prob: brak, przełożony, informacja, podwyżka, kierownik, nie
 	 FREX: przełożony, informacja, kierownik, decyzja, wynagrodzenie, przekazuje
 	 Lift: komunikacja, komunikacji, słaba, żadnej, zarobki, kierownik
 	 Score: przełożony, informacja, brak, podwyżka, kierownik, decyzja
Topic 5 Top Words:
 	 Highest Prob: dojazd, biuro, korek, hałas, godzina, open
 	 FREX: dojazd, biuro, korek, hałas, godzina, open
 	 Lift: ciągły, open, pozwalają, skupić, space, hałas
 	 Score: biuro, dojazd, hałas, korek, godzina, open
Topic 6 Top Words:
 	 Highest Prob: termin, nadgodziny, nierealne, zadanie, codziennie, ciągle
 	 FREX: termin, nierealne, codziennie, nadgodziny, ciągła, przesuwane
 	 Lift: codziennie, nierealne, termin, ciągła, krótkie, przesuwane
 	 Score: termin, nadgodziny, ciągła, nierealne, codziennie, przesuwane
Temat 1 : Chyba awarie sprzętu i systemu i VPN i system działają wolno.
Temat 2 : Szczerze mówiąc, w domu trudno oddzielić pracę od życia i czuję samotność, brakuje rozmów z ludźmi.
Temat 3 : Presja czasu, zadania spływają szybciej, niż je kończę, za dużo obowiązków i zadań naraz.
Temat 4 : Najbardziej kierownik krytykuje przy wszystkich i nie przekazuje informacji, przełożony zmienia decyzje z dnia na dzień.
Temat 5 : Najbardziej open space i hałas nie pozwalają się skupić, codzienne dojazdy do biura, ponad godzina w jedną stronę.
Temat 6 : Chyba nadgodziny, bo terminy są nierealne i ciągle nowe zadania i przesuwane terminy.
[1] 0.147 0.166 0.155 0.253 0.157 0.121
     Estimate Std. Error t value Pr(>|t|)
[1,]    0.053      0.029   1.798    0.073
[2,]    0.227      0.032   7.189    0.000
[3,]    0.050      0.030   1.670    0.096
[4,]   -0.097      0.039  -2.455    0.015
[5,]   -0.239      0.034  -6.929    0.000
[6,]    0.006      0.030   0.188    0.851
     roznica dolny95 gorny95
[1,]    0.05    0.00    0.11
[2,]    0.23    0.16    0.29
[3,]    0.05   -0.01    0.11
[4,]   -0.10   -0.17   -0.02
[5,]   -0.24   -0.31   -0.17
[6,]    0.01   -0.05    0.06
         prawdziwy
temat_stm brak_tresci dojazdy_biuro izolacja obciazenie przelozony sprzet_it wynagrodzenie
        1           6             0        0          1          1        27             8
        2           1             0       39          4          2         7             0
        3           0             1        0         43          1         0             0
        4           0             1        0          2         44         2            28
        5           0            43        1          0          1         1             2
        6           0             0        0         29          0         0             0
Zgodność dominującego tematu stm z głównym tematem odpowiedzi: 76.3 %
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- tidytext (wersja 0.4.3): Silge, J., & Robinson, D. (2016). tidytext: Text mining and analysis using tidy data principles in R. Journal of Open Source Software, 1(3), 37. https://doi.org/10.21105/joss.00037
- quanteda (wersja 4.4): Benoit, K., Watanabe, K., Wang, H., Nulty, P., Obeng, A., Müller, S., & Matsuo, A. (2018). quanteda: An R package for the quantitative analysis of textual data. Journal of Open Source Software, 3(30), 774. https://doi.org/10.21105/joss.00774
- stm (wersja 1.3.8): Roberts, M. E., Stewart, B. M., & Tingley, D. (2019). stm: An R package for structural topic models. Journal of Statistical Software, 91(2), 1–40. https://doi.org/10.18637/jss.v091.i02
- stopwords (wersja 2.3): Benoit, K., Muhr, D., & Watanabe, K. (2021). stopwords: Multilingual stopword lists [R package]. https://doi.org/10.32614/CRAN.package.stopwords
- dplyr (wersja 1.2.0): Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation [R package]. https://doi.org/10.32614/CRAN.package.dplyr
- tidyr (wersja 1.3.2): Wickham, H., Vaughan, D., & Girlich, M. (2025). tidyr: Tidy messy data [R package]. https://doi.org/10.32614/CRAN.package.tidyr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raport z samego modelu tematów, bez lektury odpowiedzi. Etykiety tematów to interpretacja badacza i wymagają uzasadnienia przykładami.
- Gotowa lista stopwords bez przejrzenia. Lista może zawierać przeczenia i uszkodzone wpisy.
- Ignorowanie fleksji. Bez sprowadzenia form „terminy” i „terminów” liczą się jako dwa różne słowa, a częstości i tematy się rozpraszają.
- Chmura słów jako wynik. Pokazuje częstość bez kontekstu i bez porównania grup. Lepszy jest wykres odsetków z rysunku 1 i bigramy.
- Jedno K bez uzasadnienia. Pokaż wskaźniki dla kilku wartości i wyjaśnij wybór.
- Model tematów na kilkudziesięciu krótkich odpowiedziach. Przy tak małym zbiorze lepiej zakodować wszystko ręcznie.
- Udziały tematów opisywane jak odsetki osób. „Temat T2 stanowił 23% treści” to nie to samo co „23% osób pisało o samotności”.
Najczęstsze pytania
Czy w R są polskie stopwords?
Tak, ale nie w domyślnym źródle Snowball, którego używają tidytext::get_stopwords() i quanteda::stopwords(). Polska lista jest w źródle stopwords-iso: get_stopwords("pl", source = "stopwords-iso"). Przejrzyj ją przed użyciem: w wersji 2.3 pakietu stopwords 27 z 356 wpisów ma uszkodzone kodowanie, a lista zawiera przeczenie „nie”.
Jak wybrać liczbę tematów w modelu stm?
Dopasuj modele dla kilku wartości K funkcją searchK() i porównaj spójność semantyczną, wyłączność i dopasowanie do odłożonych słów. Wskaźniki zwykle zawężają wybór, ale go nie rozstrzygają. Ostateczną decyzję podejmij po przeczytaniu słów i typowych odpowiedzi każdego tematu i opisz kryteria w pracy.
Czy model tematów może zastąpić ręczne kodowanie odpowiedzi otwartych?
Nie. Model pokazuje, które słowa występują razem, a etykiety tematów i ich znaczenie nadaje badacz. Wynik trzeba walidować lekturą odpowiedzi i porównaniem z kodowaniem ręcznym próby (Grimmer i Stewart, 2013). Model przydaje się do wstępnego rozpoznania dużego zbioru i do porównań grup.
Jak uwzględnić odmianę polskich wyrazów w analizie tekstu w R?
Rdzeniowanie z pakietu SnowballC nie obsługuje polskiego. W małym zbiorze przygotuj słownik form najczęstszych słów (np. „terminów” → „termin”) i zastosuj go po tokenizacji. Przy dużych zbiorach potrzebny jest zewnętrzny lematyzator. Słownik albo opis narzędzia dołącz do materiałów uzupełniających.
Powiązane hasła
Przeczytaj też
Analiza treści pytań otwartych
Klucz kategoryzacji, pilotaż, kappa dla każdej kategorii, odsetki z przedziałem Wilsona i porównanie grup – z plikiem Excel, kodem R i opisem APA.
Czytaj →PoradnikAnaliza tematyczna krok po kroku
Sześć faz według Braun i Clarke, podejście refleksyjne a książka kodowa, przykład kodowania „fragment → kod → temat”, typowe błędy i wzór opisu.
Czytaj →PoradnikBadania mieszane (mixed methods)
Trzy podstawowe schematy, cele łączenia metod, integracja na trzech poziomach, joint display i wzory opisu dla doktoratu, wniosku i artykułu.
Czytaj →Masz kilkaset odpowiedzi otwartych i nie wiesz, jak je przeanalizować?
Pomożemy zaplanować połączenie kodowania ręcznego i analizy tekstu w R, przygotować kod i opis metody tak, żebyś mógł(a) samodzielnie obronić wyniki przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Benoit, K., Watanabe, K., Wang, H., Nulty, P., Obeng, A., Müller, S., & Matsuo, A. (2018). quanteda: An R package for the quantitative analysis of textual data. Journal of Open Source Software, 3(30), Article 774. https://doi.org/10.21105/joss.00774 ● Otwarty dostęp
- Braun, V., & Clarke, V. (2006). Using thematic analysis in psychology. Qualitative Research in Psychology, 3(2), 77–101. https://doi.org/10.1191/1478088706qp063oa ● Otwarty dostęp
- Denny, M. J., & Spirling, A. (2018). Text preprocessing for unsupervised learning: Why it matters, when it misleads, and what to do about it. Political Analysis, 26(2), 168–189. https://doi.org/10.1017/pan.2017.44 ● Otwarty dostęp: pełny tekst
- Grimmer, J., & Stewart, B. M. (2013). Text as data: The promise and pitfalls of automatic content analysis methods for political texts. Political Analysis, 21(3), 267–297. https://doi.org/10.1093/pan/mps028 ● Otwarty dostęp
- Nelson, L. K. (2020). Computational grounded theory: A methodological framework. Sociological Methods & Research, 49(1), 3–42. https://doi.org/10.1177/0049124117729703
- Roberts, M. E., Stewart, B. M., & Tingley, D. (2019). stm: An R package for structural topic models. Journal of Statistical Software, 91(2), 1–40. https://doi.org/10.18637/jss.v091.i02 ● Otwarty dostęp
- Roberts, M. E., Stewart, B. M., Tingley, D., Lucas, C., Leder-Luis, J., Gadarian, S. K., Albertson, B., & Rand, D. G. (2014). Structural topic models for open-ended survey responses. American Journal of Political Science, 58(4), 1064–1082. https://doi.org/10.1111/ajps.12103
- Silge, J., & Robinson, D. (2016). tidytext: Text mining and analysis using tidy data principles in R. Journal of Open Source Software, 1(3), Article 37. https://doi.org/10.21105/joss.00037 ● Otwarty dostęp
- Züll, C. (2016). Open-ended questions. GESIS – Leibniz Institute for the Social Sciences. https://doi.org/10.15465/gesis-sg_en_002 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{benoit2018quanteda, author={Benoit, Kenneth and Watanabe, Kohei and Wang, Haiyan and Nulty, Paul and Obeng, Adam and Müller, Stefan and Matsuo, Akitaka}, title={{quanteda: An R package for the quantitative analysis of textual data}}, journal={Journal of Open Source Software}, year={2018}, volume={3}, number={30}, eid={774}, doi={10.21105/joss.00774}}@article{braun2006using, author={Braun, Virginia and Clarke, Victoria}, title={{Using thematic analysis in psychology}}, journal={Qualitative Research in Psychology}, year={2006}, volume={3}, number={2}, pages={77--101}, doi={10.1191/1478088706qp063oa}}@article{denny2018text, author={Denny, Matthew J. and Spirling, Arthur}, title={{Text preprocessing for unsupervised learning: Why it matters, when it misleads, and what to do about it}}, journal={Political Analysis}, year={2018}, volume={26}, number={2}, pages={168--189}, doi={10.1017/pan.2017.44}}@article{grimmer2013text, author={Grimmer, Justin and Stewart, Brandon M.}, title={{Text as data: The promise and pitfalls of automatic content analysis methods for political texts}}, journal={Political Analysis}, year={2013}, volume={21}, number={3}, pages={267--297}, doi={10.1093/pan/mps028}}@article{nelson2020computational, author={Nelson, Laura K.}, title={{Computational grounded theory: A methodological framework}}, journal={Sociological Methods \& Research}, year={2020}, volume={49}, number={1}, pages={3--42}, doi={10.1177/0049124117729703}}@article{roberts2019stm, author={Roberts, Margaret E. and Stewart, Brandon M. and Tingley, Dustin}, title={{stm: An R package for structural topic models}}, journal={Journal of Statistical Software}, year={2019}, volume={91}, number={2}, pages={1--40}, doi={10.18637/jss.v091.i02}}@article{roberts2014structural, author={Roberts, Margaret E. and Stewart, Brandon M. and Tingley, Dustin and Lucas, Christopher and Leder-Luis, Jetson and Gadarian, Shana Kushner and Albertson, Bethany and Rand, David G.}, title={{Structural topic models for open-ended survey responses}}, journal={American Journal of Political Science}, year={2014}, volume={58}, number={4}, pages={1064--1082}, doi={10.1111/ajps.12103}}@article{silge2016tidytext, author={Silge, Julia and Robinson, David}, title={{tidytext: Text mining and analysis using tidy data principles in R}}, journal={Journal of Open Source Software}, year={2016}, volume={1}, number={3}, eid={37}, doi={10.21105/joss.00037}}@techreport{zull2016open, author={Züll, Cornelia}, title={{Open-ended questions}}, year={2016}, institution={GESIS – Leibniz Institute for the Social Sciences}, doi={10.15465/gesis-sg_en_002}}