Ankieta wiedzy w pracy licencjackiej: co właściwie mierzysz?
W pracach z pielęgniarstwa, zdrowia publicznego i dietetyki często pada pytanie badawcze: „Jaki jest poziom wiedzy pacjentów na temat…?”. Narzędziem jest zwykle autorski test – kilkanaście pytań jednokrotnego wyboru z jedną poprawną odpowiedzią – uzupełniony metryczką i pytaniem o źródła wiedzy. Choć całość nazywa się ankietą, część z pytaniami o wiedzę działa jak test, a nie jak skala postaw: każda odpowiedź jest poprawna albo nie, a wynik to liczba poprawnych odpowiedzi. Różnicę między ankietą a kwestionariuszem wyjaśniamy w haśle kwestionariusz a ankieta.
Od tej decyzji zależy cała analiza: sposób punktowania odpowiedzi „nie wiem”, wybór współczynnika rzetelności, testy porównujące grupy i to, jak uczciwie opisać „poziom wiedzy”. W tym poradniku przechodzimy przez wszystkie kroki na jednym przykładzie. 203 pacjentów poradni specjalistycznej wypełniło ankietę z 15 pytaniami o swojej chorobie i jej leczeniu (P1–P15), metryczką i pytaniem o źródła wiedzy. Treść pytań i klucz celowo pomijamy – to poradnik o analizie, a nie o medycynie, a ten sam schemat sprawdzi się w badaniu wiedzy o żywieniu, szczepieniach czy profilaktyce. Dane są symulowane, a wszystkie liczby pochodzą z kodu z sekcji Przykład w R.
Plik do pobrania: ankieta-wiedzy-dane-przyklad.xlsx – dane 203 osób z arkuszami Dane, Klucz, Ksiazka_kodowa i Instrukcja (32 KB). Możesz na nim przećwiczyć każdy krok, zanim zrobisz to samo na własnej bazie; jak ją przygotować, opisujemy w poradniku jak przygotować bazę danych do analizy.
| Zmienna | Co zawiera | Jak ją analizujesz |
|---|---|---|
| P1–P15 | odpowiedź A–D, „nie wiem” albo brak odpowiedzi | punktacja 0/1 według klucza |
| wynik testu | suma punktów 0–15 i odsetek poprawnych odpowiedzi | główna zmienna zależna – statystyki opisowe, testy rangowe |
| poziom wiedzy | niski / średni / wysoki według progów | liczebności i odsetki, tabela krzyżowa |
| wykształcenie | podstawowe lub zawodowe / średnie / wyższe | test Kruskala–Wallisa z porównaniami parami |
| zajęcia edukacyjne w poradni | tak / nie | test Manna–Whitneya |
| wiek, staż choroby | lata | korelacja Spearmana |
| źródła wiedzy | 8 opcji, każda zakodowana 0/1 | odsetek respondentów |
Krok 1. Punktacja: 1 punkt za poprawną odpowiedź, „nie wiem” to 0
Każdą odpowiedź porównaj z kluczem i zamień na 0 albo 1 – powstaje zmienna dychotomiczna dla każdej pozycji. Suma punktów to wynik surowy (tu od 0 do 15). Podawaj go razem z odsetkiem poprawnych odpowiedzi (wynik / 15 × 100), bo odsetek łatwo porównać z innymi badaniami, w których test miał inną liczbę pytań.
Odpowiedź „nie wiem” licz jako 0 punktów, a nie jako brak danych. Osoba odpowiedziała – zadeklarowała, że nie zna odpowiedzi. Gdybyś potraktował(a) te odpowiedzi jako braki, z analizy wypadałyby przede wszystkim osoby o najmniejszej wiedzy, a średni wynik byłby sztucznie zawyżony. Samą opcję „nie wiem” warto mieć w kafeterii: w eksperymentach Luskina i Bullocka (2011) zniechęcanie respondentów do odpowiedzi „nie wiem” zwiększało liczbę poprawnych odpowiedzi w pytaniach zamkniętych, ale w większości pozornie – przez zgadywanie.
Inaczej jest z brakiem odpowiedzi, czyli pustym polem. Zanim zobaczysz wyniki, zapisz regułę: od ilu pominiętych pytań osoba nie wchodzi do analizy i jak punktujesz pojedyncze braki. W przykładzie wróciły 203 ankiety. Trzy osoby pominęły od 9 do 11 z 15 pytań, więc zgodnie z regułą („więcej niż połowa pytań pominięta”) nie weszły do analizy – zostało N = 200. Pozostałe pojedyncze braki (41 z 3000 odpowiedzi, czyli 1.4%) policzyliśmy jako odpowiedzi niepoprawne. Jeśli pytania mają kilka poprawnych odpowiedzi, z góry ustal też, czy przyznajesz punkt tylko za komplet, czy punkty cząstkowe.
Gotowy opis do rozdziału metodologicznego (uzupełnij nawiasy kwadratowe):
Krok 2. Opisz wynik ciągły, zanim podzielisz go na poziomy
Główną zmienną w analizie jest wynik 0–15, a nie etykieta „niski” czy „wysoki”. W przykładzie wyniki wahały się od 1 do 15 punktów, M = 9.80 (SD = 2.98), mediana wyniosła 10 punktów, a rozstęp ćwiartkowy (IQR) obejmował wyniki od 8 do 12. Przeciętnie respondenci odpowiedzieli poprawnie na 65.3% pytań. Najwięcej osób uzyskało od 9 do 13 punktów, maksymalny wynik miało 5 osób (2.5%), więc test nie ma wyraźnego efektu sufitu.
Podaj zarówno średnią, jak i medianę z kwartylami – pierwsza ułatwia porównanie z innymi badaniami, druga lepiej opisuje rozkład skośny i jest naturalnym towarzyszem testów rangowych. Przed dalszą analizą obejrzyj rozkład na histogramie albo wykresie pudełkowym (rysunek 2). Jeśli wiele osób ma wynik maksymalny, test był za łatwy dla Twojej grupy: różnice między osobami o dobrej wiedzy się zacierają, a wnioski o „wysokim poziomie wiedzy” stają się mało informacyjne.
Krok 3. Poziomy wiedzy: progi są umowne
W wielu pracach wynik zamienia się na trzy poziomy wiedzy. Często spotykany podział to: poniżej 60% poprawnych odpowiedzi – poziom niski, 60–79% – średni, co najmniej 80% – wysoki. W teście z 15 pytań odpowiada to 0–8, 9–11 i 12–15 punktom. W przykładzie niski poziom wiedzy miało 60 osób (30.0%), średni – 71 osób (35.5%), a wysoki – 69 osób (34.5%).
Takie progi to umowa, a nie właściwość testu. Jeśli test nie był normalizowany ani porównany z zewnętrznym kryterium, nie ma „naukowej” granicy dobrej wiedzy. Tabela poniżej pokazuje, jak bardzo wynik zależy od tej umowy: odsetek osób z „wysoką wiedzą” waha się od 7.5% do 44.5%, choć dane się nie zmieniły. Progi 75% i 80% dają ten sam wynik, bo przy 15 pytaniach oba oznaczają co najmniej 12 punktów.
| Próg „wysokiej wiedzy” | Minimalny wynik (z 15 pkt) | Osoby z „wysoką wiedzą” |
|---|---|---|
| 70% | 11 | 44.5% |
| 75% | 12 | 34.5% |
| 80% | 12 | 34.5% |
| 85% | 13 | 19.0% |
| 90% | 14 | 7.5% |
Dzielenie wyniku na kategorie ma też koszt statystyczny. MacCallum i in. (2002) pokazali, że dzielenie zmiennych ilościowych na grupy rzadko jest uzasadnione i często prowadzi do mylących wniosków, a McNeish i Wolf (2020) przypominają, że sam wynik sumaryczny to model z mocnymi założeniami, który może zawodzić także przy klasyfikowaniu osób według punktów odcięcia. W praktyce:
- ustal progi przed analizą i podaj ich źródło – wcześniejsze badania tym samym narzędziem albo kryterium uzgodnione z promotorem;
- główne analizy wykonaj na wyniku ciągłym (kroki 6 i 8);
- poziomy pokaż opisowo (n i %) i – jeśli promotor tego oczekuje – w tabeli krzyżowej (krok 7);
- nigdy nie licz średniej z kodów poziomów (więcej w sekcji o błędach).
Koszt dzielenia wyniku na dwie grupy pokazujemy liczbowo w haśle skala dychotomiczna.
Krok 4. Rzetelność testu: KR-20 i jej zastrzeżenia
Dla testu z pozycjami punktowanymi 0/1 klasyczną miarą rzetelności jest współczynnik Kudera–Richardsona KR-20 (Kuder i Richardson, 1937):
gdzie k to liczba pozycji, pi – odsetek poprawnych odpowiedzi w pozycji i, qi = 1 − pi, a s2X – wariancja wyniku testu. Cronbach (1951) pokazał, że alfa jest ogólnym wzorem, którego szczególnym przypadkiem jest właśnie KR-20. Dla pozycji 0/1 KR-20 i alfa Cronbacha to ta sama liczba – dokumentacja SPSS wprost podaje, że alfa liczona dla danych dychotomicznych jest równoważna KR-20 (IBM, b.d.). Więcej o alfie i jej interpretacji piszemy w poradniku alfa Cronbacha – jak oceniać rzetelność skali.
W przykładzie KR-20 = .74, 95% CI [.69, .79]. W literaturze nie ma jednej granicy „wystarczającej” rzetelności – Tavakol i Dennick (2011) przypominają, że podawane wartości akceptowalne wahają się od .70 do .95. Dla krótkiego testu, którego wyniki porównujesz między grupami, .74 to wynik przyzwoity; ważniejsze od etykiety jest podanie przedziału ufności i krótkie omówienie, co obniża rzetelność.
Zastrzeżenie: KR-20 nie dowodzi jednowymiarowości
KR-20, tak jak alfa, zakłada, że wszystkie pozycje mierzą tę samą wiedzę – jeden wymiar. Test wiedzy często jednak obejmuje kilka obszarów, na przykład objawy, leczenie i codzienną samoopiekę. Wysoki współczynnik nie świadczy, że test jest jednowymiarowy: alfa nie mówi nic o wewnętrznej strukturze testu (Sijtsma, 2009), a test wielowymiarowy nie musi mieć niższej alfy niż jednowymiarowy (Tavakol i Dennick, 2011). Już Cronbach (1951) zalecał, by test dający się podzielić na odrębne części dzielić przed użyciem wzoru. Jeśli Twój test ma trzy części po pięć pytań, podaj KR-20 dla każdej części – będzie niższy, bo części są krótsze, i to normalne. Strukturę testu sprawdzisz analizą czynnikową na korelacjach tetrachorycznych albo modelami teorii reagowania na pozycje testowe (IRT), ale w pracy licencjackiej zwykle wystarczy uczciwe zastrzeżenie i KR-20 policzony osobno dla obszarów. Spójność wewnętrzna to tylko jeden aspekt jakości narzędzia – równie ważna jest trafność treściowa, czyli to, czy pytania obejmują wszystko, co składa się na badaną wiedzę.
Krok 5. Analiza pozycji: łatwość i moc różnicująca
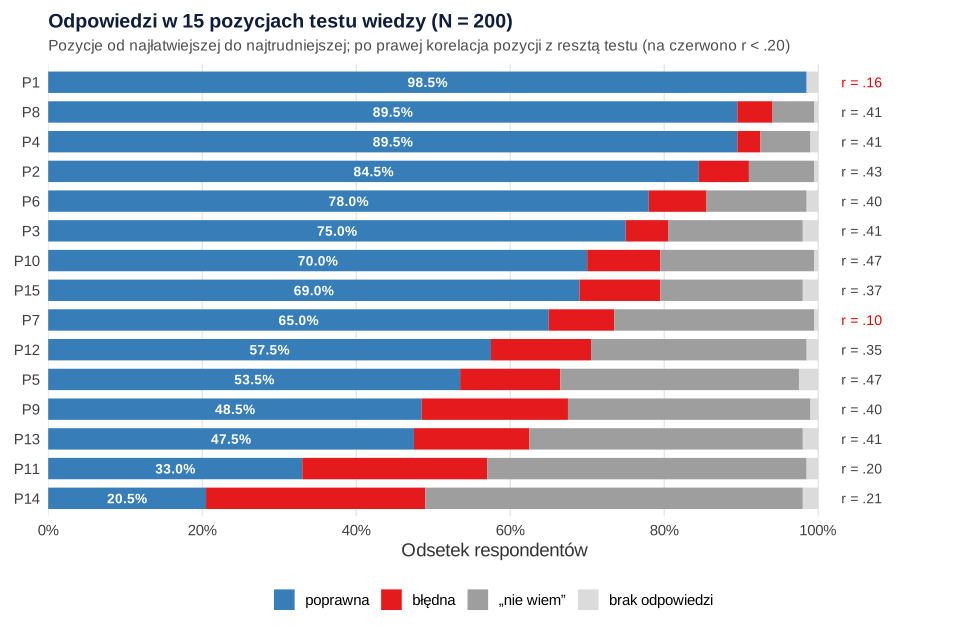
Rzetelność całego testu zależy od tego, jak działają pojedyncze pytania. Dla każdej pozycji policz dwie liczby:
- łatwość (p) – odsetek poprawnych odpowiedzi; im wyższy, tym łatwiejsze pytanie;
- moc różnicującą – korelację pozycji z wynikiem pozostałych 14 pytań (r z resztą testu). Mówi ona, czy osoby o większej wiedzy częściej odpowiadają na to pytanie poprawnie.
Rysunek 1 zestawia obie informacje i dodatkowo rozdziela odpowiedzi niepoprawne na błędne i „nie wiem”.
| Pozycja | Poprawne | Błędne | „Nie wiem” | Brak | r z resztą testu | KR-20 bez pozycji |
|---|---|---|---|---|---|---|
| P1 | 98.5% | 0.0% | 0.0% | 1.5% | .16 | .742 |
| P4 | 89.5% | 3.0% | 6.5% | 1.0% | .41 | .724 |
| P8 | 89.5% | 4.5% | 5.5% | 0.5% | .41 | .724 |
| P2 | 84.5% | 6.5% | 8.5% | 0.5% | .43 | .720 |
| P6 | 78.0% | 7.5% | 13.0% | 1.5% | .40 | .722 |
| P3 | 75.0% | 5.5% | 17.5% | 2.0% | .41 | .720 |
| P10 | 70.0% | 9.5% | 20.0% | 0.5% | .47 | .714 |
| P15 | 69.0% | 10.5% | 18.5% | 2.0% | .37 | .725 |
| P7 | 65.0% | 8.5% | 26.0% | 0.5% | .10 | .754 |
| P12 | 57.5% | 13.0% | 28.0% | 1.5% | .35 | .727 |
| P5 | 53.5% | 13.0% | 31.0% | 2.5% | .47 | .713 |
| P9 | 48.5% | 19.0% | 31.5% | 1.0% | .40 | .721 |
| P13 | 47.5% | 15.0% | 35.5% | 2.0% | .41 | .720 |
| P11 | 33.0% | 24.0% | 41.5% | 1.5% | .20 | .743 |
| P14 | 20.5% | 28.5% | 49.0% | 2.0% | .21 | .740 |
Jak czytać te liczby na przykładzie:
- P1 – poprawnie odpowiedziało 98.5% osób. Pytanie niczego nie różnicuje (r = .16), bo prawie nie ma zmienności. Może zostać z powodów merytorycznych, na przykład jako sprawdzenie podstawowej informacji, ale do rzetelności niewiele wnosi.
- P7 – łatwość umiarkowana (65.0%), ale korelacja z resztą testu tylko .10, a po usunięciu pozycji KR-20 wzrósłby z .741 do .754. To sygnał, że pytanie jest niejasne, ma dwie obronne odpowiedzi albo błąd w kluczu. Tavakol i Dennick (2011) zalecają poprawienie lub usunięcie pozycji o korelacji bliskiej zera – ale decyzję podejmij merytorycznie, opisz ją w pracy i sprawdź, czy wnioski bez tej pozycji się nie zmieniają.
- P11 i P14 – najtrudniejsze pytania (33.0% i 20.5% poprawnych) z dużym odsetkiem odpowiedzi „nie wiem” (41.5% i 49.0%) i błędnych (24.0% i 28.5%).
Rozdzielenie błędnych odpowiedzi i „nie wiem” przydaje się w dyskusji. Oba rodzaje dostają 0 punktów, ale „nie wiem” wskazuje na lukę w wiedzy, a częsta błędna odpowiedź może oznaczać utrwalone błędne przekonanie albo niejasne pytanie. Sprawdź wtedy, którą błędną odpowiedź wybierano najczęściej. Ten podział podpowiada, czego dotyczyć powinna edukacja.
Krok 6. Porównania grup: test Manna–Whitneya i Kruskala–Wallisa
Wynik testu wiedzy to liczba całkowita z wąskiego zakresu, często o rozkładzie skośnym, z możliwym efektem sufitu. Dlatego w pracach dyplomowych bezpiecznym wyborem są testy nieparametryczne oparte na rangach. Przy 200 osobach test t czy ANOVA dałyby prawdopodobnie podobne wnioski – ważne, by test wybrać przed analizą i nie zmieniać go po zobaczeniu wyników.
Dwie grupy: test Manna–Whitneya
Osoby, które uczestniczyły w zajęciach edukacyjnych w poradni (n = 99), uzyskały medianę 11 punktów (IQR 9–12), a osoby, które w nich nie uczestniczyły (n = 101) – medianę 9 punktów (IQR 7–11). Test Manna–Whitneya wykazał istotną różnicę: U = 3751.5, z = −3.07, p = .002. Jako wielkość efektu podaj korelację rangowo-dwuseryjną, rrb = .25. Kerby (2014) liczy ją prostym wzorem: odsetek par, w których wyższy wynik ma osoba z jednej grupy, minus odsetek par odwrotnych. Tutaj w 62.5% par „osoba po zajęciach – osoba bez zajęć” wyższy wynik miała osoba po zajęciach (remisy liczono po połowie).
Uważaj na sformułowanie wniosku. Test Manna–Whitneya nie porównuje median: Divine i in. (2018) pokazują, że sprawdza on, jak często wyniki z jednej grupy przewyższają wyniki z drugiej. Mediany podawaj jako opis, a wniosek formułuj tak: „osoby po zajęciach uzyskiwały wyższe wyniki”, a nie „mediany różniły się istotnie”.
Trzy grupy i więcej: test Kruskala–Wallisa z testem Dunna
Wynik różnił się w zależności od wykształcenia: mediana wyniosła 9 punktów u osób z wykształceniem podstawowym lub zawodowym, 10 – ze średnim i 12 – z wyższym. Test Kruskala–Wallisa: H(2) = 16.81, p < .001, η²H = .08. Istotny wynik mówi tylko, że gdzieś jest różnica, więc w drugim kroku wykonaj porównania post hoc. Po teście Kruskala–Wallisa stosuje się test Dunna (Dunn, 1964) – porównania sum rang ze wspólnego rangowania wszystkich grup – z korektą Holma (Holm, 1979), która jest mocniejszą odmianą korekty Bonferroniego:
- wyższe a podstawowe lub zawodowe: z = 4.10, pHolm < .001;
- wyższe a średnie: z = 2.51, pHolm = .024;
- średnie a podstawowe lub zawodowe: z = 1.90, pHolm = .057.
Rysunek 2 pokazuje cały rozkład wyników w grupach, a nie tylko mediany – widać na nim, jak bardzo grupy na siebie zachodzą, mimo istotnych różnic.
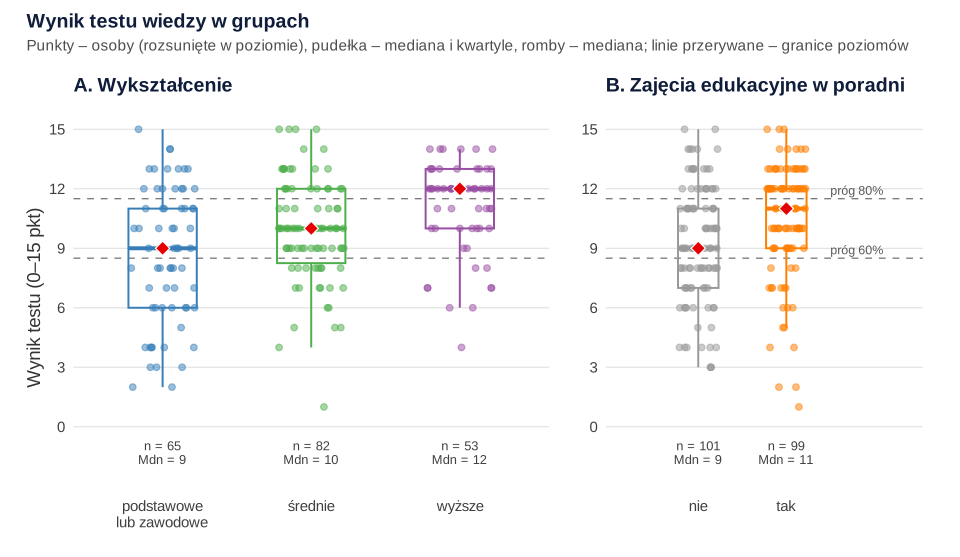
Pamiętaj, że to badanie przekrojowe. Osoby, które poszły na zajęcia edukacyjne, mogły różnić się od pozostałych już wcześniej – wykształceniem, stażem choroby czy motywacją – więc wynik nie dowodzi, że zajęcia podniosły wiedzę (zob. schemat przekrojowy i zmienna zakłócająca).
Krok 7. Poziomy wiedzy w grupach: test chi-kwadrat
Jeśli promotor oczekuje porównania poziomów wiedzy, zestaw je w tabeli krzyżowej z odsetkami w wierszach, czyli w obrębie grup wykształcenia:
| Wykształcenie | Niski | Średni | Wysoki | Razem |
|---|---|---|---|---|
| podstawowe lub zawodowe | 30 (46.2%) | 19 (29.2%) | 16 (24.6%) | 65 |
| średnie | 21 (25.6%) | 37 (45.1%) | 24 (29.3%) | 82 |
| wyższe | 9 (17.0%) | 15 (28.3%) | 29 (54.7%) | 53 |
Przed testem sprawdź liczebności oczekiwane: Kim (2017) przypomina, że najwyżej 20% komórek może mieć liczebność oczekiwaną poniżej 5, a żadna nie może mieć poniżej 1. Tu najmniejsza wynosi 15.9, więc warunek jest spełniony. Test chi-kwadrat niezależności: χ²(4, N = 200) = 21.58, p < .001, a V Craméra = .23. Wysoki poziom wiedzy miało 54.7% osób z wykształceniem wyższym i 24.6% z wykształceniem podstawowym lub zawodowym.
Traktuj ten test jako uzupełnienie, a nie zamiennik kroku 6. Chi-kwadrat ignoruje uporządkowanie poziomów i różnice wewnątrz nich – osoba z 12 i z 15 punktami ląduje w tej samej komórce. Jeśli w pracy są obie analizy, najpierw opisz wynik ciągły.
Krok 8. Wiedza a wiek i staż choroby: korelacja Spearmana
Związek wyniku testu ze zmiennymi ilościowymi, takimi jak wiek czy staż choroby, opisz korelacją Spearmana. Nie wymaga ona normalności, dobrze znosi rangi wiązane, typowe dla wyniku 0–15, i opisuje każdy związek monotoniczny, nie tylko liniowy. Wynik testu słabo korelował ze stażem choroby, ρ = .16, 95% CI [.03, .29], p = .023, i nie korelował z wiekiem, ρ = −.03, 95% CI [−.17, .11], p = .626. Przedziały ufności policzyliśmy bootstrapem z 2000 prób.
Przy wieku zwróć uwagę na przedział ufności: obejmuje on zero, ale też słabe związki w obu kierunkach. Napisz więc „nie stwierdzono związku”, a nie „wiek nie ma wpływu na wiedzę”. Nie dziel też wieku na przedziały tylko po to, by policzyć chi-kwadrat – tracisz w ten sposób informację, o czym pisaliśmy w kroku 3. Związek warto też pokazać na wykresie rozrzutu.
Krok 9. Źródła wiedzy: pytanie wielokrotnego wyboru
Pytanie „Skąd czerpie Pan/Pani wiedzę o swojej chorobie?” z możliwością zaznaczenia kilku odpowiedzi koduj tak, by każda opcja była osobną kolumną 0/1. Tak zapisują je też eksporty z formularzy online – jak je przekodować, pokazujemy w poradniku dane z Google Forms i LimeSurvey. Odsetki licz względem liczby respondentów (N = 200), a nie liczby wskazań. Wtedy suma przekracza 100%, co wyjaśnij w nocie pod tabelą.
| Źródło wiedzy | n | % respondentów | % wszystkich wskazań |
|---|---|---|---|
| lekarz | 142 | 71.0% | 26.3% |
| strony internetowe | 131 | 65.5% | 24.3% |
| pielęgniarka | 79 | 39.5% | 14.7% |
| rodzina i znajomi | 50 | 25.0% | 9.3% |
| media społecznościowe | 49 | 24.5% | 9.1% |
| ulotki i broszury | 49 | 24.5% | 9.1% |
| telewizja i radio | 27 | 13.5% | 5.0% |
| inne | 12 | 6.0% | 2.2% |
Kolumna „% respondentów” odpowiada na pytanie, jaka część badanych korzysta z danego źródła. Kolumna „% wszystkich wskazań” (podstawa: 539 wskazań) mówi tylko, jaki udział ma dane źródło we wszystkich zaznaczeniach, i w pracy zwykle się jej nie pokazuje. SPSS w procedurze Multiple Response wyświetla oba rodzaje odsetków – odsetki odpowiedzi i odsetki przypadków (IBM, b.d.) – więc sprawdź, który przepisujesz. Respondenci wskazywali średnio 2.69 źródła (mediana 3), a 5 osób nie wskazało żadnego.
Nie licz testu chi-kwadrat na tabeli wskazań, bo ta sama osoba występuje w niej kilka razy, a test wymaga niezależnych obserwacji. Jeśli porównujesz źródła wiedzy w grupach, zrób osobną tabelę krzyżową dla każdej opcji i skoryguj wyniki na wielokrotne porównania. Pamiętaj też, że związek źródła z wynikiem testu („osoby korzystające z internetu wiedzą mniej”) nie oznacza, że to źródło wpływa na wiedzę.
Jak opisać wyniki ankiety wiedzy w pracy (APA)
Najpierw opisz wynik ciągły i rzetelność, potem poziomy, a na końcu porównania i związki. Ogólne zasady zapisu statystyk znajdziesz w poradniku jak opisać wyniki w stylu APA, a cały przykładowy rozdział – we wpisie wyniki badań własnych – przykład. Poniżej gotowe fragmenty dla przykładu z tego poradnika.
Wyniki w grupach zbierz w jednej tabeli. Wzór poniżej – inne układy tabel znajdziesz we wpisie tabele APA – wzory i przykłady.
Tabela 1
Wynik testu wiedzy w grupach wykształcenia i w zależności od udziału w zajęciach edukacyjnych
| Grupa | n | M | SD | Mdn | IQR | Wysoki poziom wiedzy |
|---|---|---|---|---|---|---|
| Cała próba | 200 | 9.80 | 2.98 | 10 | 8–12 | 34.5% |
| Wykształcenie | ||||||
| podstawowe lub zawodowe | 65 | 8.68 | 3.38 | 9 | 6–11 | 24.6% |
| średnie | 82 | 9.90 | 2.66 | 10 | 8.25–12 | 29.3% |
| wyższe | 53 | 11.00 | 2.40 | 12 | 10–13 | 54.7% |
| Zajęcia edukacyjne w poradni | ||||||
| tak | 99 | 10.37 | 2.90 | 11 | 9–12 | — |
| nie | 101 | 9.23 | 2.96 | 9 | 7–11 | — |
Uwaga. Wynik testu: 0–15 punktów. IQR – rozstęp od pierwszego do trzeciego kwartyla. Wysoki poziom wiedzy – co najmniej 80% poprawnych odpowiedzi (12 punktów). Wykształcenie: H(2) = 16.81, p < .001; zajęcia edukacyjne: U = 3751.5, z = −3.07, p = .002. Dane symulowane.
Jeśli chcesz, żeby ktoś sprawdził punktację, rzetelność i dobór testów, zanim oddasz rozdział promotorowi, zobacz ofertę analiz statystycznych dla studentów – opracowujemy ankiety zdrowotne i badania wiedzy, a wyniki omawiamy tak, abyś umiał(a) samodzielnie je wyjaśnić. Pomoc w analizie ujawnij zgodnie z zasadami swojej uczelni.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Pobierz plik ankieta-wiedzy-dane-przyklad.xlsx, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2–4 korzystają z obiektów dane, pkt, klucz i pozycje z przepisu 1. Bootstrap w przepisie 3 trwa kilka sekund.
1. Wczytanie danych, punktacja i poziomy wiedzy
R
library(readxl)   # read_excel()

dane  <- read_excel("ankieta-wiedzy-dane-przyklad.xlsx", sheet = "Dane")
klucz <- read_excel("ankieta-wiedzy-dane-przyklad.xlsx", sheet = "Klucz")
pozycje <- paste0("P", 1:15)

# Reguła ustalona przed analizą: wyklucz osoby, które pominęły więcej niż połowę pytań testu
braki <- rowSums(is.na(dane[, pozycje]))
table(braki)
dane <- dane[braki <= 7, ]
nrow(dane)

# Punktacja: 1 pkt za odpowiedź zgodną z kluczem; błędna, „nie wiem” i brak odpowiedzi = 0 pkt
pkt <- sapply(pozycje, function(p) {
  poprawna <- klucz$poprawna[klucz$pozycja == p]
  as.integer(!is.na(dane[[p]]) & dane[[p]] == poprawna)
})
dane$wynik   <- rowSums(pkt)               # wynik surowy 0–15
dane$procent <- 100 * dane$wynik / 15      # odsetek poprawnych odpowiedzi
c(braki = sum(is.na(dane[, pozycje])),       # pojedyncze pominięte pytania (policzone jako 0 pkt)
  proc = round(100 * mean(is.na(dane[, pozycje])), 1))

# Wynik ciągły: statystyki opisowe i rozkład
round(c(M = mean(dane$wynik), SD = sd(dane$wynik), Mdn = median(dane$wynik),
        Q1 = unname(quantile(dane$wynik, .25)), Q3 = unname(quantile(dane$wynik, .75)),
        min = min(dane$wynik), max = max(dane$wynik), M_proc = mean(dane$procent)), 2)
table(dane$wynik)

# Poziomy wiedzy (progi umowne): < 60% niski, 60–79% średni, ≥ 80% wysoki
dane$poziom <- cut(dane$procent, breaks = c(-Inf, 60, 80, Inf), right = FALSE,
                   labels = c("niski", "średni", "wysoki"))
cbind(n = table(dane$poziom), proc = round(100 * prop.table(table(dane$poziom)), 1))

# Jak odsetek „wysokiej wiedzy” zależy od wybranego progu?
progi <- c(70, 75, 80, 85, 90)
data.frame(prog_proc = progi, min_pkt = ceiling(15 * progi / 100),
           wysoki_proc = sapply(progi, function(p) round(100 * mean(dane$procent >= p), 1)))
Wynik w R
braki
  0   1   2   9  10  11
163  33   4   1   1   1
[1] 200
braki  proc
 41.0   1.4
     M     SD    Mdn     Q1     Q3    min    max M_proc
  9.80   2.98  10.00   8.00  12.00   1.00  15.00  65.30

 1  2  3  4  5  6  7  8  9 10 11 12 13 14 15
 1  2  3  8  4 11 14 17 23 28 20 31 23 10  5
        n proc
niski  60 30.0
średni 71 35.5
wysoki 69 34.5
  prog_proc min_pkt wysoki_proc
1        70      11        44.5
2        75      12        34.5
3        80      12        34.5
4        85      13        19.0
5        90      14         7.5
2. KR-20 i analiza pozycji
R
library(psych)   # alpha()

# KR-20 ze wzoru: k/(k − 1) × (1 − Σ p·q / wariancja wyniku)
k <- ncol(pkt)
p <- colMeans(pkt)                                   # łatwość pozycji (odsetek poprawnych)
var_wyniku <- mean((dane$wynik - mean(dane$wynik))^2)
kr20 <- k / (k - 1) * (1 - sum(p * (1 - p)) / var_wyniku)
round(kr20, 3)

# To samo jako alfa Cronbacha dla pozycji 0/1 (pakiet psych) z 95% CI Feldta
a <- alpha(as.data.frame(pkt), warnings = FALSE)
round(c(alfa = a$total$raw_alpha, CI_dolna = a$feldt$lower.ci$raw_alpha, CI_gorna = a$feldt$upper.ci$raw_alpha), 3)

# Analiza pozycji: % odpowiedzi, łatwość i moc różnicująca (korelacja z resztą testu)
odsetek <- function(war) round(100 * sapply(pozycje, function(x) mean(war(dane[[x]], x))), 1)
klucz_p <- setNames(klucz$poprawna, klucz$pozycja)
tabela <- data.frame(
  poprawne   = odsetek(function(v, x) !is.na(v) & v == klucz_p[[x]]),
  bledne     = odsetek(function(v, x) !is.na(v) & v != klucz_p[[x]] & v != "nie wiem"),
  nie_wiem   = odsetek(function(v, x) !is.na(v) & v == "nie wiem"),
  brak       = odsetek(function(v, x) is.na(v)),
  r_reszta   = round(a$item.stats$r.drop, 2),        # korelacja pozycji z sumą pozostałych 14 pozycji
  alfa_bez   = round(a$alpha.drop$raw_alpha, 3)      # KR-20 po usunięciu pozycji
)
tabela[order(-tabela$poprawne), ]
Wynik w R
[1] 0.741
    alfa CI_dolna CI_gorna
   0.741    0.685    0.791
    poprawne bledne nie_wiem brak r_reszta alfa_bez
P1      98.5    0.0      0.0  1.5     0.16    0.742
P4      89.5    3.0      6.5  1.0     0.41    0.724
P8      89.5    4.5      5.5  0.5     0.41    0.724
P2      84.5    6.5      8.5  0.5     0.43    0.720
P6      78.0    7.5     13.0  1.5     0.40    0.722
P3      75.0    5.5     17.5  2.0     0.41    0.720
P10     70.0    9.5     20.0  0.5     0.47    0.714
P15     69.0   10.5     18.5  2.0     0.37    0.725
P7      65.0    8.5     26.0  0.5     0.10    0.754
P12     57.5   13.0     28.0  1.5     0.35    0.727
P5      53.5   13.0     31.0  2.5     0.47    0.713
P9      48.5   19.0     31.5  1.0     0.40    0.721
P13     47.5   15.0     35.5  2.0     0.41    0.720
P11     33.0   24.0     41.5  1.5     0.20    0.743
P14     20.5   28.5     49.0  2.0     0.21    0.740
3. Mann–Whitney, Kruskal–Wallis z testem Dunna, chi-kwadrat i Spearman
R
library(coin)      # coin::wilcox_test(): test Manna–Whitneya z wartością z
library(rstatix)   # dunn_test(): porównania parami po teście Kruskala–Wallisa
library(boot)      # boot(), boot.ci(): bootstrapowy przedział dla rho Spearmana

opis <- function(x) round(c(n = length(x), Mdn = median(x), Q1 = unname(quantile(x, .25)),
                            Q3 = unname(quantile(x, .75)), M = mean(x), SD = sd(x)), 2)

# 1. Mann–Whitney: udział w zajęciach edukacyjnych (tak/nie)
dane$edukacja <- factor(dane$edukacja, levels = c("nie", "tak"))
t(sapply(split(dane$wynik, dane$edukacja), opis))
mw <- coin::wilcox_test(wynik ~ edukacja, data = dane)      # przybliżenie asymptotyczne, rangi wiązane
U  <- wilcox.test(wynik ~ edukacja, data = dane, exact = FALSE)$statistic   # U dla grupy „nie”
n1 <- sum(dane$edukacja == "nie"); n2 <- sum(dane$edukacja == "tak")
round(c(U = unname(U), z = coin::statistic(mw), p = coin::pvalue(mw), r_rb = unname(1 - 2 * U / (n1 * n2)),
        proc_par_tak = unname(100 * (1 - U / (n1 * n2)))), 3)   # % par, w których wyższy wynik ma osoba po zajęciach

# 2. Kruskal–Wallis: wykształcenie (3 grupy) + test Dunna z korektą Holma
dane$wyksztalcenie <- factor(dane$wyksztalcenie, levels = c("podstawowe lub zawodowe", "średnie", "wyższe"))
t(sapply(split(dane$wynik, dane$wyksztalcenie), opis))
kw <- kruskal.test(wynik ~ wyksztalcenie, data = dane)
H <- unname(kw$statistic)
round(c(H = H, df = unname(kw$parameter), p = kw$p.value, eta2_H = (H - 3 + 1) / (nrow(dane) - 3)), 4)
dunn <- dunn_test(dane, wynik ~ wyksztalcenie, p.adjust.method = "holm")
data.frame(dunn[, c("group1", "group2")], z = round(dunn$statistic, 2), p = round(dunn$p, 4), p_Holm = round(dunn$p.adj, 4))

# 3. Chi-kwadrat: poziom wiedzy × wykształcenie
tab <- table(dane$wyksztalcenie, dane$poziom)
tab
round(100 * prop.table(tab, 1), 1)                          # odsetki w wierszach (w grupach wykształcenia)
chi <- chisq.test(tab)
round(chi$expected, 1)                                      # liczebności oczekiwane (wszystkie ≥ 5?)
V <- sqrt(unname(chi$statistic) / (sum(tab) * (min(dim(tab)) - 1)))
round(c(chi2 = unname(chi$statistic), df = unname(chi$parameter), p = chi$p.value, V_Cramera = V), 4)

# 4. Spearman: wynik a wiek i staż choroby (95% CI z bootstrapu percentylowego, 2000 prób)
rho_ci <- function(x, y) {
  test <- cor.test(x, y, method = "spearman", exact = FALSE)
  b <- boot(data.frame(x, y), function(d, i) cor(d$x[i], d$y[i], method = "spearman"), R = 2000)
  ci <- boot.ci(b, type = "perc")$percent[4:5]
  round(c(rho = unname(test$estimate), CI_dolna = ci[1], CI_gorna = ci[2], p = test$p.value), 3)
}
set.seed(2026)
rbind(wiek = rho_ci(dane$wynik, dane$wiek), staz_choroby = rho_ci(dane$wynik, dane$staz_choroby))
Wynik w R
      n Mdn Q1 Q3     M   SD
nie 101   9  7 11  9.23 2.96
tak  99  11  9 12 10.37 2.90
           U            z            p         r_rb proc_par_tak
    3751.500       -3.068        0.002        0.250       62.481
                         n Mdn    Q1 Q3     M   SD
podstawowe lub zawodowe 65   9  6.00 11  8.68 3.38
średnie                 82  10  8.25 12  9.90 2.66
wyższe                  53  12 10.00 13 11.00 2.40
      H      df       p  eta2_H
16.8107  2.0000  0.0002  0.0752
                   group1  group2    z      p p_Holm
1 podstawowe lub zawodowe średnie 1.90 0.0573 0.0573
2 podstawowe lub zawodowe  wyższe 4.10 0.0000 0.0001
3                 średnie  wyższe 2.51 0.0121 0.0241

                          niski średni wysoki
  podstawowe lub zawodowe    30     19     16
  średnie                    21     37     24
  wyższe                      9     15     29

                          niski średni wysoki
  podstawowe lub zawodowe  46.2   29.2   24.6
  średnie                  25.6   45.1   29.3
  wyższe                   17.0   28.3   54.7

                          niski średni wysoki
  podstawowe lub zawodowe  19.5   23.1   22.4
  średnie                  24.6   29.1   28.3
  wyższe                   15.9   18.8   18.3
     chi2        df         p V_Cramera
  21.5771    4.0000    0.0002    0.2323
                rho CI_dolna CI_gorna     p
wiek         -0.035   -0.173    0.106 0.626
staz_choroby  0.160    0.030    0.293 0.023
4. Źródła wiedzy – pytanie wielokrotnego wyboru
R
# Pytanie wielokrotnego wyboru: każda opcja to osobna kolumna 0/1
zrodla <- dane[, grep("^Z_", names(dane))]
wskazania <- colSums(zrodla)
data.frame(n = wskazania,
           proc_osob      = round(100 * wskazania / nrow(dane), 1),     # % respondentów (suma > 100%)
           proc_odpowiedzi = round(100 * wskazania / sum(wskazania), 1)  # % wszystkich wskazań (suma = 100%)
)[order(-wskazania), ]

# Ile źródeł wskazała jedna osoba?
liczba <- rowSums(zrodla)
round(c(M = mean(liczba), Mdn = median(liczba), brak_wskazan = sum(liczba == 0), wszystkich_wskazan = sum(liczba)), 2)
table(liczba)
Wynik w R
                 n proc_osob proc_odpowiedzi
Z_lekarz       142      71.0            26.3
Z_internet     131      65.5            24.3
Z_pielegniarka  79      39.5            14.7
Z_rodzina       50      25.0             9.3
Z_media_spol    49      24.5             9.1
Z_broszury      49      24.5             9.1
Z_tv_radio      27      13.5             5.0
Z_inne          12       6.0             2.2
                 M                Mdn       brak_wskazan wszystkich_wskazan
              2.69               3.00               5.00             539.00
liczba
 0  1  2  3  4  5  6
 5 32 48 66 36  9  4
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Ankieta wiedzy w SPSS – najważniejsze kroki
Te same analizy wykonasz w SPSS. Nazwy menu podajemy w angielskiej wersji programu, według dokumentacji IBM SPSS Statistics 30 (IBM, b.d.):
- Punktacja. Każdą pozycję przekoduj na 0/1 poleceniem RECODE ze słowem INTO, aby surowe odpowiedzi zostały w bazie, a następnie zsumuj punkty w nowej zmiennej. Zanim to zrobisz, wyklucz osoby według ustalonej reguły braków.
- KR-20 i analiza pozycji: Analyze → Scale → Reliability Analysis, model Alpha, wszystkie pozycje 0/1. Uzyskana alfa to KR-20. W oknie Statistics zaznacz Scale if item deleted – dostaniesz korelację każdej pozycji z resztą testu i alfę po jej usunięciu.
- Test Manna–Whitneya: Analyze → Nonparametric Tests → Legacy Dialogs → 2 Independent Samples, test Mann-Whitney U.
- Test Kruskala–Wallisa: Analyze → Nonparametric Tests → Legacy Dialogs → K Independent Samples, test Kruskal-Wallis H. Porównania parami najprościej policzysz w R (przepis 3); jeśli robisz je w SPSS, sprawdź w wydruku, jaką korektę zastosował program, i podaj ją w pracy.
- Chi-kwadrat: Analyze → Descriptive Statistics → Crosstabs, w oknie Statistics zaznacz Chi-square oraz Phi and Cramer's V.
- Korelacja Spearmana: Analyze → Correlate → Bivariate, zaznacz Spearman.
- Źródła wiedzy: Analyze → Multiple Response → Define Variable Sets (opcja Dichotomies, wartość liczona 1), a potem Analyze → Multiple Response → Frequencies. W pracy przepisz odsetki przypadków (respondentów).
Jak czytać poszczególne tabele wydruku, wyjaśniamy w poradniku jak czytać wyniki z SPSS.
Najczęstsze błędy w analizie ankiety wiedzy
- Średnia z poziomów wiedzy. Jeśli zakodujesz poziomy jako 1, 2 i 3 i podasz ich średnią, otrzymasz liczbę bez sensownej interpretacji: kategorie mają umowne granice i różną szerokość (tu 9, 3 i 4 możliwe wyniki). Podaj rozkład poziomów (n, %) i opisz wynik ciągły.
- Progi dobrane po zobaczeniu wyników. Przesuwanie granic tak, by grupy były równe albo różnice istotne, to odmiana p-hackingu. Progi zapisz w planie analizy.
- „Nie wiem” jako brak danych. Z analizy wypadają wtedy osoby o najmniejszej wiedzy, a wynik grupy jest zawyżony.
- Autorska ankieta bez rzetelności i pilotażu. Bez KR-20, analizy pozycji i wstępnego sprawdzenia pytań nie wiesz, czy test mierzy cokolwiek spójnego. Perneger i in. (2015) obliczyli, że pretest na 10 osobach ma tylko 40% szans na wykrycie problemu, który dotyczy 5% respondentów, i zalecają domyślnie 30 osób. Jak zaplanować pilotaż, opisujemy w poradniku badanie pilotażowe – po co, ile osób, co sprawdzić; warto połączyć go z wywiadem poznawczym.
- Wnioski przyczynowe z badania przekrojowego. „Zajęcia edukacyjne zwiększają wiedzę” to wniosek, którego ten schemat nie uzasadnia. Do oceny skuteczności edukacji potrzebujesz pomiaru przed i po, najlepiej z grupą porównawczą; analizę takiego schematu pokazujemy w poradniku statystyka dla fizjoterapeuty – te same zasady dotyczą testu wiedzy przed szkoleniem i po nim.
- Jeden współczynnik dla testu z kilku obszarów. KR-20 nie dowodzi jednowymiarowości; przy wyraźnych częściach testu podaj rzetelność każdej z nich.
- Testy chi-kwadrat dla każdego pytania bez korekty. 15 pozycji × 3 zmienne grupujące to 45 testów. Nawet gdyby w populacji nie było żadnych różnic, przy α = .05 możesz oczekiwać około dwóch „istotnych” wyników przypadkiem. Skup się na wyniku testu albo skoryguj p metodą Holma.
- Odsetki bez liczebności i z niewłaściwą podstawą. Zawsze podawaj n i podstawę procentowania, a w pytaniach wielokrotnego wyboru – odsetek respondentów, nie wskazań.
- „Mediany różniły się istotnie” po teście Manna–Whitneya. Test porównuje rozkłady, a nie mediany (Divine i in., 2018).
Przed oddaniem rozdziału sprawdź jeszcze, czy w aneksie jest pełna treść autorskiego testu z kluczem i źródłami poprawnych odpowiedzi, a liczba osób w każdej tabeli zgadza się z opisem wykluczeń. O pytania o rzetelność i dobór testów warto przygotować się przed obroną – pomoże w tym wpis pytania na obronie z metodologii i statystyki.
Najczęstsze pytania
Jak policzyć poziom wiedzy w ankiecie?
Za każdą odpowiedź zgodną z kluczem przyznaj 1 punkt, a za błędną, „nie wiem” i brak odpowiedzi – 0. Suma punktów to wynik testu; podaj go też jako odsetek poprawnych odpowiedzi i opisz średnią, odchylenie standardowe, medianę i kwartyle. Poziomy wiedzy (np. poniżej 60%, 60–79% i co najmniej 80% poprawnych odpowiedzi) to umowa – ustal je przed analizą, a testy statystyczne wykonuj na wyniku ciągłym.
Czy KR-20 to to samo co alfa Cronbacha?
Dla pozycji punktowanych 0/1 tak: Cronbach (1951) pokazał, że KR-20 jest szczególnym przypadkiem alfy, a SPSS podaje alfę dla danych dychotomicznych jako odpowiednik KR-20. Oba współczynniki zakładają, że pytania mierzą jedną wspólną wiedzę, i nie dowodzą jednowymiarowości. Jeśli test ma kilka wyraźnych części, podaj KR-20 dla każdej z nich.
Jak punktować odpowiedź „nie wiem” w teście wiedzy?
Jako 0 punktów, tak samo jak odpowiedź błędną – ale nie jako brak danych, bo wtedy z analizy wypadałyby osoby o najmniejszej wiedzy. W opisie wyników warto pokazać odsetki odpowiedzi „nie wiem” i błędnych osobno: pierwsze wskazują na lukę w wiedzy, drugie mogą oznaczać błędne przekonanie albo niejasne pytanie.
Jakim testem porównać poziom wiedzy w grupach?
Wynik testu w dwóch grupach porównaj testem Manna–Whitneya, a w trzech i więcej – testem Kruskala–Wallisa z porównaniami parami testem Dunna i korektą Holma. Związek z wiekiem czy stażem opisz korelacją Spearmana. Test chi-kwadrat dla poziomów wiedzy traktuj jako uzupełnienie, bo pomija informację o różnicach wewnątrz poziomów.
Jak przedstawić wyniki pytania wielokrotnego wyboru w pracy?
Każdą opcję zakoduj jako osobną zmienną 0/1 i podaj, jaki odsetek respondentów ją zaznaczył – podstawą jest liczba osób, więc suma przekracza 100%, co wyjaśnij w nocie pod tabelą. Odsetek wszystkich wskazań odpowiada na inne pytanie i zwykle się go nie pokazuje. Nie licz testu chi-kwadrat na tabeli wskazań, bo ta sama osoba występuje w niej kilka razy.
Co zrobić, gdy KR-20 testu wiedzy jest niskie?
Najpierw sprawdź analizę pozycji: pytania o korelacji z resztą testu bliskiej zera lub ujemnej mogą być niejasne albo mieć błąd w kluczu, a pytania, na które prawie wszyscy odpowiadają poprawnie, niczego nie różnicują. Sprawdź też, czy test nie łączy kilku odrębnych obszarów. Nie usuwaj pytań mechanicznie dla podniesienia współczynnika – decyzję uzasadnij merytorycznie i opisz w pracy.
Powiązane hasła
Przeczytaj też
Badanie pilotażowe: po co, ile osób, co sprawdzić
Pilotaż a pretest, ile osób zbadać, co sprawdzić w danych i dlaczego nie liczyć mocy z efektu z pilotażu. Z symulacją, kodem R i wzorem opisu.
Czytaj →PoradnikAlfa Cronbacha: jak oceniać rzetelność skali bez uproszczeń
Alfa Cronbacha krok po kroku: wzór, założenia, interpretacja, ograniczenia i sytuacje, w których lepiej raportować współczynnik omega.
Czytaj →PoradnikWyniki badań własnych – przykładowy rozdział
Cały rozdział wyników jednego badania – od przygotowania danych po tabelę hipotez – z komentarzem, tabelami APA, rysunkami i wzorem w Wordzie.
Czytaj →Analizujesz ankietę wiedzy pacjentów?
Sprawdzimy punktację, rzetelność i dobór testów oraz wyjaśnimy wyniki tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/bf02310555 ● Otwarty dostęp
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- IBM. (b.d.). IBM SPSS Statistics 30.0.0 documentation. Pobrano 16 października 2026 z https://www.ibm.com/docs/en/spss-statistics/30.0.0 ● Otwarty dostęp
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/bf02288391
- Luskin, R. C., & Bullock, J. G. (2011). “Don't know” means “don't know”: DK responses and the public's level of political knowledge. The Journal of Politics, 73(2), 547–557. https://doi.org/10.1017/s0022381611000132
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989x.7.1.19 ● Otwarty dostęp: pełny tekst
- McNeish, D., & Wolf, M. G. (2020). Thinking twice about sum scores. Behavior Research Methods, 52(6), 2287–2305. https://doi.org/10.3758/s13428-020-01398-0 ● Otwarty dostęp
- Perneger, T. V., Courvoisier, D. S., Hudelson, P. M., & Gayet-Ageron, A. (2015). Sample size for pre-tests of questionnaires. Quality of Life Research, 24(1), 147–151. https://doi.org/10.1007/s11136-014-0752-2 ● Otwarty dostęp: pełny tekst
- Sijtsma, K. (2009). On the use, the misuse, and the very limited usefulness of Cronbach's alpha. Psychometrika, 74(1), 107–120. https://doi.org/10.1007/s11336-008-9101-0 ● Otwarty dostęp
- Tavakol, M., & Dennick, R. (2011). Making sense of Cronbach's alpha. International Journal of Medical Education, 2, 53–55. https://doi.org/10.5116/ijme.4dfb.8dfd ● Otwarty dostęp
Cytowania BibTeX
@article{cronbach1951coefficient, author={Cronbach, Lee J.}, title={{Coefficient alpha and the internal structure of tests}}, journal={Psychometrika}, year={1951}, volume={16}, number={3}, pages={297--334}, doi={10.1007/bf02310555}}@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@misc{ibmndspssdokumentacja, author={{IBM}}, title={{IBM SPSS Statistics 30.0.0 documentation}}, url={https://www.ibm.com/docs/en/spss-statistics/30.0.0}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{kuder1937theory, author={Kuder, G. F. and Richardson, M. W.}, title={{The theory of the estimation of test reliability}}, journal={Psychometrika}, year={1937}, volume={2}, number={3}, pages={151--160}, doi={10.1007/bf02288391}}@article{luskin2011dont, author={Luskin, Robert C. and Bullock, John G.}, title={{“Don't know” means “don't know”: DK responses and the public's level of political knowledge}}, journal={The Journal of Politics}, year={2011}, volume={73}, number={2}, pages={547--557}, doi={10.1017/s0022381611000132}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{mcneish2020thinking, author={McNeish, Daniel and Wolf, Melissa Gordon}, title={{Thinking twice about sum scores}}, journal={Behavior Research Methods}, year={2020}, volume={52}, number={6}, pages={2287--2305}, doi={10.3758/s13428-020-01398-0}}@article{perneger2015sample, author={Perneger, Thomas V. and Courvoisier, Delphine S. and Hudelson, Patricia M. and Gayet-Ageron, Angèle}, title={{Sample size for pre-tests of questionnaires}}, journal={Quality of Life Research}, year={2015}, volume={24}, number={1}, pages={147--151}, doi={10.1007/s11136-014-0752-2}}@article{sijtsma2009use, author={Sijtsma, Klaas}, title={{On the use, the misuse, and the very limited usefulness of Cronbach's alpha}}, journal={Psychometrika}, year={2009}, volume={74}, number={1}, pages={107--120}, doi={10.1007/s11336-008-9101-0}}@article{tavakol2011making, author={Tavakol, Mohsen and Dennick, Reg}, title={{Making sense of Cronbach's alpha}}, journal={International Journal of Medical Education}, year={2011}, volume={2}, pages={53--55}, doi={10.5116/ijme.4dfb.8dfd}}