Dlaczego 60% to nie jest próg dobrej wiedzy
W pracach z pielęgniarstwa, położnictwa i zdrowia publicznego wynik testu wiedzy często zamienia się na „wiedzę dobrą” i „niewystarczającą”. Najczęściej granicą jest 60% poprawnych odpowiedzi, czasem 50%, 70% albo 80%. Taki próg ma jedną wadę: nie mówi nic o pytaniach. 60% w teście z łatwymi pytaniami o podstawy to coś innego niż 60% w teście ze szczegółowymi pytaniami o procedury. W poradniku o ankiecie wiedzy (krok 3) pokazujemy, jak bardzo odsetek osób z „wysoką wiedzą” zależy od wybranej granicy. Tu pokazujemy, skąd wziąć granicę, którą da się uzasadnić.
Próg wiedzy wystarczającej to decyzja, a nie właściwość danych. Norcini (2003) definiuje standard jako wynik, który oddziela osoby radzące sobie wystarczająco dobrze od pozostałych, i podkreśla, że wyraża on wartości zawodowe w kontekście celu i treści testu. Skoro to decyzja, trzeba ją podjąć w sposób systematyczny: z udziałem ekspertów, przed poznaniem wyników badania, z opisem procedury i z oceną jej niepewności. To właśnie robi metoda Angoffa. Jej definicję i krótki przykład znajdziesz w haśle metoda Angoffa. Ten wpis prowadzi przez całą procedurę w pracy dyplomowej: od doboru sędziów po zdanie w rozdziale wyników.
Normy testowe to co innego: mówią, jak wynik wypada na tle grupy odniesienia, a nie czy osoba wie wystarczająco dużo. Punkt odcięcia z krzywej ROC wymaga kryterium zewnętrznego, np. diagnozy, i wybiera wynik najlepiej rozróżniający grupy – jak to zrobić, opisuje wpis krzywa ROC i punkt odcięcia krok po kroku. Metoda Angoffa nie potrzebuje kryterium zewnętrznego: próg wynika z oceny treści pytań przez ekspertów.
Ten wpis należy do serii o testach wiedzy. Jak zaplanować cały test, opisuje wpis główny jak zbudować test wiedzy. Próg ustalasz na końcu budowy narzędzia, gdy pytania są już ostateczne.
Trzy rodziny metod ustalania progu
Metod jest wiele i nie ma jednej zalecanej dla każdego testu (Ben-David, 2000). Cizek i Bunch (2007) poświęcają osobne rozdziały m.in. metodzie Angoffa i jej odmianom, metodom Nedelsky’ego i Ebela, grupom kontrastowym i grupie granicznej oraz metodom kompromisowym Hofstee i Beuka. W pracy dyplomowej wystarczy znać trzy podejścia.
| Podejście | Co oceniają eksperci | Czego potrzebujesz | Kiedy w pracy dyplomowej |
|---|---|---|---|
| Oceny pytań (Angoff) | Każde pytanie: jak często odpowie na nie osoba z wiedzą ledwie wystarczającą | 6–10 sędziów, opis osoby granicznej, formularz | Najczęściej – da się zrobić przed zebraniem danych |
| Oceny osób (grupy kontrastowe, grupa graniczna) | Konkretne osoby: czy ich wiedza jest wystarczająca, niewystarczająca albo na granicy | Oceny osób niezależne od testu, np. od przełożonych lub opiekunów praktyk | Gdy ktoś zna badanych na tyle, by ocenić ich wiedzę |
| Kompromis (Hofstee) | Akceptowalny zakres progu i akceptowalny odsetek osób poniżej progu | Panel i rozkład wyników | Rzadko; raczej w egzaminach niż w badaniach |
Dalej pokazujemy krok po kroku zmodyfikowaną metodę Angoffa, a na końcu – krótko – grupy kontrastowe na tych samych danych.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa zbudowała test wiedzy o profilaktyce odleżyn: 20 pytań jednokrotnego wyboru, 1 punkt za poprawną odpowiedź. Pytania przeszły ocenę trafności treściowej i pilotaż na 30 osobach. W badaniu właściwym test wypełni 150 pielęgniarek z oddziałów zachowawczych. Promotorka pyta: „Jaki odsetek pielęgniarek ma wystarczającą wiedzę?”. Zamiast przyjąć 60%, studentka ustala próg z panelem ośmiu sędziów.
Krok 1. Panel sędziów: kogo i ilu zaprosić
Sędziowie muszą znać dwie rzeczy: treść testu i ludzi, których test dotyczy. W przykładzie to nauczyciele akademiccy pielęgniarstwa, pielęgniarki oddziałowe i pielęgniarki z doświadczeniem w opiece nad pacjentami zagrożonymi odleżynami. Norcini (2003) podkreśla, że wiarygodność progu zależy w dużej mierze od tego, kim są sędziowie, dlatego panel powinien być kompetentny i możliwie zróżnicowany. Jeśli w pracy była ocena ekspertów (trafność treściowa, CVI i CVR), możesz zaprosić część tych samych osób, ale ocena progu to osobne zadanie z osobną instrukcją.
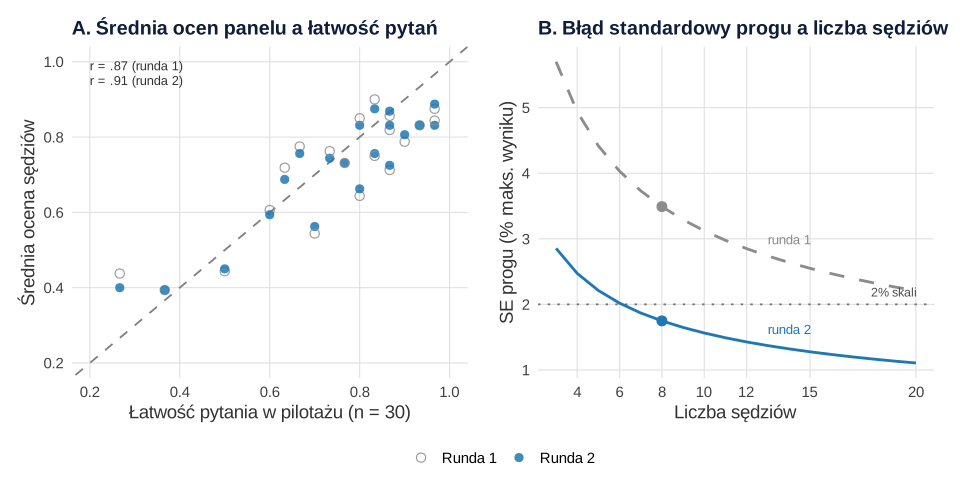
Ilu sędziów? Im więcej, tym mniejszy błąd progu. Fowell i in. (2008) w ocenach pisemnych na studiach medycznych policzyli, że do uzyskania błędu progu poniżej 2% skali potrzeba co najmniej 10 sędziów bez dyskusji albo 6 po dyskusji (błąd mierzyli jako RMSE w procentach wyniku). W pracy dyplomowej realne jest zwykle 6–10 osób. Ważniejsze od liczby jest to, żeby po zebraniu ocen policzyć błąd standardowy progu i go podać (krok 6).
Krok 2. Opis osoby z wiedzą ledwie wystarczającą
Sercem metody jest wyobrażona osoba graniczna (ang. minimally competent, borderline): ktoś, kto wie dokładnie tyle, ile trzeba, żeby uznać jego wiedzę za wystarczającą – ani trochę więcej. Zanim sędziowie zobaczą pytania, panel wspólnie spisuje, co taka osoba wie i umie, a czego nie. Hurtz i Auerbach (2003) w metaanalizie badań nad metodą Angoffa pokazali, że wspólna definicja osoby granicznej zwiększa zgodność sędziów.
W teście dla pacjentów osobą graniczną jest np. pacjent, którego wiedza ledwie wystarcza do bezpiecznej samoopieki w domu. Nie definiuj osoby granicznej procentem („zna 60% materiału”) – wtedy wracasz do progu umownego.
Krok 3. Szkolenie sędziów i pierwsza runda ocen
Panel ocenia ostateczną wersję pytań – po poprawkach treści i dystraktorów (zob. jak pisać pytania testowe i dystraktory). Każdy sędzia dostaje formularz: listę pytań z kluczem odpowiedzi i kolumnę na ocenę. Najpierw ćwiczy na 2–3 pytaniach spoza testu, potem samodzielnie ocenia wszystkie pytania. W zmodyfikowanej metodzie Angoffa ocena to szacowany odsetek osób granicznych, które odpowiedzą poprawnie. Ułatwia ją wyobrażenie sobie stu takich osób.
Sposób punktowania musi być ten sam, który zastosujesz w badaniu. Jeśli „nie wiem” liczysz jako 0, a pytania z kilkoma poprawnymi odpowiedziami punktujesz częściowo, sędzia szacuje oczekiwaną liczbę punktów, a nie odsetek poprawnych odpowiedzi. Zasady punktowania opisuje wpis punktowanie testu wiedzy. Istnieje też prostsza odmiana metody: sędzia odpowiada tylko „tak” albo „nie” na pytanie, czy osoba graniczna odpowie poprawnie. Jest łatwiejsza dla sędziów, ale zaokrągla każdą ocenę do 0 albo 1.
Krok 4. Próg każdego sędziego i próg panelu
Ocenę zapisz jako ułamek (75 osób na 100 = 0.75). Suma ocen sędziego to jego próg – oczekiwany wynik osoby granicznej. Próg panelu to średnia progów sędziów.
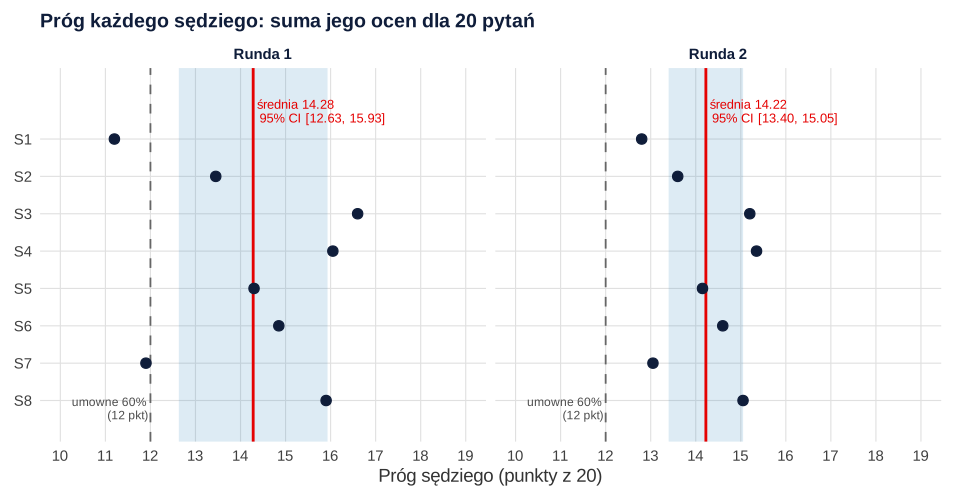
gdzie pij to ocena sędziego j dla pytania i, a J – liczba sędziów. W przykładzie progi ośmiu sędziów po pierwszej rundzie wahały się od 11.20 do 16.60 punktu. Średni próg wyniósł 14.28 punktu (71.41% maksymalnego wyniku), SD = 1.98, SE = 0.70, 95% CI [12.63, 15.93]. Przedział ma szerokość ponad 3 punktów, czyli ponad trzech pytań testu – za dużo, by na tej podstawie klasyfikować badanych. Dlatego robi się drugą rundę.
| Runda | S1 | S2 | S3 | S4 | S5 | S6 | S7 | S8 | Średnia (SD) |
|---|---|---|---|---|---|---|---|---|---|
| 1 | 11.20 | 13.45 | 16.60 | 16.05 | 14.30 | 14.85 | 11.90 | 15.90 | 14.28 (1.98) |
| 2 | 12.80 | 13.60 | 15.20 | 15.35 | 14.15 | 14.60 | 13.05 | 15.05 | 14.22 (0.99) |
Krok 5. Dyskusja i druga runda
Między rundami pokaż sędziom dwie rzeczy. Pierwsza to pytania, przy których oceny najbardziej się różnią. W przykładzie odchylenie standardowe ocen przekroczyło 0.15 przy ośmiu pytaniach (P03, P09, P11, P12, P14, P16, P19, P20). Sędziowie z najniższą i najwyższą oceną krótko uzasadniają swoje zdanie. Celem nie jest jednomyślność, tylko wspólne rozumienie pytania i osoby granicznej (o formalnym dochodzeniu do zgody pisze hasło konsensus ekspertów).
Druga to dane o trudności pytań z pilotażu, czyli łatwość pozycji – odsetek poprawnych odpowiedzi wszystkich osób, nie tylko granicznych. Pomaga to wyłapać pytania, których trudność panel źle ocenił. W przykładzie pytanie P11 sędziowie ocenili średnio na 0.71, a w pilotażu odpowiedziało na nie poprawnie 87% osób. Sędzia nie przepisuje jednak łatwości jako oceny: osoba graniczna wie mniej niż przeciętny uczestnik pilotażu. Hurtz i Auerbach (2003) zauważyli, że pokazanie sędziom danych normatywnych systematycznie obniża progi, a dyskusja zwykle je podnosi. Dlatego opisz w pracy, co sędziowie zobaczyli między rundami.
Po drugiej rundzie sprawdź trzy rzeczy. Pierwsza to rozrzut progów: w przykładzie SD spadło z 1.98 do 0.99 punktu, a 95% CI zwęził się do [13.40, 15.05]. Druga to zgodność ocen sędziów z łatwością pytań, czyli korelacja ocen z łatwością dla każdego sędziego. Brandon (2004) w przeglądzie badań stwierdził, że oceny sędziów zwykle porządkują pytania podobnie jak ich empiryczna trudność, ale zbyt często od niej odbiegają. W rundzie 1 korelacje wynosiły od .61 do .83, w rundzie 2 – od .82 do .90. Wzrost po obejrzeniu danych jest oczekiwany i nie dowodzi, że sędziowie oceniają lepiej. Korelacja bliska zera sugeruje, że sędzia źle zrozumiał zadanie – porozmawiaj z nim, zanim wykluczysz jego oceny. Trzecia to zgodność między sędziami: ICC dla ocen pytań w rundzie 2 wyniósł ICC(2,1) = .78 dla pojedynczego sędziego i ICC(2,k) = .97 dla średniej panelu. Jak wybrać model ICC, wyjaśnia wpis zgodność sędziów: kappa, ICC i alfa Krippendorffa.
Krok 6. Błąd standardowy progu i zaokrąglenie
Próg panelu to oszacowanie z małej „próby” sędziów, więc ma błąd standardowy i przedział ufności. Przy ośmiu sędziach licz przedział z rozkładu t z 7 stopniami swobody. Po drugiej rundzie próg wyniósł 14.22 punktu (71.12%), SE = 0.35, 95% CI [13.40, 15.05]. Błąd standardowy stanowi 1.75% maksymalnego wyniku. Rysunek 2B pokazuje, że przy rozrzucie z rundy 2 błąd jest bliski 2% skali już przy sześciu sędziach (2.02%), a przy rozrzucie z rundy 1 przekracza 2% nawet przy dwudziestu (2.21%). To ten sam kierunek, który opisali Fowell i in. (2008): dyskusja zmniejsza liczbę potrzebnych sędziów.
Zaokrąglenie. Wyniki testu są liczbami całkowitymi, a próg nie. Reguła „wiedza wystarczająca, gdy wynik jest nie niższy niż próg” oznacza przy progu 14.22 co najmniej 15 punktów. Nie zaokrąglaj do najbliższej całości (14), bo wtedy osoby z wynikiem poniżej progu panelu uznasz za spełniające standard. Regułę zapisz w planie analizy, zanim zobaczysz wyniki.
Błąd progu a błąd pomiaru. Niepewność ma dwa źródła: sędziów (SE progu) i sam test. Standardowy błąd pomiaru liczysz z rzetelności testu: przy KR-20 = .79 i SD = 3.86 wynosi 1.77 punktu. To pięć razy więcej niż SE progu. W badaniu właściwym 34 osoby (22.7%) miały wynik w odległości do jednego błędu pomiaru od progu – ich zaklasyfikowanie do „wiedzy wystarczającej” albo „niewystarczającej” jest niepewne. Dlatego nawet dobrze ustalony próg nie zastępuje analizy wyniku ciągłego.
Krok 7. Konsekwencje progu: ilu badanych ma wiedzę wystarczającą
Dopiero teraz próg przykładasz do danych z badania właściwego. W przykładzie 150 pielęgniarek uzyskało średnio 14.17 punktu (SD = 3.86). Co najmniej 15 punktów miało 80 osób, czyli 53.3%, 95% CI [45.4, 61.1]. Przedział dla odsetka liczysz metodą Wilsona (zob. przedział ufności dla proporcji).
| Próg | Minimalny wynik | Osoby z wiedzą wystarczającą | 95% CI |
|---|---|---|---|
| Umowne 60% | 12 pkt | 111 (74.0%) | [66.4, 80.4] |
| Dolna granica 95% CI progu (13.40) | 14 pkt | 91 (60.7%) | [52.7, 68.1] |
| Angoff (14.22) | 15 pkt | 80 (53.3%) | [45.4, 61.1] |
| Górna granica 95% CI progu (15.05) | 16 pkt | 70 (46.7%) | [38.9, 54.6] |
Umowne 60% dałoby wniosek „trzy czwarte pielęgniarek ma wystarczającą wiedzę”, a próg panelu – „mniej więcej połowa”. Test jest dość łatwy, więc 60% punktów to mniej, niż według ekspertów musi wiedzieć osoba graniczna. Niepewność progu przenosi się na wniosek: w granicach 95% CI progu odsetek waha się od 46.7% do 60.7%. Podaj ten zakres w pracy jako analizę wrażliwości. Norcini (2003) radzi też sprawdzić, czy odsetek osób powyżej progu ma sensowny związek z innymi wskaźnikami kompetencji – np. czy jest wyższy wśród osób po specjalistycznym szkoleniu.
Ten sam próg możesz zastosować do pomiaru przed szkoleniem i po nim, bo zależy od treści pytań, a nie od wyników. Jak porównać odsetki osób powyżej progu w dwóch pomiarach, opisuje wpis badanie wiedzy przed i po szkoleniu. Próg nie przenosi się natomiast na zmieniony test: po wymianie pytań potrzebny jest nowy panel albo zrównywanie wyników.
Metoda grup kontrastowych i grupy granicznej
W metodach opartych na ocenie osób eksperci nie oceniają pytań, tylko ludzi, których znają – np. przełożeni oceniają pielęgniarki, a opiekunowie praktyk studentów. Ocena musi powstać niezależnie od testu, najlepiej przed poznaniem wyników. W metodzie grup kontrastowych eksperci dzielą osoby na dwie grupy: wiedza wystarczająca i niewystarczająca. Próg to wynik, który najlepiej rozdziela te grupy – np. wynik, przy którym regresja logistyczna daje prawdopodobieństwo przynależności do grupy „wystarczającej” równe 0.5, albo wynik z najmniejszą liczbą błędnych klasyfikacji. W metodzie grupy granicznej eksperci wskazują osoby „na granicy”, a próg to mediana ich wyników.
W przykładzie przełożone oceniły 66 pielęgniarek jako mające wiedzę wystarczającą (M = 17.05, SD = 1.92) i 84 jako niewystarczającą (M = 11.92, SD = 3.49). Regresja logistyczna dała próg 15.36 punktu, najmniej błędnych klasyfikacji (28 ze 150 osób) dawał próg od 15 punktów, a mediana 17 osób wskazanych jako „na granicy” wyniosła 14.0 punktu. Wszystkie trzy wyniki są blisko progu Angoffa (14.22) i daleko od umownych 12 punktów.
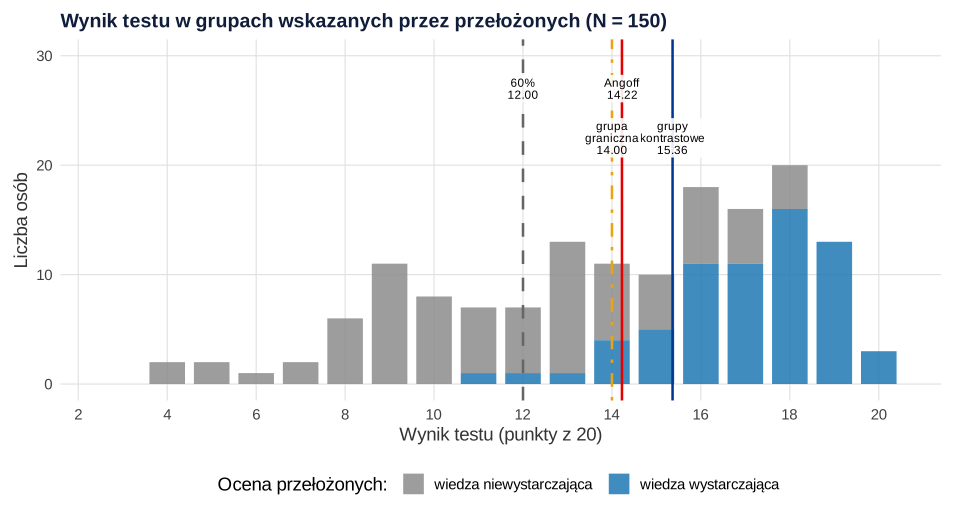
Te metody mają własne słabości: oceny przełożonych też są obarczone błędem, próg z regresji logistycznej zależy od proporcji osób w grupach, a mediana małej grupy granicznej (tu 17 osób) jest niepewna. Nie myl tej procedury z metodą grup znanych, która służy do oceny trafności testu, a nie do ustalania progu. W pracy dyplomowej grupy kontrastowe najlepiej sprawdzają się jako dodatkowe potwierdzenie progu Angoffa.
Jak opisać ustalenie progu w pracy
Opis procedury umieść w rozdziale metodologicznym, przy opisie narzędzia (zob. rozdział metodologiczny – jak go napisać). Podaj: kim byli sędziowie i ilu ich było, jak zdefiniowano osobę graniczną, skalę ocen, liczbę rund i to, co sędziowie zobaczyli między rundami, próg z SE i 95% CI oraz regułę zaokrąglenia. Opis osoby granicznej, instrukcję i formularz dołącz do aneksu.
W rozdziale wyników główne analizy (porównania grup, związki z wiekiem czy stażem) wykonaj na wyniku ciągłym, a odsetek osób powyżej progu podaj opisowo. Dzielenie wyniku na dwie kategorie zawsze kosztuje informację – zob. dychotomizacja zmiennych ciągłych.
Ograniczenia metody Angoffa
- Próg wyraża ocenę panelu. Inny panel albo inna procedura (dyskusja, pokazane dane) mogłyby dać inny próg. Dlatego podajesz SE, przedział ufności i skład panelu.
- Szacowanie prawdopodobieństw jest trudne. Sędziowie dobrze porządkują pytania według trudności, ale ich oceny bezwzględne bywają nietrafne (Brandon, 2004). Ricker (2006) w krytycznym przeglądzie omawia założenia metody i jej odmian oraz zalecenia dotyczące stosowania.
- Próg potrzebuje uzasadnienia trafności. Kane (1994) wskazuje dwa założenia: że próg odpowiada przyjętemu standardowi i że sam standard jest rozsądny wobec celu decyzji. Można je wspierać zgodnością procedury z celem, spójnością wyników i porównaniem z kryterium zewnętrznym – np. z grupami kontrastowymi.
Jak przekuć te punkty w akapit o ograniczeniach, pokazuje wpis ograniczenia badania – jak je opisać.
Najczęstsze błędy
- Próg 60% „bo tak się przyjmuje”. Bez źródła i bez związku z treścią pytań. Jeśli musisz użyć progu umownego, nazwij go umownym i pokaż, jak wynik zależy od jego wyboru.
- Próg ustalony po obejrzeniu wyników. Panel, który zna rozkład wyników badania właściwego, łatwo dopasuje próg do oczekiwanego wniosku. Między rundami pokazuj tylko dane z pilotażu.
- Sędziowie oceniają ważność pytania, a nie jego trudność dla osoby granicznej. To częsty skutek zbyt krótkiej instrukcji. Zrób rundę ćwiczebną.
- Osoba graniczna opisana jako „dobra pielęgniarka”. Wtedy sędziowie oceniają, co wie przeciętna albo wzorowa osoba, i próg wychodzi za wysoko.
- Zaokrąglenie progu w dół. Próg 14.22 oznacza co najmniej 15 punktów, a nie 14.
- Wszystkie analizy na zmiennej „wystarczająca/niewystarczająca”. Porównania grup licz na wyniku ciągłym; próg służy do opisu.
Jeśli chcesz, żeby ktoś sprawdził z Tobą formularz dla sędziów, policzył próg z przedziałem ufności i wyjaśnił wyniki tak, żebyś mógł(-ogła) je obronić, zobacz pomoc w analizie dla studentów.
Metoda Angoffa w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z tekstu. Pierwszy symuluje test (20 pytań, pilotaż 30 osób, badanie właściwe 150 osób), oceny ośmiu sędziów w dwóch rundach i liczy próg z SE i 95% CI, pytania do dyskusji, zgodność sędziów, odsetki osób powyżej progu, SEM i błąd progu przy różnej liczbie sędziów. Zapisuje też oceny sędziów do pliku CSV w folderze nadrzędnym (../) oraz dane badania do pliku pomocniczego. Drugi przepis liczy progi metodą grup kontrastowych i grupy granicznej. Rysunki powstały w osobnym skrypcie na tych samych danych. Oceny sędziów możesz pobrać: prog-angoff-oceny-sedziow.csv (sędzia, runda, pytanie, ocena).
Zmodyfikowana metoda Angoffa: dwie rundy, próg, błąd i konsekwencje
R
# B423 – próg dobrej wiedzy zmodyfikowaną metodą Angoffa (dane symulowane)
# Test: 20 pytań 0/1 o profilaktyce odleżyn; panel: 8 sędziów; dwie rundy ocen.
suppressPackageStartupMessages(library(psych))
set.seed(423)
k <- 20; J <- 8
b <- sort(rnorm(k, -1.4, 0.9))                 # trudność pytań (model Rascha)
theta_gr <- 0.1                                # wiedza osoby "ledwie wystarczającej"
odpowiedzi <- function(n) {                    # symulacja odpowiedzi n pielęgniarek
  theta <- rnorm(n, 0, 1)
  x <- (matrix(runif(n * k), n) < plogis(outer(theta, b, "-"))) * 1
  colnames(x) <- sprintf("P%02d", 1:k); list(theta = theta, x = x)
}
pilotaz <- odpowiedzi(30)$x                    # pilotaż: dane o łatwości dla rundy 2
badanie <- odpowiedzi(150)                     # badanie właściwe
latwosc <- colMeans(pilotaz)

# Runda 1: sędzia szacuje P(poprawna odpowiedź) osoby granicznej; skala co 0.05
p_gr <- plogis(theta_gr - b)
surowosc <- rnorm(J, 0, 0.07)
r1 <- outer(surowosc, p_gr, "+") + matrix(rnorm(J * k, 0, 0.13), J)
r1 <- pmax(pmin(round(r1 * 20) / 20, 0.95), 0.05)
dimnames(r1) <- list(paste0("S", 1:J), colnames(pilotaz))
# Runda 2: po dyskusji i obejrzeniu łatwości z pilotażu oceny zbliżają się do średniej panelu
sr1 <- colMeans(r1)
cel <- sr1 + 0.3 * ((latwosc - mean(latwosc)) - (sr1 - mean(sr1)))
r2 <- r1 + 0.5 * (matrix(cel, J, k, byrow = TRUE) - r1) + matrix(rnorm(J * k, 0, 0.03), J)
r2 <- pmax(pmin(round(r2 * 20) / 20, 0.95), 0.05)

cat("PROGI SĘDZIÓW (suma ocen = punkty z 20)\n")
progi <- data.frame(runda1 = rowSums(r1), runda2 = rowSums(r2))
print(t(round(progi, 2)))
panel <- function(p) { n <- length(p); se <- sd(p) / sqrt(n)
  c(prog = mean(p), proc = 100 * mean(p) / k, SD = sd(p), SE = se,
    CI_dol = mean(p) - qt(.975, n - 1) * se, CI_gor = mean(p) + qt(.975, n - 1) * se,
    min = min(p), max = max(p)) }
cat("\nPANEL\n"); print(round(rbind(runda1 = panel(progi$runda1), runda2 = panel(progi$runda2)), 2))

cat("\nPYTANIA DO DYSKUSJI (SD ocen w rundzie 1 > 0.15)\n")
sd_poz <- apply(r1, 2, sd)
print(round(rbind(SD_r1 = sd_poz, srednia_r1 = sr1, latwosc_pilotaz = latwosc)[, sd_poz > 0.15], 2))

cat("\nKORELACJA OCEN SĘDZIEGO Z ŁATWOŚCIĄ Z PILOTAŻU\n")
print(round(rbind(runda1 = apply(r1, 1, cor, latwosc), runda2 = apply(r2, 1, cor, latwosc)), 2))
cat(sprintf("Korelacja średniej ocen panelu z łatwością: %.2f (runda 1), %.2f (runda 2)\n",
            cor(sr1, latwosc), cor(colMeans(r2), latwosc)))
icc <- ICC(t(r2))$results                      # pytania = obiekty, sędziowie = oceniający
cat(sprintf("ICC(2,1) w rundzie 2 = %.2f; ICC(2,k) = %.2f\n",
            icc["Single_random_raters", "ICC"], icc["Average_random_raters", "ICC"]))

cat("\nPRÓG I JEGO KONSEKWENCJE (badanie właściwe, N = 150)\n")
prog <- mean(progi$runda2); se <- sd(progi$runda2) / sqrt(J)
min_pkt <- ceiling(prog)                       # wynik >= progu, a punkty są całkowite
wynik <- rowSums(badanie$x)
odsetek <- function(c) { t <- sum(wynik >= c); ci <- prop.test(t, length(wynik), correct = FALSE)$conf.int
  sprintf("co najmniej %2d pkt: %3d osób, %.1f%%, 95%% CI [%.1f, %.1f]", c, t, 100 * t / length(wynik), 100 * ci[1], 100 * ci[2]) }
cat(sprintf("Próg Angoffa = %.2f pkt -> minimalny wynik %d pkt\n", prog, min_pkt))
cat("Angoff:          ", odsetek(min_pkt), "\n")
cat("Umowne 60%:      ", odsetek(ceiling(0.6 * k)), "\n")
ci <- prog + c(-1, 1) * qt(.975, J - 1) * se
cat(sprintf("95%% CI progu: %.2f-%.2f pkt\n", ci[1], ci[2]))
cat("  dolna granica: ", odsetek(ceiling(ci[1])), "\n")
cat("  górna granica: ", odsetek(ceiling(ci[2])), "\n")
kr20 <- (k / (k - 1)) * (1 - sum(colMeans(badanie$x) * (1 - colMeans(badanie$x))) / var(wynik))
sem <- sd(wynik) * sqrt(1 - kr20)
cat(sprintf("Wynik: M = %.2f, SD = %.2f; KR-20 = %.2f; SEM = %.2f pkt\n", mean(wynik), sd(wynik), kr20, sem))
cat(sprintf("Osoby z wynikiem w odległości do 1 SEM od progu: %d (%.1f%%)\n",
            sum(abs(wynik - prog) <= sem), 100 * mean(abs(wynik - prog) <= sem)))

cat("\nILU SĘDZIÓW? SE progu jako % maksymalnego wyniku (SD z obu rund)\n")
ile <- data.frame(sedziow = c(4, 6, 8, 10, 12, 15, 20))
ile$runda1 <- round(100 * sd(progi$runda1) / sqrt(ile$sedziow) / k, 2)
ile$runda2 <- round(100 * sd(progi$runda2) / sqrt(ile$sedziow) / k, 2)
print(ile, row.names = FALSE)

# Dane do pobrania: oceny sędziów w formacie długim
dl <- do.call(rbind, lapply(1:2, function(r) { m <- list(r1, r2)[[r]]
  data.frame(sedzia = rep(rownames(m), k), runda = r, pytanie = rep(colnames(m), each = J), ocena = as.vector(m)) }))
write.csv(dl, "../prog-angoff-oceny-sedziow.csv", row.names = FALSE)
write.csv(data.frame(badanie$x, theta = round(badanie$theta, 3)), "b423-badanie.csv", row.names = FALSE)
write.csv(data.frame(pytanie = colnames(pilotaz), latwosc = latwosc, p_graniczna = round(p_gr, 3)), "b423-pytania.csv", row.names = FALSE)
Wynik w R
PROGI SĘDZIÓW (suma ocen = punkty z 20)
         S1    S2   S3    S4    S5    S6    S7    S8
runda1 11.2 13.45 16.6 16.05 14.30 14.85 11.90 15.90
runda2 12.8 13.60 15.2 15.35 14.15 14.60 13.05 15.05

PANEL
        prog  proc   SD   SE CI_dol CI_gor  min   max
runda1 14.28 71.41 1.98 0.70  12.63  15.93 11.2 16.60
runda2 14.22 71.12 0.99 0.35  13.40  15.05 12.8 15.35

PYTANIA DO DYSKUSJI (SD ocen w rundzie 1 > 0.15)
                 P03  P09  P11  P12  P14  P16  P19  P20
SD_r1           0.17 0.18 0.21 0.18 0.22 0.21 0.19 0.19
srednia_r1      0.83 0.75 0.71 0.73 0.64 0.61 0.39 0.44
latwosc_pilotaz 0.93 0.83 0.87 0.77 0.80 0.60 0.37 0.50

KORELACJA OCEN SĘDZIEGO Z ŁATWOŚCIĄ Z PILOTAŻU
         S1   S2   S3   S4   S5   S6   S7   S8
runda1 0.78 0.73 0.83 0.72 0.72 0.61 0.66 0.79
runda2 0.85 0.82 0.88 0.85 0.86 0.83 0.83 0.90
Korelacja średniej ocen panelu z łatwością: 0.87 (runda 1), 0.91 (runda 2)
ICC(2,1) w rundzie 2 = 0.78; ICC(2,k) = 0.97

PRÓG I JEGO KONSEKWENCJE (badanie właściwe, N = 150)
Próg Angoffa = 14.22 pkt -> minimalny wynik 15 pkt
Angoff:           co najmniej 15 pkt:  80 osób, 53.3%, 95% CI [45.4, 61.1]
Umowne 60%:       co najmniej 12 pkt: 111 osób, 74.0%, 95% CI [66.4, 80.4]
95% CI progu: 13.40-15.05 pkt
  dolna granica:  co najmniej 14 pkt:  91 osób, 60.7%, 95% CI [52.7, 68.1]
  górna granica:  co najmniej 16 pkt:  70 osób, 46.7%, 95% CI [38.9, 54.6]
Wynik: M = 14.17, SD = 3.86; KR-20 = 0.79; SEM = 1.77 pkt
Osoby z wynikiem w odległości do 1 SEM od progu: 34 (22.7%)

ILU SĘDZIÓW? SE progu jako % maksymalnego wyniku (SD z obu rund)
 sedziow runda1 runda2
       4   4.94   2.47
       6   4.03   2.02
       8   3.49   1.75
      10   3.12   1.56
      12   2.85   1.43
      15   2.55   1.28
      20   2.21   1.11
Grupy kontrastowe i grupa graniczna na tych samych danych
R
# B423 – metoda grup kontrastowych i grupy granicznej (dane symulowane)
# Wymaga pliku b423-badanie.csv z przepisu 1 (150 pielęgniarek, 20 pytań).
set.seed(4231)
d <- read.csv("b423-badanie.csv")
d$wynik <- rowSums(d[, sprintf("P%02d", 1:20)])
# Ocena przełożonych niezależna od testu: wiedza wystarczająca czy nie (z błędem oceny)
ocena <- d$theta + rnorm(nrow(d), 0, 0.6)
d$wystarczajaca <- as.numeric(ocena > 0.1)
d$na_granicy <- abs(ocena - 0.1) < 0.3          # osoby wskazane jako "na granicy"
cat("Liczebności grup:\n"); print(table(wystarczajaca = d$wystarczajaca))
print(aggregate(wynik ~ wystarczajaca, d, function(x) round(c(M = mean(x), SD = sd(x), Me = median(x)), 2)))

# 1) Grupy kontrastowe: wynik, przy którym P(wystarczająca) = 0.5 w regresji logistycznej
m <- glm(wystarczajaca ~ wynik, family = binomial, data = d)
cat(sprintf("\nGrupy kontrastowe (regresja logistyczna): próg = %.2f pkt\n", -coef(m)[1] / coef(m)[2]))
# 2) Grupy kontrastowe: wynik całkowity z najmniejszą liczbą błędnych klasyfikacji
bledy <- sapply(0:20, function(c) sum(d$wynik >= c & d$wystarczajaca == 0) + sum(d$wynik < c & d$wystarczajaca == 1))
cat(sprintf("Najmniej błędnych klasyfikacji: od %d pkt (%d z %d osób)\n", (0:20)[which.min(bledy)], min(bledy), nrow(d)))
# 3) Grupa graniczna: mediana wyników osób wskazanych jako "na granicy"
cat(sprintf("Grupa graniczna (n = %d): mediana = %.1f pkt\n", sum(d$na_granicy), median(d$wynik[d$na_granicy])))
write.csv(d[, c("wynik", "wystarczajaca", "na_granicy")], "b423-grupy.csv", row.names = FALSE)
Wynik w R
Liczebności grup:
wystarczajaca
 0  1
84 66
  wystarczajaca wynik.M wynik.SD wynik.Me
1             0   11.92     3.49    12.00
2             1   17.05     1.92    17.00

Grupy kontrastowe (regresja logistyczna): próg = 15.36 pkt
Najmniej błędnych klasyfikacji: od 15 pkt (28 z 150 osób)
Grupa graniczna (n = 17): mediana = 14.0 pkt
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem psych; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jaki procent poprawnych odpowiedzi oznacza dobrą wiedzę w teście?
Nie ma uniwersalnego procentu. Ten sam próg 60% w łatwym teście znaczy co innego niż w trudnym, bo zależy od pytań. Próg da się uzasadnić, gdy ustalą go eksperci na podstawie treści testu, np. metodą Angoffa, albo gdy pochodzi z wcześniejszych badań tym samym narzędziem. W przykładzie z tego wpisu panel ustalił 15 z 20 punktów, czyli 75%.
Kogo zaprosić do panelu sędziów w metodzie Angoffa w pracy dyplomowej?
Osoby, które znają treść testu i badaną grupę: nauczycieli akademickich danego przedmiotu, doświadczonych praktyków, np. pielęgniarki oddziałowe lub edukatorów. W pracy dyplomowej realne jest 6–10 sędziów. Nie zapraszaj do panelu osób, które będą badane, i opisz w pracy skład panelu.
Jak zaokrąglić próg z metody Angoffa do pełnych punktów?
Jeśli wiedzę uznajesz za wystarczającą przy wyniku nie niższym niż próg, zaokrąglij próg w górę do najbliższej liczby całkowitej. Próg 14.22 punktu oznacza co najmniej 15 punktów. Regułę zapisz w planie analizy, zanim zobaczysz wyniki badania.
Czy próg z metody Angoffa mogę stosować w pomiarze przed szkoleniem i po nim?
Tak, jeśli w obu pomiarach używasz tego samego testu z tym samym punktowaniem, bo próg zależy od treści pytań, a nie od wyników. Odsetki osób powyżej progu w dwóch pomiarach tych samych osób porównujesz testem McNemara. Po zmianie pytań próg trzeba ustalić na nowo.
Czym metoda grup kontrastowych różni się od metody Angoffa?
W metodzie Angoffa eksperci oceniają pytania, a w metodzie grup kontrastowych – osoby: dzielą badanych na mających wiedzę wystarczającą i niewystarczającą, niezależnie od testu. Próg to wynik najlepiej rozdzielający obie grupy. Wymaga ekspertów, którzy znają badanych, dlatego w pracy dyplomowej służy zwykle jako dodatkowe sprawdzenie progu Angoffa.
Powiązane hasła
Przeczytaj też
Jak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikTrafność treściowa testu wiedzy
Ocena ekspertów dla testu wiedzy: I-CVI, CVR z wartościami krytycznymi, klucz, tabela specyfikacji i druga runda – przykład w R z gotowym opisem.
Czytaj →PoradnikPunktowanie testu wiedzy: „nie wiem” i zgadywanie
„Nie wiem” jako 0 czy brak, poprawka na zgadywanie, próg dla prawda/fałsz i punkty częściowe za kilka poprawnych odpowiedzi – na symulacji w R.
Czytaj →Ustalasz próg wiedzy w teście do pracy z pielęgniarstwa?
Pomożemy przygotować formularz dla sędziów, policzymy próg z przedziałem ufności w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie opisać i obronić każdą decyzję.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Angoff, W. H. (1971). Scales, norms, and equivalent scores. In R. L. Thorndike (Ed.), Educational measurement (2nd ed.). American Council on Education.
- Ben-David, M. F. (2000). AMEE Guide No. 18: Standard setting in student assessment. Medical Teacher, 22(2), 120–130. https://doi.org/10.1080/01421590078526
- Brandon, P. R. (2004). Conclusions about frequently studied modified Angoff standard-setting topics. Applied Measurement in Education, 17(1), 59–88. https://doi.org/10.1207/s15324818ame1701_4
- Cizek, G. J., & Bunch, M. B. (2007). Standard setting: A guide to establishing and evaluating performance standards on tests. SAGE Publications. https://doi.org/10.4135/9781412985918
- Fowell, S. L., Fewtrell, R., & McLaughlin, P. J. (2008). Estimating the minimum number of judges required for test-centred standard setting on written assessments. Do discussion and iteration have an influence? Advances in Health Sciences Education, 13(1), 11–24. https://doi.org/10.1007/s10459-006-9027-1
- Hurtz, G. M., & Auerbach, M. A. (2003). A meta-analysis of the effects of modifications to the Angoff method on cutoff scores and judgment consensus. Educational and Psychological Measurement, 63(4), 584–601. https://doi.org/10.1177/0013164403251284
- Kane, M. (1994). Validating the performance standards associated with passing scores. Review of Educational Research, 64(3), 425–461. https://doi.org/10.3102/00346543064003425
- Norcini, J. J. (2003). Setting standards on educational tests. Medical Education, 37(5), 464–469. https://doi.org/10.1046/j.1365-2923.2003.01495.x
- Ricker, K. L. (2006). Setting cut-scores: A critical review of the Angoff and modified Angoff methods. Alberta Journal of Educational Research, 52(1), 53–64. https://doi.org/10.55016/ojs/ajer.v52i1.55111 ● Otwarty dostęp
Cytowania BibTeX
@incollection{angoff1971scales, author={Angoff, William H.}, title={{Scales, norms, and equivalent scores}}, booktitle={Educational measurement (2nd ed.)}, year={1971}, publisher={American Council on Education}}@article{bendavid2000amee, author={Ben-David, Miriam Friedman}, title={{AMEE Guide No. 18: Standard setting in student assessment}}, journal={Medical Teacher}, year={2000}, volume={22}, number={2}, pages={120--130}, doi={10.1080/01421590078526}}@article{brandon2004conclusions, author={Brandon, Paul R.}, title={{Conclusions about frequently studied modified Angoff standard-setting topics}}, journal={Applied Measurement in Education}, year={2004}, volume={17}, number={1}, pages={59--88}, doi={10.1207/s15324818ame1701_4}}@book{cizek2007standard, author={Cizek, Gregory J. and Bunch, Michael B.}, title={{Standard setting: A guide to establishing and evaluating performance standards on tests}}, year={2007}, publisher={SAGE Publications}, doi={10.4135/9781412985918}}@article{fowell2008estimating, author={Fowell, S. L. and Fewtrell, R. and McLaughlin, P. J.}, title={{Estimating the minimum number of judges required for test-centred standard setting on written assessments. Do discussion and iteration have an influence?}}, journal={Advances in Health Sciences Education}, year={2008}, volume={13}, number={1}, pages={11--24}, doi={10.1007/s10459-006-9027-1}}@article{hurtz2003meta, author={Hurtz, Gregory M. and Auerbach, Meredith A.}, title={{A meta-analysis of the effects of modifications to the Angoff method on cutoff scores and judgment consensus}}, journal={Educational and Psychological Measurement}, year={2003}, volume={63}, number={4}, pages={584--601}, doi={10.1177/0013164403251284}}@article{kane1994validating, author={Kane, Michael}, title={{Validating the performance standards associated with passing scores}}, journal={Review of Educational Research}, year={1994}, volume={64}, number={3}, pages={425--461}, doi={10.3102/00346543064003425}}@article{norcini2003setting, author={Norcini, John J.}, title={{Setting standards on educational tests}}, journal={Medical Education}, year={2003}, volume={37}, number={5}, pages={464--469}, doi={10.1046/j.1365-2923.2003.01495.x}}@article{ricker2006setting, author={Ricker, Kathryn L.}, title={{Setting cut-scores: A critical review of the Angoff and modified Angoff methods}}, journal={Alberta Journal of Educational Research}, year={2006}, volume={52}, number={1}, pages={53--64}, doi={10.55016/ojs/ajer.v52i1.55111}}