Co to jest zrównywanie wyników testów?
Zrównywanie (ang. equating) to procedura statystyczna, która przekształca wyniki surowe jednej formy testu na skalę drugiej formy, tak by można było używać ich zamiennie. Jest potrzebne, gdy kolejne wersje egzaminu mają te same specyfikacje treści, ale nieco różną trudność: 20 punktów w trudniejszej formie powinno znaczyć tyle, co wyższy wynik w łatwiejszej. Standardowym podręcznikiem tej dziedziny jest monografia Kolena i Brennana (2014). Zrównywanie to coś innego niż normy testowe: normy porównują osobę z grupą odniesienia, a zrównywanie łączy ze sobą dwie formy testu.
Schematy zbierania danych
- Grupy równoważne: formy X i Y rozdaje się losowo w jednej populacji, więc różnice rozkładów przypisuje się formom, a nie osobom.
- Ta sama grupa: każda osoba rozwiązuje obie formy, najlepiej w kolejności zrównoważonej, by kontrolować zmęczenie i wprawę.
- Kotwica (NEAT): grupy są różne, ale obie formy zawierają wspólny zestaw pozycji kotwiczących, który pozwala oddzielić różnice między grupami od różnic między formami. Kotwica powinna być miniaturą całego testu.
Najprostsze metody to liniowa (wynik zachowuje odległość od średniej w jednostkach SD) i ekwipercentylowa (wynik ma ten sam percentyl w obu formach). W modelach IRT, np. w modelu Rascha, parametry obu form sprowadza się do wspólnej skali cechy.
Przykład
W symulacji dwie losowe grupy po 2000 osób rozwiązały 40-pozycyjne formy X (trudniejsza) i Y. Średnie wyniosły 17.83 (SD = 7.74) i 19.77 (SD = 7.91). Wynik 20 w formie X odpowiada 21.99 punktu formy Y według metody liniowej i 22.14 według ekwipercentylowej; wynik 10 – odpowiednio 11.78 i 11.46.
Na rysunku
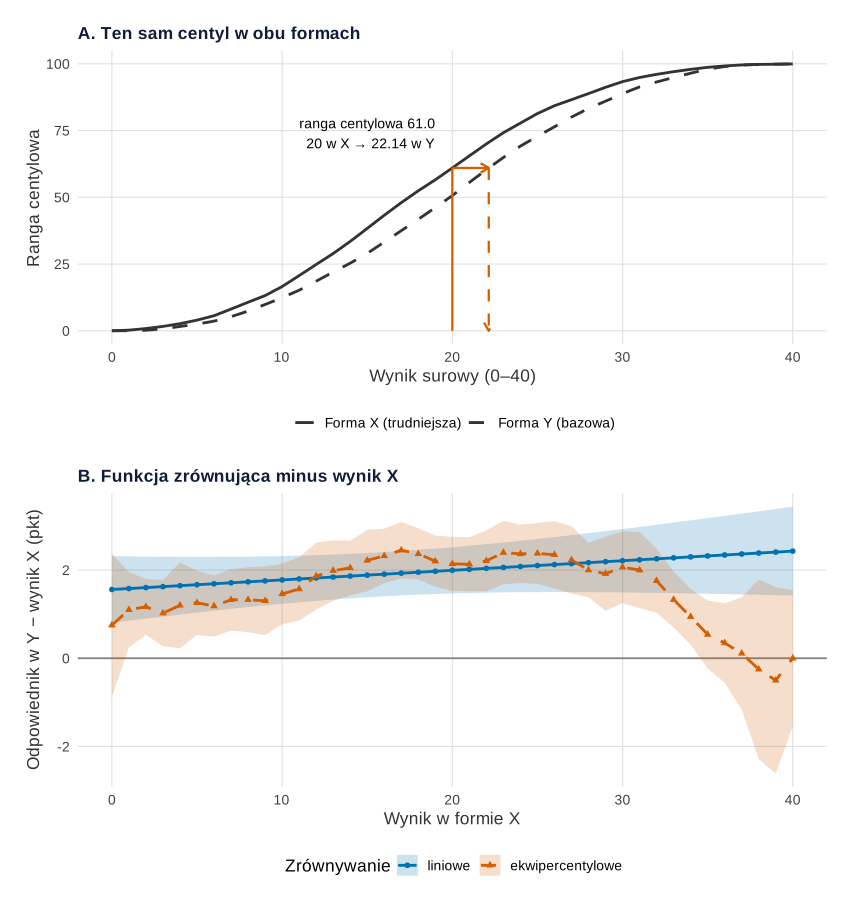
set.seed(656)).Co widać. To te same dane co w przykładzie. Panel A pokazuje metodę ekwipercentylową wprost: wynik 20 w formie X ma rangę centylową 61.0, a tę samą rangę w formie Y ma wynik 22.14. Panel B pokazuje, o ile punktów każdy wynik X przesuwa się na skali Y. Metoda liniowa daje prostą, od 1.67 punktu przy wyniku 5 do 2.32 przy 35. Krzywa ekwipercentylowa idzie za kształtem rozkładów: w środku skali prawie pokrywa się z prostą, ale przy wyniku 35 daje 35.54 zamiast 37.32. Wynik 40 metoda liniowa przenosi na 42.43, czyli poza skalę testu. Metoda ekwipercentylowa zostawia go na 40.00.
Na co uważać. Na krańcach skali jest mało osób: poniżej 5 punktów 66 z 2000, powyżej 35 tylko 20. Tam pasma z 500 prób bootstrapowych są najszersze, a krzywa ekwipercentylowa skacze między sąsiednimi wynikami (błąd standardowy dla wyniku 40 to 0.79 punktu, dla 20 – 0.31). Dlatego w praktyce stosuje się wygładzanie. Pasmo pokazuje tylko błąd losowy. Nie pokazuje błędu systematycznego, gdy grupy nie są równoważne albo gdy formy mierzą coś innego. Krzywą skumulowanego rozkładu opisuje hasło dystrybuanta empiryczna.
Podpis do pracy:
Kod losuje te same dane co przykład, z tym samym ziarnem set.seed(656), ustalonym raz; dalsza część tego samego ciągu losowań służy do 500 prób bootstrapowych. Trudności pozycji obu form ustawiono ręcznie, by forma X była wyraźnie trudniejsza. Kod sam definiuje paletę Okabe–Ito i motyw; rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Zrównywanie ekwipercentylowe na dystrybuantach (A)
# i funkcje zrównujące liniowa vs ekwipercentylowa z bootstrapowym błędem (B)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(equate))   # equate::margin zasłania ggplot2::margin – tu bez znaczenia

# Paleta Okabe–Ito i prosty motyw
kol <- c("liniowe" = "#0072B2", "ekwipercentylowe" = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), panel.grid.minor = element_blank(),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie: grupy równoważne po 2000 osób, formy po 40 pozycji (X trudniejsza)
set.seed(656)
n <- 2000; k <- 40
theta_X <- rnorm(n); theta_Y <- rnorm(n)
bX <- seq(-1.2, 1.8, length.out = k)
bY <- seq(-1.5, 1.5, length.out = k)
wynik <- function(th, b) rowSums(matrix(rbinom(length(th) * k, 1, plogis(outer(th, b, "-"))), length(th)))
X <- wynik(theta_X, bX); Y <- wynik(theta_Y, bY)
fX <- freqtab(X, scales = 0:k); fY <- freqtab(Y, scales = 0:k)

# Funkcje zrównujące z błędem standardowym z 500 prób bootstrapowych (ciąg losowań po danych)
e_lin <- equate(fX, fY, type = "linear", boot = TRUE, reps = 500)
e_ekw <- equate(fX, fY, type = "equipercentile", boot = TRUE, reps = 500)
f <- data.frame(x = rep(0:k, 2), metoda = factor(rep(names(kol), each = k + 1), levels = names(kol)),
                yx = c(e_lin$concordance$yx, e_ekw$concordance$yx),
                se = c(e_lin$bootstraps$se, e_ekw$bootstraps$se))
f$n_X <- rep(as.vector(fX), 2)
zakres <- range(X)                                   # wyniki X faktycznie obecne w próbie
round(c(min_X = zakres[1], max_X = zakres[2], osob_X_ponizej_5 = sum(X < 5), osob_X_powyzej_35 = sum(X > 35)), 2)
x <- c(5, 10, 20, 30, 35, 40)
round(data.frame(x, lin = e_lin$concordance$yx[x + 1], lin_SE = e_lin$bootstraps$se[x + 1],
                 ekw = e_ekw$concordance$yx[x + 1], ekw_SE = e_ekw$bootstraps$se[x + 1]), 2)

# Panel A: skumulowane rozkłady (rangi centylowe) obu form i odczyt dla x = 20
pr <- function(x, S) 100 * (mean(S <= x - 1) + mean(S == x) / 2)   # ranga centylowa
d <- data.frame(wynik = rep(0:k, 2), forma = rep(c("Forma X (trudniejsza)", "Forma Y (bazowa)"), each = k + 1))
d$centyl <- c(sapply(0:k, pr, S = X), sapply(0:k, pr, S = Y))
p20 <- pr(20, X); y20 <- e_ekw$concordance$yx[21]
round(c(ranga_centylowa_20_w_X = p20, odpowiednik_w_Y = y20), 2)
pA <- ggplot(d, aes(wynik, centyl, linetype = forma)) +
  geom_line(linewidth = 1, colour = "grey20") +
  annotate("segment", x = 20, xend = 20, y = 0, yend = p20, colour = kol[["ekwipercentylowe"]], linewidth = 0.8) +
  annotate("segment", x = 20, xend = y20, y = p20, yend = p20, colour = kol[["ekwipercentylowe"]], linewidth = 0.8,
           arrow = arrow(length = unit(0.25, "cm"))) +
  annotate("segment", x = y20, xend = y20, y = p20, yend = 0, colour = kol[["ekwipercentylowe"]], linewidth = 0.8,
           linetype = "dashed", arrow = arrow(length = unit(0.25, "cm"))) +
  annotate("text", x = 19, y = p20 + 13, hjust = 1, size = 3.7,
           label = sprintf("ranga centylowa %.1f\n20 w X → %.2f w Y", p20, y20)) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  labs(title = "A. Ten sam centyl w obu formach", x = "Wynik surowy (0–40)", y = "Ranga centylowa") +
  motyw

# Panel B: o ile punktów wynik X przesuwa się na skali Y; pasmo = ±1.96 SE (bootstrap)
pB <- ggplot(subset(f, x >= zakres[1] & x <= zakres[2]), aes(x, yx - x, colour = metoda, fill = metoda)) +
  geom_hline(yintercept = 0, colour = "grey50") +
  geom_ribbon(aes(ymin = yx - x - 1.96 * se, ymax = yx - x + 1.96 * se), alpha = 0.2, colour = NA) +
  geom_line(aes(linetype = metoda), linewidth = 1) +
  geom_point(aes(shape = metoda), size = 1.6) +
  scale_colour_manual(values = kol, name = "Zrównywanie") + scale_fill_manual(values = kol, name = "Zrównywanie") +
  scale_linetype_manual(values = c("solid", "dashed"), name = "Zrównywanie") +
  scale_shape_manual(values = c(16, 17), name = "Zrównywanie") +
  labs(title = "B. Funkcja zrównująca minus wynik X", x = "Wynik w formie X",
       y = "Odpowiednik w Y − wynik X (pkt)") +
  motyw

p1 <- pA / pB
p1
Wynik w R
            min_X             max_X  osob_X_ponizej_5 osob_X_powyzej_35
                0                40                66                20
   x   lin lin_SE   ekw ekw_SE
1  5  6.67   0.32  6.26   0.37
2 10 11.78   0.28 11.46   0.35
3 20 21.99   0.27 22.14   0.31
4 30 32.21   0.37 32.07   0.42
5 35 37.32   0.44 35.54   0.39
6 40 42.43   0.51 40.00   0.79
ranga_centylowa_20_w_X        odpowiednik_w_Y
                 61.00                  22.14
Jak opisać w pracy
Na co uważać
- Zrównywać można tylko formy mierzące ten sam konstrukt z podobną rzetelnością. Powiązanie różnych testów to luźniejsze linking, nie equating.
- Funkcja zrównująca powinna być taka sama w różnych podgrupach. Dorans i Holland (2000) proponują miary niezmienniczości względem populacji jako sprawdzian, czy dwie formy w ogóle nadają się do zrównania.
- Pozycje kotwiczące z DIF albo ujawnione przed egzaminem zniekształcają wynik.
- Metoda ekwipercentylowa bez wygładzania jest niestabilna w małych próbach i na krańcach skali.
Zrównywanie wyników w R
Kod symuluje schemat grup równoważnych i liczy ręcznie zrównywanie liniowe (średnia–SD) oraz ekwipercentylowe bez wygładzania, z rangami centylowymi w wersji „ciągłej” opisanej przez Kolena i Brennana. Funkcja equate::equate() daje te same wartości co obliczenia ręczne (np. 20 → 21.99 liniowo i 22.14 ekwipercentylowo).
Liniowe i ekwipercentylowe zrównanie dwóch form
R
# Zrównywanie w schemacie grup równoważnych: liniowe (średnia–SD) i ekwipercentylowe (dane symulowane)
set.seed(656)
n <- 2000; k <- 40
theta_X <- rnorm(n); theta_Y <- rnorm(n)                  # dwie losowo dobrane, równoważne grupy
bX <- seq(-1.2, 1.8, length.out = k)                       # forma X: pozycje trudniejsze
bY <- seq(-1.5, 1.5, length.out = k)                       # forma Y: forma bazowa
wynik <- function(th, b) rowSums(matrix(rbinom(length(th) * k, 1, plogis(outer(th, b, "-"))), length(th)))
X <- wynik(theta_X, bX); Y <- wynik(theta_Y, bY)
round(c(sr_X = mean(X), sd_X = sd(X), sr_Y = mean(Y), sd_Y = sd(Y)), 2)
lin <- function(x) sd(Y) / sd(X) * (x - mean(X)) + mean(Y) # zrównywanie liniowe
# Ekwipercentylowe bez wygładzania: ranga centylowa x na X -> ten sam centyl na Y (rozkład "ciągły" jak w Kolen i Brennan)
pr <- function(x, S) 100 * (mean(S <= x - 1) + mean(S == x) / 2)
ekw <- function(x) {
  F <- 100 * sapply(0:k, function(y) mean(Y <= y))         # skumulowany rozkład Y (w %)
  p <- pr(x, X); y_u <- which(F > p)[1] - 1                # najmniejszy wynik y, dla którego F(y) > p
  Fdol <- if (y_u == 0) 0 else F[y_u]
  (p - Fdol) / (F[y_u + 1] - Fdol) + y_u - 0.5
}
x <- c(10, 15, 20, 25, 30)
round(data.frame(x, liniowe = lin(x), ekwipercentylowe = sapply(x, ekw)), 2)
# To samo w pakiecie equate (te same liczby co obliczenia ręczne)
library(equate)
fX <- freqtab(X, scales = 0:k); fY <- freqtab(Y, scales = 0:k)
e_lin <- equate(fX, fY, type = "linear"); e_ekw <- equate(fX, fY, type = "equipercentile")
round(data.frame(x, liniowe = e_lin$concordance$yx[x + 1], ekwipercentylowe = e_ekw$concordance$yx[x + 1]), 2)
Wynik w R
 sr_X  sd_X  sr_Y  sd_Y
17.83  7.74 19.77  7.91
   x liniowe ekwipercentylowe
1 10   11.78            11.46
2 15   16.89            17.22
3 20   21.99            22.14
4 25   27.10            27.38
5 30   32.21            32.07
   x liniowe ekwipercentylowe
1 10   11.78            11.46
2 15   16.89            17.22
3 20   21.99            22.14
4 25   27.10            27.38
5 30   32.21            32.07
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia ręczne funkcjami bazowymi oraz pakiet equate: freqtab(), equate()). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- equate (wersja 2.0.9): Albano, A. D. (2026). equate: Observed-score linking and equating (R package version 2.0.9) [Computer software]. https://doi.org/10.32614/CRAN.package.equate
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym zrównywanie różni się od normalizacji?
Normalizacja przekłada wynik na pozycję osoby w grupie odniesienia, np. centyl albo stanin. Zrównywanie łączy dwie formy tego samego testu, tak by ten sam wynik oznaczał ten sam poziom umiejętności niezależnie od formy.
Który schemat zbierania danych wybrać?
Grupy równoważne wymagają dużych prób i losowego przydziału form. Schemat tej samej grupy daje precyzję przy mniejszej próbie, ale grozi efektem kolejności. Kotwica pozwala zrównywać formy podawane różnym grupom, np. w kolejnych latach egzaminu.
Czy wystarczy porównać średnie obu form?
Przesunięcie o różnicę średnich to najprostsza wersja, która zakłada równe odchylenia standardowe. Metoda liniowa uwzględnia też SD, a ekwipercentylowa cały kształt rozkładu, co ma znaczenie, gdy formy różnią się trudnością nierówno w całym zakresie skali.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dorans, N. J., & Holland, P. W. (2000). Population invariance and the equatability of tests: Basic theory and the linear case. Journal of Educational Measurement, 37(4), 281–306. https://doi.org/10.1111/j.1745-3984.2000.tb01088.x
- Kolen, M. J., & Brennan, R. L. (2014). Test equating, scaling, and linking: Methods and practices (3rd ed.). Springer. https://doi.org/10.1007/978-1-4939-0317-7
Cytowania BibTeX
@article{dorans2000population, author={Dorans, Neil J. and Holland, Paul W.}, title={{Population invariance and the equatability of tests: Basic theory and the linear case}}, journal={Journal of Educational Measurement}, year={2000}, volume={37}, number={4}, pages={281--306}, doi={10.1111/j.1745-3984.2000.tb01088.x}}@book{kolen2014test, author={Kolen, Michael J. and Brennan, Robert L.}, title={{Test equating, scaling, and linking: Methods and practices (3rd ed.)}}, year={2014}, publisher={Springer}, doi={10.1007/978-1-4939-0317-7}}