Test wiedzy to narzędzie pomiarowe, a nie lista pytań
W pracach z pielęgniarstwa, położnictwa, ratownictwa, dietetyki i zdrowia publicznego bardzo często pada pytanie: „Jaki jest poziom wiedzy pacjentów (rodziców, studentów, personelu) na temat…?”. Gotowego testu na dokładnie ten temat zwykle nie ma, więc powstaje własny: kilkanaście pytań spisanych z podręcznika w jeden wieczór, bez planu i bez próby. Problemy wychodzą przy analizie – połowa pytań jest za łatwa, jedno ma błąd w kluczu, a rzetelność jest za niska, żeby porównywać grupy.
Ten wpis prowadzi od pomysłu do opisu testu w rozdziale metodologicznym. Szczegóły kroków mają osobne wpisy: jak pisać pytania testowe i dystraktory, trafność treściowa i ocena ekspertów, punktowanie testu wiedzy oraz próg dobrej wiedzy metodą Angoffa. Jeśli test masz już gotowy i zebrałeś dane, przejdź od razu do poradnika ankieta wiedzy – analiza krok po kroku, a gdy mierzysz wiedzę przed szkoleniem i po nim – do wpisu o badaniu wiedzy przed i po szkoleniu.
Przykład przewodni (wymyślony, dane symulowane). Studentka pielęgniarstwa buduje test wiedzy pacjentów z niewydolnością serca o samoopiece. Test ma 20 pytań jednokrotnego wyboru w czterech obszarach. Treści pytań i klucza celowo nie podajemy: to poradnik o konstrukcji testu, a nie o leczeniu. Ten sam schemat pasuje do testu o karmieniu piersią, profilaktyce upadków czy pierwszej pomocy.
Krok 1. Cel testu: czyja wiedza, o czym i po co
Zanim napiszesz pierwsze pytanie, odpowiedz na trzy pytania i zapisz odpowiedzi – wrócą w opisie narzędzia.
- Czyja wiedza? Pacjenci, opiekunowie, studenci i personel różnią się językiem, którym można do nich pisać, oczekiwaną trudnością pytań i cierpliwością. Test dla pielęgniarek może używać terminów fachowych; test dla pacjentów po siedemdziesiątce musi być krótki, prosty i wydrukowany większą czcionką.
- Wiedza o czym? „Wiedza o niewydolności serca” to za szeroko – obejmuje patofizjologię, której pacjent znać nie musi. „Wiedza o samoopiece w niewydolności serca” jest węższa i lepiej pasuje do pracy pielęgniarskiej. Zapisz jednozdaniową definicję mierzonej wiedzy i wymień jej części. To jest operacjonalizacja zmiennej „poziom wiedzy”.
- Po co? Do porównań grup i pomiaru przed–po potrzebujesz pytań o średniej trudności i miejsca na wzrost. Bez niego pojawi się efekt sufitu: po szkoleniu wszyscy mają komplet punktów i nie widać, kto nauczył się więcej. Jeśli natomiast chcesz sprawdzić, czy pacjenci znają kilka informacji ważnych dla bezpieczeństwa, łatwe pytania są zamierzone.
Oddziel wiedzę od zachowań („Czy waży się Pan(i) codziennie?”) i postaw („Czy uważa Pan(i), że warto…?”). Takie pytania mogą być w ankiecie, ale nie w sumie punktów testu. Test wiedzy zawiera tylko pytania, na które istnieje jedna poprawna odpowiedź, potwierdzona w źródłach.
Krok 2. Źródła treści i karta pytania
Poprawna odpowiedź w teście wiedzy to twierdzenie, które musi wynikać z aktualnego źródła. Opieraj ją na aktualnych wytycznych towarzystw naukowych, podręcznikach i materiałach edukacyjnych placówki, a przy teście dla studentów – na programie przedmiotu. Nie przepisuj pytań z quizów internetowych ani cudzych prac – nie wiesz, na czym opierał się ich klucz.
Wytyczne kliniczne się zmieniają. Pytanie zgodne z wydaniem sprzed kilku lat może mieć dziś inną poprawną odpowiedź. Dlatego dla każdego pytania prowadź kartę pytania: numer, obszar i poziom z tabeli specyfikacji, treść, poprawną odpowiedź, źródło z numerem strony lub rozdziału, datę wydania źródła i krótkie uzasadnienie, dlaczego pozostałe odpowiedzi są błędne. Na jej podstawie powstaje też klucz odpowiedzi.
Napisz więcej pytań, niż potrzebujesz. Boateng i in. (2018) zalecają, żeby wstępna pula pozycji była co najmniej dwa razy dłuższa od planowanej wersji końcowej. Przy teście z 20 pytań oznacza to około 40 kandydatów. Część odpadnie po ocenie ekspertów i wywiadach poznawczych.
Krok 3. Tabela specyfikacji: plan testu przed pisaniem pytań
Tabela specyfikacji (ang. test blueprint) to plan testu. W wierszach są obszary treści, w kolumnach poziomy wymagań, a w komórkach liczba pytań. Raymond i Grande (2019) opisują jej tworzenie w czterech etapach: określenie głównych obszarów wiedzy i umiejętności, sprecyzowanie tego, co ma sprawdzać test w każdym obszarze, wybór sposobu oceny i ustalenie wagi każdego obszaru. Tabela jest też częścią argumentu za trafnością: pokazuje, że test reprezentuje całą wiedzę, o której piszesz, a nie jej przypadkowy wycinek.
Poziomy wymagań wywodzą się z taksonomii celów kształcenia Blooma, w wersji zrewidowanej opisanej przez Krathwohla (2002). W teście wiedzy do pracy dyplomowej zwykle wystarczą trzy poziomy:
| Poziom | Co sprawdza | Schemat pytania |
|---|---|---|
| Zapamiętanie | Rozpoznanie faktu, nazwy, wartości | „Który z wymienionych objawów…?”, „Jak często należy…?” |
| Zrozumienie | Wyjaśnienie, dlaczego coś się robi; rozpoznanie przykładu zasady | „Dlaczego zaleca się…?”, „Które zachowanie jest przykładem…?” |
| Zastosowanie | Użycie wiedzy w krótkim opisie sytuacji (winiecie) | „Pani Anna zauważyła, że… Co powinna zrobić w pierwszej kolejności?” |
Pytania na poziomie zastosowania najlepiej oddają samoopiekę, ale są najdłuższe – w teście dla osób starszych nie przesadzaj z ich liczbą.
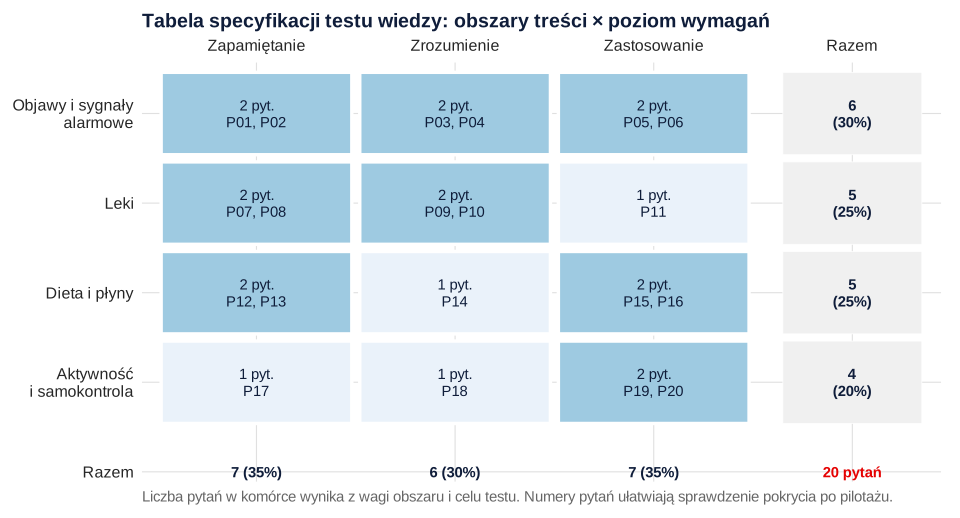
Wagi obszarów ustal według ich znaczenia dla celu badania, a nie według tego, o czym łatwo pisać pytania, i uzgodnij je z promotorem lub ekspertami (krok 8). Numery pytań w komórkach przydadzą się po pilotażu: gdy usuniesz pytanie, od razu zobaczysz, czy w danym obszarze nie zostało go za mało.
Test z kilku obszarów nie musi być jednowymiarowy, a KR-20 całego testu tego nie sprawdza. Jeśli chcesz opisywać obszary osobno, każdy potrzebuje dość pytań – cztery to zwykle za mało.
Krok 4. Ile pytań: liczba pytań a rzetelność
Każde pytanie jest niedoskonałą próbką wiedzy: kto zna temat, czasem się pomyli, kto nie zna – czasem trafi. Im więcej pytań, tym bardziej te przypadki się znoszą. Zależność długości testu i rzetelności opisuje wzór Spearmana–Browna, nazwany od dwóch prac z 1910 roku (Brown, 1910; Spearman, 1910). Kuder i Richardson (1937), wyprowadzając wzory na rzetelność testu, w tym KR-20, pokazali, że wzór Spearmana–Browna jest szczególnym przypadkiem ich ujęcia.
ρ to rzetelność obecnego testu, a n – ile razy zmieniasz jego długość (2 oznacza podwojenie liczby pytań). Przykład: test 10 pytań ma KR-20 = .60. Ile pytań trzeba do .70 albo .80? Tabela zestawia wzór z symulacją w R, w której dodawane pytania są podobnej jakości jak obecne.
| Liczba pytań | KR-20 ze wzoru (start: 10 pytań, .60) | KR-20 w symulacji: średnia [95% wyników] |
|---|---|---|
| 5 | .43 | .43 [.31, .54] |
| 10 | .60 | .60 [.51, .68] |
| 15 | .69 | .69 [.63, .75] |
| 20 | .75 | .75 [.70, .80] |
| 30 | .82 | .82 [.78, .85] |
| 40 | .86 | .86 [.83, .89] |
Do KR-20 = .70 trzeba wydłużyć test 1.56 raza, czyli do 16 pytań, a do .80 – 2.67 raza, czyli do 27 pytań. Rysunek 2 pokazuje, że kolejne pytania dają coraz mniej: przejście z 5 do 10 pytań podnosi KR-20 o .17, a z 30 do 40 – już tylko o .04.
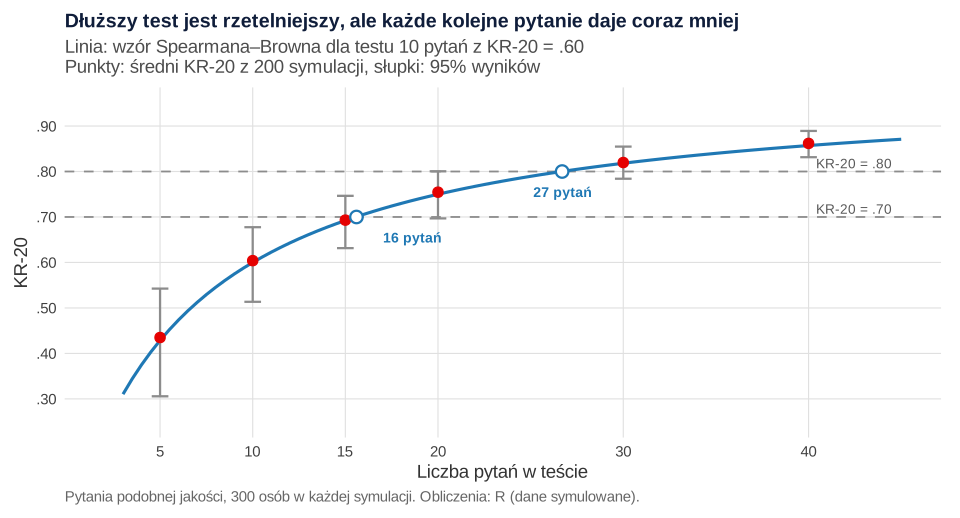
Zastrzeżenie: wzór działa tylko wtedy, gdy nowe pytania są tak samo dobre jak dotychczasowe – pięć pytań, na które wszyscy odpowiadają poprawnie, nie podniesie rzetelności. Działa też w drugą stronę: pokazuje, ile stracisz, skracając test. Więcej o nim przeczytasz w haśle rzetelność połówkowa i wzór Spearmana–Browna.
W praktyce prac dyplomowych testy wiedzy mają najczęściej 15–25 pytań. Górną granicę wyznacza respondent: pacjent po hospitalizacji przy czterdziestu pytaniach zacznie zgadywać albo przerwie.
Krok 5. Format pytań: prawda/fałsz, jednokrotny wybór czy kilka poprawnych
Format decyduje o tym, ile informacji daje pytanie i jak je punktujesz.
| Format | Zalety | Wady | Kiedy |
|---|---|---|---|
| Prawda/fałsz | Szybki do napisania i wypełnienia | 50% szans na trafienie przez zgadywanie; łatwo o twierdzenia „prawie prawdziwe” | Dużo krótkich faktów, test przesiewowy |
| Jednokrotny wybór (3–4 odpowiedzi) | Mniejsza szansa zgadnięcia, łatwe punktowanie 1/0 | Trudno napisać dobre błędne odpowiedzi (dystraktory) | Domyślny wybór w pracy dyplomowej |
| Kilka poprawnych („zaznacz wszystkie”) | Sprawdza pełniejszą wiedzę, np. wszystkie sygnały alarmowe | Wymaga reguły punktowania ustalonej z góry | Gdy wiedza ma naturalnie postać listy |
| Otwarte (krótka odpowiedź) | Brak zgadywania | Potrzebny klucz kodowania i drugi koder | Rzadko; raczej w pilotażu, do zbierania typowych błędów |
Domyślnie wybierz jednokrotny wybór z dwoma–trzema dystraktorami. Haladyna i in. (2002) zebrali w jedną taksonomię 31 zasad pisania takich pytań, opierając się na 27 podręcznikach pomiaru i 27 badaniach. Zasady te (krótkie, jednoznaczne pytanie, podobna długość odpowiedzi, bez podwójnego przeczenia i odpowiedzi „wszystkie powyższe”), przykłady „źle/dobrze” i analizę dystraktorów omawia wpis jak pisać pytania testowe i dystraktory.
Pytania z kilkoma poprawnymi odpowiedziami wymagają reguły ustalonej przed zebraniem danych: punkt tylko za komplet czy punkty cząstkowe? Od niej zależy wynik i rzetelność – porównanie wariantów znajdziesz we wpisie o punktowaniu testu wiedzy. Pamiętaj też o formularzu: w Google Forms takie pytanie trafia do eksportu jako jedna komórka z odpowiedziami rozdzielonymi przecinkami. Jak to zakodować, wyjaśnia wpis o pytaniach wielokrotnego wyboru w ankiecie.
Krok 6. Odpowiedź „nie wiem”
Dodaj do każdego pytania odpowiedź „nie wiem”, jeśli nie masz ważnego powodu, żeby tego nie robić. Bez niej osoba, która nie zna odpowiedzi, zgaduje. Przy czterech odpowiedziach trafi średnio w co czwartym takim pytaniu, a każde trafienie zawyża jej wynik i dodaje do danych szum. Luskin i Bullock (2011) sprawdzili to w dwóch eksperymentach na ogólnokrajowych próbach. Zniechęcanie respondentów do odpowiedzi „nie wiem” w pytaniach zamkniętych wyraźnie zwiększało liczbę poprawnych odpowiedzi, ale ten przyrost w większości wynikał ze zgadywania.
„Nie wiem” daje też informację, której nie widać w sumie punktów: częste „nie wiem” to luka w wiedzy, a częsta konkretna błędna odpowiedź – raczej utrwalone błędne przekonanie. Zasady:
- umieść „nie wiem” zawsze na końcu, oddzielone wizualnie od odpowiedzi merytorycznych;
- w instrukcji napisz wprost: „Jeśli nie znasz odpowiedzi, zaznacz «nie wiem» – nie zgaduj”;
- w formularzu online możesz wtedy ustawić odpowiedź jako wymaganą;
- z góry ustal punktowanie – zwykle „nie wiem” = 0, tak jak odpowiedź błędna.
Dlaczego „nie wiem” nie powinno być brakiem danych i jakie są inne warianty punktowania, wyjaśnia hasło odpowiedź „nie wiem” i „trudno powiedzieć”.
Krok 7. Kolejność pytań i język dostosowany do odbiorcy
Kolejność. Ułóż pytania blokami według obszarów i zacznij od łatwych – trudne pytanie na początku zniechęca pacjentów, którzy obawiają się „egzaminu”. Sprawdź, czy jedno pytanie nie podpowiada odpowiedzi na inne. Rozłóż poprawne odpowiedzi równo między litery – w przykładzie każda z liter A–D jest poprawna w 5 pytaniach – i nie zostawiaj wzoru, który da się odgadnąć. Odpowiedzi liczbowe ustaw rosnąco.
Miejsce w ankiecie. Test wiedzy umieść przed materiałami edukacyjnymi i pytaniami, które mogą zdradzać poprawne odpowiedzi (np. lista tematów ulotek w pytaniu o źródła wiedzy).
Język. Test dla pacjentów pisz tak, jak mówisz do pacjenta w czasie edukacji, a nie tak, jak piszesz w pracy:
- krótkie zdania, jedna informacja w pytaniu;
- słowa codzienne zamiast terminów fachowych („obrzęk nóg” zamiast „obrzęki obwodowe”); jeśli termin jest konieczny, wyjaśnij go w nawiasie;
- bez przeczeń w treści pytania, a zwłaszcza bez podwójnych („Które z poniższych nie jest niezalecane?”);
- bez słów „zawsze” i „nigdy” w błędnych odpowiedziach – doświadczony respondent rozpoznaje je jako błędne bez wiedzy;
- czytelny druk, wystarczająco duża czcionka i dużo miejsca do zaznaczania – szczególnie dla osób starszych.
Zrozumiałość pytań sprawdzi wywiad poznawczy (krok 9).
Krok 8. Ocena ekspertów: trafność treściowa i klucz
Wersję roboczą daj do oceny kilku ekspertom – praktykom (np. pielęgniarkom edukującym pacjentów, lekarzowi, dietetykowi) i osobie znającej konstrukcję testów. Każdy dostaje tabelę specyfikacji i karty pytań i ocenia:
- trafność każdego pytania wobec obszaru, do którego je przypisałeś (zwykle na skali 1–4);
- poprawność klucza – czy wskazana odpowiedź jest jedyną poprawną w świetle aktualnych źródeł;
- jasność sformułowania;
- kompletność – czy w tabeli specyfikacji nie brakuje ważnego obszaru i czy wagi są rozsądne.
Z ocen trafności liczysz wskaźnik trafności treściowej (CVI). Polit i in. (2007) proponują, by przy co najmniej trzech ekspertach uznawać pytania z I-CVI wynoszącym co najmniej .78 za dowód dobrej trafności treściowej. Jak dobrać ekspertów, przygotować formularz, policzyć I-CVI, S-CVI, kappę zmodyfikowaną i CVR i co zrobić z pytaniami o niskiej ocenie, opisuje wpis trafność treściowa testu wiedzy: ocena ekspertów, CVI i CVR.
Ocena klucza jest równie ważna jak ocena trafności: jeśli choć jeden ekspert widzi w pytaniu dwie obronne odpowiedzi, popraw je przed pilotażem.
Krok 9. Wywiad poznawczy i pilotaż
Wywiad poznawczy sprawdza, jak respondenci rozumieją pytania. Kilka osób z grupy docelowej rozwiązuje test na głos albo odpowiada na pytania typu „Co znaczy dla Pana to słowo?”, „Dlaczego wybrała Pani tę odpowiedź?”. Boateng i in. (2018) podają, że zwykle prowadzi się od 5 do 15 takich wywiadów w dwóch–trzech rundach, z poprawkami pytań między rundami. Wywiad wyłapuje pytania, na które ktoś odpowiada poprawnie z błędnego powodu albo źle, bo nie rozumie słowa. Jak to zaplanować i zliczyć problemy, opisuje wpis wywiad poznawczy w pilotażu krok po kroku.
Pilotaż to próbne badanie na kilkudziesięciu osobach z populacji docelowej. Test dla pacjentów pilotuj na pacjentach, a nie na koleżankach z roku, które odpowiedzą poprawnie na prawie wszystko. Sprawdzasz czas wypełniania, braki, uwagi respondentów i analizę pozycji (krok 10). Ogólne zasady i liczebność pilotażu omawia wpis o badaniu pilotażowym.
Pilotaż na 60 osobach nie daje precyzyjnych oszacowań. Boateng i in. (2018) przytaczają dla badań walidacyjnych regułę co najmniej 10 osób na pozycję, czyli 200 osób przy 20 pytaniach. Pilotaż służy do znalezienia wad, a ostateczne liczby – rzetelność i łatwość pytań – podasz z badania głównego.
Krok 10. Analiza pozycji po pilotażu: przykład 20 pytań i 60 osób
Po pilotażu dla każdego pytania policz dwie liczby. Łatwość to odsetek poprawnych odpowiedzi. Moc różnicująca to skorygowana korelacja pozycji z resztą testu, czyli korelacja punktowo-dwuseryjna odpowiedzi 0/1 z sumą pozostałych 19 pytań. Pokazuje ona, czy osoby o większej wiedzy częściej odpowiadają na pytanie poprawnie. Definicje i alternatywny wskaźnik D (różnica między grupą górną i dolną) znajdziesz w haśle analiza pozycji testu.
Reguły decyzji zapisz przed obejrzeniem danych. W przykładzie przyjęto je tak:
| Wynik pytania | Co prawdopodobnie jest nie tak | Decyzja |
|---|---|---|
| Korelacja z resztą < 0 | Błąd w kluczu albo kusząca błędna odpowiedź | Najpierw sprawdź klucz |
| Korelacja z resztą < .20 | Pytanie niejasne, dwie obronne odpowiedzi, treść spoza tematu | Przeredaguj i sprawdź w wywiadzie poznawczym |
| Łatwość > .90 | Pytanie prawie nie różnicuje | Zostaw, jeśli treść jest kluczowa; inaczej zastąp trudniejszym z tej samej komórki tabeli |
| Łatwość < .20 | Treść spoza materiałów, niejasne sformułowanie albo zamierzenie trudne pytanie | Sprawdź treść i klucz |
Próg .20 jest łagodniejszy od .30, który Boateng i in. (2018) podają jako sygnał ostrzegawczy w skalach – w krótkim teście z kilku obszarów korelacje z resztą bywają niższe. Ważne, żeby próg ustalić z góry.
Wyniki pilotażu. Przy kluczu użytym w pilotażu sześćdziesięciu pacjentów uzyskało średnio 11.02 punktu na 20 (SD = 3.86, mediana 11, zakres 3–18), czyli 55.1% poprawnych odpowiedzi. KR-20 wyniósł .76, 95% CI [.65, .82]. Szesnaście pytań nie budzi zastrzeżeń, cztery wymagają decyzji (rysunek 3).
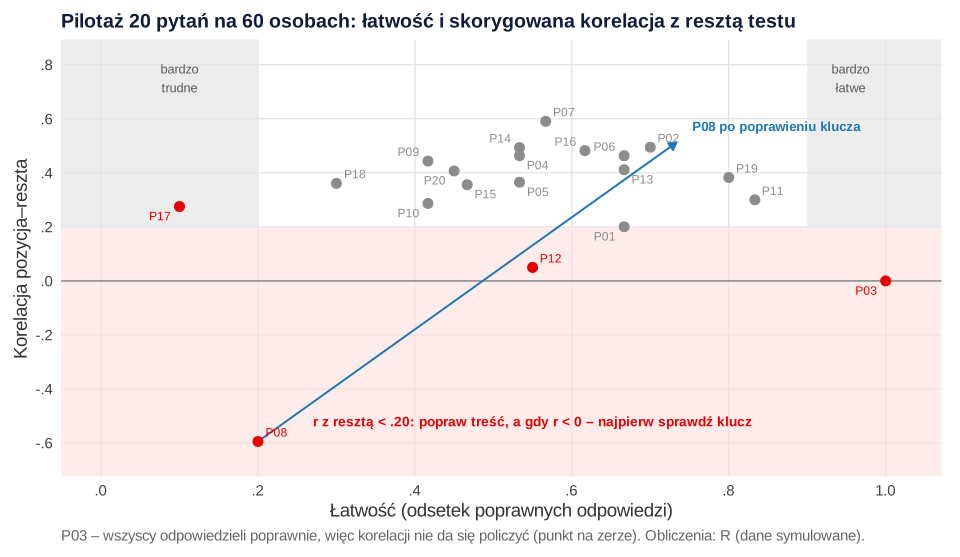
- P08 – błąd w kluczu. Łatwość .20 i korelacja −.59: im większa wiedza, tym rzadziej „poprawna” odpowiedź. W grupie 27% osób z najwyższym wynikiem 89% wybrało odpowiedź C, a w grupie dolnej 44% wybrało B. W kluczu omyłkowo wpisano B zamiast C. Po poprawieniu klucza łatwość wynosi .73, korelacja .51, a KR-20 całego testu wzrasta z .76 do .82. Ujemna korelacja może też oznaczać myląco dobrą błędną odpowiedź, ale klucz sprawdź jako pierwszy.
- P12 – pytanie niejasne. Łatwość .55, ale korelacja z resztą tylko .05: osoby z dużą i małą wiedzą odpowiadały poprawnie równie często. Bez P12 KR-20 wyniósłby .83, ale nie usuwaj go automatycznie – to jedno z dwóch pytań w komórce „Dieta i płyny – zapamiętanie”. Przeredaguj je i sprawdź w kilku wywiadach poznawczych.
- P03 – brak zmienności. Wszyscy odpowiedzieli poprawnie, więc korelacji nie da się policzyć. Zostaw je, jeśli dotyczy informacji, którą każdy pacjent musi znać; inaczej zastąp trudniejszym z tej samej komórki.
- P17 – pytanie bardzo trudne. Poprawnie odpowiedziało tylko 10% osób, a 38% zaznaczyło „nie wiem”. Korelacja (.28) jest dobra, więc pytanie działa. Sprawdź, czy ta treść jest w materiałach dla pacjentów – jeśli tak, wynik to ważna informacja dla edukacji.
Średnia łatwość w obszarach (po poprawieniu klucza) wyniosła .68 dla objawów, .59 dla leków, .57 dla diety i płynów i .41 dla aktywności i samokontroli. Taki przegląd pokazuje, czy któryś obszar nie jest za trudny dla całej grupy.
Jak bardzo ufać liczbom z pilotażu? Niezbyt. Przy 60 osobach 95% przedział ufności dla korelacji .30 sięga od .05 do .51. Powtórzyliśmy ten sam pilotaż 1000 razy na nowych, losowych próbach po 60 osób (z poprawnym kluczem). KR-20 wahał się od .72 do .86 w 95% powtórzeń (mediana .80). Dobre pytania wypadały poniżej progu .20 w 4.3% przypadków – rzadko, ale przy 17 dobrych pytaniach w teście taki fałszywy alarm nie jest niczym niezwykłym. Z kolei niejasne P12 przekroczyło próg .20 w 17.0% pilotaży, więc mogło się „ukryć”. Wniosek: liczby z pilotażu wskazują pytania do przejrzenia, ale decyzję podejmujesz po przeczytaniu pytania, karty pytania i uwag z wywiadów. Pełną analizę pozycji z podziałem odpowiedzi niepoprawnych na błędne i „nie wiem” pokazuje poradnik ankieta wiedzy – analiza krok po kroku, a analizę każdej błędnej odpowiedzi osobno – wpis o dystraktorach.
Po poprawkach to inna wersja testu, więc danych z pilotażu nie dołączaj do badania głównego.
Krok 11. Próg dobrej wiedzy: ustal go przed zebraniem danych
W wielu pracach wynik testu zamienia się na poziomy wiedzy, np. poniżej 60% – niski, 60–79% – średni, od 80% – wysoki. Takie progi są umowne: w tych samych danych odsetek osób z „wysoką wiedzą” może zmienić się kilkukrotnie zależnie od progu (przykład liczbowy jest w poradniku o analizie ankiety wiedzy). Jeśli w pracy potrzebujesz progu, który coś znaczy („pacjent wie dość, żeby bezpiecznie dbać o siebie w domu”), ustal go metodą ekspercką, zanim zobaczysz wyniki. Często stosuje się metodę Angoffa: eksperci oceniają, jaki odsetek minimalnie kompetentnych osób odpowie poprawnie na każde pytanie. Procedurę krok po kroku opisuje wpis próg dobrej wiedzy w teście: metoda Angoffa. Niezależnie od progu główne analizy prowadź na wyniku liczbowym, a poziomy pokazuj opisowo.
Krok 12. Gotowy opis narzędzia do rozdziału metodologicznego
Recenzent pyta: skąd wiadomo, że test mierzy to, co miał mierzyć? Opisz więc drogę, którą test przeszedł. Poniższy wzór dotyczy procedury budowy testu. Akapit o punktacji i rzetelności z badania głównego znajdziesz w trzecim wzorze wpisu opis narzędzia badawczego – wzór. Uzupełnij nawiasy kwadratowe.
Własny test czy gotowy test z literatury?
Zanim zaczniesz budować test od zera, sprawdź, czy ktoś już go nie zbudował i nie sprawdził. Gotowy, opisany test oszczędza pracę, daje mocniejsze dowody trafności i pozwala porównać wyniki z innymi badaniami. Gdzie szukać i jak ocenić narzędzie, opisuje wpis gdzie znaleźć kwestionariusze. Przy gotowym teście pamiętaj o trzech sprawach:
- Prawa do narzędzia. To, że test wydrukowano w artykule albo cudzej pracy dyplomowej, nie oznacza swobody użycia. Sprawdź warunki i w razie wątpliwości poproś autora o zgodę (zob. licencja narzędzia badawczego).
- Aktualność treści. Stary test może mieć klucz niezgodny z obecnymi wytycznymi. Zmiany opisz – po nich wyniki nie są w pełni porównywalne z oryginałem.
- Język i kultura. Test z innego kraju trzeba przetłumaczyć i zaadaptować – nie wystarczy przekład w translatorze. Procedurę opisuje wpis o adaptacji kulturowej kwestionariusza.
Własny test ma sens, gdy gotowego nie ma albo nie pasuje do Twojej grupy – wtedy kroki z tego wpisu są dowodem jakości narzędzia. Inne typowe projekty i analizy w pracach z tej dziedziny zebraliśmy w poradniku statystyka w pracy z pielęgniarstwa.
Najczęstsze błędy przy budowie testu wiedzy
- Pytania bez planu. Bez tabeli specyfikacji połowa testu dotyczy tematu, o którym łatwo pisać pytania, a ważny obszar ma jedno pytanie albo żadnego.
- Mieszanie wiedzy, postaw i zachowań. Pytania „Czy Pan(i)…?” wliczone do sumy punktów testu wiedzy.
- Klucz bez źródła. Odpowiedź „poprawna, bo tak się robi na oddziale” zamiast odpowiedzi opartej na aktualnych wytycznych.
- Za mało pytań. Test z 8 pytań ma zwykle zbyt niską rzetelność do porównań grup.
- Brak odpowiedzi „nie wiem”. Respondenci zgadują, a Ty nie odróżnisz luki w wiedzy od błędnego przekonania.
- Język z podręcznika w teście dla pacjentów. Pacjent zna odpowiedź, ale nie rozumie pytania.
- Pilotaż na niewłaściwej grupie. Test dla pacjentów sprawdzony na studentach wydaje się łatwy i rzetelny tylko w pilotażu.
- Usuwanie pytań wyłącznie według liczb. Przy 60 osobach korelacje z resztą są bardzo niepewne.
- Próg „dobrej wiedzy” wymyślony po zobaczeniu wyników. Progi ustal przed zebraniem danych i podaj ich źródło.
Jeśli chcesz, żeby ktoś przejrzał z Tobą tabelę specyfikacji i klucz albo policzył analizę pozycji po pilotażu i wyjaśnił decyzje, zobacz pomoc w analizie dla studentów.
Test wiedzy w R: liczba pytań, pilotaż i analiza pozycji
Dwa przepisy liczą wszystkie liczby z tekstu i korzystają tylko z bazowego R. Pierwszy pokazuje wzór Spearmana–Browna i sprawdza go symulacją. Drugi tworzy dane pilotażu (odpowiedzi A–D i „nie wiem” zakodowane jako N), zapisuje je w pliku CSV w folderze nadrzędnym (../), punktuje je według klucza, liczy KR-20 z przedziałem bootstrapowym, łatwość i skorygowaną korelację pozycja–reszta, stosuje reguły decyzji, a na końcu powtarza pilotaż 1000 razy. Ziarno drugiego przepisu wybrano tak, żeby próba była typowa – rozrzut wyników z 1000 powtórzeń pokazuje koniec przepisu. Rysunki powstały w osobnym skrypcie na tych samych danych. Dane pilotażu możesz pobrać: test-wiedzy-pilotaz-odpowiedzi.csv (60 osób × 20 pytań; poprawny klucz to wektor klucz_prawdziwy w kodzie).
Liczba pytań a KR-20: wzór Spearmana–Browna i symulacja
R
# B419 – liczba pytań a rzetelność testu wiedzy: wzór Spearmana–Browna i sprawdzenie symulacją
# Dane symulowane: odpowiedzi 0/1 z modelu logistycznego (wiedza osoby, trudność i moc pytania).
set.seed(4191)

# Wzór Spearmana–Browna: rzetelność testu n razy dłuższego (n = nowa liczba pytań / obecna)
sb <- function(rho, n) n * rho / (1 + (n - 1) * rho)
# Ile razy wydłużyć test, żeby osiągnąć rzetelność docelową
krotnosc <- function(rho, cel) cel * (1 - rho) / (rho * (1 - cel))
# KR-20 dla macierzy odpowiedzi 0/1 (osoby w wierszach, pytania w kolumnach)
kr20 <- function(X) {
  k <- ncol(X); p <- colMeans(X); s <- rowSums(X)
  k / (k - 1) * (1 - sum(p * (1 - p)) / mean((s - mean(s))^2))
}

# 1. Przewidywanie ze wzoru: test 10 pytań ma KR-20 = .60
rho10 <- .60
tab <- data.frame(pytan = c(5, 10, 15, 20, 30, 40))
tab$KR20_wzor <- round(sb(rho10, tab$pytan / 10), 2)
print(tab, row.names = FALSE)
for (cel in c(.70, .80)) {
  k <- krotnosc(rho10, cel)
  cat(sprintf("Do KR-20 = %.2f potrzeba %.2f x 10 = %d pytań\n", cel, k, ceiling(10 * k)))
}

# 2. Sprawdzenie symulacją: 200 powtórzeń dla każdej długości testu,
#    za każdym razem 300 nowych osób i nowe pytania z tej samej „puli” trudności i mocy
symuluj_test <- function(k, N = 300) {
  wiedza <- rnorm(N)
  a <- runif(k, 0.6, 1.3)            # moc różnicująca pytań
  b <- rnorm(k, -0.6, 1)             # trudność (test raczej łatwy, jak w badaniach pacjentów)
  P <- plogis(outer(wiedza, b, "-") * matrix(a, N, k, byrow = TRUE))
  X <- matrix(rbinom(N * k, 1, P), N, k)
  kr20(X)
}
dl <- c(5, 10, 15, 20, 30, 40)
sym <- sapply(dl, function(k) replicate(200, symuluj_test(k)))
wynik <- data.frame(pytan = dl,
                    KR20_sredni = round(colMeans(sym), 2),
                    KR20_2.5proc = round(apply(sym, 2, quantile, .025), 2),
                    KR20_97.5proc = round(apply(sym, 2, quantile, .975), 2))
wynik$wzor_z_10_pytan <- round(sb(mean(sym[, 2]), dl / 10), 2)
print(wynik, row.names = FALSE)
write.csv(data.frame(pytan = rep(dl, each = 200), KR20 = round(as.vector(sym), 4)),
          "b419-dlugosc-symulacja.csv", row.names = FALSE)
Wynik w R
 pytan KR20_wzor
     5      0.43
    10      0.60
    15      0.69
    20      0.75
    30      0.82
    40      0.86
Do KR-20 = 0.70 potrzeba 1.56 x 10 = 16 pytań
Do KR-20 = 0.80 potrzeba 2.67 x 10 = 27 pytań
 pytan KR20_sredni KR20_2.5proc KR20_97.5proc wzor_z_10_pytan
     5        0.43         0.31          0.54            0.43
    10        0.60         0.51          0.68            0.60
    15        0.69         0.63          0.75            0.70
    20        0.75         0.70          0.80            0.75
    30        0.82         0.78          0.85            0.82
    40        0.86         0.83          0.89            0.86
Pilotaż 20 pytań na 60 osobach: punktowanie, KR-20, analiza pozycji i 1000 powtórzeń
R
# B419 – pilotaż testu wiedzy: 20 pytań, 60 osób (dane symulowane)
# Test wiedzy pacjentów z niewydolnością serca o samoopiece; 4 obszary treści x 3 poziomy.
set.seed(4197)   # ziarno wybrane tak, by próba była typowa; rozrzut 1000 pilotaży – na końcu
options(width = 110)

# Tabela specyfikacji: obszar i poziom każdego pytania
spec <- data.frame(
  pytanie = sprintf("P%02d", 1:20),
  obszar = rep(c("Objawy", "Leki", "Dieta i płyny", "Aktywność"), c(6, 5, 5, 4)),
  poziom = c("zap", "zap", "zroz", "zroz", "zast", "zast",   # Objawy: 2/2/2
             "zap", "zap", "zroz", "zroz", "zast",           # Leki: 2/2/1
             "zap", "zap", "zroz", "zast", "zast",           # Dieta i płyny: 2/1/2
             "zap", "zroz", "zast", "zast"))                 # Aktywność: 1/1/2
print(table(spec$obszar, spec$poziom)[c("Objawy", "Leki", "Dieta i płyny", "Aktywność"), c("zap", "zroz", "zast")])

# Parametry pytań: a – moc różnicująca, b – trudność. Trzy pytania mają wady „wbudowane” w symulację:
# P03 – prawie wszyscy znają odpowiedź; P12 – niejasne (odpowiedź prawie losowa); P17 – bardzo trudne.
a <- rep(1.2, 20); b <- sample(seq(-1.6, 0.6, length.out = 20))
b[3] <- -3.8; a[12] <- 0.15; b[12] <- 0; b[17] <- 2.4
klucz_prawdziwy <- c("B","D","A","C","A","B","D","C","A","B","C","D","B","A","D","C","B","A","C","D")
klucz_w_pliku <- klucz_prawdziwy
klucz_w_pliku[8] <- "B"   # P08: w kluczu omyłkowo wpisano B zamiast C

symuluj_pilotaz <- function(N = 60) {
  wiedza <- rnorm(N)
  P <- plogis(outer(wiedza, b, "-") * matrix(a, N, 20, byrow = TRUE))
  odp <- matrix("", N, 20)
  for (j in 1:20) {
    dobrze <- rbinom(N, 1, P[, j]) == 1
    dystr <- setdiff(c("A", "B", "C", "D"), klucz_prawdziwy[j])
    nie_wiem <- runif(N) < plogis(-0.4 - wiedza) * ifelse(j == 8, 0.3, 1)  # słabsi częściej: „nie wiem”
    zly <- if (j == 8) sample(dystr, N, TRUE, prob = ifelse(dystr == "B", .70, .15))  # B kusi
           else sample(dystr, N, TRUE)
    odp[, j] <- ifelse(dobrze, klucz_prawdziwy[j], ifelse(nie_wiem, "N", zly))
  }
  colnames(odp) <- spec$pytanie
  odp
}
punktuj <- function(odp, klucz) (odp == matrix(klucz, nrow(odp), 20, byrow = TRUE)) * 1
kr20 <- function(X) {
  k <- ncol(X); p <- colMeans(X); s <- rowSums(X)
  k / (k - 1) * (1 - sum(p * (1 - p)) / mean((s - mean(s))^2))
}
analiza_pozycji <- function(X) {
  data.frame(latwosc = round(colMeans(X), 2),
             r_reszta = round(suppressWarnings(sapply(1:ncol(X), function(j) cor(X[, j], rowSums(X[, -j])))), 2),
             KR20_bez = round(sapply(1:ncol(X), function(j) kr20(X[, -j])), 3))
}

odp <- symuluj_pilotaz(60)
write.csv(data.frame(id = 1:60, odp), "../test-wiedzy-pilotaz-odpowiedzi.csv", row.names = FALSE)
X <- punktuj(odp, klucz_w_pliku)
wynik <- rowSums(X)
cat(sprintf("\nWynik (0–20): M = %.2f, SD = %.2f, Me = %g, min = %d, max = %d; %.1f%% poprawnych\n",
            mean(wynik), sd(wynik), median(wynik), min(wynik), max(wynik), 100 * mean(wynik) / 20))

# KR-20 z przedziałem bootstrapowym (2000 losowań osób ze zwracaniem)
kr_boot <- replicate(2000, kr20(X[sample(60, replace = TRUE), ]))
cat(sprintf("KR-20 = %.2f, 95%% CI bootstrap [%.2f, %.2f]\n",
            kr20(X), quantile(kr_boot, .025), quantile(kr_boot, .975)))

# Analiza pozycji i reguły decyzji zapisane przed pilotażem
tab <- cbind(spec, analiza_pozycji(X), nie_wiem = round(colMeans(odp == "N"), 2))
tab$decyzja <- with(tab, ifelse(is.na(r_reszta), "brak zmienności",
                         ifelse(r_reszta < 0, "sprawdź klucz",
                         ifelse(r_reszta < .20, "popraw treść",
                         ifelse(latwosc > .90, "b. łatwe: zostaw, jeśli kluczowe",
                         ifelse(latwosc < .20, "b. trudne: sprawdź treść", "zostaw"))))))
cat("\n"); print(tab, row.names = FALSE)

# Przy pytaniu z ujemną korelacją sprawdź, którą odpowiedź wybierały osoby z najwyższym wynikiem
gorna <- wynik >= quantile(wynik, .73); dolna <- wynik <= quantile(wynik, .27)
cat("\nP08 – odsetek wyboru odpowiedzi w grupie górnej i dolnej (27%):\n")
print(round(rbind(gorna = prop.table(table(factor(odp[gorna, 8], levels = c("A","B","C","D","N")))),
                  dolna = prop.table(table(factor(odp[dolna, 8], levels = c("A","B","C","D","N"))))), 2))

# Po poprawieniu klucza P08 i po odłożeniu P12 do przeredagowania
X2 <- punktuj(odp, klucz_prawdziwy)
cat(sprintf("\nKR-20 po poprawieniu klucza P08: %.2f (r z resztą dla P08: %.2f)\n",
            kr20(X2), cor(X2[, 8], rowSums(X2[, -8]))))
cat(sprintf("KR-20 po poprawieniu klucza i bez P12 (19 pytań): %.2f\n", kr20(X2[, -12])))
cat("Średnia łatwość w obszarach (klucz poprawiony):\n")
print(round(tapply(colMeans(X2), spec$obszar, mean), 2))

# Jak niepewna jest korelacja z resztą przy 60 osobach? 95% CI dla r = .30 (transformacja Fishera)
z <- atanh(.30); h <- qnorm(.975) / sqrt(60 - 3)
cat(sprintf("\n95%% CI dla r = .30 przy n = 60: [%.2f, %.2f]\n", tanh(z - h), tanh(z + h)))

# Ten sam pilotaż powtórzony 1000 razy (klucz poprawny): jak często dobre pytanie „wypada” poniżej .20?
dobre <- setdiff(1:20, c(3, 12, 17))
rep <- replicate(1000, {
  Xr <- punktuj(symuluj_pilotaz(60), klucz_prawdziwy)
  ar <- analiza_pozycji(Xr)
  c(kr20 = kr20(Xr), dobre_ponizej_20 = mean(ar$r_reszta[dobre] < .20),
    P12_ponizej_20 = ar$r_reszta[12] < .20)
})
cat(sprintf("KR-20 w 1000 pilotażach: mediana %.2f, 95%% wyników między %.2f a %.2f\n",
            median(rep["kr20", ]), quantile(rep["kr20", ], .025), quantile(rep["kr20", ], .975)))
cat(sprintf("Dobre pytania z r z resztą < .20: średnio %.1f%% pytań w pilotażu\n", 100 * mean(rep["dobre_ponizej_20", ])))
cat(sprintf("P12 (niejasne) z r z resztą < .20: w %.1f%% pilotaży\n", 100 * mean(rep["P12_ponizej_20", ])))
write.csv(cbind(tab[, c("pytanie", "obszar", "poziom", "latwosc", "r_reszta", "decyzja")]),
          "b419-analiza-pozycji.csv", row.names = FALSE)
Wynik w R
                zap zroz zast
  Objawy          2    2    2
  Leki            2    2    1
  Dieta i płyny   2    1    2
  Aktywność       1    1    2

Wynik (0–20): M = 11.02, SD = 3.86, Me = 11, min = 3, max = 18; 55.1% poprawnych
KR-20 = 0.76, 95% CI bootstrap [0.65, 0.82]

 pytanie        obszar poziom latwosc r_reszta KR20_bez nie_wiem                  decyzja
     P01        Objawy    zap    0.67     0.20    0.758     0.22                   zostaw
     P02        Objawy    zap    0.70     0.49    0.736     0.22                   zostaw
     P03        Objawy   zroz    1.00       NA    0.761     0.00          brak zmienności
     P04        Objawy   zroz    0.53     0.46    0.737     0.25                   zostaw
     P05        Objawy   zast    0.53     0.37    0.745     0.22                   zostaw
     P06        Objawy   zast    0.67     0.46    0.738     0.18                   zostaw
     P07          Leki    zap    0.57     0.59    0.727     0.32                   zostaw
     P08          Leki    zap    0.20    -0.59    0.803     0.03            sprawdź klucz
     P09          Leki   zroz    0.42     0.44    0.739     0.32                   zostaw
     P10          Leki   zroz    0.42     0.29    0.752     0.37                   zostaw
     P11          Leki   zast    0.83     0.30    0.750     0.08                   zostaw
     P12 Dieta i płyny    zap    0.55     0.05    0.770     0.23             popraw treść
     P13 Dieta i płyny    zap    0.67     0.41    0.742     0.12                   zostaw
     P14 Dieta i płyny   zroz    0.53     0.49    0.735     0.33                   zostaw
     P15 Dieta i płyny   zast    0.47     0.36    0.746     0.25                   zostaw
     P16 Dieta i płyny   zast    0.62     0.48    0.736     0.18                   zostaw
     P17     Aktywność    zap    0.10     0.28    0.752     0.38 b. trudne: sprawdź treść
     P18     Aktywność   zroz    0.30     0.36    0.746     0.33                   zostaw
     P19     Aktywność   zast    0.80     0.38    0.745     0.17                   zostaw
     P20     Aktywność   zast    0.45     0.41    0.742     0.38                   zostaw

P08 – odsetek wyboru odpowiedzi w grupie górnej i dolnej (27%):
         A    B    C    D    N
gorna 0.06 0.00 0.89 0.06 0.00
dolna 0.00 0.44 0.44 0.00 0.12

KR-20 po poprawieniu klucza P08: 0.82 (r z resztą dla P08: 0.51)
KR-20 po poprawieniu klucza i bez P12 (19 pytań): 0.83
Średnia łatwość w obszarach (klucz poprawiony):
    Aktywność Dieta i płyny          Leki        Objawy
         0.41          0.57          0.59          0.68

95% CI dla r = .30 przy n = 60: [0.05, 0.51]
KR-20 w 1000 pilotażach: mediana 0.80, 95% wyników między 0.72 a 0.86
Dobre pytania z r z resztą < .20: średnio 4.3% pytań w pilotażu
P12 (niejasne) z r z resztą < .20: w 83.0% pilotaży
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko pakiety bazowe); rysunki przygotowano w pakietach ggplot2, ggrepel i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed pilotażem i badaniem głównym sprawdź…
- Czy cel testu mówi, czyją wiedzę, o czym i po co mierzysz?
- Czy każde pytanie ma kartę ze źródłem, datą wydania źródła i uzasadnieniem odpowiedzi?
- Czy tabela specyfikacji pokrywa wszystkie ważne obszary, a wagi wynikają z ich znaczenia?
- Czy liczba pytań pozwala oczekiwać KR-20 około .70 także po usunięciu kilku pytań?
- Czy reguła punktowania (także pytań z kilkoma poprawnymi odpowiedziami i „nie wiem”) jest zapisana?
- Czy „nie wiem” jest na końcu, a poprawne odpowiedzi są równo rozłożone między litery?
- Czy eksperci ocenili trafność, klucz i jasność pytań?
- Czy wywiady poznawcze i pilotaż odbyły się w grupie, dla której jest test?
- Czy reguły decyzji po pilotażu i ewentualny próg dobrej wiedzy są ustalone przed analizą?
Najczęstsze pytania
Ile pytań powinien mieć test wiedzy w pracy licencjackiej?
Zwykle 15–25 pytań jednokrotnego wyboru. Mniej pytań daje niską rzetelność: według wzoru Spearmana–Browna test 10 pytań z KR-20 = .60 trzeba wydłużyć do 16 równie dobrych pytań, żeby osiągnąć .70, i do 27, żeby osiągnąć .80. Górną granicę wyznacza cierpliwość respondentów – pacjent po zabiegu nie odpowie rzetelnie na 50 pytań.
Co to jest tabela specyfikacji testu wiedzy (blueprint)?
To plan testu w formie tabeli: wiersze to obszary treści (np. objawy, leki, dieta), kolumny – poziomy wymagań (zapamiętanie, zrozumienie, zastosowanie), a w komórkach jest liczba pytań. Tabela pokazuje, że test obejmuje całą wiedzę, którą chcesz mierzyć, i że ważniejsze obszary mają więcej pytań. Przydaje się też ekspertom, którzy oceniają trafność treściową.
Czy w teście wiedzy pacjentów dawać odpowiedź „nie wiem”?
Zwykle tak. Bez niej osoby, które nie znają odpowiedzi, zgadują, a trafne strzały zawyżają wynik i dodają szum. Odpowiedź „nie wiem” punktuj jak błędną (0), a w analizie pokaż osobno odsetek „nie wiem” i odpowiedzi błędnych – podpowiadają one, gdzie brakuje wiedzy, a gdzie są błędne przekonania.
Ile osób potrzeba do pilotażu testu wiedzy?
Do wykrycia pytań wadliwych (błąd w kluczu, pytanie niejasne, zbyt łatwe) wystarczy kilkadziesiąt osób z populacji docelowej, np. 40–60. To za mało, żeby precyzyjnie oszacować rzetelność czy korelacje pozycji: przy 60 osobach przedział ufności dla korelacji .30 sięga od .05 do .51. Dlatego decyzje po pilotażu opieraj na liczbach i na treści pytania jednocześnie.
Czy mogę użyć testu wiedzy z innej pracy dyplomowej lub artykułu?
Tak, jeśli autor się zgodzi albo test jest udostępniony na licencji, która na to pozwala, i jeśli treść odpowiada aktualnej wiedzy i Twojej grupie. Zawsze podaj źródło, opisz zmiany (np. aktualizację pytań czy uproszczenie języka) i policz rzetelność we własnej próbie. Po każdej zmianie test jest w praktyce nową wersją, więc warto go ponownie przejrzeć z ekspertami i przepilotować.
Powiązane hasła
Przeczytaj też
Analiza wyników sprawdzianu i ewaluacja w szkole
Zadania do poprawy, porównanie klas bez rankingu nauczycieli, dwa sprawdziany, ankieta ewaluacyjna i raport dla rady: Excel, R i gotowe zdania.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikJak pisać pytania testowe i dystraktory
Zasady pisania pytań jednokrotnego wyboru, przykłady źle i lepiej z pielęgniarstwa, trzy czy cztery odpowiedzi i analiza dystraktorów po pilotażu w R.
Czytaj →PoradnikPróg dobrej wiedzy: metoda Angoffa
Jak ustalić próg wiedzy wystarczającej z panelem sędziów: osoba graniczna, dwie rundy, SE progu, grupy kontrastowe i gotowy opis do pracy.
Czytaj →Budujesz test wiedzy do pracy z pielęgniarstwa?
Przejrzymy z Tobą tabelę specyfikacji i klucz, policzymy analizę pozycji i KR-20 po pilotażu w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie uzasadnić każdą zmianę w teście.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Brown, W. (1910). Some experimental results in the correlation of mental abilities. British Journal of Psychology, 3(3), 296–322. https://doi.org/10.1111/j.2044-8295.1910.tb00207.x ● Otwarty dostęp: pełny tekst
- Haladyna, T. M., Downing, S. M., & Rodriguez, M. C. (2002). A review of multiple-choice item-writing guidelines for classroom assessment. Applied Measurement in Education, 15(3), 309–333. https://doi.org/10.1207/s15324818ame1503_5
- Krathwohl, D. R. (2002). A revision of Bloom's taxonomy: An overview. Theory Into Practice, 41(4), 212–218. https://doi.org/10.1207/s15430421tip4104_2 ● Otwarty dostęp: pełny tekst
- Kuder, G. F., & Richardson, M. W. (1937). The theory of the estimation of test reliability. Psychometrika, 2(3), 151–160. https://doi.org/10.1007/BF02288391
- Luskin, R. C., & Bullock, J. G. (2011). “Don't know” means “don't know”: DK responses and the public's level of political knowledge. The Journal of Politics, 73(2), 547–557. https://doi.org/10.1017/s0022381611000132
- Polit, D. F., Beck, C. T., & Owen, S. V. (2007). Is the CVI an acceptable indicator of content validity? Appraisal and recommendations. Research in Nursing & Health, 30(4), 459–467. https://doi.org/10.1002/nur.20199
- Raymond, M. R., & Grande, J. P. (2019). A practical guide to test blueprinting. Medical Teacher, 41(8), 854–861. https://doi.org/10.1080/0142159x.2019.1595556
- Spearman, C. (1910). Correlation calculated from faulty data. British Journal of Psychology, 3(3), 271–295. https://doi.org/10.1111/j.2044-8295.1910.tb00206.x
Cytowania BibTeX
@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{brown1910some, author={Brown, William}, title={{Some experimental results in the correlation of mental abilities}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={296--322}, doi={10.1111/j.2044-8295.1910.tb00207.x}}@article{haladyna2002review, author={Haladyna, Thomas M. and Downing, Steven M. and Rodriguez, Michael C.}, title={{A review of multiple-choice item-writing guidelines for classroom assessment}}, journal={Applied Measurement in Education}, year={2002}, volume={15}, number={3}, pages={309--333}, doi={10.1207/s15324818ame1503_5}}@article{krathwohl2002revision, author={Krathwohl, David R.}, title={{A revision of Bloom's taxonomy: An overview}}, journal={Theory Into Practice}, year={2002}, volume={41}, number={4}, pages={212--218}, doi={10.1207/s15430421tip4104_2}}@article{kuder1937theory, author={Kuder, G. F. and Richardson, M. W.}, title={{The theory of the estimation of test reliability}}, journal={Psychometrika}, year={1937}, volume={2}, number={3}, pages={151--160}, doi={10.1007/bf02288391}}@article{luskin2011dont, author={Luskin, Robert C. and Bullock, John G.}, title={{“Don't know” means “don't know”: DK responses and the public's level of political knowledge}}, journal={The Journal of Politics}, year={2011}, volume={73}, number={2}, pages={547--557}, doi={10.1017/s0022381611000132}}@article{polit2007cvi, author={Polit, Denise F. and Beck, Cheryl Tatano and Owen, Steven V.}, title={{Is the CVI an acceptable indicator of content validity? Appraisal and recommendations}}, journal={Research in Nursing \& Health}, year={2007}, volume={30}, number={4}, pages={459--467}, doi={10.1002/nur.20199}}@article{raymond2019practical, author={Raymond, Mark R. and Grande, Joseph P.}, title={{A practical guide to test blueprinting}}, journal={Medical Teacher}, year={2019}, volume={41}, number={8}, pages={854--861}, doi={10.1080/0142159x.2019.1595556}}@article{spearman1910correlation, author={Spearman, Charles}, title={{Correlation calculated from faulty data}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={271--295}, doi={10.1111/j.2044-8295.1910.tb00206.x}}