Sprawdzian w trzech klasach: co da się policzyć, a czego nie
Nauczyciel matematyki dał ten sam sprawdzian trzem klasom siódmym, a szkoła prowadzi ewaluację wewnętrzną i pyta uczniów, rodziców i nauczycieli o to samo w ankiecie. Z takich danych powstaje wiele prac podyplomowych i magisterskich z pedagogiki, a także sprawozdanie dla rady pedagogicznej. Liczenie jest proste. Trudność leży gdzie indziej: klasa to nie losowa próba, sprawdziany różnią się trudnością, a w ankiecie odpowiada kilkanaście osób. Ten wpis pokazuje cztery analizy na jednym fikcyjnym przykładzie i przy każdej mówi, czego z wyniku nie wolno wywnioskować.
Budowę testu (tabela specyfikacji, liczba pytań, pilotaż) opisuje poradnik jak zbudować test wiedzy, a ogólne zasady analiz w pedagogice (skale Likerta, tabele krzyżowe, uczniowie w klasach) – wpis statystyka w pracy z pedagogiki. Tu zaczynamy od gotowego sprawdzianu.
| Analiza | Pytanie | Co policzyć | Czego nie wnioskować |
|---|---|---|---|
| 1. Jeden sprawdzian | Które zadania działają, a które trzeba poprawić? | rozkład wyników, łatwość, korelacja zadania z resztą, KR-20 | „zadanie jest złe”, zanim sprawdzisz treść i klucz |
| 2. Porównanie klas | Czy klasy różnią się wynikiem? | średnie z 95% CI, wynik przy tym samym poziomie wyjściowym | która klasa ma lepszego nauczyciela |
| 3. Dwa sprawdziany jednej grupy | Czy uczniowie zrobili postęp? | zadania wspólne (kotwiczące), wynik względem grupy | „wyniki spadły”, gdy drugi sprawdzian był trudniejszy |
| 4. Ankieta ewaluacyjna | Jak uczniowie, rodzice i nauczyciele oceniają …? | zwrot ankiet, odsetki z CI, udział „trudno powiedzieć” | wyniki grup kilkuosobowych |
Przykład: 65 uczniów (klasy 7a, 7b i 7c po 24, 22 i 19 osób) rozwiązało 20 zadań po 1 punkcie. Znamy też wynik diagnozy z września. Dane są fikcyjne i symulowane; w symulacji nauczyciel nie ma żadnego wpływu na wynik, a klasy różnią się tylko składem. Dane możesz pobrać jako plik CSV, a kod jest w sekcji Przykład w R.
Jeśli badasz własnych uczniów, przeczytaj też wpis o badaniu we własnym miejscu pracy: nauczyciel, który wystawia oceny, i ten sam nauczyciel jako badacz to dwie role. W pracy i w raporcie nie podawaj nazwisk ani danych, z których da się rozpoznać ucznia.
Analiza 1. Jeden sprawdzian: rozkład wyników i zadania do poprawy
Rozkład wyników
Zacznij od rozkładu sumy punktów, nie od średniej. Uczniowie zdobyli średnio 9.85 punktu na 20 (SD = 4.12, mediana 10, zakres 2–18). Dwunastu uczniów miało 0–5 punktów, 21 – od 6 do 10, 28 – od 11 do 15, a tylko czterech 16–20. Nikt nie zdobył kompletu, więc sprawdzian nie miał efektu sufitu. Wykres liczebności sumy punktów (z osobnym słupkiem dla każdego wyniku) pokaże więcej niż średnia: czy jest grupa uczniów, którzy prawie nic nie zrobili, i czy wyniki układają się w dwa skupiska.
Łatwość i moc różnicująca zadań
Dla każdego zadania policz dwie liczby. Łatwość to odsetek poprawnych odpowiedzi. Moc różnicująca mówi, czy zadanie lepiej rozwiązują uczniowie, którzy dobrze napisali resztę sprawdzianu. Najprościej liczyć ją jako korelację zadania z sumą pozostałych zadań (korelacja z resztą). Wzory, wersję z grupami skrajnymi po 27% uczniów (Kelley, 1939) i interpretację opisuje hasło analiza pozycji testu, a pełny przykład z „nie wiem” – ankieta wiedzy krok po kroku.
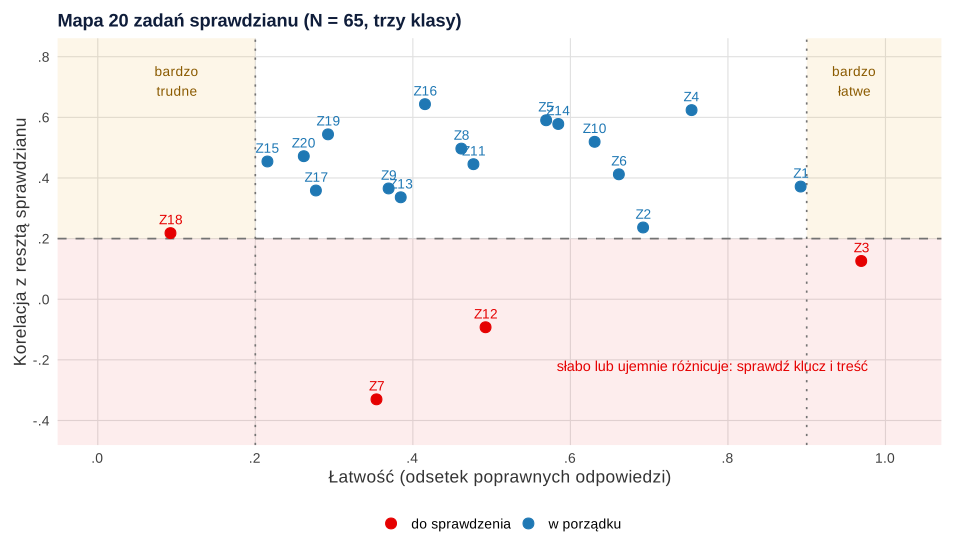
W przykładzie 16 zadań działa przyzwoicie (łatwość od .22 do .89, korelacja z resztą od .24 do .64). Cztery wymagają uwagi:
- Z7 – korelacja ujemna (−.33). Częściej rozwiązywali je słabsi uczniowie. Prawie zawsze oznacza to błąd w kluczu odpowiedzi albo zadanie, które można zrozumieć na dwa sposoby. Tak też było w symulacji: w kluczu zaznaczono złą odpowiedź.
- Z12 – korelacja bliska zera (−.09). Wynik zadania nie wiąże się z resztą sprawdzianu: może mierzyć coś innego (np. czytanie długiej treści) albo być zgadywane. Przejrzyj odpowiedzi uczniów; zasady pisania zadań i analizę błędnych odpowiedzi opisuje wpis o pytaniach testowych i dystraktorach.
- Z3 – łatwość .97. Rozwiązali je prawie wszyscy, więc nie różnicuje. W sprawdzianie kontrolującym opanowanie podstaw takie zadanie bywa zamierzone.
- Z18 – łatwość .09. Za trudne albo nieprzerobione na lekcjach. Zanim je usuniesz, sprawdź, czy materiał był omawiany.
Progi są umowne. Boateng i in. (2018) piszą, że korelacja z resztą poniżej .30 to sygnał, by rozważyć usunięcie pozycji; w krótkim sprawdzianie przyjęliśmy łagodniejszy próg .20, bo korelacje z resztą krótkiego testu bywają niższe. Ustal próg przed analizą. Nie usuwaj zadań mechanicznie: przeczytaj treść, sprawdź klucz, porozmawiaj z uczniami. Rzetelność całego sprawdzianu (KR-20) wyniosła .80, a po usunięciu Z7 i Z12 – .85.
Małe klasy: łatwość licz na całym roczniku
Łatwość jednego zadania w jednej klasie jest bardzo niepewna. Zadanie Z14 rozwiązało 62% uczniów 7a, 59% w 7b i 53% w 7c. Wygląda to na różnicę, ale przedział ufności Wilsona dla 7c (10 z 19 uczniów) to 95% CI [32, 73]%, a dla 7a [43, 79]%. Brown, Cai i DasGupta (2001) zalecają przedział Wilsona właśnie przy małym n, bo zwykły przedział Walda bywa wtedy zawodny. Wniosek: analizę zadań rób na wszystkich uczniach, którzy pisali ten sam sprawdzian, a wyniki zadań w pojedynczej klasie traktuj jako wskazówkę do rozmowy, nie jako dowód.
Łatwość zadania w Excelu: cztery formuły
Jeśli liczysz w arkuszu, ułóż dane tak: jeden wiersz to jeden uczeń, kolumny B–U to zadania Z1–Z20 z wartościami 1 (dobrze) i 0 (źle), kolumna V to suma. Uczniowie zajmują wiersze 2–66. Nazwy funkcji w polskiej wersji pochodzą z pomocy Microsoft (Microsoft, b.d.); w polskich ustawieniach argumenty oddziela średnik.
| Co liczysz | Formuła (zadanie Z1) | Uwagi |
|---|---|---|
| Liczba poprawnych odpowiedzi | =LICZ.JEŻELI(B2:B66;1) | przeciągnij w prawo do kolumny U |
| Łatwość | =ŚREDNIA(B2:B66) | średnia z zer i jedynek to odsetek poprawnych |
| Wynik bez zadania (kolumna pomocnicza W) | =$V2-B2 | w wierszu 2, potem w dół |
| Korelacja z resztą | =WSP.KORELACJI(B2:B66;W2:W66) | dla każdego zadania osobna kolumna pomocnicza |
Pułapka z pustymi komórkami: według pomocy Microsoft funkcja ŚREDNIA pomija puste komórki, ale uwzględnia zera. Jeśli zadanie bez odpowiedzi zostawisz puste, łatwość wyjdzie zawyżona, bo uczeń zniknie z mianownika. Wpisz 0 za brak odpowiedzi (albo ustal inną regułę i opisz ją). Więcej o tym, co Excel liczy dobrze, a czego nie ma, piszemy w poradniku analiza statystyczna w Excelu, a jak zrobić z wyników wykres słupkowy ze słupkami błędów – we wpisie wykresy w Excelu do pracy dyplomowej.
Analiza 2. Porównanie klas: to nie jest ranking nauczycieli
Surowe wyniki wyglądają jednoznacznie: 7b zdobyła średnio 54.5% punktów (95% CI [46.5, 62.6]), 7a 50.4% [40.8, 60.0], a 7c 41.6% [32.3, 50.8]. Różnica między najlepszą a najsłabszą klasą to 13.0 punktu procentowego. Jednoczynnikowa analiza wariancji: F(2, 62) = 2.16, p = .124, η² = .065. Przy tej liczbie uczniów nawet test nie pozwala uznać różnic za wyraźne.
Ważniejsze jest jednak to, z jakim poziomem klasy zaczynały. We wrześniowej diagnozie 7b miała średnio 68.0%, 7a 61.8%, a 7c 57.5%. Gdy porównasz klasy przy tym samym wyniku diagnozy (regresja z diagnozą jako zmienną towarzyszącą), wyniki zbliżają się: 51.1%, 50.2% i 45.8%, a różnice między klasami są nieistotne, F(2, 61) = 0.80, p = .456. W symulacji tak właśnie było: klasy różniły się składem, a nie uczeniem.
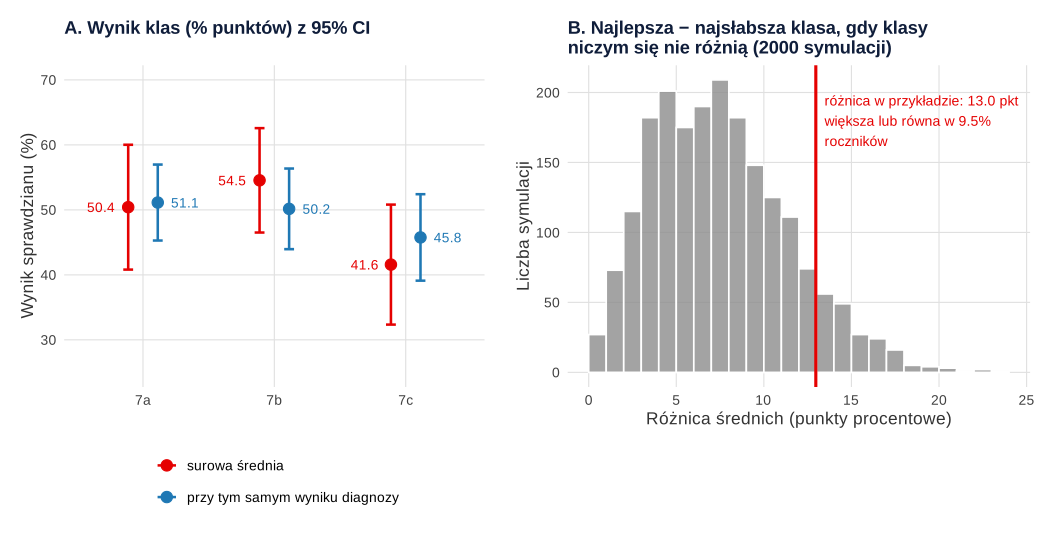
Panel B pokazuje, ile różnicy daje sam przypadek. Gdy uczniów trzech klas tej wielkości losowano z tej samej populacji i dawano im te same zadania, różnica między najlepszą a najsłabszą klasą wynosiła w połowie symulacji 7.2 punktu procentowego lub więcej, w 25.0% symulacji co najmniej 10 punktów, a w 9.5% – co najmniej 13 punktów jak w przykładzie. Klasy po 20 uczniów różnią się o kilka, a nawet kilkanaście punktów bez żadnego powodu. Kane i Staiger (2002) pokazali to samo dla szkół: średnie wyniki małych jednostek są mało precyzyjne, więc na skrajach zestawień częściej lądują małe szkoły. Leckie i Goldstein (2009) stwierdzili, że po uwzględnieniu niepewności tylko nieliczne szkoły w rankingu dało się odróżnić od średniej i od siebie nawzajem.
Czego nie wnioskować z porównania klas
- O nauczycielu. Każda klasa ma innego nauczyciela, inny skład, inną porę lekcji i czasem inną wersję sprawdzianu. Przy jednej klasie na nauczyciela efektu nauczyciela nie da się oddzielić od efektu klasy – to ten sam problem co z dwoma oddziałami w pracy z pedagogiki przedszkolnej.
- O metodzie nauczania. Jeśli 7b uczyła się metodą projektu, a 7c nie, porównanie dwóch klas nie mówi, która metoda działa. Uczniowie jednej klasy są do siebie podobni (mierzy to ICC), więc 22 uczniów z jednej klasy to dużo mniej niż 22 niezależne obserwacje (efekt schematu). Typowe wartości ICC dla osiągnięć szkolnych zebrali Hedges i Hedberg (2007); ten sam mechanizm w grupach studenckich pokazuje wpis o ankiecie na zajęciach.
- O całej szkole z jednej podgrupy. Klasa z lepszym wynikiem może mieć gorsze wyniki w każdej grupie uczniów o podobnym starcie, jeśli ma więcej uczniów mocnych na wejściu. Taki układ to paradoks Simpsona.
Co możesz napisać: opis wyników każdej klasy z przedziałem, porównanie przy tym samym wyniku wyjściowym i zdanie, że różnice mogą wynikać ze składu klas i przypadku. Do pracy, która ma ocenić program, potrzebujesz kilku klas w każdym warunku i analizy na poziomie klas.
Analiza 3. Dwa sprawdziany tej samej grupy: trudność i regresja do średniej
W listopadzie ci sami uczniowie napisali drugi sprawdzian. Średni wynik spadł z 49.2% do 38.3% punktów. Czy uczniowie umieją mniej? W symulacji ich poziom w ogóle się nie zmienił – drugi sprawdzian był po prostu trudniejszy. Odsetek punktów z dwóch różnych sprawdzianów to dwie różne miary i surowo nie wolno ich porównywać.
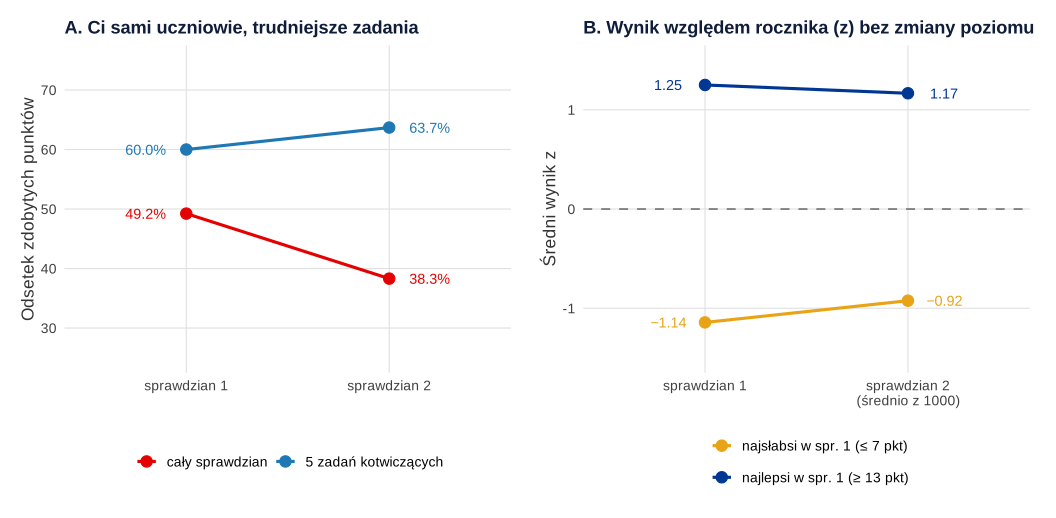
Zadania kotwiczące. Najprostsza ochrona to powtórzenie w drugim sprawdzianie kilku zadań bez zmian. W przykładzie pięć takich zadań uczniowie rozwiązali w 60.0% za pierwszym razem i w 63.7% za drugim. Spadek całego wyniku wynika więc z nowych zadań, nie z uczniów. Formalne przeliczanie wyników dwóch wersji testu na wspólną skalę to zrównywanie wyników; jego metody opisuje podręcznik Kolena i Brennana (2014). W szkole zwykle wystarczy porównywać tylko zadania wspólne albo położenie ucznia względem grupy.
Wynik względem grupy. Wynik standaryzowany z (odległość od średniej grupy w odchyleniach standardowych) albo pozycja centylowa usuwa różnicę trudności, ale ma swoją cenę: średnia z w grupie zawsze wynosi 0, więc nie pokaże, czy cała grupa zrobiła postęp. Mówi tylko, czy uczeń przesunął się względem kolegów. Korelacja wyników obu sprawdzianów wyniosła r = .88.
„Najsłabsi się poprawili”. To najczęstszy wniosek z dwóch sprawdzianów i najczęściej mylący. Uczniowie z wynikiem do 7 punktów w pierwszym sprawdzianie (n = 22) mieli średnio z = −1.14. W drugim sprawdzianie, bez żadnych zajęć wyrównawczych i bez zmiany poziomu, mieli przeciętnie −0.92 (średnia z 1000 powtórzeń), a najlepsi (od 13 punktów, n = 17) spadli z 1.25 do 1.17. To regresja do średniej: w wyniku skrajnym jest też trochę szczęścia lub pecha, które przy kolejnym pomiarze się nie powtarza. Barnett, van der Pols i Dobson (2005) piszą, że efekt jest tym wyraźniejszy, im większy błąd pomiaru i gdy analizuje się tylko podgrupę wybraną na podstawie pierwszego wyniku. W pojedynczym zbiorze bywa różnie: tu najlepsi akurat utrzymali wynik (1.26), dlatego pokazujemy średnią z powtórzeń.
Jeśli w pracy oceniasz zajęcia wyrównawcze dla uczniów z najniższym wynikiem, potrzebujesz grupy porównawczej wybranej tym samym kryterium albo co najmniej drugiego pomiaru przed zajęciami. Co można dodać do planu bez grupy kontrolnej, opisuje wpis badanie bez grupy kontrolnej.
Analiza 4. Ankieta w ewaluacji wewnętrznej: odsetki, „trudno powiedzieć” i małe grupy
Szkoła pyta uczniów, rodziców i nauczycieli o to samo stwierdzenie, np. „Na lekcjach matematyki wiem, czego się ode mnie oczekuje”, w skali od „zdecydowanie nie” do „zdecydowanie tak” ze środkiem „trudno powiedzieć”. W przykładzie odpowiedziało 58 z 65 uczniów, 31 z 65 rodziców i 9 z 12 nauczycieli.
| Grupa | Odpowiedziało (zwrot) | „Raczej” lub „zdecydowanie tak” [95% CI] | To samo bez „trudno powiedzieć” | „Trudno powiedzieć” |
|---|---|---|---|---|
| Uczniowie | 58 z 65 (89.2%) | 53.4% [40.8, 65.7] | 70.5% | 24.1% |
| Rodzice | 31 z 65 (47.7%) | 54.8% [37.8, 70.8] | 77.3% | 29.0% |
| Nauczyciele | 9 z 12 (75.0%) | 66.7% [35.4, 87.9] | 85.7% | 22.2% |
Trzy rzeczy z tej tabeli trafiają do raportu:
- Mianownik zmienia wniosek. Zgadzało się 53.4% uczniów, ale jeśli usuniesz „trudno powiedzieć”, wyjdzie 70.5%. Obie liczby są poprawne, odpowiadają na inne pytania. Podawaj odsetek ze wszystkich odpowiadających, a udział „trudno powiedzieć” osobno. Co ta odpowiedź znaczy i jak ją kodować, opisuje hasło odpowiedź „nie wiem” i „trudno powiedzieć”, a wybór mianownika – wpis o pytaniach filtrujących i mianowniku.
- Przedział zamiast samego procentu. „Dwie trzecie nauczycieli” to 6 osób z 9, a 95% CI Wilsona sięga od 35.4% do 87.9%. Przy tak szerokim przedziale różnica między nauczycielami a uczniami (66.7% wobec 53.4%) niewiele mówi.
- Zwrot ankiet. Odpowiedziało 47.7% rodziców. Jeśli ankietę częściej oddają rodzice zaangażowani, wynik „rodziców” opisuje głównie ich. Podawaj wskaźnik odpowiedzi w każdej grupie.
Anonimowość w małych grupach. Dziewięciu nauczycieli podzielonych według stażu czy przedmiotu daje grupy po 2–4 osoby i każdy w pokoju nauczycielskim zgadnie, kto co odpowiedział. Ustal przed analizą regułę, np. nie pokazujesz wyników grup mniejszych niż 5 osób, i nie podawaj sum, z których ukrytą liczbę da się odjąć. Szczegóły tej reguły i łączenie małych grup opisuje wpis o ankiecie w jednym szpitalu – zasada jest ta sama w szkole.
Raport dla rady pedagogicznej: jedna tabela, jeden wykres, ostrożne zdania
Raport z ewaluacji czy z analizy sprawdzianu czytają osoby, które nie mają czasu na tabele z dziesięcioma kolumnami. Wystarczy zwykle:
- Jedna tabela z liczbą osób, zwrotem ankiet, odsetkiem lub średnią i przedziałem ufności (jak wyżej).
- Jeden wykres: punkty z przedziałami (jak rysunek 2A) zamiast słupków bez niepewności i bez wykresów kołowych.
- Lista zadań do poprawy z mapy zadań – to najbardziej praktyczny wynik analizy sprawdzianu.
- Jedno zdanie o ograniczeniach: liczba osób, skład klas, trudność sprawdzianu, zwrot ankiet.
Istnieją też oficjalne wyniki egzaminów zewnętrznych i wskaźniki dla szkół. Jeśli chcesz się do nich odnieść, korzystaj z opisu metody podanego przez instytucję, która je publikuje, i pamiętaj, że wynik szkolnego sprawdzianu i wynik egzaminu to inne narzędzia.
| Jak bywa napisane | Co nie tak | Lepiej |
|---|---|---|
| „Klasa 7c wypadła najsłabiej, potrzebne są działania naprawcze w pracy nauczyciela”. | Ranking z jednego sprawdzianu, skład klas pominięty, wniosek o nauczycielu. | „Różnice między klasami nie były istotne statystycznie i mogły wynikać z przypadku; przy tym samym wyniku diagnozy były mniejsze”. |
| „Wyniki uczniów spadły o 11 punktów procentowych”. | Dwa sprawdziany o różnej trudności. | „W zadaniach powtórzonych w obu sprawdzianach wynik nie spadł; drugi sprawdzian był trudniejszy”. |
| „Zajęcia wyrównawcze poprawiły wyniki najsłabszych”. | Regresja do średniej, brak grupy porównawczej. | „Uczniowie z najniższym wynikiem zbliżyli się do średniej, czego można oczekiwać także bez zajęć”. |
| „Większość rodziców (77%) jest zadowolona”. | Mianownik bez „trudno powiedzieć”, zwrot 48%. | „Zgodę wyraziło 54.8% odpowiadających rodziców; ankietę oddało 31 z 65”. |
Przykład w R: sprawdzian, klasy i ankieta
Kod odtwarza wszystkie liczby z tego wpisu. Przepis 1 tworzy fikcyjne wyniki sprawdzianu, zapisuje je do pliku CSV i analizuje zadania. Przepis 2 porównuje klasy i symuluje drugi sprawdzian tych samych uczniów; korzysta z obiektów z przepisu 1. Przepis 3 liczy wyniki ankiety. Parametry symulacji (trudność i moc różnicująca zadań, poziom klas, błędny klucz w Z7, trudniejszy drugi sprawdzian, liczby odpowiedzi w ankiecie) ustawiono ręcznie; ziarno losowania to numer wpisu i nie było dobierane pod wynik. Kod rysunków pomijamy; rysunki powstały w pakietach ggplot2, patchwork i svglite. Dane z przepisu 1 możesz pobrać jako plik CSV (kolumny: id, klasa, diagnoza, Z1–Z20, suma).
1. Jeden sprawdzian: rozkład wyników, łatwość, korelacja z resztą, KR-20 i przedział Wilsona
R
# Sprawdzian z matematyki w trzech klasach siódmych: 20 zadań po 1 punkcie (dane fikcyjne, symulowane).
# Klasy różnią się składem (wynik diagnozy z września), ale nie sposobem uczenia: w symulacji
# nauczyciel nie ma żadnego wpływu na wynik. Zadanie Z7 ma błąd w kluczu, Z12 słabo różnicuje.
set.seed(533)
klasa <- factor(rep(c("7a", "7b", "7c"), times = c(24, 22, 19)))
n <- length(klasa)
poziom <- rnorm(n, mean = c("7a" = 0.3, "7b" = 0, "7c" = -0.4)[as.character(klasa)], sd = 1)
diagnoza <- round(pmin(100, pmax(0, 60 + 15 * (poziom + rnorm(n, 0, 0.6)))))  # wrzesień, wynik w %

trudnosc <- c(-1.6, -1.2, -3.2, -0.8, -0.5, -0.9, -0.3, 0.0, 0.2, -0.4,
              0.4, 0.1, 0.6, -0.2, 0.8, 0.3, 1.0, 2.6, 0.5, 1.2)
moc <- c(1.6, 1.4, 1.2, 1.7, 1.5, 1.3, 1.5, 1.6, 1.4, 1.8, 1.5, 0.2, 1.6, 1.4, 1.5, 1.7, 1.3, 1.2, 1.6, 1.4)
odp <- sapply(1:20, function(j) rbinom(n, 1, plogis(moc[j] * (poziom - trudnosc[j]))))
odp[, 7] <- rbinom(n, 1, plogis(-0.6 - 1.2 * poziom))   # Z7: w kluczu zaznaczono złą odpowiedź
colnames(odp) <- paste0("Z", 1:20)
dane <- data.frame(id = sprintf("U%02d", 1:n), klasa, diagnoza, odp)
dane$suma <- rowSums(odp)
write.csv(dane, "sprawdzian-wyniki.csv", row.names = FALSE)

# Krok 1. Rozkład wyników (0–20 punktów)
opis <- function(x) round(c(n = length(x), M = mean(x), SD = sd(x), Me = median(x), min = min(x), max = max(x)), 2)
rbind(wszyscy = opis(dane$suma), t(sapply(split(dane$suma, dane$klasa), opis)))
table(cut(dane$suma, breaks = c(-1, 5, 10, 15, 20), labels = c("0-5", "6-10", "11-15", "16-20")))

# Krok 2. Łatwość zadań i moc różnicująca (wszystkie trzy klasy razem, N = 65)
reszta <- sapply(1:20, function(j) dane$suma - odp[, j])
kolejnosc <- order(dane$suma)
n27 <- round(0.27 * n)                                         # grupy skrajne po 27%
zadania <- data.frame(
  zadanie = colnames(odp),
  latwosc = colMeans(odp),
  r_reszta = sapply(1:20, function(j) cor(odp[, j], reszta[, j])),
  D = colMeans(odp[tail(kolejnosc, n27), ]) - colMeans(odp[head(kolejnosc, n27), ]))
zadania$do_poprawy <- with(zadania, latwosc < .20 | latwosc > .90 | r_reszta < .20)
print(transform(zadania, latwosc = round(latwosc, 2), r_reszta = round(r_reszta, 2), D = round(D, 2)),
      row.names = FALSE)

# Rzetelność KR-20 przed i po usunięciu zadań do poprawy
kr20 <- function(m) { k <- ncol(m); p <- colMeans(m); k / (k - 1) * (1 - sum(p * (1 - p)) / var(rowSums(m))) }
round(c(KR20_20_zadan = kr20(odp), KR20_bez_Z7_Z12 = kr20(odp[, -c(7, 12)])), 3)

# Krok 3. Łatwość jednego zadania w jednej klasie: przedział Wilsona
wilson <- function(x, n, z = qnorm(.975)) {
  p <- x / n; s <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  c(p = p, dolna = (p + z^2 / (2 * n) - s) / (1 + z^2 / n), gorna = (p + z^2 / (2 * n) + s) / (1 + z^2 / n))
}
z14 <- t(sapply(split(dane$Z14, dane$klasa), function(x) c(poprawnie = sum(x), n = length(x), wilson(sum(x), length(x)))))
round(z14, 2)
Wynik w R
         n     M   SD   Me min max
wszyscy 65  9.85 4.12 10.0   2  18
7a      24 10.08 4.55 11.0   2  18
7b      22 10.91 3.62 11.5   4  18
7c      19  8.32 3.83  7.0   4  15

  0-5  6-10 11-15 16-20
   12    21    28     4
 zadanie latwosc r_reszta     D do_poprawy
      Z1    0.89     0.37  0.33      FALSE
      Z2    0.69     0.24  0.33      FALSE
      Z3    0.97     0.13  0.06       TRUE
      Z4    0.75     0.62  0.67      FALSE
      Z5    0.57     0.59  0.78      FALSE
      Z6    0.66     0.41  0.61      FALSE
      Z7    0.35    -0.33 -0.28       TRUE
      Z8    0.46     0.50  0.83      FALSE
      Z9    0.37     0.37  0.56      FALSE
     Z10    0.63     0.52  0.78      FALSE
     Z11    0.48     0.45  0.67      FALSE
     Z12    0.49    -0.09  0.00       TRUE
     Z13    0.38     0.34  0.56      FALSE
     Z14    0.58     0.58  0.78      FALSE
     Z15    0.22     0.45  0.56      FALSE
     Z16    0.42     0.64  0.89      FALSE
     Z17    0.28     0.36  0.50      FALSE
     Z18    0.09     0.22  0.22       TRUE
     Z19    0.29     0.54  0.72      FALSE
     Z20    0.26     0.47  0.56      FALSE
  KR20_20_zadan KR20_bez_Z7_Z12
          0.804           0.854
   poprawnie  n    p dolna gorna
7a        15 24 0.62  0.43  0.79
7b        13 22 0.59  0.39  0.77
7c        10 19 0.53  0.32  0.73
2. Porównanie klas i dwa sprawdziany tych samych uczniów
R
# Przepis 2: uruchom w tej samej sesji po przepisie 1 (korzysta z obiektów dane, poziom, trudnosc, moc).
# Część A. Porównanie trzech klas: surowe średnie, średnie przy tym samym wyniku diagnozy,
# i jak bardzo kolejność klas zmienia się z samego przypadku.
dane$procent <- 100 * dane$suma / 20
srednie <- t(sapply(split(dane$procent, dane$klasa), function(x) {
  ci <- t.test(x)$conf.int; c(n = length(x), M = mean(x), dolna = ci[1], gorna = ci[2]) }))
round(srednie, 1)
round(sapply(split(dane$diagnoza, dane$klasa), mean), 1)       # średni wynik diagnozy z września

a <- anova(lm(procent ~ klasa, data = dane))
round(c(F = a$`F value`[1], df1 = a$Df[1], df2 = a$Df[2], p = a$`Pr(>F)`[1],
        eta2 = a$`Sum Sq`[1] / sum(a$`Sum Sq`)), 3)

m <- lm(procent ~ klasa + diagnoza, data = dane)               # przy tym samym wyniku diagnozy
nowe <- data.frame(klasa = levels(dane$klasa), diagnoza = mean(dane$diagnoza))
skor <- predict(m, nowe, interval = "confidence")
rownames(skor) <- levels(dane$klasa); round(skor, 1)
round(anova(lm(procent ~ diagnoza, data = dane), m)[2, c("F", "Pr(>F)")], 3)

# Ile wynosi różnica między najlepszą a najsłabszą klasą, gdy klasy NICZYM się nie różnią?
# 2000 roczników: uczniowie losowani z tej samej populacji, te same zadania, klasy po 24, 22 i 19 osób.
rozstep <- replicate(2000, {
  p <- rnorm(n)
  o <- sapply(1:20, function(j) rbinom(n, 1, plogis(moc[j] * (p - trudnosc[j]))))
  o[, 7] <- rbinom(n, 1, plogis(-0.6 - 1.2 * p))
  diff(range(tapply(100 * rowSums(o) / 20, dane$klasa, mean)))
})
obserwowany <- diff(range(srednie[, "M"]))
round(c(obserwowany = obserwowany, mediana_rozstepu = median(rozstep),
        proc_co_najmniej_obserwowany = 100 * mean(rozstep >= obserwowany),
        proc_co_najmniej_10_pkt = 100 * mean(rozstep >= 10)), 1)

# Część B. Drugi sprawdzian tych samych uczniów: poziom się nie zmienił, ale zadania są trudniejsze.
# Pięć zadań (K1–K5) powtórzono bez zmian z pierwszego sprawdzianu (zadania Z4, Z5, Z8, Z10, Z14).
kotwice <- c(4, 5, 8, 10, 14)
trudnosc2 <- c(trudnosc[kotwice], trudnosc[-c(kotwice, 3, 7, 12, 18)] + 0.8, 0.9, 1.1, 0.7, 1.3)
moc2 <- c(moc[kotwice], rep(1.5, 15))
odp2 <- sapply(1:20, function(j) rbinom(n, 1, plogis(moc2[j] * (poziom - trudnosc2[j]))))
dane$suma2 <- rowSums(odp2)
round(c(proc_spr1 = mean(dane$procent), proc_spr2 = mean(100 * dane$suma2 / 20),
        kotwice_spr1 = 100 * mean(odp[, kotwice]), kotwice_spr2 = 100 * mean(odp2[, 1:5]),
        r_spr1_spr2 = cor(dane$suma, dane$suma2)), 2)

# Wynik względem rocznika (z) w każdym sprawdzianie i „najsłabsi” z pierwszego sprawdzianu
dane$z1 <- as.numeric(scale(dane$suma)); dane$z2 <- as.numeric(scale(dane$suma2))
najslabsi <- dane$suma <= quantile(dane$suma, .25)
najlepsi <- dane$suma >= quantile(dane$suma, .75)
quantile(dane$suma, c(.25, .75))                               # progi w punktach (0–20)
round(rbind(najslabsi = c(n = sum(najslabsi), z_spr1 = mean(dane$z1[najslabsi]), z_spr2 = mean(dane$z2[najslabsi])),
            najlepsi = c(n = sum(najlepsi), z_spr1 = mean(dane$z1[najlepsi]), z_spr2 = mean(dane$z2[najlepsi]))), 2)

# To samo w 1000 powtórzeniach drugiego sprawdzianu (ci sami uczniowie, te same grupy z pierwszego)
z2_powt <- replicate(1000, {
  o2 <- sapply(1:20, function(j) rbinom(n, 1, plogis(moc2[j] * (poziom - trudnosc2[j]))))
  z <- as.numeric(scale(rowSums(o2))); c(najslabsi = mean(z[najslabsi]), najlepsi = mean(z[najlepsi]))
})
round(rowMeans(z2_powt), 2)
Wynik w R
    n    M dolna gorna
7a 24 50.4  40.8  60.0
7b 22 54.5  46.5  62.6
7c 19 41.6  32.3  50.8
  7a   7b   7c
61.8 68.0 57.5
     F    df1    df2      p   eta2
 2.158  2.000 62.000  0.124  0.065
    fit  lwr  upr
7a 51.1 45.3 57.0
7b 50.2 44.0 56.4
7c 45.8 39.1 52.4
      F Pr(>F)
2 0.795  0.456
                 obserwowany             mediana_rozstepu
                        13.0                          7.2
proc_co_najmniej_obserwowany      proc_co_najmniej_10_pkt
                         9.5                         25.0
   proc_spr1    proc_spr2 kotwice_spr1 kotwice_spr2  r_spr1_spr2
       49.23        38.31        60.00        63.69         0.88
25% 75%
  7  13
           n z_spr1 z_spr2
najslabsi 22  -1.14  -1.00
najlepsi  17   1.25   1.26
najslabsi  najlepsi
    -0.92      1.17
3. Ankieta ewaluacyjna: zwrot, odsetki z przedziałem Wilsona i „trudno powiedzieć”
R
# Przepis 3: ankieta w ewaluacji wewnętrznej (dane fikcyjne). Jedno stwierdzenie:
# „Na lekcjach matematyki wiem, czego się ode mnie oczekuje” (wersje dla uczniów, rodziców, nauczycieli).
options(width = 110)
odpowiedzi <- c("zdecydowanie nie", "raczej nie", "trudno powiedzieć", "raczej tak", "zdecydowanie tak")
liczby <- rbind(uczniowie  = c(4, 9, 14, 21, 10),
                rodzice    = c(1, 4, 9, 11, 6),
                nauczyciele = c(0, 1, 2, 4, 2))
colnames(liczby) <- odpowiedzi
zaproszeni <- c(uczniowie = 65, rodzice = 65, nauczyciele = 12)
liczby

wilson <- function(x, n, z = qnorm(.975)) {
  p <- x / n; s <- z * sqrt(p * (1 - p) / n + z^2 / (4 * n^2))
  100 * c(proc = p, dolna = (p + z^2 / (2 * n) - s) / (1 + z^2 / n), gorna = (p + z^2 / (2 * n) + s) / (1 + z^2 / n))
}
odpowiedzialo <- rowSums(liczby)
zgoda <- liczby[, "raczej tak"] + liczby[, "zdecydowanie tak"]
trudno <- liczby[, "trudno powiedzieć"]
wynik <- cbind(zaproszeni, odpowiedzialo, zwrot_proc = 100 * odpowiedzialo / zaproszeni,
               t(mapply(wilson, zgoda, odpowiedzialo)),                       # mianownik: wszyscy odpowiadający
               proc_bez_trudno = 100 * zgoda / (odpowiedzialo - trudno),     # mianownik: bez „trudno powiedzieć”
               proc_trudno = 100 * trudno / odpowiedzialo)
round(wynik, 1)
Wynik w R
            zdecydowanie nie raczej nie trudno powiedzieć raczej tak zdecydowanie tak
uczniowie                  4          9                14         21               10
rodzice                    1          4                 9         11                6
nauczyciele                0          1                 2          4                2
            zaproszeni odpowiedzialo zwrot_proc proc dolna gorna proc_bez_trudno proc_trudno
uczniowie           65            58       89.2 53.4  40.8  65.7            70.5        24.1
rodzice             65            31       47.7 54.8  37.8  70.8            77.3        29.0
nauczyciele         12             9       75.0 66.7  35.4  87.9            85.7        22.2
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), anova(), t.test(), cor() i rbinom() z pakietu stats); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Usuwanie zadań tylko na podstawie liczb. Zadanie z ujemną korelacją najpierw sprawdź w kluczu – w przykładzie Z7 miało błędny klucz.
- Analiza zadań w każdej klasie osobno. Przy 19 uczniach łatwość zadania ma przedział szeroki na 40 punktów procentowych.
- Puste komórki zamiast zer w Excelu. ŚREDNIA je pomija i zawyża łatwość.
- Ranking klas i wnioski o nauczycielach. Różnica 13 punktów zdarzała się w 9.5% symulacji, w których klasy niczym się nie różniły.
- Porównanie odsetków z dwóch różnych sprawdzianów. Spadek z 49.2% do 38.3%, choć wynik zadań kotwiczących nie spadł (60.0% i 63.7%).
- „Poprawa najsłabszych” bez grupy porównawczej – to regresja do średniej.
- Procent bez mianownika i bez zwrotu ankiet, wyniki grup kilkuosobowych.
Lista kontrolna przed raportem lub rozdziałem wyników
- Czy brak odpowiedzi w zadaniu jest zakodowany jako 0 (albo według opisanej reguły)?
- Czy sprawdziłeś treść i klucz zadań z korelacją z resztą poniżej .20?
- Czy analizę zadań zrobiłeś na wszystkich uczniach, którzy pisali ten sam sprawdzian?
- Czy przy porównaniu klas podajesz przedziały ufności i wynik wyjściowy klas?
- Czy żadne zdanie nie ocenia nauczyciela na podstawie wyniku jednej klasy?
- Czy dwa sprawdziany mają zadania wspólne albo czy porównujesz tylko położenie względem grupy?
- Czy w ankiecie podajesz zwrot w każdej grupie, mianownik i udział „trudno powiedzieć”?
- Czy żadna grupa w raporcie nie liczy mniej niż 5 osób?
Jeśli potrzebujesz pomocy w analizie danych ze szkoły do pracy dyplomowej, zajrzyj do oferty analizy statystyczne dla studentów. Wyniki i ich ograniczenia musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Jak policzyć łatwość zadania w sprawdzianie?
Zakoduj każde zadanie jako 1 (poprawnie) i 0 (źle lub brak odpowiedzi) i policz średnią z kolumny – to odsetek uczniów, którzy rozwiązali zadanie. W polskim Excelu wystarczy =ŚREDNIA(B2:B66), ale brak odpowiedzi wpisz jako 0, bo funkcja pomija puste komórki. Obok łatwości policz korelację zadania z sumą pozostałych zadań, która pokazuje, czy zadanie różnicuje uczniów.
Czy można porównać wyniki sprawdzianu w dwóch klasach i ocenić nauczycieli?
Wyniki klas można opisać i porównać z przedziałami ufności, ale nie można z nich ocenić nauczyciela. Klasy różnią się składem, porą lekcji i warunkami, a przy około 20 uczniach różnica kilku lub kilkunastu punktów procentowych pojawia się często przez sam przypadek. Porównuj klasy przy tym samym wyniku wyjściowym i pisz o różnicach ostrożnie.
Jak porównać wyniki dwóch sprawdzianów, jeśli drugi był trudniejszy?
Nie porównuj surowych odsetków punktów, bo spadek może wynikać tylko z trudności zadań. Powtórz w drugim sprawdzianie kilka zadań bez zmian i porównuj wyniki tych zadań albo porównuj położenie ucznia względem grupy (wynik z lub centyl). Pamiętaj, że średni wynik z grupy zawsze wynosi 0, więc nie pokaże postępu całej grupy.
Jak opisać wyniki ankiety ewaluacyjnej, gdy odpowiedziało kilka osób?
Podaj liczbę osób i zwrot ankiet, odsetek z przedziałem ufności (np. Wilsona) i udział odpowiedzi „trudno powiedzieć”. Przy 9 nauczycielach przedział dla odsetka 66.7% sięga od 35.4% do 87.9%, więc taki wynik jest tylko orientacyjny. Nie pokazuj wyników grup mniejszych niż 5 osób, żeby nie dało się rozpoznać, kto co odpowiedział.
Dlaczego najsłabsi uczniowie poprawiają wynik w kolejnym sprawdzianie?
Częściowo przez regresję do średniej: w bardzo niskim wyniku jest też pech, który przy kolejnym pomiarze się nie powtarza. W przykładzie uczniowie z najniższym wynikiem zbliżyli się do średniej (z od −1.14 do −0.92), choć ich poziom się nie zmienił. Dlatego poprawy najsłabszych po zajęciach wyrównawczych nie przypisuj zajęciom bez grupy porównawczej.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →PoradnikAnkieta wiedzy – analiza krok po kroku
Punktacja z „nie wiem”, poziomy wiedzy, KR-20, analiza pozycji, testy rangowe i źródła wiedzy – na danych do pobrania, z kodem R i opisem APA.
Czytaj →PoradnikJak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikWykresy w Excelu do pracy dyplomowej
Słupki błędów z UFNOŚĆ.T, histogram, linia trendu i R², Likert 100% skumulowany i wykres przed–po – krok po kroku, z plikiem XLSX i przenoszeniem do Worda.
Czytaj →Analizujesz wyniki uczniów albo ankietę ewaluacyjną do pracy dyplomowej?
Pomożemy przeanalizować sprawdzian, porównać klasy i opracować ankietę z ewaluacji tak, żeby wnioski nie wychodziły poza dane – i wyjaśnimy wyniki, żebyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Boateng, G. O., Neilands, T. B., Frongillo, E. A., Melgar-Quiñonez, H. R., & Young, S. L. (2018). Best practices for developing and validating scales for health, social, and behavioral research: A primer. Frontiers in Public Health, 6, Article 149. https://doi.org/10.3389/fpubh.2018.00149 ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Hedges, L. V., & Hedberg, E. C. (2007). Intraclass correlation values for planning group-randomized trials in education. Educational Evaluation and Policy Analysis, 29(1), 60–87. https://doi.org/10.3102/0162373707299706
- Kane, T. J., & Staiger, D. O. (2002). The promise and pitfalls of using imprecise school accountability measures. Journal of Economic Perspectives, 16(4), 91–114. https://doi.org/10.1257/089533002320950993
- Kelley, T. L. (1939). The selection of upper and lower groups for the validation of test items. Journal of Educational Psychology, 30(1), 17–24. https://doi.org/10.1037/h0057123
- Kolen, M. J., & Brennan, R. L. (2014). Test equating, scaling, and linking: Methods and practices (3rd ed.). Springer. https://doi.org/10.1007/978-1-4939-0317-7
- Leckie, G., & Goldstein, H. (2009). The limitations of using school league tables to inform school choice. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(4), 835–851. https://doi.org/10.1111/j.1467-985x.2009.00597.x
- Microsoft. (b.d.). Funkcje statystyczne (informacje). Microsoft Support. Pobrano 10 listopada 2026 z https://support.microsoft.com/pl-pl/excel/statistical-functions-reference ● Otwarty dostęp
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{boateng2018best, author={Boateng, Godfred O. and Neilands, Torsten B. and Frongillo, Edward A. and Melgar-Quiñonez, Hugo R. and Young, Sera L.}, title={{Best practices for developing and validating scales for health, social, and behavioral research: A primer}}, journal={Frontiers in Public Health}, year={2018}, volume={6}, eid={149}, doi={10.3389/fpubh.2018.00149}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{hedges2007intraclass, author={Hedges, Larry V. and Hedberg, E. C.}, title={{Intraclass correlation values for planning group-randomized trials in education}}, journal={Educational Evaluation and Policy Analysis}, year={2007}, volume={29}, number={1}, pages={60--87}, doi={10.3102/0162373707299706}}@article{kane2002promise, author={Kane, Thomas J. and Staiger, Douglas O.}, title={{The promise and pitfalls of using imprecise school accountability measures}}, journal={Journal of Economic Perspectives}, year={2002}, volume={16}, number={4}, pages={91--114}, doi={10.1257/089533002320950993}}@article{kelley1939selection, author={Kelley, Truman L.}, title={{The selection of upper and lower groups for the validation of test items}}, journal={Journal of Educational Psychology}, year={1939}, volume={30}, number={1}, pages={17--24}, doi={10.1037/h0057123}}@book{kolen2014test, author={Kolen, Michael J. and Brennan, Robert L.}, title={{Test equating, scaling, and linking: Methods and practices (3rd ed.)}}, year={2014}, publisher={Springer}, doi={10.1007/978-1-4939-0317-7}}@article{leckie2009limitations, author={Leckie, George and Goldstein, Harvey}, title={{The limitations of using school league tables to inform school choice}}, journal={Journal of the Royal Statistical Society: Series A (Statistics in Society)}, year={2009}, volume={172}, number={4}, pages={835--851}, doi={10.1111/j.1467-985x.2009.00597.x}}@misc{microsoftndfunkcjestatystyczne, author={{Microsoft}}, title={{Funkcje statystyczne (informacje)}}, howpublished={Microsoft Support}, publisher={Microsoft}, url={https://support.microsoft.com/pl-pl/excel/statistical-functions-reference}}