Badasz tam, gdzie pracujesz: wygoda i jej cena
Masz dostęp do osób, znasz miejsce, dyrekcja Cię kojarzy. Dlatego tak wiele prac powstaje na własnym oddziale, we własnej klasie albo we własnej firmie. Ta sama bliskość, która ułatwia rekrutację, zmienia to, co ludzie odpowiadają, i to, czy czują, że mogą odmówić. Ten wpis pokazuje, jak zaplanować zbieranie danych, żeby autor pracy nie stał nad ankietą, ile może kosztować brak takiego rozdzielenia i co napisać w Metodzie.
Reszta tematu ma osobne strony. Jak przedstawić zależność komisji, opisuje wpis o wniosku do komisji, a o dostęp prosi się pismem do placówki. Liczenie populacji i odsetka odpowiedzi w jednym szpitalu wyjaśnia ankieta wśród personelu, opis programu, który sam prowadzisz, ewaluacja programu, a cykl zmian we własnej praktyce badanie w działaniu. To nie jest porada prawna: zasady komisji, placówki i uczelni mają pierwszeństwo.
Przykład przewodni (fikcyjny, dane symulowane). Pielęgniarka pisze magisterkę o edukacji przedoperacyjnej, którą sama prowadzi. Przed wypisem pyta pacjentów, jak oceniają swoje przygotowanie do samoopieki (6 pozycji, skala 1–5). Pyta osobiście, przy łóżku, a ankietę odbiera z ręki.
Trzy układy, trzy rodzaje zależności
Zależność nie zawsze wygląda jak władza. Czasem to wdzięczność, czasem obawa o ocenę, a czasem zwykła niezręczność wobec osoby, którą spotkasz jutro w pokoju socjalnym.
| Układ | Od czego zależy badany | Co może przesuwać odpowiedzi | Główne ryzyko dla wyników |
|---|---|---|---|
| Klinicysta i swoi pacjenci | Od dalszej opieki, od relacji z osobą, która go leczy | Wdzięczność, chęć bycia „dobrym pacjentem” | Zawyżona ocena opieki i poprawy; klinicysta prowadzi badanie jak wizytę |
| Nauczyciel i swoi uczniowie lub studenci | Od oceny, zaliczenia, opinii | Obawa o ocenę, chęć zadowolenia nauczyciela | Zawyżona ocena zajęć, odpowiedzi „pod wynik”, pozorna dobrowolność |
| Pracownik i współpracownicy lub podwładni | Od relacji w zespole, oceny okresowej, premii | Lojalność, obawa przed rozpoznaniem | Złagodzone oceny przełożonych i warunków pracy; łatwa identyfikacja w małych zespołach |
Przegląd Hay-Smith i in. (2016) opisuje, że klinicyści prowadzący badania powielają w nich zachowania z pracy klinicznej, a relacja z uczestnikiem zaczyna przypominać relację z pacjentem. Przegląd opiera się na opisach doświadczeń, więc mówi, że tak się dzieje, ale nie jak często. Clark i McCann (2005) zauważają, że problemy etyczne rosną, gdy badacz uczy tych, których bada. Ich zdaniem da się to zrobić etycznie, także na małym kampusie, a ważną rolę ma rozmowa z komisją. Sytuację uczniów niepełnoletnich omawia wpis o badaniach z udziałem dzieci i młodzieży.
Czego się obawiać i co z tym zrobić
Każdy wiersz to osobna decyzja. Podejmij ją przed rekrutacją, bo po zebraniu danych zostaje już tylko opis ograniczenia.
| Zagrożenie | Co zrobić | Co napisać w Metodzie |
|---|---|---|
| Zgoda pod presją: odmowa wydaje się ryzykowna | Zaprasza osoba spoza opieki, oceny lub podległości albo ogłoszenie; autor nie wie, kto odmówił; odmowa bez skutków, zapisana w informacji dla uczestnika | Kto zapraszał, jaką ma funkcję; czy autor znał odmowy |
| Odpowiedzi pod ocenę: aprobata społeczna | Wypełnianie samodzielne, bez autora w pokoju; link lub urna zamiast oddawania do ręki | Kto, gdzie i w jakiej formie zbierał dane; czy autor był obecny |
| Anonimowość w małych grupach | Mniej pytań metryczki, szerokie przedziały, próg raportowania ustalony przed analizą; do łączenia pomiarów kod identyfikacyjny | Próg raportowania, poziom szczegółowości metryczki, sposób łączenia pomiarów |
| Wiedza badacza o badanych: wiesz, kto jaki jest i kto był w programie | Pomiar lub ocenę prowadzi ktoś, kto nie zna grupy (zaślepienie oceniającego); odpowiedzi kodowane przed Twoją analizą | Kto oceniał, czy znał przydział, czy autor widział nazwiska |
| Przydział we własnej placówce | Pacjenci, uczniowie i koledzy rozmawiają. Ogranicz kontaminację i zadbaj o ukrycie przydziału: losuje ktoś inny, nie Ty przy łóżku | Jednostka przydziału, kto losował, jak ograniczono przenikanie programu |
| Dostęp do dokumentacji | Dostęp służbowy to nie to samo co zgoda na badanie: zapytaj komisję i placówkę. Dane wypisuje osoba do tego uprawniona, tylko zmienne z planu | Źródło danych, kto je wypisał, numer i data zgody |
| Role po badaniu: wyniki wracają do zespołu, a Ty zostajesz | Tylko wyniki zbiorcze; klucz kodów nie u autora; ustal z góry, co dostanie dyrekcja | Kto ma surowe dane; w jakiej formie przekazano wyniki placówce |
Przy kontaminacji warto pamiętać o koszcie obu wyjść. Torgerson (2001) wskazuje, że przenikanie programu do grupy kontrolnej zaniża oszacowany efekt i sprzyja błędowi II rodzaju. Losowanie całych oddziałów wymaga jednak większej próby i grozi błędem rekrutacji, a pod względem łącznej liczebności jest wydajniejsze dopiero przy kontaminacji powyżej 30%. Wybór warunku porównawczego omawia wpis o grupie kontrolnej.
Wiedza oceniającego ma mierzalny skutek. W przeglądzie Hróbjartssona i in. (2013), obejmującym badania z tym samym wynikiem ocenianym przez zaślepionych i niezaślepionych obserwatorów, ocena niezaślepiona na skalach subiektywnych dawała efekt korzystniejszy (różnica wielkości efektu −0.23, 95% CI [−0.40, −0.06]). To badania kliniczne, ale mechanizm oczekiwań badacza nie kończy się na medycynie.
Co wiadomo o odpowiedziach pod okiem badacza
Krumpal (2013) w przeglądzie pokazuje, że w pytaniach drażliwych respondenci zaniżają zachowania niepożądane i zawyżają pożądane, a skala zniekształcenia zależy m.in. od konstrukcji badania i sytuacji pomiaru. Tourangeau i Yan (2007) opisują to jako motywowaną „edycję” odpowiedzi: unikanie zakłopotania wobec ankietera albo konsekwencji ze strony innych osób. We własnym miejscu pracy ankieter i „inne osoby” to często ta sama osoba. Trzy badania są szczególnie bliskie tej sytuacji:
- Anonimowość a poufność. W badaniu Ong i Weiss (2000) wśród studentów, którzy faktycznie ściągali, przyznało się do tego 25% przy zapewnieniu poufności i 74% przy anonimowości. „Nikomu nie powiem” to nie to samo co „nie wiem, że to Ty”.
- Podwładni i przełożeni. W eksperymencie terenowym Antonioniego (1994) podwładni podpisujący ocenę dawali menedżerom wyraźnie wyższe noty niż oceniający anonimowo i czuli się mniej swobodnie.
- Ankieta wręczona a wysłana. W badaniu Gribble’a i Haupt (2005) pacjentów losowo przydzielono do ankiety wręczanej i wysyłanej pocztą. Wręczana dała wyższe oceny satysfakcji i więcej zwrotów, ale też mniejsze zróżnicowanie ocen i więcej pominiętych pytań. Badanie porównuje sposoby dystrybucji i nie rozstrzyga, skąd różnica, więc nie przypisuj jej wprost aprobacie.
Żadne z tych badań nie mówi, ile punktów zmieni się w Twojej ankiecie. Dlatego poniżej liczymy to na założeniach, które można zmieniać.
Symulacja: ta sama grupa, trzy sposoby zbierania
Symulowani pacjenci mają prawdziwą ocenę (M = 3.50, SD = 0.70) i własną skłonność do ulegania presji. Presja dodaje punkty tym więcej, im dalej dana osoba jest od maksimum skali: kto ocenia słabo, ma najwięcej do „poprawienia”. Przesunięcie u typowej osoby ustawiono ręcznie: 0.05 punktu przy anonimowym linku, 0.15 przy osobie trzeciej z kopertą, 0.45 przy autorze badania. Te wartości są fikcyjne; prawdziwa siła presji zależy od tematu i relacji. Test wiedzy to miara spoza samoopisu, skorelowana z prawdziwą oceną.
| Sposób zbierania | Średnia | Obciążenie | SD | Osoby z wynikiem ≥ 4.5 | r z testem wiedzy | Pokrycie 95% CI |
|---|---|---|---|---|---|---|
| Bez presji (punkt odniesienia) | 3.49 | 0.00 | 0.72 | 10.28% | .46 | 94.66% |
| Anonimowy link | 3.53 | 0.05 | 0.70 | 10.94% | .46 | 89.69% |
| Osoba trzecia, koperta | 3.63 | 0.15 | 0.66 | 12.47% | .45 | 49.34% |
| Autor badania osobiście | 3.92 | 0.43 | 0.61 | 23.18% | .37 | 0.00% |
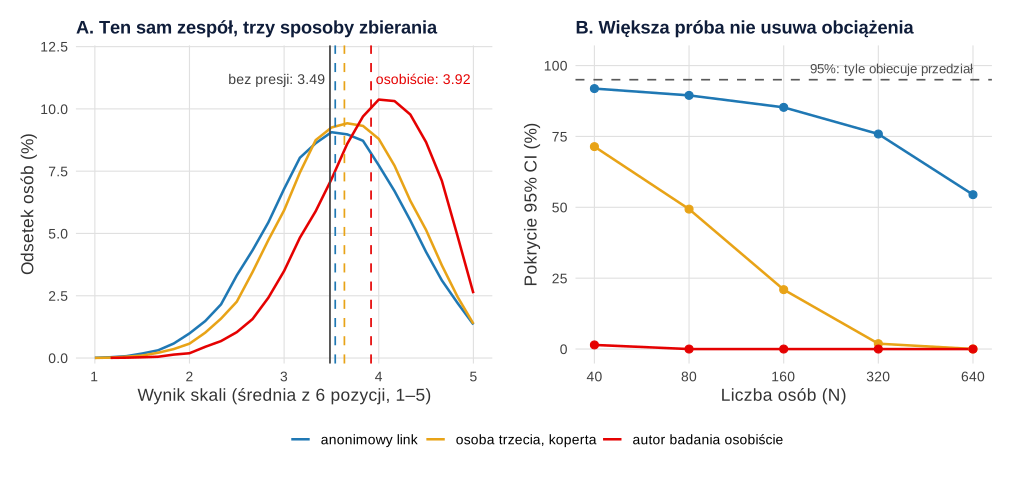
Autor zbierający ankiety osobiście zawyża średnią o 0.43 punktu, czyli o 0.61 SD. Przy takim przesunięciu sama ankieta mogłaby wyglądać jak skutek programu. Skutki są jednak szersze niż sama średnia:
- Rozkład się ściska. SD spada z 0.72 do 0.61, a wyników przy górnej granicy jest ponad dwa razy więcej. Pojawia się efekt sufitu.
- Korelacje słabną. Związek z testem wiedzy spada z r = .46 do r = .37, bo część wyniku mówi teraz o uległości, nie o przygotowaniu. Cierpi trafność kryterialna.
- Więcej osób nie pomaga. Przedział ufności opisuje tylko błąd losowy, a obciążenie zostaje. Przy osobistym zbieraniu pokrycie wynosi 1.5% już dla 40 osób. Nawet mała presja przy anonimowym linku obniża je z 91.9% do 54.4%, gdy próba rośnie do 640 osób (rysunek 1B).
Pozorny efekt programu
Prawdziwy kłopot pojawia się, gdy porównujesz. Poniżej program nie zmienia niczego, a test ma α = .05. Prosty schemat pretest–posttest nie jest tu jedynym problemem: inne zagrożenia, takie jak regresja do średniej, opisuje wspomniany wpis o ewaluacji programu, a w tej symulacji ich nie ma.
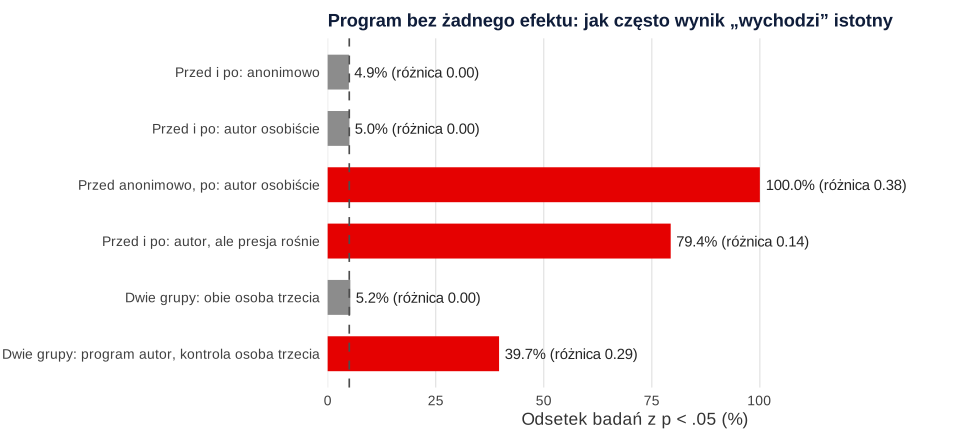
Liczy się to, czy sposób zbierania jest taki sam w obu porównywanych pomiarach. Gdy przed i po autor zbiera tak samo, odsetek fałszywych alarmów wynosi 5.04%, ale tylko przy założeniu, że presja się nie zmieniła. Po kilku tygodniach wspólnych zajęć rzadko tak jest. Gdy presja rośnie z 0.30 do 0.45, pozorna różnica 0.14 daje 79.37% wyników istotnych. Zmiana trybu (anonimowo przed, osobiście po) to 0.38 punktu i 100.00%. Gdy grupę programu zbiera autor, a kontrolę osoba trzecia, wychodzi 0.29 punktu i 39.66%. Wniosek: ten sam, niezależny od Ciebie sposób zbierania we wszystkich pomiarach i grupach.
Kto co robi: rozdzielenie ról w trzech układach
Wystarczy zwykle jedna życzliwa osoba spoza relacji zależności i przemyślany moment. Tabela to punkt wyjścia do rozmowy z promotorem i placówką, a przy pacjentach także do rozmowy o tym, jak zorganizować badanie, by nie kolidowało z opieką.
| Element | Klinicysta i swoi pacjenci | Nauczyciel i swoi uczniowie | Pracownik i zespół |
|---|---|---|---|
| Kto zaprasza | Osoba spoza opieki nad tym pacjentem, plakat, rejestracja | Inny nauczyciel, pedagog, list do rodziców | Ogłoszenie ogólne, nie przełożony i nie droga służbowa |
| Kto rozdaje i zbiera | Ta sama osoba trzecia; zamknięta urna lub link | Inny nauczyciel na swojej lekcji; autor poza salą | Link bez logowania; urna w neutralnym miejscu |
| Kiedy | Nie w czasie zabiegu ani wizyty; poza momentem, gdy pacjent czeka na decyzję | Nie przed sprawdzianem ani przy wystawianiu ocen | Poza okresem ocen okresowych, premii, reorganizacji |
| Co widzi autor | Bazę bez nazwisk, po zamknięciu zbierania | Bazę bez nazwisk, kody zamiast list klasowych | Tylko wyniki zbiorcze; grup poniżej progu nie analizuje osobno |
| Rozdzielenie ról | Pytania o leczenie odsyłasz do zespołu leczącego; nie zbierasz danych jako osoba prowadząca | Udział nie wpływa na ocenę i nie daje punktów bez alternatywy | Nie badasz bezpośrednich podwładnych osobiście; wyniki nie trafiają do akt |
Do pytań bardzo drażliwych, gdy nawet anonimowy link nie wystarcza, istnieje technika randomizowanych odpowiedzi. Przy doborze wyłącznie z własnej placówki pamiętaj też, że wnioski dotyczą tej placówki (to dobór wygodny), a kto nie odpowiedział, może się systematycznie różnić od reszty (błąd selekcji). Czy potrzebna jest opinia komisji bioetycznej, sprawdź u promotora i w samej komisji.
Małe zespoły: anonimowość, której nie ma
Ankieta bez nazwiska nie jest anonimowa, jeśli ktoś może rozpoznać odpowiedź po metryczce. A Ty znasz cały zespół. Policzyliśmy to na fikcyjnych rozkładach cech: staż w trzech przedziałach, płeć (80/20), wykształcenie w dwóch kategoriach.
| Wielkość zespołu | Jedyni w komórce: 1 pytanie (staż) | 2 pytania (+ płeć) | 3 pytania (+ wykształcenie) | W komórkach < 5, 3 pytania |
|---|---|---|---|---|
| 6 osób | 13.3% | 30.9% | 54.9% | 99.8% |
| 10 osób | 2.7% | 15.6% | 35.9% | 97.6% |
| 15 osób | 0.4% | 8.7% | 23.1% | 89.6% |
| 30 osób | 0.0% | 2.7% | 8.8% | 53.8% |
| 60 osób | 0.0% | 0.3% | 2.7% | 21.1% |
W zespole 10 osób trzy niewinne pytania czynią jednoznacznie rozpoznawalną ponad jedną trzecią badanych (35.9%), a 97.6% trafia do komórek poniżej pięciu osób. Dopiero przy 60 osobach odsetek jedynych spada do 2.7%. Wniosek jest prosty: w małym zespole każde kolejne pytanie metryczki kosztuje anonimowość. Zadaj tylko te, których użyjesz w analizie. Próg raportowania i ukrywanie przez odejmowanie opisuje wpis o anonimowości w małych oddziałach, a rozróżnienie pojęć – hasło o anonimizacji i pseudonimizacji.
Co napisać w Metodzie i Ograniczeniach
Jak bywa napisane: „Badanie przeprowadzono na oddziale, na którym pracuje autorka, co ułatwiło dostęp do pacjentów”.
Co nie tak: jest wygoda, nie ma zależności ani tego, jak ją ograniczono.
Poprawione: pierwsze zdanie poniżej.
Jak bywa napisane: „Ankiety były anonimowe”.
Co nie tak: nie wiadomo, kto je zbierał ani czy dało się rozpoznać osobę po metryczce.
Poprawione: podaj sposób zbierania i próg raportowania.
Jak bywa napisane: „Wysoka ocena przygotowania świadczy o skuteczności edukacji prowadzonej przez autorkę”.
Co nie tak: autorka prowadziła zajęcia i odbierała ankiety, więc wynik łączy efekt programu i uprzejmość.
Poprawione: „Wyniki należy interpretować ostrożnie, ponieważ…” (ostatnie zdanie poniżej).
Metoda – rekrutacja i zbieranie:
Metoda – małe grupy i ocena:
Ograniczenia – gdy rozdzielić ról się nie dało lub częściowo:
Więcej o tej części pracy: ograniczenia badania – jak je opisać. Przykłady i liczby w tym wpisie są fikcyjne.
Najczęstsze błędy
- „Odmowa nie ma konsekwencji” w informacji, a zaproszenie od osoby, od której coś zależy. Słowa nie znoszą relacji.
- Anonimowy link wysłany z imiennej listy przez przełożonego. Dla odbiorcy to nie jest anonimowe.
- Zmiana sposobu zbierania między pomiarami. Rysunek 2 pokazuje, że sama ta zmiana może dać „efekt”.
- Odczytywanie wyników w trakcie zbierania i rozmowy z badanymi o tym, jak im poszło. Zaburza to kolejne odpowiedzi i ujawnia, kto już odpowiedział.
- Traktowanie wysokiego odsetka odpowiedzi jako dowodu jakości. Odsetek odpowiedzi podniesiony presją to nie ten sam sukces.
- Podawanie wyników oddziału lub klasy, gdy zespół liczy kilka osób. Nawet średnia może wskazać konkretną osobę.
- Brak informacji o własnej roli. Czytelnik nie oceni wtedy ryzyka, którego nie zna.
Aprobata społeczna i małe zespoły w R
Dwa przepisy liczą wszystkie liczby z tabel i tekstu. Rysunki powstały w osobnym skrypcie. Ziaren nie wybierano pod wynik; przesunięcia 0.05, 0.15 i 0.45 oraz rozkłady cech metryczki ustawiono ręcznie jako założenia ilustracyjne. Zmień je i sprawdź, co stanie się z tabelami.
Symulacja: sposób zbierania a obciążenie
R
# Symulacja: jak aprobata społeczna przy osobistym zbieraniu ankiet
# zmienia wynik. Wszystkie parametry są fikcyjne i ilustracyjne.
# Ankieta: samoocena przygotowania do samoopieki, 6 pozycji, skala 1-5.
set.seed(513)

# Siła presji w trzech sposobach zbierania (przesunięcie odpowiedzi w punktach
# skali u osoby przeciętnej, która ma dokładnie średnią prawdziwą ocenę)
presja <- c("anonimowy link" = 0.05, "osoba trzecia, koperta" = 0.15,
            "autor badania osobiście" = 0.45)

osoby <- function(n) data.frame(
  ocena = rnorm(n, 3.50, 0.70),           # prawdziwa ocena osoby
  podatnosc = rgamma(n, shape = 2, rate = 2))  # skłonność do aprobaty, M = 1

# Odpowiedzi na 6 pozycji: im dalej od maksimum, tym więcej „do poprawienia”
pomiar <- function(d, lambda, k = 6) {
  n <- nrow(d)
  poprawka <- lambda * d$podatnosc * pmax(5 - d$ocena, 0) / 1.5
  x <- matrix(rnorm(n * k, d$ocena + poprawka, 0.60), n, k)
  rowMeans(pmin(pmax(round(x), 1), 5))
}

# Wartość prawdziwa: średnia skali, gdy nikt nie odczuwa presji
mu <- mean(pomiar(osoby(2e6), 0))
cat("Wartość prawdziwa (bez presji):", round(mu, 3), "\n\n")

# 1. Badanie z N = 80: średnia, obciążenie, rozproszenie, trafność
jedno_badanie <- function(lambda, n = 80) {
  d <- osoby(n)
  y <- pomiar(d, lambda)
  # Test wiedzy: miara niezależna od samoopisu, r z prawdziwą oceną = .50
  test <- 0.5 * as.numeric(scale(d$ocena)) + sqrt(0.75) * rnorm(n)
  ci <- mean(y) + c(-1, 1) * qt(.975, n - 1) * sd(y) / sqrt(n)
  c(srednia = mean(y), sd = sd(y), sufit = mean(y >= 4.5) * 100,
    r_test = cor(y, test), pokrycie = (ci[1] <= mu & mu <= ci[2]) * 100)
}
B <- 10000
w1 <- t(sapply(c("bez presji" = 0, presja),
               function(l) rowMeans(replicate(B, jedno_badanie(l)))))
w1 <- cbind(w1, obciazenie = w1[, "srednia"] - mu)
cat("Badanie N = 80,", B, "powtórzeń na wiersz\n")
print(round(w1[, c("srednia", "obciazenie", "sd", "sufit", "r_test", "pokrycie")], 2))
d_obc <- w1[, "obciazenie"] / w1["bez presji", "sd"]
cat("\nObciążenie w jednostkach SD (bez presji):\n")
print(round(d_obc, 2))

# 2. Czy większa próba pomaga? Pokrycie 95% CI dla wartości prawdziwej
N <- c(40, 80, 160, 320, 640)
pokrycie <- function(lambda, n, B = 4000) mean(replicate(B, {
  y <- pomiar(osoby(n), lambda)
  ci <- mean(y) + c(-1, 1) * qt(.975, n - 1) * sd(y) / sqrt(n)
  ci[1] <= mu & mu <= ci[2]
})) * 100
w2 <- sapply(presja, function(l) sapply(N, function(n) pokrycie(l, n)))
rownames(w2) <- paste0("N = ", N)
cat("\nPokrycie 95% CI dla wartości prawdziwej (%)\n")
print(round(w2, 1))

# 3. Program, który nic nie zmienia: co pokaże porównanie?
plan <- function(p1, p2, typ, n = 60, B = 10000) {
  w <- replicate(B, {
    if (typ == "przed-po") {
      d <- osoby(n)
      a <- pomiar(d, p1); b <- pomiar(d, p2)
      c(mean(b) - mean(a), t.test(b, a, paired = TRUE)$p.value)
    } else {               # dwie grupy, n osób łącznie, pomiar tylko po
      a <- pomiar(osoby(n / 2), p1); b <- pomiar(osoby(n / 2), p2)
      c(mean(b) - mean(a), t.test(b, a)$p.value)
    }
  })
  c(roznica = mean(w[1, ]), istotne = mean(w[2, ] < .05) * 100)
}
a <- 0.05; t3 <- 0.15; o <- 0.45
w3 <- rbind(
  "przed i po: anonimowo"                  = plan(a, a, "przed-po"),
  "przed i po: autor osobiście"            = plan(o, o, "przed-po"),
  "przed: anonimowo, po: autor osobiście"  = plan(a, o, "przed-po"),
  "przed: autor, po: autor, presja rośnie" = plan(0.30, o, "przed-po"),
  "2 grupy: obie osoba trzecia"            = plan(t3, t3, "grupy"),
  "2 grupy: kontrola osoba trzecia, program autor" = plan(t3, o, "grupy"))
cat("\nProgram bez efektu, N = 60, 10000 powtórzeń na wiersz\n")
print(round(w3, 2))
Wynik
Wartość prawdziwa (bez presji): 3.485

Badanie N = 80, 10000 powtórzeń na wiersz
                        srednia obciazenie   sd sufit r_test pokrycie
bez presji                 3.49       0.00 0.72 10.28   0.46    94.66
anonimowy link             3.53       0.05 0.70 10.94   0.46    89.69
osoba trzecia, koperta     3.63       0.15 0.66 12.47   0.45    49.34
autor badania osobiście    3.92       0.43 0.61 23.18   0.37     0.00

Obciążenie w jednostkach SD (bez presji):
             bez presji          anonimowy link  osoba trzecia, koperta
                   0.00                    0.07                    0.21
autor badania osobiście
                   0.61

Pokrycie 95% CI dla wartości prawdziwej (%)
        anonimowy link osoba trzecia, koperta autor badania osobiście
N = 40            91.9                   71.4                     1.5
N = 80            89.5                   49.4                     0.0
N = 160           85.2                   21.0                     0.0
N = 320           75.8                    1.9                     0.0
N = 640           54.4                    0.0                     0.0

Program bez efektu, N = 60, 10000 powtórzeń na wiersz
                                               roznica istotne
przed i po: anonimowo                             0.00    4.91
przed i po: autor osobiście                       0.00    5.04
przed: anonimowo, po: autor osobiście             0.38  100.00
przed: autor, po: autor, presja rośnie            0.14   79.37
2 grupy: obie osoba trzecia                       0.00    5.25
2 grupy: kontrola osoba trzecia, program autor    0.29   39.66
Metryczka a rozpoznawalność w małym zespole
R
# Ile osób w małym zespole da się rozpoznać po metryczce?
# Rozkłady cech są fikcyjne: płeć 80/20, staż w 3 przedziałach, wykształcenie 60/40.
set.seed(5131)
cechy <- list(staz = c(.30, .35, .35), plec = c(.80, .20), wyksz = c(.60, .40))

ryzyko <- function(n, k, B = 20000) {
  liczba_kom <- prod(lengths(cechy[seq_len(k)]))
  w <- replicate(B, {
    kod <- rep(0L, n)
    for (j in seq_len(k)) {
      p <- cechy[[j]]
      kod <- kod * length(p) + sample.int(length(p), n, TRUE, p) - 1L
    }
    ile <- tabulate(kod + 1L, liczba_kom)[kod + 1L]  # liczność komórki każdej osoby
    c(mean(ile == 1), mean(ile < 5))
  })
  rowMeans(w) * 100
}

zespoly <- c(6, 10, 15, 30, 60)
wyn <- as.data.frame(t(sapply(zespoly, function(n) c(
  zespol = n,
  jedyni_1 = ryzyko(n, 1)[1], jedyni_2 = ryzyko(n, 2)[1], jedyni_3 = ryzyko(n, 3)[1],
  ponizej5_3 = ryzyko(n, 3)[2]))))
cat("Odsetek osób (%): jedyni w swojej komórce po 1, 2 i 3 pytaniach metryczki\n")
cat("oraz osoby w komórkach poniżej 5 przy 3 pytaniach\n")
print(round(wyn, 1), row.names = FALSE)
Wynik
Odsetek osób (%): jedyni w swojej komórce po 1, 2 i 3 pytaniach metryczki
oraz osoby w komórkach poniżej 5 przy 3 pytaniach
 zespol jedyni_1 jedyni_2 jedyni_3 ponizej5_3
      6     13.3     30.9     54.9       99.8
     10      2.7     15.6     35.9       97.6
     15      0.4      8.7     23.1       89.6
     30      0.0      2.7      8.8       53.8
     60      0.0      0.3      2.7       21.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim rozdasz pierwszą ankietę, sprawdź
- Czy zaprasza ktoś, od kogo badany nie zależy?
- Czy odmowa jest niewidoczna dla Ciebie?
- Czy badani wypełniają ankietę bez Twojej obecności i oddają ją nie do Twojej ręki?
- Czy moment zbierania nie wypada w czasie zabiegu, oceny ani decyzji kadrowej?
- Czy sposób zbierania jest taki sam we wszystkich pomiarach i grupach?
- Czy osoba oceniająca nie wie, kto był w programie?
- Czy metryczka zawiera tylko pytania potrzebne do analizy, a próg raportowania jest ustalony przed analizą?
- Czy dostęp do dokumentacji do celów badania jest uzgodniony z placówką i komisją?
- Czy wiesz, kto po badaniu ma dostęp do surowych danych i co dostanie placówka?
- Czy w Metodzie jest Twoja rola, a w Ograniczeniach jej możliwy wpływ?
Najczęstsze pytania
Czy mogę zbadać swoich pacjentów do pracy magisterskiej?
Często jest to możliwe, ale decydują zasady komisji, placówki i uczelni. Z metodologicznego punktu widzenia zaproszenie i zbieranie danych powinna prowadzić osoba niezwiązana z opieką, a udział nie może wpływać na leczenie. Swoją rolę opisz w Metodzie, a przy wątpliwościach zapytaj promotora i komisję.
Czy nauczyciel może przeprowadzić ankietę wśród swoich uczniów?
Może to być dopuszczalne, ale sprawdź zasady szkoły i komisji oraz wymagane zgody. Najlepiej, aby ankietę przeprowadził inny nauczyciel, poza oceną i bez Twojej obecności w sali. Udział nie powinien wpływać na oceny ani dawać punktów bez równoważnej alternatywy.
Czy ankieta rozdana osobiście może być anonimowa?
Formalnie tak, jeśli nie ma danych identyfikujących, ale badany widzi, kto ją odbiera, a to osłabia poczucie anonimowości. Ong i Weiss (2000) pokazali dużą różnicę między poufnością a anonimowością w przyznawaniu się do ściągania. Bezpieczniejsza jest urna albo link, a osoba zbierająca nie powinna być autorem.
Jak w pracy opisać, że badanie przeprowadzono w miejscu zatrudnienia?
Podaj swoją funkcję, kto zapraszał, kto i w jakiej formie zbierał dane oraz czy znałeś osoby, które odmówiły. W Ograniczeniach napisz, że odpowiedzi mogły być przesunięte z powodu aprobaty społecznej. Placówkę opisz ogólnie, zgodnie z ustaleniami z nią. Gotowe zdania są w tej sekcji.
Czy większa próba rozwiązuje problem aprobaty społecznej?
Nie. Aprobata przesuwa wynik systematycznie, a próba zmniejsza tylko błąd losowy. W symulacji przy osobistym zbieraniu przedział 95% obejmował wartość prawdziwą w 1.5% badań już przy 40 osobach, a przy większych próbach w 0.0%. Pomaga zmiana sposobu zbierania, a nie liczba osób.
Powiązane hasła
Przeczytaj też
Ankieta ujawnia zagrożenie uczestnika
Anonimowość a możliwość reakcji, stała informacja o pomocy, progi przesiewowe, rola promotora i gotowe teksty do wniosku oraz ankiety.
Czytaj →PoradnikWniosek do komisji bioetycznej – jak opisać badanie
Metoda językiem zrozumiałym dla komisji: rekrutacja, procedura, liczebność, dane, wypełniony fikcyjny przykład i poprawione fragmenty.
Czytaj →PoradnikZgoda placówki na badanie – wzór pisma
Do kogo pisać, co zawrzeć w piśmie, trzy fikcyjne warianty dla szpitala, szkoły i firmy oraz co zrobić po odmowie lub braku odpowiedzi.
Czytaj →PoradnikAnkieta wśród personelu jednego szpitala
Populacja czy próba, odsetek odpowiedzi w oddziałach, poprawka na skończoną populację w przedziale ufności, liczebność przy małej kadrze i anonimowość małych oddziałów – z przykładem w R.
Czytaj →PoradnikEwaluacja programu w jednej placówce – opis metody
Gotowy podrozdział „Metoda”: autor jako prowadzący, wierność realizacji, grupa porównawcza i dozwolone wnioski, z kodem R.
Czytaj →Badasz własną placówkę i chcesz, żeby plan wytrzymał pytania recenzenta?
Sprawdzimy plan zbierania danych i analizę w R lub SPSS, a wyniki wyjaśnimy tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Antonioni, D. (1994). The effects of feedback accountability on upward appraisal ratings. Personnel Psychology, 47(2), 349–356. https://doi.org/10.1111/j.1744-6570.1994.tb01728.x
- Clark, E., & McCann, T. V. (2005). Researching students: An ethical dilemma. Nurse Researcher, 12(3), 42–51. https://doi.org/10.7748/nr2005.01.12.3.42.c5947
- Gribble, R. K., & Haupt, C. (2005). Quantitative and qualitative differences between handout and mailed patient satisfaction surveys. Medical Care, 43(3), 276–281. https://doi.org/10.1097/00005650-200503000-00010
- Hay-Smith, E. J. C., Brown, M., Anderson, L., & Treharne, G. J. (2016). Once a clinician, always a clinician: A systematic review to develop a typology of clinician-researcher dual-role experiences in health research with patient-participants. BMC Medical Research Methodology, 16(1), Article 95. https://doi.org/10.1186/s12874-016-0203-6 ● Otwarty dostęp
- Hróbjartsson, A., Thomsen, A. S. S., Emanuelsson, F., Tendal, B., Hilden, J., Boutron, I., Ravaud, P., & Brorson, S. (2013). Observer bias in randomized clinical trials with measurement scale outcomes: A systematic review of trials with both blinded and nonblinded assessors. Canadian Medical Association Journal, 185(4), E201–E211. https://doi.org/10.1503/cmaj.120744 ● Otwarty dostęp
- Krumpal, I. (2013). Determinants of social desirability bias in sensitive surveys: A literature review. Quality & Quantity, 47(4), 2025–2047. https://doi.org/10.1007/s11135-011-9640-9 ● Otwarty dostęp
- Ong, A. D., & Weiss, D. J. (2000). The impact of anonymity on responses to sensitive questions. Journal of Applied Social Psychology, 30(8), 1691–1708. https://doi.org/10.1111/j.1559-1816.2000.tb02462.x
- Torgerson, D. J. (2001). Contamination in trials: Is cluster randomisation the answer? BMJ, 322(7282), 355–357. https://doi.org/10.1136/bmj.322.7282.355 ● Otwarty dostęp
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
Cytowania BibTeX
@article{antonioni1994effects, author={Antonioni, David}, title={{The effects of feedback accountability on upward appraisal ratings}}, journal={Personnel Psychology}, year={1994}, volume={47}, number={2}, pages={349--356}, doi={10.1111/j.1744-6570.1994.tb01728.x}}@article{clark2005researching, author={Clark, Eileen and McCann, Terence V.}, title={{Researching students: An ethical dilemma}}, journal={Nurse Researcher}, year={2005}, volume={12}, number={3}, pages={42--51}, doi={10.7748/nr2005.01.12.3.42.c5947}}@article{gribble2005quantitative, author={Gribble, Robert K. and Haupt, Cherie}, title={{Quantitative and qualitative differences between handout and mailed patient satisfaction surveys}}, journal={Medical Care}, year={2005}, volume={43}, number={3}, pages={276--281}, doi={10.1097/00005650-200503000-00010}}@article{haysmith2016once, author={Hay-Smith, E. Jean C. and Brown, Melanie and Anderson, Lynley and Treharne, Gareth J.}, title={{Once a clinician, always a clinician: A systematic review to develop a typology of clinician-researcher dual-role experiences in health research with patient-participants}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={95}, doi={10.1186/s12874-016-0203-6}}@article{hrobjartsson2013observer, author={Hróbjartsson, Asbjørn and Thomsen, Ann Sofia Skou and Emanuelsson, Frida and Tendal, Britta and Hilden, Jørgen and Boutron, Isabelle and Ravaud, Philippe and Brorson, Stig}, title={{Observer bias in randomized clinical trials with measurement scale outcomes: A systematic review of trials with both blinded and nonblinded assessors}}, journal={Canadian Medical Association Journal}, year={2013}, volume={185}, number={4}, pages={E201--E211}, doi={10.1503/cmaj.120744}}@article{krumpal2013determinants, author={Krumpal, Ivar}, title={{Determinants of social desirability bias in sensitive surveys: A literature review}}, journal={Quality \& Quantity}, year={2013}, volume={47}, number={4}, pages={2025--2047}, doi={10.1007/s11135-011-9640-9}}@article{ong2000impact, author={Ong, Anthony D. and Weiss, David J.}, title={{The impact of anonymity on responses to sensitive questions}}, journal={Journal of Applied Social Psychology}, year={2000}, volume={30}, number={8}, pages={1691--1708}, doi={10.1111/j.1559-1816.2000.tb02462.x}}@article{torgerson2001contamination, author={Torgerson, David J.}, title={{Contamination in trials: Is cluster randomisation the answer?}}, journal={BMJ}, year={2001}, volume={322}, number={7282}, pages={355--357}, doi={10.1136/bmj.322.7282.355}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}