Jedna placówka, zwykle bez losowania: co to zmienia w rozdziale
Ewaluacja programu ocenia konkretne działanie w konkretnym miejscu. W pracy dyplomowej mają zwykle znaczenie dwie okoliczności. Po pierwsze, autor bywa jednocześnie pracownikiem placówki, prowadzącym zajęcia i osobą, która zbiera ankiety. Po drugie, nikt nie losuje uczestników, bo o udziale decyduje kolejność zgłoszeń, grafik albo dyrekcja. Rozdział metodologiczny powinien pokazywać obie te rzeczy wprost.
Ogólny plan ewaluacji, kryteria i wskaźniki znajdziesz w poradniku o badaniu ewaluacyjnym w pracy dyplomowej, a zagrożenia planu dwóch pomiarów i regresję do średniej we wpisie o badaniu przed i po. Tu zajmujemy się tym, co jest specyficzne dla ewaluacji we własnej placówce: kto mierzy, gdy autor prowadzi, jak zapisać wierność realizacji i czego nie wolno wnioskować z frekwencji.
Przykład przewodni (fikcyjny, dane symulowane). Autorka pracy jest zatrudniona w centrum wsparcia opiekunów osób z demencją i ocenia program 10 cotygodniowych warsztatów po 90 minut. Program realizowano w trzech grupach: grupy 1 i 2 prowadziła autorka, a grupę 3 koleżanka z zespołu. Miejsc było mniej niż zgłoszeń, więc osoby zgłoszone później trafiły na listę oczekujących i posłużyły jako grupa porównawcza. Wynikiem jest obciążenie opieką, skala 0–40 (im wyżej, tym większe; narzędzie wymyślone na potrzeby przykładu), mierzone przed programem (T1) i po 10 tygodniach (T2).
Pytania ewaluacyjne: najpierw o proces, potem o wynik
Pytanie ewaluacyjne nie brzmi tak samo jak hipoteza. Wskazuje program, miejsce i kryterium oceny. Dobrze jest rozdzielić pytania o przebieg programu od pytań o to, co zmieniło się u uczestników, bo wymagają innych danych i pozwalają na inne wnioski.
| Pytanie | Typ | Dane | Co plan pozwala powiedzieć |
|---|---|---|---|
| W jakim stopniu program zrealizowano zgodnie ze scenariuszem? | Proces | Lista kontrolna elementów | Odpowiedź bezpośrednią |
| Ile spotkań uzyskali uczestnicy? | Proces | Lista obecności | Odpowiedź bezpośrednią |
| Czy obciążenie opieką zmieniło się między T1 a T2? | Wynik | Skala w dwóch pomiarach | Opis zmiany, bez przyczyny |
| Czy zmiana była większa niż na liście oczekujących? | Wynik | Skala w obu grupach | Różnicę z zastrzeżeniem braku losowania |
Jak bywa napisane: „Celem pracy jest ocena skuteczności programu”.
Co jest nie tak: słowo „skuteczność” obiecuje wniosek, na który plan bez losowania nie pozwala, a przebieg programu w ogóle nie jest badany.
Jeśli program jest szkoleniem, kolejne pytania możesz ułożyć według poziomów opisanych we wpisie o modelu Kirkpatricka. W rozdziale metody wystarczy wtedy zdanie, które poziomy objęto pomiarem i dlaczego pozostałych nie mierzono. Sama wysoka ocena zajęć nie odpowiada na pytanie o wynik.
Logika programu w jednym rysunku
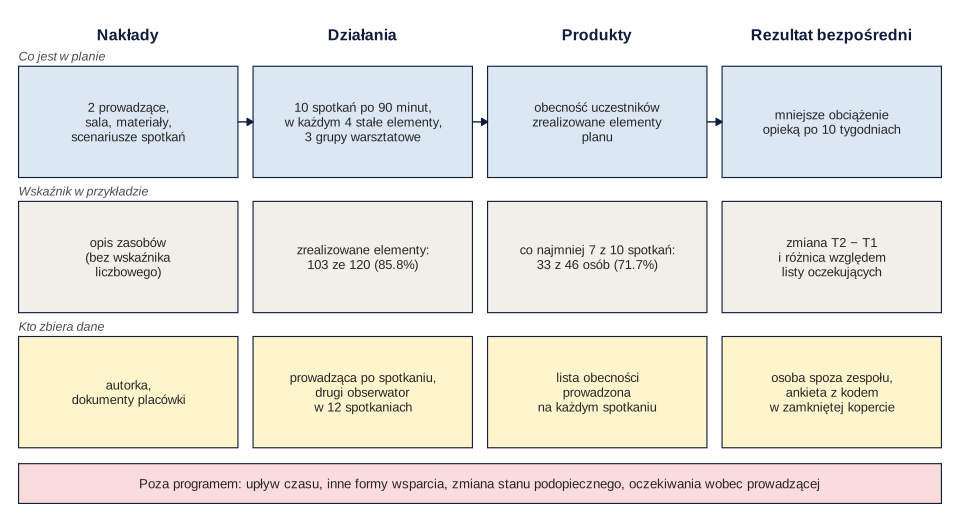
Horstman i Godwin (2025) opisują pięć elementów modelu logicznego: nakłady, działania, produkty, rezultaty i wpływ, i radzą poprawiać model, gdy program się zmienia. Definicję i różnicę względem teorii zmiany podaje hasło teoria zmiany i model logiczny. W rozdziale metody model jest przydatny z innego powodu: pod każdym ogniwem możesz zapisać wskaźnik i osobę, która zbiera dane. Rysunek 1 nie ma ostatniego ogniwa. Zmiany długofalowe w życiu rodzin przekraczają zakres pracy dyplomowej i lepiej to napisać, niż je sugerować.
Kto prowadzi, a kto mierzy
Gdy autor prowadzi program, wynik obciąża kilka rzeczy naraz. Autor chce, żeby program się udał. Uczestnicy mogą nie chcieć sprawić mu przykrości, a oczekiwania badacza działają w tym samym kierunku. W badaniach nad psychoterapią metametaanaliza Mundera i in. (2013) objęła 30 metaanaliz i wykazała, że przywiązanie badacza do badanej terapii wiązało się z jej efektem, średnio r = .262. To inna dziedzina i nie przenosi się wprost na warsztaty w jednej placówce, ale dobrze pokazuje, dlaczego rola autora należy do opisu metody. Przy wynikach na skalach subiektywnych przegląd badań randomizowanych Hróbjartssona i in. (2013) wykazał, że niezaślepieni oceniający dawali korzystniejsze oszacowania efektu niż zaślepieni (różnica wielkości efektu −0.23). Nie zawsze da się zaślepić pomiar, ale prawie zawsze można oddzielić zbieranie odpowiedzi od prowadzenia zajęć.
| Sytuacja | Ryzyko | Co zrobić w planie | Co napisać w metodzie |
|---|---|---|---|
| Autor prowadzi zajęcia | Bardziej staranne prowadzenie zajęć w badanych grupach, oczekiwania | Scenariusz spisany przed startem, lista kontrolna, inna osoba prowadzi część grup | Kto prowadził które grupy i jakie miał przygotowanie |
| Autor rozdaje ankietę po ostatnim spotkaniu | Odpowiedzi życzliwe wobec prowadzącego | Ankietę zbiera osoba spoza zespołu, koperta, kod zamiast nazwiska | Kto, gdzie i w jakiej formie zbierał dane |
| Uczestnik korzysta z usług placówki | Poczucie, że odmowa zaszkodzi | Informacja, że odmowa nie zmienia dostępu do usług; zgodę zbiera osoba niezależna | Jak zapewniono dobrowolność (zob. świadoma zgoda) |
| Grupy liczą kilkanaście osób | Rozpoznanie osoby po metryczce | Kod identyfikacyjny, brak komórek z małą liczbą osób | Sposób łączenia pomiarów, poziom szczegółowości wyników |
Wierność realizacji: cztery pytania i prosta lista kontrolna
Carroll i in. (2007) definiują wierność realizacji jako stopień, w jakim program przeprowadzono zgodnie z założeniami, i traktują ją jako ważne źródło zróżnicowania wyników. Bellg i in. (2004) wymieniają strategie obejmujące projekt badania, szkolenie realizatorów, realizację, odbiór przez uczestników i stosowanie nabytych umiejętności. Przegląd Durlaka i DuPre (2008), obejmujący ponad 500 badań ilościowych, wskazuje, że poziom realizacji wpływa na wyniki programów promocji i profilaktyki. Bez tych danych brak zmiany może oznaczać zarówno słaby program, jak i program, którego nie przeprowadzono. O uczestnikach, którzy przestrzegają planu, pisze hasło adherencja. O realizacji warto zapisać cztery rzeczy:
- Czy zrobiono to, co w planie. Odsetek zrealizowanych elementów ze scenariusza.
- Ile programu dostali ludzie. Liczba spotkań lub minut na osobę.
- Jak to zrobiono. Ocena jakości przez obserwatora, jeśli jest ktoś, kto może ją wystawić.
- Co zmieniono. Skrócone zajęcia, zmiana kolejności, inna osoba prowadząca, z datą i powodem.
Listę kontrolną zbuduj ze scenariusza, zanim program się zacznie: jeden element, jedno zdanie, odpowiedź tak/nie. W przykładzie każde spotkanie ma cztery elementy, czyli razem 120 elementów w trzech grupach. Prowadząca wypełnia listę zaraz po zajęciach, a ponieważ samoocena może być zbyt życzliwa, druga osoba ocenia niezależnie część spotkań. Tak samo liczy się zgodność w obserwacji z listą kontrolną. Próg („realizacja wystarczająca od 80%”) jest umowny, więc zapisz go przed zbieraniem danych.
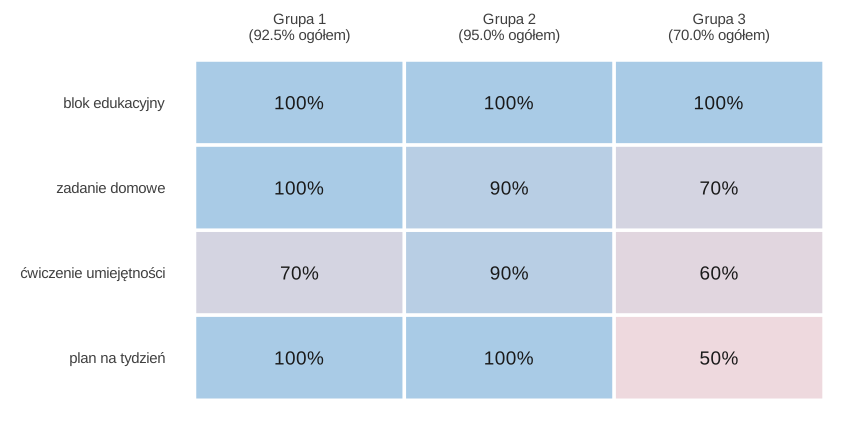
W przykładzie zrealizowano 103 ze 120 elementów, czyli 85.8%. Drugi obserwator ocenił 48 elementów z 12 spotkań; zgodność wyniosła 95.8%, a kappa Cohena κ = .81, przy czym tylko pięć elementów oboje uznali za niezrealizowane. Frekwencja: średnio 7.83 spotkania (SD = 1.89, zakres 3–10), a co najmniej 7 z 10 spotkań uzyskały 33 z 46 osób (71.7%). Rysunek 2 pokazuje, po co dzielić wierność na elementy. Blok edukacyjny odbył się zawsze. W grupie 3 odpadł plan na tydzień w połowie spotkań i ćwiczenie umiejętności w czterech z dziesięciu, a więc składniki, od których program miał zależeć.
Grupa porównawcza albo uczciwy jej brak
Decyzję o grupie porównawczej podejmij przed programem i opisz, skąd się wzięła. Zagrożenia dla wniosków omawiają Shadish i in. (2002), a tu przekładamy je na wybory dostępne w jednej placówce.
| Rozwiązanie | Co daje | Główne ograniczenie |
|---|---|---|
| Lista oczekujących bez losowania | Ten sam czas i miejsce, nikt nie traci dostępu do programu | Później zgłoszeni mogą być inni; porównanie tylko z czekaniem |
| Losowanie z listy, gdy miejsc jest za mało | Najmocniejszy wariant, przydział nie zależy od nikogo w placówce | Wymaga zgody placówki i zaplanowania przed zapisami |
| Poprzednia edycja lub inny oddział | Dostępne, często bez dodatkowych kosztów | Inny czas lub zespół; zob. różnica w różnicach |
| Dwa pomiary przed programem | Pokazuje, jak wynik zmienia się bez programu | Wydłuża badanie; nie zastępuje grupy |
| Dane miesięczne sprzed i po wdrożeniu | Trend przed programem (przerwany szereg czasowy) | Potrzeba wielu punktów i wskaźnika z dokumentacji |
| Brak grupy | Pełny opis realizacji i zmiany | Nie da się oddzielić programu od upływu czasu |
Gdy grupy nie ma, nie próbuj jej zastępować dłuższym opisem wyników. Praca może mieć wartość jako ewaluacja procesu: pokazuje, co udało się zrealizować, u kogo i jaka zmiana towarzyszyła programowi.
Wyniki przykładu: zmiana, porównanie i pułapka frekwencji
Ze zgłoszonych 52 i 36 osób pomiar T1 wypełniło odpowiednio 46 i 32, a T2 uzyskano od 40 uczestników (ubytek 13.0%) i 29 osób z listy (9.4%). Sześć osób z programu bez T2 miało w T1 niższą średnią (22.17) niż osoby z T2 (25.73). Ubytek nie był więc przypadkowy względem wyniku.
| Grupa | n | T1, M (SD) | T2, M (SD) | Zmiana [95% CI] | dz |
|---|---|---|---|---|---|
| Program | 40 | 25.73 (8.09) | 21.92 (8.97) | −3.80 [−5.36, −2.24] | −0.78 |
| Lista oczekujących | 29 | 26.00 (5.79) | 23.83 (6.36) | −2.17 [−3.60, −0.75] | −0.58 |
Zmiana była istotna w obu grupach, w tym u osób, które tylko czekały. Różnica między grupami wyniosła −1.63 punktu, 95% CI [−3.79, 0.53], p = .137, a w ANCOVA z T1 jako kowariantem −1.65 punktu, 95% CI [−3.81, 0.51], p = .132. Przedział obejmuje zarówno zero, jak i różnice kilkupunktowe, więc wniosek o „braku efektu” byłby tak samo nieuprawniony jak wniosek o skuteczności. W symulacji znamy prawdę: średni efekt programu wyniósł −3.06 punktu, ale badanie tej wielkości nie zdołało go precyzyjnie oszacować. Osoby z programu miały na starcie wynik zbliżony do osób z listy (SMD = −0.07).
| Grupa | Wierność | Średnia frekwencja | n z T2 | Zmiana, M (SD) |
|---|---|---|---|---|
| 1 (autorka) | 92.5% | 8.33 | 13 | −6.31 (5.99) |
| 2 (autorka) | 95.0% | 7.59 | 13 | −1.85 (3.63) |
| 3 (koleżanka) | 70.0% | 7.57 | 14 | −3.29 (3.93) |
Trzy wiersze kuszą, żeby policzyć korelację wierności ze zmianą. Nie rób tego. Grupa o najwyższej wierności ma najmniejszą zmianę, a z tego nie wynika, że wierność szkodzi, bo grupy różnią się składem, porą i prowadzącą, a n = 3 to nie jest próba grup. Pokaż tabelę, opisz, co pominięto, i zaznacz, że nie da się z niej ocenić związku wierności z wynikiem. Uczestnicy są też pogrupowani w warsztatach, a przy trzech grupach nie oszacujesz wiarygodnie tej zależności, więc to kolejne ograniczenie do wymienienia.
Drugą pokusą jest frekwencja. Związek wygląda na wyraźny (rysunek 3): każde dodatkowe spotkanie wiązało się ze zmianą o −1.19 punktu, 95% CI [−2.00, −0.38], p = .005, r = −.44. Osoby obecne na co najmniej 7 spotkaniach zmieniły wynik o −4.87 punktu (n = 30), a pozostałe o −0.60 (n = 10). Tekst sam się pisze: „im więcej spotkań, tym lepiej”. To jednak porównanie według tego, co uczestnicy faktycznie zrobili, a nie według przydziału. Na spotkania częściej przychodzą osoby bardziej zmotywowane, którym i tak może być łatwiej.
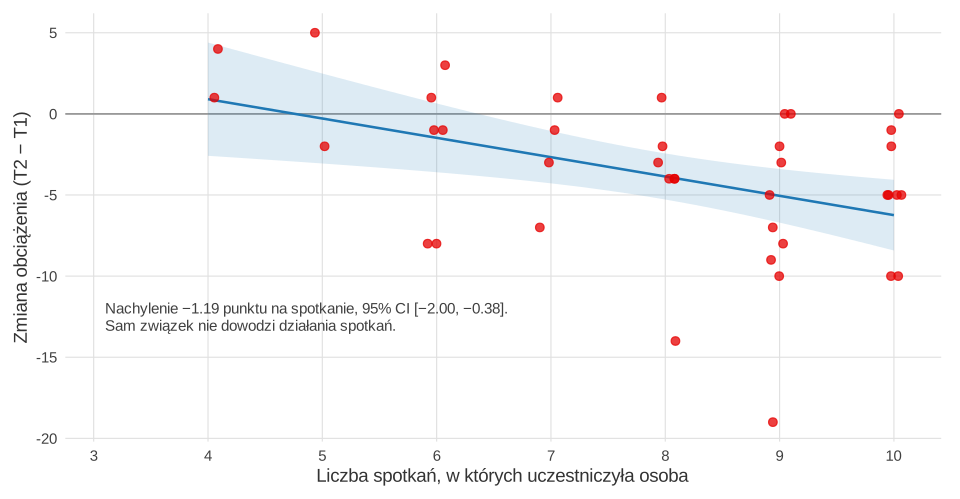
Żeby sprawdzić, jak mylące to bywa, powtórzyliśmy program 5000 razy, także przy efekcie programu równym zero, z takim samym ubytkiem jak w przykładzie.
| Scenariusz | Średnie nachylenie | Wyniki istotne | Zmiana: wszyscy | Zmiana: ≥ 7 spotkań |
|---|---|---|---|---|
| Brak efektu, motywacja bez znaczenia | 0.00 | 5.00% | −0.82 | −0.81 |
| Brak efektu, motywacja umiarkowana | −0.37 | 19.94% | −0.92 | −1.23 |
| Brak efektu, motywacja silna | −0.51 | 41.12% | −1.06 | −1.59 |
| Efekt −0.40 na spotkanie, motywacja umiarkowana | −0.78 | 62.54% | −4.01 | −4.64 |
Program bez żadnego działania dawał „istotną zależność od frekwencji” w 19.94% i 41.12% badań, a nachylenie w ostatnim wierszu (−0.78) jest prawie dwa razy większe od efektu wbudowanego w dane (−0.40). Analiza „tylko osoby z co najmniej 7 spotkaniami” dziedziczy ten sam problem. Taką analizę potraktuj jako opis lub analizę wrażliwości, a porównanie główne zapisz według przydziału do warunku.
Gotowy podrozdział „Metoda” z komentarzem
Układ pasuje do schematu z poradnika o rozdziale metodologicznym. Opis programu możesz oprzeć na liście TIDieR (Hoffmann i in., 2014), a opis badania bez losowania na wytycznych TREND (Des Jarlais i in., 2004), sprawdzając przy tym wymagania uczelni i promotora.
Schemat i miejsce badania
Jak bywa napisane: „Badanie przeprowadzono w placówce, w której pracuje autorka”.
Co jest nie tak: czytelnik nie wie, jaką rolę autorka miała w programie ani skąd wzięła się grupa porównawcza.
Uczestnicy
Program
Jak bywa napisane: „Uczestnicy brali udział w autorskim programie wsparcia”.
Co jest nie tak: programu nie da się powtórzyć ani ocenić. „Autorski” niczego nie mówi o treści.
Role i zbieranie danych
Wierność realizacji
Plan analizy
Jak bywa napisane: „Skuteczność programu oceniono testem t, a następnie sprawdzono związek frekwencji z efektem”.
Co jest nie tak: test w jednej grupie nie mówi o skuteczności, a związek frekwencji z wynikiem jest zapisany tak, jakby mierzył działanie programu.
Dane, wyniki, osoby, program i skala w tym podrozdziale są fikcyjne, a akapity nie zawierają cytowań badań.
Co wolno napisać we wnioskach
Ogólne zasady są w poradniku o wnioskach i rekomendacjach. W ewaluacji jednej placówki dochodzą trzy szczególne pokusy: orzeczenie o skuteczności, przypisanie efektu frekwencji i uogólnienie na inne placówki.
| Zamiast | Napisz |
|---|---|
| „Program okazał się skuteczny” | „Obciążenie obniżyło się u uczestników o 3.80 punktu, a u osób oczekujących o 2.17 punktu; przedział dla różnicy obejmował zero” |
| „Program nie działa” | „Badanie nie pozwoliło precyzyjnie określić różnicy między grupami; przedział [−3.79, 0.53] obejmuje zarówno zero, jak i spadek o blisko 4 punkty” |
| „Im więcej spotkań, tym większy efekt programu” | „Większa liczba spotkań wiązała się z większą zmianą, ale związek ten może wynikać z cech osób częściej uczestniczących” |
| „Program zrealizowano prawidłowo” | „Zrealizowano 103 ze 120 elementów (85.8%); w jednej grupie 70.0%, głównie kosztem ćwiczeń i planu na tydzień” |
| „Program warto wdrożyć w innych placówkach” | „Wyniki dotyczą jednej placówki; uzasadnione jest badanie z losowym przydziałem miejsc z listy oczekujących” |
Układ tej części pracy omawia wpis o ograniczeniach badania.
Na co zwrócić uwagę w różnych dziedzinach
To obserwacje ogólne, a nie reguły; wymagania uczelni i promotora mają pierwszeństwo.
| Dziedzina | Częsty kłopot | Co często dopisać w metodzie |
|---|---|---|
| Psychologia | Autor jako trener lub terapeuta | Przygotowanie i rola prowadzącego, samoopis a pomiar niezależny |
| Nauki o zdrowiu | Równoległe zmiany standardu opieki | Inne działania w placówce, dokumentacja realizacji, bez zaleceń klinicznych |
| Fizjoterapia | Naturalny przebieg dolegliwości | Dawka ćwiczeń, sposób ich rejestrowania, zmiana a próg znaczenia klinicznego ze źródła |
| Pedagogika | Całe klasy i jeden nauczyciel | Klasa jako jednostka realizacji, zgody rodziców, kto ocenia uczniów |
| Zarządzanie | Program narzucony przez przełożonych | Anonimowość wobec pracodawcy, zdarzenia w firmie, koszt programu |
| Praca socjalna | Zależność klientów od instytucji | Sposób zapewnienia dobrowolności, dane z systemów instytucji, małe zespoły |
Najczęstsze błędy
- Brak informacji, że autor prowadził program. To nie wada, jeśli jest opisane; wadą jest przemilczenie.
- Ankieta rozdawana przez prowadzącego na ostatnim spotkaniu.
- Same produkty jako dowód. „Przeszkolono 46 osób” nie mówi nic o zmianie.
- Wierność jako jedna liczba. W przykładzie 85.8% ukrywa, że w jednej grupie pominięto połowę planów na tydzień.
- Korelacja wierności z wynikiem z trzech grup. Trzy punkty nie są analizą.
- „Im więcej spotkań, tym lepiej” jako wniosek przyczynowy. W symulacji bez efektu taki wynik był istotny w 41.12% badań przy silnym wpływie motywacji.
- Analiza tylko osób z wysoką frekwencją przedstawiona jako wynik główny.
- Istotna zmiana u uczestników jako dowód, gdy osoby czekające też się zmieniły.
- Rekomendacja wdrożenia w innych placówkach na podstawie jednej edycji w jednym miejscu.
Ewaluacja programu w R: realizacja, zmiana i frekwencja
Trzy przepisy liczą wszystkie liczby z tekstu i tabel. Pierwszy tworzy dane, zapisuje je w folderze nadrzędnym (../) i opisuje przepływ osób oraz realizację. Drugi liczy zmiany, porównanie grup i związek frekwencji ze zmianą. Trzeci powtarza program 5000 razy w czterech scenariuszach. Ziarna nie wybierano pod wynik. Rysunki powstały w osobnym skrypcie. Dane do pobrania: ewaluacja-programu-uczestnicy.csv (78 osób, format szeroki) i ewaluacja-programu-realizacja.csv (120 elementów programu). Dane, osoby i placówka są fikcyjne.
Dane, przepływ osób i wierność realizacji
R
# B491 – dane symulowane: program w jednej placówce i lista oczekujących
set.seed(4910)
zgloszeni <- c(program = 52, lista = 36)
n_gr <- c(G1 = 15, G2 = 17, G3 = 14); n_lista <- 32
grupa <- c(rep(names(n_gr), n_gr), rep("lista", n_lista))
N <- length(grupa); program <- grupa != "lista"
motywacja <- rnorm(N)                                  # cecha niemierzona
T1 <- round(pmin(pmax(rnorm(N, 25 + 1.5 * !program, 6.5), 0), 40))

# Plan: 10 spotkań w 3 grupach, w każdym 4 elementy (razem 120 elementów)
elementy <- c("zadanie domowe", "blok edukacyjny", "ćwiczenie umiejętności", "plan na tydzień")
p_real <- rbind(G1 = c(.90, .98, .90, .92), G2 = c(.85, .98, .85, .90), G3 = c(.70, .95, .45, .70))
real <- expand.grid(grupa = names(n_gr), spotkanie = 1:10, element = elementy, stringsAsFactors = FALSE)
real$zrealizowano <- rbinom(nrow(real), 1, p_real[cbind(match(real$grupa, rownames(p_real)), match(real$element, elementy))])
# Drugi obserwator: 4 losowe spotkania w każdej grupie, niekiedy inna ocena
wybrane <- unlist(lapply(names(n_gr), function(g) paste(g, sample(1:10, 4))))
real$obserwator2 <- NA
ktore <- paste(real$grupa, real$spotkanie) %in% wybrane
inna <- rbinom(sum(ktore), 1, .06)
real$obserwator2[ktore] <- ifelse(inna == 1, 1 - real$zrealizowano[ktore], real$zrealizowano[ktore])
wiernosc <- tapply(real$zrealizowano, real$grupa, mean)

# Frekwencja: bardziej zmotywowani przychodzą częściej
spotkania <- ifelse(program, rbinom(N, 10, plogis(1.2 + .9 * motywacja)), NA)
efekt <- ifelse(program, -.45 * spotkania * wiernosc[grupa], 0)  # prawdziwy efekt: dawka × wierność
T2 <- round(pmin(pmax(T1 - .8 - 1.0 * motywacja + efekt + rnorm(N, 0, 3.5), 0), 40))
p_brak <- ifelse(program, plogis(-.6 - .35 * (spotkania - 5)), .10)
T2[rbinom(N, 1, p_brak) == 1] <- NA

dane <- data.frame(id = seq_len(N), grupa, program = as.integer(program), spotkania, T1, T2)
write.csv(dane, "../ewaluacja-programu-uczestnicy.csv", row.names = FALSE, na = "")
write.csv(real, "../ewaluacja-programu-realizacja.csv", row.names = FALSE, na = "")

# Przepływ osób
cat("Zgłoszeni:", zgloszeni, " rezygnacja przed T1:", zgloszeni - c(sum(n_gr), n_lista), "\n")
cat("T1:", sum(program), "program,", sum(!program), "lista\n")
cat("T2:", sum(!is.na(T2[program])), "program,", sum(!is.na(T2[!program])), "lista\n")
cat(sprintf("Ubytek: program %.1f%%, lista %.1f%%\n", 100 * mean(is.na(T2[program])), 100 * mean(is.na(T2[!program]))))
cat("\nT2 w programie według obecności (mediana spotkań):\n")
print(tapply(spotkania[program], is.na(T2[program]), median))

# Wierność realizacji
cat("\nOdsetek zrealizowanych elementów, grupa:\n")
print(round(100 * wiernosc, 1))
cat(sprintf("Razem: %d z %d = %.1f%%\n", sum(real$zrealizowano), nrow(real), 100 * mean(real$zrealizowano)))
cat("\nGrupa x element (%):\n")
print(round(100 * tapply(real$zrealizowano, list(real$element, real$grupa), mean), 0))

# Zgodność obserwatorów (elementy ocenione przez oba)
d2 <- real[!is.na(real$obserwator2), ]
tab <- table(d2$zrealizowano, d2$obserwator2)
po <- sum(diag(tab)) / sum(tab)
pe <- sum(rowSums(tab) * colSums(tab)) / sum(tab)^2
cat("\nZgodność na", nrow(d2), "elementach:\n"); print(tab)
cat(sprintf("Zgodność procentowa = %.1f%%, kappa = %.2f\n", 100 * po, (po - pe) / (1 - pe)))

# Frekwencja
s <- spotkania[program]
cat(sprintf("\nFrekwencja: M = %.2f, SD = %.2f, mediana = %g, zakres %d–%d\n", mean(s), sd(s), median(s), min(s), max(s)))
cat(sprintf("Co najmniej 7 z 10 spotkań: %d z %d = %.1f%%\n", sum(s >= 7), length(s), 100 * mean(s >= 7)))
cat("Średnia frekwencja w grupach:\n"); print(round(tapply(spotkania[program], grupa[program], mean), 2))

# Prawda wbudowana w symulację (w prawdziwym badaniu nieznana)
cat(sprintf("\nŚredni prawdziwy efekt programu w grupie programu: %.2f punktu\n", mean(efekt[program])))
Wynik w R
Zgłoszeni: 52 36  rezygnacja przed T1: 6 4
T1: 46 program, 32 lista
T2: 40 program, 29 lista
Ubytek: program 13.0%, lista 9.4%

T2 w programie według obecności (mediana spotkań):
FALSE  TRUE
    8     7

Odsetek zrealizowanych elementów, grupa:
  G1   G2   G3
92.5 95.0 70.0
Razem: 103 z 120 = 85.8%

Grupa x element (%):
                        G1  G2  G3
blok edukacyjny        100 100 100
ćwiczenie umiejętności  70  90  60
plan na tydzień        100 100  50
zadanie domowe         100  90  70

Zgodność na 48 elementach:

     0  1
  0  5  0
  1  2 41
Zgodność procentowa = 95.8%, kappa = 0.81

Frekwencja: M = 7.83, SD = 1.89, mediana = 8, zakres 3–10
Co najmniej 7 z 10 spotkań: 33 z 46 = 71.7%
Średnia frekwencja w grupach:
  G1   G2   G3
8.33 7.59 7.57

Średni prawdziwy efekt programu w grupie programu: -3.06 punktu
Zmiana, porównanie grup i frekwencja
R
# B491 – analiza: zmiana w programie, porównanie z listą, frekwencja a zmiana
d <- read.csv("../ewaluacja-programu-uczestnicy.csv")
real <- read.csv("../ewaluacja-programu-realizacja.csv")
apa_p <- function(p) if (p < .001) "p < .001" else sprintf("p = %s", sub("^0", "", sprintf("%.3f", p)))
d$zmiana <- d$T2 - d$T1
kompl <- d[!is.na(d$T2), ]
P <- kompl[kompl$program == 1, ]; L <- kompl[kompl$program == 0, ]

opis <- function(x) c(n = sum(!is.na(x)), M = round(mean(x, na.rm = TRUE), 2), SD = round(sd(x, na.rm = TRUE), 2))
cat("T1 (wszyscy)\n"); print(rbind(program = opis(d$T1[d$program == 1]), lista = opis(d$T1[d$program == 0])))
cat("\nZ pomiarem T2\n")
print(rbind(program_T1 = opis(P$T1), program_T2 = opis(P$T2), lista_T1 = opis(L$T1), lista_T2 = opis(L$T2)))
cat("\nT1 osób bez T2 w programie:", round(mean(d$T1[d$program == 1 & is.na(d$T2)]), 2),
    " z T2:", round(mean(P$T1), 2), "\n")
a <- d$T1[d$program == 1]; b <- d$T1[d$program == 0]
smd <- (mean(a) - mean(b)) / sqrt(((length(a) - 1) * var(a) + (length(b) - 1) * var(b)) / (length(a) + length(b) - 2))
cat(sprintf("SMD dla T1 (program - lista): %.2f\n", smd))

parami <- function(x, nazwa) {
  t0 <- t.test(x$T2, x$T1, paired = TRUE); z <- x$T2 - x$T1
  cat(sprintf("%s: M zmiany = %.2f, SD = %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, %s, d_z = %.2f, n = %d\n",
              nazwa, mean(z), sd(z), t0$conf.int[1], t0$conf.int[2], t0$parameter, t0$statistic,
              apa_p(t0$p.value), mean(z) / sd(z), length(z)))
}
cat("\n"); parami(P, "Program"); parami(L, "Lista oczekujących")

wypisz <- function(m, nazwa, wsp) {
  e <- coef(summary(m))[wsp, ]; ci <- confint(m)[wsp, ]
  cat(sprintf("%s: %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, %s\n", nazwa, e[1], ci[1], ci[2],
              df.residual(m), e[3], apa_p(e[4])))
}
cat("\n")
wypisz(lm(zmiana ~ program, kompl), "Analiza zmian (program - lista)", "program")
wypisz(lm(T2 ~ T1 + program, kompl), "ANCOVA (program - lista)", "program")

cat("\nWierność, frekwencja i zmiana w grupach warsztatowych\n")
gr <- data.frame(wiernosc = round(100 * tapply(real$zrealizowano, real$grupa, mean), 1),
                 n_T1 = as.vector(table(d$grupa[d$program == 1])),
                 frekwencja = round(tapply(d$spotkania[d$program == 1], d$grupa[d$program == 1], mean), 2),
                 n_T2 = as.vector(table(P$grupa)),
                 zmiana = round(tapply(P$zmiana, P$grupa, mean), 2),
                 SD = round(tapply(P$zmiana, P$grupa, sd), 2))
print(gr)

cat("\nFrekwencja a zmiana (osoby z programu z T2)\n")
wypisz(lm(zmiana ~ spotkania, P), "Zmiana na każde dodatkowe spotkanie", "spotkania")
cat(sprintf("r = %s\n", sub("^(-?)0", "\\1", sprintf("%.2f", cor(P$spotkania, P$zmiana)))))
P$co7 <- as.integer(P$spotkania >= 7)
for (k in 1:0) { x <- P$zmiana[P$co7 == k]
  cat(sprintf("%s: n = %d, M zmiany = %.2f, SD = %.2f\n", ifelse(k == 1, "co najmniej 7 spotkań", "mniej niż 7"), length(x), mean(x), sd(x))) }
Wynik w R
T1 (wszyscy)
         n     M   SD
program 46 25.26 7.90
lista   32 25.75 5.67

Z pomiarem T2
            n     M   SD
program_T1 40 25.73 8.09
program_T2 40 21.92 8.97
lista_T1   29 26.00 5.79
lista_T2   29 23.83 6.36

T1 osób bez T2 w programie: 22.17  z T2: 25.73
SMD dla T1 (program - lista): -0.07

Program: M zmiany = -3.80, SD = 4.87, 95% CI [-5.36, -2.24], t(39) = -4.94, p < .001, d_z = -0.78, n = 40
Lista oczekujących: M zmiany = -2.17, SD = 3.74, 95% CI [-3.60, -0.75], t(28) = -3.13, p = .004, d_z = -0.58, n = 29

Analiza zmian (program - lista): -1.63, 95% CI [-3.79, 0.53], t(67) = -1.51, p = .137
ANCOVA (program - lista): -1.65, 95% CI [-3.81, 0.51], t(66) = -1.53, p = .132

Wierność, frekwencja i zmiana w grupach warsztatowych
   wiernosc n_T1 frekwencja n_T2 zmiana   SD
G1     92.5   15       8.33   13  -6.31 5.99
G2     95.0   17       7.59   13  -1.85 3.63
G3     70.0   14       7.57   14  -3.29 3.93

Frekwencja a zmiana (osoby z programu z T2)
Zmiana na każde dodatkowe spotkanie: -1.19, 95% CI [-2.00, -0.38], t(38) = -2.99, p = .005
r = -.44
co najmniej 7 spotkań: n = 30, M zmiany = -4.87, SD = 4.57
mniej niż 7: n = 10, M zmiany = -0.60, SD = 4.50
Symulacja: frekwencja bez działania programu
R
# B491 – czy związek frekwencji ze zmianą dowodzi działania programu?
# 5000 powtórzeń programu dla 46 osób, efekt programu równy zero albo nie
set.seed(4911)
jedno <- function(b_frekw, b_zmiana, efekt_sp) {
  n <- 46; m <- rnorm(n)
  s <- rbinom(n, 10, plogis(1.2 + b_frekw * m))
  z <- -.8 + b_zmiana * m + efekt_sp * s + rnorm(n, 0, 3.5)
  brak <- rbinom(n, 1, plogis(-.6 - .35 * (s - 5))) == 1
  s <- s[!brak]; z <- z[!brak]
  if (length(unique(s)) < 2) return(rep(NA, 4))
  f <- summary(lm(z ~ s))$coefficients["s", ]
  co7 <- s >= 7
  c(nachylenie = f[1], p = f[4], zmiana_wszyscy = mean(z), zmiana_co7 = mean(z[co7]))
}
scen <- rbind("A brak efektu, motywacja bez znaczenia"     = c(0, 0, 0),
              "B brak efektu, motywacja umiarkowana"       = c(.9, -1, 0),
              "C brak efektu, motywacja silna"             = c(1.3, -1.5, 0),
              "D efekt -0.40 na spotkanie, motywacja jak B" = c(.9, -1, -.40))
wyn <- t(apply(scen, 1, function(p) {
  w <- t(replicate(5000, jedno(p[1], p[2], p[3])))
  c(sr_nachylenie = mean(w[, 1], na.rm = TRUE), proc_p05 = 100 * mean(w[, 2] < .05, na.rm = TRUE),
    proc_ujemne_p05 = 100 * mean(w[, 2] < .05 & w[, 1] < 0, na.rm = TRUE),
    zmiana_wszyscy = mean(w[, 3], na.rm = TRUE), zmiana_co7 = mean(w[, 4], na.rm = TRUE))
}))
print(round(wyn, 2))
Wynik w R
                                            sr_nachylenie proc_p05
A brak efektu, motywacja bez znaczenia               0.00     5.00
B brak efektu, motywacja umiarkowana                -0.37    19.94
C brak efektu, motywacja silna                      -0.51    41.12
D efekt -0.40 na spotkanie, motywacja jak B         -0.78    62.54
                                            proc_ujemne_p05 zmiana_wszyscy
A brak efektu, motywacja bez znaczenia                 2.34          -0.82
B brak efektu, motywacja umiarkowana                  19.92          -0.92
C brak efektu, motywacja silna                        41.12          -1.06
D efekt -0.40 na spotkanie, motywacja jak B           62.52          -4.01
                                            zmiana_co7
A brak efektu, motywacja bez znaczenia           -0.81
B brak efektu, motywacja umiarkowana             -1.23
C brak efektu, motywacja silna                   -1.59
D efekt -0.40 na spotkanie, motywacja jak B      -4.64
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem rozdziału sprawdź…
- Czy pytania ewaluacyjne rozdzielają przebieg programu od zmiany u uczestników?
- Czy napisano, kto prowadził, kto zbierał dane i jaką rolę w placówce ma autor?
- Czy lista kontrolna powstała przed programem i czy ktoś drugi ocenił część spotkań?
- Czy wierność podano według grup i elementów, a nie tylko jedną liczbą?
- Czy opisano, skąd wzięła się grupa porównawcza, a jeśli jej nie ma, czy napisano, czego przez to nie wiadomo?
- Czy porównanie główne jest według przydziału, a analizy frekwencji oznaczono jako eksploracyjne?
- Czy wnioski mówią o tej placówce i tej edycji programu?
Jeśli chcesz, żeby ktoś sprawdził plan ewaluacji albo opis metody i pomógł policzyć analizę, zobacz pomoc w analizie dla studentów.
Najczęstsze pytania
Czy mogę prowadzić program i jednocześnie pisać jego ewaluację?
Tak, jeśli to opiszesz i oddzielisz prowadzenie od pomiaru. Niech ankiety zbiera ktoś spoza zespołu, a odpowiedzi trafiają do koperty z kodem zamiast nazwiska. W ograniczeniach zaznacz, że autorka była jednocześnie prowadzącą, i dodaj, jak ograniczono ten wpływ.
Jak zmierzyć wierność realizacji programu w pracy dyplomowej?
Zamień scenariusz na listę elementów z odpowiedzią tak/nie i wypełniaj ją po każdym spotkaniu. Podaj odsetek zrealizowanych elementów, ogółem i według grup, oraz zapisuj odstępstwa z datą i powodem. Część spotkań niech niezależnie oceni druga osoba, żeby dało się policzyć zgodność.
Czy ewaluacja programu bez grupy porównawczej ma sens?
Ma, jeśli przedstawisz ją jako ewaluację procesu i opis zmiany, a nie ocenę skuteczności. Pokazujesz, co zrealizowano, kto uczestniczył i jaka zmiana towarzyszyła programowi. Musisz jednak napisać wprost, że plan nie oddziela programu od upływu czasu i innych zdarzeń.
Czy mogę napisać, że im więcej spotkań, tym większy efekt programu?
Nie jako wniosek przyczynowy. Liczby spotkań nikt nie przydzielał, a częściej przychodzą osoby bardziej zmotywowane. W symulacji programu bez działania związek frekwencji ze zmianą był istotny w 19.94% badań przy umiarkowanym i w 41.12% przy silnym wpływie motywacji. Napisz, że liczba spotkań wiązała się ze zmianą, i wskaż to ograniczenie.
Czy wyniki ewaluacji z jednej placówki można uogólnić?
Zwykle nie na inne placówki. Opisz dokładnie miejsce, uczestników, prowadzących i realizację, żeby czytelnik mógł ocenić, czy wyniki pasują do jego sytuacji. Wnioski sformułuj dla tej placówki i tej edycji, a następny krok przedstaw jako propozycję badania, np. z losowaniem miejsc z listy oczekujących.
Powiązane hasła
Przeczytaj też
Badanie we własnym miejscu pracy
Swoi pacjenci, uczniowie, zespół: zagrożenia, kto ma zbierać dane, symulacja aprobaty społecznej w R i zdania do Metody oraz Ograniczeń.
Czytaj →PoradnikBadanie bez grupy kontrolnej – jak wzmocnić plan
Sześć dodatków do planu jednej grupy, co każdy daje i czego nie rozwiązuje, symulacja w R i gotowe zdania do metody i ograniczeń.
Czytaj →PoradnikBadanie ewaluacyjne w pracy dyplomowej
Model logiczny, kryteria i poziomy Kirkpatricka, wskaźniki, schemat przed–po z grupą porównawczą oraz ANCOVA i DiD w R na przykładzie szkolenia.
Czytaj →PoradnikBadanie przed i po – opis metody i wnioski
Gotowy podrozdział „Metoda” dla jednej grupy i grupy nierandomizowanej, symulacja regresji do średniej i zdania, które wolno napisać we wnioskach.
Czytaj →PoradnikEwaluacja szkolenia w modelu Kirkpatricka
Cztery poziomy jako cztery pomiary: narzędzie, termin, schemat i analiza, krytyka modelu oraz korelacje między poziomami – z przykładem 120 osób w R.
Czytaj →PoradnikObserwacja z listą kontrolną
Audyt przestrzegania procedur (np. higieny rąk): okazja jako jednostka, CI uwzględniający osoby, zgodność obserwatorów, Hawthorne i przed–po – przykład w R.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikJak napisać pracę z pracy socjalnej
Problem społeczny, dostęp do ośrodków, anonimowość w małych zespołach, dane z systemów i ewaluacja programu – z gotowymi akapitami na fikcyjnych przykładach.
Czytaj →PoradnikPilotaż wykonalności (feasibility)
Kryteria postępu, odsetki rekrutacji, retencji i adherencji z 95% CI, decyzja o badaniu głównym i raport CONSORT – bez testowania efektu, z kodem R.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Oceniasz program w swojej placówce i nie wiesz, co wolno napisać?
Sprawdzimy plan ewaluacji i opis metody, policzymy analizę w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bellg, A. J., Borrelli, B., Resnick, B., Hecht, J., Minicucci, D. S., Ory, M., Ogedegbe, G., Orwig, D., Ernst, D., Czajkowski, S., & Treatment Fidelity Workgroup of the NIH Behavior Change Consortium. (2004). Enhancing treatment fidelity in health behavior change studies: Best practices and recommendations from the NIH Behavior Change Consortium. Health Psychology, 23(5), 443–451. https://doi.org/10.1037/0278-6133.23.5.443
- Carroll, C., Patterson, M., Wood, S., Booth, A., Rick, J., & Balain, S. (2007). A conceptual framework for implementation fidelity. Implementation Science, 2(1), Article 40. https://doi.org/10.1186/1748-5908-2-40 ● Otwarty dostęp
- Des Jarlais, D. C., Lyles, C., Crepaz, N., & TREND Group. (2004). Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement. American Journal of Public Health, 94(3), 361–366. https://doi.org/10.2105/ajph.94.3.361 ● Otwarty dostęp: pełny tekst
- Durlak, J. A., & DuPre, E. P. (2008). Implementation matters: A review of research on the influence of implementation on program outcomes and the factors affecting implementation. American Journal of Community Psychology, 41(3–4), 327–350. https://doi.org/10.1007/s10464-008-9165-0
- Hoffmann, T. C., Glasziou, P. P., Boutron, I., Milne, R., Perera, R., Moher, D., Altman, D. G., Barbour, V., Macdonald, H., Johnston, M., Lamb, S. E., Dixon-Woods, M., McCulloch, P., Wyatt, J. C., Chan, A.-W., & Michie, S. (2014). Better reporting of interventions: Template for intervention description and replication (TIDieR) checklist and guide. BMJ, 348, Article g1687. https://doi.org/10.1136/bmj.g1687 ● Otwarty dostęp
- Horstman, M. J., & Godwin, K. M. (2025). Methodological progress note: Logic models. Journal of Hospital Medicine, 21(4), 409–412. https://doi.org/10.1002/jhm.70181 ● Otwarty dostęp
- Hróbjartsson, A., Thomsen, A. S. S., Emanuelsson, F., Tendal, B., Hilden, J., Boutron, I., Ravaud, P., & Brorson, S. (2013). Observer bias in randomized clinical trials with measurement scale outcomes: A systematic review of trials with both blinded and nonblinded assessors. Canadian Medical Association Journal, 185(4), E201–E211. https://doi.org/10.1503/cmaj.120744 ● Otwarty dostęp
- Munder, T., Brütsch, O., Leonhart, R., Gerger, H., & Barth, J. (2013). Researcher allegiance in psychotherapy outcome research: An overview of reviews. Clinical Psychology Review, 33(4), 501–511. https://doi.org/10.1016/j.cpr.2013.02.002
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
Cytowania BibTeX
@article{bellg2004enhancing, author={Bellg, Albert J. and Borrelli, Belinda and Resnick, Barbara and Hecht, Jacki and Minicucci, Daryl Sharp and Ory, Marcia and Ogedegbe, Gbenga and Orwig, Denise and Ernst, Denise and Czajkowski, Susan and {Treatment Fidelity Workgroup of the NIH Behavior Change Consortium}}, title={{Enhancing treatment fidelity in health behavior change studies: Best practices and recommendations from the NIH Behavior Change Consortium}}, journal={Health Psychology}, year={2004}, volume={23}, number={5}, pages={443--451}, doi={10.1037/0278-6133.23.5.443}}@article{carroll2007conceptual, author={Carroll, Christopher and Patterson, Malcolm and Wood, Stephen and Booth, Andrew and Rick, Jo and Balain, Shashi}, title={{A conceptual framework for implementation fidelity}}, journal={Implementation Science}, year={2007}, volume={2}, number={1}, eid={40}, doi={10.1186/1748-5908-2-40}}@article{desjarlais2004improving, author={Des Jarlais, Don C. and Lyles, Cynthia and Crepaz, Nicole and {TREND Group}}, title={{Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement}}, journal={American Journal of Public Health}, year={2004}, volume={94}, number={3}, pages={361--366}, doi={10.2105/ajph.94.3.361}}@article{durlak2008implementation, author={Durlak, Joseph A. and DuPre, Emily P.}, title={{Implementation matters: A review of research on the influence of implementation on program outcomes and the factors affecting implementation}}, journal={American Journal of Community Psychology}, year={2008}, volume={41}, number={3–4}, pages={327--350}, doi={10.1007/s10464-008-9165-0}}@article{hoffmann2014better, author={Hoffmann, Tammy C. and Glasziou, Paul P. and Boutron, Isabelle and Milne, Ruairidh and Perera, Rafael and Moher, David and Altman, Douglas G. and Barbour, Virginia and Macdonald, Helen and Johnston, Marie and Lamb, Sarah E. and Dixon-Woods, Mary and McCulloch, Peter and Wyatt, Jeremy C. and Chan, An-Wen and Michie, Susan}, title={{Better reporting of interventions: Template for intervention description and replication (TIDieR) checklist and guide}}, journal={BMJ}, year={2014}, volume={348}, eid={g1687}, doi={10.1136/bmj.g1687}}@article{horstman2025methodological, author={Horstman, Molly J. and Godwin, Kyler M.}, title={{Methodological progress note: Logic models}}, journal={Journal of Hospital Medicine}, year={2025}, volume={21}, number={4}, pages={409--412}, doi={10.1002/jhm.70181}}@article{hrobjartsson2013observer, author={Hróbjartsson, Asbjørn and Thomsen, Ann Sofia Skou and Emanuelsson, Frida and Tendal, Britta and Hilden, Jørgen and Boutron, Isabelle and Ravaud, Philippe and Brorson, Stig}, title={{Observer bias in randomized clinical trials with measurement scale outcomes: A systematic review of trials with both blinded and nonblinded assessors}}, journal={Canadian Medical Association Journal}, year={2013}, volume={185}, number={4}, pages={E201--E211}, doi={10.1503/cmaj.120744}}@article{munder2013researcher, author={Munder, Thomas and Br{\"u}tsch, Oliver and Leonhart, Rainer and Gerger, Heike and Barth, J{\"u}rgen}, title={{Researcher allegiance in psychotherapy outcome research: An overview of reviews}}, journal={Clinical Psychology Review}, year={2013}, volume={33}, number={4}, pages={501--511}, doi={10.1016/j.cpr.2013.02.002}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}