Nie będzie grupy kontrolnej. Co możesz dodać do planu
Zaplanowałaś program w jednej klasie albo na jednym oddziale i wiesz już, że drugiej grupy nie będzie. Zostają dwa pomiary, przed i po, i pytanie promotora: skąd wiadomo, że to program? Marsden i Torgerson (2012) w przeglądzie badań ewaluacyjnych pokazują, że wynik planu jednej grupy mogą kształtować regresja do średniej, dojrzewanie, historia i efekt testowania, a autorzy takich badań nie wspominali o regresji do średniej.
Zagrożenia tego planu i dozwolone wnioski omawia wpis o badaniu przed i po, regresję do średniej – osobny wpis, opis programu we własnej placówce – wpis o ewaluacji, a porównanie z inną grupą – wpis o różnicy w różnicach. Jeśli grupa jest jeszcze możliwa, zacznij od wyboru warunku kontrolnego. Tu zostaje jedno pytanie: co dołożyć do planu i co każdy dodatek naprawdę daje.
Shadish, Cook i Campbell (2002) opisują plany jednogrupowe wzmacniane dodatkowymi pomiarami i dodatkowymi zmiennymi. Logika jest prosta: każdy dodatek tworzy przewidywanie, które powinno się spełnić, jeśli zmianę spowodował program, a nie spełni się, jeśli zmianę spowodowało coś innego. Rysunek 1 pokazuje sześć takich dodatków.
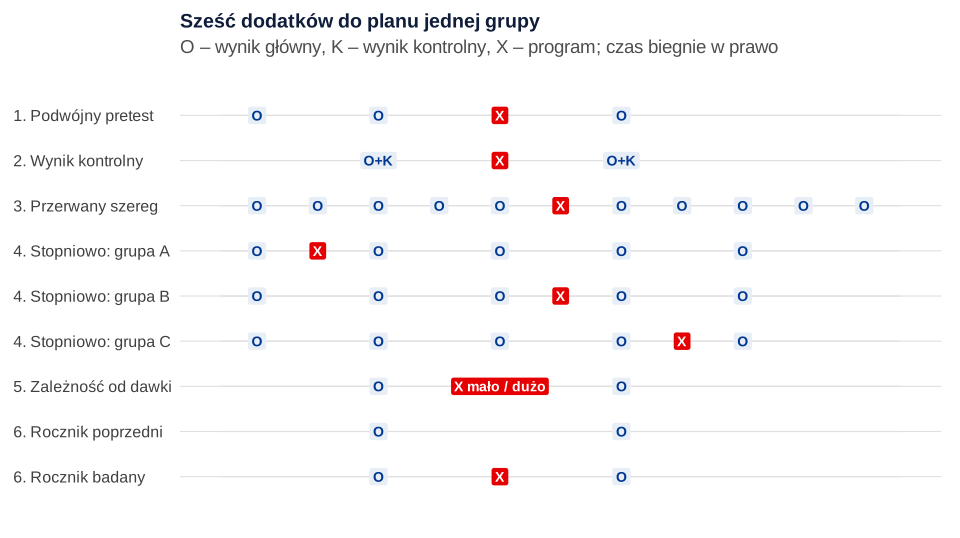
Przykład przewodni (fikcyjny, dane symulowane). Program czytania dla 64 uczniów czwartej klasy trwa 8 tygodni. Mierzymy tempo czytania (słowa na minutę) we wrześniu (T0), w listopadzie (T1) i w styczniu (T2), a także tempo prostych działań matematycznych. W danych wpisano, że program nie działa wcale, a dzieci same czytają z każdym okresem szybciej.
Dodatek 1: dwa pomiary przed programem
Dwa pomiary przed programem kosztują jedno dodatkowe spotkanie, a odpowiadają na pytanie, którego żaden pojedynczy pretest nie rozstrzyga: czy wynik zmieniał się już bez programu. Odstęp T0–T1 powinien być taki sam jak T1–T2.
W przykładzie tempo czytania wynosiło M = 96.09 (SD = 18.20) w T0, M = 100.52 (SD = 18.07) w T1 i M = 103.47 (SD = 20.21) w T2. Sam plan przed–po dałby wzrost o 2.95 słowa, 95% CI [0.80, 5.10], t(63) = 2.75, p = .008. Bez dodatkowego pomiaru byłby to „istotny efekt programu”.
Tymczasem przed programem dzieci przyspieszyły o 4.42 słowa, 95% CI [2.61, 6.24], t(63) = 4.87, p < .001. Porównanie obu okresów, czyli kontrast (T2 − T1) − (T1 − T0), daje −1.47 słowa, 95% CI [−4.87, 1.94], t(63) = −0.86, p = .392. Zwróć uwagę na szerokość przedziału: dane nie dowodzą, że program nie działa. Mówią tylko, że zmiany w okresie programu nie da się odróżnić od zmiany, która zachodziła wcześniej.
Dodatek ma trzy słabe strony. Zakłada, że bez programu tempo zmiany byłoby takie samo. Kontrast jest też mniej precyzyjny niż zwykła różnica, bo składa się z trzech pomiarów obarczonych błędem. Po trzecie, dwa punkty nie odróżnią trendu od efektu uczenia się testu: wzrost T0→T1 może być jednym albo drugim. Pomaga wersja równoległa narzędzia albo trzeci pomiar przed programem, bo wzrost związany z pierwszym powtórzeniem badania zwykle nie powtarza się w kolejnych odstępach tak jak trend.
Drugi pretest ma jeszcze jedną zaletę: pozwala oddzielić pomiar, według którego kwalifikujesz, od pomiaru wyjściowego, co usuwa część regresji do średniej.
Dodatek 2: wynik, na który program nie powinien działać
Wynik kontrolny, ang. negative control outcome (zob. hasło kontrola negatywna), to zmienna, która podlega tym samym wpływom ubocznym co wynik główny, ale której program nie powinien zmienić. Lipsitch i in. (2010) opisują kontrole negatywne jako narzędzie do wykrywania zakłócenia i innych źródeł błędu oraz wskazują warunki, od których zależy ich przydatność. Wykrywanie to słowo kluczowe: wynik kontrolny pokazuje problem, ale nie oszacuje efektu za Ciebie.
Dobry wynik kontrolny spełnia dwa warunki. Program naprawdę nie ma jak na niego wpłynąć, a na oba wyniki działają te same źródła błędu: wiek, sezon, zmiany w placówce, życzliwość wobec badacza. Przykłady:
- Pielęgniarstwo: program o higienie rąk; wynik kontrolny to wiedza o prawidłowym pomiarze ciśnienia, mierzona tak samo.
- Fizjoterapia: ćwiczenia odcinka lędźwiowego; wynik kontrolny to ocena dolegliwości nadgarstka, zadana tym samym formatem pytania.
- Psychologia: trening uważności dla studentów; wynik kontrolny to postawa wobec zdrowego odżywiania z tej samej ankiety.
- Pedagogika: program czytania; wynik kontrolny to tempo działań matematycznych.
W przykładzie tempo działań wzrosło o 1.86 działania na minutę, 95% CI [1.11, 2.61], t(63) = 4.94, p < .001, choć program czytania tego nie obejmował. Wyników w różnych jednostkach nie wolno odejmować wprost, dlatego porównujemy je po podzieleniu przez SD z T1. Zmiana wyniosła .163 SD dla czytania i .222 SD dla działań, a różnica −0.06 SD, 95% CI [−0.21, 0.09], t(63) = −0.78, p = .437. Wynik główny zachował się tak samo jak zmienna, której program nie dotyczył. To sygnał, żeby zmianę czytania przypisać czemuś innemu niż program. Wybierz wynik kontrolny przed zebraniem danych; dobrany po fakcie niczego nie sprawdza.
Co te dwa dodatki dają razem: 5000 badań w sześciu światach
Jedno badanie to anegdota. Zasymulowaliśmy więc 5000 badań po 60 osób dla każdego z sześciu scenariuszy o znanej prawdzie, z parametrami ustawionymi ręcznie (kod na dole strony). Liczymy, jak często plan pokazuje dodatni, istotny wynik przy dwustronnym α = .05. Reguła łączna uznaje program za „wykryty” tylko wtedy, gdy kontrast dla wyniku głównego jest istotny dodatnio, a ten sam kontrast dla wyniku kontrolnego nie.
| Świat (prawda) | Średnia zmiana T1→T2 | Tylko przed–po | Podwójny pretest: średni kontrast | Podwójny pretest: % istotnych | Pretest + wynik kontrolny |
|---|---|---|---|---|---|
| A. Trend, program bez efektu | 4.02 | 98.92% | 0.02 | 2.54% | 2.54% |
| B. Trend i prawdziwy efekt +5 | 8.98 | 100.00% | 4.98 | 87.42% | 85.24% |
| C. Bez trendu, efekt testowania +3 | 0.01 | 2.62% | −2.98 | 0.02% | 0.02% |
| D. Trend przyspiesza (+2, potem +6) | 5.99 | 100.00% | 3.99 | 69.86% | 20.64% |
| E. Zdarzenie działa na oba wyniki +4 | 8.01 | 100.00% | 3.98 | 69.12% | 20.96% |
| F. Zdarzenie działa tylko na wynik główny +4 | 8.02 | 100.00% | 4.03 | 71.12% | 69.06% |
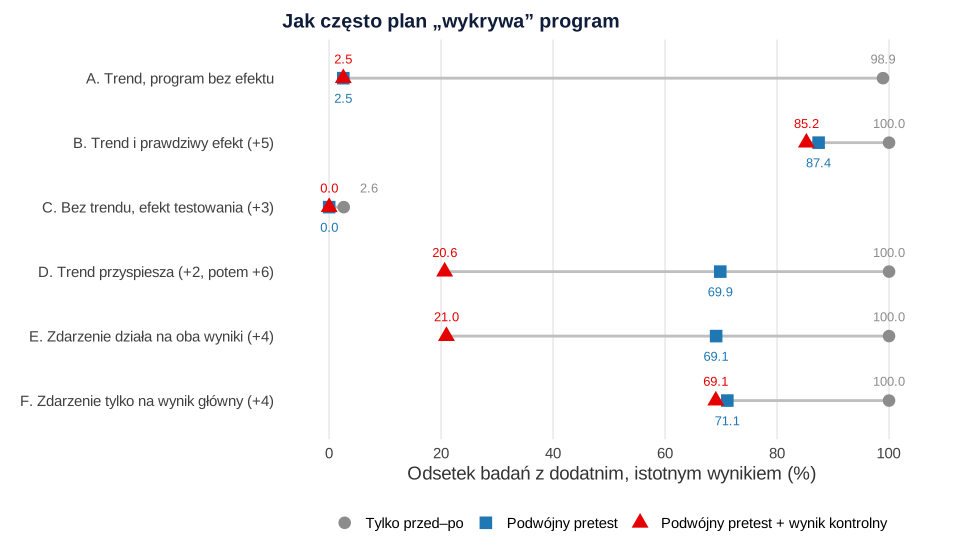
Sam plan przed–po rozpoznaje program prawie zawsze, nawet gdy programu nie ma w scenariuszu A (98.92%). Podwójny pretest usuwa ten błąd (2.54%), a przy prawdziwym efekcie zachowuje moc 87.42%. Płaci się za to w scenariuszu C: efekt testowania „zjada” kontrast (średnio −2.98), więc gdyby program działał, część efektu by zniknęła.
Scenariusze D i E pokazują, gdzie podwójny pretest zawodzi: trend przyspiesza albo w czasie programu dzieje się coś, co podnosi wszystkie wyniki. Wykrywa wtedy „efekt” w około 70% badań. Dołożenie wyniku kontrolnego obniża to do 20.64% i 20.96%. Nie do zera, bo wynik kontrolny też ma ograniczoną moc.
Scenariusz F to najważniejszy wiersz. Jeśli w czasie programu dzieje się coś, co działa wyłącznie na wynik główny (w szkole rusza konkurs czytelniczy), reguła łączna myli się w 69.06% badań. Żaden dodatek nie widzi tego, co działa dokładnie tam i wtedy co program.
Dodatek 3: kilka punktów przed i po (przerwany szereg)
Jeśli pomiar jest tani i powtarzalny albo wyniki leżą w dokumentacji (liczba upadków na oddziale, cotygodniowe próbki czytania), możesz zbudować przerwany szereg czasowy. Technikę opisują wpisy o regresji segmentowej i o szeregach czasowych. Tu ważne są dwie decyzje planu. Lopez Bernal i in. (2016) podkreślają, by model wpływu (skok, zmiana nachylenia, opóźnienie) określić z góry, a przed analizą pomyśleć o autokorelacji, sezonowości i zmiennych zakłócających zmieniających się w czasie.
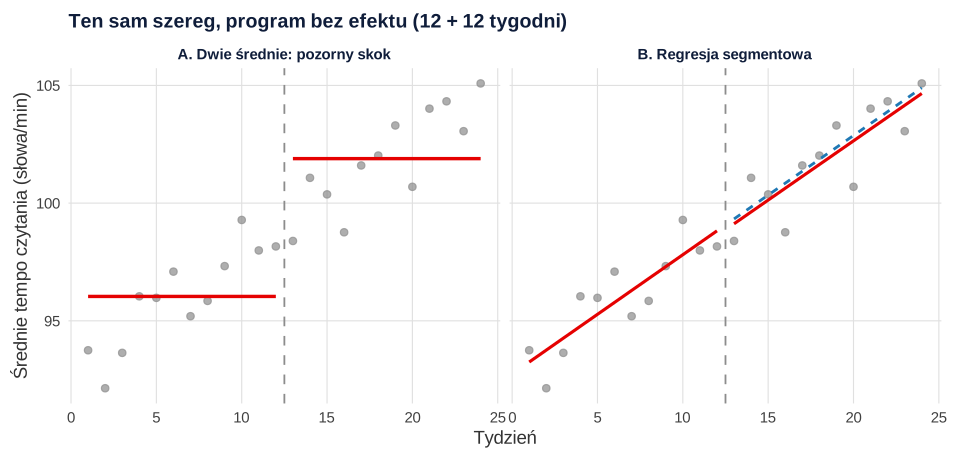
W przykładzie średnia klasy rośnie o 0.35 słowa tygodniowo, program nie działa, a błędy są skorelowane (φ = .3). Porównanie dwóch średnich z 12 tygodni przed i po daje 96.04 i 101.89 słowa, różnicę 5.86, p < .001. Regresja segmentowa daje skok −0.205, 95% CI [−2.165, 1.754], p = .829 i zmianę nachylenia −0.003, 95% CI [−0.286, 0.279], p = .981, czyli brak śladu programu (rysunek 3).
| Punkty przed + po | Porównanie dwóch średnich, efekt 0 | Regresja segmentowa, efekt 0 | Moc przy skoku +3 | SD oszacowania skoku |
|---|---|---|---|---|
| 4 + 4 | 21.70% | 7.56% | 25.56% | 2.15 |
| 6 + 6 | 53.92% | 9.36% | 43.08% | 1.88 |
| 8 + 8 | 85.04% | 11.08% | 51.52% | 1.73 |
| 12 + 12 | 99.90% | 11.78% | 66.06% | 1.49 |
| 24 + 24 | 100.00% | 13.80% | 87.56% | 1.13 |
Tabela (5000 powtórzeń, skok +3 przy SD błędu 1.5) pokazuje, dlaczego nie ma bezpiecznej liczby punktów. Przy 4 + 4 model ma cztery stopnie swobody reszt, a moc wynosi 25.56%. Fałszywych alarmów przybywa wraz z długością serii (7.56% przy 4 + 4, 13.80% przy 24 + 24), bo zwykła regresja ignoruje autokorelację. Turner i in. (2021) stwierdzili w symulacjach, że metody ogólnie działają lepiej przy dłuższych seriach, z wyjątkiem zwykłej regresji przy autokorelacji, a przedziały ufności są zwykle za wąskie we wszystkich metodach. Dla serii krótszych niż 12 punktów preferowali zwykłą regresję, a dla dłuższych metodę REML. Hawley i in. (2019) pokazali, że nawet 12 punktów przed i 12 po nie gwarantuje mocy przy małej liczebności na punkt. Regułę „12 punktów przed i po” traktuj więc najwyżej jako punkt wyjścia i sprawdź moc dla swoich założeń. Jeśli masz tylko 6–8 punktów, opisz przebieg i nie stawiaj mocnych wniosków.
Dodatek 4: stopniowe wdrażanie
Jeśli program i tak trafi do kilku klas, oddziałów lub osób, nie uruchamiaj go wszędzie naraz. Zmiana powinna pojawiać się za każdym razem wtedy, gdy program startuje w danej grupie, a nie w jednym terminie kalendarzowym. Przy kilku osobach lub małych grupach mówimy o wielokrotnej linii bazowej – standardy takich planów opisują Kratochwill i in. (2013). Przy klasach lub oddziałach odpowiednikiem jest schemat stepped-wedge, w którym kolejność wejścia skupień jest losowa. Hemming i in. (2015) ostrzegają, że ponieważ pod koniec badania więcej skupień ma interwencję, jej efekt może być zakłócony trendem czasowym, więc analiza musi uwzględniać czas i skupienie.
Jeśli możesz, wylosuj kolejność startu – to mały koszt, a zamienia dodatek w plan z elementem losowym. Gdy kolejność wybrała placówka, napisz o tym wprost. Oddziały, które wystartowały pierwsze, często są lepiej zmotywowane, a osoby mogą przenosić treści między grupami (kontaminacja).
Dodatek 5: zależność od dawki
Liczba obecności nic nie kosztuje, więc kuszące jest sprawdzenie, czy kto chodził częściej, ten zyskał więcej (zależność dawka–odpowiedź). W pracy dyplomowej to najczęściej najsłabszy z dodatków, bo frekwencję wybierają uczestnicy. W symulacji (5000 badań, n = 60, program bez efektu, zmotywowane osoby chodzą częściej i rozwijają się szybciej) nachylenie zmiany względem frekwencji było średnio dodatnie (b = 0.463 słowa na sesję) i istotne w 26.68% badań.
Podwójny pretest pozwala to sprawdzić testem placebo: czy frekwencja „przewiduje” zmianę przed programem, której program nie mógł spowodować? W symulacji nachylenie było prawie takie samo (b = 0.456), istotne w 26.16% badań. Jeśli dawka „przewiduje” zmianę sprzed programu, Twoja zależność od dawki jest samoselekcją. Taki układ warto zaplanować zawsze, gdy zbierasz frekwencję, a brak związku przed programem opisuj ostrożnie, bo moc jest niewielka.
Dodatek 6: norma albo wcześniejszy rocznik
Pomiar po programie możesz porównać z normami testu, a rocznik z programem z rocznikiem bez niego, jeśli jego wyniki przechowano. To tani dodatek, ale słaby. Normy powstały na innych osobach, często dawniej i w innych warunkach, a uczestnicy Twojego programu nie muszą być do nich podobni. Wcześniejszy rocznik mógł mieć innego nauczyciela, inny egzamin i inną rekrutację.
Klasyczne ostrzeżenie pochodzi z badań klinicznych: Sacks i in. (1982) porównali badania z kontrolą historyczną i randomizowane tych samych sześciu terapii. Terapię uznało za lepszą 79% badań z kontrolą historyczną (44 z 56) i 20% randomizowanych (10 z 50), głównie dlatego, że historyczne grupy kontrolne wypadały gorzej, a korekta na czynniki prognostyczne wiele nie zmieniała. Używaj tego porównania jako kontekstu, nigdy jako głównej analizy. Sprawdź też, czy procedura i narzędzie w obu rocznikach były identyczne, oraz czy masz zgodę na użycie archiwalnych danych.
Który dodatek wybrać
| Dodatek | Koszt | Które wyjaśnienie osłabia | Czego nie rozwiązuje |
|---|---|---|---|
| Podwójny pretest | Jeden pomiar więcej, zwykle kilka tygodni wcześniejszego startu | Spontaniczny trend, dojrzewanie; regresję do średniej, jeśli pierwszy pomiar służył kwalifikacji | Zdarzeń w czasie programu, zmiany tempa; nie odróżni trendu od efektu testowania |
| Wynik kontrolny | Kilka pozycji lub minut w tych samych sesjach | Wspólne przyczyny obu wyników: zdarzenia, trend, styl odpowiadania | Zdarzeń działających tylko na wynik główny; zależy od założenia, że program go nie zmienia |
| Przerwany szereg | Duży: wiele punktów przed i po, chyba że są dane z dokumentacji | Trend, regresję do średniej, część sezonowości | Zdarzenia dokładnie w chwili startu; krótkiej serii i autokorelacji |
| Stopniowe wdrażanie | Kilka grup lub placówek, rozłożenie programu w czasie | Zdarzenia związane z kalendarzem: efekt powinien iść za datą startu grupy | Selekcji, gdy kolejność nie jest losowa; przenikania programu między grupami |
| Zależność od dawki | Mały: lista obecności | Jest przesłanką, sama niczego nie wyklucza | Samoselekcji: kto chodzi częściej, i tak mógł zmieniać się szybciej |
| Norma lub wcześniejszy rocznik | Najmniejszy, jeśli dane istnieją | Częściowo trend wiekowy lub sezonowy | Innych osób, warunków i wersji narzędzia; selekcji do programu |
Dla typowej pracy dyplomowej zwykle realne i najlepsze są dodatki 1 i 2 razem: jedno spotkanie więcej i krótka dodatkowa skala. Dane z dokumentacji sprzyjają szeregowi, a kilka placówek – stopniowemu wdrażaniu. Dodatki 5 i 6 traktuj jako uzupełnienie. Czy taki plan jest w ogóle realny, sprawdzisz w teście wykonalności tematu.
Uczciwy wniosek: żaden dodatek ani ich zestaw nie zastępuje losowej grupy. Każdy wyklucza określone wyjaśnienia, ale zawsze zostaje to, co działa tylko na wynik główny, dokładnie w czasie programu. We wnioskach pisz więc o zgodności wyników z działaniem programu, a nie o jego skuteczności.
Gotowe zdania do pracy
Schemat w „Metodzie” (uzupełnij pola):
Ograniczenia:
Wynik przy podwójnym pretescie (liczby z przykładu fikcyjnego):
Przykład, nazwy i liczby są fikcyjne. Jeśli chcesz, aby ktoś sprawdził plan zanim zaczniesz zbierać dane, skorzystaj z oferty dla studentów.
Plan bez grupy kontrolnej w R: przykład, symulacja i szereg
Trzy przepisy liczą wszystkie liczby z tekstu i tabel. Korzystają tylko z bazowego R. Rysunki powstały w osobnym skrypcie. Ziarna nie wybierano pod wynik, a parametry są założeniami ilustracyjnymi.
Przykład: jedna klasa, trzy pomiary, wynik kontrolny
R
# B497 – jedna klasa, trzy pomiary, program bez działania (dane symulowane, przykład fikcyjny)
# Wynik główny: tempo czytania (słowa na minutę). Wynik kontrolny: tempo prostych działań
# (działania na minutę), na które program czytania nie powinien wpływać.
# T0 – wrzesień, T1 – listopad (przed programem), T2 – styczeń (po 8-tygodniowym programie).
# Założone: prawdziwy efekt programu = 0, dzieci rosną same o ok. 4 słowa w każdym odstępie.
set.seed(4971)
n <- 64
motyw <- rnorm(n)                                     # motywacja (cecha nieobserwowana)
start <- 95 + 20 * motyw * 0.3 + rnorm(n, 0, 19)      # poziom czytania
tempo <- 4 + 1.5 * motyw + rnorm(n, 0, 1)             # przyrost w jednym odstępie
y <- function(k) round(start + k * tempo + rnorm(n, 0, 5))
T0 <- y(0); T1 <- y(1); T2 <- y(2)                    # w T2 nie ma żadnego efektu programu
start_k <- 30 + 8 * (0.3 * motyw + 0.5 * scale(start)[, 1]) + rnorm(n, 0, 6)
kontr <- function(k) round(start_k + k * 0.4 * tempo + rnorm(n, 0, 2))
K0 <- kontr(0); K1 <- kontr(1); K2 <- kontr(2)

opis <- function(x) sprintf("M = %.2f, SD = %.2f", mean(x), sd(x))
cat("Czytanie  T0:", opis(T0), "| T1:", opis(T1), "| T2:", opis(T2), "\n")
cat("Działania T0:", opis(K0), "| T1:", opis(K1), "| T2:", opis(K2), "\n")
cat("\n")

pf <- function(p) if (p < .001) "< .001" else sub("^0", "= ", sprintf("%.3f", p))
raport <- function(x, etykieta) {
  t1 <- t.test(x)
  cat(sprintf("%-42s M = %6.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, p %s, dz = %.2f\n", etykieta,
              mean(x), t1$conf.int[1], t1$conf.int[2], t1$parameter, t1$statistic,
              pf(t1$p.value), mean(x) / sd(x)))
}
raport(T2 - T1, "1. Naiwnie: czytanie T2 - T1")
raport(T1 - T0, "2. Bez programu: czytanie T1 - T0")
raport((T2 - T1) - (T1 - T0), "3. Podwójny pretest: (T2-T1) - (T1-T0)")
raport(K2 - K1, "4. Wynik kontrolny: działania K2 - K1")
sdT <- sd(T1); sdK <- sd(K1)
raport((T2 - T1) / sdT - (K2 - K1) / sdK, "5. Różnica zmian w jednostkach SD")
cat(sprintf("Zmiana w SD: czytanie = %.3f, działania = %.3f\n\n", mean(T2 - T1) / sdT, mean(K2 - K1) / sdK))
Wynik
Czytanie  T0: M = 96.09, SD = 18.20 | T1: M = 100.52, SD = 18.07 | T2: M = 103.47, SD = 20.21
Działania T0: M = 28.30, SD = 7.72 | T1: M = 29.55, SD = 8.39 | T2: M = 31.41, SD = 8.84

1. Naiwnie: czytanie T2 - T1               M =   2.95, 95% CI [0.80, 5.10], t(63) = 2.75, p = .008, dz = 0.34
2. Bez programu: czytanie T1 - T0          M =   4.42, 95% CI [2.61, 6.24], t(63) = 4.87, p < .001, dz = 0.61
3. Podwójny pretest: (T2-T1) - (T1-T0)    M =  -1.47, 95% CI [-4.87, 1.94], t(63) = -0.86, p = .392, dz = -0.11
4. Wynik kontrolny: działania K2 - K1     M =   1.86, 95% CI [1.11, 2.61], t(63) = 4.94, p < .001, dz = 0.62
5. Różnica zmian w jednostkach SD        M =  -0.06, 95% CI [-0.21, 0.09], t(63) = -0.78, p = .437, dz = -0.10
Zmiana w SD: czytanie = 0.163, działania = 0.222
Symulacja: sześć światów i dawka
R
# B497 – 5000 powtórzeń badania bez grupy kontrolnej w sześciu światach (dane symulowane)
# n = 60, trzy pomiary, wynik główny (Y) i wynik kontrolny (K). Parametry ustawione ręcznie.
# Y: SD poziomu = 20, błąd pomiaru = 5. K: te same wielkości razy 0.4 (inne jednostki).
set.seed(4972)
R <- 5000; n <- 60
swiaty <- list(                          # a, b – przyrost spontaniczny T0->T1 i T1->T2
  "A. Trend, program bez efektu"           = c(a = 4, b = 4, test = 0, efekt = 0, oba = 0, tylkoY = 0),
  "B. Trend i prawdziwy efekt (+5)"        = c(a = 4, b = 4, test = 0, efekt = 5, oba = 0, tylkoY = 0),
  "C. Bez trendu, efekt testowania (+3)"   = c(a = 0, b = 0, test = 3, efekt = 0, oba = 0, tylkoY = 0),
  "D. Trend przyspiesza (+2, potem +6)"    = c(a = 2, b = 6, test = 0, efekt = 0, oba = 0, tylkoY = 0),
  "E. Zdarzenie działa na oba wyniki (+4)" = c(a = 4, b = 4, test = 0, efekt = 0, oba = 4, tylkoY = 0),
  "F. Zdarzenie tylko na wynik główny (+4)" = c(a = 4, b = 4, test = 0, efekt = 0, oba = 0, tylkoY = 4)
)
istotny <- function(x) {                 # dodatnio istotny test t dla jednej próby (kolumny = badania)
  colMeans(x) / (apply(x, 2, sd) / sqrt(n)) > qt(.975, n - 1)
}
losuj <- function(s = 1) matrix(rnorm(n * R, 0, s), n, R)
jeden_swiat <- function(p) {
  wspolny <- losuj()
  poziomY <- 20 * (sqrt(.5) * wspolny + sqrt(.5) * losuj())   # korelacja poziomów Y i K = .50
  poziomK <- 20 * (sqrt(.5) * wspolny + sqrt(.5) * losuj())
  tempo <- losuj(1.5)                                         # osobiste tempo zmiany, wspólne dla Y i K
  e <- function() losuj(5)
  przyrost1 <- p[["a"]] + p[["test"]]
  przyrost2 <- przyrost1 + p[["b"]] + p[["oba"]]
  Y0 <- poziomY + e()
  Y1 <- poziomY + przyrost1 + tempo + e()
  Y2 <- poziomY + przyrost2 + 2 * tempo + p[["efekt"]] + p[["tylkoY"]] + e()
  K0 <- 0.4 * (poziomK + e())
  K1 <- 0.4 * (poziomK + przyrost1 + tempo + e())
  K2 <- 0.4 * (poziomK + przyrost2 + 2 * tempo + e())
  naiwna <- Y2 - Y1
  podwojny <- naiwna - (Y1 - Y0)                              # (T2 - T1) - (T1 - T0)
  zmianaK <- K2 - K1
  podwojnyK <- zmianaK - (K1 - K0)                            # ten sam kontrast dla wyniku kontrolnego
  sN <- istotny(naiwna); sP <- istotny(podwojny); sK <- istotny(zmianaK); sPK <- istotny(podwojnyK)
  c(naiwna_sr = mean(naiwna), naiwna_proc = 100 * mean(sN), podw_sr = mean(podwojny), podw_proc = 100 * mean(sP),
    K_zm_proc = 100 * mean(sK), K_podw_proc = 100 * mean(sPK), lacznie_proc = 100 * mean(sP & !sPK))
}
wynik <- t(sapply(swiaty, jeden_swiat))
print(round(wynik, 2))

# Dawka bez działania programu: bardziej zmotywowani chodzą częściej i rosną szybciej
cat("\nDawka–odpowiedź przy zerowym efekcie programu (n = 60, 5000 powtórzeń)\n")
dawka <- replicate(R, {
  motyw <- rnorm(n)
  tempo_i <- 4 + 1.5 * motyw + rnorm(n, 0, 1)
  start <- rnorm(n, 95, 20); bl <- function() rnorm(n, 0, 5)
  T0 <- start + bl(); T1 <- start + tempo_i + bl(); T2 <- start + 2 * tempo_i + bl()
  sesje <- pmin(16, pmax(4, round(12 + 2.5 * motyw + rnorm(n, 0, 1.5))))
  m1 <- summary(lm(I(T2 - T1) ~ sesje))$coefficients["sesje", c(1, 4)]
  m2 <- summary(lm(I(T1 - T0) ~ sesje))$coefficients["sesje", c(1, 4)]
  c(b_po = m1[[1]], p_po = m1[[2]], b_przed = m2[[1]], p_przed = m2[[2]])
})
dawka <- t(dawka)
ist_po <- dawka[, "b_po"] > 0 & dawka[, "p_po"] < .05
cat(sprintf("Nachylenie zmiany T1-T2 na frekwencję: średnio b = %.3f, istotne dodatnio w %.2f%% badań\n",
            mean(dawka[, "b_po"]), 100 * mean(ist_po)))
cat(sprintf("Test placebo (zmiana T0-T1 na frekwencję): średnio b = %.3f, istotny dodatnio w %.2f%% badań\n",
            mean(dawka[, "b_przed"]), 100 * mean(dawka[, "b_przed"] > 0 & dawka[, "p_przed"] < .05)))
Wynik
                                        naiwna_sr naiwna_proc podw_sr podw_proc
A. Trend, program bez efektu                 4.02       98.92    0.02      2.54
B. Trend i prawdziwy efekt (+5)              8.98      100.00    4.98     87.42
C. Bez trendu, efekt testowania (+3)         0.01        2.62   -2.98      0.02
D. Trend przyspiesza (+2, potem +6)          5.99      100.00    3.99     69.86
E. Zdarzenie działa na oba wyniki (+4)       8.01      100.00    3.98     69.12
F. Zdarzenie tylko na wynik główny (+4)      8.02      100.00    4.03     71.12
                                        K_zm_proc K_podw_proc lacznie_proc
A. Trend, program bez efektu                99.00        2.08         2.54
B. Trend i prawdziwy efekt (+5)             98.88        2.54        85.24
C. Bez trendu, efekt testowania (+3)         2.06        0.02         0.02
D. Trend przyspiesza (+2, potem +6)        100.00       69.84        20.64
E. Zdarzenie działa na oba wyniki (+4)     100.00       69.14        20.96
F. Zdarzenie tylko na wynik główny (+4)     98.82        2.78        69.06

Dawka–odpowiedź przy zerowym efekcie programu (n = 60, 5000 powtórzeń)
Nachylenie zmiany T1-T2 na frekwencję: średnio b = 0.463, istotne dodatnio w 26.68% badań
Test placebo (zmiana T0-T1 na frekwencję): średnio b = 0.456, istotny dodatnio w 26.16% badań
Przerwany szereg: średnie a regresja segmentowa
R
# B497 – przerwany szereg czasowy przy trendzie bez efektu programu (dane symulowane)
# Cotygodniowy jednominutowy pomiar czytania; średnia klasy w każdym tygodniu.
# Trend 0.35 słowa na tydzień, błędy AR(1) z phi = .3, SD błędu = 1.5. Parametry ustawione ręcznie.
set.seed(4973)
seria <- function(k, skok = 0) {
  N <- 2 * k; t <- 1:N
  e <- as.numeric(arima.sim(list(ar = 0.3), n = N, sd = 1.5 * sqrt(1 - 0.3^2)))
  po <- as.numeric(t > k)
  data.frame(t, po, t_po = pmax(0, t - (k + 1)), y = 95 + 0.35 * t + skok * po + e)
}
analizy <- function(d) {
  w <- t.test(y ~ po, d)                                  # porównanie średnich przed i po
  m <- lm(y ~ t + po + t_po, d)                           # regresja segmentowa
  c(p_srednie = w$p.value, diff = mean(d$y[d$po == 1]) - mean(d$y[d$po == 0]),
    p_poziom = coef(summary(m))["po", 4], poziom = coef(m)[["po"]], p_nachyl = coef(summary(m))["t_po", 4])
}
przyklad <- seria(12)
a <- analizy(przyklad); m <- lm(y ~ t + po + t_po, przyklad)
cat(sprintf("Jeden szereg 12 + 12 tygodni: średnie przed = %.2f, po = %.2f, różnica = %.2f, p %s\n",
            mean(przyklad$y[przyklad$po == 0]), mean(przyklad$y[przyklad$po == 1]), a[["diff"]],
            if (a[["p_srednie"]] < .001) "< .001" else sprintf("%.3f", a[["p_srednie"]])))
print(round(cbind(coef(summary(m))[, 1:2], confint(m), p = coef(summary(m))[, 4]), 3))

R <- 5000
wiersz <- function(k) {
  zero <- t(replicate(R, analizy(seria(k))))
  skok <- t(replicate(R, analizy(seria(k, skok = 3))))
  c(k = k, srednie_FP = 100 * mean(zero[, "p_srednie"] < .05), poziom_FP = 100 * mean(zero[, "p_poziom"] < .05),
    poziom_srednio = mean(zero[, "poziom"]), moc_skok3 = 100 * mean(skok[, "p_poziom"] < .05),
    sr_skok3 = mean(skok[, "poziom"]), sd_skok3 = sd(skok[, "poziom"]))
}
tabela <- t(sapply(c(4, 6, 8, 12, 24), wiersz))
print(round(tabela, 2), row.names = FALSE)
Wynik
Jeden szereg 12 + 12 tygodni: średnie przed = 96.04, po = 101.89, różnica = 5.86, p < .001
            Estimate Std. Error  2.5 % 97.5 %     p
(Intercept)   92.742      0.704 91.273 94.211 0.000
t              0.507      0.096  0.307  0.706 0.000
po            -0.205      0.939 -2.165  1.754 0.829
t_po          -0.003      0.135 -0.286  0.279 0.981
      k srednie_FP poziom_FP poziom_srednio moc_skok3 sr_skok3 sd_skok3
[1,]  4      21.70      7.56          -0.03     25.56     2.96     2.15
[2,]  6      53.92      9.36          -0.02     43.08     3.06     1.88
[3,]  8      85.04     11.08           0.00     51.52     2.98     1.73
[4,] 12      99.90     11.78           0.02     66.06     2.99     1.49
[5,] 24     100.00     13.80           0.00     87.56     2.98     1.13
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Zanim zaczniesz zbierać dane
- Czy wybrano dodatki przed rozpoczęciem programu i zapisano przewidywania?
- Czy odstępy między pomiarami są równe, a pomiar kwalifikujący nie jest pomiarem wyjściowym?
- Czy wynik kontrolny ma te same źródła błędu co główny i program na pewno go nie dotyczy?
- Czy zaplanowano wersję równoległą narzędzia albo inną obronę przed efektem testowania?
- Czy przy szeregu określono z góry kształt efektu i policzono moc?
- Czy zapisywana jest frekwencja i czy zaplanowano test placebo?
- Czy we wnioskach nie pada słowo „skuteczność”?
Najczęstsze pytania
Co dodać do badania, jeśli nie mam grupy kontrolnej?
Zwykle najbardziej realne są dwa dodatki: drugi pomiar przed programem i wynik, na który program nie powinien działać. Gdy masz dane z dokumentacji, możesz zbudować przerwany szereg czasowy, a gdy jest kilka grup – wdrażać program stopniowo. Wybór zrób przed zebraniem danych i uzgodnij go z promotorem.
Po co robić dwa pomiary przed programem?
Dwa pomiary pokazują, czy wynik zmieniał się już bez programu, i pozwalają porównać tempo zmiany przed programem i w jego trakcie. Oddzielają też pomiar kwalifikujący od wyjściowego. Same nie odróżnią jednak trendu od efektu uczenia się testu i wymagają równych odstępów.
Co to jest wynik kontrolny w badaniu bez grupy kontrolnej?
To zmienna, która podlega tym samym wpływom ubocznym co wynik główny, ale której program nie powinien zmienić. Jeśli zmienia się podobnie, zmianę wyniku głównego trudno przypisać programowi. Wynik kontrolny służy do wykrywania błędu, a nie do szacowania efektu.
Ile punktów czasowych trzeba do przerwanego szeregu czasowego?
Nie ma jednej bezpiecznej liczby. W symulacji przy 4 punktach przed i 4 po moc wyniosła 25.56%, a przy 12 + 12 – 66.06%. Liczba punktów zależy od zmienności, autokorelacji i wielkości efektu, dlatego moc policz dla swoich założeń, a przy krótkim szeregu opisuj przebieg bez mocnych wniosków.
Czy większy efekt u osób z wyższą frekwencją dowodzi działania programu?
Nie. Osoby bardziej zmotywowane częściej przychodzą i często i tak zmieniają się szybciej. W symulacji przy zerowym efekcie zależność od frekwencji była istotna w 26.68% badań. Mając dwa pomiary przed programem, sprawdź, czy frekwencja „przewiduje” także zmianę sprzed programu.
Czy mogę porównać wyniki z normami zamiast z grupą kontrolną?
Możesz, ale traktuj to jako kontekst, a nie główną analizę. Normy pochodzą od innych osób, często z innego czasu i warunków. Podobnie wcześniejszy rocznik: inny nauczyciel, inny skład grupy i inna procedura mogą odpowiadać za różnicę.
Powiązane hasła
Przeczytaj też
Badanie przed i po – opis metody i wnioski
Gotowy podrozdział „Metoda” dla jednej grupy i grupy nierandomizowanej, symulacja regresji do średniej i zdania, które wolno napisać we wnioskach.
Czytaj →PoradnikGrupa kontrolna w badaniu interwencji
Lista oczekujących, zwykła opieka czy aktywna kontrola: co każda opcja kontroluje, symulacja w R, tabela decyzyjna i gotowe zdania do pracy.
Czytaj →PoradnikRegresja segmentowa i przerwany szereg czasowy
Zmiana poziomu i nachylenia, gls z AR(1), sezonowość, szereg kontrolny, nieznany punkt załamania z bootstrapem, przykład w R i wzór opisu.
Czytaj →PoradnikBadanie jednego przypadku (single-case)
Schematy ABAB i wielokrotnej linii bazowej, analiza wizualna w liczbach, NAP, Tau-U i jego pułapki, test randomizacyjny, SCRIBE i kod R.
Czytaj →PoradnikEwaluacja programu w jednej placówce – opis metody
Gotowy podrozdział „Metoda”: autor jako prowadzący, wierność realizacji, grupa porównawcza i dozwolone wnioski, z kodem R.
Czytaj →Nie masz grupy kontrolnej i nie wiesz, jak obronić plan?
Sprawdzimy plan, zanim zaczniesz zbierać dane, policzymy analizę w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hawley, S., Ali, M. S., Berencsi, K., Judge, A., & Prieto-Alhambra, D. (2019). Sample size and power considerations for ordinary least squares interrupted time series analysis: A simulation study. Clinical Epidemiology, Volume 11, 197–205. https://doi.org/10.2147/clep.s176723 ● Otwarty dostęp
- Hemming, K., Haines, T. P., Chilton, P. J., Girling, A. J., & Lilford, R. J. (2015). The stepped wedge cluster randomised trial: Rationale, design, analysis, and reporting. BMJ, 350, Article h391. https://doi.org/10.1136/bmj.h391 ● Otwarty dostęp
- Kratochwill, T. R., Hitchcock, J. H., Horner, R. H., Levin, J. R., Odom, S. L., Rindskopf, D. M., & Shadish, W. R. (2013). Single-case intervention research design standards. Remedial and Special Education, 34(1), 26–38. https://doi.org/10.1177/0741932512452794
- Lipsitch, M., Tchetgen Tchetgen, E., & Cohen, T. (2010). Negative controls: A tool for detecting confounding and bias in observational studies. Epidemiology, 21(3), 383–388. https://doi.org/10.1097/ede.0b013e3181d61eeb ● Otwarty dostęp: pełny tekst
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2016). Interrupted time series regression for the evaluation of public health interventions: A tutorial. International Journal of Epidemiology, 46(1), 348–355. https://doi.org/10.1093/ije/dyw098 ● Otwarty dostęp
- Marsden, E., & Torgerson, C. J. (2012). Single group, pre- and post-test research designs: Some methodological concerns. Oxford Review of Education, 38(5), 583–616. https://doi.org/10.1080/03054985.2012.731208 ● Otwarty dostęp: pełny tekst
- Sacks, H., Chalmers, T. C., & Smith, H., Jr. (1982). Randomized versus historical controls for clinical trials. The American Journal of Medicine, 72(2), 233–240. https://doi.org/10.1016/0002-9343(82)90815-4
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Turner, S. L., Forbes, A. B., Karahalios, A., Taljaard, M., & McKenzie, J. E. (2021). Evaluation of statistical methods used in the analysis of interrupted time series studies: A simulation study. BMC Medical Research Methodology, 21(1), Article 181. https://doi.org/10.1186/s12874-021-01364-0 ● Otwarty dostęp
Cytowania BibTeX
@article{hawley2019sample, author={Hawley, Samuel and Ali, M. Sanni and Berencsi, Klara and Judge, Andrew and Prieto-Alhambra, Daniel}, title={{Sample size and power considerations for ordinary least squares interrupted time series analysis: A simulation study}}, journal={Clinical Epidemiology}, year={2019}, volume={Volume 11}, pages={197--205}, doi={10.2147/clep.s176723}}@article{hemming2015stepped, author={Hemming, Karla and Haines, Terry P. and Chilton, Peter J. and Girling, Alan J. and Lilford, Richard J.}, title={{The stepped wedge cluster randomised trial: Rationale, design, analysis, and reporting}}, journal={BMJ}, year={2015}, volume={350}, eid={h391}, doi={10.1136/bmj.h391}}@article{kratochwill2013single, author={Kratochwill, Thomas R. and Hitchcock, John H. and Horner, Robert H. and Levin, Joel R. and Odom, Samuel L. and Rindskopf, David M. and Shadish, William R.}, title={{Single-case intervention research design standards}}, journal={Remedial and Special Education}, year={2013}, volume={34}, number={1}, pages={26--38}, doi={10.1177/0741932512452794}}@article{lipsitch2010negative, author={Lipsitch, Marc and Tchetgen Tchetgen, Eric and Cohen, Ted}, title={{Negative controls: A tool for detecting confounding and bias in observational studies}}, journal={Epidemiology}, year={2010}, volume={21}, number={3}, pages={383--388}, doi={10.1097/ede.0b013e3181d61eeb}}@article{lopezbernal2016interrupted, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{Interrupted time series regression for the evaluation of public health interventions: A tutorial}}, journal={International Journal of Epidemiology}, year={2016}, volume={46}, number={1}, pages={348--355}, doi={10.1093/ije/dyw098}}@article{marsden2012single, author={Marsden, Emma and Torgerson, Carole J.}, title={{Single group, pre- and post-test research designs: Some methodological concerns}}, journal={Oxford Review of Education}, year={2012}, volume={38}, number={5}, pages={583--616}, doi={10.1080/03054985.2012.731208}}@article{sacks1982randomized, author={Sacks, Henry and Chalmers, Thomas C. and Smith, Harry, Jr.}, title={{Randomized versus historical controls for clinical trials}}, journal={The American Journal of Medicine}, year={1982}, volume={72}, number={2}, pages={233--240}, doi={10.1016/0002-9343(82)90815-4}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{turner2021evaluation, author={Turner, Simon L. and Forbes, Andrew B. and Karahalios, Amalia and Taljaard, Monica and McKenzie, Joanne E.}, title={{Evaluation of statistical methods used in the analysis of interrupted time series studies: A simulation study}}, journal={BMC Medical Research Methodology}, year={2021}, volume={21}, number={1}, eid={181}, doi={10.1186/s12874-021-01364-0}}