Co to jest zależność dawka–odpowiedź?
Zależność dawka–odpowiedź (ang. dose–response relationship) opisuje, jak efekt zmienia się wraz z ilością ekspozycji: dawką leku, liczbą sesji terapii, spożyciem alkoholu czy godzinami nauki. Monotoniczny gradient jest jednym z argumentów za przyczynowością w kryteriach Bradforda Hilla, ale kształt bywa też nieliniowy, np. w kształcie litery J lub U.
W badaniach obserwacyjnych wyniki podaje się zwykle w kategoriach dawki jako ryzyka względne względem tej samej grupy referencyjnej. Takie oszacowania są skorelowane, bo dzielą grupę odniesienia. Greenland i Longnecker (1992) zaproponowali metody, które odtwarzają te korelacje z danych zbiorczych (liczba przypadków i osób w kategoriach), dają trafniejsze wariancje nachylenia, a jedna z nich pozwala szacować też składowe nieliniowe. W metaanalizie łączy się potem nachylenia lub współczynniki splajnów z wielu badań; pakiet dosresmeta obejmuje odtwarzanie kowariancji, elastyczne modelowanie ekspozycji, ocenę heterogeniczności i prezentację krzywej (Crippa i Orsini, 2016). Dla danych eksperymentalnych (np. ED50) służy pakiet drc (Ritz i in., 2015).
Przykład
Zbiór alcohol_cvd z pakietu dosresmeta zawiera sześć badań o spożyciu alkoholu (g/dzień) i chorobach układu krążenia. W pierwszym badaniu nachylenie z kowariancjami Greenlanda–Longneckera wyniosło 0.0108 (SE = 0.0051), a naiwna regresja ignorująca korelacje – 0.0082 (SE = 0.0044). Trend liniowy w metaanalizie był bliski zera (log RR = −0.044 na 10 g, p = .459). Splajn kubiczny ujawnił kształt J: RR = 0.77 przy 10 g i 0.72 przy 20 g, ale 1.63 (95% CI: 0.38–6.94) przy 60 g; test nieliniowości: χ²(1) = 3.53, p = .060.
Na rysunku
Rysunek zestawia dwa typy krzywych dawka–odpowiedź. Panel A to eksperyment: zbiór ryegrass z pakietu drc (24 pomiary długości korzeni życicy przy siedmiu stężeniach kwasu ferulowego) i czteroparametrowy model log-logistyczny. Panel B to krzywa z metaanalizy z przykładu powyżej. Oba zbiory są wbudowane w pakiety R, więc nic nie losowano.
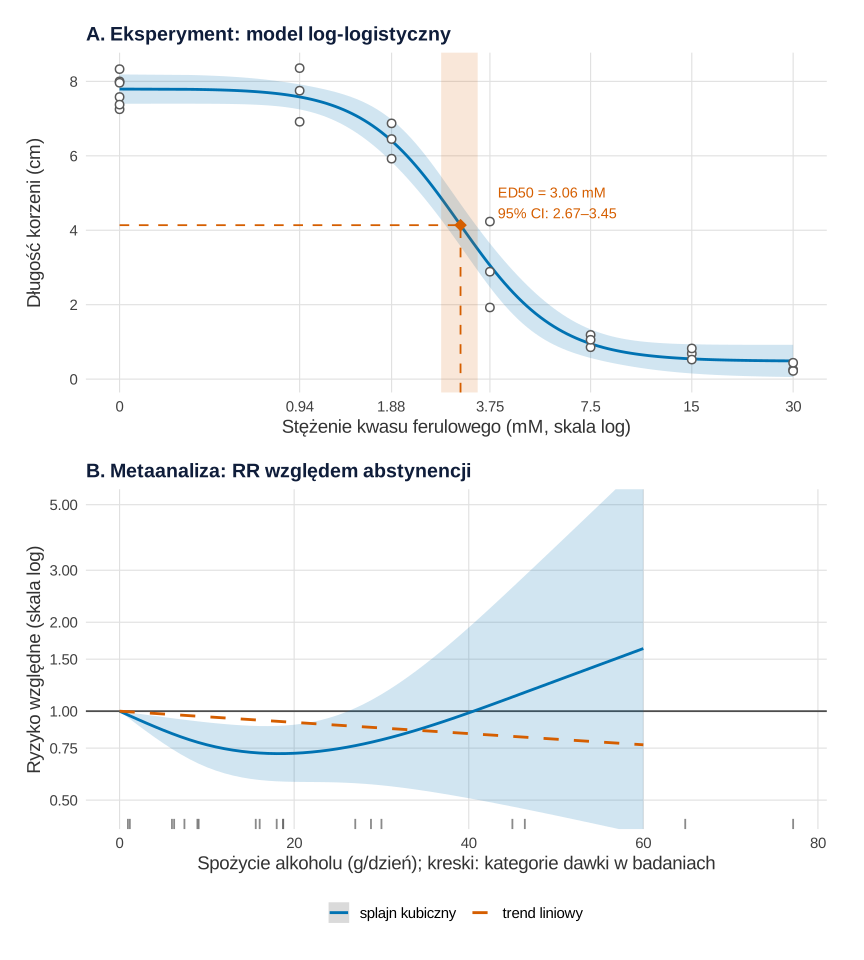
Co widać. W panelu A krzywa ma kształt odwróconej litery S między górną asymptotą (7.79 cm) a dolną (0.48 cm). ED50, czyli stężenie, przy którym odpowiedź jest w połowie drogi między asymptotami, wynosi 3.06 mM (95% CI: 2.67–3.45). Na osi logarytmicznej krzywa jest symetryczna wokół ED50, a parametr nachylenia (b = 2.98) mówi, jak stromo spada. W panelu B splajn ma minimum RR = 0.72 przy 18 g/dzień, a potem rośnie. Trend liniowy uśrednia ten kształt do łagodnego spadku (RR = 0.77 przy 60 g wobec 1.63 ze splajnu).
Na co uważać. Pasmo w panelu B jest wąskie przy małych dawkach i bardzo szerokie powyżej 40 g. Tylko 4 z 19 niezerowych kategorii dawki leżą powyżej 40 g (kreski przy osi), więc wzrost ryzyka na prawym końcu jest słabo oszacowany. Jak odróżnić pasmo ufności krzywej od zakresu pojedynczych wyników, wyjaśnia hasło pasmo ufności i pasmo predykcji. W panelu A model zakłada symetryczną krzywą S. Jeśli punkty odstają od niej systematycznie, warto sprawdzić inny model z rodziny drc. Żaden z wykresów nie mówi nic o przyczynowości.
Podpis do pracy:
Kod poniżej odtwarza rysunek i wypisuje liczby użyte w opisie. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p z motywem serwisu. Dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Krzywa dawka–odpowiedź w eksperymencie (log-logistyczna, ED50) i w metaanalizie (splajn, RR)
library(ggplot2)
library(patchwork)
suppressPackageStartupMessages(library(drc))
suppressPackageStartupMessages(library(dosresmeta))

# Paleta Okabe–Ito i prosty motyw
kol <- c(model = "#0072B2", akcent = "#D55E00", dane = "grey35")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. Eksperyment: długość korzeni życicy a stężenie kwasu ferulowego (zbiór ryegrass z pakietu drc)
data("ryegrass")
m <- drm(rootl ~ conc, data = ryegrass, fct = LL.4(names = c("b", "dolna", "gorna", "ED50")))
round(coef(summary(m))[, 1:2], 3)
ed <- ED(m, 50, interval = "delta", display = FALSE)
round(ed, 3)                                         # ED50 z 95% CI (metoda delta)
siatka <- data.frame(conc = c(0, exp(seq(log(0.3), log(30), length.out = 150))))
pA_pred <- cbind(siatka, predict(m, newdata = siatka, interval = "confidence"))
pol <- (coef(m)[2] + coef(m)[3]) / 2                 # połowa drogi między dolną a górną asymptotą
os_x <- scales::pseudo_log_trans(sigma = 0.3)        # oś „prawie logarytmiczna”, która mieści stężenie 0

pA <- ggplot(pA_pred, aes(conc)) +
  geom_ribbon(aes(ymin = Lower, ymax = Upper), fill = kol[["model"]], alpha = 0.18) +
  geom_line(aes(y = Prediction), colour = kol[["model"]], linewidth = 1) +
  geom_point(data = ryegrass, aes(conc, rootl), colour = kol[["dane"]], shape = 21, fill = "white", size = 2.4, stroke = 0.8) +
  annotate("rect", xmin = ed[1, "Lower"], xmax = ed[1, "Upper"], ymin = -Inf, ymax = Inf, fill = kol[["akcent"]], alpha = 0.15) +
  annotate("segment", x = ed[1, "Estimate"], xend = ed[1, "Estimate"], y = -Inf, yend = pol, colour = kol[["akcent"]], linetype = "dashed") +
  annotate("segment", x = 0, xend = ed[1, "Estimate"], y = pol, yend = pol, colour = kol[["akcent"]], linetype = "dashed") +
  annotate("point", x = ed[1, "Estimate"], y = pol, colour = kol[["akcent"]], shape = 18, size = 4) +
  annotate("text", x = ed[1, "Upper"] * 1.15, y = pol + 0.6, hjust = 0, size = 3.8, colour = kol[["akcent"]],
           label = sprintf("ED50 = %.2f mM\n95%% CI: %.2f–%.2f", ed[1, "Estimate"], ed[1, "Lower"], ed[1, "Upper"])) +
  scale_x_continuous(trans = os_x, breaks = c(0, 0.94, 1.88, 3.75, 7.5, 15, 30), labels = c("0", "0.94", "1.88", "3.75", "7.5", "15", "30")) +
  labs(title = "A. Eksperyment: model log-logistyczny", x = "Stężenie kwasu ferulowego (mM, skala log)",
       y = "Długość korzeni (cm)") +
  motyw

# B. Metaanaliza sześciu badań: alkohol a choroby układu krążenia (zbiór alcohol_cvd), splajn vs trend liniowy
data("alcohol_cvd")
d <- alcohol_cvd
k <- quantile(d$dose, c(.1, .5, .9))
spl <- dosresmeta(logrr ~ rms::rcs(dose, k), id = id, type = type, cases = cases, n = n, se = se, data = d)
lin <- dosresmeta(logrr ~ dose, id = id, type = type, cases = cases, n = n, se = se, data = d)
nowe <- data.frame(dose = seq(0, 60, by = 1))
ps <- predict(spl, newdata = nowe, expo = TRUE)
pl <- predict(lin, newdata = nowe, expo = TRUE)
krzywe <- rbind(data.frame(dose = nowe$dose, model = "splajn kubiczny", rr = ps$pred, lo = ps$ci.lb, hi = ps$ci.ub),
                data.frame(dose = nowe$dose, model = "trend liniowy", rr = pl$pred, lo = pl$ci.lb, hi = pl$ci.ub))
print(round(subset(krzywe, dose %in% c(10, 20, 40, 60))[, -2], 3), row.names = FALSE)
c(min_RR_splajn = round(min(ps$pred), 3), przy_dawce = nowe$dose[which.min(ps$pred)])
round(c(kategorie_powyzej_40g = sum(d$dose > 40), wszystkie_niezerowe = sum(d$dose > 0)), 0)

pB <- ggplot(krzywe, aes(dose, rr, colour = model, linetype = model, fill = model)) +
  geom_hline(yintercept = 1, colour = "grey30") +
  geom_ribbon(data = subset(krzywe, model == "splajn kubiczny"), aes(ymin = lo, ymax = hi), alpha = 0.18, colour = NA) +
  geom_line(linewidth = 1) +
  geom_rug(data = subset(d, dose > 0), aes(x = dose), inherit.aes = FALSE, sides = "b", colour = kol[["dane"]], alpha = 0.7) +
  scale_colour_manual(values = c("splajn kubiczny" = kol[["model"]], "trend liniowy" = kol[["akcent"]]), name = NULL) +
  scale_fill_manual(values = c("splajn kubiczny" = kol[["model"]], "trend liniowy" = kol[["akcent"]]), guide = "none") +
  scale_linetype_manual(values = c("splajn kubiczny" = "solid", "trend liniowy" = "dashed"), name = NULL) +
  scale_y_continuous(trans = "log", breaks = c(0.5, 0.75, 1, 1.5, 2, 3, 5)) +
  coord_cartesian(ylim = c(0.45, 5)) +
  labs(title = "B. Metaanaliza: RR względem abstynencji", x = "Spożycie alkoholu (g/dzień); kreski: kategorie dawki w badaniach",
       y = "Ryzyko względne (skala log)") +
  motyw

p <- pA / pB
p
Wynik w R
                  Estimate Std. Error
b:(Intercept)        2.982      0.465
dolna:(Intercept)    0.481      0.212
gorna:(Intercept)    7.793      0.189
ED50:(Intercept)     3.058      0.186
       Estimate Std. Error Lower Upper
e:1:50    3.058      0.186 2.671 3.445
 dose    rr    lo    hi
   10 0.770 0.646 0.917
   20 0.720 0.577 0.900
   40 0.987 0.507 1.920
   60 1.630 0.383 6.941
   10 0.957 0.853 1.074
   20 0.916 0.727 1.154
   40 0.840 0.529 1.333
   60 0.770 0.385 1.538
min_RR_splajn    przy_dawce
        0.718        18.000
kategorie_powyzej_40g   wszystkie_niezerowe
                    4                    19
Jak opisać w pracy
Na co uważać
- Brak trendu liniowego nie oznacza braku związku – przy kształcie J lub U sprawdź model nieliniowy (zob. splajny i GAM).
- Gradient nie dowodzi przyczynowości, bo zmienna zakłócająca też może rosnąć z dawką.
- Szerokie przedziały na krańcach wynikają z małej liczby osób z najwyższą dawką.
Zależność dawka–odpowiedź w R
Kod porównuje nachylenie z kowariancjami Greenlanda–Longneckera z naiwną regresją w jednym badaniu, a potem łączy sześć badań funkcją dosresmeta() w modelu liniowym i splajnie kubicznym (rms::rcs). Liczby w tekście pochodzą z tego kodu.
Trend liniowy, splajn i test nieliniowości
R
set.seed(697)                                        # analiza deterministyczna; ziarno dla porządku
suppressPackageStartupMessages(library(dosresmeta))
data("alcohol_cvd")                                  # 6 badań: alkohol (g/dzień) a ryzyko chorób układu krążenia
d <- alcohol_cvd
# 1. Jedno badanie: nachylenie z kowariancjami Greenlanda-Longneckera a naiwna regresja ważona
b1 <- subset(d, id == 1)
gl <- dosresmeta(logrr ~ dose, type = type, cases = cases, n = n, se = se,
                 data = b1)
naiw <- lm(logrr ~ dose - 1, data = b1[-1, ], weights = 1 / se^2)
round(c(GL_b = coef(gl), GL_se = sqrt(vcov(gl))[1],
        naiw_b = coef(naiw), naiw_se = sqrt(vcov(naiw)[1] / summary(naiw)$sigma^2)), 4)
# 2. Metaanaliza sześciu badań: trend liniowy i splajn kubiczny
lin <- dosresmeta(logrr ~ dose, id = id, type = type, cases = cases, n = n, se = se,
                  data = d)
k <- quantile(d$dose, c(.1, .5, .9))
spl <- dosresmeta(logrr ~ rms::rcs(dose, k), id = id, type = type, cases = cases,
                  n = n, se = se, data = d)
round(c(b_lin_10g = 10 * unname(coef(lin)), p_lin = summary(lin)$coefficients[1, 4]), 4)
w <- waldtest(b = coef(spl), Sigma = vcov(spl), Terms = 2)  # test nieliniowości (2. człon splajnu)
round(w$chitest, 4)
nowe <- data.frame(dose = c(0, 10, 20, 40, 60))
pr <- predict(spl, newdata = nowe, expo = TRUE)       # RR względem 0 g/dzień
print(data.frame(dose = nowe$dose, round(pr[, c("pred", "ci.lb", "ci.ub")], 3)))
Wynik w R
  GL_b.dose       GL_se naiw_b.dose     naiw_se
     0.0108      0.0051      0.0082      0.0044
b_lin_10g     p_lin
  -0.0437    0.4585
  chi2     df      P
3.5307 1.0000 0.0602
  dose  pred ci.lb ci.ub
1    0 1.000 1.000 1.000
2   10 0.770 0.646 0.917
3   20 0.720 0.577 0.900
4   40 0.987 0.507 1.920
5   60 1.630 0.383 6.941
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety dosresmeta 2.2.0, mixmeta 1.2.2 i rms 8.2-1). Rysunek 1 wykonano pakietami drc 4.0.0, ggplot2, scales i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- dosresmeta (wersja 2.2.0): Crippa, A., & Orsini, N. (2016). Multivariate dose-response meta-analysis: The dosresmeta R package. Journal of Statistical Software, Code Snippets, 72(1), 1–15. https://doi.org/10.18637/jss.v072.c01
- mixmeta (wersja 1.2.2): Gasparrini, A., & Sera, F. (2025). mixmeta: An extended mixed-effects framework for meta-analysis (R package version 1.2.2) [Computer software]. https://CRAN.R-project.org/package=mixmeta
- rms (wersja 8.2-1): Harrell, F. E., Jr. (2026). rms: Regression modeling strategies (R package version 8.2-1) [Computer software]. https://doi.org/10.32614/CRAN.package.rms
- drc (wersja 4.0.0): Ritz, C., Baty, F., Streibig, J. C., & Gerhard, D. (2015). Dose-response analysis using R. PLOS ONE, 10(12), Article e0146021. https://doi.org/10.1371/journal.pone.0146021
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
Najczęstsze pytania
Dlaczego nie wystarczy zwykła regresja log RR na dawce?
Ryzyka względne z kategorii dawki liczy się względem tej samej grupy referencyjnej, więc są skorelowane. Pominięcie korelacji zmienia nachylenie i zwykle zaniża jego błąd standardowy, co widać w przykładzie.
Jak sprawdzić, czy zależność jest nieliniowa?
Dopasuj splajn kubiczny (np. z trzema węzłami) i testem Walda sprawdź, czy człon nieliniowy różni się od zera. Pokaż też wykres krzywej z przedziałem ufności.
Czy zależność dawka–odpowiedź dowodzi przyczynowości?
Nie. Gradient wzmacnia argument przyczynowy, ale może też wynikać z zakłócenia, które rośnie razem z dawką. Brak gradientu nie wyklucza przyczynowości, np. przy efekcie progowym.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Crippa, A., & Orsini, N. (2016). Multivariate dose-response meta-analysis: The dosresmeta R package. Journal of Statistical Software, Code Snippets, 72(1), 1–15. https://doi.org/10.18637/jss.v072.c01 ● Otwarty dostęp
- Greenland, S., & Longnecker, M. P. (1992). Methods for trend estimation from summarized dose-response data, with applications to meta-analysis. American Journal of Epidemiology, 135(11), 1301–1309. https://doi.org/10.1093/oxfordjournals.aje.a116237
- Ritz, C., Baty, F., Streibig, J. C., & Gerhard, D. (2015). Dose-response analysis using R. PLOS ONE, 10(12), Article e0146021. https://doi.org/10.1371/journal.pone.0146021 ● Otwarty dostęp
Cytowania BibTeX
@article{crippa2016multivariate, author={Crippa, Alessio and Orsini, Nicola}, title={{Multivariate dose-response meta-analysis: The dosresmeta R package}}, journal={Journal of Statistical Software, Code Snippets}, year={2016}, volume={72}, number={1}, pages={1--15}, doi={10.18637/jss.v072.c01}}@article{greenland1992methods, author={Greenland, Sander and Longnecker, Matthew P.}, title={{Methods for trend estimation from summarized dose-response data, with applications to meta-analysis}}, journal={American Journal of Epidemiology}, year={1992}, volume={135}, number={11}, pages={1301--1309}, doi={10.1093/oxfordjournals.aje.a116237}}@article{ritz2015doseresponse, author={Ritz, Christian and Baty, Florent and Streibig, Jens C. and Gerhard, Daniel}, title={{Dose-response analysis using R}}, journal={PLOS ONE}, year={2015}, volume={10}, number={12}, eid={e0146021}, doi={10.1371/journal.pone.0146021}}