Jeden schemat, dwa warianty i jedno pytanie: co jeszcze mogło to zmienić
Badanie przed i po to plan, w którym te same osoby mierzysz przed interwencją i po niej, a nikt nie przydziela ich losowo do warunków. W wariancie najprostszym jest jedna grupa (schemat pretest–posttest bez grupy kontrolnej). W mocniejszym dochodzi grupa, której nie przydzielono losowo, np. inny oddział albo inna szkoła (schemat quasi-eksperymentalny). Harris i in. (2006) układają takie plany w hierarchię i zachęcają do wyboru planów z jej wyższych szczebli, bo dają one mocniejsze dowody przyczynowe. Knapp (2016) w artykule z pisma pielęgniarskiego pyta wprost, dlaczego plan jednogrupowy jest wciąż w użyciu mimo krytyki. W pracy dyplomowej bywa jednak jedynym możliwym wyborem. Wtedy o jakości rozdziału decyduje to, czy opiszesz go uczciwie.
Ten wpis dotyczy opisu metody i granic wniosków. Analizę statystyczną omawiają inne strony: ANCOVA w badaniu przed i po, spór między analizą zmian a ANCOVA w paradoksie Lorda, a mechanizm regresji do średniej wpis o pozornej poprawie. Testy wiedzy przed i po szkoleniu ma osobny poradnik, a trzy pomiary z ubytkiem – wpis o pomiarze odroczonym.
Przykład przewodni (fikcyjny, dane symulowane). Studentka pielęgniarstwa ocenia 8-tygodniowy program higieny snu dla personelu pracującego w systemie zmianowym. Program prowadzi szpital A, a szpital B go nie ma, więc służy za porównanie. Do programu kwalifikuje wynik co najmniej 12 punktów w kwestionariuszu problemów ze snem (0–30, im wyżej, tym gorzej; narzędzie wymyślone na potrzeby przykładu). Rysunek 1 pokazuje plan, który opisujemy, i jego słabszą wersję.
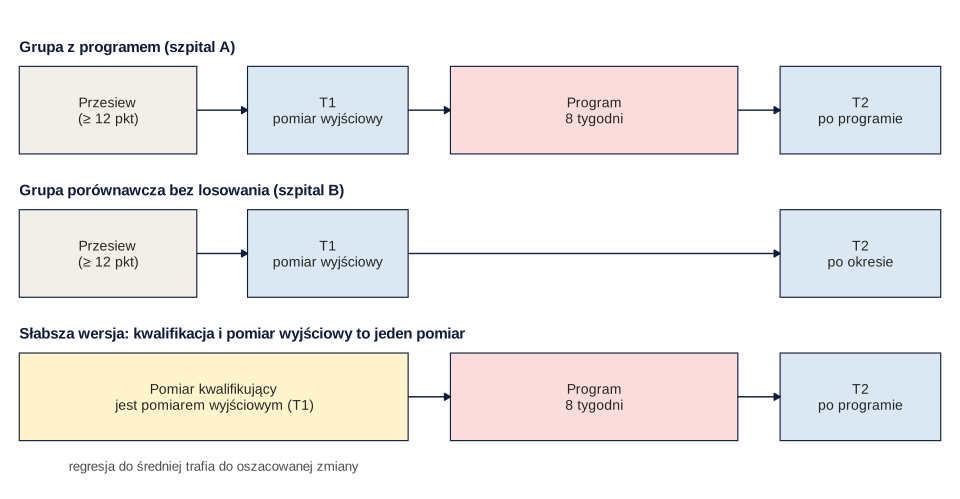
Siedem konkurencyjnych wyjaśnień, które recenzent ma w głowie
Zmiana między pomiarami to fakt. Pytanie brzmi, skąd się wzięła. Shadish i in. (2002) opisują zagrożenia trafności wewnętrznej, a poniższa tabela przekłada je na przykład ze snem. Ostatnia kolumna to rzecz, którą da się zrobić na etapie planu, więc warto ją przeczytać, zanim zbierzesz dane.
| Zagrożenie | W przykładzie | Co zrobić w planie |
|---|---|---|
| Historia – zdarzenie między pomiarami | W szpitalu A zmieniono grafik dyżurów w połowie programu | Notuj zdarzenia, zbierz pomiar w grupie porównawczej w tym samym czasie |
| Dojrzewanie – zmiana naturalna | Nowe osoby przyzwyczajają się do pracy zmianowej | Podaj staż, sprawdź, czy zmiana zależy od stażu; dodaj pomiar sprzed programu |
| Regresja do średniej | Do programu trafiają osoby po wyjątkowo złych tygodniach | Osobny przesiew i osobny pomiar wyjściowy; to samo kryterium w obu grupach |
| Efekt testowania – skutki samego pomiaru | Wypełnienie kwestionariusza zwraca uwagę na sen | Rozważ wersję równoległą (testy) lub rzadszy pomiar; grupa porównawcza wypełnia to samo |
| Zmiana narzędzia | Przed programem papier, po programie formularz online | Ta sama wersja, ten sam tryb, ta sama pora dnia |
| Ubytek | Osoby, którym program nie pomógł, nie wypełniają T2 | Zapisz powód braku, porównaj obecnych i nieobecnych w T1 |
| Selekcja (tylko z grupą nierandomizowaną) | Szpital A wybrano, bo personel gorzej śpi | Zmierz cechy różniące grupy, pokaż je w tabeli, nie nazywaj grup równoważnymi |
O skali efektu testowania wiadomo mniej, niż sugerują podręczniki. W metaanalizie Willsona i Putnama (1982) pretest podwyższał wynik posttestu średnio o 0.22 SD, ale przegląd badań w schemacie czterech grup Solomona, który przeprowadzili McCambridge i in. (2011), dał niespójny obraz: było za mało dobrych badań, by rozstrzygnąć sprawę. W pracy napisz więc o tym jako o możliwości, a nie o stwierdzonym fakcie. Przy testach wiedzy i zadaniach poznawczych dochodzi efekt uczenia się, a przy obserwacji zachowań efekt Hawthorne’a.
Program, który nie działa: 5000 badań przed i po
Barnett i in. (2005) podkreślają, że regresja do średniej jest najsilniejsza, gdy do dalszej obserwacji trafiają osoby wybrane na podstawie wyniku wyjściowego, i tym większa, im większy błąd pomiaru. Poniższa symulacja ma jedną rzecz do pokazania: jaki wynik da plan, gdy prawdziwy efekt programu wynosi zero. Każdy wiersz to 5000 powtórzeń po 60 osób w grupie (rzetelność pomiaru około .72, próg 12 punktów).
| Plan i analiza | Średnie oszacowanie (pkt) | Odsetek p < .05 |
|---|---|---|
| A. Jedna grupa, bez kryterium kwalifikacji | 0.01 | 4.80% |
| B. Jedna grupa, kwalifikacja na podstawie T1 | −1.15 | 74.00% |
| C. Jedna grupa, osobny przesiew, a potem T1 | 0.00 | 5.26% |
| D. Jak C, ale wszyscy zmieniają się o −0.8 z innych powodów | −0.81 | 41.50% |
| E. Dwie grupy, osobny przesiew, zmiana wspólna, analiza zmian | 0.00 | 5.04% |
| F. Jak E, analiza ANCOVA | 0.33 | 8.96% |
| G. Dwie grupy, kwalifikacja na podstawie T1, analiza zmian | 0.28 | 8.12% |
Wiersz B to „sukces” bezużytecznego programu w trzech na cztery badania. Wiersz C pokazuje najtańszą poprawkę: oddzielenie kwalifikacji od pomiaru wyjściowego. Wiersz D przypomina, że przesiew nie chroni przed tym, co zmienia się samo; tu pomaga dopiero grupa porównawcza (wiersz E), pod warunkiem że bez programu obie grupy zmieniałyby się tak samo. Wiersze F i G pokazują, że grupy różniące się populacją (średnia 11.5 i 10) wciąż grożą obciążeniem. Dodatni znak oznacza pozorne pogorszenie w grupie z programem, czyli wynik zaniżający efekt. Przyczyny tłumaczy paradoks Lorda, o którym mowa wyżej.
Wyniki przykładu: co widać w danych
Przesiew wypełniło 170 osób w szpitalu A i 150 w szpitalu B. Kryterium spełniły odpowiednio 83 i 53 osoby, a pomiar po 8 tygodniach ma 73 i 50 osób (ubytek 12.0% i 5.7%). Rysunek 2 pokazuje coś, czego zwykłe badanie przed i po nie widzi: wynik spadł, zanim program się zaczął. Między przesiewem a T1 średnia w szpitalu A obniżyła się o 1.06 punktu, 95% CI [−1.86, −0.27], a w szpitalu B o 1.81 punktu, 95% CI [−2.66, −0.96].
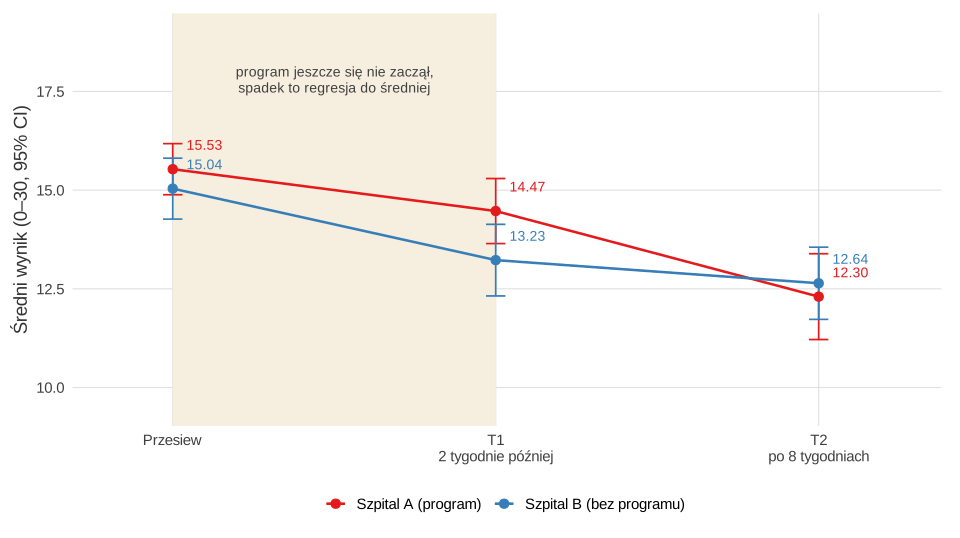
Gdyby badaczka przyjęła przesiew za pomiar wyjściowy, zmiana w szpitalu A wyniosłaby −3.26 punktu. Przy osobnym T1 jest to −2.37 punktu, 95% CI [−3.16, −1.58], t(72) = −5.97, p < .001, dz = −0.70. Różnica 0.89 punktu to pozorna poprawa, którą wnosi sama kwalifikacja. Ale i te −2.37 nie jest efektem programu. W szpitalu B wynik zmienił się o −0.60 punktu, 95% CI [−1.53, 0.33], p = .200. W symulacji znamy prawdę: program −1.5, zmiana wspólna −0.8.
Porównanie grup daje: analiza zmian −1.77 punktu, 95% CI [−2.98, −0.56], p = .005, a ANCOVA z T1 jako kowariantem −1.41 punktu, 95% CI [−2.61, −0.21], p = .022. Grupy różniły się na starcie (SMD = 0.35), więc obie analizy opierają się na innych założeniach. W pracy podaj obie, razem z tymi założeniami. Jeśli masz kilka pomiarów przed interwencją, plan zbliża się do różnicy w różnicach, a przy wielu pomiarach do przerwanego szeregu czasowego.
Gotowy podrozdział „Metoda” z komentarzem
Układ pasuje do schematu z poradnika o rozdziale metodologicznym. Pisząc o interwencji bez losowania, kieruj się wytycznymi TREND. Des Jarlais i in. (2004) kładą w nich nacisk na opis teorii, interwencji i warunku porównawczego, schematu oraz metod korygowania obciążeń. Którą listę wybrać przy innym schemacie, pokazuje zestawienie wytycznych. Akapity są zgodne z danymi przykładu.
Schemat
Jak bywa napisane: „Przeprowadzono eksperyment mający na celu zbadanie wpływu programu na jakość snu”.
Co jest nie tak: bez losowego przydziału to nie eksperyment, a słowo „wpływ” przesądza wniosek przed wynikami. Brakuje informacji, kto i dlaczego dostał program.
Uczestnicy
Jak bywa napisane: „Badaniem objęto 123 pielęgniarki”.
Co jest nie tak: nie wiadomo, ile osób zgłoszono, ile spełniło kryteria i kto odpadł. Podanie samych analizowanych ukrywa selekcję.
Przy większym ubytku opisz go szerzej. Jeśli badanie jest anonimowe, pomiary połączysz przez kod identyfikacyjny.
Narzędzia
Jak bywa napisane: „Zastosowano kwestionariusz problemów ze snem o dobrej rzetelności”.
Co jest nie tak: brakuje zakresu, kierunku punktacji i rzetelności w tej próbie. Przy pomiarze przed i po trzeba też napisać, czy narzędzie i tryb były za każdym razem takie same.
W pracach z miarą kliniczną dodaj minimalną istotną klinicznie różnicę ze źródła, jeśli taka istnieje dla Twojego narzędzia.
Procedura i interwencja
Jak bywa napisane: „Uczestnicy wzięli udział w programie edukacyjnym”.
Co jest nie tak: czytelnik nie odtworzy interwencji. Lista TIDieR (Hoffmann i in., 2014) wymienia 12 elementów opisu: m.in. co, kto, jak, gdzie, kiedy i ile, a także modyfikacje oraz rzeczywistą realizację. Autorzy kierują ją przede wszystkim do badań klinicznych, ale przeznaczają także do innych badań oceniających interwencje.
Informację o zgodzie komisji bioetycznej podaj zgodnie z wymaganiami swojej uczelni.
Plan analizy
Jak bywa napisane: „Do analizy wykorzystano test t, przyjmując poziom istotności p < .05”.
Co jest nie tak: nie wiadomo, co porównano, jak potraktowano braki i po co jest grupa porównawcza. Sam test t dla prób zależnych w jednej grupie opisuje zmianę, ale nie jej przyczynę.
Założenia i sposób wyboru między analizami opisują strony o wyniku różnicowym i ANCOVA, wskazane na początku wpisu. Przy wielkości efektu podaj, którą miarę liczysz (dz czy dav).
Co wolno napisać we wnioskach
Istotna zmiana w jednej grupie nie jest dowodem skuteczności, nawet gdy p < .001. Czasowniki w tabeli poniżej to najprostsza kontrola, a ogólne zasady formułowania wniosków są w poradniku o wnioskach i rekomendacjach.
| Zamiast | Jedna grupa | Z grupą nierandomizowaną |
|---|---|---|
| „Program poprawił sen” | „Po programie wynik był niższy o 2.37 punktu” | „Spadek w grupie z programem był większy niż w grupie porównawczej” |
| „Program jest skuteczny” | „Plan nie pozwala ocenić skuteczności” | „Wyniki są zgodne z korzystnym działaniem programu, ale nie wykluczają różnic między szpitalami” |
| „Dzięki programowi…” | „Po zakończeniu programu…” | „W porównaniu ze szpitalem B…” |
| „Należy wdrożyć program” | „Uzasadnione jest badanie z grupą porównawczą” | „Uzasadnione jest badanie z losowym przydziałem, także klastrów” |
Gotowe akapity dla obu wersji (liczby z przykładu):
Pełny schemat tego podrozdziału znajdziesz we wpisie o ograniczeniach badania. Jeśli zależy Ci na wniosku przyczynowym, zobacz jak opisać eksperyment z losowym przydziałem.
Na co zwrócić uwagę w różnych dziedzinach
Są to obserwacje ogólne, a nie reguły; wymagania uczelni i promotora mają pierwszeństwo.
| Dziedzina | Najczęstsze ryzyko | Co często dopisać w metodzie |
|---|---|---|
| Psychologia | Oczekiwania uczestników, efekt testowania i uczenia się w zadaniach poznawczych | Wersje równoległe testów, kto mierzy i czy zna cel badania |
| Nauki o zdrowiu | Pora roku, zmiany w standardzie opieki, kwalifikacja po ostrym epizodzie | Kalendarz pomiarów, inne działania na oddziale, TREND |
| Fizjoterapia | Naturalny przebieg dolegliwości, leczenie równoległe | Opis programu wg TIDieR, RCI, MDC i MCID obok istotności |
| Zarządzanie | Równoległe zmiany w firmie, odejścia pracowników między pomiarami | Zdarzenia w organizacji, kto odszedł, sposób łączenia anonimowych pomiarów |
Najczęstsze błędy
- „Eksperyment” bez losowania. Nazwa planu sugeruje wniosek, którego plan nie udźwignie.
- Pomiar kwalifikujący jako wyjściowy. W przykładzie zawyżył zmianę o 0.89 punktu.
- Istotny test w grupie z programem i nieistotny w grupie porównawczej jako dowód różnicy. Porównuj zmianę między grupami, a nie dwie wartości p.
- Grupa porównawcza z innym kryterium. Osoby z dobrym snem nie pokażą tej samej regresji do średniej.
- Same analizowane osoby w opisie. Bez liczby przesianych i utraconych nie widać selekcji.
- Zmiana trybu lub wersji narzędzia między pomiarami bez wzmianki w metodzie.
- Rekomendacja wdrożenia w jednym zdaniu z wynikiem badania bez grupy porównawczej.
Badanie przed i po w R: dane, analiza i symulacja
Trzy przepisy liczą wszystkie liczby z tekstu i tabel. Pierwszy tworzy dane, zapisuje je w pliku CSV w folderze nadrzędnym (../) i opisuje przepływ osób. Drugi liczy zmiany w grupach oraz analizę zmian i ANCOVA. Trzeci powtarza badanie 5000 razy w każdym wariancie przy zerowym efekcie. Ziarna nie wybierano pod wynik. Rysunki powstały w osobnym skrypcie. Dane do pobrania: badanie-przed-i-po-sen-dane.csv (136 osób, format szeroki).
Dane, przepływ osób i porównanie na starcie
R
# B470 – badanie przed i po: program higieny snu w szpitalu A, szpital B bez programu (dane symulowane)
# Wynik: fikcyjny kwestionariusz problemów ze snem 0–30 (im wyżej, tym gorzej).
# Kwalifikacja: przesiew >= 12; T1 – osobny pomiar po 2 tygodniach; T2 – po 8-tygodniowym okresie.
set.seed(4701)
nA <- 170; nB <- 150
szpital <- rep(c("A", "B"), c(nA, nB))
poziom <- rnorm(nA + nB, ifelse(szpital == "A", 11.5, 10), 4)   # stały poziom problemów ze snem
pomiar <- function(x) pmin(pmax(round(x + rnorm(length(x), 0, 2.5)), 0), 30)   # odczyt z błędem
przesiew <- pomiar(poziom)
T1 <- pomiar(poziom)
zmiana_wspolna <- -0.8                                   # to, co zmienia się bez programu
program <- ifelse(szpital == "A", -1.5, 0)               # prawdziwy efekt programu
T2 <- pomiar(poziom + zmiana_wspolna + program)
zakw <- przesiew >= 12
dane <- data.frame(id = seq_len(nA + nB), szpital, przesiew, T1, T2)[zakw, ]
# Ubytek przed T2 (nieco częstszy przy gorszym śnie)
brak <- rbinom(nrow(dane), 1, plogis(-2.2 + 0.08 * (dane$T1 - 12)))
dane$T2[brak == 1] <- NA
write.csv(dane, "../badanie-przed-i-po-sen-dane.csv", row.names = FALSE, na = "")

cat("Przesiew: A =", nA, " B =", nB, "\n")
cat("Zakwalifikowani:\n"); print(table(dane$szpital))
cat("Z pomiarem T2:\n"); print(table(dane$szpital[!is.na(dane$T2)]))
cat("Ubytek %:\n"); print(round(100 * tapply(is.na(dane$T2), dane$szpital, mean), 1))
apa_p <- function(p) if (p < .001) "p < .001" else sprintf("p = %s", sub("^0", "", sprintf("%.3f", p)))
opis <- function(x) c(n = sum(!is.na(x)), M = round(mean(x, na.rm = TRUE), 2), SD = round(sd(x, na.rm = TRUE), 2))
for (s in c("A", "B")) {
  d <- dane[dane$szpital == s, ]
  cat("\nSzpital", s, "\n")
  print(rbind(przesiew = opis(d$przesiew), T1 = opis(d$T1), T2 = opis(d$T2)))
  t0 <- t.test(d$T1, d$przesiew, paired = TRUE)
  cat(sprintf("T1 - przesiew (bez programu): %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, %s\n",
              t0$estimate, t0$conf.int[1], t0$conf.int[2], t0$parameter, t0$statistic, apa_p(t0$p.value)))
}
# Kto odpadł: wynik T1 u obecnych i nieobecnych w T2
cat("\nT1 według obecności w T2:\n")
print(aggregate(T1 ~ szpital + brak_T2, transform(dane, brak_T2 = is.na(T2)), function(x) round(mean(x), 2)))
# Porównanie grup na starcie (T1): standaryzowana różnica średnich
a <- dane$T1[dane$szpital == "A"]; b <- dane$T1[dane$szpital == "B"]
smd <- (mean(a) - mean(b)) / sqrt(((length(a) - 1) * var(a) + (length(b) - 1) * var(b)) / (length(a) + length(b) - 2))
cat(sprintf("\nSMD dla T1 (A - B): %.2f\n", smd))
Wynik w R
Przesiew: A = 170  B = 150
Zakwalifikowani:

 A  B
83 53
Z pomiarem T2:

 A  B
73 50
Ubytek %:
   A    B
12.0  5.7

Szpital A
          n     M   SD
przesiew 83 15.53 2.96
T1       83 14.47 3.77
T2       73 12.30 4.66
T1 - przesiew (bez programu): -1.06, 95% CI [-1.86, -0.27], t(82) = -2.65, p = .010

Szpital B
          n     M   SD
przesiew 53 15.04 2.80
T1       53 13.23 3.29
T2       50 12.64 3.22
T1 - przesiew (bez programu): -1.81, 95% CI [-2.66, -0.96], t(52) = -4.28, p < .001

T1 według obecności w T2:
  szpital brak_T2    T1
1       A   FALSE 14.67
2       B   FALSE 13.24
3       A    TRUE 13.00
4       B    TRUE 13.00

SMD dla T1 (A - B): 0.35
Zmiana w grupach, analiza zmian i ANCOVA
R
# B470 – analiza: jedna grupa (szpital A), a potem porównanie z grupą nierandomizowaną
d <- read.csv("../badanie-przed-i-po-sen-dane.csv")
d <- d[!is.na(d$T2), ]
A <- d[d$szpital == "A", ]; B <- d[d$szpital == "B", ]
apa_p <- function(p) if (p < .001) "p < .001" else sprintf("p = %s", sub("^0", "", sprintf("%.3f", p)))
parami <- function(x, y, etykieta) {
  t0 <- t.test(y, x, paired = TRUE); roz <- y - x
  cat(sprintf("%s: M zmiany = %.2f, SD = %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, %s, d_z = %.2f, n = %d\n",
              etykieta, mean(roz), sd(roz), t0$conf.int[1], t0$conf.int[2], t0$parameter,
              t0$statistic, apa_p(t0$p.value), mean(roz) / sd(roz), length(roz)))
}
# 1. Jedna grupa
parami(A$T1, A$T2, "Szpital A, T2 - T1 (opis właściwy)")
parami(A$przesiew, A$T2, "Szpital A, T2 - przesiew (pomiar kwalifikujący jako wyjściowy)")
cat(sprintf("Korelacja T1 i T2 w szpitalu A: r = %s\n", sub("^0", "", sprintf("%.2f", cor(A$T1, A$T2)))))
# 2. Grupa nierandomizowana: to samo w szpitalu B
parami(B$T1, B$T2, "Szpital B, T2 - T1")
# 3. Porównanie grup: analiza zmian (różnica w różnicach) i ANCOVA
d$szpital <- factor(d$szpital, levels = c("B", "A"))
d$zmiana <- d$T2 - d$T1
m1 <- lm(zmiana ~ szpital, d); m2 <- lm(T2 ~ T1 + szpital, d)
wypisz <- function(m, nazwa) {
  e <- coef(summary(m))["szpitalA", ]; ci <- confint(m)["szpitalA", ]
  cat(sprintf("%s: %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, %s\n",
              nazwa, e[1], ci[1], ci[2], df.residual(m), e[3], apa_p(e[4])))
}
wypisz(m1, "Analiza zmian (A - B)")
wypisz(m2, "ANCOVA z T1 (A - B)")
cat(sprintf("Nachylenie T1 w ANCOVA: %.2f\n", coef(m2)["T1"]))
Wynik w R
Szpital A, T2 - T1 (opis właściwy): M zmiany = -2.37, SD = 3.39, 95% CI [-3.16, -1.58], t(72) = -5.97, p < .001, d_z = -0.70, n = 73
Szpital A, T2 - przesiew (pomiar kwalifikujący jako wyjściowy): M zmiany = -3.26, SD = 3.59, 95% CI [-4.10, -2.42], t(72) = -7.76, p < .001, d_z = -0.91, n = 73
Korelacja T1 i T2 w szpitalu A: r = .69
Szpital B, T2 - T1: M zmiany = -0.60, SD = 3.26, 95% CI [-1.53, 0.33], t(49) = -1.30, p = .200, d_z = -0.18, n = 50
Analiza zmian (A - B): -1.77, 95% CI [-2.98, -0.56], t(121) = -2.89, p = .005
ANCOVA z T1 (A - B): -1.41, 95% CI [-2.61, -0.21], t(120) = -2.33, p = .022
Nachylenie T1 w ANCOVA: 0.75
Symulacja przy zerowym efekcie programu
R
# B470 – co pokazuje badanie przed i po, gdy program NIE działa (prawdziwy efekt = 0)
set.seed(4702)
B <- 5000; n <- 60
los <- function(mu, kryt_na, sd_p = 4, sd_e = 2.5) {          # n osób spełniających przesiew >= 12
  pula <- rnorm(n * 8, mu, sd_p)
  s <- pula + rnorm(length(pula), 0, sd_e); t1 <- pula + rnorm(length(pula), 0, sd_e)
  t2 <- pula + rnorm(length(pula), 0, sd_e)
  w <- switch(kryt_na, brak = rep(TRUE, length(pula)), T1 = t1 >= 12, przesiew = s >= 12)
  i <- which(w)[1:n]; list(T1 = t1[i], T2 = t2[i])
}
jedna <- function(kryt, zm = 0, mu = 11.5) {
  r <- replicate(B, { d <- los(mu, kryt); t0 <- t.test(d$T2 + zm, d$T1, paired = TRUE)
                      c(unname(t0$estimate), t0$p.value) })
  c(oszacowanie = mean(r[1, ]), proc_istotnych = 100 * mean(r[2, ] < .05))
}
dwie <- function(kryt, analiza, zm = -0.8) {
  r <- replicate(B, {
    a <- los(11.5, kryt); b <- los(10, kryt)
    T1 <- c(a$T1, b$T1); T2 <- c(a$T2, b$T2) + zm; g <- rep(1:0, each = n)
    m <- if (analiza == "zmiany") lm(T2 - T1 ~ g) else lm(T2 ~ T1 + g)
    coef(summary(m))["g", c(1, 4)] })
  c(oszacowanie = mean(r[1, ]), proc_istotnych = 100 * mean(r[2, ] < .05))
}
wyniki <- rbind(
  "A jedna grupa, bez kryterium"                = jedna("brak"),
  "B jedna grupa, kryterium = T1"               = jedna("T1"),
  "C jedna grupa, osobny przesiew"              = jedna("przesiew"),
  "D jak C + zmiana wspólna -0.8"               = jedna("przesiew", zm = -0.8),
  "E dwie grupy, osobny przesiew, zmiany"       = dwie("przesiew", "zmiany"),
  "F dwie grupy, osobny przesiew, ANCOVA"       = dwie("przesiew", "ancova"),
  "G dwie grupy, kryterium = T1, zmiany"        = dwie("T1", "zmiany"))
print(round(wyniki, 2))
Wynik w R
                                      oszacowanie proc_istotnych
A jedna grupa, bez kryterium                 0.01           4.80
B jedna grupa, kryterium = T1               -1.15          74.00
C jedna grupa, osobny przesiew               0.00           5.26
D jak C + zmiana wspólna -0.8               -0.81          41.50
E dwie grupy, osobny przesiew, zmiany        0.00           5.04
F dwie grupy, osobny przesiew, ANCOVA        0.33           8.96
G dwie grupy, kryterium = T1, zmiany         0.28           8.12
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (tylko funkcje bazowe); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem rozdziału sprawdź…
- Czy plan nazwany jest zgodnie z tym, jak utworzono grupy, i czy nie pada słowo „eksperyment”, gdy nie było losowania?
- Czy pomiar kwalifikujący jest oddzielony od wyjściowego, a jeśli nie – czy napisano o tym w ograniczeniach?
- Czy podano liczby osób na każdym etapie i porównano obecnych z nieobecnymi w T2?
- Czy narzędzie, tryb i pora pomiaru były takie same?
- Czy interwencja jest opisana tak, żeby ktoś mógł ją powtórzyć, i czy zapisano zdarzenia w okresie badania?
- Czy w planie z grupą porównawczą podano różnice na starcie, obie analizy i ich założenia?
- Czy wnioski mówią o zmianie i o różnicy, a nie o wpływie, a rekomendacje nie wykraczają poza plan?
Jeśli chcesz, żeby ktoś sprawdził plan badania albo rozdział metody i pomógł policzyć analizę, zobacz pomoc w analizie dla studentów.
Najczęstsze pytania
Czy badanie przed i po bez grupy kontrolnej nadaje się do pracy magisterskiej?
Tak, jeśli opiszesz je jako plan jednogrupowy i nie wyciągasz wniosku o skuteczności. Możesz pokazać, o ile zmienił się wynik i z jaką precyzją, oraz wymienić wyjaśnienia, których plan nie wyklucza. W wielu pracach to uczciwy wybór, gdy grupy porównawczej nie da się zebrać, ale warto to uzgodnić z promotorem przed zbieraniem danych.
Dlaczego pomiar kwalifikujący do badania nie powinien być pomiarem wyjściowym?
Bo do badania trafiają wtedy osoby, które w tym jednym pomiarze miały akurat wynik wyjątkowo wysoki, a w następnym wypadną bliżej swojej typowej wartości. W symulacji bez żadnego działania programu taki plan dał średni spadek o 1.15 punktu i wynik istotny w 74.00% badań. Osobny przesiew i osobny pomiar wyjściowy prawie usunęły ten problem.
Co napisać, gdy w grupie z programem wynik jest istotny, a w porównawczej nie?
Nie porównuj dwóch wartości p. Oszacuj różnicę zmian między grupami z przedziałem ufności i dopiero ją opisz. W przykładzie szpital z programem miał zmianę −2.37 punktu, a szpital bez programu −0.60 punktu, więc właściwym wynikiem jest różnica −1.77 punktu, 95% CI [−2.98, −0.56].
Czy trzeba stosować wytyczne TREND w pracy dyplomowej?
To zależy od wymagań uczelni i promotora, a TREND dobrze porządkuje opis badania interwencyjnego bez losowania. Des Jarlais i in. kładą w nich nacisk na opis teorii, interwencji i warunku porównawczego, schematu oraz metod korygowania obciążeń. Możesz traktować je jako listę kontrolną, także gdy nikt ich nie wymaga.
Czy grupa porównawcza bez losowania pozwala napisać, że interwencja zadziałała?
Nie wprost. Grupa porównawcza usuwa część alternatywnych wyjaśnień, ale grupy mogą różnić się cechami, których nie zmierzono, i zmieniać się w innym tempie. Napisz, że wynik jest zgodny z działaniem interwencji, podaj różnice na starcie i założenia analizy oraz nazwij brak randomizacji jako ograniczenie.
Powiązane hasła
Przeczytaj też
Nie da się połączyć pomiaru przed i po
Uczciwe łączenie kodów regułami ustalonymi z góry, analiza jak dla dwóch grup, utrata mocy, selektywne łączenie, kod R i gotowe zdania.
Czytaj →PoradnikBadanie bez grupy kontrolnej – jak wzmocnić plan
Sześć dodatków do planu jednej grupy, co każdy daje i czego nie rozwiązuje, symulacja w R i gotowe zdania do metody i ograniczeń.
Czytaj →PoradnikGrupa kontrolna w badaniu interwencji
Lista oczekujących, zwykła opieka czy aktywna kontrola: co każda opcja kontroluje, symulacja w R, tabela decyzyjna i gotowe zdania do pracy.
Czytaj →PoradnikPowtarzane pomiary – jak opisać metodę
Kontrbalansowanie, kwadrat łaciński i zrównoważony, odstępy, wprawa, przeniesienie, ubytek i łączenie pomiarów po kodzie – wzór metody z komentarzem i symulacja efektu kolejności w R.
Czytaj →PoradnikPorównanie grup istniejących
Pacjenci i osoby bez choroby, zawody, płeć: źródło każdej grupy, dobór grupy porównawczej, standaryzowane różnice, ANCOVA ostrożnie i gotowa metoda – z kodem R.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikRegresja do średniej w badaniu przed–po
Dlaczego osoby zakwalifikowane za wysoki wynik „poprawiają się” bez leczenia, ile wynosi ten efekt i jak go usunąć grupą kontrolną, ANCOVA i osobnym pomiarem wyjściowym.
Czytaj →PoradnikParadoks Lorda: ANCOVA czy wynik różnicowy?
Kiedy obie analizy badania przed–po się zgadzają, kiedy myli się każda z nich, regresja do średniej, graf przyczynowy i symulacja w R.
Czytaj →PoradnikBadanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Masz badanie przed i po i nie wiesz, co wolno napisać?
Sprawdzimy plan i opis metody, policzymy analizę w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Des Jarlais, D. C., Lyles, C., Crepaz, N., & TREND Group. (2004). Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement. American Journal of Public Health, 94(3), 361–366. https://doi.org/10.2105/ajph.94.3.361 ● Otwarty dostęp: pełny tekst
- Harris, A. D., McGregor, J. C., Perencevich, E. N., Furuno, J. P., Zhu, J., Peterson, D. E., & Finkelstein, J. (2006). The use and interpretation of quasi-experimental studies in medical informatics. Journal of the American Medical Informatics Association, 13(1), 16–23. https://doi.org/10.1197/jamia.m1749 ● Otwarty dostęp
- Hoffmann, T. C., Glasziou, P. P., Boutron, I., Milne, R., Perera, R., Moher, D., Altman, D. G., Barbour, V., Macdonald, H., Johnston, M., Lamb, S. E., Dixon-Woods, M., McCulloch, P., Wyatt, J. C., Chan, A.-W., & Michie, S. (2014). Better reporting of interventions: Template for intervention description and replication (TIDieR) checklist and guide. BMJ, 348, Article g1687. https://doi.org/10.1136/bmj.g1687 ● Otwarty dostęp
- Knapp, T. R. (2016). Why is the one-group pretest–posttest design still used? Clinical Nursing Research, 25(5), 467–472. https://doi.org/10.1177/1054773816666280
- McCambridge, J., Butor-Bhavsar, K., Witton, J., & Elbourne, D. (2011). Can research assessments themselves cause bias in behaviour change trials? A systematic review of evidence from Solomon 4-group studies. PLoS ONE, 6(10), Article e25223. https://doi.org/10.1371/journal.pone.0025223 ● Otwarty dostęp
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Willson, V. L., & Putnam, R. R. (1982). A meta-analysis of pretest sensitization effects in experimental design. American Educational Research Journal, 19(2), 249–258. https://doi.org/10.3102/00028312019002249
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{desjarlais2004improving, author={Des Jarlais, Don C. and Lyles, Cynthia and Crepaz, Nicole and {TREND Group}}, title={{Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement}}, journal={American Journal of Public Health}, year={2004}, volume={94}, number={3}, pages={361--366}, doi={10.2105/ajph.94.3.361}}@article{harris2006use, author={Harris, Anthony D. and McGregor, Jessina C. and Perencevich, Eli N. and Furuno, Jon P. and Zhu, Jingkun and Peterson, Dan E. and Finkelstein, Joseph}, title={{The use and interpretation of quasi-experimental studies in medical informatics}}, journal={Journal of the American Medical Informatics Association}, year={2006}, volume={13}, number={1}, pages={16--23}, doi={10.1197/jamia.m1749}}@article{hoffmann2014better, author={Hoffmann, Tammy C. and Glasziou, Paul P. and Boutron, Isabelle and Milne, Ruairidh and Perera, Rafael and Moher, David and Altman, Douglas G. and Barbour, Virginia and Macdonald, Helen and Johnston, Marie and Lamb, Sarah E. and Dixon-Woods, Mary and McCulloch, Peter and Wyatt, Jeremy C. and Chan, An-Wen and Michie, Susan}, title={{Better reporting of interventions: Template for intervention description and replication (TIDieR) checklist and guide}}, journal={BMJ}, year={2014}, volume={348}, eid={g1687}, doi={10.1136/bmj.g1687}}@article{knapp2016why, author={Knapp, Thomas R.}, title={{Why is the one-group pretest–posttest design still used?}}, journal={Clinical Nursing Research}, year={2016}, volume={25}, number={5}, pages={467--472}, doi={10.1177/1054773816666280}}@article{mccambridge2011can, author={McCambridge, Jim and Butor-Bhavsar, Kaushiki and Witton, John and Elbourne, Diana}, title={{Can research assessments themselves cause bias in behaviour change trials? A systematic review of evidence from Solomon 4-group studies}}, journal={PLoS ONE}, year={2011}, volume={6}, number={10}, eid={e25223}, doi={10.1371/journal.pone.0025223}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{willson1982meta, author={Willson, Victor L. and Putnam, Richard R.}, title={{A meta-analysis of pretest sensitization effects in experimental design}}, journal={American Educational Research Journal}, year={1982}, volume={19}, number={2}, pages={249--258}, doi={10.3102/00028312019002249}}