Trzy pomiary, trzy różne pytania
W pracach z pielęgniarstwa i położnictwa często pojawia się projekt: pacjent rozwiązuje test wiedzy przed sesją edukacyjną, zaraz po niej i jeszcze raz po kilku tygodniach. Każdy z tych pomiarów odpowiada na inne pytanie. Porównanie po – przed mówi, ile pacjent przyswoił. Porównanie odroczony – po mówi, ile z tego zapomniał. Porównanie odroczony – przed mówi, czy po miesiącu wie więcej niż na starcie. Dla praktyki najważniejsze bywa ostatnie, bo pacjent korzysta z wiedzy w domu.
Ten wpis rozwija poradnik o badaniu wiedzy przed i po szkoleniu. Test t, Wilcoxona, McNemara i znormalizowany przyrost opisaliśmy tam. Tu zajmujemy się tym, co wnosi trzeci pomiar: osobami, które nie wróciły, wyborem modelu, kontrastami, miarą utrzymania wiedzy i pułapkami interpretacji. Budowę testu opisuje wpis jak zbudować test wiedzy krok po kroku.
Plan pomiaru odroczonego – zanim zbierzesz dane
Pomiar odroczony ma sens, bo pacjenci zapamiętują tylko część informacji przekazanych w gabinecie. Kessels (2003) w przeglądzie badań zauważa, że część informacji medycznych, którą pacjenci poprawnie pamiętają, jest uderzająco mała, i omawia, co utrudnia zapamiętywanie. Wynik tuż po sesji to raczej górna granica wiedzy. Ogólne zasady opisuje hasło pomiar odroczony, a w protokole badania edukacyjnego zapisz sześć decyzji:
- Termin i okno. „Po miesiącu” zapisz jako okno, np. 28–35 dni, i notuj rzeczywistą datę pomiaru. W pracy podasz medianę i zakres odstępu.
- Ta sama wersja testu. Wersje równoległe muszą mieć sprawdzoną, równą trudność, inaczej zapominanie miesza się z trudnością wersji.
- Ten sam tryb. Przez telefon pacjent może zajrzeć do ulotki. Gdy zmiana trybu jest nieunikniona, zanotuj ją.
- Łączenie pomiarów. Trzy arkusze tej samej osoby muszą mieć ten sam identyfikator. Przy anonimowej ankiecie pomoże kod tworzony przez pacjenta (zob. kod identyfikacyjny w ankiecie anonimowej).
- Utrzymanie uczestników. Połącz pomiar z wizytą kontrolną, przypominaj o nim i zapisuj powód każdej nieobecności.
- Plan analizy. Zapisz z góry model, kontrasty i miarę utrzymania wiedzy.
Badanie przykładowe: 80 pacjentów, 14 bez pomiaru po miesiącu
Praca magisterska z pielęgniarstwa: pacjenci rozpoczynający leczenie wymagające samodzielnego przyjmowania leku przechodzą przed wypisem sesję edukacyjną prowadzoną przez pielęgniarkę. Wiedzę mierzy autorski test z 15 pytań (wynik 0–15) w trzech pomiarach: przed sesją (T1), bezpośrednio po niej (T2) i podczas wizyty kontrolnej po około miesiącu (T3). Treści pytań celowo nie podajemy.
W badaniu wzięło udział 80 osób. Na wizytę kontrolną nie przyszło 14 z nich, czyli 17.5%. Pomiar T3 wykonano od 26 do 41 dni po sesji (mediana 33.5 dnia). Dane są symulowane. Możesz je pobrać w pliku edukacja-pacjenta-wiedza-dane.csv (kolumny: id, wiek, mieszka_sam, T1, T2, T3, dni_T3). Symulacja ma przewagę nad prawdziwym badaniem: znamy wynik, który uzyskałoby 14 nieobecnych, więc widać, która analiza trafia najbliżej prawdy.
Krok 1. Ubytek: kto nie wrócił i co to znaczy
Dumville i in. (2006) zwracają uwagę, że utrata uczestników może obciążyć wynik, jeśli osoby utracone różnią się od pozostałych w cechach związanych z wynikiem, i że nie ma progu, poniżej którego utrata przestaje mieć znaczenie. Porównaj więc osoby obecne i nieobecne w T3 pod względem wszystkiego, co zmierzyłeś wcześniej.
| Zmienna | Obecni w T3 (n = 66), M (SD) | Nieobecni w T3 (n = 14), M (SD) | SMD |
|---|---|---|---|
| Wynik przed edukacją (T1) | 7.06 (3.15) | 6.50 (2.50) | 0.18 |
| Wynik bezpośrednio po edukacji (T2) | 10.03 (3.09) | 8.93 (3.00) | 0.36 |
| Wiek (lata) | 66.53 (10.27) | 71.07 (7.49) | −0.46 |
| Mieszka sam(a), odsetek | 20% | 29% | −0.21 |
Osoby, które nie wróciły, miały po edukacji przeciętnie o ponad punkt niższy wynik i były starsze. Test Welcha dla wyniku T2 dał t(19.31) = −1.24, p = .229, a w regresji logistycznej ani wynik T2 (OR = 0.90, 95% CI [0.75, 1.09]), ani wiek (OR = 1.05 na rok, 95% CI [0.98, 1.12]) nie przewidywały istotnie braku pomiaru. Nie znaczy to, że ubytek jest losowy: przy 14 nieobecnych test ma bardzo małą moc, więc ważniejsza jest wielkość różnic. Standaryzowana różnica średnich 0.36 dla T2 i −0.46 dla wieku to różnice wyraźne.
Jeżeli brak pomiaru zależy od rzeczy zmierzonych wcześniej (wyniku T2, wieku), mamy braki typu MAR. Jeżeli zależy od samej, niezmierzonej wiedzy po miesiącu (pacjent nie przychodzi, bo czuje, że „wszystko zapomniał”), to braki MNAR. Żaden test tego nie rozstrzygnie, bo brakującej wiedzy po miesiącu nie znasz (zob. braki danych MCAR, MAR i MNAR). W symulacji braki są typu MAR: zależą od wyniku T2 i wieku. Jak raportować ubytek w kilku grupach, opisuje hasło utrata uczestników.
Krok 2. Dlaczego nie ANOVA tylko dla osób z kompletem pomiarów
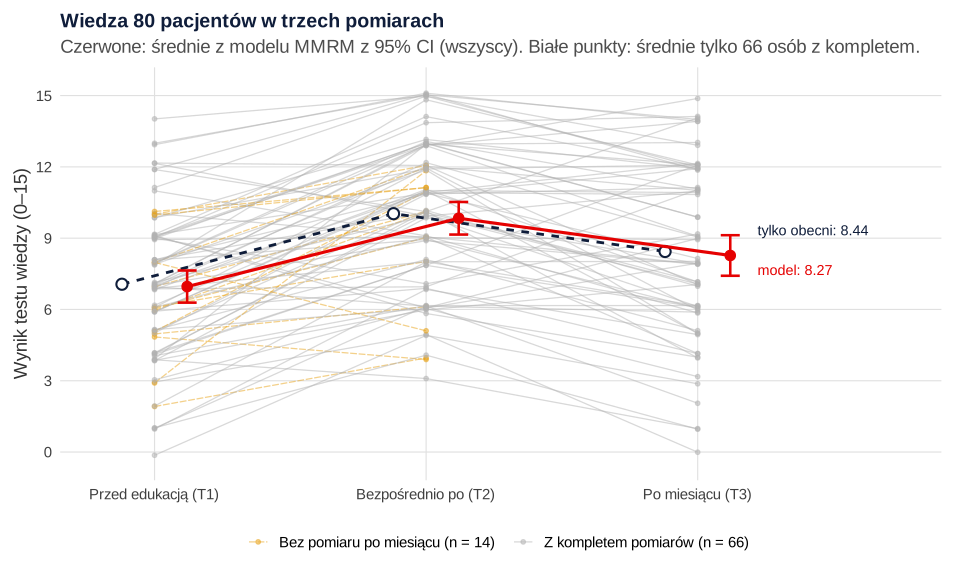
ANOVA z powtarzanymi pomiarami usuwa każdą osobę z choćby jednym brakiem. W przykładzie zostaje 66 osób, a wynik jest wyraźny: F(2, 130) = 37.27, p < .001, średnie 7.06, 10.03 i 8.44. Problem polega na tym, że to średnie osób, które wróciły, a wróciły raczej te z lepszym wynikiem po edukacji. Średnia T3 wszystkich 80 pacjentów (znana tylko w symulacji) wynosi 8.20. Nieobecni uzyskaliby średnio 7.07. Analiza samych obecnych zawyża więc wiedzę po miesiącu.
Druga pokusa to LOCF: wpisanie nieobecnym wyniku z T2 w miejsce T3. Wychodzi 8.53 – jeszcze dalej od prawdy, bo LOCF zakłada, że nieobecni niczego nie zapomnieli. Molenberghs i in. (2004) pokazują, że analiza kompletnych przypadków i LOCF wymagają restrykcyjnych założeń i mają słabsze podstawy niż metody największej wiarygodności, które dają poprawne wnioski przy brakach MAR.
Jeden przykład to za mało, więc powtórzyliśmy badanie 1000 razy i za każdym razem porównaliśmy oszacowanie średniej T3 z wartością z pełnych danych (rysunek 1).
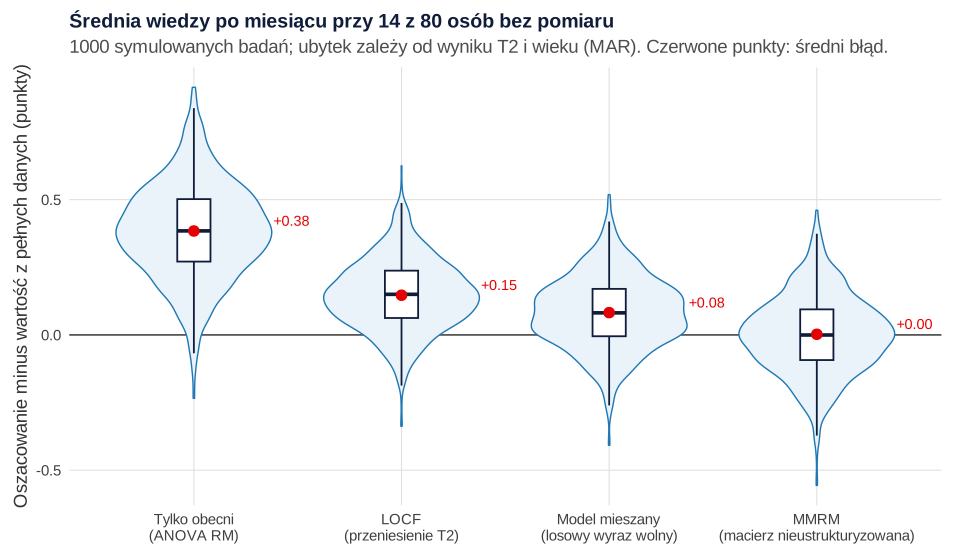
Analiza samych obecnych zawyżała średnią T3 przeciętnie o 0.38 punktu, a LOCF o 0.15 punktu. W 86.6% powtórzeń LOCF pokazywał mniejsze zapominanie, niż było naprawdę. Model mieszany z losowym wyrazem wolnym był bliżej (+0.08). Model z nieustrukturyzowaną macierzą kowariancji (MMRM, opisany w kroku 3) nie miał praktycznie żadnego obciążenia (+0.002) i najmniejszy średni błąd kwadratowy (RMSE = 0.146 wobec 0.424 dla samych obecnych). Gueorguieva i Krystal (2004) wymieniają wykorzystanie wszystkich dostępnych danych wśród przewag modeli mieszanych nad ANOVA. Kiedy ANOVA z powtarzanymi pomiarami wystarcza, a kiedy nie, wyjaśnia wpis ANOVA z powtarzanymi pomiarami czy model mieszany.
Krok 3. Model mieszany z czasem jako czynnikiem
Dane przekształć do formatu długiego (wiersz = pomiar osoby). Osoba bez T3 zostaje w analizie z dwoma pomiarami. Model ma postać:
Pomiar (przed, po, odroczony) to czynnik, a nie zmienna liczbowa. Odstępy są skrajnie nierówne (godzina i miesiąc), a wynik najpierw rośnie, potem spada; czynnik nie narzuca kształtu zmiany. (1 | id) to losowy wyraz wolny: każdy pacjent ma własny poziom wiedzy, a pomiary tej samej osoby są przez to skorelowane (zob. efekty stałe i losowe). Losowego nachylenia dla czynnika czasu przy trzech pomiarach nie dodasz – efektów losowych byłoby tyle, ile obserwacji na osobę.
W przykładzie model objął wszystkie 80 osób i 226 pomiarów: F(2, 146.55) = 42.28, p < .001, ze stopniami swobody Satterthwaite’a. Odchylenie standardowe losowego wyrazu wolnego wyniosło 2.57 punktu, a reszt – 1.98 punktu.
Sprawdź założenie o korelacjach: model MMRM
Losowy wyraz wolny zakłada symetrię złożoną: jednakową wariancję w każdym pomiarze i jednakową korelację każdej pary pomiarów. W badaniu edukacyjnym bywa to wątpliwe: T2 i T3 bywają silniej powiązane niż T1 i T3, a rozrzut po miesiącu rośnie. Przy trzech pomiarach sprawdzisz to modelem z nieustrukturyzowaną macierzą kowariancji (MMRM), w którym każdy pomiar ma własną wariancję, a każda para – własną korelację. W R służy do tego funkcja gls() z pakietu nlme.
W przykładzie korelacje wyniosły .61 (T1–T2), .56 (T1–T3) i .75 (T2–T3), a odchylenia standardowe 3.04, 3.08 i 3.67 punktu. Model nieustrukturyzowany był lepiej dopasowany niż model z symetrią złożoną: AIC = 1094.22 wobec 1097.81, test ilorazu wiarygodności 11.58 przy 4 stopniach swobody, p = .021. Symulacja z kroku 2 pokazuje, dlaczego to ważne: przy ubytku zależnym od T2 źle określona struktura korelacji zostawiła w modelu z losowym wyrazem wolnym małe obciążenie (+0.08), którego MMRM nie miał. Dopasuj oba modele, jeden z nich wskaż w planie jako główny, drugi podaj jako analizę wrażliwości. Tu oba prowadzą do tych samych wniosków.
Przed modelem mieszanym nie musisz imputować braków w wyniku. Twisk i in. (2013) porównali analizy z imputacją wielokrotną i bez niej i uznali imputację przed modelem mieszanym za niepotrzebną, a Schafer i Graham (2002) rekomendują estymację metodą największej wiarygodności jako jedno z dwóch zalecanych podejść. Imputacja (zob. braki danych i imputacja wielokrotna w R) przyda się przy brakach w zmiennych niezależnych.
Krok 4. Kontrasty: po – przed, odroczony – po, odroczony – przed
Na pytania badawcze odpowiadają kontrasty planowane, czyli porównania wpisane do planu analizy przed zebraniem danych. Tu są to trzy porównania z początku wpisu, zapisane w emmeans jako wektory wag, np. "odroczony - po" = c(0, -1, 1). Więcej o kontrastach piszemy we wpisie kontrasty planowane i analiza trendu.
| Wielkość | Model z losowym wyrazem wolnym [95% CI] | MMRM [95% CI] |
|---|---|---|
| Średnia przed (T1) | 6.96 [6.25, 7.68] | 6.96 [6.29, 7.64] |
| Średnia po (T2) | 9.84 [9.12, 10.55] | 9.84 [9.15, 10.52] |
| Średnia po miesiącu (T3) | 8.33 [7.57, 9.08] | 8.27 [7.42, 9.13] |
| Po – przed | 2.88 [2.26, 3.49], t(145) = 9.19 | 2.88 [2.27, 3.48], t(79.4) = 9.50 |
| Odroczony – po | −1.51 [−2.17, −0.85], t(148) = −4.51 | −1.57 [−2.17, −0.96], t(65.0) = −5.19 |
| Odroczony – przed | 1.36 [0.70, 2.03], t(148) = 4.07 | 1.31 [0.55, 2.07], t(72.4) = 3.45 |
Po korekcie Holma dla trzech porównań wszystkie wartości p były mniejsze niż .001, z wyjątkiem porównania odroczony – przed w MMRM (p = .001). Czy przy trzech porównaniach zaplanowanych z góry korekta jest potrzebna, to sprawa sporna (zob. czy muszę stosować poprawkę); w pracy dyplomowej korekta Holma jest bezpiecznym wyborem.
Krok 5. Ile wiedzy zostało po miesiącu?
Spadek o 1.51 punktu nie mówi, czy to dużo. Czytelniejsza jest miara względna: jaka część przyrostu z sesji utrzymała się po miesiącu.
U = 1 oznacza pełne utrzymanie przyrostu, U = 0 – powrót do poziomu wyjściowego. Licz U ze średnich z modelu, a nie jako średnią ilorazów poszczególnych osób – przy przyroście bliskim zera iloraz osiąga absurdalne wartości. W przykładzie przyrost wyniósł 2.88 punktu, a po miesiącu zostało 1.36 punktu, więc U = 0.475. Pacjenci zachowali mniej więcej połowę (47.5%) tego, czego nauczyli się na sesji. Przedział ufności policzysz metodą delta z macierzy kowariancji współczynników modelu: 95% CI [0.27, 0.68]. W modelu MMRM U = 0.455, 95% CI [0.24, 0.67]. Przedział jest szeroki, bo iloraz dziedziczy niepewność obu różnic.
Liczenie pacjentów, którzy „zapomnieli” (T3 < T2), jest zawodne: spadek o jeden–dwa punkty w krótkim teście może być zwykłym wahaniem. Do klasyfikacji pacjentów użyj wskaźnika wiarygodnej zmiany (zob. RCI, MDC i MCID) jako opisu uzupełniającego.
Pułapka: kto zapomina najwięcej?
Najwięcej stracili pacjenci z najlepszym wynikiem po sesji: osoby z wynikiem T2 od 12 do 15 punktów straciły średnio 2.09 punktu, z wynikiem 9–11 punktów – 1.82, a z wynikiem 0–8 punktów – 0.81. Podobnie przyrost od T1 do T2 był tym mniejszy, im wyższy wynik wyjściowy: r = −.43, 95% CI [−.59, −.23], p < .001. Brzmi to jak odkrycie: „najlepsi zapominają najszybciej”.
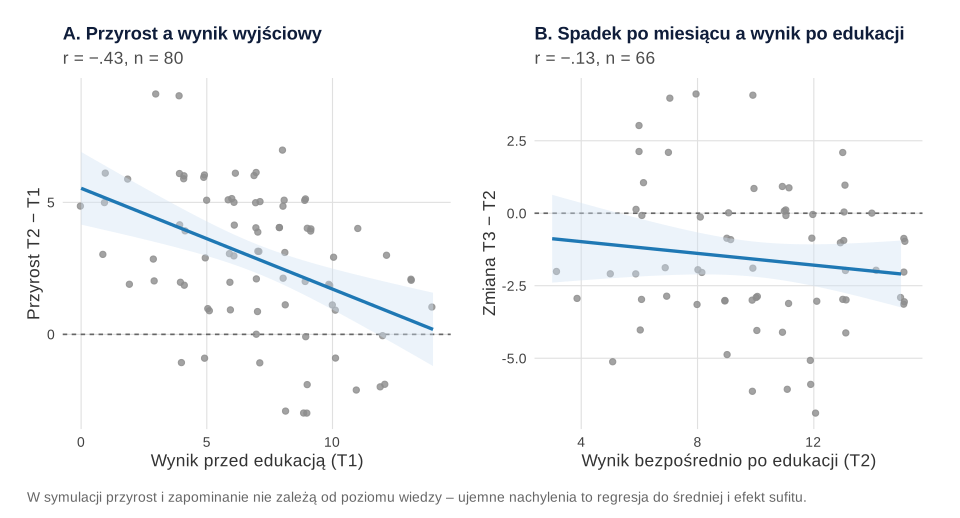
W symulacji przyrost i zapominanie losowano niezależnie od poziomu wiedzy, a ujemne nachylenia tworzą dwa artefakty. Pierwszy to regresja do średniej: kto w T2 trafił kilka odpowiedzi szczęśliwie, w T3 zwykle tego szczęścia nie ma. Barnett i in. (2005) opisują, że efekt rośnie z błędem pomiaru i jest szczególnie wyraźny, gdy dalsze pomiary analizuje się w podgrupie wybranej według wcześniejszego wyniku. Drugi to efekt sufitu: kto ma 14 punktów na 15, ten nie może zyskać więcej niż punkt. Korelacja w panelu B jest słaba (r = −.13, p = .309), choć średnie w grupach wyglądają przekonująco – nie przedstawiaj ich jako różnic w zapamiętywaniu. Szerzej o mechanizmie piszemy we wpisie regresja do średniej w badaniu przed–po.
Bez grupy kontrolnej: co wolno napisać
Schemat jednej grupy nie pozwala przypisać zmian samej edukacji (zob. ograniczenia w poradniku badanie wiedzy przed i po szkoleniu). Pomiar odroczony dodaje dwie sprawy:
- Wynik T3 to nie czysta pamięć sesji. Pacjent rozwiązał test dwa razy, zanim przyszedł na wizytę kontrolną. Roediger i Karpicke (2006) pokazali, że rozwiązywanie testu utrwala materiał lepiej niż ponowna nauka. Trzeci pomiar mierzy więc wiedzę po sesji i po dwóch testach, a także po miesiącu ulotek i rozmów z lekarzem.
- Założenie MAR jest nieweryfikowalne. Molenberghs i in. (2004) zalecają traktować modele dla braków MNAR jako analizę wrażliwości. Prosty wariant: załóż, że nieobecni wypadliby w T3 o δ punktów gorzej, niż przewiduje model, i przesuń średnią T3 o δ × odsetek nieobecnych. Przy δ = 1 średnia T3 spada w przykładzie z 8.33 do 8.15, a U z 0.47 do 0.41; przy δ = 2 – do 7.98 i 0.35. Wniosek „po miesiącu wiedza była wyższa niż przed edukacją” utrzymuje się w każdym wariancie (różnica 1.19 i 1.01 punktu).
Mocniejszy schemat to grupa porównawcza bez edukacji (albo z edukacją później), zbadana np. tylko w T3 – wtedy porównania nie zaburzają wcześniejsze testy. Analizę takiego badania opisuje wpis ANCOVA w badaniu przed i po, a opis ograniczeń w pracy – wpis ograniczenia badania – jak je opisać.
Opis w pracy: metoda, wyniki i ograniczenia
Dopasuj akapity do własnych danych; liczby pochodzą z przykładu.
Inne typowe projekty prac z tej dziedziny znajdziesz w poradniku statystyka w pracy z pielęgniarstwa.
Najczęstsze błędy
- ANOVA na samych kompletnych przypadkach bez opisu usuniętych pacjentów.
- LOCF w badaniu o zapominaniu. Przeniesienie wyniku z T2 do T3 zakłada, że nieobecni niczego nie zapomnieli.
- „Ubytek był losowy, bo p > .05” – przy kilkunastu nieobecnych test niczego nie dowodzi; podaj SMD.
- Czas jako zmienna liczbowa 1, 2, 3 zamiast czynnika.
- Wszystkie porównania post hoc zamiast trzech kontrastów zapisanych w planie analizy.
- „Najlepsi zapominają najszybciej” – wniosek z podziału pacjentów według wyniku T2, który w dużej części jest regresją do średniej.
- Pomiar odroczony bez zapisanej daty i trybu.
Trzy pomiary wiedzy w R: ubytek, model mieszany, kontrasty i symulacja
Trzy przepisy liczą wszystkie liczby z tekstu. Pierwszy tworzy dane, zapisuje je w pliku CSV w folderze nadrzędnym (../) i opisuje ubytek. Drugi dopasowuje ANOVA, model mieszany i MMRM, liczy kontrasty, utrzymanie wiedzy i analizę wrażliwości. Trzeci powtarza badanie 1000 razy. Ziarna nie wybierano pod wynik; typowość przykładu pokazuje rozrzut z trzeciego przepisu. Rysunki powstały w osobnym skrypcie. Dane do pobrania: edukacja-pacjenta-wiedza-dane.csv (80 pacjentów, format szeroki).
Dane, przepływ uczestników i porównanie osób, które odpadły
R
# B438 – edukacja pacjenta: test wiedzy przed (T1), po (T2) i po miesiącu (T3); dane symulowane
# 80 pacjentów, test 15 pytań (wynik 0–15); 14 osób nie przychodzi na pomiar odroczony.
set.seed(4381)
options(width = 110)
n <- 80
wiek <- round(pmin(pmax(rnorm(n, 66, 10), 40), 89))
mieszka_sam <- rbinom(n, 1, .30)
# Wiedza osoby na skali logitowej: poziom wyjściowy, przyrost po edukacji i zapominanie w ciągu miesiąca.
# Przyrost i zapominanie są niezależne od poziomu wyjściowego (bez „prawdziwej” regresji do średniej).
a <- rnorm(n, -0.10, 0.80) - 0.02 * (wiek - 66)
g <- rnorm(n, 1.10, 0.50)
f <- rnorm(n, 0.45, 0.35)
T1 <- rbinom(n, 15, plogis(a))
T2 <- rbinom(n, 15, plogis(a + g))
T3_pelne <- rbinom(n, 15, plogis(a + g - f))   # wynik, który uzyskałby każdy – znany tylko w symulacji
# Ubytek zależy od danych zebranych wcześniej (wynik po edukacji, wiek) – mechanizm MAR; dokładnie 14 osób
sklonnosc <- plogis(-1.7 - 0.35 * (T2 - mean(T2)) + 0.05 * (wiek - 66))
odpadli <- sample(n, 14, prob = sklonnosc)
T3 <- T3_pelne; T3[odpadli] <- NA
dni_T3 <- ifelse(is.na(T3), NA, sample(26:41, n, replace = TRUE))
dane <- data.frame(id = sprintf("P%02d", 1:n), wiek, mieszka_sam, T1, T2, T3, dni_T3)
write.csv(dane, "../edukacja-pacjenta-wiedza-dane.csv", row.names = FALSE)

# 1. Przepływ uczestników i odstęp do pomiaru odroczonego
obecny <- !is.na(dane$T3)
c(T1 = sum(!is.na(dane$T1)), T2 = sum(!is.na(dane$T2)), T3 = sum(obecny),
  brak_T3 = sum(!obecny), proc_brak = round(100 * mean(!obecny), 1))
summary(dane$dni_T3)

# 2. Kto odpadł? Średnie, SD i standaryzowana różnica (SMD: obecni – nieobecni, wspólne SD)
smd <- function(x, grupa) {
  m1 <- mean(x[grupa]); m0 <- mean(x[!grupa])
  s <- sqrt(((sum(grupa) - 1) * var(x[grupa]) + (sum(!grupa) - 1) * var(x[!grupa])) / (length(x) - 2))
  (m1 - m0) / s
}
porownanie <- sapply(c("T1", "T2", "wiek", "mieszka_sam"), function(v) {
  x <- dane[[v]]
  c(obecni_M = mean(x[obecny]), obecni_SD = sd(x[obecny]),
    nieobecni_M = mean(x[!obecny]), nieobecni_SD = sd(x[!obecny]), SMD = smd(x, obecny))
})
round(t(porownanie), 2)
t.test(T2 ~ obecny, data = dane)   # Welch: nieobecni (FALSE) vs obecni (TRUE)
# Regresja logistyczna: co przewiduje brak pomiaru odroczonego?
m_brak <- glm(!obecny ~ T2 + wiek, family = binomial, data = dane)
round(cbind(OR = exp(coef(m_brak)), exp(confint.default(m_brak)), p = coef(summary(m_brak))[, 4]), 3)

# 3. Tego nie zobaczysz w prawdziwym badaniu: średnia T3 wszystkich 80 osób (gdyby nikt nie odpadł)
round(c(T3_wszyscy = mean(T3_pelne), T3_obecni = mean(T3, na.rm = TRUE),
        T3_nieobecni_ukryte = mean(T3_pelne[!obecny])), 2)
Wynik w R
       T1        T2        T3   brak_T3 proc_brak
     80.0      80.0      66.0      14.0      17.5
   Min. 1st Qu.  Median    Mean 3rd Qu.    Max.    NA's
  26.00   30.25   33.50   34.05   38.00   41.00      14
            obecni_M obecni_SD nieobecni_M nieobecni_SD   SMD
T1              7.06      3.15        6.50         2.50  0.18
T2             10.03      3.09        8.93         3.00  0.36
wiek           66.53     10.27       71.07         7.49 -0.46
mieszka_sam     0.20      0.40        0.29         0.47 -0.21

	Welch Two Sample t-test

data:  T2 by obecny
t = -1.2419, df = 19.31, p-value = 0.2291
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
 -2.9564661  0.7530029
sample estimates:
mean in group FALSE  mean in group TRUE
           8.928571           10.030303

               OR 2.5 % 97.5 %     p
(Intercept) 0.020 0.000  2.965 0.125
T2          0.901 0.746  1.088 0.278
wiek        1.050 0.983  1.121 0.145
         T3_wszyscy           T3_obecni T3_nieobecni_ukryte
               8.20                8.44                7.07
ANOVA, model mieszany, MMRM, kontrasty i utrzymanie wiedzy
R
# B438 – analiza trzech pomiarów: model mieszany z czasem jako czynnikiem, kontrasty, utrzymanie wiedzy
suppressPackageStartupMessages({ library(lme4); library(lmerTest); library(emmeans); library(nlme) })
options(width = 110)
set.seed(4382)   # przybliżone df Satterthwaite’a dla gls() w emmeans korzystają z losowania
dane <- read.csv("../edukacja-pacjenta-wiedza-dane.csv")
# Format długi: jeden wiersz = jeden pomiar osoby; wiersze z brakiem T3 zostają jako NA i model je pomija
dl <- reshape(dane[, c("id", "T1", "T2", "T3")], direction = "long", idvar = "id",
              varying = c("T1", "T2", "T3"), v.names = "wynik", timevar = "pomiar",
              times = c("przed", "po", "odroczony"))
dl$pomiar <- factor(dl$pomiar, levels = c("przed", "po", "odroczony"))
dl$nr <- as.integer(dl$pomiar)
dl <- dl[order(dl$id, dl$nr), ]
table(dl$pomiar, obecny = !is.na(dl$wynik))

# 4. Dla porównania: ANOVA z powtarzanymi pomiarami – liczy tylko osoby z kompletem (66 z 80)
kompletni <- dane$id[!is.na(dane$T3)]
dk <- subset(dl, id %in% kompletni)
summary(aov(wynik ~ pomiar + Error(factor(id) / pomiar), data = dk))
round(tapply(dk$wynik, dk$pomiar, mean), 2)

# 5. Model mieszany z losowym wyrazem wolnym (wszystkie 80 osób, 226 pomiarów)
mm <- lmer(wynik ~ pomiar + (1 | id), data = dl)
anova(mm)
VarCorr(mm)

# 6. Model z nieustrukturyzowaną macierzą kowariancji (MMRM): własna wariancja w każdym pomiarze
#    i własna korelacja dla każdej pary pomiarów; porównanie z symetrią złożoną (oba REML, te same efekty stałe)
cs <- gls(wynik ~ pomiar, data = dl, na.action = na.omit, method = "REML",
          correlation = corCompSymm(form = ~ nr | id))
un <- gls(wynik ~ pomiar, data = dl, na.action = na.omit, method = "REML",
          correlation = corSymm(form = ~ nr | id), weights = varIdent(form = ~ 1 | pomiar))
anova(cs, un)
round(c(SD_przed = 1, coef(un$modelStruct$varStruct, unconstrained = FALSE)) * un$sigma, 2)
round(corMatrix(un$modelStruct$corStruct)[[1]], 2)

# 7. Średnie brzegowe i kontrasty zaplanowane przed analizą: 95% CI bez korekty, p z korektą Holma
emm_mm <- emmeans(mm, ~ pomiar, lmer.df = "satterthwaite")
emm_un <- emmeans(un, ~ pomiar, mode = "appx-satterthwaite")
kontrasty <- list("po - przed" = c(-1, 1, 0), "odroczony - po" = c(0, -1, 1), "odroczony - przed" = c(-1, 0, 1))
print(emm_mm, digits = 3)
k_mm <- contrast(emm_mm, kontrasty)
print(confint(k_mm, adjust = "none"), digits = 3)
print(test(k_mm, adjust = "holm"), digits = 3)
print(emm_un, digits = 3)
k_un <- contrast(emm_un, kontrasty)
print(confint(k_un, adjust = "none"), digits = 3)
print(test(k_un, adjust = "holm"), digits = 3)

# 8. Utrzymanie wiedzy: jaka część przyrostu została po miesiącu? U = (T3 - T1) / (T2 - T1)
#    Przedział metodą delta z macierzy kowariancji współczynników (pomiarpo, pomiarodroczony)
utrzymanie <- function(b, V) {
  U <- b[[2]] / b[[1]]
  grad <- c(-b[[2]] / b[[1]]^2, 1 / b[[1]])
  se <- sqrt(drop(t(grad) %*% V %*% grad))
  c(przyrost = b[[1]], zostalo = b[[2]], U = U, dolna = U - 1.96 * se, gorna = U + 1.96 * se)
}
wsp <- c("pomiarpo", "pomiarodroczony")
round(rbind(LMM = utrzymanie(fixef(mm)[wsp], as.matrix(vcov(mm))[wsp, wsp]),
            MMRM = utrzymanie(coef(un)[wsp], vcov(un)[wsp, wsp])), 3)

# 9. Analiza wrażliwości na braki MNAR: nieobecni wypadliby w T3 o delta punktów gorzej, niż przewiduje model
p_brak <- mean(is.na(dane$T3))
b_mm <- fixef(mm)
wrazliwosc <- sapply(0:2, function(delta) {
  T3 <- b_mm[[1]] + b_mm[["pomiarodroczony"]] - delta * p_brak
  c(delta = delta, T3 = T3, odroczony_przed = T3 - b_mm[[1]],
    U = (b_mm[["pomiarodroczony"]] - delta * p_brak) / b_mm[["pomiarpo"]])
})
round(t(wrazliwosc), 2)

# 10. Średnia T3 według metody (w przepisie 1: średnia T3 wszystkich 80 osób = 8.20)
locf <- ifelse(is.na(dane$T3), dane$T2, dane$T3)   # przeniesienie ostatniej obserwacji – nie rób tak
round(c(tylko_obecni = mean(dane$T3, na.rm = TRUE), LOCF = mean(locf),
        LMM = summary(emm_mm)$emmean[3], MMRM = summary(emm_un)$emmean[3]), 2)

# 11. Regresja do średniej: kto miał najwyższy wynik po edukacji, ten „najwięcej zapomniał”?
spadek <- dane$T3 - dane$T2
cor.test(dane$T2, spadek)
cor.test(dane$T1, dane$T2 - dane$T1)
round(tapply(spadek, cut(dane$T2, c(-1, 8, 11, 15), labels = c("T2 0-8", "T2 9-11", "T2 12-15")),
             function(x) mean(x, na.rm = TRUE)), 2)
Wynik w R
           obecny
            FALSE TRUE
  przed         0   80
  po            0   80
  odroczony    14   66

Error: factor(id)
          Df Sum Sq Mean Sq F value Pr(>F)
Residuals 65   1644   25.28

Error: factor(id):pomiar
           Df Sum Sq Mean Sq F value   Pr(>F)
pomiar      2  291.5  145.76   37.27 1.61e-13 ***
Residuals 130  508.5    3.91
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
    przed        po odroczony
     7.06     10.03      8.44
Type III Analysis of Variance Table with Satterthwaite's method
       Sum Sq Mean Sq NumDF  DenDF F value    Pr(>F)
pomiar 330.86  165.43     2 146.55  42.276 3.198e-15 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 Groups   Name        Std.Dev.
 id       (Intercept) 2.5689
 Residual             1.9782
   Model df      AIC      BIC    logLik   Test  L.Ratio p-value
cs     1  5 1097.807 1114.843 -543.9034
un     2  9 1094.224 1124.888 -538.1119 1 vs 2 11.58304  0.0207
 SD_przed        po odroczony
     3.04      3.08      3.67
     [,1] [,2] [,3]
[1,] 1.00 0.61 0.56
[2,] 0.61 1.00 0.75
[3,] 0.56 0.75 1.00
 pomiar    emmean    SE  df lower.CL upper.CL
 przed       6.96 0.362 130     6.25     7.68
 po          9.84 0.362 130     9.12    10.55
 odroczony   8.33 0.382 149     7.57     9.08

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
 contrast          estimate    SE  df lower.CL upper.CL
 po - przed            2.88 0.313 145    2.257    3.493
 odroczony - po       -1.51 0.335 148   -2.172   -0.848
 odroczony - przed     1.36 0.335 148    0.703    2.027

Degrees-of-freedom method: satterthwaite
Confidence level used: 0.95
 contrast          estimate    SE  df t.ratio p.value
 po - przed            2.88 0.313 145   9.192 <0.0001
 odroczony - po       -1.51 0.335 148  -4.509 <0.0001
 odroczony - przed     1.36 0.335 148   4.074 <0.0001

Degrees-of-freedom method: satterthwaite
P value adjustment: holm method for 3 tests
 pomiar    emmean    SE   df lower.CL upper.CL
 przed       6.96 0.340 78.5     6.29     7.64
 po          9.84 0.345 78.7     9.15    10.52
 odroczony   8.27 0.429 75.6     7.42     9.13

Degrees-of-freedom method: appx-satterthwaite
Confidence level used: 0.95
 contrast          estimate    SE   df lower.CL upper.CL
 po - przed            2.88 0.303 79.4    2.273    3.477
 odroczony - po       -1.57 0.302 65.0   -2.169   -0.964
 odroczony - przed     1.31 0.380 72.4    0.552    2.066

Degrees-of-freedom method: appx-satterthwaite
Confidence level used: 0.95
 contrast          estimate    SE   df t.ratio p.value
 po - przed            2.88 0.303 79.4   9.501 <0.0001
 odroczony - po       -1.57 0.302 65.0  -5.189 <0.0001
 odroczony - przed     1.31 0.380 72.4   3.446  0.0010

Degrees-of-freedom method: appx-satterthwaite
P value adjustment: holm method for 3 tests
     przyrost zostalo     U dolna gorna
LMM     2.875   1.365 0.475 0.273 0.677
MMRM    2.875   1.309 0.455 0.242 0.668
     delta   T3 odroczony_przed    U
[1,]     0 8.33            1.36 0.47
[2,]     1 8.15            1.19 0.41
[3,]     2 7.98            1.01 0.35
tylko_obecni         LOCF          LMM         MMRM
        8.44         8.53         8.33         8.27

	Pearson's product-moment correlation

data:  dane$T2 and spadek
t = -1.0252, df = 64, p-value = 0.3091
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.3581272  0.1185682
sample estimates:
       cor
-0.1271123


	Pearson's product-moment correlation

data:  dane$T1 and dane$T2 - dane$T1
t = -4.1896, df = 78, p-value = 7.296e-05
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.5925208 -0.2306014
sample estimates:
       cor
-0.4286023

  T2 0-8  T2 9-11 T2 12-15
   -0.81    -1.82    -2.09
1000 powtórzeń: obecni, LOCF, model mieszany i MMRM
R
# B438 – 1000 powtórzeń badania: jak metody radzą sobie z ubytkiem zależnym od wyniku po edukacji i wieku
suppressPackageStartupMessages({ library(lme4); library(nlme) })
options(width = 110)
set.seed(4383)
symuluj <- function(n = 80, n_brak = 14) {   # ten sam mechanizm co w przepisie 1
  wiek <- round(pmin(pmax(rnorm(n, 66, 10), 40), 89))
  a <- rnorm(n, -0.10, 0.80) - 0.02 * (wiek - 66)
  g <- rnorm(n, 1.10, 0.50); f <- rnorm(n, 0.45, 0.35)
  T1 <- rbinom(n, 15, plogis(a)); T2 <- rbinom(n, 15, plogis(a + g)); T3p <- rbinom(n, 15, plogis(a + g - f))
  odpadli <- sample(n, n_brak, prob = plogis(-1.7 - 0.35 * (T2 - mean(T2)) + 0.05 * (wiek - 66)))
  T3 <- T3p; T3[odpadli] <- NA
  data.frame(id = 1:n, T1, T2, T3, T3p)
}
jedno_badanie <- function() {
  d <- symuluj()
  dl <- data.frame(id = rep(d$id, 3), nr = rep(1:3, each = nrow(d)), wynik = c(d$T1, d$T2, d$T3))
  dl$pomiar <- factor(dl$nr, labels = c("przed", "po", "odroczony"))
  dl <- dl[order(dl$id, dl$nr), ]
  b_mm <- fixef(lmer(wynik ~ pomiar + (1 | id), data = dl))
  b_un <- coef(gls(wynik ~ pomiar, data = dl, na.action = na.omit,
                   correlation = corSymm(form = ~ nr | id), weights = varIdent(form = ~ 1 | pomiar)))
  ok <- !is.na(d$T3); locf <- ifelse(ok, d$T3, d$T2)
  c(T3_pelne = mean(d$T3p), T3_obecni = mean(d$T3[ok]), T3_LOCF = mean(locf),
    T3_LMM = sum(b_mm[c(1, 3)]), T3_MMRM = sum(b_un[c(1, 3)]),
    sp_pelne = mean(d$T3p - d$T2), sp_obecni = mean(d$T3[ok] - d$T2[ok]), sp_LOCF = mean(locf - d$T2),
    sp_LMM = b_mm[[3]] - b_mm[[2]], sp_MMRM = b_un[[3]] - b_un[[2]])
}
wyn <- t(replicate(1000, jedno_badanie()))
# Błąd = oszacowanie z danymi z ubytkiem minus wartość z pełnych danych tego samego badania
blad_T3 <- wyn[, c("T3_obecni", "T3_LOCF", "T3_LMM", "T3_MMRM")] - wyn[, "T3_pelne"]
blad_sp <- wyn[, c("sp_obecni", "sp_LOCF", "sp_LMM", "sp_MMRM")] - wyn[, "sp_pelne"]
podsum <- function(e) round(rbind(sredni_blad = colMeans(e), SD_bledu = apply(e, 2, sd),
                                  RMSE = sqrt(colMeans(e^2))), 3)
cat("Średnia T3 (punkty 0-15):\n"); podsum(blad_T3)
cat("Spadek T2 -> T3 (punkty):\n"); podsum(blad_sp)
round(c(sredni_spadek_pelne = mean(wyn[, "sp_pelne"]), proc_LOCF_mniejszy = 100 * mean(blad_sp[, "sp_LOCF"] > 0)), 2)
write.csv(data.frame(blad_T3, blad_sp), "b438-symulacja.csv", row.names = FALSE)
Wynik w R
Średnia T3 (punkty 0-15):
            T3_obecni T3_LOCF T3_LMM T3_MMRM
sredni_blad     0.384   0.147  0.082   0.002
SD_bledu        0.179   0.130  0.135   0.146
RMSE            0.424   0.196  0.158   0.146
Spadek T2 -> T3 (punkty):
            sp_obecni sp_LOCF sp_LMM sp_MMRM
sredni_blad    -0.102   0.147  0.082   0.002
SD_bledu        0.143   0.130  0.135   0.146
RMSE            0.176   0.196  0.158   0.146
sredni_spadek_pelne  proc_LOCF_mniejszy
              -1.32               86.60
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lme4, lmerTest, emmeans i nlme); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed pomiarem odroczonym i analizą sprawdź…
- Czy termin pomiaru odroczonego ma okno w dniach i czy notujesz rzeczywistą datę i tryb każdego pomiaru?
- Czy pomiary osoby łączy jeden identyfikator i czy zapisujesz powód każdej nieobecności?
- Czy plan analizy wymienia model, trzy kontrasty i miarę utrzymania wiedzy?
- Czy porównałeś osoby obecne i nieobecne w T3 (SMD, a nie tylko p)?
- Czy model obejmuje także pacjentów bez T3 i czy sprawdziłeś strukturę korelacji (MMRM)?
- Czy w ograniczeniach opisałeś brak grupy kontrolnej, efekt wielokrotnego testowania i założenie MAR?
Jeśli chcesz, żeby ktoś sprawdził z Tobą model, kontrasty i opis ubytku, zobacz pomoc w analizie dla studentów.
Najczęstsze pytania
Jak policzyć, jaka część przyrostu wiedzy utrzymała się po miesiącu?
Podziel różnicę między wynikiem po miesiącu a wynikiem sprzed edukacji przez przyrost uzyskany na sesji: U = (T3 − T1) / (T2 − T1). Licz ją ze średnich z modelu, a nie jako średnią ilorazów poszczególnych pacjentów, i dodaj 95% CI metodą delta. W przykładzie U = 0.475, 95% CI [0.27, 0.68], czyli pacjenci zachowali około połowy przyrostu.
Czym różni się model z losowym wyrazem wolnym od MMRM przy trzech pomiarach wiedzy?
Model z losowym wyrazem wolnym zakłada jednakową wariancję w każdym pomiarze i jednakową korelację każdej pary pomiarów. MMRM, czyli model z nieustrukturyzowaną macierzą kowariancji, pozwala każdemu pomiarowi mieć własną wariancję, a każdej parze – własną korelację. Przy trzech pomiarach można dopasować oba i porównać AIC; w przykładzie lepszy był MMRM, a wnioski z obu modeli były takie same.
Dlaczego nie wpisać pacjentom bez pomiaru po miesiącu ich wyniku sprzed miesiąca?
Przeniesienie ostatniej obserwacji (LOCF) zakłada, że nieobecni niczego nie zapomnieli, a w badaniu o utrzymaniu wiedzy to właśnie jest pytanie badawcze. W 1000 symulowanych badaniach LOCF zawyżał średnią wiedzę po miesiącu średnio o 0.15 punktu i w 86.6% powtórzeń pokazywał mniejsze zapominanie niż w pełnych danych. Model mieszany obejmujący wszystkie pomiary był bliżej prawdy.
Czy pacjenci z najlepszym wynikiem po edukacji naprawdę zapominają najwięcej?
Niekoniecznie. Gdy dzielisz pacjentów według wyniku po edukacji, grupa najlepszych zawiera osoby, którym w tym pomiarze dopisało szczęście, więc w kolejnym pomiarze ich wynik spada nawet bez zapominania. Do tego dochodzi efekt sufitu. W przykładzie najlepsi stracili średnio 2.09 punktu, a najsłabsi 0.81, choć w symulacji zapominanie nie zależało od poziomu wiedzy.
Jakie porównania zaplanować przy teście wiedzy przed, po i po miesiącu?
Trzy kontrasty odpowiadające trzem pytaniom: po – przed (ile pacjent przyswoił), odroczony – po (ile zapomniał) i odroczony – przed (czy po miesiącu wie więcej niż na starcie). Zapisz je w planie analizy przed zebraniem danych, policz je ze średnich brzegowych modelu i skoryguj wartości p metodą Holma zamiast wykonywać wszystkie testy post hoc.
Powiązane hasła
Przeczytaj też
Ewaluacja szkolenia w modelu Kirkpatricka
Cztery poziomy jako cztery pomiary: narzędzie, termin, schemat i analiza, krytyka modelu oraz korelacje między poziomami – z przykładem 120 osób w R.
Czytaj →PoradnikBadanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikRegresja do średniej w badaniu przed–po
Dlaczego osoby zakwalifikowane za wysoki wynik „poprawiają się” bez leczenia, ile wynosi ten efekt i jak go usunąć grupą kontrolną, ANCOVA i osobnym pomiarem wyjściowym.
Czytaj →PoradnikJak zbudować test wiedzy krok po kroku
Cel, tabela specyfikacji, liczba pytań a KR-20, format, „nie wiem”, eksperci i pilotaż z analizą pozycji w R – od pomysłu do opisu narzędzia w pracy.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →Masz test wiedzy pacjentów w trzech pomiarach?
Pomożemy opisać ubytek uczestników, dopasować model mieszany z kontrastami i policzyć utrzymanie wiedzy w R lub SPSS, a potem wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Dumville, J. C., Torgerson, D. J., & Hewitt, C. E. (2006). Reporting attrition in randomised controlled trials. BMJ, 332(7547), 969–971. https://doi.org/10.1136/bmj.332.7547.969 ● Otwarty dostęp: pełny tekst
- Gueorguieva, R., & Krystal, J. H. (2004). Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry. Archives of General Psychiatry, 61(3), 310–317. https://doi.org/10.1001/archpsyc.61.3.310
- Kessels, R. P. C. (2003). Patients’ memory for medical information. Journal of the Royal Society of Medicine, 96(5), 219–222. https://doi.org/10.1258/jrsm.96.5.219 ● Otwarty dostęp: pełny tekst
- Molenberghs, G., Thijs, H., Jansen, I., Beunckens, C., Kenward, M. G., Mallinckrodt, C., & Carroll, R. J. (2004). Analyzing incomplete longitudinal clinical trial data. Biostatistics, 5(3), 445–464. https://doi.org/10.1093/biostatistics/kxh001
- Roediger, H. L., & Karpicke, J. D. (2006). Test-enhanced learning: Taking memory tests improves long-term retention. Psychological Science, 17(3), 249–255. https://doi.org/10.1111/j.1467-9280.2006.01693.x
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Twisk, J., de Boer, M., de Vente, W., & Heymans, M. (2013). Multiple imputation of missing values was not necessary before performing a longitudinal mixed-model analysis. Journal of Clinical Epidemiology, 66(9), 1022–1028. https://doi.org/10.1016/j.jclinepi.2013.03.017
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{dumville2006reporting, author={Dumville, Jo C. and Torgerson, David J. and Hewitt, Catherine E.}, title={{Reporting attrition in randomised controlled trials}}, journal={BMJ}, year={2006}, volume={332}, number={7547}, pages={969--971}, doi={10.1136/bmj.332.7547.969}}@article{gueorguieva2004move, author={Gueorguieva, Ralitza and Krystal, John H.}, title={{Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry}}, journal={Archives of General Psychiatry}, year={2004}, volume={61}, number={3}, pages={310--317}, doi={10.1001/archpsyc.61.3.310}}@article{kessels2003patients, author={Kessels, Roy P. C.}, title={{Patients’ memory for medical information}}, journal={Journal of the Royal Society of Medicine}, year={2003}, volume={96}, number={5}, pages={219--222}, doi={10.1258/jrsm.96.5.219}}@article{molenberghs2004analyzing, author={Molenberghs, Geert and Thijs, Herbert and Jansen, Ivy and Beunckens, Caroline and Kenward, Michael G. and Mallinckrodt, Craig and Carroll, Raymond J.}, title={{Analyzing incomplete longitudinal clinical trial data}}, journal={Biostatistics}, year={2004}, volume={5}, number={3}, pages={445--464}, doi={10.1093/biostatistics/kxh001}}@article{roediger2006test, author={Roediger, Henry L. and Karpicke, Jeffrey D.}, title={{Test-enhanced learning: Taking memory tests improves long-term retention}}, journal={Psychological Science}, year={2006}, volume={17}, number={3}, pages={249--255}, doi={10.1111/j.1467-9280.2006.01693.x}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}@article{twisk2013multiple, author={Twisk, Jos and de Boer, Michiel and de Vente, Wieke and Heymans, Martijn}, title={{Multiple imputation of missing values was not necessary before performing a longitudinal mixed-model analysis}}, journal={Journal of Clinical Epidemiology}, year={2013}, volume={66}, number={9}, pages={1022--1028}, doi={10.1016/j.jclinepi.2013.03.017}}