Cztery poziomy to plan pomiaru, a nie drabina
Promotor(ka) mówi: „oceń to szkolenie modelem Kirkpatricka”, a pod ręką masz ankietę z ostatniego dnia zajęć. To za mało. Model opisuje cztery różne rzeczy, które można zmierzyć po szkoleniu: reakcję, uczenie się, zachowanie i rezultaty (Alliger i Janak, 1989). Każda z nich wymaga innego narzędzia, innego terminu pomiaru i innej analizy.
Model wywodzi się z serii artykułów Donalda Kirkpatricka z lat 1959–1960 (Alliger i Janak, 1989), a rozwinięciem jest książka Evaluating training programs (Kirkpatrick i Kirkpatrick, 2006). Ten wpis przekłada go na decyzje badawcze w pracy dyplomowej. Ogólny plan ewaluacji, model logiczny programu i kryteria oceny znajdziesz w poradniku badanie ewaluacyjne w pracy dyplomowej. Tutaj zajmujemy się tylko tym, co mierzyć na każdym poziomie, jak to policzyć i czego wolno się spodziewać po korelacjach między poziomami. Wpis dotyczy wyłącznie danych ilościowych.
Co mierzyć na każdym poziomie
Tabela to skrót całego wpisu. Dla każdego poziomu podaje najprostsze sensowne rozwiązanie. W kolumnie „schemat” jest minimum, a nie ideał.
| Poziom | Co mierzysz | Narzędzie | Schemat | Analiza |
|---|---|---|---|---|
| 1. Reakcja | zadowolenie i postrzegana przydatność | ankieta po zajęciach, skala 1–5 | jeden pomiar | rozkład, M, SD, odsetek ocen najwyższych |
| 2. Uczenie się | wiedza lub umiejętność | test wiedzy przed i po | pretest–posttest | test t dla prób zależnych, wielkość efektu |
| 3. Zachowanie | co uczestnik robi w pracy | obserwacja z listą kontrolną, dokumentacja | przed i po kilku tygodniach lub miesiącach | model mieszany |
| 4. Rezultaty | wskaźnik organizacji albo opieki | rejestry, raporty, dokumentacja | przerwany szereg czasowy albo grupa porównawcza | GLMM, regresja segmentowa |
Przykład: szkolenie z przekazywania dyżuru
Dane są symulowane, a sytuacja wymyślona. Studiująca pielęgniarka ocenia wewnętrzne szkolenie z ustrukturyzowanego przekazywania dyżuru. Bierze w nim udział 120 osób z ośmiu oddziałów. Plan pomiaru pokazuje rysunek 1: na koniec zajęć ankieta (3 pozycje o zadowoleniu, 3 o przydatności), test wiedzy 0–20 przed szkoleniem i tuż po nim, trzy obserwacje przekazania dyżuru z listą 10 elementów przed szkoleniem i po trzech miesiącach oraz wskaźnik z okresów trzymiesięcznych: odsetek przekazań, po których następna zmiana zgłosiła brak informacji. Po trzech miesiącach nie udało się zebrać danych od 15 osób. Na koniec zajęć uczestnicy ocenili też wsparcie przełożonych i zespołu w stosowaniu nowego sposobu pracy.
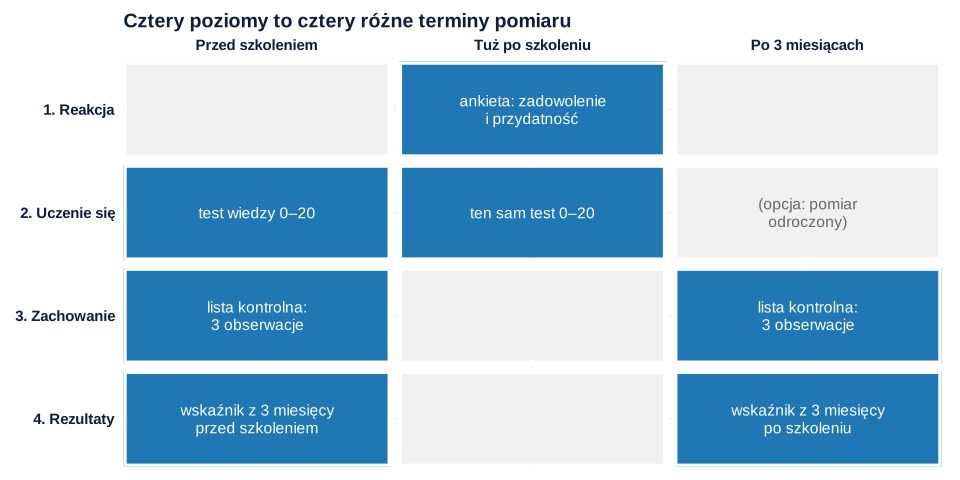
Poziom 1. Reakcja: rozdziel zadowolenie i przydatność
Ankieta ma być krótka i wypełniona przed wyjściem z sali. Pytaj osobno o to, czy szkolenie się podobało, i o to, czy przyda się w pracy. Zasady analizy skali Likerta i opisu takich wyników są we wpisie o ankiecie satysfakcji; policz też rzetelność każdej podskali i podaj ją przy opisie narzędzia.
W przykładzie zadowolenie wynosi M = 4.33 (SD = 0.57, α = .82), a przydatność M = 4.26 (SD = 0.58, α = .82). Wyniki co najmniej 4 ma odpowiednio 81.7% i 77.5% osób, a maksimum 28.3% i 20.8%. Tak skupiony rozkład to efekt sufitu – mało różnic między ludźmi, więc mało do skorelowania z czymkolwiek.
Co wolno z tego wywnioskować? Że uczestnicy dobrze ocenili zajęcia. Metaanaliza reakcji na szkolenia wskazuje, że opisują one głównie cechy kursu: najsilniejszymi predyktorami były styl prowadzenia zajęć (ρ = .66) i interakcja z ludźmi (ρ = .56; Sitzmann i in., 2008). Wysoka ocena mówi przede wszystkim o zajęciach, a nie o tym, czego się nauczono.
Poziom 2. Uczenie się: mierz, zamiast pytać
Tu potrzebny jest test, a nie pytanie „ile się nauczyłeś(-aś)?”. Sitzmann i in. (2010) w metaanalizie pokazali, że samoocena wiedzy była najsilniej związana z motywacją i zadowoleniem, a z rzeczywistym uczeniem się tylko umiarkowanie; niemal jedna trzecia badań ewaluacyjnych traktowała ją mimo to jako dowód uczenia się. Test zbuduj według wpisu jak zbudować test wiedzy.
Wynik w przykładzie: przed szkoleniem M = 11.00 (SD = 3.34), tuż po M = 15.21 (SD = 3.29). Różnica to 4.21 punktu, 95% CI [3.62, 4.80], t(119) = 14.15, p < .001, dav = 1.27 (wielkość efektu dla prób zależnych). Tylko 4.2% osób osiągnęło maksimum, więc test nie ma tu sufitu. Analizy poszczególnych pytań, test McNemara i przyrost znormalizowany opisuje wpis badanie wiedzy przed i po szkoleniu; nie ma potrzeby ich tu powtarzać. Tak duży efekt tuż po zajęciach nie mówi też, ile wiedzy zostanie po miesiącu – to pytanie o pomiar odroczony.
Poziom 3. Zachowanie: obserwacja i odroczony termin
Zachowanie mierz tam, gdzie zachodzi, i z odstępem czasu, który pozwala je zmienić. Jednostką obserwacji jest okazja, np. przekazanie dyżuru, zagnieżdżona w osobie i oddziale. Szczegóły listy kontrolnej, zgodności obserwatorów i przedziałów dla danych skupionych są we wpisie o obserwacji z listą kontrolną, a na efekt Hawthorne'a przygotuj się w planie obserwacji.
Jeśli obserwacja jest niemożliwa i zostaje ankieta, opisz to jako ograniczenie. W metaanalizie transferu związki predyktorów z transferem były zawyżone, gdy transfer oceniało to samo źródło w tym samym kontekście pomiaru (Blume i in., 2010). To wspólna wariancja metody w praktyce, a dochodzi do niej aprobata społeczna.
Najpierw opisz ubytek. Po trzech miesiącach brakuje 15 osób ze 120 (12.5%). Miały one niższą wiedzę wyjściową (M = 9.00 wobec 11.29 u tych, którzy zostali) i nieco niższy wyjściowy odsetek wykonanych elementów listy (54.0% wobec 59.9%). Utrata uczestników nie jest więc czysto losowa. Dlatego zamiast analizy kompletnych przypadków użyj modelu mieszanego, który wykorzystuje wszystkie 120 osób przy założeniu MAR.
Odsetek wykonanych elementów wzrósł z 59.2% (SD = 14.3, n = 120) do 70.5% (SD = 14.4, n = 105). Model z efektami losowymi osoby i oddziału daje zmianę o 10.83 punktu procentowego, 95% CI [8.23, 13.42], t(108.3) = 8.18, p < .001. Dlaczego model mieszany, a nie ANOVA tylko dla osób z kompletem pomiarów, wyjaśnia wpis o pomiarach powtarzanych.
Poziom 4. Rezultaty: wskaźnik, który istniał przed szkoleniem
Rezultat to wskaźnik organizacji lub opieki, a nie odpowiedź uczestnika. Musi spełniać trzy warunki: da się go policzyć w okresie przed szkoleniem, zdefiniowano go zanim zebrano dane i można go wiarygodnie powiązać z zakresem szkolenia. Dobór i definiowanie wskaźników opisuje wpis o badaniu ewaluacyjnym (krok 3).
W przykładzie przekazania z brakiem informacji stanowiły 20.9% przed szkoleniem (930 z 4460) i 14.2% po nim (545 z 3825). Dane to liczba zdarzeń na liczbę przekazań, dlatego model jest logistyczny: OR = 0.62, 95% CI [0.55, 0.70], z = −7.86, p < .001 (iloraz szans poniżej 1 oznacza spadek).
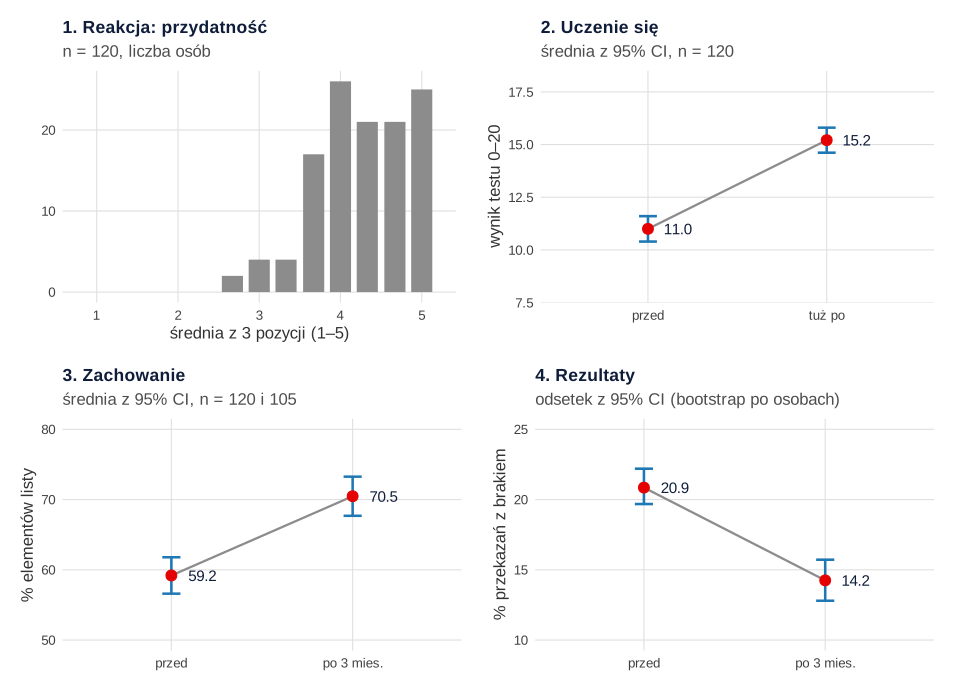
Rysunek 2 wygląda jak dowód skuteczności, ale nim nie jest. W tym samym czasie mogło zmienić się wszystko inne na oddziałach. Przy wskaźniku zbieranym co miesiąc znacznie mocniejszy jest przerwany szereg czasowy: wiele punktów przed i po, z trendem i autokorelacją. Gdy szereg jest za krótki, potrzebna jest grupa porównawcza. Zwróć uwagę, jak rzadko bada się ten poziom: w metaanalizie Arthura i in. (2003) było k = 26 efektów dla rezultatów wobec k = 234 dla uczenia się.
Bez grupy porównawczej opisujesz zmianę, a nie efekt
Przykład ma jedną grupę, bo tak wygląda większość ewaluacji w pracach dyplomowych. Taki schemat nie oddziela działania szkolenia od upływu czasu, regresji do średniej i tego, że uczestnicy znają już test. Jeśli możesz dodać grupę, wybierz listę oczekujących albo oddział szkolony później, a analizę zaplanuj według wpisów o ANCOVA i różnicy w różnicach. Gdy szkolisz całe oddziały, pamiętaj, że jednostką przydziału jest oddział.
Czy poziomy naprawdę tworzą łańcuch?
Model często czyta się jak drabinę: podobało się, więc się nauczyli, więc robią inaczej, więc są rezultaty. Literatura tego nie potwierdza.
- Trzy założenia. Alliger i Janak (1989) nazwali problematycznymi założenia, że wyższe poziomy dają więcej informacji, że poziomy łączą się przyczynowo i że są dodatnio skorelowane.
- Taksonomia zamiast modelu. Holton (1996) uznał cztery poziomy za taksonomię wyników. Prawdziwy model powinien, jego zdaniem, wskazywać związki przyczynowe i zmienne pośredniczące, takie jak motywacja do nauki, cechy osobowe i warunki przenoszenia do pracy.
- Jaki rodzaj reakcji? Alliger i in. (1997) stwierdzili, że reakcje dotyczące przydatności silniej łączą się z uczeniem się i transferem niż reakcje afektywne. Sitzmann i in. (2008) nie znaleźli różnicy między tymi rodzajami w związkach z uczeniem się. Pytanie o przydatność nadal warto zadać, ale nie obiecuj, że zastąpi test.
- Zakres zastosowania. Yardley i Dornan (2012) uznali, że w edukacji medycznej poziomy nadają się tylko do względnie prostych interwencji i krótkoterminowych punktów końcowych; ich hierarchiczne stosowanie jako narzędzia oceny jakości dowodów wnosi niewiele.
Jednocześnie Arthur i in. (2003) w metaanalizie uzyskali średnie efekty szkoleń bardzo podobne dla wszystkich czterech rodzajów kryteriów: d od 0.60 do 0.63. Model przydaje się więc jako lista tego, co mierzyć, nawet jeśli poziomy nie wynikają jeden z drugiego.
Korelacje między poziomami w przykładzie
Uczestników można ułożyć w tabeli i policzyć korelacje między poziomami. Dla poziomów 2–4 użyj zmian: wyników różnicowych. Dla poziomu 4 to spadek odsetka przekazań z brakiem, tak aby większa wartość zawsze oznaczała lepszy wynik. Sprawdź też korelację Spearmana, bo reakcje mają sufit.
| Para poziomów | n | r | 95% CI | ρ Spearmana |
|---|---|---|---|---|
| Przydatność – przyrost wiedzy | 120 | .13 | [−.05, .30] | .14 |
| Zadowolenie – przyrost wiedzy | 120 | .02 | [−.16, .20] | −.04 |
| Przydatność – zmiana zachowania | 105 | .00 | [−.19, .20] | .00 |
| Zadowolenie – zmiana zachowania | 105 | −.04 | [−.23, .15] | −.01 |
| Przyrost wiedzy – zmiana zachowania | 105 | −.01 | [−.20, .18] | .02 |
| Zmiana zachowania – spadek braków | 105 | .17 | [−.02, .35] | .20 |
| Przyrost wiedzy – spadek braków | 105 | −.16 | [−.34, .03] | −.17 |
| Przydatność – spadek braków | 105 | −.19 | [−.37, .00] | −.19 |
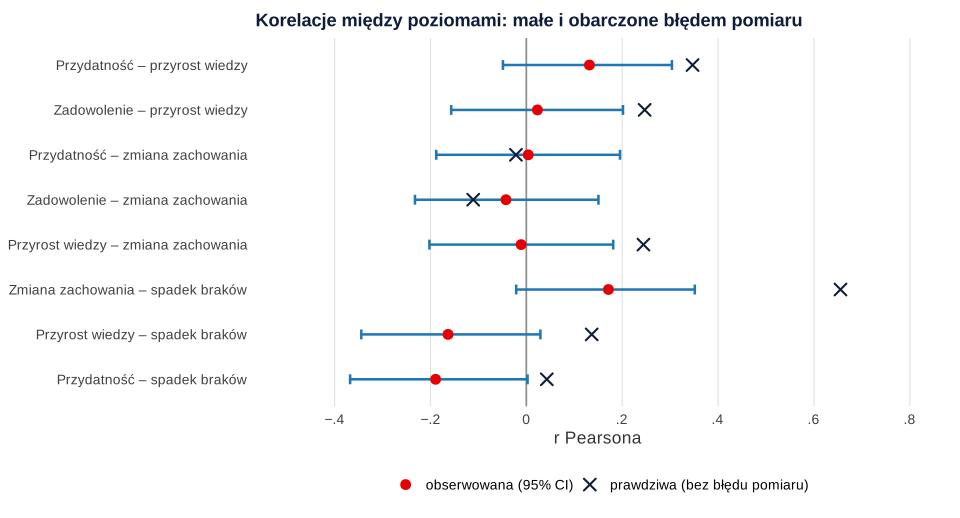
Żaden przedział nie wyklucza zera wyraźnie, a po poprawce Holma najmniejsze p wynosi .426. Odjęcie średnich oddziałów zmienia r najwyżej o 0.03. Czy to znaczy, że poziomy nie mają ze sobą nic wspólnego? W tych danych nie. Ponieważ są symulowane, znamy prawdziwe zależności: między zmianą zachowania a spadkiem braków r = .66, a obserwujemy r = .17.
Powody są trzy i występują w prawdziwych badaniach:
- Błąd pomiaru zmian. Różnica dwóch wyników ma niższą rzetelność niż każdy z nich, a trzy obserwacje i kilkadziesiąt przekazań na osobę to mało. Różnica jest też podatna na regresję do średniej.
- Ograniczony zakres. Gdy reakcje są skupione przy maksimum, korelacja z nimi musi być niska.
- Mała próba. Przy n = 105 przedział 95% dla r ma szerokość około .38 (czy korelacja .30 to dużo).
Korelacje między osobami odpowiadają na inne pytanie niż analizy poziomów. Uczestnicy mogą wyraźnie zyskać na szkoleniu (rysunek 2), choć ci, którzy zyskali więcej wiedzy, wcale nie zmieniają zachowania bardziej (rysunek 3). Wynik nieistotny opisz przedziałem (jak opisać wynik nieistotny), a nie zdaniem „poziomy nie są powiązane”.
Zgodnie z argumentem Holtona (1996) sprawdź zmienną pośredniczącą, którą zmierzyłeś(-aś) obok poziomów. W regresji zmiany zachowania (n = 105) przydatność (b = 0.83, 95% CI [−3.83, 5.49], p = .723) i przyrost wiedzy (b = −0.01, 95% CI [−0.92, 0.90], p = .983) nie przewidują wyniku, a wsparcie przełożonych i zespołu tak: b = 3.89, 95% CI [0.57, 7.21], p = .022, R² = .051. To zgodne z metaanalizą, w której środowisko pracy wspierające zmiany dodatnio wiązało się z transferem (Blume i in., 2010). Jeden punkt skali wsparcia to prawie 4 punkty procentowe większej zmiany – mały efekt, ale inna informacja dla organizatora szkolenia.
Gotowy opis do pracy
Akapit opisuje przykład. Podmień liczby i usuń to, czego nie zrobiłeś(-aś).
Najczęstsze błędy
- Ankieta zadowolenia jako dowód skuteczności. Reakcja to tylko poziom 1; wysoka ocena nie oznacza przyrostu wiedzy ani zmiany pracy.
- Samoocena „ile się nauczyłem” zamiast testu. Opisuj ją jako percepcję, a nie jako poziom 2.
- Pomiar zachowania tydzień po szkoleniu. Termin dobierz do tego, kiedy uczestnicy mogli zastosować nowy sposób pracy; najlepiej ustal go przed zebraniem danych.
- Wskaźnik bez danych wyjściowych. Bez okresu przed szkoleniem poziom 4 jest tylko opisem jednego okresu.
- Wnioski przyczynowe z jednej grupy. Pisz „po szkoleniu wynik był wyższy”, nie „szkolenie poprawiło”.
- Wynik nieistotnej korelacji jako dowód braku związku. Podaj przedział ufności i błąd pomiaru.
- Usunięcie osób z ubytkiem. Opisz je i użyj modelu wykorzystującego wszystkie dostępne pomiary.
- Traktowanie czterech poziomów jak hierarchii jakości. Poziomy odpowiadają na różne pytania; poziom 4 nie jest automatycznie lepszy od poziomu 2.
Jeśli chcesz sprawdzić, czy plan pomiaru i analiza pasują do Twojego szkolenia, zobacz pomoc w analizie dla studentów. Wynik obronisz samodzielnie, jeśli rozumiesz każdy krok.
Ewaluacja w czterech poziomach w R
Trzy przepisy liczą wszystkie liczby z tekstu. Uruchamiaj je po kolei z jednego folderu; rysunki powstały w osobnym skrypcie na tych samych danych. Dane możesz pobrać: szkolenie-kirkpatrick-120-uczestnikow.csv (120 osób, układ szeroki: pozycje ankiety, wsparcie, wiedza, liczba wykonanych elementów listy oraz przekazania i braki w obu okresach; brak pomiaru po 3 miesiącach to puste pola).
Dane: symulacja 120 uczestników
R
# B454 – ewaluacja szkolenia w modelu Kirkpatricka: symulacja 120 uczestników
# Dane fikcyjne. Szkolenie z przekazywania dyżuru, 8 oddziałów, pomiary: przed, tuż po i po 3 miesiącach.
set.seed(4541)
n <- 120
oddzial <- sample(rep(paste0("O", 1:8), each = 15))
u_odd <- rnorm(8, 0, .22)[as.integer(factor(oddzial))]     # efekt oddziału (zachowanie, rezultat)

# Zmienne ukryte: w prawdziwym badaniu ich nie znasz
theta   <- rnorm(n, .25, .55)                              # wiedza wyjściowa (skala logitowa)
g_wiedza <- rnorm(n, 1.05, .35)                            # prawdziwy przyrost wiedzy
wsparcie_u <- rnorm(n)                                     # wsparcie przełożonego i zespołu
przydat_u <- .35 * as.numeric(scale(g_wiedza)) + rnorm(n, 0, .94)   # postrzegana przydatność
zadow_u   <- .55 * przydat_u + rnorm(n, 0, .84)            # zadowolenie (podobało się)
g_zach <- .62 + .10 * as.numeric(scale(g_wiedza)) + .24 * wsparcie_u + rnorm(n, 0, .18)  # zmiana zachowania
g_rez  <- -.12 - .55 * g_zach + rnorm(n, 0, .22)           # zmiana szansy braku informacji

# Poziom 1: ankieta na koniec szkolenia, pozycje 1–5
item <- function(u) pmin(5, pmax(1, round(4.4 + .62 * u + rnorm(n, 0, .38))))
z1 <- item(zadow_u); z2 <- item(zadow_u); z3 <- item(zadow_u)
p1 <- item(przydat_u); p2 <- item(przydat_u); p3 <- item(przydat_u)

# Poziom 2: test wiedzy 0–20 przed i tuż po szkoleniu
wiedza_przed <- rbinom(n, 20, plogis(theta))
wiedza_po    <- rbinom(n, 20, plogis(theta + g_wiedza))

# Poziom 3: lista kontrolna, 3 obserwacje przekazania dyżuru po 10 elementów (0–30)
wsp <- pmin(5, pmax(1, round(3.4 + .75 * wsparcie_u + rnorm(n, 0, .25), 1)))
a_os <- rnorm(n, .35, .45)
elementy_przed <- rbinom(n, 30, plogis(a_os + u_odd))
elementy_3m    <- rbinom(n, 30, plogis(a_os + u_odd + g_zach))

# Poziom 4: przekazania z brakiem informacji zgłoszonym przez następną zmianę, po 3 miesiące
c_os <- rnorm(n, -1.45, .25)
prz_przed <- rpois(n, 36); prz_3m <- rpois(n, 36)
braki_przed <- rbinom(n, prz_przed, plogis(c_os - .6 * u_odd))
braki_3m    <- rbinom(n, prz_3m, plogis(c_os - .6 * u_odd + g_rez))

# Ubytek po 3 miesiącach: częściej przy niższej wiedzy wyjściowej
ubytek <- rbinom(n, 1, plogis(-2.0 - .7 * as.numeric(scale(wiedza_przed)))) == 1
elementy_3m[ubytek] <- NA; prz_3m[ubytek] <- NA; braki_3m[ubytek] <- NA

d <- data.frame(id = 1:n, oddzial, z1, z2, z3, p1, p2, p3, wsparcie = wsp,
                wiedza_przed, wiedza_po, elementy_przed, elementy_3m,
                prz_przed, braki_przed, prz_3m, braki_3m)
write.csv(d, "../szkolenie-kirkpatrick-120-uczestnikow.csv", row.names = FALSE, fileEncoding = "UTF-8")

cat("Uczestnicy:", nrow(d), "| oddziały:", length(unique(d$oddzial)),
    "| bez pomiaru po 3 miesiącach:", sum(ubytek), "\n")

# Tylko w symulacji: prawdziwe korelacje przyrostów (bez błędu pomiaru) i zapis do rysunku
prawdziwe <- data.frame(
  para = c("przydatnosc-wiedza", "zadowolenie-wiedza", "przydatnosc-zachowanie", "zadowolenie-zachowanie",
           "wiedza-zachowanie", "zachowanie-rezultat", "wiedza-rezultat", "przydatnosc-rezultat"),
  r_prawdziwe = c(cor(przydat_u, g_wiedza), cor(zadow_u, g_wiedza), cor(przydat_u, g_zach), cor(zadow_u, g_zach),
                  cor(g_wiedza, g_zach), cor(g_zach, -g_rez), cor(g_wiedza, -g_rez), cor(przydat_u, -g_rez)))
write.csv(prawdziwe, "b454-prawdziwe-korelacje.csv", row.names = FALSE, fileEncoding = "UTF-8")
prawdziwe$r_prawdziwe <- round(prawdziwe$r_prawdziwe, 2)
print(prawdziwe, row.names = FALSE)
Wynik w R
Uczestnicy: 120 | oddziały: 8 | bez pomiaru po 3 miesiącach: 15
                   para r_prawdziwe
     przydatnosc-wiedza        0.35
     zadowolenie-wiedza        0.25
 przydatnosc-zachowanie       -0.02
 zadowolenie-zachowanie       -0.11
      wiedza-zachowanie        0.24
    zachowanie-rezultat        0.66
        wiedza-rezultat        0.14
   przydatnosc-rezultat        0.04
Analiza poziomów 1–4
R
# B454 – analiza każdego poziomu osobno
suppressPackageStartupMessages({library(lmerTest); library(psych)})
d <- read.csv("../szkolenie-kirkpatrick-120-uczestnikow.csv", fileEncoding = "UTF-8")
d$zadowolenie <- rowMeans(d[, c("z1", "z2", "z3")])
d$przydatnosc <- rowMeans(d[, c("p1", "p2", "p3")])

cat("== Poziom 1: reakcja (1–5) ==\n")
for (s in c("zadowolenie", "przydatnosc")) {
  x <- d[[s]]; it <- if (s == "zadowolenie") c("z1", "z2", "z3") else c("p1", "p2", "p3")
  cat(sprintf("%-12s M = %.2f, SD = %.2f, min = %.2f; wynik >= 4: %.1f%%; wynik = 5: %.1f%%; alfa = %.2f\n", s, mean(x), sd(x), min(x),
              100 * mean(x >= 4), 100 * mean(x == 5),
              psych::alpha(d[, it], warnings = FALSE)$total$raw_alpha))
}

cat("\n== Poziom 2: wiedza 0–20, przed i tuż po (n = 120) ==\n")
t2 <- t.test(d$wiedza_po, d$wiedza_przed, paired = TRUE)
dif <- d$wiedza_po - d$wiedza_przed
cat(sprintf("przed M = %.2f, SD = %.2f; po M = %.2f, SD = %.2f\n", mean(d$wiedza_przed), sd(d$wiedza_przed), mean(d$wiedza_po), sd(d$wiedza_po)))
cat(sprintf("różnica = %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, p %s\n", mean(dif), t2$conf.int[1], t2$conf.int[2], t2$parameter, t2$statistic,
            ifelse(t2$p.value < .001, "< .001", sprintf("= %.3f", t2$p.value))))
cat(sprintf("d_av = %.2f\n", mean(dif) / mean(c(sd(d$wiedza_przed), sd(d$wiedza_po)))))
cat(sprintf("wynik po = 20 punktów: %.1f%%\n", 100 * mean(d$wiedza_po == 20)))

cat("\n== Ubytek przed pomiarem po 3 miesiącach ==\n")
d$ubyl <- is.na(d$elementy_3m)
cat("ubyło:", sum(d$ubyl), "z", nrow(d), sprintf("(%.1f%%)\n", 100 * mean(d$ubyl)))
cat(sprintf("wiedza przed: zostali M = %.2f (n = %d), ubyli M = %.2f (n = %d)\n", mean(d$wiedza_przed[!d$ubyl]), sum(!d$ubyl),
            mean(d$wiedza_przed[d$ubyl]), sum(d$ubyl)))
cat(sprintf("elementy przed (%%): zostali M = %.1f, ubyli M = %.1f\n", mean(d$elementy_przed[!d$ubyl]) / .3, mean(d$elementy_przed[d$ubyl]) / .3))

cat("\n== Poziom 3: zachowanie, % wykonanych elementów listy (3 obserwacje × 10) ==\n")
dl <- rbind(data.frame(id = d$id, oddzial = d$oddzial, czas = "przed", el = d$elementy_przed, prz = d$prz_przed, br = d$braki_przed),
            data.frame(id = d$id, oddzial = d$oddzial, czas = "po3m", el = d$elementy_3m, prz = d$prz_3m, br = d$braki_3m))
dl$czas <- factor(dl$czas, levels = c("przed", "po3m")); dl$proc <- dl$el / 30 * 100
cat(sprintf("przed M = %.1f, SD = %.1f (n = %d); po 3 mies. M = %.1f, SD = %.1f (n = %d)\n",
            mean(dl$proc[dl$czas == "przed"]), sd(dl$proc[dl$czas == "przed"]), sum(dl$czas == "przed"),
            mean(dl$proc[dl$czas == "po3m"], na.rm = TRUE), sd(dl$proc[dl$czas == "po3m"], na.rm = TRUE), sum(!is.na(dl$proc[dl$czas == "po3m"]))))
m3 <- lmer(proc ~ czas + (1 | id) + (1 | oddzial), data = dl)
ci3 <- confint(m3, parm = "czaspo3m", method = "Wald")
s3 <- coef(summary(m3))["czaspo3m", ]
cat(sprintf("model mieszany: zmiana = %.2f pp, 95%% CI [%.2f, %.2f], t(%.1f) = %.2f, p %s\n", s3[1], ci3[1], ci3[2], s3[3], s3[4],
            ifelse(s3[5] < .001, "< .001", sprintf("= %.3f", s3[5]))))
vc3 <- as.data.frame(VarCorr(m3)); print(vc3[, c("grp", "vcov")], digits = 3, row.names = FALSE)
cat("osobliwe dopasowanie:", isSingular(m3), "\n")

cat("\n== Poziom 4: przekazania z brakiem informacji ==\n")
cat(sprintf("przed: %d z %d (%.1f%%); po 3 mies.: %d z %d (%.1f%%)\n", sum(d$braki_przed), sum(d$prz_przed), 100 * sum(d$braki_przed) / sum(d$prz_przed),
            sum(d$braki_3m, na.rm = TRUE), sum(d$prz_3m, na.rm = TRUE), 100 * sum(d$braki_3m, na.rm = TRUE) / sum(d$prz_3m, na.rm = TRUE)))
dl4 <- subset(dl, !is.na(br))
m4 <- glmer(cbind(br, prz - br) ~ czas + (1 | id) + (1 | oddzial), data = dl4, family = binomial,
            control = glmerControl(optimizer = "bobyqa"))
s4 <- coef(summary(m4))["czaspo3m", ]
cat(sprintf("model logistyczny mieszany: OR = %.2f, 95%% CI [%.2f, %.2f], z = %.2f, p %s\n", exp(s4[1]), exp(s4[1] - 1.96 * s4[2]), exp(s4[1] + 1.96 * s4[2]), s4[3],
            ifelse(s4[4] < .001, "< .001", sprintf("= %.3f", s4[4]))))
cat("osobliwe dopasowanie:", isSingular(m4), "\n")
Wynik w R
== Poziom 1: reakcja (1–5) ==
zadowolenie  M = 4.33, SD = 0.57, min = 3.00; wynik >= 4: 81.7%; wynik = 5: 28.3%; alfa = 0.82
przydatnosc  M = 4.26, SD = 0.58, min = 2.67; wynik >= 4: 77.5%; wynik = 5: 20.8%; alfa = 0.82

== Poziom 2: wiedza 0–20, przed i tuż po (n = 120) ==
przed M = 11.00, SD = 3.34; po M = 15.21, SD = 3.29
różnica = 4.21, 95% CI [3.62, 4.80], t(119) = 14.15, p < .001
d_av = 1.27
wynik po = 20 punktów: 4.2%

== Ubytek przed pomiarem po 3 miesiącach ==
ubyło: 15 z 120 (12.5%)
wiedza przed: zostali M = 11.29 (n = 105), ubyli M = 9.00 (n = 15)
elementy przed (%): zostali M = 59.9, ubyli M = 54.0

== Poziom 3: zachowanie, % wykonanych elementów listy (3 obserwacje × 10) ==
przed M = 59.2, SD = 14.3 (n = 120); po 3 mies. M = 70.5, SD = 14.4 (n = 105)
model mieszany: zmiana = 10.83 pp, 95% CI [8.23, 13.42], t(108.3) = 8.18, p < .001
      grp  vcov
       id 102.2
  oddzial  12.2
 Residual  94.8
osobliwe dopasowanie: FALSE

== Poziom 4: przekazania z brakiem informacji ==
przed: 930 z 4460 (20.9%); po 3 mies.: 545 z 3825 (14.2%)
model logistyczny mieszany: OR = 0.62, 95% CI [0.55, 0.70], z = -7.86, p < .001
osobliwe dopasowanie: FALSE
Korelacje między poziomami i regresja zmiany zachowania
R
# B454 – związki między poziomami i czynniki pośredniczące
d <- read.csv("../szkolenie-kirkpatrick-120-uczestnikow.csv", fileEncoding = "UTF-8")
d$zadowolenie <- rowMeans(d[, c("z1", "z2", "z3")])
d$przydatnosc <- rowMeans(d[, c("p1", "p2", "p3")])
d$zm_wiedza <- d$wiedza_po - d$wiedza_przed
d$zm_zachowanie <- (d$elementy_3m - d$elementy_przed) / 30 * 100
d$spadek_brakow <- 100 * (d$braki_przed / d$prz_przed - d$braki_3m / d$prz_3m)

pary <- list(c("przydatnosc", "zm_wiedza"), c("zadowolenie", "zm_wiedza"), c("przydatnosc", "zm_zachowanie"), c("zadowolenie", "zm_zachowanie"),
             c("zm_wiedza", "zm_zachowanie"), c("zm_zachowanie", "spadek_brakow"), c("zm_wiedza", "spadek_brakow"), c("przydatnosc", "spadek_brakow"))
nazwa <- c("przydatnosc-wiedza", "zadowolenie-wiedza", "przydatnosc-zachowanie", "zadowolenie-zachowanie",
           "wiedza-zachowanie", "zachowanie-rezultat", "wiedza-rezultat", "przydatnosc-rezultat")
wyn <- do.call(rbind, lapply(seq_along(pary), function(i) {
  x <- d[[pary[[i]][1]]]; y <- d[[pary[[i]][2]]]; ok <- complete.cases(x, y)
  ct <- cor.test(x[ok], y[ok])
  data.frame(para = nazwa[i], n = sum(ok), r = ct$estimate, dolna = ct$conf.int[1], gorna = ct$conf.int[2], p = ct$p.value,
             rho_spearman = suppressWarnings(cor(x[ok], y[ok], method = "spearman")))
}))
wyn$p_holm <- p.adjust(wyn$p, "holm")
write.csv(wyn, "b454-korelacje.csv", row.names = FALSE, fileEncoding = "UTF-8")
pok <- wyn; pok[, c("r", "dolna", "gorna", "rho_spearman")] <- round(pok[, c("r", "dolna", "gorna", "rho_spearman")], 2)
pok$p <- round(pok$p, 3); pok$p_holm <- round(pok$p_holm, 3)
print(pok, row.names = FALSE)

cat("\nPo odjęciu średnich oddziałów: największa zmiana korelacji =")
srodk <- function(x) x - ave(x, d$oddzial, FUN = function(v) mean(v, na.rm = TRUE))
r2 <- sapply(pary, function(p) cor(srodk(d[[p[1]]]), srodk(d[[p[2]]]), use = "complete.obs"))
cat(sprintf(" %s\n", sub("^0", "", sprintf("%.2f", max(abs(r2 - wyn$r))))))

cat("\nCo przewiduje zmianę zachowania (n =", sum(complete.cases(d$zm_zachowanie)), ")\n")
m <- lm(zm_zachowanie ~ przydatnosc + zm_wiedza + wsparcie, data = d)
tab <- cbind(b = coef(m), confint(m), p = coef(summary(m))[, 4])
colnames(tab) <- c("b", "dolna", "gorna", "p")
tab[, 1:3] <- round(tab[, 1:3], 2); tab[, 4] <- round(tab[, 4], 3)
print(tab)
bz <- function(x, k) sub("^0", "", sprintf(paste0("%.", k, "f"), x))
cat(sprintf("R2 = %s; korelacja wsparcie–zmiana zachowania: r = %s\n", bz(summary(m)$r.squared, 3), bz(cor(d$wsparcie, d$zm_zachowanie, use = "complete.obs"), 2)))
Wynik w R
                   para   n     r dolna gorna     p rho_spearman p_holm
     przydatnosc-wiedza 120  0.13 -0.05  0.30 0.152         0.14  0.760
     zadowolenie-wiedza 120  0.02 -0.16  0.20 0.802        -0.04  1.000
 przydatnosc-zachowanie 105  0.00 -0.19  0.20 0.969         0.00  1.000
 zadowolenie-zachowanie 105 -0.04 -0.23  0.15 0.667        -0.01  1.000
      wiedza-zachowanie 105 -0.01 -0.20  0.18 0.912         0.02  1.000
    zachowanie-rezultat 105  0.17 -0.02  0.35 0.081         0.20  0.565
        wiedza-rezultat 105 -0.16 -0.34  0.03 0.096        -0.17  0.576
   przydatnosc-rezultat 105 -0.19 -0.37  0.00 0.053        -0.19  0.426

Po odjęciu średnich oddziałów: największa zmiana korelacji = .03

Co przewiduje zmianę zachowania (n = 105 )
                b  dolna gorna     p
(Intercept) -6.07 -30.05 17.92 0.617
przydatnosc  0.83  -3.83  5.49 0.723
zm_wiedza   -0.01  -0.92  0.90 0.983
wsparcie     3.89   0.57  7.21 0.022
R2 = .051; korelacja wsparcie–zmiana zachowania: r = .22
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4, lmerTest i psych; rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://CRAN.R-project.org/package=svglite
Przed zebraniem danych sprawdź
- Wiesz, które poziomy mierzysz i dlaczego, a które świadomie pomijasz.
- Każdy poziom ma narzędzie, termin i zdefiniowany wskaźnik.
- Test wiedzy i lista kontrolna są gotowe przed szkoleniem, a wskaźnik ma dane sprzed szkolenia.
- Masz identyfikator łączący pomiary tej samej osoby.
- Znasz plan postępowania z ubytkiem i schemat (czy jest grupa porównawcza).
- Zmierzyłeś(-aś) co najmniej jedną zmienną pośredniczącą, np. wsparcie w pracy.
Najczęstsze pytania
Czy w pracy magisterskiej trzeba zmierzyć wszystkie cztery poziomy Kirkpatricka?
Nie. Wybierz poziomy, które odpowiadają pytaniu badawczemu i które da się zmierzyć w czasie pracy, a pominięcie pozostałych uzasadnij. W pracy dyplomowej realne są często poziomy 1–3. Poziom 4 wymaga wskaźnika z okresu przed szkoleniem i schematu, który pozwala odróżnić wpływ szkolenia od innych zmian.
Jak zmierzyć zmianę zachowania po szkoleniu, jeśli nie mogę obserwować uczestników?
Użyj dokumentacji albo wskaźnika pracy, a gdy to niemożliwe – kwestionariusza ocenianego przez przełożonego lub współpracownika. Samoocenę uczestnika opisz jako percepcję zmiany i wskaż ograniczenie: w metaanalizie Blume i in. (2010) związki z transferem były zawyżone, gdy transfer oceniało to samo źródło w tym samym kontekście.
Dlaczego korelacja między oceną szkolenia a wynikiem testu wiedzy jest niska?
Reakcje zwykle skupiają się przy maksimum skali, więc mają mały zakres, a zmiana w teście jest mierzona z błędem. Reakcje opisują też głównie cechy kursu (Sitzmann i in., 2008). Niska korelacja nie oznacza więc, że szkolenie nie działa. Podaj ją z przedziałem ufności i nie traktuj jej jako testu skuteczności.
Jak pokazać wpływ szkolenia na wskaźniki oddziału bez grupy kontrolnej?
Zbierz wskaźnik w wielu okresach przed szkoleniem i po nim, np. co miesiąc, i użyj regresji segmentowej dla przerwanego szeregu czasowego. Dwa punkty (przed i po) pozwalają opisać jedynie zmianę. Zawsze sprawdź, co jeszcze zmieniło się w tym czasie na oddziale, i opisz to jako ograniczenie.
Po jakim czasie od szkolenia mierzyć zachowanie uczestników?
Nie ma uniwersalnej liczby tygodni. Odstęp powinien wynikać z tego, jak często pojawia się okazja do zastosowania nowych umiejętności i kiedy mogą one wejść w codzienną pracę. Termin ustal przed badaniem, zapisz w metodzie i ten sam stosuj u wszystkich uczestników oraz w grupie porównawczej, jeśli ją masz.
Powiązane hasła
Przeczytaj też
Ewaluacja programu w jednej placówce – opis metody
Gotowy podrozdział „Metoda”: autor jako prowadzący, wierność realizacji, grupa porównawcza i dozwolone wnioski, z kodem R.
Czytaj →PoradnikBadanie ewaluacyjne w pracy dyplomowej
Model logiczny, kryteria i poziomy Kirkpatricka, wskaźniki, schemat przed–po z grupą porównawczą oraz ANCOVA i DiD w R na przykładzie szkolenia.
Czytaj →PoradnikBadanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →PoradnikObserwacja z listą kontrolną
Audyt przestrzegania procedur (np. higieny rąk): okazja jako jednostka, CI uwzględniający osoby, zgodność obserwatorów, Hawthorne i przed–po – przykład w R.
Czytaj →PoradnikRegresja segmentowa i przerwany szereg czasowy
Zmiana poziomu i nachylenia, gls z AR(1), sezonowość, szereg kontrolny, nieznany punkt załamania z bootstrapem, przykład w R i wzór opisu.
Czytaj →Oceniasz szkolenie w swojej pracy dyplomowej?
Pomożemy dobrać pomiary do poziomów, policzyć modele dla danych przed i po oraz opisać ubytek i ograniczenia – w R lub SPSS, z wyjaśnieniem, które pozwoli Ci samodzielnie obronić wyniki.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Alliger, G. M., & Janak, E. A. (1989). Kirkpatrick's levels of training criteria: Thirty years later. Personnel Psychology, 42(2), 331–342. https://doi.org/10.1111/j.1744-6570.1989.tb00661.x
- Alliger, G. M., Tannenbaum, S. I., Bennett, W., Traver, H., & Shotland, A. (1997). A meta-analysis of the relations among training criteria. Personnel Psychology, 50(2), 341–358. https://doi.org/10.1111/j.1744-6570.1997.tb00911.x
- Arthur, W., Bennett, W., Edens, P. S., & Bell, S. T. (2003). Effectiveness of training in organizations: A meta-analysis of design and evaluation features. Journal of Applied Psychology, 88(2), 234–245. https://doi.org/10.1037/0021-9010.88.2.234
- Blume, B. D., Ford, J. K., Baldwin, T. T., & Huang, J. L. (2010). Transfer of training: A meta-analytic review. Journal of Management, 36(4), 1065–1105. https://doi.org/10.1177/0149206309352880
- Holton, E. F. (1996). The flawed four-level evaluation model. Human Resource Development Quarterly, 7(1), 5–21. https://doi.org/10.1002/hrdq.3920070103
- Kirkpatrick, D. L., & Kirkpatrick, J. D. (2006). Evaluating training programs: The four levels (3rd ed.). Berrett-Koehler.
- Sitzmann, T., Brown, K. G., Casper, W. J., Ely, K., & Zimmerman, R. D. (2008). A review and meta-analysis of the nomological network of trainee reactions. Journal of Applied Psychology, 93(2), 280–295. https://doi.org/10.1037/0021-9010.93.2.280
- Sitzmann, T., Ely, K., Brown, K. G., & Bauer, K. N. (2010). Self-assessment of knowledge: A cognitive learning or affective measure? Academy of Management Learning & Education, 9(2), 169–191. https://doi.org/10.5465/amle.9.2.zqr169
- Yardley, S., & Dornan, T. (2012). Kirkpatrick's levels and education 'evidence'. Medical Education, 46(1), 97–106. https://doi.org/10.1111/j.1365-2923.2011.04076.x ● Otwarty dostęp
Cytowania BibTeX
@article{alliger1989kirkpatrick, author={Alliger, George M. and Janak, Elizabeth A.}, title={{Kirkpatrick's levels of training criteria: Thirty years later}}, journal={Personnel Psychology}, year={1989}, volume={42}, number={2}, pages={331--342}, doi={10.1111/j.1744-6570.1989.tb00661.x}}@article{alliger1997meta, author={Alliger, George M. and Tannenbaum, Scott I. and Bennett, Winston and Traver, Holly and Shotland, Allison}, title={{A meta-analysis of the relations among training criteria}}, journal={Personnel Psychology}, year={1997}, volume={50}, number={2}, pages={341--358}, doi={10.1111/j.1744-6570.1997.tb00911.x}}@article{arthur2003effectiveness, author={Arthur, Winfred and Bennett, Winston and Edens, Pamela S. and Bell, Suzanne T.}, title={{Effectiveness of training in organizations: A meta-analysis of design and evaluation features}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={2}, pages={234--245}, doi={10.1037/0021-9010.88.2.234}}@article{blume2010transfer, author={Blume, Brian D. and Ford, J. Kevin and Baldwin, Timothy T. and Huang, Jason L.}, title={{Transfer of training: A meta-analytic review}}, journal={Journal of Management}, year={2010}, volume={36}, number={4}, pages={1065--1105}, doi={10.1177/0149206309352880}}@article{holton1996flawed, author={Holton, Elwood F.}, title={{The flawed four-level evaluation model}}, journal={Human Resource Development Quarterly}, year={1996}, volume={7}, number={1}, pages={5--21}, doi={10.1002/hrdq.3920070103}}@book{kirkpatrick2006evaluating, author={Kirkpatrick, Donald L. and Kirkpatrick, James D.}, title={{Evaluating training programs: The four levels (3rd ed.)}}, year={2006}, publisher={Berrett-Koehler}}@article{sitzmann2008review, author={Sitzmann, Traci and Brown, Kenneth G. and Casper, Wendy J. and Ely, Katherine and Zimmerman, Ryan D.}, title={{A review and meta-analysis of the nomological network of trainee reactions}}, journal={Journal of Applied Psychology}, year={2008}, volume={93}, number={2}, pages={280--295}, doi={10.1037/0021-9010.93.2.280}}@article{sitzmann2010selfassessment, author={Sitzmann, Traci and Ely, Katherine and Brown, Kenneth G. and Bauer, Kristina N.}, title={{Self-assessment of knowledge: A cognitive learning or affective measure?}}, journal={Academy of Management Learning \& Education}, year={2010}, volume={9}, number={2}, pages={169--191}, doi={10.5465/amle.9.2.zqr169}}@article{yardley2012kirkpatrick, author={Yardley, Sarah and Dornan, Tim}, title={{Kirkpatrick's levels and education 'evidence'}}, journal={Medical Education}, year={2012}, volume={46}, number={1}, pages={97--106}, doi={10.1111/j.1365-2923.2011.04076.x}}