Czym jest badanie ewaluacyjne i kiedy pasuje do pracy
Badanie ewaluacyjne odpowiada na praktyczne pytanie: czy konkretny program, szkolenie albo projekt działa tak, jak zakładano, i dlaczego. Nie bada ogólnej zależności między zmiennymi, tylko ocenia jedno działanie w jednym miejscu. W pracach dyplomowych pojawia się często. Na pedagogice ocenia się zajęcia profilaktyczne albo program wychowawczy. Na zarządzaniu bada się szkolenia pracowników, a na zdrowiu publicznym, pielęgniarstwie i dietetyce – programy edukacji zdrowotnej. Typowe analizy tych kierunków opisują wpisy statystyka w pracy z pedagogiki, statystyka w pracy z zarządzania i ekonomii oraz statystyka w pracy ze zdrowia publicznego.
Ewaluacja ma dwie części. Ewaluacja procesu sprawdza, czy program zrealizowano zgodnie z planem i kto z niego skorzystał. Ewaluacja wyników sprawdza, co się zmieniło u uczestników. W pracy dyplomowej zwykle potrzebujesz obu, bo słaby wynik bez danych o realizacji niczego nie wyjaśnia. Jeśli program dopiero powstaje i chcesz sprawdzić, czy da się go w ogóle przeprowadzić, właściwym schematem jest pilotaż wykonalności, a nie ewaluacja skuteczności.
Ten wpis prowadzi przez cztery decyzje: model logiczny, kryteria i pytania, wskaźniki oraz schemat badania. Na końcu jest przykład w R i lista ograniczeń. Same metody analizy omawiają osobne wpisy, do których odsyłamy.
Krok 1. Narysuj model logiczny programu
Model logiczny to schemat, który pokazuje, jak program ma prowadzić do zmiany. Horstman i Godwin (2025) opisują pięć standardowych elementów: nakłady, działania, produkty, rezultaty i wpływ. Radzą też tworzyć model razem z osobami, które program prowadzą, i poprawiać go, gdy program się zmienia.
- Nakłady – zasoby: ludzie, czas, pieniądze, materiały.
- Działania – co program robi: warsztaty, porady, kampania.
- Produkty – bezpośrednie, policzalne efekty działań: liczba zajęć, liczba uczestników, frekwencja.
- Rezultaty – zmiany u uczestników: najpierw w wiedzy i postawach, potem w zachowaniu.
- Wpływ – zmiany długofalowe w organizacji lub społeczności, zwykle poza zasięgiem pracy dyplomowej.
Najważniejsza różnica, którą trzeba pilnować, to produkt a rezultat. „Przeszkolono 64 osoby” to produkt. „Wiedza uczestników wzrosła” to rezultat. Wiele prac kończy się na produktach i nazywa je skutecznością. Rysunek 1 pokazuje model logiczny szkolenia z naszego przykładu razem ze wskaźnikami, które zmierzono.
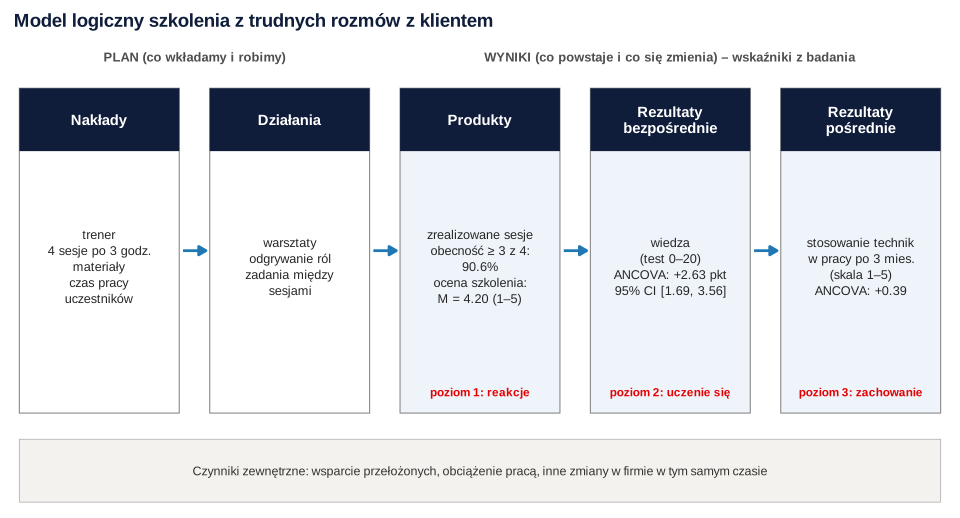
Model logiczny przyda Ci się trzy razy. Przy planowaniu wskazuje, co mierzyć. W rozdziale metodologicznym zastępuje długi opis programu. W dyskusji pomaga ustalić, w którym miejscu łańcuch się przerwał, jeśli rezultatu nie ma.
Krok 2. Wybierz kryteria i pytania ewaluacyjne
Kryteria mówią, pod jakim kątem oceniasz program. W ewaluacji programów rozwojowych najczęściej stosuje się kryteria OECD DAC, zrewidowane w latach 2018–2019: trafność (adekwatność do potrzeb), spójność, skuteczność, efektywność, wpływ i trwałość (OECD, 2019). Dokument OECD podkreśla, że kryteriów nie stosuje się mechanicznie wszystkich naraz, tylko dobiera do kontekstu i potrzeb odbiorców ewaluacji. W pracy dyplomowej wybierz dwa lub trzy. Prawie zawsze będzie wśród nich skuteczność, czyli pytanie, czy osiągnięto zamierzone rezultaty.
Przy szkoleniach popularnym porządkiem jest model Kirkpatricka. Ma cztery poziomy: reakcje, uczenie się, zachowanie i rezultaty (Alliger i Janak, 1989).
| Poziom | Pytanie | Przykładowy wskaźnik | Kiedy mierzyć |
|---|---|---|---|
| 1. Reakcje | Jak uczestnicy ocenili szkolenie? | średnia ocena przydatności (1–5) | na koniec zajęć |
| 2. Uczenie się | Czy wzrosła wiedza lub umiejętność? | wynik testu wiedzy (0–20) | przed i tuż po |
| 3. Zachowanie | Czy uczestnicy stosują to w pracy? | częstość stosowania technik (1–5) | przed i po kilku miesiącach |
| 4. Rezultaty | Czy zmieniło się coś w organizacji? | liczba skarg, rotacja | po dłuższym czasie |
Modelu nie traktuj jak drabiny, w której każdy szczebel wynika z poprzedniego. Alliger i Janak (1989) wskazali trzy wątpliwe założenia: że wyższe poziomy dają cenniejszą informację, że poziomy łączą się przyczynowo i że są ze sobą dodatnio skorelowane. Metaanaliza Alligera i in. (1997) pokazała, że oceny przydatności szkolenia wiązały się z uczeniem się i transferem do pracy silniej niż ocena, czy szkolenie się podobało. Praktyczny wniosek: w ankiecie reakcji pytaj o przydatność, a nie tylko o zadowolenie. Wysoka ocena szkolenia nie jest dowodem jego skuteczności.
Krok 3. Zamień rezultaty na wskaźniki
Wskaźnik to mierzalna wersja rezultatu, czyli jego operacjonalizacja. Dobry wskaźnik ma pięć elementów: co mierzysz, jakim narzędziem, u kogo, kiedy i jaka zmiana byłaby dla Ciebie sukcesem. Ostatni element zapisz przed zebraniem danych, najlepiej w planie analizy.
| Element modelu | Wskaźnik | Źródło danych | Analiza |
|---|---|---|---|
| Produkt | odsetek osób obecnych na co najmniej 3 z 4 sesji | lista obecności | odsetek z 95% CI |
| Produkt (reakcje) | średnia ocena przydatności | ankieta po szkoleniu | M (SD) |
| Rezultat bezpośredni | wynik testu wiedzy 0–20 | test przed i tydzień po | ANCOVA z grupą porównawczą |
| Rezultat pośredni | stosowanie technik w pracy, 1–5 | kwestionariusz przed i po 3 miesiącach | ANCOVA z grupą porównawczą |
Do wskaźników procesu dodaj wierność realizacji: czy program przeprowadzono tak, jak go zaprojektowano. Bellg i in. (2004) wymieniają tu m.in. szkolenie osób prowadzących, sposób realizacji, odbiór przez uczestników i stosowanie nabytych umiejętności. W pracy dyplomowej wystarczy lista kontrolna wypełniana po każdej sesji. Szerzej opisuje to hasło adherencja.
Krok 4. Zaplanuj schemat przed–po z grupą porównawczą
Najsłabszy, a bardzo częsty plan to jeden pomiar przed programem i jeden po, bez żadnej grupy odniesienia. Taki schemat pretest–posttest nie oddziela efektu programu od upływu czasu, efektu ponownego testowania i regresji do średniej. Jeśli w szkoleniu wiedzy nie masz innej możliwości, analizę takiego badania opisuje wpis badanie wiedzy przed i po szkoleniu.
Znacznie mocniejszy jest schemat przed–po z grupą porównawczą. Grupę porównawczą tworzą osoby podobne do uczestników, które w tym czasie programu nie dostają. Może to być inny oddział, równoległa klasa albo osoby z listy oczekujących. Gdy przydział nie jest losowy, to quasi-eksperyment – klasyczny podręcznik takich planów napisali Shadish i in. (2002). Jeśli możesz losować, zrób to. Gdy program obejmuje całe klasy lub zespoły, losuj całe grupy według zasad z wpisu o randomizacji klastrowej.
Trzy rady do planu:
- Zmierz obie grupy tym samym narzędziem i w tym samym czasie. Bez pomiaru wyjściowego nie ocenisz, jak bardzo grupy różniły się od początku.
- Dodaj pomiar odroczony, jeśli pytasz o zachowanie. Zmiana w pracy nie pojawia się tydzień po szkoleniu.
- Zapisz z góry, kto odpadł i dlaczego. Utrata uczestników różna w grupach może sama wytworzyć „efekt”.
Przykład: ewaluacja szkolenia z trudnych rozmów z klientem
Dane są symulowane. Firma przeszkoliła pracowników obsługi klienta z oddziału A (n = 64; cztery sesje po 3 godziny). Oddział B (n = 60) miał dostać to samo szkolenie w kolejnym kwartale i posłużył jako grupa porównawcza. Grup nie losowano. Wiedzę mierzono testem 0–20 przed szkoleniem i tydzień po, a stosowanie technik w pracy – skalą 1–5 przed i po trzech miesiącach. Dane są w pliku CSV.
Produkty i reakcje. Na co najmniej trzech sesjach było 58 z 64 osób, czyli 90.6%, 95% CI [80.7, 96.5]. Średnia ocena przydatności wyniosła M = 4.20 (SD = 0.49). To dobra informacja o realizacji, ale jeszcze nie o skuteczności.
Utrata uczestników. Pomiaru po tygodniu brakowało u 2 osób z grupy szkolenia i 7 z grupy porównawczej. Pomiaru po trzech miesiącach brakowało odpowiednio u 11 i 6 osób.
| Wskaźnik, M (SD) | Porównawcza | Szkolenie |
|---|---|---|
| Wiedza przed (0–20) | 11.43 (3.38) | 10.39 (3.10) |
| Wiedza tydzień po | 11.58 (2.92) | 13.63 (2.73) |
| Stosowanie technik przed (1–5) | 2.88 (0.61) | 2.85 (0.57) |
| Stosowanie technik po 3 miesiącach | 2.76 (0.50) | 3.15 (0.68) |
Wiedza (poziom 2). Grupa szkolenia zaczynała z niższą wiedzą o mniej więcej punkt. Dlatego wynik po szkoleniu porównano w ANCOVA z wiedzą wyjściową jako kowariantem. Przy tej samej wiedzy wyjściowej uczestnicy szkolenia mieli po szkoleniu o 2.63 punktu więcej, 95% CI [1.69, 3.56], t(112) = 5.56, p < .001. Średnie skorygowane wyniosły 13.90 i 11.27, a d = 0.93. Dlaczego ANCOVA, a nie porównanie samych wyników końcowych, wyjaśnia wpis ANCOVA w badaniu przed i po.
To samo jako różnica w różnicach. Wiedza w grupie szkolenia wzrosła średnio o 3.35 punktu, a w grupie porównawczej zmieniła się o −0.04. Różnica w różnicach wynosi 3.39, 95% CI [2.26, 4.53]. Obie metody wskazują wyraźny wzrost, ale dają różne liczby. Van Breukelen (2006) pokazuje, że w badaniach bez losowania, gdy grupy różnią się na starcie, ANCOVA i analiza zmian mogą prowadzić do sprzecznych wniosków. Dzieje się tak, bo każda metoda przyjmuje inne założenie o tym, co stałoby się bez programu. Kiedy wybrać którą, omawia wpis o paradoksie Lorda. Logikę różnicy w różnicach i jej założenie o równoległych trendach wyjaśnia wpis o quasi-eksperymencie i DiD. W pracy podaj metodę główną wybraną przed analizą, a drugą – jako analizę wrażliwości.
Zachowanie (poziom 3). Po trzech miesiącach i przy tym samym poziomie wyjściowym uczestnicy szkolenia deklarowali częstsze stosowanie technik o 0.39 punktu, 95% CI [0.18, 0.59], t(104) = 3.74, p < .001, d = 0.65. To samoopis, więc część efektu może wynikać z chęci wypadnięcia dobrze po szkoleniu. Poziomu 4 w tym badaniu nie mierzono.
Jak opisać wyniki ewaluacji w pracy
Zacznij od realizacji programu, potem przejdź do rezultatów w kolejności modelu logicznego. Przy każdym rezultacie podaj metodę, różnicę skorygowaną z przedziałem ufności i wielkość efektu.
Zdania dla innych testów przygotuje generator opisu wyników w stylu APA.
Ewaluacja szkolenia w R: wskaźniki, ANCOVA i różnica w różnicach
Kod w bazowym R z pakietami emmeans (średnie skorygowane) i car (tabela ANCOVA). Tworzy dane, zapisuje je do pliku CSV i liczy wszystkie liczby z przykładu: wskaźniki produktów, utratę uczestników, statystyki opisowe, ANCOVA dla wiedzy, różnicę w różnicach i ANCOVA dla stosowania technik po trzech miesiącach. Kod rysunku 1 to osobny skrypt w ggplot2.
1. Wskaźniki i rezultaty szkolenia
R
# B269 – ewaluacja szkolenia: wskaźniki z modelu logicznego, ANCOVA i różnica w różnicach
# Dane symulowane, set.seed(2693): szkolenie z obsługi trudnych rozmów z klientem
# w oddziale A (grupa szkolenia) i oddział B bez szkolenia w tym kwartale (grupa porównawcza).
# Grupy nie były losowane. Pomiary: przed szkoleniem, tydzień po i 3 miesiące później.
suppressPackageStartupMessages(library(emmeans))
set.seed(2693)
n_s <- 64; n_p <- 60; n <- n_s + n_p
grupa <- factor(rep(c("porównawcza", "szkolenie"), c(n_p, n_s)), levels = c("porównawcza", "szkolenie"))
s <- as.numeric(grupa == "szkolenie")
staz <- round(pmax(0.5, rgamma(n, shape = 2, scale = 2.5)), 1)
# Poziom 2 (uczenie się): test wiedzy 0–20 przed i tydzień po
wiedza_przed <- round(pmin(20, pmax(0, rnorm(n, 10.4 - 0.8 * s + 0.15 * staz, 3))))
wiedza_po <- round(pmin(20, pmax(0, 4.6 + 0.6 * wiedza_przed + 3.0 * s + rnorm(n, 0, 2.4))))
# Poziom 3 (zachowanie): stosowanie technik w pracy, skala 1–5, przed i po 3 miesiącach
stos_przed <- round(pmin(5, pmax(1, rnorm(n, 2.9, 0.6))), 2)
stos_3m <- round(pmin(5, pmax(1, 1.3 + 0.55 * stos_przed + 0.35 * s + rnorm(n, 0, 0.55))), 2)
# Produkty i poziom 1 (reakcje): obecność na 4 sesjach i ocena szkolenia 1–5 (tylko grupa szkolenia)
sesje <- ifelse(s == 1, sample(1:4, n, TRUE, c(.04, .08, .24, .64)), NA)
ocena <- ifelse(s == 1, round(pmin(5, pmax(1, rnorm(n, 4.2, 0.6))), 1), NA)
dane <- data.frame(id = 1:n, grupa, staz, sesje, ocena, wiedza_przed, wiedza_po, stos_przed, stos_3m)
# Utrata uczestników: brak pomiaru tydzień po i po 3 miesiącach
dane$wiedza_po[sample(n, 9)] <- NA
dane$stos_3m[sample(n, 17)] <- NA
write.csv(dane, "../badanie-ewaluacyjne-dane-przyklad.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Krok 1. Wskaźniki produktów i reakcji (grupa szkolenia)
sz <- subset(dane, grupa == "szkolenie")
pelna <- sum(sz$sesje >= 3); c(osoby = nrow(sz), co_najmniej_3_sesje = pelna)
round(100 * binom.test(pelna, nrow(sz))$estimate, 1); round(100 * binom.test(pelna, nrow(sz))$conf.int, 1)
round(c(M_ocena = mean(sz$ocena), SD_ocena = sd(sz$ocena)), 2)

# Krok 2. Utrata uczestników według grupy
aggregate(cbind(brak_po = is.na(wiedza_po), brak_3m = is.na(stos_3m)) ~ grupa, dane, sum)

# Krok 3. Statystyki opisowe M (SD) w obu grupach
opis <- function(x) sprintf("%.2f (%.2f)", mean(x, na.rm = TRUE), sd(x, na.rm = TRUE))
sapply(split(dane[c("wiedza_przed", "wiedza_po", "stos_przed", "stos_3m")], dane$grupa), function(d) sapply(d, opis))

# Krok 4. ANCOVA: wiedza po szkoleniu skorygowana o wiedzę przed
m1 <- lm(wiedza_po ~ wiedza_przed + grupa, data = dane)
round(summary(m1)$coefficients, 3); c(n = nobs(m1), df = m1$df.residual)
round(confint(m1)["grupaszkolenie", ], 2)
car::Anova(m1, type = 2)
em <- as.data.frame(emmeans(m1, ~ grupa)); em[, -1] <- round(em[, -1], 2); em
sd_po <- sqrt(mean(tapply(dane$wiedza_po, dane$grupa, var, na.rm = TRUE)))
round(c(sd_po = sd_po, d = unname(coef(m1)["grupaszkolenie"]) / sd_po), 2)

# Krok 5. Różnica w różnicach na tych samych danych (zmiana przed–po w obu grupach)
dane$zmiana_wiedzy <- dane$wiedza_po - dane$wiedza_przed
m2 <- lm(zmiana_wiedzy ~ grupa, data = dane)
round(tapply(dane$zmiana_wiedzy, dane$grupa, mean, na.rm = TRUE), 2)
round(c(DiD = unname(coef(m2)[2]), confint(m2)[2, ]), 2)
round(summary(m2)$coefficients["grupaszkolenie", ], 3); m2$df.residual

# Krok 6. Poziom 3: stosowanie technik po 3 miesiącach (ANCOVA)
m3 <- lm(stos_3m ~ stos_przed + grupa, data = dane)
round(summary(m3)$coefficients["grupaszkolenie", ], 3)
round(confint(m3)["grupaszkolenie", ], 2)
sd_3m <- sqrt(mean(tapply(dane$stos_3m, dane$grupa, var, na.rm = TRUE)))
round(c(n = nobs(m3), df = m3$df.residual, d = unname(coef(m3)["grupaszkolenie"]) / sd_3m), 2)
Wynik w R
              osoby co_najmniej_3_sesje
                 64                  58
probability of success
                  90.6
[1] 80.7 96.5
attr(,"conf.level")
[1] 0.95
 M_ocena SD_ocena
    4.20     0.49
        grupa brak_po brak_3m
1 porównawcza       7       6
2   szkolenie       2      11
             porównawcza    szkolenie
wiedza_przed "11.43 (3.38)" "10.39 (3.10)"
wiedza_po    "11.58 (2.92)" "13.63 (2.73)"
stos_przed   "2.88 (0.61)"  "2.85 (0.57)"
stos_3m      "2.76 (0.50)"  "3.15 (0.68)"
               Estimate Std. Error t value Pr(>|t|)
(Intercept)       6.571      0.909   7.230        0
wiedza_przed      0.431      0.073   5.945        0
grupaszkolenie    2.626      0.472   5.564        0
  n  df
115 112
 2.5 % 97.5 %
  1.69   3.56
Anova Table (Type II tests)

Response: wiedza_po
             Sum Sq  Df F value    Pr(>F)
wiedza_przed 215.26   1  35.346 3.194e-08 ***
grupa        188.54   1  30.960 1.820e-07 ***
Residuals    682.08 112
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 grupa       emmean   SE  df lower.CL upper.CL
 porównawcza  11.27 0.34 112    10.59    11.95
 szkolenie    13.90 0.32 112    13.27    14.52

Confidence level used: 0.95
sd_po     d
 2.83  0.93
porównawcza   szkolenie
      -0.04        3.35
   DiD  2.5 % 97.5 %
  3.39   2.26   4.53
  Estimate Std. Error    t value   Pr(>|t|)
     3.393      0.572      5.932      0.000
[1] 113
  Estimate Std. Error    t value   Pr(>|t|)
     0.386      0.103      3.739      0.000
 2.5 % 97.5 %
  0.18   0.59
     n     df      d
107.00 104.00   0.65
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek 1 utworzono w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Ograniczenia, które musisz opisać
Ewaluacja bez losowania ma słabsze podstawy do wniosków przyczynowych niż eksperyment. Nie przekreśla to pracy, ale wymaga uczciwego opisu zagrożeń trafności wewnętrznej.
- Dobór do grup. Oddziały, klasy i szkoły różnią się nie tylko programem. Kowariant wyjściowy wyrównuje tylko to, co zmierzono. Wing i in. (2018) zalecają świadomie dobierać grupy porównawcze i sprawdzać wyniki w analizach wrażliwości. Podkreślają też, że różnica w różnicach nie zastępuje w pełni eksperymentu.
- Regresja do średniej. Jeśli do programu kierowano osoby z najsłabszymi wynikami, część poprawy pojawi się bez względu na program.
- Świadomość udziału w badaniu. Uczestnicy, którzy wiedzą, że są oceniani, mogą zmieniać zachowanie (zob. efekt Hawthorne).
- Przenikanie programu. Pracownicy dwóch oddziałów mogą wymieniać się materiałami, co zmniejsza różnicę między grupami.
- Samoopis i jeden prowadzący. Wynik może zależeć od trenera, a nie od programu, więc nie uogólniaj go na inne realizacje.
- Utrata uczestników. Podaj liczbę braków w każdej grupie i sprawdź, czy osoby, które odpadły, różniły się na starcie.
Przy raportowaniu ewaluacji bez losowania pomocna jest lista TREND. Zwraca uwagę na opis teorii programu, warunków interwencji i porównania, schematu badania oraz metod korygowania obciążeń (Des Jarlais i in., 2004). Którą listę wybrać przy innych schematach, wyjaśnia wpis o wytycznych raportowania.
Najczęstsze błędy w ewaluacji w pracy dyplomowej
- Ocena szkolenia zamiast oceny skutków. Ankieta zadowolenia to poziom 1, a nie dowód, że program działa.
- Produkty nazwane rezultatami. Liczba przeszkolonych osób mówi o realizacji, nie o zmianie.
- Brak grupy kontrolnej lub porównawczej i wniosek przyczynowy z samego wzrostu wyniku.
- Dwa osobne testy t (istotny wzrost w jednej grupie, nieistotny w drugiej) zamiast jednego porównania zmian między grupami.
- Wskaźniki dobrane po fakcie, czyli raportowanie tylko tych, które „wyszły”.
- Brak opisu realizacji, przez co nie wiadomo, czy słaby wynik dotyczy programu, czy tego, że prawie nikt nie przyszedł.
Jeśli chcesz, żeby ktoś sprawdził model logiczny, wskaźniki i plan analizy przed zbieraniem danych, możesz skorzystać z oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czym różni się badanie ewaluacyjne od zwykłego badania empirycznego?
Badanie ewaluacyjne ocenia jedno konkretne działanie – program, szkolenie, projekt – w określonym miejscu i czasie, a jego celem jest decyzja: kontynuować, poprawić czy zakończyć. Zwykłe badanie empiryczne szuka ogólnej zależności między zmiennymi. W ewaluacji oprócz rezultatów ocenia się też realizację programu, np. frekwencję i zgodność z planem.
Czy ankieta zadowolenia po szkoleniu wystarczy do oceny jego skuteczności?
Nie. To pierwszy poziom modelu Kirkpatricka (reakcje). Alliger i Janak (1989) podważają założenie, że poziomy łączą się przyczynowo, a metaanaliza Alligera i in. (1997) pokazała, że z uczeniem się i transferem do pracy silniej wiązały się oceny przydatności niż zadowolenie. O skuteczności mówią pomiary wiedzy lub zachowania przed i po, najlepiej z grupą porównawczą.
Co zrobić, jeśli nie mam grupy kontrolnej?
Zastanów się, czy nie da się jej stworzyć: osoby z listy oczekujących, równoległa klasa, inny oddział. Jeśli naprawdę się nie da, opisz badanie jako schemat pretest–posttest, nie formułuj wniosków przyczynowych i omów regresję do średniej oraz efekt ponownego testowania jako ograniczenia.
ANCOVA czy różnica w różnicach – którą analizę wybrać w ewaluacji?
W badaniu z losowaniem zwykle ANCOVA z pomiarem wyjściowym jako kowariantem. Bez losowania, gdy grupy różnią się na starcie, obie metody mogą dać różne wyniki, bo przyjmują inne założenia (Van Breukelen, 2006). Wybierz metodę główną przed analizą, a drugą podaj jako analizę wrażliwości; szczegóły są we wpisie o paradoksie Lorda.
Jakie kryteria ewaluacji wybrać do pracy dyplomowej?
Kryteria OECD DAC to trafność, spójność, skuteczność, efektywność, wpływ i trwałość (OECD, 2019), ale nie trzeba stosować wszystkich. W pracy dyplomowej wybierz 2–3, które da się zmierzyć w czasie badania. Zwykle będą to skuteczność oraz trafność albo jakość realizacji.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikBadanie wiedzy przed i po szkoleniu
Test t i Wilcoxona z d_z, McNemar z korektą Holma, znormalizowany przyrost, test Bowkera i pomiar odroczony – z danymi, kodem R i opisem APA.
Czytaj →Planujesz ewaluację programu albo szkolenia w pracy dyplomowej?
Sprawdzimy model logiczny, wskaźniki, schemat z grupą porównawczą i plan analizy oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Alliger, G. M., & Janak, E. A. (1989). Kirkpatrick's levels of training criteria: Thirty years later. Personnel Psychology, 42(2), 331–342. https://doi.org/10.1111/j.1744-6570.1989.tb00661.x
- Alliger, G. M., Tannenbaum, S. I., Bennett, W., Traver, H., & Shotland, A. (1997). A meta-analysis of the relations among training criteria. Personnel Psychology, 50(2), 341–358. https://doi.org/10.1111/j.1744-6570.1997.tb00911.x
- Bellg, A. J., Borrelli, B., Resnick, B., Hecht, J., Minicucci, D. S., Ory, M., Ogedegbe, G., Orwig, D., Ernst, D., Czajkowski, S., & Treatment Fidelity Workgroup of the NIH Behavior Change Consortium. (2004). Enhancing treatment fidelity in health behavior change studies: Best practices and recommendations from the NIH Behavior Change Consortium. Health Psychology, 23(5), 443–451. https://doi.org/10.1037/0278-6133.23.5.443
- Des Jarlais, D. C., Lyles, C., Crepaz, N., & TREND Group. (2004). Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement. American Journal of Public Health, 94(3), 361–366. https://doi.org/10.2105/ajph.94.3.361 ● Otwarty dostęp: pełny tekst
- Horstman, M. J., & Godwin, K. M. (2025). Methodological progress note: Logic models. Journal of Hospital Medicine, 21(4), 409–412. https://doi.org/10.1002/jhm.70181 ● Otwarty dostęp
- OECD. (2019). Better criteria for better evaluation. OECD Publishing. https://doi.org/10.1787/15a9c26b-en ● Otwarty dostęp
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Wing, C., Simon, K., & Bello-Gomez, R. A. (2018). Designing difference in difference studies: Best practices for public health policy research. Annual Review of Public Health, 39(1), 453–469. https://doi.org/10.1146/annurev-publhealth-040617-013507 ● Otwarty dostęp
Cytowania BibTeX
@article{alliger1989kirkpatrick, author={Alliger, George M. and Janak, Elizabeth A.}, title={{Kirkpatrick's levels of training criteria: Thirty years later}}, journal={Personnel Psychology}, year={1989}, volume={42}, number={2}, pages={331--342}, doi={10.1111/j.1744-6570.1989.tb00661.x}}@article{alliger1997meta, author={Alliger, George M. and Tannenbaum, Scott I. and Bennett, Winston and Traver, Holly and Shotland, Allison}, title={{A meta-analysis of the relations among training criteria}}, journal={Personnel Psychology}, year={1997}, volume={50}, number={2}, pages={341--358}, doi={10.1111/j.1744-6570.1997.tb00911.x}}@article{bellg2004enhancing, author={Bellg, Albert J. and Borrelli, Belinda and Resnick, Barbara and Hecht, Jacki and Minicucci, Daryl Sharp and Ory, Marcia and Ogedegbe, Gbenga and Orwig, Denise and Ernst, Denise and Czajkowski, Susan and {Treatment Fidelity Workgroup of the NIH Behavior Change Consortium}}, title={{Enhancing treatment fidelity in health behavior change studies: Best practices and recommendations from the NIH Behavior Change Consortium}}, journal={Health Psychology}, year={2004}, volume={23}, number={5}, pages={443--451}, doi={10.1037/0278-6133.23.5.443}}@article{desjarlais2004improving, author={Des Jarlais, Don C. and Lyles, Cynthia and Crepaz, Nicole and {TREND Group}}, title={{Improving the reporting quality of nonrandomized evaluations of behavioral and public health interventions: The TREND statement}}, journal={American Journal of Public Health}, year={2004}, volume={94}, number={3}, pages={361--366}, doi={10.2105/ajph.94.3.361}}@article{horstman2025methodological, author={Horstman, Molly J. and Godwin, Kyler M.}, title={{Methodological progress note: Logic models}}, journal={Journal of Hospital Medicine}, year={2025}, volume={21}, number={4}, pages={409--412}, doi={10.1002/jhm.70181}}@techreport{oecd2019better, author={{OECD}}, title={{Better criteria for better evaluation}}, year={2019}, institution={OECD Publishing}, doi={10.1787/15a9c26b-en}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{wing2018designing, author={Wing, Coady and Simon, Kosali and Bello-Gomez, Ricardo A.}, title={{Designing difference in difference studies: Best practices for public health policy research}}, journal={Annual Review of Public Health}, year={2018}, volume={39}, number={1}, pages={453--469}, doi={10.1146/annurev-publhealth-040617-013507}}