Pięć typowych projektów w pracy ze zdrowia publicznego
Prace ze zdrowia publicznego rzadko dotyczą pojedynczego pacjenta. Pytanie brzmi zwykle: jak często coś występuje w populacji, w jakich grupach częściej i czy dwa obszary albo dwa okresy naprawdę się różnią. Odpowiedź daje zazwyczaj jednorazowe badanie ankietowe, czyli schemat przekrojowy, albo analiza danych z rejestrów i statystyki publicznej. Oba źródła mają własne pułapki: częsty wynik, który psuje interpretację ilorazu szans, różną strukturę wieku porównywanych populacji i próbę, która nie odwzorowuje populacji. Tabela porządkuje pięć projektów, które omawiamy dalej.
| Projekt | Typowe pytanie | Dane | Analiza główna | Miara |
|---|---|---|---|---|
| 1. Chorobowość | Jaki odsetek dorosłych pali codziennie? | ankieta w próbie mieszkańców | odsetek z przedziałem Wilsona, porównania grup | % z 95% CI |
| 2. Czynnik a choroba | Czy otyłość wiąże się z nadciśnieniem? | ekspozycja i wynik binarny | tabela 2 × 2, regresja Poissona z odpornym błędem | PR (i OR) |
| 3. Porównanie obszarów | Czy w powiecie A jest więcej hospitalizacji niż w B? | liczby zdarzeń i ludności w grupach wieku | standaryzacja bezpośrednia i pośrednia | współczynnik standaryzowany, SMR |
| 4. Ważenie próby | Czy wynik ankiety odpowiada populacji? | struktura próby i populacji | wagi poststratyfikacyjne | % ważony, efekt ważenia |
| 5. Trend w czasie | Czy zapadalność rośnie? | roczne liczby zachorowań i ludności | regresja Poissona z offsetem | IRR na rok |
Wszystkie dane są symulowane, a liczby pochodzą z kodu R. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem zmiennych). Ten wpis nie powtarza miar z badań klinicznych. Ryzyko bezwzględne, NNT i interpretację wyników badań z randomizacją omawiamy w poradniku statystyka dla lekarza, a Tabelę 1, regresję logistyczną i krzywą ROC w artykule – w poradniku statystyka w publikacji medycznej. Z prac o żywieniu i otyłości korzysta też poradnik statystyka w pracy z dietetyki.
Zanim zaczniesz liczyć: trzy decyzje
Po pierwsze, nazwij schemat i miarę, jaką on daje. Badanie przekrojowe mierzy ekspozycję i wynik w tym samym czasie, więc szacuje chorobowość, a nie zapadalność. Setia (2016) podkreśla, że z jednorazowego pomiaru trudno wnioskować o przyczynowości, bo nie wiadomo, co było pierwsze. Wang i Cheng (2020) dodają, że badania przekrojowe są tanie i dobrze służą opisowi populacji oraz jako wstęp do badań bardziej złożonych. Zapadalność wymaga obserwacji w czasie, np. w badaniu kohortowym albo w danych z rejestru. Iloraz szans ma naturalną interpretację w badaniu kliniczno-kontrolnym, ale w przekrojowym zwykle lepszy jest iloraz chorobowości.
Po drugie, opisz, kogo reprezentuje próba. Ankieta rozesłana w mediach społecznościowych nie jest próbą mieszkańców powiatu. Napisz, jak dobierano osoby, ile z zaproszonych odpowiedziało i czym próba różni się od populacji pod względem płci i wieku. To podstawa oceny reprezentatywności próby i ryzyka błędu braku odpowiedzi.
Po trzecie, zaplanuj raport według listy STROBE. Lista STROBE ma 22 punkty dotyczące tytułu i streszczenia, wstępu, metod, wyników i dyskusji. Osiemnaście z nich jest wspólnych dla badań kohortowych, kliniczno-kontrolnych i przekrojowych (von Elm i in., 2007). Promotor rzadko jej wymaga, ale recenzent artykułu – prawie zawsze.
Projekt 1. Chorobowość w badaniu przekrojowym
Przykład: w losowej próbie 1200 dorosłych mieszkańców powiatu (18–79 lat) zapytano o palenie tytoniu i zmierzono ciśnienie tętnicze. Codziennie paliło 221 osób, czyli 18.4%, 95% CI [16.3, 20.7]. Przedział liczymy metodą Wilsona. Brown i in. (2001) pokazali, że standardowy przedział Walda ma chaotyczne pokrycie znacznie częściej, niż się sądzi, a podręcznikowe reguły jego bezpiecznego stosowania są zawodne. Zalecili m.in. przedział Wilsona. Więcej o wyborze metody piszemy w haśle przedział ufności dla proporcji.
| Grupa | n | Palący codziennie | % | 95% CI |
|---|---|---|---|---|
| Ogółem | 1200 | 221 | 18.4 | [16.3, 20.7] |
| Kobiety | 726 | 114 | 15.7 | [13.2, 18.5] |
| Mężczyźni | 474 | 107 | 22.6 | [19.0, 26.5] |
| 18–39 lat | 540 | 117 | 21.7 | [18.4, 25.3] |
| 40–59 lat | 390 | 66 | 16.9 | [13.5, 21.0] |
| 60–79 lat | 270 | 38 | 14.1 | [10.4, 18.7] |
Zwróć uwagę na szerokość przedziałów. Dla 270 najstarszych osób przedział ma ponad 8 punktów procentowych. W pracy podawaj więc odsetki z przedziałami, a nie same liczby, i nie interpretuj różnicy kilku punktów między małymi podgrupami jako „wyraźnej tendencji”. Ten sam przedział, wyrażony połową szerokości, to margines błędu znany z sondaży. Gdy próbę dobierano warstwowo albo w gronach, np. przez losowanie szkół czy przychodni, przedział jest szerszy, a zwiększenie wariancji opisuje efekt schematu.
Wynik dla nadciśnienia: 290 osób, czyli 24.2%, 95% CI [21.8, 26.7]. Odsetki w grupach porównasz testem chi-kwadrat (zob. test chi-kwadrat krok po kroku). Jeśli jednak pytasz o związek czynnika z chorobą, lepiej od razu policzyć miarę związku z przedziałem ufności. To temat projektu 2.
Projekt 2. Iloraz chorobowości czy iloraz szans?
Pytanie: czy osoby z otyłością częściej mają nadciśnienie? W próbie było 154 osób z otyłością, z czego 74 miało nadciśnienie (48.1%). Wśród 1046 osób bez otyłości nadciśnienie miało 216 (20.7%). Związek jest silny i istotny: χ²(1) = 55.00, p < .001. Jak jednak wyrazić jego siłę?
- Iloraz chorobowości (prevalence ratio, PR) to stosunek odsetków: 48.1% / 20.7% = 2.33, 95% CI [1.90, 2.85]. Czytamy go wprost: nadciśnienie było 2.33 razy częstsze u osób z otyłością. To przekrojowy odpowiednik ryzyka względnego.
- Iloraz szans (odds ratio, OR) porównuje szanse, czyli stosunek liczby osób z chorobą do liczby osób bez niej: OR = 3.55, 95% CI [2.51, 5.04].
Oba wyniki są poprawne, ale opisują co innego. Kłopot zaczyna się, gdy OR = 3.55 ktoś opisuje jako „3.5 razy większe ryzyko”. Bland i Altman (2000) wyjaśniają, że szansa to stosunek prawdopodobieństwa zajścia zdarzenia do prawdopodobieństwa jego niezajścia, a OR jest popularny głównie dzięki regresji logistycznej i badaniom kliniczno-kontrolnym. Davies i in. (1998) pokazali, że OR interpretowany jak ryzyko względne zawsze zawyża efekt. Rozbieżność rośnie z częstością wyniku, a OR dobrze przybliża ryzyko względne tylko wtedy, gdy wynik jest rzadki.
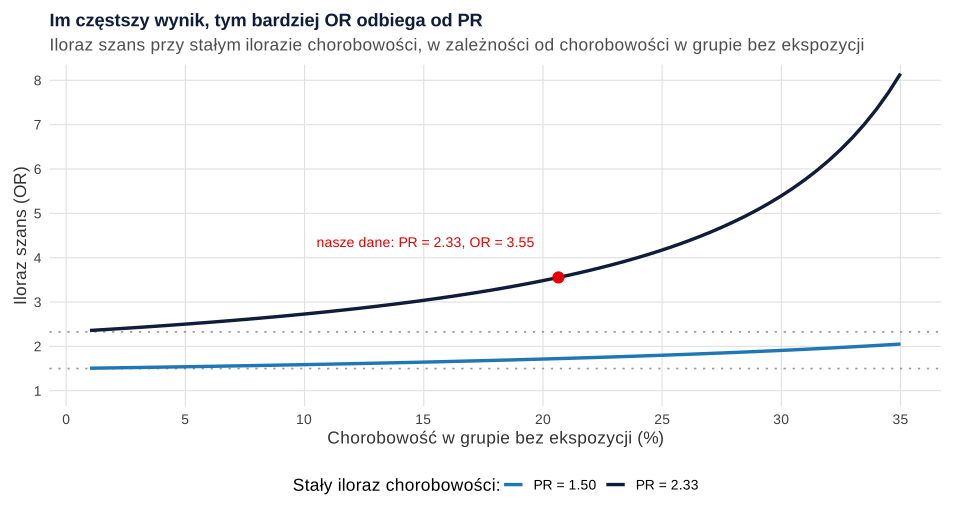
Rysunek pokazuje to na liczbach. Przy PR = 2.33 i chorobowości 1% w grupie bez ekspozycji OR wynosi 2.36, czyli prawie tyle samo. Przy chorobowości 20% wynosi już 3.48, a przy 30% – 5.40. Nadciśnienie, nadwaga czy palenie w populacji dorosłych to wyniki częste, więc w pracach ze zdrowia publicznego ta różnica ma znaczenie praktyczne. Zhang i Yu (1998) zwracają uwagę, że przy częstości wyniku powyżej 10% skorygowany OR z regresji logistycznej przestaje przybliżać ryzyko względne.
Model skorygowany: regresja Poissona z odpornym błędem
Związek otyłości z nadciśnieniem może częściowo wynikać z wieku, bo starsze osoby częściej mają oba stany. Wiek jest tu czynnikiem zakłócającym. Klasycznie wprowadza się go do regresji logistycznej, która daje skorygowany OR. Alternatywą, która daje wprost skorygowany PR, jest regresja Poissona z odpornym (sandwich) estymatorem wariancji. Zou (2004) zaproponował ją do szacowania ryzyka względnego przy wyniku binarnym i pokazał, że działa wiarygodnie nawet przy 100 obserwacjach. Barros i Hirakata (2003) porównali modele dla badań przekrojowych. Regresja Poissona lub Coxa z odpornym błędem i regresja log-dwumianowa dawały poprawne oszacowania PR, a OR z regresji logistycznej mógł go znacznie zawyżać. Wariant bez odpornego błędu wypadł w ich porównaniu najsłabiej pod względem przedziałów ufności, więc nie pomijaj odpornych błędów standardowych.
| Predyktor | OR [95% CI] | PR [95% CI] | p (PR) |
|---|---|---|---|
| Otyłość (tak vs nie) | 2.96 [2.04, 4.31] | 1.86 [1.53, 2.26] | < .001 |
| Wiek (na 10 lat) | 1.60 [1.47, 1.74] | 1.39 [1.31, 1.47] | < .001 |
| Mężczyzna (vs kobieta) | 1.00 [0.75, 1.35] | 1.00 [0.83, 1.21] | .996 |
Po uwzględnieniu wieku i płci nadciśnienie było u osób z otyłością 1.86 razy częstsze. Skorygowany OR wyniósł 2.96 i sugerowałby efekt ponad półtora raza większy. Thompson i in. (1998) zauważają, że przy PR > 1 iloraz szans chorobowości jest zawsze większy od PR, a obie miary mogą prowadzić do różnych wniosków o zakłócaniu i modyfikacji efektu. Jeśli promotor oczekuje regresji logistycznej, podaj OR, ale opisuj go jako iloraz szans, nie ryzyka. Podstawy modelu logistycznego, jego założenia i interpretację omawiamy w poradniku regresja logistyczna krok po kroku.
Jeszcze jedna pułapka. W tabeli z modelu skorygowanego tylko wiersz otyłości odpowiada na pytanie badawcze. Westreich i Greenland (2013) opisali „błąd Tabeli 2”: współczynniki zmiennych zakłócających z tego samego modelu łatwo pomylić z ich efektami całkowitymi, choć nimi nie są. Nie pisz więc, że „płeć nie ma wpływu na nadciśnienie”, tylko dlatego, że w modelu dla otyłości jej PR wyniósł 1.00.
Projekt 3. Standaryzacja względem wieku: porównanie dwóch powiatów
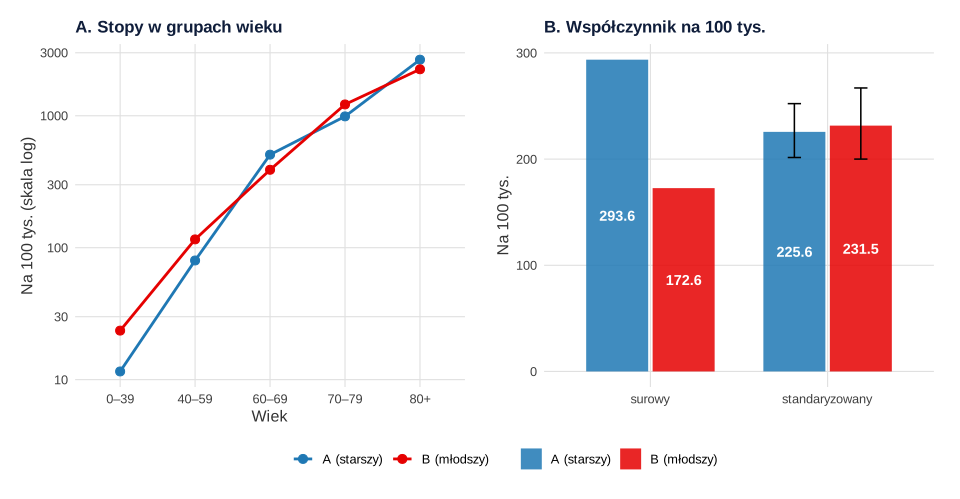
Dwa powiaty różnią się liczbą hospitalizacji z powodu choroby, której częstość silnie rośnie z wiekiem. Powiat A ma starszą populację niż powiat B. Surowy współczynnik hospitalizacji wynosi w A 293.6, a w B 172.6 na 100 tys. mieszkańców. Czy w A „choruje się częściej”? Tego nie wiadomo, dopóki nie uwzględnisz struktury wieku. To zadanie standaryzacji względem wieku.
| Wiek | Ludność A | Hospitalizacje A | Na 100 tys. A | Ludność B | Hospitalizacje B | Na 100 tys. B |
|---|---|---|---|---|---|---|
| 0–39 | 52 000 | 6 | 11.5 | 68 000 | 16 | 23.5 |
| 40–59 | 30 000 | 24 | 80.0 | 32 000 | 37 | 115.6 |
| 60–69 | 14 000 | 71 | 507.1 | 9 500 | 37 | 389.5 |
| 70–79 | 9 000 | 89 | 988.9 | 5 500 | 67 | 1218.2 |
| 80+ | 5 000 | 133 | 2660.0 | 2 000 | 45 | 2250.0 |
Standaryzacja bezpośrednia odpowiada na pytanie: jaki byłby współczynnik w każdym powiecie, gdyby oba miały tę samą strukturę wieku? Stopy z grup wieku mnożysz przez udział tych grup w populacji standardowej i sumujesz. W przykładzie populacją standardową jest suma obu powiatów (udziały: .529, .273, .104, .064, .031). W raportach statystyki publicznej używa się zwykle stałych populacji standardowych. Jeśli porównujesz swoje wyniki z danymi urzędowymi, użyj tej samej populacji standardowej co źródło i podaj ją w metodzie.
Po standaryzacji współczynniki wynoszą 225.6 na 100 tys., 95% CI [201.5, 252.2], w powiecie A i 231.5, 95% CI [200.0, 267.0], w powiecie B. Iloraz surowych współczynników B/A wynosił 0.59, a standaryzowanych – 1.03. Cała „przewaga” powiatu A wynikała ze struktury wieku. Przedziały ufności dla współczynników standaryzowanych policzyliśmy metodą Faya i Feuera (1997). Opiera się ona na rozkładzie gamma i w symulacjach autorów okazała się zachowawcza, podczas gdy inne metody bywały zbyt liberalne. Wąskie grupy wieku z kilkoma zdarzeniami, jak tu najmłodsza, dają niestabilne stopy, więc nie interpretuj ich osobno.
Standaryzacja pośrednia przydaje się, gdy badany obszar jest mały i stopy w grupach wieku są niestabilne. Liczysz oczekiwaną liczbę zdarzeń przy stopach z populacji odniesienia i porównujesz ją z liczbą obserwowaną. Iloraz to standaryzowany współczynnik zachorowalności lub hospitalizacji (SMR, SIR). Gdyby w powiecie B obowiązywały stopy powiatu A, należałoby oczekiwać 189.21 hospitalizacji. Zaobserwowano 202, więc SMR = 1.07, 95% CI [0.93, 1.23]. Przedział obejmuje 1, czyli liczba hospitalizacji w B nie odbiega istotnie od oczekiwanej.
Ten przykład pokazuje też, jak powstaje paradoks Simpsona. W trzech z pięciu grup wieku stopa była wyższa w B, a współczynnik surowy był w B o 41% niższy. Wszystko przez inną strukturę populacji.
Projekt 4. Ważenie próby do struktury populacji
Wróćmy do próby 1200 mieszkańców. Kobiety stanowiły w niej 60.5%, a osoby w wieku 18–39 lat – 45.0%. Przyjmijmy, że w populacji powiatu udziały są inne. W przykładzie użyliśmy wartości ilustracyjnych, a w pracy trzeba je wziąć z oficjalnych danych dla tego obszaru i roku. Jeśli nadciśnienie częściej mają starsi mężczyźni, a jest ich w próbie za mało, odsetek z próby będzie zaniżony. Rozwiązaniem jest ważenie poststratyfikacyjne. Każda osoba dostaje wagę równą udziałowi jej grupy w populacji podzielonemu przez udział tej grupy w próbie.
| Grupa | Udział w populacji | Udział w próbie | Waga |
|---|---|---|---|
| Kobiety 18–39 | .185 | .266 | 0.696 |
| Kobiety 40–59 | .175 | .207 | 0.847 |
| Kobiety 60–79 | .160 | .132 | 1.208 |
| Mężczyźni 18–39 | .180 | .184 | 0.977 |
| Mężczyźni 40–59 | .170 | .118 | 1.437 |
| Mężczyźni 60–79 | .130 | .092 | 1.405 |
Po ważeniu odsetek osób z nadciśnieniem wzrósł z 24.2% do 26.6%, 95% CI [24.1, 29.3]. Odsetek palących się nie zmienił (18.4%), bo palenie słabiej zależy od struktury próby. Ważenie ma swoją cenę: zmniejsza precyzję. Liczebność efektywna Kisha, czyli (Σw)² / Σw², wyniosła 1118 zamiast 1200, a efekt ważenia 1.07. Przy bardziej zróżnicowanych wagach strata jest dużo większa. Przedział z liczebnością efektywną jest przybliżeniem. Pełną analizę wariancji dla prób ważonych i złożonych prowadzi się w wyspecjalizowanym oprogramowaniu do analizy sondaży.
Pamiętaj, że wagi korygują tylko te cechy, według których je zbudowano. Nie naprawią próby, do której trafili wyłącznie ludzie zainteresowani zdrowiem. Dlatego w ograniczeniach opisz sposób rekrutacji i wskaźnik odpowiedzi, a rodzaje badań ankietowych i ich ograniczenia porównujemy w poradniku rodzaje badań ankietowych.
Projekt 5. Trend zapadalności z danych rejestrowych
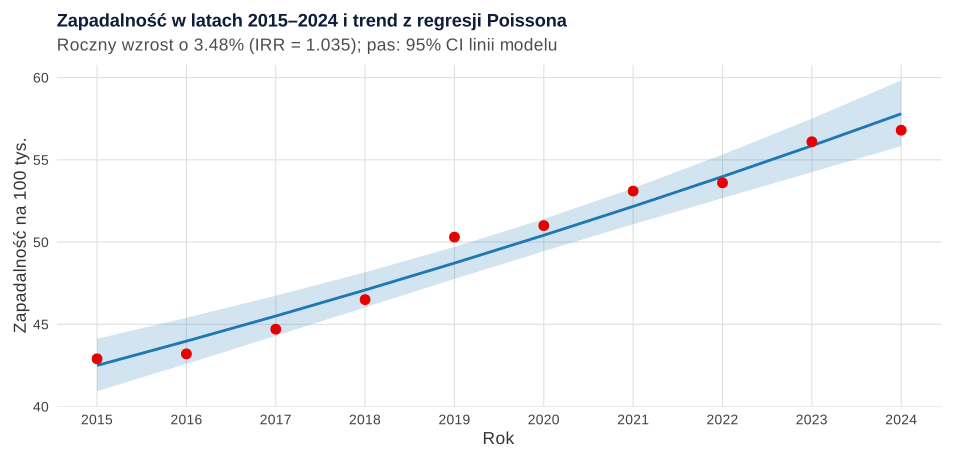
Wiele prac ze zdrowia publicznego korzysta z danych zagregowanych: rocznej liczby zachorowań, zgonów albo hospitalizacji i liczby ludności. Przykład: w województwie liczba nowych zachorowań wzrosła z 900 w 2015 roku do 1161 w 2024 roku, a zapadalność z 42.9 do 56.8 na 100 tys. Czy to trend, czy wahania losowe?
Liczby zdarzeń modeluje się regresją Poissona z offsetem, czyli logarytmem liczby ludności. Wtedy model opisuje współczynnik, a nie surową liczbę zdarzeń. Gardner i in. (1995) pokazują, dlaczego liczebności nie należy analizować zwykłą regresją liniową. Przestrzegają też, że regresja Poissona myli, gdy dane są nadmiernie rozproszone, a wtedy lepszy jest model z nadmiernym rozproszeniem albo regresja ujemna dwumianowa. W przykładzie zapadalność rosła średnio o 3.48% rocznie: iloraz zapadalności (IRR) = 1.035 na rok, 95% CI [1.028, 1.042]. Model przewiduje wzrost z 42.5 do 57.8 na 100 tys. Wskaźnik dyspersji wyniósł 0.33, więc nadmiernego rozproszenia nie było. Gdy przekracza wyraźnie 1, sięgnij po modele z poradnika regresja dla zliczeń: Poisson, ujemna dwumianowa i nadmiar zer.
Dwa zastrzeżenia. Po pierwsze, wzrost zapadalności w rejestrze może wynikać ze zmian w diagnostyce, kodowaniu albo kompletności zgłoszeń, a nie z częstszego występowania choroby. Opisz to w dyskusji. Po drugie, przy danych dla obszarów, np. powiatów, łatwo popełnić błąd ekologiczny. Robinson (1950) pokazał, że korelacje liczone na danych zagregowanych dla obszarów mogą bardzo różnić się od korelacji między cechami osób. Związek „powiaty z większym bezrobociem mają wyższą umieralność” nie mówi, że to osoby bezrobotne umierają częściej. Gdy dane obejmują wiele lat, a struktura wieku się zmienia, licz trend na współczynnikach standaryzowanych albo dodaj wiek do modelu.
Jak opisać wyniki: ściąga
W zdrowiu publicznym wyniki opisuje się przede wszystkim miarami częstości i miarami związku z przedziałami ufności. Wartość p jest dodatkiem. Tabela zbiera zapisy z tego wpisu.
| Pytanie | Miara | Przykład zapisu |
|---|---|---|
| Jak często? | odsetek z 95% CI Wilsona | 18.4%, 95% CI [16.3, 20.7] |
| Czy częściej przy ekspozycji? (przekrojowe) | PR z 95% CI | PR = 1.86, 95% CI [1.53, 2.26] |
| To samo z regresji logistycznej | OR z 95% CI | OR = 2.96, 95% CI [2.04, 4.31] – opis jako iloraz szans |
| Czy obszary się różnią? | współczynnik standaryzowany na 100 tys. | 225.6, 95% CI [201.5, 252.2] |
| Więcej niż oczekiwano? | SMR z 95% CI | SMR = 1.07, 95% CI [0.93, 1.23] |
| Czy rośnie w czasie? | IRR na rok | IRR = 1.035, 95% CI [1.028, 1.042] |
Zapisuj liczby z kropką dziesiętną, a p do trzech miejsc po kropce bez zera wiodącego („p = .002”, „p < .001”). Ilorazy (OR, PR, IRR, SMR) podawaj z zerem wiodącym i dwoma albo trzema miejscami po kropce. Zawsze napisz, czego dotyczy grupa odniesienia. Jeśli chcesz, aby statystyk sprawdził dobór analiz albo pomógł policzyć standaryzację czy model, zajrzyj do oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu. Przepis 1 to pełny przykład analizy badania przekrojowego: od chorobowości z przedziałem Wilsona, przez tabelę 2 × 2, po skorygowany iloraz chorobowości z regresji Poissona z odpornym błędem. Standaryzację i przedział Faya i Feuera liczymy bez dodatkowych pakietów, żeby było widać każdy krok. Ostatni przepis zapisuje plik XLSX do pobrania.
1. Projekty 1 i 2 (pełny przykład): chorobowość, PR i OR
R
# Projekty 1, 2 i 4: badanie przekrojowe dorosłych mieszkańców powiatu (dane symulowane).
# 1200 osób w wieku 18–79 lat; palenie codzienne, nadciśnienie (pomiar w badaniu), otyłość (BMI ≥ 30), płeć, wiek.
# Próba celowo „przechyla się” ku kobietom i osobom młodszym, jak w wielu ankietach – to wykorzystujemy w projekcie 4.
suppressPackageStartupMessages({ library(DescTools); library(sandwich); library(lmtest) })
set.seed(6801)
n <- 1200
plec <- factor(sample(c("kobieta", "mężczyzna"), n, TRUE, prob = c(.60, .40)), levels = c("kobieta", "mężczyzna"))
wiek_gr <- factor(sample(c("18–39", "40–59", "60–79"), n, TRUE, prob = c(.45, .33, .22)), levels = c("18–39", "40–59", "60–79"))
wiek <- round(c(18, 40, 60)[as.integer(wiek_gr)] + runif(n, 0, 19.99))
otylosc <- rbinom(n, 1, plogis(-2.0 + 0.025 * (wiek - 45) + 0.15 * (plec == "mężczyzna")))
palenie <- rbinom(n, 1, plogis(-1.75 + 0.55 * (plec == "mężczyzna") - 0.012 * (wiek - 45)))
p_nadc <- pmin(.95, exp(log(.17) + 0.030 * (wiek - 45) + 0.18 * (plec == "mężczyzna") + log(1.45) * otylosc))
nadcisnienie <- rbinom(n, 1, p_nadc)
d <- data.frame(id = 1:n, plec, wiek, wiek_gr, palenie, otylosc, nadcisnienie)

# Projekt 1: chorobowość (rozpowszechnienie) z 95% CI Wilsona – ogółem, wg płci i grup wieku
k <- sum(d$palenie); k
round(100 * BinomCI(k, n, method = "wilson"), 1)
roz <- function(x) { k <- sum(x); c(n = length(x), k = k, round(100 * BinomCI(k, length(x), method = "wilson"), 1)) }
do.call(rbind, tapply(d$palenie, d$plec, roz))
do.call(rbind, tapply(d$palenie, d$wiek_gr, roz))
round(100 * BinomCI(sum(d$nadcisnienie), n, method = "wilson"), 1)

# Projekt 2: otyłość a nadciśnienie – tabela 2 × 2, iloraz chorobowości (PR) i iloraz szans (OR)
tab <- table(otylosc = factor(d$otylosc, 1:0, c("otyłość", "bez otyłości")), nadcisnienie = factor(d$nadcisnienie, 1:0, c("tak", "nie"))); tab
round(100 * prop.table(tab, 1), 1)
a <- tab[1, 1]; b <- tab[1, 2]; c_ <- tab[2, 1]; dd <- tab[2, 2]
PR <- (a / (a + b)) / (c_ / (c_ + dd)); se_lpr <- sqrt(1 / a - 1 / (a + b) + 1 / c_ - 1 / (c_ + dd))
OR <- (a * dd) / (b * c_); se_lor <- sqrt(1 / a + 1 / b + 1 / c_ + 1 / dd)
round(rbind(PR = c(PR, exp(log(PR) + c(-1, 1) * 1.96 * se_lpr)), OR = c(OR, exp(log(OR) + c(-1, 1) * 1.96 * se_lor))), 2)
chisq.test(tab, correct = FALSE)
# Skorygowane o wiek i płeć: regresja logistyczna (OR) i regresja Poissona z odpornym błędem (PR)
m_log <- glm(nadcisnienie ~ otylosc + I(wiek / 10) + plec, data = d, family = binomial)
round(cbind(OR = exp(coef(m_log)), exp(confint.default(m_log)), p = summary(m_log)$coefficients[, 4]), 3)
m_poi <- glm(nadcisnienie ~ otylosc + I(wiek / 10) + plec, data = d, family = poisson)
ct <- coeftest(m_poi, vcov. = vcovHC(m_poi, type = "HC0"))
round(cbind(PR = exp(ct[, 1]), dolna = exp(ct[, 1] - 1.96 * ct[, 2]), gorna = exp(ct[, 1] + 1.96 * ct[, 2]), p = ct[, 4]), 3)
Wynik w R
[1] 221
      est lwr.ci upr.ci
[1,] 18.4   16.3   20.7
            n   k
kobieta   726 114 15.7 13.2 18.5
mężczyzna 474 107 22.6 19.0 26.5
        n   k
18–39 540 117 21.7 18.4 25.3
40–59 390  66 16.9 13.5 21.0
60–79 270  38 14.1 10.4 18.7
      est lwr.ci upr.ci
[1,] 24.2   21.8   26.7
              nadcisnienie
otylosc        tak nie
  otyłość       74  80
  bez otyłości 216 830
              nadcisnienie
otylosc         tak  nie
  otyłość      48.1 51.9
  bez otyłości 20.7 79.3
   [,1] [,2] [,3]
PR 2.33 1.90 2.85
OR 3.55 2.51 5.04

	Pearson's Chi-squared test

data:  tab
X-squared = 54.999, df = 1, p-value = 1.206e-13

                 OR 2.5 % 97.5 %     p
(Intercept)   0.028 0.017  0.045 0.000
otylosc       2.962 2.035  4.312 0.000
I(wiek/10)    1.600 1.469  1.743 0.000
plecmężczyzna 1.004 0.748  1.347 0.981
                 PR dolna gorna     p
(Intercept)   0.042 0.030 0.059 0.000
otylosc       1.861 1.533 2.260 0.000
I(wiek/10)    1.387 1.312 1.467 0.000
plecmężczyzna 0.999 0.829 1.205 0.996
2. Projekt 4: wagi poststratyfikacyjne
R
# Projekt 4: ważenie poststratyfikacyjne próby z projektu 1 (płeć × grupa wieku).
# Struktura populacji to wartości przykładowe; w pracy weź ją z oficjalnych danych dla Twojego obszaru i roku.
suppressPackageStartupMessages(library(DescTools))
if (!exists("d")) source("b68-1-przekrojowe.R")
pop <- expand.grid(plec = levels(d$plec), wiek_gr = levels(d$wiek_gr))
pop$udzial_pop <- c(.185, .180, .175, .170, .160, .130)          # wartości przykładowe, suma = 1
stopifnot(abs(sum(pop$udzial_pop) - 1) < 1e-9)
prob <- as.data.frame(prop.table(table(plec = d$plec, wiek_gr = d$wiek_gr)), responseName = "udzial_proby")
w <- merge(pop, prob); w$waga <- w$udzial_pop / w$udzial_proby
print(transform(w, udzial_proby = round(udzial_proby, 3), waga = round(waga, 3)))
d$waga <- w$waga[match(paste(d$plec, d$wiek_gr), paste(w$plec, w$wiek_gr))]
round(c(suma_wag = sum(d$waga), min = min(d$waga), max = max(d$waga)), 3)
# Rozpowszechnienie palenia i nadciśnienia: bez wag i z wagami
n_eff <- sum(d$waga)^2 / sum(d$waga^2)
deff <- nrow(d) / n_eff
round(c(n_efektywne = n_eff, efekt_wazenia = deff), 2)
for (v in c("palenie", "nadcisnienie")) {
  pw <- weighted.mean(d[[v]], d$waga)
  ci_w <- BinomCI(round(pw * n_eff), round(n_eff), method = "wilson")   # przybliżony 95% CI z liczebnością efektywną
  cat(v, ": bez wag ", round(100 * mean(d[[v]]), 1), "%, z wagami ", round(100 * pw, 1), "% [",
      round(100 * ci_w[2], 1), ", ", round(100 * ci_w[3], 1), "]\n", sep = "")
}
Wynik w R
       plec wiek_gr udzial_pop udzial_proby  waga
1   kobieta   18–39      0.185        0.266 0.696
2   kobieta   40–59      0.175        0.207 0.847
3   kobieta   60–79      0.160        0.132 1.208
4 mężczyzna   18–39      0.180        0.184 0.977
5 mężczyzna   40–59      0.170        0.118 1.437
6 mężczyzna   60–79      0.130        0.092 1.405
suma_wag      min      max
1200.000    0.696    1.437
  n_efektywne efekt_wazenia
      1118.37          1.07
palenie: bez wag 18.4%, z wagami 18.4% [16.3, 20.8]
nadcisnienie: bez wag 24.2%, z wagami 26.6% [24.1, 29.3]
3. Projekt 3: standaryzacja bezpośrednia i pośrednia
R
# Projekt 3: standaryzacja względem wieku – hospitalizacje z powodu choroby X w dwóch powiatach (dane symulowane).
# Standaryzacja bezpośrednia (populacja standardowa = suma obu powiatów) z 95% CI metodą Faya i Feuera
# oraz standaryzacja pośrednia (SMR) z dokładnym przedziałem Poissona.
set.seed(6803)
wiek <- c("0–39", "40–59", "60–69", "70–79", "80+")
pop_A <- c(52000, 30000, 14000, 9000, 5000)     # powiat A: starszy
pop_B <- c(68000, 32000, 9500, 5500, 2000)      # powiat B: młodszy
stopa_A <- c(2, 12, 45, 110, 240) / 1e4         # „prawdziwe” stopy na osobę
stopa_B <- c(2.2, 14, 52, 125, 270) / 1e4       # w B wyższe w każdej grupie wieku
x_A <- rpois(5, pop_A * stopa_A); x_B <- rpois(5, pop_B * stopa_B)
tab <- data.frame(wiek, pop_A, x_A, stopa_A_100k = round(1e5 * x_A / pop_A, 1), pop_B, x_B, stopa_B_100k = round(1e5 * x_B / pop_B, 1)); tab
# Współczynniki surowe na 100 tys.
surowy <- c(A = 1e5 * sum(x_A) / sum(pop_A), B = 1e5 * sum(x_B) / sum(pop_B)); round(surowy, 1)
# Standaryzacja bezpośrednia; populacja standardowa = suma obu powiatów
std <- pop_A + pop_B; wst <- std / sum(std); round(wst, 3)
fay_feuer <- function(x, n, w, alpha = .05) {          # Fay i Feuer (1997), przedział gamma
  w <- w / sum(w); y <- sum(w * x / n); v <- sum(w^2 * x / n^2); wm <- max(w / n)
  c(stopa = y, dolna = qgamma(alpha / 2, shape = y^2 / v, scale = v / y),
    gorna = qgamma(1 - alpha / 2, shape = (y + wm)^2 / (v + wm^2), scale = (v + wm^2) / (y + wm)))
}
std_A <- fay_feuer(x_A, pop_A, std); std_B <- fay_feuer(x_B, pop_B, std)
round(1e5 * rbind(A = std_A, B = std_B), 1)
round(c(iloraz_surowych = unname(surowy["B"] / surowy["A"]), iloraz_standaryzowanych = unname(std_B[1] / std_A[1])), 2)
# Standaryzacja pośrednia: oczekiwana liczba w B przy stopach powiatu A (SMR)
oczek_B <- sum(pop_B * x_A / pop_A); obs_B <- sum(x_B)
pt <- poisson.test(obs_B, oczek_B)
round(c(obserwowane = obs_B, oczekiwane = oczek_B, SMR = obs_B / oczek_B, dolna = pt$conf.int[1], gorna = pt$conf.int[2]), 2)
Wynik w R
   wiek pop_A x_A stopa_A_100k pop_B x_B stopa_B_100k
1  0–39 52000   6         11.5 68000  16         23.5
2 40–59 30000  24         80.0 32000  37        115.6
3 60–69 14000  71        507.1  9500  37        389.5
4 70–79  9000  89        988.9  5500  67       1218.2
5   80+  5000 133       2660.0  2000  45       2250.0
    A     B
293.6 172.6
[1] 0.529 0.273 0.104 0.064 0.031
  stopa dolna gorna
A 225.6 201.5 252.2
B 231.5 200.0 267.0
        iloraz_surowych iloraz_standaryzowanych
                   0.59                    1.03
obserwowane  oczekiwane         SMR       dolna       gorna
     202.00      189.21        1.07        0.93        1.23
4. Projekt 5: trend zapadalności i plik do pobrania
R
# Projekt 5: trend zapadalności z danych rejestrowych – regresja Poissona z offsetem (dane symulowane).
# Roczna liczba nowych zachorowań i liczba ludności województwa w latach 2015–2024.
suppressPackageStartupMessages(library(openxlsx))
set.seed(6804)
rok <- 2015:2024
ludnosc <- round(2100000 * (1 - 0.003 * (rok - 2015)))
x <- rpois(length(rok), ludnosc * 42e-5 * 1.035^(rok - 2015))
r5 <- data.frame(rok, ludnosc, zachorowania = x, zapadalnosc_100k = round(1e5 * x / ludnosc, 1)); r5
m5 <- glm(zachorowania ~ I(rok - 2015) + offset(log(ludnosc)), data = r5, family = poisson)
round(cbind(IRR = exp(coef(m5)), exp(confint.default(m5))), 4)
round(100 * (exp(coef(m5)[2]) - 1), 2)                 # roczna zmiana w %
round(c(dyspersja = sum(residuals(m5, type = "pearson")^2) / df.residual(m5)), 2)
# Zapadalność przewidywana przez model na 100 tys. (2015 i 2024)
round(1e5 * exp(predict(m5, newdata = data.frame(rok = c(2015, 2024), ludnosc = 1))), 1)

# Plik XLSX z danymi wszystkich projektów (autor w metadanych: Metodolog.pl)
invisible(capture.output({ source("b68-1-przekrojowe.R"); source("b68-2-wazenie.R"); source("b68-3-standaryzacja.R") }))
wb <- createWorkbook(creator = "Metodolog.pl")
for (a in list(list("1-2-4_badanie_przekrojowe", d), list("3_standaryzacja", tab), list("4_struktura_wag", w), list("5_rejestr", r5))) {
  addWorksheet(wb, a[[1]]); writeData(wb, a[[1]], a[[2]])
}
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 6801–6804) – metodolog.pl, wpis „Statystyka w pracy ze zdrowia publicznego”.",
                       "1-2-4_badanie_przekrojowe: palenie, otylosc, nadcisnienie = 1 (tak) / 0 (nie); waga = waga poststratyfikacyjna.",
                       "3_standaryzacja: liczba ludności (pop_) i hospitalizacji (x_) w grupach wieku w dwóch powiatach.",
                       "4_struktura_wag: udział grup w populacji (wartości przykładowe) i w próbie oraz waga.",
                       "5_rejestr: roczna liczba zachorowań i ludności."))
saveWorkbook(wb, "../statystyka-zdrowie-publiczne-dane-przyklad.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-zdrowie-publiczne-dane-przyklad.xlsx"); spr
sapply(spr[1:4], function(a) nrow(readxl::read_excel("../statystyka-zdrowie-publiczne-dane-przyklad.xlsx", sheet = a)))
openxlsx::getCreators(loadWorkbook("../statystyka-zdrowie-publiczne-dane-przyklad.xlsx"))
Wynik w R
    rok ludnosc zachorowania zapadalnosc_100k
1  2015 2100000          900             42.9
2  2016 2093700          905             43.2
3  2017 2087400          933             44.7
4  2018 2081100          968             46.5
5  2019 2074800         1043             50.3
6  2020 2068500         1054             51.0
7  2021 2062200         1094             53.1
8  2022 2055900         1101             53.6
9  2023 2049600         1149             56.1
10 2024 2043300         1161             56.8
                 IRR  2.5 % 97.5 %
(Intercept)   0.0004 0.0004 0.0004
I(rok - 2015) 1.0348 1.0278 1.0418
I(rok - 2015)
         3.48
dyspersja
     0.33
   1    2
42.5 57.8
[1] "1-2-4_badanie_przekrojowe" "3_standaryzacja"           "4_struktura_wag"
[4] "5_rejestr"                 "opis"
1-2-4_badanie_przekrojowe           3_standaryzacja           4_struktura_wag                 5_rejestr
                     1200                         5                         6                        10
[1] "Metodolog.pl"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje chisq.test(), glm(), poisson.test() i qgamma() z pakietów stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w pracach ze zdrowia publicznego
- Iloraz szans opisany jako „ryzyko” przy częstym wyniku. Przy chorobowości kilkunastu procent i więcej OR wyraźnie zawyża PR. Podaj PR albo opisuj OR jako iloraz szans.
- Porównanie surowych współczynników obszarów o różnej strukturze wieku. Standaryzuj albo modeluj wiek.
- „Zapadalność” z badania przekrojowego. Jednorazowa ankieta daje chorobowość.
- Odsetki bez przedziałów ufności, zwłaszcza w małych podgrupach.
- Próba internetowa opisana jako „reprezentatywna” tylko dlatego, że jest duża.
- Interpretowanie współczynników zmiennych kontrolnych z modelu skorygowanego jako ich efektów (Westreich i Greenland, 2013).
- Wnioski o osobach z danych dla obszarów, czyli błąd ekologiczny.
- Regresja liniowa na liczbie zdarzeń zamiast regresji Poissona z offsetem dla liczby ludności.
- Wnioski przyczynowe z badania przekrojowego, np. „otyłość powoduje nadciśnienie”, bez zastrzeżenia o kolejności zdarzeń.
Najczęstsze pytania
Iloraz szans czy iloraz chorobowości w badaniu przekrojowym?
Gdy wynik jest częsty, np. nadciśnienie albo nadwaga u dorosłych, iloraz szans wyraźnie zawyża iloraz chorobowości (PR), a łatwo go błędnie opisać jako „ryzyko”. Wtedy jako główną miarę podaj PR, a model skorygowany policz regresją Poissona z odpornym błędem. Jeśli korzystasz z regresji logistycznej, opisuj OR jako iloraz szans.
Jak policzyć przedział ufności dla chorobowości w pracy?
Użyj przedziału Wilsona, który ma pokrycie bliskie nominalnemu także przy małych próbach i odsetkach bliskich 0 lub 100%. Podaj liczbę przypadków, liczebność grupy, odsetek i 95% CI, np. „18.4%, 95% CI [16.3, 20.7]”. Przy próbie warstwowej, gronowej lub ważonej przedział trzeba poszerzyć o efekt schematu.
Kiedy stosować standaryzację względem wieku?
Zawsze, gdy porównujesz współczynniki (zachorowań, zgonów, hospitalizacji) między obszarami albo latami, a częstość zdarzenia zależy od wieku, a struktura wieku populacji jest różna. Standaryzacja bezpośrednia daje współczynniki przy wspólnej populacji standardowej, a pośrednia – iloraz liczby obserwowanej do oczekiwanej (SMR), przydatny dla małych obszarów.
Czy trzeba ważyć dane z ankiety w pracy ze zdrowia publicznego?
Warto, gdy struktura próby według płci i wieku wyraźnie różni się od populacji, a badana cecha zależy od tych zmiennych. Wagi poststratyfikacyjne korygują tylko cechy, według których je zbudowano, i zmniejszają precyzję, dlatego podaj liczebność efektywną. Nie zastąpią one losowego doboru próby.
Jak sprawdzić, czy zapadalność rośnie z roku na rok?
Zbuduj regresję Poissona dla rocznej liczby przypadków z logarytmem liczby ludności jako offsetem i rokiem jako predyktorem. Wykładnik współczynnika roku to iloraz zapadalności (IRR), np. 1.035 oznacza wzrost o 3.5% rocznie. Sprawdź nadmierne rozproszenie i opisz możliwe zmiany w rejestracji przypadków.
Powiązane hasła
Przeczytaj też
Statystyka dla lekarza
ARR, RR, NNT i NNH z przedziałem ufności, PPV i ilorazy wiarygodności, krzywe Kaplana–Meiera i HR, non-inferiority, pułapki i pierwsze kroki własnego badania.
Czytaj →PoradnikRegresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikStatystyka w pracy z dietetyki
Sposób żywienia, BMI, FFQ a zapis spożycia, interwencja przed i po i błąd pomiaru: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikTest Fagerströma (FTND) – jak policzyć wynik
Sześć pozycji, suma punktów, HSI, braki i rzetelność – z przykładem w R, omegą i wzorem opisu w pracy, bez etykiet uzależnienia.
Czytaj →Piszesz pracę ze zdrowia publicznego i nie wiesz, którą miarę wybrać?
Pomożemy dobrać analizy do Twoich danych, policzyć chorobowość, ilorazy i standaryzację oraz wyjaśnić wyniki tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barros, A. J. D., & Hirakata, V. N. (2003). Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio. BMC Medical Research Methodology, 3(1), Article 21. https://doi.org/10.1186/1471-2288-3-21 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (2000). Statistics notes: The odds ratio. BMJ, 320(7247), 1468. https://doi.org/10.1136/bmj.320.7247.1468 ● Otwarty dostęp: pełny tekst
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Fay, M. P., & Feuer, E. J. (1997). Confidence intervals for directly standardized rates: A method based on the gamma distribution. Statistics in Medicine, 16(7), 791–801. https://doi.org/10.1002/(sici)1097-0258(19970415)16:7<791::aid-sim500>3.0.co;2-#
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
- Setia, M. S. (2016). Methodology series module 3: Cross-sectional studies. Indian Journal of Dermatology, 61(3), 261–264. https://doi.org/10.4103/0019-5154.182410 ● Otwarty dostęp
- Thompson, M. L., Myers, J. E., & Kriebel, D. (1998). Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done? Occupational and Environmental Medicine, 55(4), 272–277. https://doi.org/10.1136/oem.55.4.272 ● Otwarty dostęp
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. PLOS Medicine, 4(10), Article e296. https://doi.org/10.1371/journal.pmed.0040296 ● Otwarty dostęp
- Wang, X., & Cheng, Z. (2020). Cross-sectional studies: Strengths, weaknesses, and recommendations. Chest, 158(1), S65–S71. https://doi.org/10.1016/j.chest.2020.03.012 ● Otwarty dostęp
- Westreich, D., & Greenland, S. (2013). The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients. American Journal of Epidemiology, 177(4), 292–298. https://doi.org/10.1093/aje/kws412 ● Otwarty dostęp
- Zhang, J., & Yu, K. F. (1998). What's the relative risk? JAMA, 280(19), 1690. https://doi.org/10.1001/jama.280.19.1690
- Zou, G. (2004). A modified Poisson regression approach to prospective studies with binary data. American Journal of Epidemiology, 159(7), 702–706. https://doi.org/10.1093/aje/kwh090
Cytowania BibTeX
@article{barros2003alternatives, author={Barros, Aluísio J. D. and Hirakata, Vânia N.}, title={{Alternatives for logistic regression in cross-sectional studies: An empirical comparison of models that directly estimate the prevalence ratio}}, journal={BMC Medical Research Methodology}, year={2003}, volume={3}, number={1}, eid={21}, doi={10.1186/1471-2288-3-21}}@article{bland2000statistics, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: The odds ratio}}, journal={BMJ}, year={2000}, volume={320}, number={7247}, pages={1468}, doi={10.1136/bmj.320.7247.1468}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{fay1997confidence, author={Fay, Michael P. and Feuer, Eric J.}, title={{Confidence intervals for directly standardized rates: A method based on the gamma distribution}}, journal={Statistics in Medicine}, year={1997}, volume={16}, number={7}, pages={791--801}, doi={10.1002/(sici)1097-0258(19970415)16:7<791::aid-sim500>3.0.co;2-#}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{robinson1950ecological, author={Robinson, W. S.}, title={{Ecological correlations and the behavior of individuals}}, journal={American Sociological Review}, year={1950}, volume={15}, number={3}, pages={351--357}, doi={10.2307/2087176}}@article{setia2016methodology, author={Setia, Maninder Singh}, title={{Methodology series module 3: Cross-sectional studies}}, journal={Indian Journal of Dermatology}, year={2016}, volume={61}, number={3}, pages={261--264}, doi={10.4103/0019-5154.182410}}@article{thompson1998prevalence, author={Thompson, M. L. and Myers, J. E. and Kriebel, D.}, title={{Prevalence odds ratio or prevalence ratio in the analysis of cross sectional data: What is to be done?}}, journal={Occupational and Environmental Medicine}, year={1998}, volume={55}, number={4}, pages={272--277}, doi={10.1136/oem.55.4.272}}@article{vonelm2007strengthening, author={von Elm, Erik and Altman, Douglas G. and Egger, Matthias and Pocock, Stuart J. and Gøtzsche, Peter C. and Vandenbroucke, Jan P. and {STROBE Initiative}}, title={{The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e296}, doi={10.1371/journal.pmed.0040296}}@article{wang2020cross, author={Wang, Xiaofeng and Cheng, Zhenshun}, title={{Cross-sectional studies: Strengths, weaknesses, and recommendations}}, journal={Chest}, year={2020}, volume={158}, number={1}, pages={S65--S71}, doi={10.1016/j.chest.2020.03.012}}@article{westreich2013table, author={Westreich, Daniel and Greenland, Sander}, title={{The Table 2 fallacy: Presenting and interpreting confounder and modifier coefficients}}, journal={American Journal of Epidemiology}, year={2013}, volume={177}, number={4}, pages={292--298}, doi={10.1093/aje/kws412}}@article{zhang1998whats, author={Zhang, Jun and Yu, Kai F.}, title={{What's the relative risk?}}, journal={JAMA}, year={1998}, volume={280}, number={19}, pages={1690}, doi={10.1001/jama.280.19.1690}}@article{zou2004modified, author={Zou, Guangyong}, title={{A modified Poisson regression approach to prospective studies with binary data}}, journal={American Journal of Epidemiology}, year={2004}, volume={159}, number={7}, pages={702--706}, doi={10.1093/aje/kwh090}}