Po co lekarzowi statystyka?
Artykuł o nowym leku kończy się zdaniem: „leczenie zmniejszyło ryzyko hospitalizacji o 33%”. Czy to dużo? To zależy od ryzyka, od którego zaczynamy, od tego, ilu pacjentów trzeba leczyć, by jeden uniknął hospitalizacji, i ilu z nich zapłaci za to działaniem niepożądanym. Statystyka dla lekarza to przede wszystkim przekładanie liczb z badań na decyzje: ile zyskuje chory, na ile można ufać wynikowi testu i co naprawdę pokazuje krzywa przeżycia.
W tym poradniku omawiamy miary, które najczęściej pojawiają się w badaniach klinicznych: ryzyko bezwzględne i względne, NNT i NNH, iloraz szans, wartości predykcyjne i ilorazy wiarygodności testów diagnostycznych, krzywe Kaplana–Meiera i iloraz hazardów. Każdą pokazujemy na liczbach policzonych w R. Wszystkie przykłady to dane symulowane – nie dotyczą żadnego rzeczywistego leku ani testu i nie są zaleceniami terapeutycznymi. Na końcu opisujemy trzy częste pułapki i pierwsze kroki przy planowaniu własnego badania. Jak przygotować z badania publikację (wytyczne CONSORT i STROBE, Tabela 1, regresja logistyczna, krzywe ROC), wyjaśniamy w osobnym poradniku statystyka w publikacji medycznej.
Przy każdym wyniku zadawaj trzy pytania: jak duży jest efekt w liczbach bezwzględnych, jak dokładnie go oszacowano (szerokość przedziału ufności) i czy dotyczy pacjentów podobnych do moich. Sama wartość p nie odpowiada na żadne z nich.
Ryzyko bezwzględne i względne: ARR, RR i RRR
Przykład (dane symulowane): w badaniu randomizowanym 1200 pacjentów z chorobą przewlekłą losowo przydzielono do leku X albo placebo, po 600 osób. Pierwszorzędowym punktem końcowym była hospitalizacja w ciągu 12 miesięcy. Wynik zapisuje się w tabeli 2 × 2:
| Grupa | Hospitalizacja | Bez hospitalizacji | Ryzyko w 12 miesięcy |
|---|---|---|---|
| Lek X | 64 | 536 | 10.7% |
| Placebo | 95 | 505 | 15.8% |
Z tych czterech liczb powstają wszystkie podstawowe miary efektu:
RR = ryzykolek / ryzykoplacebo = 0.1067 / 0.1583 = 0.674
RRR = 1 − RR = 0.326
NNT = 1 / ARR = 1 / 0.0517 = 19.4
| Miara | Wartość | 95% CI | Jak ją czytać |
|---|---|---|---|
| ARR – bezwzględna redukcja ryzyka | 5.2 pkt proc. | [1.3, 9.0] | o tyle punktów procentowych mniej hospitalizacji w grupie leku |
| RR – ryzyko względne | 0.67 | [0.50, 0.91] | ryzyko w grupie leku to 67% ryzyka w grupie placebo |
| RRR – względna redukcja ryzyka | 32.6% | [9.4%, 49.9%] | ryzyko mniejsze o mniej więcej jedną trzecią |
| OR – iloraz szans | 0.63 | [0.45, 0.89] | szanse hospitalizacji mniejsze o około 37% |
| NNT – liczba pacjentów, których trzeba leczyć | 19.4 | [11.1, 74.6] | tylu pacjentów trzeba leczyć przez 12 miesięcy, by jeden uniknął hospitalizacji |
Ten sam wynik można więc opisać jako „ryzyko mniejsze o 33%” albo „mniejsze o 5.2 punktu procentowego”. Oba zdania są prawdziwe, ale brzmią zupełnie inaczej. CONSORT 2025 zaleca, by przy binarnym punkcie końcowym podawać zarówno miarę względną, jak i bezwzględną, każdą z przedziałem ufności: żadna z nich osobno nie daje pełnego obrazu, a gdy efekt przedstawia się wyłącznie jako ryzyko względne, zarówno lekarze, jak i pacjenci go przeceniają (Hopewell i in., 2025). Ryzyko względne lepiej przenosi się na inne populacje, a różnica bezwzględna lepiej opisuje korzyść konkretnego chorego, bo zależy od jego ryzyka wyjściowego.
NNT i NNH – zawsze z przedziałem ufności i horyzontem czasowym
NNT (ang. number needed to treat) to liczba pacjentów, których trzeba leczyć przez określony czas, by jeden z nich uniknął zdarzenia. Cook i Sackett (1995) opisują NNT jako odwrotność bezwzględnej redukcji ryzyka i miarę bardziej użyteczną w decyzjach klinicznych niż RR, RRR czy iloraz szans. W przykładzie NNT = 1 / 0.0517 = 19.4, czyli – w zaokrągleniu w górę – 20 pacjentów leczonych przez 12 miesięcy na jedną hospitalizację mniej. Bez horyzontu czasowego ta liczba nic nie znaczy: po dwóch latach leczenia NNT byłoby inne.
Równie ważny jest przedział ufności. Altman (1998) pokazuje, że wystarczy odwrócić granice przedziału dla ARR (i zamienić ich kolejność): ARR = 5.2 punktu procentowego, 95% CI [1.3, 9.0], więc NNT = 19.4, 95% CI [11.1, 74.6]. Dane są zgodne zarówno z dużą korzyścią (jedna hospitalizacja mniej na 11 leczonych), jak i z bardzo skromną (jedna na 75). Gdy przedział dla ARR obejmuje zero, przedział dla NNT „przechodzi przez nieskończoność”. Altman (1998) proponuje wtedy oznaczenia NNTB (liczba leczonych na jedną korzyść) i NNTH (na jedną szkodę) oraz zapis w rodzaju „NNTB 10 (NNTH 20 do ∞ do NNTB 4)” i przypomina, że przedział ufności należy podawać przy każdej wartości NNT.
Szkody liczy się tak samo. Poważne krwawienie wystąpiło u 26 pacjentów (4.3%) w grupie leku i 6 (1.0%) w grupie placebo. Bezwzględny wzrost ryzyka (ARI) wyniósł 3.3 punktu procentowego, 95% CI [1.5, 5.1], a NNH = 30.0, 95% CI [19.4, 65.8]. W liczbach naturalnych: na 1000 pacjentów leczonych przez rok lek zapobiega około 52 hospitalizacjom i powoduje około 33 dodatkowe krwawienia. To zestawienie, a nie samo „RRR = 33%”, jest podstawą rozmowy z pacjentem i decyzji, czy korzyść przeważa nad ryzykiem.
Jeśli opisujesz taki wynik we własnym artykule albo w raporcie, możesz skorzystać z tego wzoru:
Iloraz szans a ryzyko względne – kiedy się rozjeżdżają
W badaniach kliniczno-kontrolnych i w regresji logistycznej zamiast ryzyka względnego dostajesz iloraz szans (OR). W naszym badaniu OR = 0.63, a RR = 0.67 – prawie to samo, bo hospitalizacje były stosunkowo rzadkie. Davies i in. (1998) pokazują jednak, że iloraz szans czytany jak ryzyko względne zawsze wyolbrzymia efekt, a rozbieżność rośnie wraz z częstością zdarzenia. Tabela przedstawia ten sam efekt względny, RR = 0.70, przy różnym ryzyku wyjściowym:
| Ryzyko bez leczenia | Ryzyko z leczeniem | ARR | NNT | RR | OR |
|---|---|---|---|---|---|
| 1% | 0.7% | 0.3 pkt proc. | 333.3 | 0.70 | 0.698 |
| 5% | 3.5% | 1.5 pkt proc. | 66.7 | 0.70 | 0.689 |
| 15% | 10.5% | 4.5 pkt proc. | 22.2 | 0.70 | 0.665 |
| 30% | 21.0% | 9.0 pkt proc. | 11.1 | 0.70 | 0.620 |
| 50% | 35.0% | 15.0 pkt proc. | 6.7 | 0.70 | 0.538 |
Z tabeli płyną dwa wnioski. Po pierwsze, przy częstych zdarzeniach OR = 0.54–0.62 sugeruje dużo silniejszy efekt niż RR = 0.70, dlatego zawsze sprawdzaj, którą miarę podano w artykule. Po drugie, ten sam efekt względny oznacza zupełnie inną korzyść dla pacjentów o różnym ryzyku: NNT wynosi 333 przy ryzyku 1% i niecałe 7 przy ryzyku 50%. Cook i Sackett (1995) wskazują, że jeśli względna redukcja ryzyka jest stała, w ten sposób można przenieść wynik badania na pacjenta o innym ryzyku wyjściowym niż średnie ryzyko w badaniu.
Istotność statystyczna a kliniczna
„Istotny statystycznie” znaczy tylko tyle, że tak duża różnica byłaby mało prawdopodobna, gdyby efekt był zerowy. Nie mówi, czy jest wystarczająco duża, by zmienić leczenie. Man-Son-Hing i in. (2002) krytykują utożsamianie wyników istotnych statystycznie z klinicznie ważnymi i proponują prostą metodę: porównaj oszacowanie efektu i jego przedział ufności z najmniejszą różnicą, która zmieniłaby postępowanie z pacjentem (często nazywaną minimalną klinicznie istotną różnicą, MCID). Poniżej trzy symulowane badania ze skalą objawów 0–100 punktów i MCID ustaloną z góry na 10 punktów:
| Badanie | n w grupie | Różnica [95% CI] | p | Wniosek względem MCID = 10 |
|---|---|---|---|---|
| A | 1500 | 1.32 [0.05, 2.58] | .041 | istotne statystycznie, ale cały przedział leży poniżej MCID – efekt bez znaczenia klinicznego |
| B | 30 | 6.61 [−2.22, 15.44] | .140 | nierozstrzygające: dane są zgodne i z brakiem efektu, i z efektem ważnym klinicznie |
| C | 200 | 14.42 [10.93, 17.92] | < .001 | cały przedział powyżej MCID – efekt istotny statystycznie i klinicznie |
Badanie B pokazuje, dlaczego wynik nieistotny nie dowodzi braku efektu: przy 30 osobach w grupie przedział jest tak szeroki, że obejmuje i zero, i wartości powyżej MCID (zob. moc testu i błąd II rodzaju). Badanie A – że bardzo duża próba czyni istotnym nawet efekt bez znaczenia dla chorego. CONSORT 2025 przypomina, że wyników nie powinno się podawać wyłącznie jako wartości p, a przedziały ufności są szczególnie cenne przy wynikach nieistotnych, bo pokazują, czy nie wykluczono klinicznie ważnej różnicy (Hopewell i in., 2025). Szerzej piszemy o tym w poradnikach wartość p – co naprawdę oznacza i wielkość efektu.
Testy diagnostyczne: czułość, swoistość, PPV i NPV
Przykład (dane symulowane): nowy szybki test wykonano u 1000 pacjentów poradni, a rozpoznanie ustalono standardem referencyjnym. Chorobę miało 200 osób, czyli chorobowość w badanej grupie wynosiła 20%.
| Wynik testu | Choroba obecna | Choroba nieobecna | Razem |
|---|---|---|---|
| Dodatni | 182 (TP) | 140 (FP) | 322 |
| Ujemny | 18 (FN) | 660 (TN) | 678 |
| Razem | 200 | 800 | 1000 |
Czułość, czyli odsetek chorych z wynikiem dodatnim, wynosi 182/200 = 91.0%, 95% CI [86.2%, 94.2%]. Swoistość, czyli odsetek zdrowych z wynikiem ujemnym, to 660/800 = 82.5%, 95% CI [79.7%, 85.0%]. Obie miary opisują sam test, choć i one mogą się różnić między populacjami, np. zależnie od zaawansowania choroby u badanych. Lekarza interesuje jednak pytanie odwrotne: mój pacjent ma wynik dodatni – jakie jest prawdopodobieństwo, że jest chory? Odpowiada na nie wartość predykcyjna dodatnia (PPV): 182/322 = 56.5%, 95% CI [51.1%, 61.8%]. Wartość predykcyjna ujemna (NPV) wynosi 660/678 = 97.3%, 95% CI [95.8%, 98.3%]. Pełny zestaw miar opisuje hasło macierz pomyłek, a wybór punktu odcięcia testów dających wynik liczbowy – hasło krzywa ROC.
Kluczowe jest to, że wartości predykcyjne zależą od chorobowości w grupie, w której wykonano badanie (Deeks i Altman, 2004). Ten sam test w innej populacji:
| Chorobowość | PPV | NPV | Trafne wyniki dodatnie na 1000 badanych | Fałszywie dodatnie na 1000 badanych |
|---|---|---|---|---|
| 1% | 5.0% | 99.9% | 9 | 173 |
| 5% | 21.5% | 99.4% | 46 | 166 |
| 10% | 36.6% | 98.8% | 91 | 158 |
| 20% | 56.5% | 97.3% | 182 | 140 |
| 40% | 77.6% | 93.2% | 364 | 105 |
W badaniu przesiewowym przy chorobowości 1% tylko co dwudziesty wynik dodatni oznacza chorobę: na jedno trafne rozpoznanie przypada 19 fałszywych alarmów. Rysunek 1 pokazuje tę zależność w sposób ciągły.
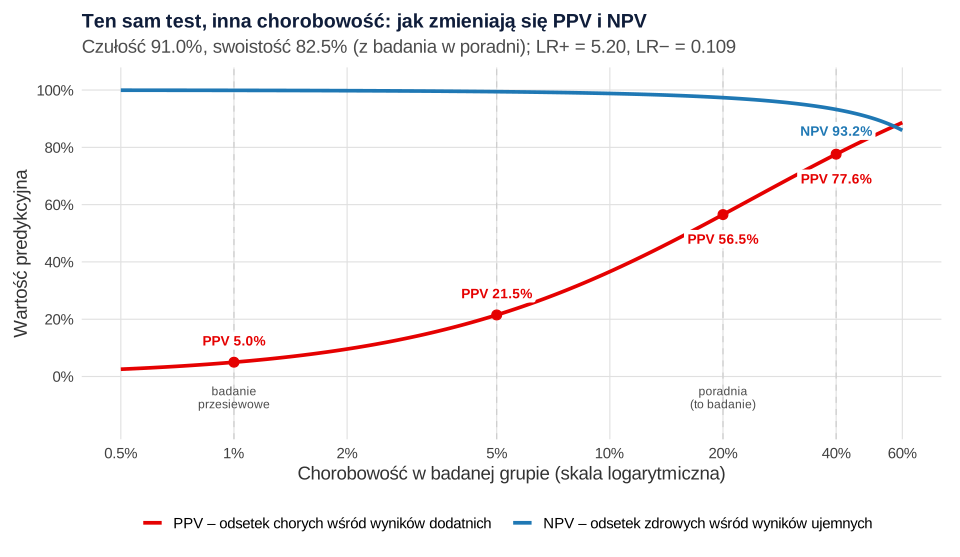
Wniosek praktyczny: PPV i NPV z artykułu przenoś na swoich pacjentów tylko wtedy, gdy chorobowość jest podobna. W przeciwnym razie przelicz je z czułości i swoistości albo skorzystaj z ilorazów wiarygodności.
Ilorazy wiarygodności i prawdopodobieństwo po teście
Iloraz wiarygodności (LR, ang. likelihood ratio) mówi, ile razy bardziej prawdopodobny jest dany wynik testu u osoby chorej niż u zdrowej (Deeks i Altman, 2004). Dla testu z dwoma wynikami:
LR− = (1 − czułość) / swoistość = 0.090 / 0.825 = 0.109
W przykładzie LR+ = 5.20, 95% CI [4.45, 6.08], a LR− = 0.109, 95% CI [0.070, 0.170]. Deeks i Altman (2004) przyjmują, że LR powyżej 10 i poniżej 0.1 w większości sytuacji są silnymi argumentami odpowiednio za rozpoznaniem i przeciw niemu. Nasz test lepiej więc wyklucza chorobę (LR− bliski 0.1), niż ją potwierdza.
LR pozwala przeliczyć prawdopodobieństwo choroby przed testem – oszacowane na podstawie wywiadu, objawów i częstości choroby w danym miejscu – na prawdopodobieństwo po teście. Liczy się to na skali szans: szansę po teście otrzymuje się, mnożąc szansę przed testem przez LR (Deeks i Altman, 2004).
szansa po teście = szansa przed testem × LR
prawdopodobieństwo po teście = szansa po teście / (1 + szansa po teście)
| Prawdopodobieństwo przed testem | Po wyniku dodatnim (LR+ = 5.20) | Po wyniku ujemnym (LR− = 0.109) |
|---|---|---|
| 5% | 21.5% | 0.6% |
| 10% | 36.6% | 1.2% |
| 50% | 83.9% | 9.8% |
Przy prawdopodobieństwie przed testem 10% wynik ujemny obniża je do 1.2%, a dodatni podnosi tylko do 36.6% – sam test nie wystarcza, by potwierdzić chorobę. Przy prawdopodobieństwie 50% nawet po wyniku ujemnym zostaje 9.8%, więc i tu test nie rozstrzyga. Zamiast liczyć, można użyć nomogramu Fagana, który pozwala ominąć przeliczanie szans i prawdopodobieństw (Deeks i Altman, 2004).
Krzywe Kaplana–Meiera i iloraz hazardów (HR)
Gdy punktem końcowym jest czas do zdarzenia (zgonu, nawrotu, hospitalizacji), część pacjentów kończy obserwację bez zdarzenia – bo badanie dobiegło końca albo stracono z nimi kontakt. Takie obserwacje nazywamy uciętymi (cenzurowanymi): wiemy tylko, że do pewnego momentu zdarzenie nie wystąpiło. Kaplan i Meier (1958) zaproponowali nieparametryczny estymator iloczynowy, który wykorzystuje tę częściową informację przy założeniu, że czas do zdarzenia nie zależy od momentu utraty z obserwacji. Podstawy metody opisuje hasło analiza przeżycia.
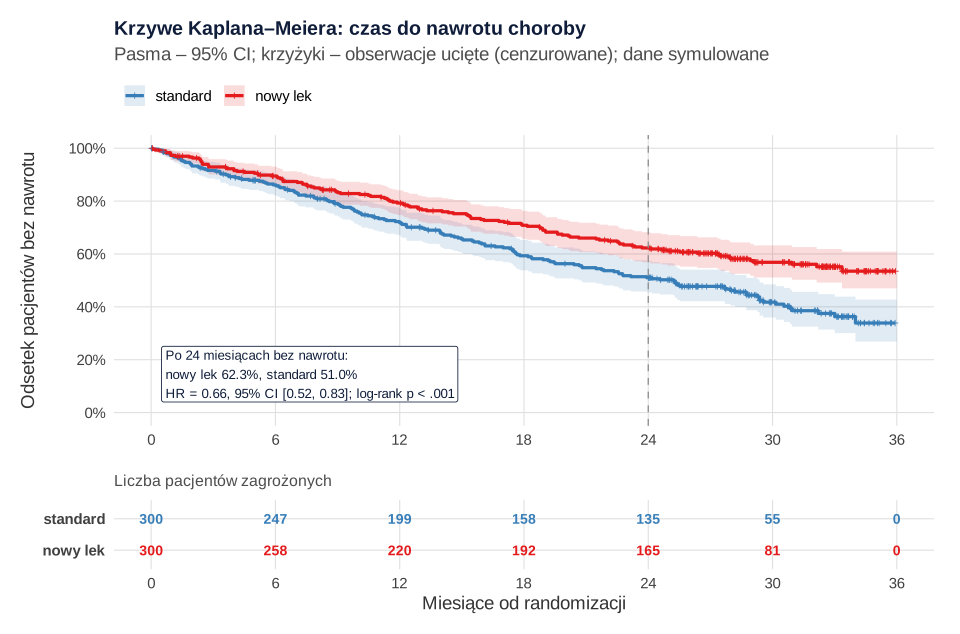
Przykład (dane symulowane): 600 pacjentów losowo przydzielono do nowego leku albo leczenia standardowego i obserwowano maksymalnie przez 24–36 miesięcy (zależnie od daty włączenia do badania). Nawrót choroby wystąpił u 120 z 300 osób w grupie nowego leku i u 162 z 300 w grupie standardowej.
Jak czytać rysunek 2:
- Oś pionowa to odsetek pacjentów bez nawrotu, a każdy schodek to zdarzenie. Po 12 miesiącach bez nawrotu pozostawało 79.3%, 95% CI [74.7%, 84.1%], pacjentów leczonych nowym lekiem i 71.9%, 95% CI [66.9%, 77.3%], leczonych standardowo; po 24 miesiącach – 62.3%, 95% CI [56.8%, 68.2%], i 51.0%, 95% CI [45.4%, 57.3%].
- Mediana czasu do nawrotu w grupie standardowej wyniosła 25.2 miesiąca, 95% CI [20.8, 29.4]. W grupie nowego leku nie została osiągnięta, bo do końca obserwacji krzywa nie spadła poniżej 50%.
- Liczba zagrożonych pod wykresem przypomina, że prawa część krzywych opiera się na coraz mniejszej liczbie osób (po 30 miesiącach – 81 i 55), więc jest mniej pewna. Nie wyciągaj wniosków z „ogona” krzywej.
Test log-rank porównuje całe krzywe: χ²(1) = 12.25, p < .001. Siłę efektu opisuje iloraz hazardów z modelu proporcjonalnych hazardów, który zaproponował Cox (1972): HR = 0.66, 95% CI [0.52, 0.83]. Oznacza to, że w każdym momencie obserwacji chwilowe tempo nawrotów u pacjentów leczonych nowym lekiem było o około jedną trzecią niższe niż u leczonych standardowo – pod warunkiem, że ten stosunek jest stały w czasie. W przykładzie test tego założenia nie wskazał odstępstw (χ²(1) = 0.97, p = .325). W prawdziwych badaniach krzywe bywają jednak przez pierwsze miesiące prawie identyczne, a rozchodzą się dopiero później.
Hernán (2010) przestrzega przed traktowaniem HR jak prostej miary przyczynowej, nawet w badaniu randomizowanym. HR może zmieniać się w czasie, więc pojedyncza wartość jest rodzajem średniej z całego okresu obserwacji i zależy od jego długości, a ponadto ma wbudowane obciążenie selekcją (porównuje w kolejnych momentach tylko osoby, u których zdarzenie jeszcze nie wystąpiło). Dlatego obok HR podawaj różnicę bezwzględną w ustalonym momencie. W przykładzie po 24 miesiącach odsetek pacjentów bez nawrotu był w grupie nowego leku większy o 11.3 punktu procentowego, 95% CI [3.0, 19.5], co odpowiada NNT = 8.9, 95% CI [5.1, 32.9], na 24 miesiące leczenia.
Badania non-inferiority w skrócie
Nie każde badanie ma wykazać przewagę. Badanie non-inferiority („nie gorszy niż”) sprawdza, czy nowe leczenie – np. tańsze, wygodniejsze albo lepiej tolerowane – nie jest niedopuszczalnie gorsze od standardu. Schumi i Wittes (2011) wyjaśniają jego odwróconą logikę: hipoteza zerowa mówi, że nowe leczenie jest gorsze o więcej niż margines −Δ, a hipoteza alternatywna – że różnica jest mniejsza niż ten margines. Margines ustala się przed rozpoczęciem badania.
Przykład (dane symulowane): nowy lek doustny porównano z leczeniem standardowym u 2 × 350 pacjentów. Margines non-inferiority ustalono z góry na −8 punktów procentowych odsetka wyleczeń. Wyleczono 298 pacjentów (85.1%) w grupie nowego leku i 310 (88.6%) w grupie standardowej. Różnica wyniosła −3.4 punktu procentowego, 95% CI [−8.4, 1.6]. Przedział obejmuje zero, więc leki nie różnią się istotnie, ale jego dolna granica (−8.4) leży poniżej marginesu −8. Non-inferiority nie wykazano. To częsty błąd interpretacji: brak istotnej różnicy to nie to samo co wykazanie, że nowe leczenie nie jest gorsze. Wniosek o non-inferiority wymaga, by cały 95% przedział ufności leżał powyżej marginesu, co odpowiada jednostronnemu testowi na poziomie 2.5% (zob. test jednostronny i dwustronny).
Czytając takie badanie, sprawdź, czy margines ustalono przed badaniem i czy jest klinicznie uzasadniony, a także czy wnioski są takie same w analizie wszystkich randomizowanych pacjentów (ITT) i w analizie per protocol. Schumi i Wittes (2011) zwracają uwagę, że im mniej starannie przeprowadzono badanie, tym łatwiej wykazać w nim non-inferiority.
Trzy pułapki: podgrupy, badania obserwacyjne i punkty zastępcze
Analizy podgrup
W badaniu leku X (dane symulowane) prawdziwy efekt był taki sam w obu grupach wieku: RR = 0.70. Mimo to analiza w podgrupach dała obraz, który aż prosi się o nagłówek „lek działa tylko u starszych”. U pacjentów w wieku co najmniej 65 lat RR = 0.57, 95% CI [0.39, 0.85], p = .005, a u młodszych RR = 0.79, 95% CI [0.50, 1.25], p = .315. Właściwe pytanie brzmi jednak: czy efekty w podgrupach różnią się od siebie? Odpowiada na nie test interakcji: iloraz obu RR wynosi 0.72, 95% CI [0.40, 1.31], p = .286. Dane nie dają więc podstaw, by twierdzić, że lek działa inaczej w zależności od wieku.
Tak samo stawia sprawę CONSORT 2025. Przy podgrupach liczy się porównanie efektów między podgrupami (test interakcji z oszacowaniem różnicy i przedziałem ufności), a nie to, czy w którejś z nich wynik jest istotny. Trzeba też podać, które analizy zaplanowano z góry (Hopewell i in., 2025). Brookes i in. (2004) pokazali w symulacjach, że istotny efekt tylko w jednej podgrupie pojawiał się – zależnie od cech badania – w 7–64% symulowanych badań, a badanie z mocą 80% dla efektu ogólnego miało tylko 29% mocy do wykrycia interakcji tej samej wielkości. Nieliczne podgrupy zaplanowane z góry i mające wiarygodne uzasadnienie traktuj jako wskazówkę do dalszych badań. Kilkanaście podgrup bez korekty na wielokrotne porównania to przepis na fałszywy alarm (zob. korekta Bonferroniego).
Wnioski z badań obserwacyjnych
W rejestrach i analizach dokumentacji medycznej leczenie nie jest przydzielane losowo: lekarze przepisują je pacjentom, którzy ich zdaniem najbardziej go potrzebują. W symulowanym rejestrze 3000 pacjentów lek częściej dostawali chorzy z ciężkim przebiegiem choroby, u których zdarzenia były i tak częstsze. Surowe RR = 1.40 sugeruje, że lek szkodzi. Tymczasem w obu warstwach ciężkości przebiegu lek obniżał ryzyko (RR = 0.77 przy przebiegu łagodnym i 0.78 przy ciężkim), a łączne RR Mantela–Haenszela wyniosło 0.78 – blisko prawdziwego efektu wpisanego do symulacji (RR = 0.75). To zakłócanie przez wskazanie (ang. confounding by indication).
Grimes i Schulz (2002) przypominają, że w badaniach obserwacyjnych zawsze w jakimś stopniu działają błąd selekcji, błąd informacji i zakłócanie. Przypadek należy rozważać na końcu, bo te błędy mogą dawać wysoce istotne, lecz pozorne wyniki. W prawdziwych danych nie znasz wszystkich zmiennych zakłócających, więc nawet staranna korekta nie zastąpi randomizacji. Za związkiem przyczynowym przemawiają dopiero m.in. właściwa kolejność w czasie, siła i spójność związku oraz zależność dawka–odpowiedź (Grimes i Schulz, 2002).
Zastępcze punkty końcowe
Zastępczy punkt końcowy, np. wynik badania laboratoryjnego albo obrazowego, mierzy się szybciej i taniej niż zdarzenia ważne dla pacjenta (zgon, zawał, hospitalizację). Poprawa wskaźnika nie musi jednak przekładać się na lepsze rokowanie. Ciani i in. (2013) porównali 84 badania randomizowane z zastępczym i 101 badań z istotnym dla pacjenta pierwszorzędowym punktem końcowym. Te pierwsze raportowały większe efekty leczenia (OR 0.51 a 0.76; iloraz OR 1.47, 95% CI [1.07, 2.01]), czego nie wyjaśniały różnice w ryzyku błędu systematycznego. Czytając badanie, sprawdź więc, co dokładnie było punktem końcowym i czy ma ono znaczenie dla chorego. Pojedyncze badanie rzadko jest ostatnim słowem – wyniki wielu badań łączy metaanaliza.
Własne badanie: od pytania do planu analizy
Jeśli sam planujesz badanie, zacznij od precyzyjnego pytania (populacja, interwencja, porównanie, punkt końcowy i horyzont czasowy) i jednego pierwszorzędowego punktu końcowego. Potem:
- Oszacuj liczebność. Aby z mocą 80% przy α = .05 wykryć spadek ryzyka z 15% do 10.5%, potrzeba 862 pacjentów w każdej grupie, a w praktyce więcej, z zapasem na utratę z obserwacji. Badanie z naszego przykładu, z 600 osobami w grupie, miało dla takiego efektu moc 64.7%, czyli ponad jedną trzecią szans, że prawdziwy efekt zostanie przeoczony. Więcej w poradniku dobór liczebności próby i w haśle analiza mocy a priori.
- Spisz plan analizy przed zebraniem danych: miary efektu, sposób postępowania z brakami danych, zaplanowane podgrupy i analizy wrażliwości. Zarejestruj badanie (prerejestracja), a plan przygotuj według wzoru z poradnika plan analizy statystycznej i prerejestracja.
- Dobierz wytyczne raportowania do schematu badania: CONSORT dla badań randomizowanych, STROBE dla obserwacyjnych, STARD dla badań dokładności diagnostycznej, TRIPOD+AI dla modeli predykcyjnych. Co z nich wynika dla Tabeli 1, regresji logistycznej i krzywych ROC, opisujemy w drugiej części tej serii, poświęconej publikacji medycznej.
- Zaangażuj statystyka na etapie projektu, a nie dopiero po zebraniu danych – błędów w schemacie i liczebności nie da się naprawić analizą. Jeśli potrzebujesz wsparcia przy planie analizy, obliczeniu liczebności albo interpretacji wyników, zajrzyj do oferty analiz statystycznych dla badaczy.
Wiele uwag recenzentów wynika z problemów, których można uniknąć na etapie planowania – ich listę omawiamy w poradniku najczęstsze zarzuty recenzentów do statystyki.
Lista kontrolna: czytając artykuł kliniczny
- Czy podano ryzyko w obu grupach i różnicę bezwzględną z 95% CI, a nie tylko RR, RRR albo OR?
- Czy NNT i NNH mają przedziały ufności i horyzont czasowy?
- Czy przedział ufności wyklucza efekty bez znaczenia klinicznego, czyli mniejsze od MCID?
- Czy wartości predykcyjne pochodzą z populacji o podobnej chorobowości jak Twoi pacjenci?
- Czy obok HR pokazano krzywe Kaplana–Meiera z liczbą zagrożonych i odsetki w ważnych punktach czasu?
- W badaniu non-inferiority: czy margines ustalono z góry i czy cały przedział ufności leży powyżej niego?
- Czy wnioski o podgrupach opierają się na teście interakcji i analizach zaplanowanych z góry?
- Czy w badaniu obserwacyjnym uwzględniono zmienne zakłócające i czy autorzy unikają języka przyczynowego?
- Czy punkt końcowy jest ważny dla pacjenta, czy jest punktem zastępczym?
Przykład w R
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R: przepis 5 korzysta z danych badania z przepisu 1. Poza pakietem survival (przepis 4) wystarczają funkcje podstawowej instalacji R.
1. Badanie randomizowane: ARR, RR, RRR, OR, NNT i NNH
R
# Badanie randomizowane (dane symulowane): lek X a placebo, 600 osób w każdej grupie.
# Punkt końcowy: hospitalizacja w ciągu 12 miesięcy; działanie niepożądane: poważne krwawienie.
set.seed(2026)
n <- 600
grupa  <- factor(rep(c("placebo", "lek"), each = n), levels = c("placebo", "lek"))
wiek65 <- rbinom(2 * n, 1, 0.45)                          # 1 = wiek co najmniej 65 lat
ryzyko0 <- ifelse(wiek65 == 1, 0.20, 0.11)                # ryzyko bez leczenia
hosp <- rbinom(2 * n, 1, ifelse(grupa == "lek", 0.70 * ryzyko0, ryzyko0))  # prawdziwe RR = 0.70
krwawienie <- rbinom(2 * n, 1, ifelse(grupa == "lek", 0.045, 0.020))
rct <- data.frame(grupa, wiek65, hosp, krwawienie)

# Tabela 2 × 2 i ryzyko w grupach
table(rct$grupa, rct$hosp)
a  <- sum(rct$hosp[rct$grupa == "lek"])                   # zdarzenia w grupie leczonej
c0 <- sum(rct$hosp[rct$grupa == "placebo"])               # zdarzenia w grupie placebo
r1 <- a / n; r0 <- c0 / n
round(c(ryzyko_placebo = r0, ryzyko_lek = r1), 4)

# ARR (różnica ryzyka) z 95% CI i NNT = 1 / ARR; granice CI dla NNT to odwrotności granic ARR
arr <- r0 - r1
se_arr <- sqrt(r0 * (1 - r0) / n + r1 * (1 - r1) / n)
ci_arr <- arr + c(-1, 1) * qnorm(0.975) * se_arr
round(c(ARR = arr, dolna = ci_arr[1], gorna = ci_arr[2]), 4)
round(c(NNT = 1 / arr, dolna = 1 / ci_arr[2], gorna = 1 / ci_arr[1]), 1)

# RR i RRR = 1 − RR (przedział liczony na skali logarytmicznej)
rr <- r1 / r0
se_lnrr <- sqrt(1 / a - 1 / n + 1 / c0 - 1 / n)
ci_rr <- exp(log(rr) + c(-1, 1) * qnorm(0.975) * se_lnrr)
round(c(RR = rr, dolna = ci_rr[1], gorna = ci_rr[2]), 3)
round(c(RRR = 1 - rr, dolna = 1 - ci_rr[2], gorna = 1 - ci_rr[1]), 3)

# Iloraz szans (OR) dla tych samych danych
or <- (a / (n - a)) / (c0 / (n - c0))
se_lnor <- sqrt(1 / a + 1 / (n - a) + 1 / c0 + 1 / (n - c0))
ci_or <- exp(log(or) + c(-1, 1) * qnorm(0.975) * se_lnor)
round(c(OR = or, dolna = ci_or[1], gorna = ci_or[2]), 4)

# Szkody: ARI (wzrost ryzyka bezwzględnego) i NNH = 1 / ARI
k1 <- sum(rct$krwawienie[rct$grupa == "lek"]); k0 <- sum(rct$krwawienie[rct$grupa == "placebo"])
ari <- k1 / n - k0 / n
se_ari <- sqrt((k1 / n) * (1 - k1 / n) / n + (k0 / n) * (1 - k0 / n) / n)
ci_ari <- ari + c(-1, 1) * qnorm(0.975) * se_ari
c(krwawienia_lek = k1, krwawienia_placebo = k0)
round(c(ARI = ari, dolna = ci_ari[1], gorna = ci_ari[2]), 4)
round(c(NNH = 1 / ari, dolna = 1 / ci_ari[2], gorna = 1 / ci_ari[1]), 1)

# To samo w liczbach naturalnych: na 1000 leczonych przez 12 miesięcy
round(1000 * c(hospitalizacji_mniej = arr, krwawien_wiecej = ari))
Wynik w R
            0   1
  placebo 505  95
  lek     536  64
ryzyko_placebo     ryzyko_lek
        0.1583         0.1067
   ARR  dolna  gorna
0.0517 0.0134 0.0899
  NNT dolna gorna
 19.4  11.1  74.6
   RR dolna gorna
0.674 0.501 0.906
  RRR dolna gorna
0.326 0.094 0.499
    OR  dolna  gorna
0.6347 0.4520 0.8913
    krwawienia_lek krwawienia_placebo
                26                  6
   ARI  dolna  gorna
0.0333 0.0152 0.0515
  NNH dolna gorna
 30.0  19.4  65.8
hospitalizacji_mniej      krwawien_wiecej
                  52                   33
2. Ten sam RR przy różnym ryzyku wyjściowym i istotność kliniczna
R
# Ten sam efekt względny (RR = 0.70) przy różnym ryzyku wyjściowym: ARR, NNT i OR
p0 <- c(0.01, 0.05, 0.15, 0.30, 0.50)                     # ryzyko w grupie kontrolnej
p1 <- 0.70 * p0                                           # ryzyko w grupie leczonej
data.frame(ryzyko_kontrola = p0, ryzyko_leczeni = p1,
           ARR_pp = round(100 * (p0 - p1), 1),
           NNT    = round(1 / (p0 - p1), 1),
           RR     = 0.70,
           OR     = round((p1 / (1 - p1)) / (p0 / (1 - p0)), 3))

# Istotność statystyczna a kliniczna: trzy symulowane badania, wynik w skali objawów 0–100,
# minimalna klinicznie istotna różnica (MCID) ustalona z góry na 10 punktów
set.seed(314)
badanie <- function(n, roznica, sd = 18) {
  kontrola <- rnorm(n, 50, sd)
  leczeni  <- rnorm(n, 50 - roznica, sd)                  # niższy wynik = mniej objawów
  t <- t.test(kontrola, leczeni, var.equal = TRUE)
  c(n_w_grupie = n, roznica = unname(t$estimate[1] - t$estimate[2]),
    dolna = t$conf.int[1], gorna = t$conf.int[2], p = t$p.value)
}
w <- rbind(A = badanie(1500, 3), B = badanie(30, 10), C = badanie(200, 14))
cbind(round(w[, 1:4], 2), p = round(w[, "p"], 3))
Wynik w R
  ryzyko_kontrola ryzyko_leczeni ARR_pp   NNT  RR    OR
1            0.01          0.007    0.3 333.3 0.7 0.698
2            0.05          0.035    1.5  66.7 0.7 0.689
3            0.15          0.105    4.5  22.2 0.7 0.665
4            0.30          0.210    9.0  11.1 0.7 0.620
5            0.50          0.350   15.0   6.7 0.7 0.538
  n_w_grupie roznica dolna gorna     p
A       1500    1.32  0.05  2.58 0.041
B         30    6.61 -2.22 15.44 0.140
C        200   14.42 10.93 17.92 0.000
3. Test diagnostyczny: czułość, swoistość, PPV, NPV i ilorazy wiarygodności
R
# Badanie dokładności diagnostycznej (dane symulowane): szybki test a standard referencyjny,
# 1000 pacjentów poradni, w tym 200 z chorobą (chorobowość 20%)
set.seed(77)
chorzy <- 200; zdrowi <- 800
TP <- rbinom(1, chorzy, 0.90); FN <- chorzy - TP          # prawdziwa czułość 90%
TN <- rbinom(1, zdrowi, 0.85); FP <- zdrowi - TN          # prawdziwa swoistość 85%
matrix(c(TP, FN, FP, TN), 2, dimnames = list(Test = c("dodatni", "ujemny"), Choroba = c("tak", "nie")))

# Czułość i swoistość z 95% CI (Wilsona)
ci <- function(x, n) prop.test(x, n, correct = FALSE)$conf.int
wynik <- rbind(czulosc   = c(TP / chorzy, ci(TP, chorzy)),
               swoistosc = c(TN / zdrowi, ci(TN, zdrowi)),
               PPV       = c(TP / (TP + FP), ci(TP, TP + FP)),
               NPV       = c(TN / (TN + FN), ci(TN, TN + FN)))
colnames(wynik) <- c("wartosc", "dolna", "gorna")
round(wynik, 3)

# Ilorazy wiarygodności z 95% CI (na skali logarytmicznej)
se <- TP / chorzy; sp <- TN / zdrowi
lr_plus  <- se / (1 - sp); s_plus  <- sqrt(1 / TP - 1 / chorzy + 1 / FP - 1 / zdrowi)
lr_minus <- (1 - se) / sp; s_minus <- sqrt(1 / FN - 1 / chorzy + 1 / TN - 1 / zdrowi)
lr <- rbind(LR_plus  = lr_plus  * exp(c(0, -1.96, 1.96) * s_plus),
            LR_minus = lr_minus * exp(c(0, -1.96, 1.96) * s_minus))
colnames(lr) <- c("wartosc", "dolna", "gorna")
round(lr, 3)

# PPV i NPV tego samego testu przy innej chorobowości
chorobowosc <- c(0.01, 0.05, 0.10, 0.20, 0.40)
ppv <- se * chorobowosc / (se * chorobowosc + (1 - sp) * (1 - chorobowosc))
npv <- sp * (1 - chorobowosc) / (sp * (1 - chorobowosc) + (1 - se) * chorobowosc)
round(data.frame(chorobowosc, PPV = ppv, NPV = npv, falszywe_alarmy_na_1_trafienie = (1 - ppv) / ppv), 3)
# Liczby naturalne: wyniki dodatnie na 1000 zbadanych osób
data.frame(chorobowosc, trafne_dodatnie = round(1000 * chorobowosc * se), falszywe_dodatnie = round(1000 * (1 - chorobowosc) * (1 - sp)))

# Prawdopodobieństwo po teście = szansa przed testem × LR, przeliczona z powrotem na prawdopodobieństwo
po_tescie <- function(przed, lr) { s <- przed / (1 - przed) * lr; s / (1 + s) }
po <- rbind(wynik_dodatni = po_tescie(c(0.05, 0.10, 0.50), lr_plus),
            wynik_ujemny  = po_tescie(c(0.05, 0.10, 0.50), lr_minus))
colnames(po) <- c("przed_5%", "przed_10%", "przed_50%")
round(po, 3)
Wynik w R
         Choroba
Test      tak nie
  dodatni 182 140
  ujemny   18 660
          wartosc dolna gorna
czulosc     0.910 0.862 0.942
swoistosc   0.825 0.797 0.850
PPV         0.565 0.511 0.618
NPV         0.973 0.958 0.983
         wartosc dolna gorna
LR_plus    5.200 4.446 6.082
LR_minus   0.109 0.070 0.170
  chorobowosc   PPV   NPV falszywe_alarmy_na_1_trafienie
1        0.01 0.050 0.999                         19.038
2        0.05 0.215 0.994                          3.654
3        0.10 0.366 0.988                          1.731
4        0.20 0.565 0.973                          0.769
5        0.40 0.776 0.932                          0.288
  chorobowosc trafne_dodatnie falszywe_dodatnie
1        0.01               9               173
2        0.05              46               166
3        0.10              91               158
4        0.20             182               140
5        0.40             364               105
              przed_5% przed_10% przed_50%
wynik_dodatni    0.215     0.366     0.839
wynik_ujemny     0.006     0.012     0.098
4. Krzywe Kaplana–Meiera, test log-rank i iloraz hazardów
R
# Czas do nawrotu choroby (dane symulowane): 2 × 300 pacjentów, rekrutacja przez 12 miesięcy,
# koniec obserwacji po 36 miesiącach od startu badania, część osób traci kontakt z ośrodkiem
library(survival)
set.seed(36)
n <- 300
leczenie <- factor(rep(c("standard", "nowy lek"), each = n), levels = c("standard", "nowy lek"))
hazard   <- ifelse(leczenie == "nowy lek", 0.70 * 0.025, 0.025)       # prawdziwe HR = 0.70
t_zdarzenia <- rexp(2 * n, hazard)                                    # miesiące do nawrotu
t_utraty    <- rexp(2 * n, 0.006)                                     # utrata z obserwacji
t_konca     <- 36 - runif(2 * n, 0, 12)                               # obserwacja do końca badania
czas  <- pmin(t_zdarzenia, t_utraty, t_konca)
nawrot <- as.integer(t_zdarzenia <= pmin(t_utraty, t_konca))          # 0 = obserwacja ucięta
km <- data.frame(leczenie, czas, nawrot)
table(km$leczenie, km$nawrot)

# Estymator Kaplana–Meiera: odsetek bez nawrotu po 12 i 24 miesiącach (95% CI) oraz mediana
fit <- survfit(Surv(czas, nawrot) ~ leczenie, data = km)
s <- summary(fit, times = c(12, 24))
data.frame(grupa = s$strata, miesiac = s$time, zagrozeni = s$n.risk, bez_nawrotu = round(s$surv, 3),
           dolna = round(s$lower, 3), gorna = round(s$upper, 3))
print(fit)                                                            # mediany czasu do nawrotu

# Test log-rank i model proporcjonalnych hazardów Coxa
logrank <- survdiff(Surv(czas, nawrot) ~ leczenie, data = km)
logrank
round(c(chi2 = logrank$chisq, p = pchisq(logrank$chisq, 1, lower.tail = FALSE)), 5)
cox <- coxph(Surv(czas, nawrot) ~ leczenie, data = km)
round(summary(cox)$conf.int, 3)                                       # HR z 95% CI
round(cox.zph(cox)$table, 3)                                          # założenie proporcjonalnych hazardów

# Różnica bezwzględna po 24 miesiącach i NNT na 24 miesiące
s24 <- summary(fit, times = 24)
roznica <- s24$surv[2] - s24$surv[1]
se_r <- sqrt(s24$std.err[1]^2 + s24$std.err[2]^2)
ci_r <- roznica + c(-1, 1) * 1.96 * se_r
round(c(roznica = roznica, dolna = ci_r[1], gorna = ci_r[2]), 3)
round(c(NNT_24 = 1 / roznica, dolna = 1 / ci_r[2], gorna = 1 / ci_r[1]), 1)
Wynik w R
             0   1
  standard 138 162
  nowy lek 180 120
              grupa miesiac zagrozeni bez_nawrotu dolna gorna
1 leczenie=standard      12       199       0.719 0.669 0.773
2 leczenie=standard      24       135       0.510 0.454 0.573
3 leczenie=nowy lek      12       220       0.793 0.747 0.841
4 leczenie=nowy lek      24       165       0.623 0.568 0.682
Call: survfit(formula = Surv(czas, nawrot) ~ leczenie, data = km)

                    n events median 0.95LCL 0.95UCL
leczenie=standard 300    162   25.2    20.8    29.4
leczenie=nowy lek 300    120     NA    32.1      NA
Call:
survdiff(formula = Surv(czas, nawrot) ~ leczenie, data = km)

                    N Observed Expected (O-E)^2/E (O-E)^2/V
leczenie=standard 300      162      133      6.47      12.3
leczenie=nowy lek 300      120      149      5.75      12.3

 Chisq= 12.3  on 1 degrees of freedom, p= 5e-04
    chi2        p
12.25249  0.00046
                 exp(coef) exp(-coef) lower .95 upper .95
leczenienowy lek     0.658       1.52     0.519     0.833
         chisq df     p
leczenie 0.968  1 0.325
GLOBAL   0.968  1 0.325
roznica   dolna   gorna
  0.113   0.030   0.195
NNT_24  dolna  gorna
   8.9    5.1   32.9
5. Podgrupy, non-inferiority, zakłócanie przez wskazanie i liczebność
R
# 1. Analiza podgrup w badaniu z przepisu 1 (ramka rct): prawdziwe RR = 0.70 w obu podgrupach wieku
rr_podgrupa <- function(d) {
  x1 <- sum(d$hosp[d$grupa == "lek"]); n1 <- sum(d$grupa == "lek")
  x0 <- sum(d$hosp[d$grupa == "placebo"]); n0 <- sum(d$grupa == "placebo")
  se <- sqrt(1 / x1 - 1 / n1 + 1 / x0 - 1 / n0)
  c(RR = (x1 / n1) / (x0 / n0), lnRR = log((x1 / n1) / (x0 / n0)), se = se)
}
m <- rr_podgrupa(subset(rct, wiek65 == 0)); s <- rr_podgrupa(subset(rct, wiek65 == 1))
wyniki <- rbind(ponizej_65 = m, od_65 = s)
round(cbind(RR = wyniki[, "RR"], dolna = exp(wyniki[, "lnRR"] - 1.96 * wyniki[, "se"]),
            gorna = exp(wyniki[, "lnRR"] + 1.96 * wyniki[, "se"]),
            p = 2 * pnorm(-abs(wyniki[, "lnRR"] / wyniki[, "se"]))), 3)
# Test interakcji: iloraz RR (od 65 / poniżej 65) z 95% CI
d_ln <- unname(s["lnRR"] - m["lnRR"]); se_d <- unname(sqrt(s["se"]^2 + m["se"]^2))
round(c(iloraz_RR = exp(d_ln), dolna = exp(d_ln - 1.96 * se_d), gorna = exp(d_ln + 1.96 * se_d),
        p = 2 * pnorm(-abs(d_ln / se_d))), 3)

# 2. Badanie non-inferiority (dane symulowane): nowy lek doustny a standard, odsetek wyleczeń,
# margines non-inferiority ustalony z góry: −8 punktów procentowych
set.seed(808)
nn <- 350
wyl_nowy <- rbinom(1, nn, 0.85); wyl_std <- rbinom(1, nn, 0.86)
p_n <- wyl_nowy / nn; p_s <- wyl_std / nn
c(wyleczeni_nowy = wyl_nowy, wyleczeni_standard = wyl_std)
se_ni <- sqrt(p_n * (1 - p_n) / nn + p_s * (1 - p_s) / nn)
round(100 * c(nowy = p_n, standard = p_s, roznica = p_n - p_s,
              dolna = p_n - p_s - 1.96 * se_ni, gorna = p_n - p_s + 1.96 * se_ni), 1)

# 3. Rejestr obserwacyjny (dane symulowane): lek częściej dostają pacjenci z ciężkim przebiegiem
set.seed(99)
N <- 3000
ciezki <- rbinom(N, 1, 0.40)
lek    <- rbinom(N, 1, ifelse(ciezki == 1, 0.70, 0.25))
zdarz  <- rbinom(N, 1, ifelse(ciezki == 1, 0.30, 0.08) * ifelse(lek == 1, 0.75, 1))  # lek obniża ryzyko o 25%
ryzyko_wzgl <- function(z, l) mean(z[l == 1]) / mean(z[l == 0])
round(c(RR_surowe = ryzyko_wzgl(zdarz, lek),
        RR_lagodny = ryzyko_wzgl(zdarz[ciezki == 0], lek[ciezki == 0]),
        RR_ciezki = ryzyko_wzgl(zdarz[ciezki == 1], lek[ciezki == 1])), 3)
# RR Mantela–Haenszela (łączny dla warstw ciężkości)
mh <- sapply(0:1, function(k) {
  z <- zdarz[ciezki == k]; l <- lek[ciezki == k]; Nk <- length(z)
  c(licznik = sum(z[l == 1]) * sum(l == 0) / Nk, mianownik = sum(z[l == 0]) * sum(l == 1) / Nk)
})
round(sum(mh["licznik", ]) / sum(mh["mianownik", ]), 3)

# 4. Własne badanie: liczebność dla różnicy 15% a 10.5% (moc 80%, alfa = .05, test dwustronny)
power.prop.test(p1 = 0.15, p2 = 0.105, power = 0.80, sig.level = 0.05)
round(power.prop.test(n = 600, p1 = 0.15, p2 = 0.105, sig.level = 0.05)$power, 3)   # moc badania z przepisu 1
Wynik w R
              RR dolna gorna     p
ponizej_65 0.793 0.504 1.247 0.315
od_65      0.573 0.388 0.846 0.005
iloraz_RR     dolna     gorna         p
    0.722     0.398     1.313     0.286
    wyleczeni_nowy wyleczeni_standard
               298                310
    nowy standard  roznica    dolna    gorna
    85.1     88.6     -3.4     -8.4      1.6
 RR_surowe RR_lagodny  RR_ciezki
     1.399      0.768      0.782
[1] 0.778

     Two-sample comparison of proportions power calculation

              n = 861.1794
             p1 = 0.15
             p2 = 0.105
      sig.level = 0.05
          power = 0.8
    alternative = two.sided

NOTE: n is number in *each* group

[1] 0.647
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; analizę przeżycia wykonano w pakiecie survival, a rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Jak obliczyć NNT i jego przedział ufności?
NNT to odwrotność bezwzględnej redukcji ryzyka (ARR). Przy ryzyku 15.8% w grupie placebo i 10.7% w grupie leczonej ARR = 5.2 punktu procentowego, więc NNT = 1 / 0.0517 = 19.4 – tylu pacjentów trzeba leczyć przez 12 miesięcy, by jeden uniknął zdarzenia. Przedział ufności dla NNT to odwrotności granic przedziału dla ARR, tu od 11.1 do 74.6 (Altman, 1998). Zawsze podawaj horyzont czasowy.
Czym różni się redukcja ryzyka względnego od bezwzględnego?
Względna redukcja ryzyka (RRR) mówi, o jaki odsetek spada ryzyko w porównaniu z grupą kontrolną, a bezwzględna (ARR) – o ile punktów procentowych. Ta sama RRR = 30% oznacza ARR = 0.3 punktu procentowego przy ryzyku wyjściowym 1% i 15 punktów przy ryzyku 50%. CONSORT 2025 zaleca podawanie obu miar z przedziałami ufności, bo samo ryzyko względne prowadzi do przeceniania efektu (Hopewell i in., 2025).
Dlaczego dodatni wynik testu nie oznacza, że pacjent jest chory?
Bo prawdopodobieństwo choroby po dodatnim wyniku, czyli wartość predykcyjna dodatnia (PPV), zależy nie tylko od czułości i swoistości testu, ale też od częstości choroby w badanej grupie. Test o czułości 91.0% i swoistości 82.5% ma w poradni z chorobowością 20% PPV = 56.5%, a w badaniu przesiewowym z chorobowością 1% – tylko 5.0%. Na jedno trafne rozpoznanie przypada wtedy 19 fałszywych alarmów.
Jak policzyć prawdopodobieństwo choroby po wyniku testu?
Zamień prawdopodobieństwo przed testem na szansę, p / (1 − p), pomnóż ją przez iloraz wiarygodności wyniku (LR+ dla dodatniego, LR− dla ujemnego) i przelicz z powrotem: szansa / (1 + szansa). Przy prawdopodobieństwie przed testem 10% i LR+ = 5.20 wychodzi 36.6%, a po wyniku ujemnym (LR− = 0.109) – 1.2% (Deeks i Altman, 2004).
Co oznacza HR = 0.66 w badaniu klinicznym?
Iloraz hazardów 0.66 oznacza, że chwilowe tempo zdarzeń w grupie leczonej było przez cały okres obserwacji o około jedną trzecią niższe niż w grupie kontrolnej – przy założeniu proporcjonalnych hazardów. HR to nie ryzyko względne ani skrócenie czasu do zdarzenia. Obok niego podaj odsetek pacjentów bez zdarzenia w ustalonym czasie z krzywych Kaplana–Meiera, np. 62.3% a 51.0% po 24 miesiącach.
Co to jest badanie non-inferiority?
To badanie, które ma wykazać, że nowe leczenie nie jest gorsze od standardowego o więcej niż ustalony z góry margines, np. 8 punktów procentowych odsetka wyleczeń. Wniosek o non-inferiority wymaga, by cały przedział ufności różnicy leżał powyżej marginesu – brak istotnej różnicy nie wystarcza. Im mniej starannie przeprowadzone badanie, tym łatwiej o fałszywy wniosek o non-inferiority (Schumi i Wittes, 2011).
Powiązane hasła
Przeczytaj też
Statystyka w publikacji medycznej
STROBE, CONSORT 2025, STARD i TRIPOD+AI, sekcja Statistical analysis (PL/EN), Tabela 1 z SMD, regresja logistyczna, ROC, kalibracja i walidacja.
Czytaj →PoradnikWielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Planujesz badanie kliniczne albo musisz zinterpretować jego wyniki?
Pomożemy obliczyć liczebność, przygotować plan analizy, wykonać obliczenia i wyjaśnić wyniki tak, by każdą liczbę w artykule umieć uzasadnić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G. (1998). Confidence intervals for the number needed to treat. BMJ, 317(7168), 1309–1312. https://doi.org/10.1136/bmj.317.7168.1309 ● Otwarty dostęp: pełny tekst
- Brookes, S. T., Whitely, E., Egger, M., Davey Smith, G., Mulheran, P. A., & Peters, T. J. (2004). Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test. Journal of Clinical Epidemiology, 57(3), 229–236. https://doi.org/10.1016/j.jclinepi.2003.08.009
- Ciani, O., Buyse, M., Garside, R., Pavey, T., Stein, K., Sterne, J. A. C., & Taylor, R. S. (2013). Comparison of treatment effect sizes associated with surrogate and final patient relevant outcomes in randomised controlled trials: Meta-epidemiological study. BMJ, 346, Article f457. https://doi.org/10.1136/bmj.f457 ● Otwarty dostęp
- Cook, R. J., & Sackett, D. L. (1995). The number needed to treat: A clinically useful measure of treatment effect. BMJ, 310(6977), 452–454. https://doi.org/10.1136/bmj.310.6977.452 ● Otwarty dostęp: pełny tekst
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Davies, H. T. O., Crombie, I. K., & Tavakoli, M. (1998). When can odds ratios mislead? BMJ, 316(7136), 989–991. https://doi.org/10.1136/bmj.316.7136.989 ● Otwarty dostęp: pełny tekst
- Deeks, J. J., & Altman, D. G. (2004). Diagnostic tests 4: Likelihood ratios. BMJ, 329(7458), 168–169. https://doi.org/10.1136/bmj.329.7458.168 ● Otwarty dostęp
- Grimes, D. A., & Schulz, K. F. (2002). Bias and causal associations in observational research. The Lancet, 359(9302), 248–252. https://doi.org/10.1016/s0140-6736(02)07451-2
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. https://doi.org/10.1097/ede.0b013e3181c1ea43 ● Otwarty dostęp: pełny tekst
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials. BMJ, 389, Article e081124. https://doi.org/10.1136/bmj-2024-081124 ● Otwarty dostęp
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Man-Son-Hing, M., Laupacis, A., O’Rourke, K., Molnar, F. J., Mahon, J., Chan, K. B. Y., & Wells, G. (2002). Determination of the clinical importance of study results. Journal of General Internal Medicine, 17(6), 469–476. https://doi.org/10.1046/j.1525-1497.2002.11111.x ● Otwarty dostęp: pełny tekst
- Schumi, J., & Wittes, J. T. (2011). Through the looking glass: Understanding non-inferiority. Trials, 12(1), Article 106. https://doi.org/10.1186/1745-6215-12-106 ● Otwarty dostęp
Cytowania BibTeX
@article{altman1998confidence, author={Altman, Douglas G.}, title={{Confidence intervals for the number needed to treat}}, journal={BMJ}, year={1998}, volume={317}, number={7168}, pages={1309--1312}, doi={10.1136/bmj.317.7168.1309}}@article{brookes2004subgroup, author={Brookes, Sara T. and Whitely, Elise and Egger, Matthias and Davey Smith, George and Mulheran, Paul A. and Peters, Tim J.}, title={{Subgroup analyses in randomized trials: Risks of subgroup-specific analyses; power and sample size for the interaction test}}, journal={Journal of Clinical Epidemiology}, year={2004}, volume={57}, number={3}, pages={229--236}, doi={10.1016/j.jclinepi.2003.08.009}}@article{ciani2013comparison, author={Ciani, Oriana and Buyse, Marc and Garside, Ruth and Pavey, Toby and Stein, Ken and Sterne, Jonathan A. C. and Taylor, Rod S.}, title={{Comparison of treatment effect sizes associated with surrogate and final patient relevant outcomes in randomised controlled trials: Meta-epidemiological study}}, journal={BMJ}, year={2013}, volume={346}, eid={f457}, doi={10.1136/bmj.f457}}@article{cook1995number, author={Cook, Richard J. and Sackett, David L.}, title={{The number needed to treat: A clinically useful measure of treatment effect}}, journal={BMJ}, year={1995}, volume={310}, number={6977}, pages={452--454}, doi={10.1136/bmj.310.6977.452}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{davies1998when, author={Davies, Huw T. O. and Crombie, Iain K. and Tavakoli, Manouchehr}, title={{When can odds ratios mislead?}}, journal={BMJ}, year={1998}, volume={316}, number={7136}, pages={989--991}, doi={10.1136/bmj.316.7136.989}}@article{deeks2004diagnostic, author={Deeks, Jonathan J. and Altman, Douglas G.}, title={{Diagnostic tests 4: Likelihood ratios}}, journal={BMJ}, year={2004}, volume={329}, number={7458}, pages={168--169}, doi={10.1136/bmj.329.7458.168}}@article{grimes2002bias, author={Grimes, David A. and Schulz, Kenneth F.}, title={{Bias and causal associations in observational research}}, journal={The Lancet}, year={2002}, volume={359}, number={9302}, pages={248--252}, doi={10.1016/s0140-6736(02)07451-2}}@article{hernan2010hazards, author={Hernán, Miguel A.}, title={{The hazards of hazard ratios}}, journal={Epidemiology}, year={2010}, volume={21}, number={1}, pages={13--15}, doi={10.1097/ede.0b013e3181c1ea43}}@article{hopewell2025consort, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 explanation and elaboration: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081124}, doi={10.1136/bmj-2024-081124}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{mansonhing2002determination, author={Man-Son-Hing, Malcolm and Laupacis, Andreas and O’Rourke, Keith and Molnar, Frank J. and Mahon, Jeffery and Chan, Karen B. Y. and Wells, George}, title={{Determination of the clinical importance of study results}}, journal={Journal of General Internal Medicine}, year={2002}, volume={17}, number={6}, pages={469--476}, doi={10.1046/j.1525-1497.2002.11111.x}}@article{schumi2011through, author={Schumi, Jennifer and Wittes, Janet T.}, title={{Through the looking glass: Understanding non-inferiority}}, journal={Trials}, year={2011}, volume={12}, number={1}, eid={106}, doi={10.1186/1745-6215-12-106}}