Czym jest podrozdział „Analiza statystyczna”
Opis metod statystycznych to ostatni podrozdział części metodologicznej pracy, zwykle zatytułowany „Analiza statystyczna” albo „Metody analizy danych”. Odpowiada na jedno pytanie: co zrobiono z danymi, zanim powstały wyniki. Czytelnik po jego lekturze powinien wiedzieć, jakim programem, jakimi testami i według jakich reguł sprawdzałeś każdą hipotezę – na tyle dokładnie, by móc powtórzyć analizę na tych samych danych.
Ten podrozdział nie jest:
- wykładem z podręcznika statystyki. Nie tłumacz, czym jest test t ani kto wymyślił korelację. Napisz, do czego go użyłeś i w jakiej wersji.
- rozdziałem wyników. Nie podawaj tu wartości p ani średnich. Wyjątkiem bywa krótka informacja o spełnieniu założeń, jeśli od niej zależał wybór testu – choć i ją lepiej umieścić na początku wyników.
- listą nazw testów. Zdanie „W pracy zastosowano test t, ANOVA, korelację Pearsona i regresję” nie mówi, który test sprawdzał którą hipotezę.
Miejsce podrozdziału w całym rozdziale metodologicznym pokazuje poradnik rozdział metodologiczny – jak go napisać. Standardy raportowania APA dla badań ilościowych wymagają w tym miejscu opisu strategii analiz osobno dla hipotez głównych, drugorzędowych i eksploracyjnych (Appelbaum i in., 2018); omawiamy je szerzej we wpisie wytyczne APA dla metodologii i statystyki.
Osiem elementów dobrego opisu
Większość podrozdziałów o analizie statystycznej da się złożyć z ośmiu elementów. Nie każdy musi mieć osobny akapit, ale każdy powinien się pojawić:
| Element | Na jakie pytanie odpowiada |
|---|---|
| 1. Oprogramowanie | W jakim programie, w jakiej wersji i jakimi pakietami liczono analizy? |
| 2. Przygotowanie danych | Jak liczono wyniki skal, kogo wykluczono, co zrobiono z brakami i obserwacjami odstającymi? |
| 3. Statystyki opisowe | Jakie miary podano dla zmiennych ilościowych i jakościowych? |
| 4. Założenia | Jak sprawdzano założenia testów i co zrobiono, gdy nie były spełnione? |
| 5. Testowanie hipotez | Jaka analiza sprawdzała każdą hipotezę? |
| 6. Wielkość efektu | Jakie miary efektu i jakie przedziały ufności podano? |
| 7. Poziom istotności i korekty | Jakie α, test jedno- czy dwustronny, czy i jak korygowano wiele testów? |
| 8. Analizy dodatkowe | Które analizy były eksploracyjne lub sprawdzały odporność wyników? |
Jeśli analizę planowałeś przed zebraniem danych, większość tych elementów masz już w planie analizy. Wtedy podrozdział w pracy jest jego uporządkowaną wersją, a odstępstwa od planu opisujesz wprost – zob. plan analizy statystycznej i prerejestracja.
Oprogramowanie i jego cytowanie
Podaj nazwę programu, numer wersji i producenta, a przy R – także pakiety z wersjami. Program jest narzędziem, od którego zależą ustawienia domyślne (np. czy test t liczony jest z poprawką Welcha), więc jego wersja to część opisu metody, a nie formalność. Najprościej sprawdzić to w samym programie:
- R podaje zalecany sposób cytowania po wpisaniu
citation(); dla wersji 4.5.3 jest to R Core Team (2026). Pakiety cytujesz poleceniemcitation("nazwa_pakietu"), a ich wersje sprawdzasz funkcjąpackageVersion(). - JASP podaje na stronie projektu zalecane cytowanie w formie „JASP Team (rok). JASP (Version …) [Computer software]” (JASP Team, b.d.).
- jamovi zaleca cytowanie „The jamovi project (rok). jamovi (Version …) [Computer Software]”, a wiele analiz w programie podaje dodatkowo własne cytowania pakietów R, które warto dołączyć (The jamovi project, b.d.).
- IBM SPSS Statistics – podaj nazwę, numer wersji, której faktycznie używałeś, i producenta (IBM Corp.).
Programy bezpłatne porównujemy w poradniku bezpłatne programy do analizy statystycznej.
Przygotowanie danych: wykluczenia, braki, wyniki skal
Ta część dokumentuje decyzje, które zmieniają wyniki, choć rzadko o nich się pisze. Opisz:
- jak liczono wyniki skal (średnia czy suma pozycji, które pozycje odwrócono, ile braków w skali dopuszczano);
- według jakich reguł wykluczano osoby (niezaliczone pytanie kontrolne, zbyt szybkie wypełnienie, niespełnione kryteria udziału) i ile osób wykluczono;
- jak postępowano z brakami danych – usunięcie przypadków, analiza dostępnych par, imputacja;
- jak definiowano obserwacje odstające i co z nimi zrobiono.
Najważniejsze: reguły powinny być ustalone przed obejrzeniem wyników testów. Wykluczanie osób „do skutku”, aż wynik stanie się istotny, to jedna z form manipulowania analizą.
Założenia: jak je opisać, żeby nie napisać nieprawdy
Najczęstsze zdanie w tym miejscu brzmi: „Sprawdzono normalność rozkładu wszystkich zmiennych testem Shapiro–Wilka”. Problem w tym, że testy parametryczne zakładają normalność czego innego – w teście t rozkładu w każdej grupie, a w regresji i ANOVA rozkładu reszt modelu – a przy dużej próbie test Shapiro–Wilka odrzuca normalność nawet przy odchyleniach bez praktycznego znaczenia. Lepiej napisać, które założenie, dla której analizy i jak sprawdzano: np. wykres kwantyl–kwantyl reszt, wykres reszt względem wartości dopasowanych, współczynniki VIF. Praktyczne sposoby oceny normalności opisujemy w poradniku jak sprawdzić normalność rozkładu.
Druga dobra praktyka: tam, gdzie to możliwe, wybierz z góry metodę odporną na naruszenie założeń, zamiast warunkować wybór testu wynikiem testu wstępnego. Delacre i in. (2017) pokazują, że dobór testu na podstawie wstępnego testu równości wariancji często zawodzi, a test t Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy są równe – dlatego zalecają go jako domyślny.
Poziom istotności i kierunek testu
Zawsze napisz, jaki poziom istotności przyjąłeś i czy testy były dwustronne. W większości prac to α = .05 i testy dwustronne. Ten wybór nie jest jednak prawem przyrody. Benjamin i in. (2018) zaproponowali obniżenie domyślnego progu do .005 dla twierdzeń o nowych odkryciach, a w odpowiedzi Lakens i in. (2018) postulowali, by badacze uzasadniali każdą decyzję projektową, w tym poziom α, zamiast stosować jeden uniwersalny próg. Maier i Lakens (2022) opisują dwa praktyczne sposoby uzasadnienia α, m.in. przez zrównoważenie ryzyka błędów I i II rodzaju. W pracy dyplomowej zwykle wystarczy α = .05 z jednym zdaniem uzasadnienia albo z odesłaniem do konwencji w dziedzinie.
Test jednostronny wymaga osobnego uzasadnienia. Ruxton i Neuhäuser (2010) uznają go za uprawniony tylko wtedy, gdy potrafisz wyjaśnić, dlaczego duży efekt w kierunku przeciwnym do oczekiwanego potraktowałbyś tak samo jak brak efektu – i to uzasadnienie musi znaleźć się w pracy. Jeśli go nie masz, testuj dwustronnie także hipotezy kierunkowe.
Wiele testów i korekty
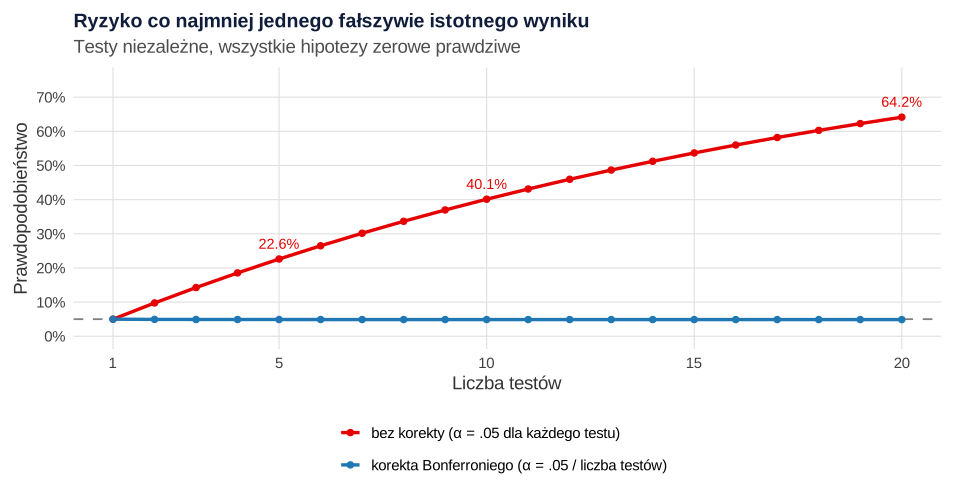
Każdy test przy α = .05 daje 5% szans na wynik fałszywie istotny, gdy hipoteza zerowa jest prawdziwa. Przy wielu testach ryzyko się sumuje. Jeśli wykonasz 5 niezależnych testów i we wszystkich hipotezy zerowe będą prawdziwe, prawdopodobieństwo co najmniej jednego fałszywie istotnego wyniku wynosi 22.6%, przy 10 testach – 40.1%, a przy 20 – 64.2% (rysunek 1). Korekta Bonferroniego utrzymuje to ryzyko na poziomie 4.9%.
Do wyboru masz trzy popularne podejścia (szerzej: problem wielokrotnych porównań i poradnik poprawki na wielokrotne porównania):
- Korekta Bonferroniego – mnoży każde p przez liczbę testów. Najprostsza i najbardziej zachowawcza.
- Korekta Holma – sekwencyjna wersja Bonferroniego. Holm (1979) wykazał, że zapewnia ona z góry ustalony poziom ochrony przed błędem I rodzaju dla dowolnej kombinacji prawdziwych hipotez. Jej progi nigdy nie są ostrzejsze niż w korekcie Bonferroniego, więc odrzuca co najmniej tyle samo hipotez – zwykle nie ma powodu, by wybierać Bonferroniego zamiast Holma.
- Procedura Benjaminiego–Hochberga – kontroluje nie prawdopodobieństwo choćby jednego błędu, ale oczekiwany odsetek fałszywych odkryć (FDR) wśród wyników istotnych, co daje większą moc (Benjamini i Hochberg, 1995). Pasuje do analiz z wieloma zmiennymi o charakterze przesiewowym.
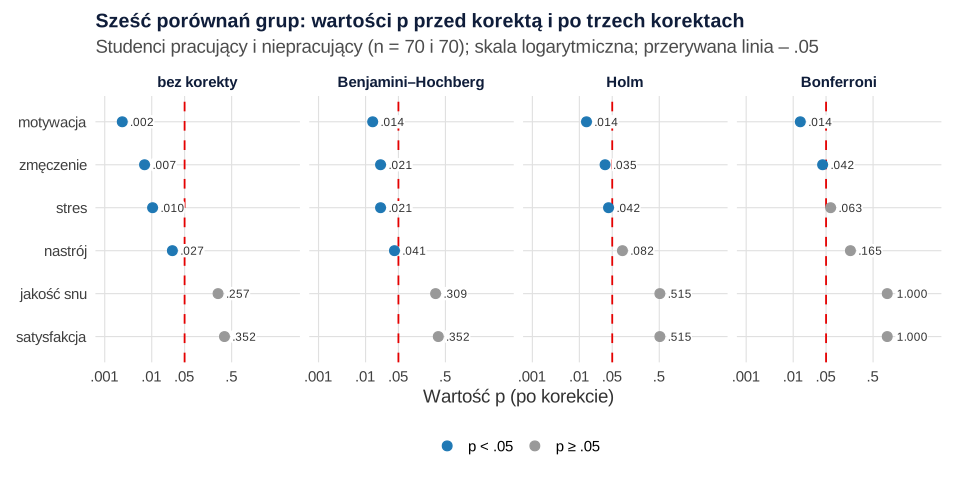
Przykład z R: studentów pracujących zarobkowo i niepracujących (po 70 osób, dane symulowane) porównano w sześciu wskaźnikach samopoczucia testem Welcha. Bez korekty istotne były cztery różnice (motywacja p = .002, zmęczenie p = .007, stres p = .010, nastrój p = .027). Po korekcie Bonferroniego zostały dwie (motywacja i zmęczenie), po korekcie Holma – trzy (stres z p = .042), a po procedurze Benjaminiego–Hochberga – wszystkie cztery (rysunek 2).
Wybór korekty zależy od pytania, a nie od tego, która „zostawi” więcej istotnych wyników – dlatego zapisz ją w podrozdziale o analizie przed obliczeniami. Korekty nie stosuje się zwykle do testów różnych hipotez głównych, z których każda ma własne uzasadnienie teoretyczne; stosuje się ją do rodziny testów odpowiadających na jedno pytanie (np. sześć wskaźników samopoczucia albo porównania parami po ANOVA). Napisz, co uznajesz za rodzinę testów.
Wzory zdań dla typowych planów analiz
Poniżej gotowe fragmenty dla najczęstszych analiz w pracach dyplomowych. Dostosuj nazwy zmiennych i usuń to, czego nie robiłeś. Każdy wzór zawiera wielkość efektu, bo sama decyzja „istotne – nieistotne” nie mówi, jak duża jest różnica czy związek (zob. siła efektu).
Porównanie dwóch grup
Gdy zmienna jest porządkowa albo rozkład jest wyraźnie skośny przy małej próbie, test główny może być nieparametryczny – test U Manna–Whitneya.
Trzy grupy lub więcej
Hasła pomocnicze: ANOVA, test Gamesa–Howella, test Kruskala–Wallisa.
Korelacje
Zob. korelacja Pearsona i korelacja Spearmana.
Regresja wieloraka i hierarchiczna
Zob. regresja hierarchiczna.
Moderacja i mediacja
Zob. moderacja, mediacja i bootstrap.
Zmienne jakościowe
Zob. test chi-kwadrat niezależności i test dokładny Fishera.
Pomiary powtarzane
Zob. ANOVA z powtarzanymi pomiarami.
Liczebność próby w opisie metod
Jeśli liczebność planowałeś analizą mocy, napisz to w metodzie – w opisie próby albo w podrozdziale o analizie. Podaj zakładany efekt i jego źródło, poziom α, moc i wynik obliczeń. Lakens (2022) przypomina, że liczebność można uzasadnić na kilka sposobów, także ograniczeniami zasobów – ważne, by napisać, który z nich zastosowano. Przykładowe wyniki z R przy mocy .80, α = .05 i teście dwustronnym:
- test t dla dwóch grup, d = 0.50 – 64 osoby w każdej grupie;
- jednoczynnikowa ANOVA, trzy grupy, f = 0.25 – 53 osoby w każdej grupie;
- korelacja, r = .30 – 85 osób (przybliżenie Fishera z; programy liczące dokładnie mogą podać 84).
Jak policzyć moc w programie G*Power, opisuje hasło analiza mocy a priori (G*Power).
Przykład całego podrozdziału
Tak może wyglądać kompletny podrozdział dla pracy magisterskiej z badaniem korelacyjnym (stres, wsparcie społeczne i jakość snu studentów; trzy hipotezy główne i analiza eksploracyjna):
Ten podrozdział liczy około 150 słów. W pracy magisterskiej rzadko potrzeba więcej niż jednej strony – jeśli tekst się wydłuża, sprawdź, czy nie zawiera definicji z podręcznika albo wyników.
Źle i dobrze: typowe sformułowania
| Źle | Dobrze |
|---|---|
| Dane opracowano statystycznie w programie SPSS. | Analizy przeprowadzono w programie IBM SPSS Statistics (wersja …). |
| Test t Studenta jest testem parametrycznym służącym do porównania dwóch średnich… | Różnice między grupami (H1) sprawdzono testem t Welcha; jako wielkość efektu podano g Hedgesa z 95% CI. |
| Wszystkie zmienne miały rozkład normalny. | Rozkład reszt modelu oceniano na wykresie kwantyl–kwantyl; nie stwierdzono odchyleń, które mogłyby wpływać na wnioski. |
| Za istotne uznano wyniki p < .05, a za tendencję wyniki p < .10. | Przyjęto poziom istotności α = .05; testy były dwustronne. |
| W pracy zastosowano korelację, regresję i ANOVA. | H1 i H2 – korelacja Pearsona; H3 – regresja z interakcją; analiza eksploracyjna – ANOVA Welcha. |
| Wyniki odstające usunięto. | Za odstające uznano wyniki z |z| > 3.29; analizy powtórzono bez nich, a wnioski się nie zmieniły. |
| Zastosowano poprawkę na wielokrotne porównania. | Wartości p sześciu porównań wskaźników samopoczucia skorygowano metodą Holma. |
Jeśli masz gotowy plan analizy i chcesz, żeby ktoś sprawdził, czy podrozdział jest kompletny i zgodny z tym, co faktycznie policzyłeś, możesz skorzystać z konsultacji w ramach analiz statystycznych dla studentów. Tekst piszesz sam – konsultacja pomaga uzupełnić braki i zrozumieć decyzje, których będziesz bronić.
Przykład w R
Kod odtwarza liczby z sekcji o korektach i liczebności próby oraz dane do rysunków. Korekty liczy wbudowana funkcja p.adjust(), a liczebność – funkcje power.t.test() i power.anova.test().
Ryzyko błędu przy wielu testach, trzy korekty p i liczebność a priori
R
# P25 – liczby do podrozdziału „Analiza statystyczna”: ryzyko błędu przy wielu testach, korekty p,
# liczebność a priori dla typowych planów analiz.
# Uruchom z katalogu strony (strony/P25):  Rscript kod/p25-plan-analizy.R > kod/p25-plan-analizy-wynik.txt
fp <- function(p) ifelse(p < .001, "< .001", sub("^0", "", sprintf("%.3f", p)))   # zapis p jak w APA

# --- 1. Prawdopodobieństwo co najmniej jednego wyniku fałszywie istotnego (testy niezależne, wszystkie H0 prawdziwe)
k <- c(1, 3, 5, 10, 20)
print(data.frame(liczba_testow = k,
                 bez_korekty_proc = round(100 * (1 - (1 - .05)^k), 1),
                 Bonferroni_proc = round(100 * (1 - (1 - .05 / k)^k), 1)), row.names = FALSE)

# --- 2. Sześć porównań dwóch grup (dane symulowane) i trzy korekty
# Studenci pracujący zarobkowo (n = 70) i niepracujący (n = 70): sześć wskaźników samopoczucia (skale 1–5)
set.seed(2688)
efekty <- c(stres = 0.45, zmeczenie = 0.38, sen = -0.33, nastroj = -0.20, motywacja = -0.10, satysfakcja = 0.00)
wyniki <- do.call(rbind, lapply(names(efekty), function(v) {
  pracujacy <- rnorm(70, 3 + 0.7 * efekty[[v]], 0.7)
  niepracujacy <- rnorm(70, 3, 0.7)
  tt <- t.test(pracujacy, niepracujacy)                 # test Welcha
  data.frame(zmienna = v, roznica = unname(diff(rev(tt$estimate))), t = unname(tt$statistic),
             df = unname(tt$parameter), p = tt$p.value)
}))
wyniki$p_Bonferroni <- p.adjust(wyniki$p, "bonferroni")
wyniki$p_Holm <- p.adjust(wyniki$p, "holm")
wyniki$p_BH <- p.adjust(wyniki$p, "BH")
wydruk <- wyniki
wydruk[c("roznica", "t", "df")] <- lapply(wydruk[c("roznica", "t", "df")], round, 2)
wydruk[c("p", "p_Bonferroni", "p_Holm", "p_BH")] <- lapply(wydruk[c("p", "p_Bonferroni", "p_Holm", "p_BH")], fp)
print(wydruk, row.names = FALSE)
cat("Liczba wyników p < .05: bez korekty =", sum(wyniki$p < .05), "| Bonferroni =", sum(wyniki$p_Bonferroni < .05),
    "| Holm =", sum(wyniki$p_Holm < .05), "| BH =", sum(wyniki$p_BH < .05), "\n")
saveRDS(wyniki, "kod/p25-korekty.rds")

# --- 3. Liczebność a priori (moc .80, alfa = .05, test dwustronny)
cat("\nTest t dla dwóch grup, d = 0.50: n na grupę =", ceiling(power.t.test(delta = 0.5, power = .80)$n), "\n")
f <- 0.25                                               # f Cohena dla jednoczynnikowej ANOVA, 3 grupy
cat("ANOVA, 3 grupy, f = 0.25: n na grupę =",
    ceiling(power.anova.test(groups = 3, between.var = f^2 * 3 / 2, within.var = 1, power = .80)$n), "\n")
n_r <- 10; while (pnorm(atanh(0.30) * sqrt(n_r - 3) - qnorm(.975)) < .80) n_r <- n_r + 1
cat("Korelacja r = .30 (przybliżenie Fishera z): n =", n_r, "\n")
Wynik w R
 liczba_testow bez_korekty_proc Bonferroni_proc
             1              5.0             5.0
             3             14.3             4.9
             5             22.6             4.9
            10             40.1             4.9
            20             64.2             4.9
     zmienna roznica     t     df    p p_Bonferroni p_Holm p_BH
       stres    0.30  2.60 134.72 .010         .063   .042 .021
   zmeczenie    0.34  2.74 137.87 .007         .042   .035 .021
         sen   -0.13 -1.14 133.46 .257        1.000   .515 .309
     nastroj   -0.25 -2.23 131.87 .027         .165   .082 .041
   motywacja   -0.38 -3.10 135.29 .002         .014   .014 .014
 satysfakcja    0.11  0.93 137.90 .352        1.000   .515 .352
Liczba wyników p < .05: bez korekty = 4 | Bonferroni = 2 | Holm = 3 | BH = 4

Test t dla dwóch grup, d = 0.50: n na grupę = 64
ANOVA, 3 grupy, f = 0.25: n na grupę = 53
Korelacja r = .30 (przybliżenie Fishera z): n = 85
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Lista kontrolna podrozdziału
- Program z numerem wersji; przy R – pakiety z wersjami i cytowaniami.
- Sposób liczenia wyników skal i odwracania pozycji.
- Reguły wykluczeń, postępowanie z brakami i obserwacjami odstającymi.
- Jakie statystyki opisowe podajesz dla jakich zmiennych.
- Które założenia, dla której analizy i jak sprawdzano; co robiono przy ich naruszeniu.
- Dla każdej hipotezy – konkretna analiza, z numerem hipotezy.
- Miara wielkości efektu i przedziały ufności dla każdej analizy.
- Poziom α, testy jedno- lub dwustronne, rodziny testów i rodzaj korekty.
- Analizy eksploracyjne oznaczone jako eksploracyjne.
- Brak definicji z podręcznika i brak wyników liczbowych.
Najczęstsze pytania
Co powinien zawierać podrozdział o analizie statystycznej w pracy magisterskiej?
Nazwę i wersję programu, sposób przygotowania danych (wyniki skal, wykluczenia, braki danych), opis sprawdzania założeń, analizę przypisaną do każdej hipotezy, miary wielkości efektu i przedziały ufności, poziom istotności z informacją o testach jedno- lub dwustronnych oraz korekty przy wielu testach. Na końcu wymień analizy eksploracyjne.
Jak zacytować program statystyczny w pracy?
Podaj nazwę programu, numer wersji i producenta, a przy R także pakiety z wersjami. R pokazuje zalecane cytowanie po wpisaniu citation(), a pakiety – po wpisaniu citation("nazwa"). JASP i jamovi podają zalecany sposób cytowania na swoich stronach. Pozycję umieść także w bibliografii, jeśli wymaga tego styl pracy.
Czy w opisie metod trzeba tłumaczyć, na czym polega test statystyczny?
Nie. Podrozdział o analizie mówi, do czego i w jakiej wersji użyto testu, a nie, jak test działa. Wyjątkiem są metody mniej znane albo niestandardowe ustawienia – wtedy wystarczy jedno zdanie z odwołaniem do źródła metodologicznego.
Czy trzeba stosować korektę Bonferroniego przy wielu hipotezach?
Nie zawsze. Korektę stosuje się do rodziny testów odpowiadających na jedno pytanie, np. porównań parami po ANOVA albo wielu wskaźników tego samego konstruktu. Hipotezy główne z osobnym uzasadnieniem teoretycznym zwykle testuje się bez korekty. Zamiast Bonferroniego lepiej użyć metody Holma, która chroni tak samo, a ma większą moc.
Gdzie w pracy opisać sprawdzanie założeń testów?
W podrozdziale o analizie statystycznej napisz, które założenia i jak sprawdzano oraz co robiono przy ich naruszeniu. Wyniki tego sprawdzenia, np. informację o skośności reszt, podaj na początku rozdziału wyników, przed testowaniem hipotez.
Powiązane hasła
Przeczytaj też
Rozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →Piszesz podrozdział o analizie statystycznej?
Sprawdzimy, czy opis metod odpowiada hipotezom i faktycznie wykonanym analizom, i wyjaśnimy każdą decyzję tak, abyś umiał(a) ją uzasadnić przed promotorem i komisją.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Benjamin, D. J., Berger, J. O., Johannesson, M., Nosek, B. A., Wagenmakers, E.-J., Berk, R., Bollen, K. A., Brembs, B., Brown, L., Camerer, C., Cesarini, D., Chambers, C. D., Clyde, M., Cook, T. D., De Boeck, P., Dienes, Z., Dreber, A., Easwaran, K., Efferson, C., . . . Johnson, V. E. (2018). Redefine statistical significance. Nature Human Behaviour, 2(1), 6–10. https://doi.org/10.1038/s41562-017-0189-z ● Otwarty dostęp
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- JASP Team. (b.d.). Frequently asked questions. Pobrano 26 października 2026 z https://jasp-stats.org/faq/ ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., Adolfi, F. G., Albers, C. J., Anvari, F., Apps, M. A. J., Argamon, S. E., Baguley, T., Becker, R. B., Benning, S. D., Bradford, D. E., Buchanan, E. M., Caldwell, A. R., Van Calster, B., Carlsson, R., Chen, S.-C., Chung, B., Colling, L. J., Collins, G. S., Crook, Z., . . . Zwaan, R. A. (2018). Justify your alpha. Nature Human Behaviour, 2(3), 168–171. https://doi.org/10.1038/s41562-018-0311-x ● Otwarty dostęp: pełny tekst
- Maier, M., & Lakens, D. (2022). Justify your alpha: A primer on two practical approaches. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221080396. https://doi.org/10.1177/25152459221080396 ● Otwarty dostęp
- R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/ ● Otwarty dostęp
- Ruxton, G. D., & Neuhäuser, M. (2010). When should we use one-tailed hypothesis testing? Methods in Ecology and Evolution, 1(2), 114–117. https://doi.org/10.1111/j.2041-210X.2010.00014.x ● Otwarty dostęp
- The jamovi project. (b.d.). About jamovi. Pobrano 26 października 2026 z https://www.jamovi.org/about.html ● Otwarty dostęp
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{benjamin2018redefine, author={Benjamin, Daniel J. and Berger, James O. and Johannesson, Magnus and Nosek, Brian A. and Wagenmakers, Eric-Jan and Berk, Richard and Bollen, Kenneth A. and Brembs, Björn and Brown, Lawrence and Camerer, Colin and Cesarini, David and Chambers, Christopher D. and Clyde, Merlise and Cook, Thomas D. and De Boeck, Paul and Dienes, Zoltan and Dreber, Anna and Easwaran, Kenny and Efferson, Charles and others}, title={{Redefine statistical significance}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={1}, pages={6--10}, doi={10.1038/s41562-017-0189-z}}@article{benjamini1995controlling, author={Benjamini, Yoav and Hochberg, Yosef}, title={{Controlling the false discovery rate: A practical and powerful approach to multiple testing}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1995}, volume={57}, number={1}, pages={289--300}, doi={10.1111/j.2517-6161.1995.tb02031.x}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@misc{jaspndfaq, author={{JASP Team}}, title={{Frequently asked questions}}, howpublished={JASP}, url={https://jasp-stats.org/faq/}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2018justify, author={Lakens, Daniël and Adolfi, Federico G. and Albers, Casper J. and Anvari, Farid and Apps, Matthew A. J. and Argamon, Shlomo E. and Baguley, Thom and Becker, Raymond B. and Benning, Stephen D. and Bradford, Daniel E. and Buchanan, Erin M. and Caldwell, Aaron R. and Van Calster, Ben and Carlsson, Rickard and Chen, Sau-Chin and Chung, Bryan and Colling, Lincoln J. and Collins, Gary S. and Crook, Zander and others}, title={{Justify your alpha}}, journal={Nature Human Behaviour}, year={2018}, volume={2}, number={3}, pages={168--171}, doi={10.1038/s41562-018-0311-x}}@article{maier2022justify, author={Maier, Maximilian and Lakens, Daniël}, title={{Justify your alpha: A primer on two practical approaches}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221080396}, doi={10.1177/25152459221080396}}@misc{rcoreteam2026r, author={{R Core Team}}, title={{R: A language and environment for statistical computing [Computer software]}}, year={2026}, publisher={R Foundation for Statistical Computing}, url={https://www.R-project.org/}}@article{ruxton2010when, author={Ruxton, Graeme D. and Neuhäuser, Markus}, title={{When should we use one-tailed hypothesis testing?}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={2}, pages={114--117}, doi={10.1111/j.2041-210x.2010.00014.x}}@misc{jamovindabout, author={{The jamovi project}}, title={{About jamovi}}, howpublished={jamovi}, url={https://www.jamovi.org/about.html}}