Pięć typowych projektów w pracy z dietetyki
Prace licencjackie i magisterskie z dietetyki mają zwykle jeden z kilku układów. Najczęściej to ankieta o sposobie żywienia w wybranej grupie, np. studentów, sportowców, kobiet w ciąży albo seniorów, uzupełniona o masę ciała i wzrost. Drugi częsty układ to ocena spożycia kwestionariuszem częstości spożycia albo zapisem jadłospisu. Trzeci to interwencja dietetyczna z pomiarami antropometrycznymi przed i po. Każdy z tych układów wymaga innych analiz, a błędy w pracach powtarzają się zaskakująco regularnie. Tabela porządkuje pięć projektów, które omawiamy dalej.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Sposób żywienia | Czy kobiety i mężczyźni różnią się częstością jedzenia warzyw? | pytania o częstość (kategorie porządkowe) | chi-kwadrat, test Manna–Whitneya | V Craméra, korelacja rangowo-dwuseryjna |
| 2. BMI i stan odżywienia | Co wiąże się z wyższym BMI studentów? | masa, wzrost, aktywność, nawyki | regresja wieloraka na BMI ciągłym | b z 95% CI, R² |
| 3. Kwestionariusz częstości spożycia | Czy FFQ dobrze szacuje spożycie błonnika? | FFQ i zapis spożycia u tych samych osób | Spearman, tercyle, ważona kappa, Bland–Altman | ρ, κw, granice zgodności |
| 4. Interwencja przed i po | Czy poradnictwo dietetyczne zmniejsza masę ciała? | masa i obwód talii w dwóch pomiarach, dwie grupy | ANCOVA z pomiarem wyjściowym | skorygowana różnica z 95% CI, η²p, dz |
| 5. Błąd pomiaru antropometrycznego | Jak dokładnie mierzę obwód talii? | dwa pomiary tych samych osób | TEM, współczynnik rzetelności, ICC | TEM w cm i w % |
Wszystkie dane w przykładach są symulowane, ale mają realistyczne wartości. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem zmiennych) i powtórzyć obliczenia w SPSS, jamovi albo R. Podobne poradniki dla innych kierunków medycznych to statystyka w pracy z pielęgniarstwa i statystyka w pracy ze zdrowia publicznego. W tym drugim znajdziesz chorobowość, iloraz chorobowości i standaryzację względem wieku, które przydają się także w pracach o otyłości w populacji.
Zanim zaczniesz liczyć: trzy decyzje
Po pierwsze, ustal rodzaj każdej zmiennej. Pytanie „jak często jesz warzywa?” z odpowiedziami od „rzadziej niż raz dziennie” do „co najmniej dwa razy dziennie” to skala porządkowa, a nie liczba porcji. Masa ciała, obwód talii, BMI i spożycie składnika w gramach to zmienne ilościowe. Kategorie BMI są zmienną porządkową, która powstała z ilościowej, więc gubią część informacji. Ta różnica decyduje o wyborze testu i o tym, jak opisujesz wynik.
Po drugie, zapisz hipotezy przed analizą. Ankieta żywieniowa ma zwykle kilkadziesiąt pytań o częstość spożycia różnych produktów. Jeśli każde porównasz z płcią, miejscem zamieszkania i rokiem studiów, dostaniesz ponad sto testów i kilka przypadkowych „istotnych” wyników. To problem wielokrotnych porównań. Wybierz 3–5 głównych pytań, a resztę opisz jako analizy eksploracyjne.
Po trzecie, nazwij schemat badania. Jednorazowa ankieta to schemat przekrojowy: pokazuje związki, ale nie kierunek przyczynowy. Pomiar przed i po interwencji bez grupy kontrolnej nie pozwala przypisać zmiany samej diecie. Pisz więc „osoby jedzące śniadanie codziennie miały niższe BMI”, a nie „regularne śniadania obniżają BMI”.
Zgoda komisji bioetycznej, świadoma zgoda uczestników i ochrona danych zależą od regulaminu uczelni i miejsca badania. Sprawdź je z promotorem przed rozpoczęciem zbierania danych, zwłaszcza gdy badasz pacjentów poradni albo osoby niepełnoletnie.
Projekt 1. Sposób żywienia: pytania o częstość spożycia
Przykład: 240 studentów (160 kobiet i 80 mężczyzn) odpowiedziało na ankietę o nawykach żywieniowych. Jedno z pytań dotyczyło częstości jedzenia warzyw i miało trzy odpowiedzi. Pytanie badawcze brzmi: czy kobiety i mężczyźni różnią się pod tym względem?
| Płeć | Rzadziej niż raz dziennie | Raz dziennie | Co najmniej 2 razy dziennie |
|---|---|---|---|
| Kobiety (n = 160) | 52 (32.5%) | 64 (40.0%) | 44 (27.5%) |
| Mężczyźni (n = 80) | 36 (45.0%) | 28 (35.0%) | 16 (20.0%) |
Masz dwie poprawne drogi. Pierwsza to test chi-kwadrat niezależności, który traktuje odpowiedzi jak kategorie: χ²(2) = 3.82, p = .148, V Craméra = .13. Najmniejsza liczebność oczekiwana wynosi 20.0, więc warunek stosowania testu jest spełniony. Druga droga korzysta z tego, że odpowiedzi są uporządkowane. Test Manna–Whitneya porównuje rangi: W = 7304, p = .057, korelacja rangowo-dwuseryjna r = .14, 95% CI [−.01, .29]. Wybierz jedną z nich przed analizą i uzasadnij wybór w rozdziale metodologicznym. Nie licz obu, żeby potem pokazać tę, która „wyszła”.
Wynik nie jest istotny statystycznie. W pracy nie piszesz jednak, że „płeć nie ma wpływu na spożycie warzyw”. Piszesz, że różnica była niewielka i nieistotna, a przedział ufności dla wielkości efektu sięga od braku różnicy do różnicy małej. Brak istotności przy 240 osobach nie dowodzi braku różnicy w populacji. Krok po kroku test chi-kwadrat pokazujemy w poradniku test chi-kwadrat krok po kroku, a testy rangowe – w poradniku testy nieparametryczne krok po kroku.
Popularnym, ale wątpliwym zwyczajem jest zamiana odpowiedzi na „porcje dziennie” i liczenie średniej. Odpowiedź „rzadziej niż raz dziennie” może oznaczać zarówno dwa razy w tygodniu, jak i prawie codziennie. Jeśli narzędzie ma opublikowany klucz przeliczania kategorii na częstość dzienną, użyj go i zacytuj źródło. Jeśli nie ma, opisuj rozkład odpowiedzi i stosuj testy dla danych porządkowych.
Projekt 2. BMI i stan odżywienia
W tej samej grupie studenci podali masę ciała i wzrost, a z nich policzono BMI (masa w kilogramach podzielona przez kwadrat wzrostu w metrach). Średnie BMI wyniosło 23.56 kg/m² (SD = 3.47, Me = 23.18, Q1–Q3: 20.96–25.88), a zakres od 14.97 do 34.67. World Health Organization (2026) definiuje u dorosłych nadwagę jako BMI ≥ 25, a otyłość jako BMI ≥ 30. U dzieci i młodzieży te progi nie obowiązują. Stosuje się BMI względem wieku i płci odniesione do siatek centylowych, a WHO podaje osobne kryteria dla dzieci poniżej 5 lat i dla grupy 5–19 lat. Każdy próg w pracy cytuj ze źródła, z którego go bierzesz.
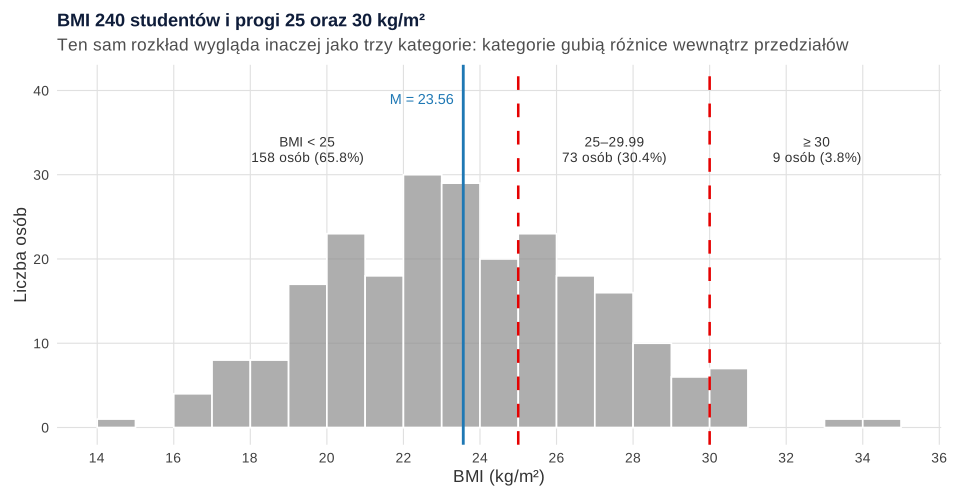
Nadwagę lub otyłość (BMI ≥ 25) miało 82 studentów, czyli 34.2%, 95% CI [28.5, 40.4]. Przy odsetkach zawsze podawaj przedział ufności dla proporcji, najlepiej Wilsona. Bez niego nie wiadomo, czy 34.2% w próbie 240 osób to oszacowanie precyzyjne. Gdy masa i wzrost pochodzą z deklaracji, a nie z pomiaru, napisz to wyraźnie w ograniczeniach. Deklarowana masa bywa zaniżana, więc odsetek osób z nadwagą może być niedoszacowany.
Analizuj BMI jako liczbę, kategorie pokazuj opisowo
Pytanie „co wiąże się z BMI” najlepiej rozwiązuje regresja wieloraka na BMI ciągłym. W przykładzie predyktorami były płeć, aktywność fizyczna (godziny tygodniowo) i regularność śniadań. Model wyjaśnił 14.1% wariancji BMI, F(3, 236) = 12.90, p < .001, R² = .141, skorygowane R² = .130.
| Predyktor | b | 95% CI | p |
|---|---|---|---|
| Mężczyzna (vs kobieta) | 1.42 | [0.54, 2.30] | .002 |
| Aktywność fizyczna (godziny/tydzień) | −0.41 | [−0.58, −0.24] | < .001 |
| Śniadanie nie codziennie (vs codziennie) | 1.04 | [0.20, 1.88] | .016 |
Każda dodatkowa godzina aktywności tygodniowo wiązała się z BMI niższym średnio o 0.41 kg/m² przy tej samej płci i regularności śniadań. Ten zapis jest konkretny i da się go porównać z innymi badaniami. Te same dane można też podzielić na „nadwaga tak/nie” i policzyć regresję logistyczną. Wtedy aktywność ma OR = 0.75, 95% CI [0.65, 0.87], a brak codziennego śniadania OR = 1.86, 95% CI [1.05, 3.31], p = .035. Wniosek jest podobny, ale model mówi tylko o przekroczeniu progu. Osoba z BMI 25.1 liczy się tak samo jak osoba z BMI 34. Bennette i Vickers (2012) opisują, dlaczego dzielenie zmiennych ciągłych na kategorie jest w epidemiologii tak problematyczne, i pokazują lepsze rozwiązania. Kategorie BMI pokaż więc w tabeli opisowej, a hipotezy testuj na BMI ciągłym.
Przed interpretacją sprawdź założenia modelu, przede wszystkim rozkład reszt i obserwacje nietypowe. Procedurę opisujemy w poradniku regresja wieloraka krok po kroku. BMI ma często rozkład prawoskośny. Przy kilkuset osobach nie jest to zwykle problem dla regresji, ale opisz rozkład medianą i kwartylami obok średniej.
Projekt 3. Kwestionariusz częstości spożycia i jego zgodność z zapisem
Kwestionariusz częstości spożycia (food frequency questionnaire, FFQ) pyta, jak często w określonym czasie osoba jadła produkty z listy. Cade i in. (2002) w przeglądzie poświęconym budowie i walidacji takich narzędzi podkreślają, że nie istnieje złoty standard oceny ich trafności. FFQ trzeba więc sprawdzać pod kątem zamierzonego zastosowania. W pracy dyplomowej oznacza to zwykle porównanie FFQ z inną metodą u tych samych osób, np. z kilkudniowym zapisem jadłospisu. Taką ocenę nazywa się trafnością względną.
Jeśli korzystasz z opublikowanego kwestionariusza, licz wynik dokładnie według instrukcji autorów i zacytuj ją. Nie przedrukowuj pozycji w aneksie bez zgody właściciela praw. Wystarczy liczba pozycji, okres, którego dotyczą pytania, kategorie odpowiedzi i grupy produktów. Taki opis wystarczy, by czytelnik wiedział, czym mierzono spożycie.
Przykład: 90 osób wypełniło autorski FFQ i prowadziło 3-dniowy zapis spożycia. Porównujemy spożycie błonnika. Według FFQ wynosiło ono średnio 25.63 g/dzień (SD = 10.66), a według zapisu 22.63 g/dzień (SD = 9.37). Lombard i in. (2015) przejrzeli 60 badań walidacyjnych i znaleźli sześć różnych testów w 21 kombinacjach, bez zgody co do kryteriów akceptowalnej trafności. Każdy test opisuje inny aspekt zgodności, więc warto policzyć kilka:
- Korelacja rangowa. Korelacja Spearmana wyniosła ρ = .70, p < .001. Mówi ona, czy obie metody podobnie porządkują osoby od najniższego do najwyższego spożycia. Nie mówi natomiast, czy dają te same wartości.
- Klasyfikacja do tercyli. Do tej samej tercyli obie metody przypisały 58.9% osób, do sąsiedniej 37.8%, a do przeciwnej 3.3%.
- Ważona kappa. Zgodność tercyli z uwzględnieniem odległości kategorii opisuje kappa ważona: κw = .62, 95% CI [.48, .75]. Kappa bez wag wyniosła .38.
- Wykres Blanda–Altmana. FFQ dawał średnio o 3.00 g/dzień więcej niż zapis, 95% CI [1.26, 4.74], t(89) = 3.43, p < .001. Granice zgodności sięgały od −13.27 do 19.27 g/dzień.
Masson i in. (2003) zaproponowali orientacyjne kryteria trafności względnej. Są to korelacja Spearmana powyżej .5, ponad 50% osób w tej samej tercyli, mniej niż 10% w przeciwnej i ważona kappa powyżej .4. Nasz FFQ spełnia je wszystkie. Traktuj jednak te progi jako punkt odniesienia z jednej publikacji, a nie jako normę. Ważniejsze jest to, co pokazuje metoda Blanda–Altmana.
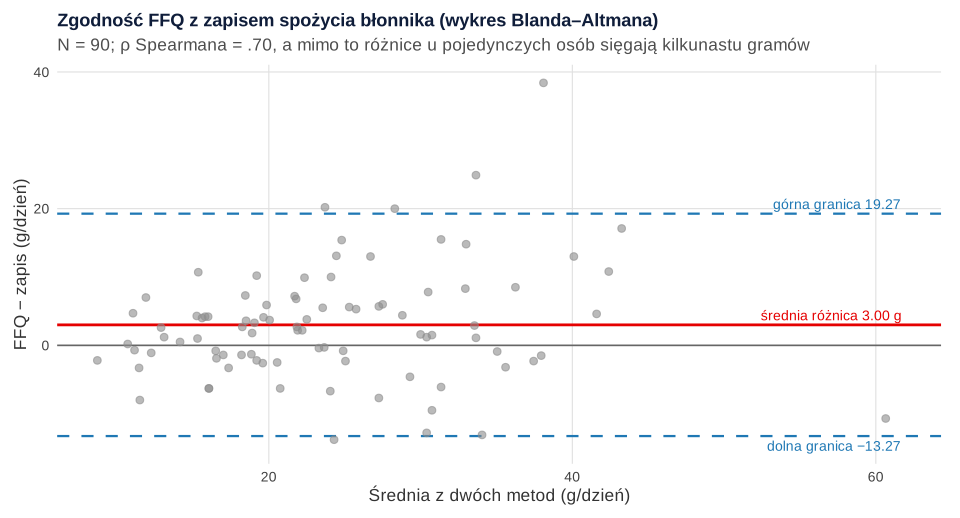
Bland i Altman (1986) pokazali, że korelacja wprowadza w błąd przy porównywaniu metod pomiaru, i zaproponowali właśnie ten wykres. Tu widać to wyraźnie. Przy ρ = .70 FFQ u części osób zawyża spożycie o kilkanaście gramów, a u innych je zaniża. Taki kwestionariusz nadaje się do porównań grup albo do podziału na tercyle spożycia. Nie nadaje się do oceny, czy konkretny pacjent spożywa zalecaną ilość błonnika. Sprawdź też, czy różnica zależy od poziomu spożycia. W przykładzie regresja różnicy na średniej nie dała istotnego nachylenia (b = 0.155, p = .109), ale przy szerszym zakresie spożycia często tak bywa. Granice zgodności i rzetelność pomiaru omawiamy szerzej w poradniku badanie rzetelności pomiaru klinicznego.
Jeszcze jedno zastrzeżenie dotyczy energii. Subar i in. (2015) przypominają, że deklarowanego spożycia energii nie należy traktować jako miary rzeczywistego spożycia, bo jest ono zwykle zaniżane. Zalecają natomiast używanie deklarowanej energii do korekty spożycia innych składników względem energii, a ograniczenia danych samoopisowych trzeba uczciwie opisać. Jeśli analizujesz składniki odżywcze, dowiedz się od promotora, czy w Twojej dziedzinie oczekuje się wyników skorygowanych względem energii.
Projekt 4. Interwencja dietetyczna z pomiarami przed i po
To najbardziej „kliniczny” typ pracy i jednocześnie najczęstsze źródło błędnych wniosków. Przykład: 84 dorosłych z nadwagą losowo przydzielono do dwóch grup po 42 osoby. Grupa interwencyjna przez 12 tygodni korzystała z indywidualnego poradnictwa dietetycznego, a grupa kontrolna dostała ulotkę z zaleceniami. Masę ciała i obwód talii zmierzono na początku i po 12 tygodniach. Pełny kod tego projektu znajdziesz w sekcji z przykładem w R.
| Grupa | Masa przed, M (SD) | Masa po, M (SD) | Zmiana masy, M (SD) | Talia przed | Talia po |
|---|---|---|---|---|---|
| Kontrola (n = 42) | 89.78 (10.79) | 88.31 (11.77) | −1.47 (2.31) | 101.93 (7.69) | 100.91 (7.88) |
| Interwencja (n = 42) | 89.66 (11.29) | 86.22 (12.41) | −3.44 (3.42) | 101.71 (8.24) | 98.00 (8.74) |
Pułapka: dwa testy t dla prób zależnych
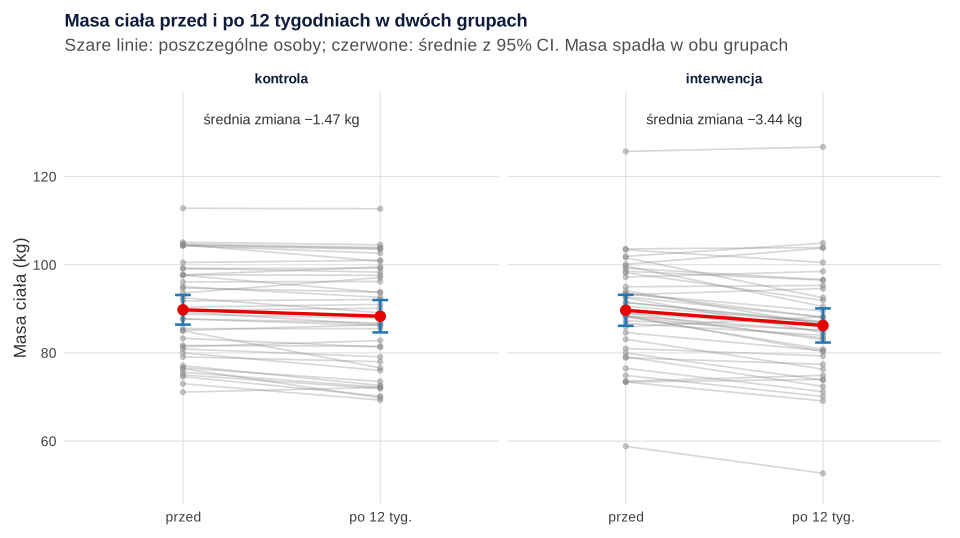
Najczęstszy błąd polega na policzeniu dwóch osobnych testów t dla prób zależnych i porównaniu ich wyników. W grupie interwencyjnej masa spadła o 3.44 kg, 95% CI [2.37, 4.50], t(41) = −6.52, p < .001, dz = −0.99. Ale masa spadła istotnie także w grupie kontrolnej: o 1.47 kg, 95% CI [0.75, 2.19], t(41) = −4.11, p < .001, dz = −0.62. Dwa istotne wyniki nic nie mówią o tym, czy interwencja działała lepiej niż ulotka. Na to pytanie odpowiada tylko bezpośrednie porównanie grup. Spadek w grupie kontrolnej to zjawisko typowe. Składa się na niego sam udział w badaniu, sezonowość i regresja do średniej. Barnett i in. (2005) wyjaśniają, że po nietypowo wysokich pomiarach kolejne są zwykle bliższe średniej, a efekt jest najsilniejszy, gdy do badania kwalifikuje się osoby według wysokiej wartości wyjściowej, np. BMI powyżej progu.
Rozwiązanie: ANCOVA z pomiarem wyjściowym
W badaniu z randomizacją standardem jest ANCOVA: masa po 12 tygodniach jest zmienną zależną, grupa – czynnikiem, a masa wyjściowa – współzmienną. Van Breukelen (2006) pokazał, że w badaniach randomizowanych zarówno ANCOVA, jak i analiza wyników zmiany są nieobciążone, ale ANCOVA ma większą moc. W badaniach nierandomizowanych obie metody mogą dawać sprzeczne wyniki. Vickers i Altman (2001) dodają, że przewaga jednej z prostszych metod zależy od korelacji między pomiarem wyjściowym i końcowym.
Wynik w przykładzie: po uwzględnieniu masy wyjściowej grupa interwencyjna ważyła po 12 tygodniach średnio o 1.96 kg mniej niż kontrolna, 95% CI [0.73, 3.20], F(1, 81) = 10.00, p = .002, η²p = .11. Skorygowane średnie wyniosły 86.3 i 88.2 kg. Analiza wyników zmiany testem Welcha dała zbieżny wynik: różnica 1.97 kg, 95% CI [0.70, 3.24], t(72.02) = 3.10, p = .003. Dla obwodu talii skorygowana różnica wyniosła 2.70 cm na korzyść interwencji, 95% CI [1.48, 3.91], p < .001. Założenie równoległości nachyleń było spełnione, bo interakcja masy wyjściowej z grupą okazała się nieistotna: F(1, 80) = 0.06, p = .815. Szczegóły ANCOVA, paradoks Lorda i porównanie wszystkich strategii na jednych danych opisujemy w poradniku ANCOVA w badaniu przed i po.
Częsty dodatek to odsetek osób, które schudły o określony procent masy ciała. W przykładzie przyjęliśmy próg 5% wyłącznie jako ilustrację. Przekroczyło go 42.9% osób w grupie interwencyjnej i 14.3% w kontrolnej. Jeśli w pracy liczysz taki wskaźnik, próg musi wynikać z protokołu badania albo ze wskazanych wytycznych, a analiza główna i tak powinna dotyczyć masy w kilogramach.
Gdy nie masz grupy kontrolnej, zostaje test t dla prób zależnych z dz (zob. test t Studenta krok po kroku). Pamiętaj jednak, że taki wynik to opis zmiany w grupie, a nie dowód skuteczności diety. Lakens (2013) pokazuje, że wielkość efektu w schemacie wewnątrzosobowym liczy się inaczej niż w międzygrupowym, więc w pracy napisz, której miary użyłeś.
Projekt 5. Błąd pomiaru antropometrycznego
Wyniki interwencji są tak dobre, jak pomiary, na których się opierają. Różnica 2 cm w obwodzie talii ma znaczenie tylko wtedy, gdy wiesz, jaki jest błąd samego pomiaru. Ulijaszek i Kerr (1999) opisują sposoby oceny tego błędu na podstawie powtórzonych pomiarów u tych samych osób. Są to techniczny błąd pomiaru (TEM), względny TEM, współczynnik rzetelności R i ICC. Autorzy zalecają dążyć do R > .95 i zwracają uwagę, że TEM zależy od wieku i cech badanej grupy.
Tu d to różnica między dwoma pomiarami tej samej osoby, n – liczba osób, M – średnia wszystkich pomiarów, a SD – ich odchylenie standardowe. Przykład: osoba prowadząca badanie zmierzyła obwód talii 30 osób dwa razy w odstępie kilku minut. TEM wyniósł 1.29 cm, czyli 1.52% średniej, a R = .988. ICC (zgodność bezwzględna, pojedynczy pomiar) wyniosło .99, 95% CI [.98, .99]. Średnia różnica między pomiarami wyniosła −0.58 cm. Wysokie ICC wynika tu głównie z dużych różnic między osobami, a TEM mówi, ile wynosi typowy błąd u jednej osoby. Dlatego w pracy podaj obie miary.
W praktyce oznacza to, że zmianę obwodu talii o mniej niż około 1–2 cm u pojedynczej osoby trudno odróżnić od błędu pomiaru. Na poziomie średnich grupowych błąd się częściowo znosi, więc różnica 2.70 cm między grupami w projekcie 4 jest wiarygodna. Takie rozumowanie formalizują standardowy błąd pomiaru i minimalna wykrywalna zmiana. Jeśli pomiary wykonuje kilka osób, oceń także zgodność między nimi. Wybór odpowiedniej postaci ICC opisujemy w poradniku zgodność sędziów: kappa, ICC i alfa Krippendorffa.
Wielkość efektu i zapis APA: ściąga
Promotor albo recenzent zapyta nie tylko, czy wynik jest istotny, lecz także, jak duży jest efekt. W dietetyce najlepiej podawać go w jednostkach, które rozumie czytelnik: kilogramach, centymetrach, gramach na dzień, kg/m². Miary standaryzowane dodaj obok.
| Analiza | Wielkość efektu | Przykład zapisu |
|---|---|---|
| Chi-kwadrat niezależności | V Craméra | χ²(2) = 3.82, p = .148, V = .13 |
| Test Manna–Whitneya | korelacja rangowo-dwuseryjna | W = 7304, p = .057, r = .14, 95% CI [−.01, .29] |
| Odsetek z przedziałem Wilsona | proporcja z 95% CI | 34.2%, 95% CI [28.5, 40.4] |
| Regresja wieloraka | b z 95% CI, R² | b = −0.41, 95% CI [−0.58, −0.24]; R² = .141 |
| Korelacja Spearmana (walidacja) | ρ | ρ = .70, p < .001 |
| Ważona kappa | κw z 95% CI | κw = .62, 95% CI [.48, .75] |
| Bland–Altman | średnia różnica i granice zgodności | 3.00 g/dzień, granice od −13.27 do 19.27 |
| Test t dla prób zależnych | dz z 95% CI | t(41) = −6.52, p < .001, dz = −0.99, 95% CI [−1.35, −0.62] |
| ANCOVA | skorygowana różnica, η²p | F(1, 81) = 10.00, p = .002, η²p = .11 |
Zapisuj p dokładnie do trzech miejsc po kropce, a poniżej .001 jako „p < .001”. Wartości, które nie mogą przekroczyć 1 (p, r, ρ, κ, V, η²), podawaj bez zera przed kropką. Opis tabel z wynikami znajdziesz w poradniku jak opisać wyniki w stylu APA. Jeśli potrzebujesz pomocy w doborze analiz albo w sprawdzeniu obliczeń, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu. Przepis 3 to pełny przykład krok po kroku dla badania interwencyjnego: od opisu grup, przez testy dla prób zależnych, po ANCOVA ze sprawdzeniem założenia równoległości nachyleń. Każdy przepis tworzy własne dane symulowane, więc możesz uruchomić go osobno. Ostatni zapisuje plik XLSX do pobrania.
1. Projekty 1 i 2: sposób żywienia i BMI
R
# Projekty 1 i 2: sposób żywienia i BMI studentów (dane symulowane).
# 240 studentów; częstość spożycia warzyw (3 kategorie porządkowe), regularność śniadań,
# masa ciała i wzrost (deklarowane), aktywność fizyczna (min/tydzień).
suppressPackageStartupMessages({ library(effectsize); library(DescTools) })
set.seed(6701)
n <- 240
plec <- factor(sample(c("kobieta", "mężczyzna"), n, TRUE, prob = c(.62, .38)), levels = c("kobieta", "mężczyzna"))
p_war <- ifelse(plec == "kobieta", 1, 0)
u <- runif(n)
warzywa <- factor(ifelse(u < .40 - .14 * p_war, "rzadziej niż raz dziennie",
                  ifelse(u < .78 - .10 * p_war, "raz dziennie", "co najmniej 2 razy dziennie")),
                  levels = c("rzadziej niż raz dziennie", "raz dziennie", "co najmniej 2 razy dziennie"))
sniadanie <- factor(ifelse(runif(n) < .64, "codziennie", "nie codziennie"), levels = c("codziennie", "nie codziennie"))
aktywnosc <- round(pmax(0, rgamma(n, shape = 2.2, scale = 90)))         # min/tydzień
wzrost <- round(ifelse(plec == "kobieta", rnorm(n, 166, 6), rnorm(n, 180, 7)))
bmi_lp <- 22.6 + 1.3 * (plec == "mężczyzna") - 0.006 * (aktywnosc - 200) + 0.8 * (sniadanie == "nie codziennie")
bmi_true <- bmi_lp + rnorm(n, 0, 3.1) + pmax(0, rnorm(n, 0, 2.2)) * (runif(n) < .3)
masa <- round(bmi_true * (wzrost / 100)^2, 1)
p1 <- data.frame(id = 1:n, plec, warzywa, sniadanie, aktywnosc_min = aktywnosc, wzrost_cm = wzrost, masa_kg = masa)
p1$bmi <- round(p1$masa_kg / (p1$wzrost_cm / 100)^2, 2)

# Projekt 1: tabela krzyżowa płeć × częstość spożycia warzyw (odsetki w wierszach)
tab <- table(p1$plec, p1$warzywa); tab
round(100 * prop.table(tab, 1), 1)
ch <- chisq.test(tab); ch
round(min(ch$expected), 1)
round(unlist(as.data.frame(cramers_v(tab, adjust = FALSE))[, c(1, 3, 4)]), 2)
# Ta sama zmienna jako porządkowa (1–3): test Manna–Whitneya i korelacja rangowo-dwuseryjna
p1$warzywa_ord <- as.integer(p1$warzywa)
wilcox.test(warzywa_ord ~ plec, data = p1, exact = FALSE)
round(unlist(as.data.frame(rank_biserial(warzywa_ord ~ plec, data = p1))[, c(1, 3, 4)]), 2)

# Projekt 2: BMI – opis, kategorie według progów WHO dla dorosłych (25 i 30), regresja na wyniku ciągłym
round(c(M = mean(p1$bmi), SD = sd(p1$bmi), Me = median(p1$bmi), Q1 = unname(quantile(p1$bmi, .25)),
        Q3 = unname(quantile(p1$bmi, .75)), min = min(p1$bmi), max = max(p1$bmi)), 2)
p1$bmi_kat <- cut(p1$bmi, c(-Inf, 25, 30, Inf), right = FALSE, labels = c("< 25", "25–29.99", ">= 30"))
table(p1$bmi_kat)
k25 <- sum(p1$bmi >= 25); k25
round(100 * BinomCI(k25, n, method = "wilson"), 1)
m2 <- lm(bmi ~ plec + I(aktywnosc_min / 60) + sniadanie, data = p1)
round(cbind(b = coef(m2), confint(m2), p = summary(m2)$coefficients[, 4]), 3)
s <- summary(m2); round(c(R2 = s$r.squared, R2_skor = s$adj.r.squared, F = unname(s$fstatistic[1]),
                          df1 = unname(s$fstatistic[2]), df2 = unname(s$fstatistic[3]),
                          p = unname(pf(s$fstatistic[1], s$fstatistic[2], s$fstatistic[3], lower.tail = FALSE))), 3)
# Dla porównania: ta sama hipoteza na BMI podzielonym na „nadwaga tak/nie” (regresja logistyczna)
m2b <- glm(I(bmi >= 25) ~ plec + I(aktywnosc_min / 60) + sniadanie, data = p1, family = binomial)
round(cbind(OR = exp(coef(m2b)), exp(confint.default(m2b)), p = summary(m2b)$coefficients[, 4]), 3)
Wynik w R
            rzadziej niż raz dziennie raz dziennie co najmniej 2 razy dziennie
  kobieta                          52           64                          44
  mężczyzna                        36           28                          16

            rzadziej niż raz dziennie raz dziennie co najmniej 2 razy dziennie
  kobieta                        32.5         40.0                        27.5
  mężczyzna                      45.0         35.0                        20.0

	Pearson's Chi-squared test

data:  tab
X-squared = 3.8206, df = 2, p-value = 0.148

[1] 20
Cramers_v    CI_low   CI_high
     0.13      0.00      1.00

	Wilcoxon rank sum test with continuity correction

data:  warzywa_ord by plec
W = 7304, p-value = 0.05731
alternative hypothesis: true location shift is not equal to 0

r_rank_biserial          CI_low         CI_high
           0.14           -0.01            0.29
    M    SD    Me    Q1    Q3   min   max
23.56  3.47 23.18 20.96 25.88 14.97 34.67

    < 25 25–29.99    >= 30
     158       73        9
[1] 82
      est lwr.ci upr.ci
[1,] 34.2   28.5   40.4
                             b  2.5 % 97.5 %     p
(Intercept)             24.109 23.227 24.992 0.000
plecmężczyzna            1.418  0.542  2.295 0.002
I(aktywnosc_min/60)     -0.406 -0.576 -0.237 0.000
sniadanienie codziennie  1.040  0.197  1.883 0.016
     R2 R2_skor       F     df1     df2       p
  0.141   0.130  12.902   3.000 236.000   0.000
                           OR 2.5 % 97.5 %     p
(Intercept)             0.785 0.426  1.448 0.439
plecmężczyzna           2.090 1.154  3.785 0.015
I(aktywnosc_min/60)     0.749 0.646  0.868 0.000
sniadanienie codziennie 1.861 1.045  3.312 0.035
2. Projekt 3: zgodność FFQ z zapisem spożycia
R
# Projekt 3: kwestionariusz częstości spożycia (FFQ) a 3-dniowy zapis spożycia – zgodność względna (dane symulowane).
# 90 osób; spożycie błonnika (g/dzień) oszacowane z autorskiego FFQ i z zapisu jako metody odniesienia.
suppressPackageStartupMessages({ library(psych) })
set.seed(6702)
n <- 90
prawdziwe <- rlnorm(n, log(21), .32)                                   # „prawdziwe” spożycie
zapis <- round(prawdziwe * exp(rnorm(n, 0, .18)), 1)                   # metoda odniesienia
ffq <- round(prawdziwe * 1.12 * exp(rnorm(n, 0, .27)), 1)              # FFQ: przeszacowanie i większy błąd
p3 <- data.frame(id = 1:n, blonnik_ffq = ffq, blonnik_zapis = zapis)

round(sapply(p3[, 2:3], function(x) c(M = mean(x), SD = sd(x), Me = median(x))), 2)
# Korelacja Spearmana
cor.test(p3$blonnik_ffq, p3$blonnik_zapis, method = "spearman", exact = FALSE)
# Klasyfikacja do tercyli: ta sama, sąsiednia i przeciwna kategoria
t_ffq <- cut(rank(p3$blonnik_ffq), 3, labels = 1:3); t_zap <- cut(rank(p3$blonnik_zapis), 3, labels = 1:3)
tt <- table(FFQ = t_ffq, zapis = t_zap); tt
d <- abs(as.integer(t_ffq) - as.integer(t_zap))
round(100 * c(ta_sama = mean(d == 0), sasiednia = mean(d == 1), przeciwna = mean(d == 2)), 1)
# Ważona kappa (wagi kwadratowe w psych::cohen.kappa)
ck <- cohen.kappa(cbind(as.integer(t_ffq), as.integer(t_zap))); ck
# Metoda Blanda–Altmana: średnia różnica i granice zgodności
roz <- p3$blonnik_ffq - p3$blonnik_zapis; sr <- (p3$blonnik_ffq + p3$blonnik_zapis) / 2
ba <- c(roznica_M = mean(roz), SD = sd(roz), dolna = mean(roz) - 1.96 * sd(roz), gorna = mean(roz) + 1.96 * sd(roz))
round(ba, 2)
t.test(roz)
# Czy różnica rośnie z poziomem spożycia? (regresja różnicy na średniej)
round(summary(lm(roz ~ sr))$coefficients, 3)
Wynik w R
   blonnik_ffq blonnik_zapis
M        25.63         22.63
SD       10.66          9.37
Me       23.70         20.40

	Spearman's rank correlation rho

data:  p3$blonnik_ffq and p3$blonnik_zapis
S = 36896, p-value = 2.552e-14
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.6962909

   zapis
FFQ  1  2  3
  1 20  9  1
  2  8 13  9
  3  2  8 20
  ta_sama sasiednia przeciwna
     58.9      37.8       3.3
Call: cohen.kappa1(x = x, w = w, n.obs = n.obs, alpha = alpha, levels = levels,
    w.exp = w.exp)

Cohen Kappa and Weighted Kappa correlation coefficients and confidence boundaries
                 lower estimate upper
unweighted kappa  0.23     0.38  0.54
weighted kappa    0.48     0.62  0.75

 Number of subjects = 90
roznica_M        SD     dolna     gorna
     3.00      8.30    -13.27     19.27

	One Sample t-test

data:  roz
t = 3.4277, df = 89, p-value = 0.0009238
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
 1.260476 4.737302
sample estimates:
mean of x
 2.998889

            Estimate Std. Error t value Pr(>|t|)
(Intercept)   -0.734      2.460  -0.298    0.766
sr             0.155      0.095   1.621    0.109
3. Projekt 4 (pełny przykład): interwencja dietetyczna przed i po
R
# Projekt 4 (pełny przykład): 12-tygodniowa interwencja dietetyczna z pomiarami antropometrycznymi przed i po.
# 84 dorosłych z nadwagą przydzielonych losowo do grupy z poradnictwem dietetycznym albo do grupy z ulotką (kontrola);
# masa ciała (kg) i obwód talii (cm) przed i po (dane symulowane).
suppressPackageStartupMessages({ library(effectsize); library(emmeans) })
set.seed(6703)
n_g <- 42
grupa <- factor(rep(c("kontrola", "interwencja"), each = n_g), levels = c("kontrola", "interwencja"))
masa_0 <- round(rnorm(2 * n_g, 88, 11), 1)
masa_12 <- round(masa_0 - ifelse(grupa == "interwencja", 3.4, 1.0) + 0.04 * (masa_0 - 88) + rnorm(2 * n_g, 0, 2.6), 1)
talia_0 <- round(0.62 * masa_0 + 46 + rnorm(2 * n_g, 0, 4.5), 1)
talia_12 <- round(talia_0 - ifelse(grupa == "interwencja", 3.6, 1.1) + rnorm(2 * n_g, 0, 3.0), 1)
p4 <- data.frame(id = 1:(2 * n_g), grupa, masa_0, masa_12, talia_0, talia_12)
p4$zmiana_masy <- p4$masa_12 - p4$masa_0
p4$zmiana_proc <- 100 * p4$zmiana_masy / p4$masa_0

# Opis: średnie i SD w grupach w obu pomiarach
aggregate(cbind(masa_0, masa_12, talia_0, talia_12, zmiana_masy) ~ grupa, data = p4, FUN = function(x) round(mean(x), 2))
aggregate(cbind(masa_0, masa_12, talia_0, talia_12, zmiana_masy) ~ grupa, data = p4, FUN = function(x) round(sd(x), 2))
# Zmiana w każdej grupie osobno: test t dla prób zależnych i d_z
for (g in levels(p4$grupa)) {
  d <- subset(p4, grupa == g)
  tt <- t.test(d$masa_12, d$masa_0, paired = TRUE)
  cat(g, ": t(", tt$parameter, ") = ", round(tt$statistic, 2), ", p = ", format(tt$p.value, digits = 3, scientific = TRUE),
      ", zmiana = ", round(tt$estimate, 2), " [", round(tt$conf.int[1], 2), ", ", round(tt$conf.int[2], 2), "]\n", sep = "")
  dz <- repeated_measures_d(d$masa_12, d$masa_0, method = "z"); print(round(unlist(as.data.frame(dz)[, c(1, 3, 4)]), 2))
}
# Porównanie grup: ANCOVA (masa po ~ grupa + masa przed)
m4 <- lm(masa_12 ~ masa_0 + grupa, data = p4)
round(cbind(b = coef(m4), confint(m4), p = summary(m4)$coefficients[, 4]), 3)
anova(m4)
round(unlist(as.data.frame(eta_squared(car::Anova(m4, type = 2), partial = TRUE))[2, c(2, 4, 5)]), 3)
emmeans(m4, ~ grupa)
# Dla porównania: test Welcha na wynikach zmiany (change scores)
t.test(zmiana_masy ~ grupa, data = p4)
# Obwód talii: ta sama ANCOVA
m4t <- lm(talia_12 ~ talia_0 + grupa, data = p4)
round(cbind(b = coef(m4t), confint(m4t), p = summary(m4t)$coefficients[, 4]), 3)
# Założenie: równoległość nachyleń (interakcja masa_0 × grupa)
anova(m4, lm(masa_12 ~ masa_0 * grupa, data = p4))
# Odsetek osób, które schudły co najmniej 5% (próg przyjęty w tym przykładzie, opis pomocniczy)
tab5 <- table(p4$grupa, p4$zmiana_proc <= -5); tab5
round(100 * prop.table(tab5, 1), 1)
Wynik w R
        grupa masa_0 masa_12 talia_0 talia_12 zmiana_masy
1    kontrola  89.78   88.31  101.93   100.91       -1.47
2 interwencja  89.66   86.22  101.71    98.00       -3.44
        grupa masa_0 masa_12 talia_0 talia_12 zmiana_masy
1    kontrola  10.79   11.77    7.69     7.88        2.31
2 interwencja  11.29   12.41    8.24     8.74        3.42
kontrola: t(41) = -4.11, p = 1.84e-04, zmiana = -1.47 [-2.19, -0.75]
    d_z  CI_low CI_high
  -0.62   -0.95   -0.30
interwencja: t(41) = -6.52, p = 7.9e-08, zmiana = -3.44 [-4.5, -2.37]
    d_z  CI_low CI_high
  -0.99   -1.35   -0.62
                      b   2.5 % 97.5 %     p
(Intercept)      -7.294 -12.452 -2.135 0.006
masa_0            1.065   1.008  1.122 0.000
grupainterwencja -1.964  -3.199 -0.728 0.002
Analysis of Variance Table

Response: masa_12
          Df  Sum Sq Mean Sq F value    Pr(>F)
masa_0     1 11348.7 11348.7  1401.5 < 2.2e-16 ***
grupa      1    81.0    81.0    10.0  0.002203 **
Residuals 81   655.9     8.1
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Eta2_partial       CI_low      CI_high
       0.110        0.026        1.000
 grupa       emmean    SE df lower.CL upper.CL
 kontrola      88.2 0.439 81     87.4     89.1
 interwencja   86.3 0.439 81     85.4     87.2

Confidence level used: 0.95

	Welch Two Sample t-test

data:  zmiana_masy by grupa
t = 3.0965, df = 72.019, p-value = 0.00279
alternative hypothesis: true difference in means between group kontrola and group interwencja is not equal to 0
95 percent confidence interval:
 0.7022722 3.2405849
sample estimates:
   mean in group kontrola mean in group interwencja
                -1.466667                 -3.438095

                      b  2.5 % 97.5 %     p
(Intercept)       0.580 -7.326  8.486 0.884
talia_0           0.984  0.907  1.061 0.000
grupainterwencja -2.696 -3.911 -1.482 0.000
Analysis of Variance Table

Model 1: masa_12 ~ masa_0 + grupa
Model 2: masa_12 ~ masa_0 * grupa
  Res.Df    RSS Df Sum of Sq      F Pr(>F)
1     81 655.88
2     80 655.43  1   0.45213 0.0552 0.8149

              FALSE TRUE
  kontrola       36    6
  interwencja    24   18

              FALSE TRUE
  kontrola     85.7 14.3
  interwencja  57.1 42.9
4. Projekt 5: błąd pomiaru obwodu talii i plik do pobrania
R
# Projekt 5: błąd pomiaru antropometrycznego – dwukrotny pomiar obwodu talii u 30 osób przez tę samą osobę badającą
# (dane symulowane); TEM, względny TEM, współczynnik rzetelności R i ICC; na końcu zapis pliku XLSX do pobrania.
suppressPackageStartupMessages({ library(psych); library(openxlsx) })
set.seed(6704)
n <- 30
prawdziwy <- rnorm(n, 84, 11)
pomiar1 <- round(prawdziwy + rnorm(n, 0, 1.1), 1)
pomiar2 <- round(prawdziwy + rnorm(n, 0, 1.1), 1)
p5 <- data.frame(id = 1:n, talia_pomiar1 = pomiar1, talia_pomiar2 = pomiar2)
d <- p5$talia_pomiar1 - p5$talia_pomiar2
TEM <- sqrt(sum(d^2) / (2 * n))
srednia <- mean(c(p5$talia_pomiar1, p5$talia_pomiar2))
SD_all <- sd(c(p5$talia_pomiar1, p5$talia_pomiar2))
R <- 1 - TEM^2 / SD_all^2
round(c(TEM_cm = TEM, TEM_proc = 100 * TEM / srednia, R = R, roznica_M = mean(d)), 3)
ic <- ICC(p5[, 2:3]); ic$results[c(1, 2), c(1, 2, 7, 8)]

# Plik XLSX z danymi wszystkich projektów (autor w metadanych: Metodolog.pl)
invisible(capture.output({ source("b67-1-nawyki-bmi.R"); source("b67-2-ffq-walidacja.R"); source("b67-3-interwencja-przed-po.R") }))
wb <- createWorkbook(creator = "Metodolog.pl")
for (a in list(list("1-2_nawyki_bmi", p1[, c("id", "plec", "warzywa", "sniadanie", "aktywnosc_min", "wzrost_cm", "masa_kg", "bmi")]),
               list("3_ffq_zapis", p3), list("4_interwencja", p4[, 1:6]), list("5_powtorny_pomiar", p5))) {
  addWorksheet(wb, a[[1]]); writeData(wb, a[[1]], a[[2]])
}
addWorksheet(wb, "opis")
writeData(wb, "opis", c("Dane symulowane (R, set.seed 6701–6704) – metodolog.pl, wpis „Statystyka w pracy z dietetyki”.",
                       "1-2_nawyki_bmi: warzywa = częstość spożycia (3 kategorie); aktywnosc_min = minuty aktywności tygodniowo; bmi = masa / wzrost^2.",
                       "3_ffq_zapis: spożycie błonnika (g/dzień) z kwestionariusza częstości (FFQ) i z 3-dniowego zapisu.",
                       "4_interwencja: masa ciała (kg) i obwód talii (cm) przed (_0) i po 12 tygodniach (_12).",
                       "5_powtorny_pomiar: dwa pomiary obwodu talii (cm) u tych samych osób."))
saveWorkbook(wb, "../statystyka-dietetyka-dane-przyklad.xlsx", overwrite = TRUE)
spr <- readxl::excel_sheets("../statystyka-dietetyka-dane-przyklad.xlsx"); spr
sapply(spr[1:4], function(a) nrow(readxl::read_excel("../statystyka-dietetyka-dane-przyklad.xlsx", sheet = a)))
openxlsx::getCreators(loadWorkbook("../statystyka-dietetyka-dane-przyklad.xlsx"))
Wynik w R
   TEM_cm  TEM_proc         R roznica_M
    1.292     1.520     0.988    -0.580
                       type       ICC lower bound upper bound
Single_raters_absolute ICC1 0.9884531   0.9761011   0.9944646
Single_random_raters   ICC2 0.9884577   0.9752812   0.9945554
[1] "1-2_nawyki_bmi"    "3_ffq_zapis"       "4_interwencja"     "5_powtorny_pomiar" "opis"
   1-2_nawyki_bmi       3_ffq_zapis     4_interwencja 5_powtorny_pomiar
              240                90                84                30
[1] "Metodolog.pl"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje chisq.test(), wilcox.test(), cor.test(), t.test(), lm() i glm() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizach prac z dietetyki
- Dwa testy t „przed i po” zamiast porównania grup. Istotny spadek masy w grupie interwencyjnej nie dowodzi skuteczności, jeśli masa spadła także w grupie kontrolnej. Porównaj grupy ANCOVA.
- Kategorie BMI jako jedyna zmienna w testach. Analizuj BMI ciągłe, a kategorie pokazuj opisowo (Bennette i Vickers, 2012).
- Progi BMI dorosłych u dzieci i nastolatków. U dzieci i młodzieży ocenia się BMI względem wieku i płci, np. według kryteriów WHO dla odpowiedniej grupy wieku albo siatek centylowych wskazanych przez promotora.
- Korelacja jako jedyny dowód zgodności metod. Wysokie ρ między FFQ a zapisem nie oznacza, że metody dają te same wartości. Dodaj wykres Blanda–Altmana i klasyfikację do tercyli.
- Średnia z kategorii częstości („raz w tygodniu” = 2, „codziennie” = 4) bez opublikowanego klucza przeliczania.
- Deklarowana masa i wzrost opisane jak pomiar. Napisz, skąd pochodzą dane, i uwzględnij to w ograniczeniach.
- Brak oceny błędu pomiaru w pracach z pomiarami antropometrycznymi. Kilkanaście powtórzonych pomiarów wystarczy, żeby policzyć TEM.
- Dziesiątki testów bez hipotez na każdym pytaniu ankiety żywieniowej.
- Wnioski przyczynowe z ankiety przekrojowej, np. „śniadania obniżają BMI”.
Uporządkowany opis wszystkich zmiennych przed analizą ułatwia poradnik statystyki opisowe w pracy.
Najczęstsze pytania
Jakie testy statystyczne wybrać do pracy licencjackiej z dietetyki?
Zależy to od rodzaju danych. Pytania o częstość spożycia to dane porządkowe, więc porównasz je testem chi-kwadrat albo testem Manna–Whitneya. BMI, masę ciała i spożycie w gramach analizuj testem t Welcha, ANOVA albo regresją wieloraką. Pomiary przed i po u tych samych osób wymagają testu t dla prób zależnych, a porównanie dwóch grup w badaniu interwencyjnym – ANCOVA z pomiarem wyjściowym.
Czy w pracy z dietetyki analizować BMI jako liczbę czy kategorie?
Hipotezy testuj na BMI jako liczbie, np. regresją wieloraką, bo podział na kategorie gubi informację: osoba z BMI 25.1 trafia do tej samej grupy co osoba z BMI 29.9. Kategorie według progów WHO (u dorosłych 25 i 30 kg/m²) pokaż w tabeli opisowej z odsetkami i 95% CI. U dzieci i młodzieży stosuje się BMI względem wieku i płci.
Jak sprawdzić trafność kwestionariusza częstości spożycia w pracy magisterskiej?
Porównaj FFQ z inną metodą u tych samych osób, np. z kilkudniowym zapisem jadłospisu. Policz korelację Spearmana, odsetek osób zaklasyfikowanych do tej samej i przeciwnej tercyli, kappę ważoną i średnią różnicę z granicami zgodności Blanda–Altmana. Sama korelacja nie wystarczy, bo nie mówi, czy metody dają te same wartości.
Masa spadła w obu grupach – czy dieta zadziałała?
Spadek w grupie kontrolnej jest typowy: wynika z udziału w badaniu, sezonowości i regresji do średniej. O skuteczności interwencji świadczy dopiero różnica między grupami, najlepiej oszacowana ANCOVA z masą wyjściową jako współzmienną. Podaj skorygowaną różnicę w kilogramach z 95% CI i η²p.
Co to jest TEM w pomiarach antropometrycznych?
TEM (technical error of measurement) to techniczny błąd pomiaru liczony z dwóch pomiarów tych samych osób: pierwiastek z sumy kwadratów różnic podzielonej przez 2n. Podaje się go w jednostkach pomiaru (np. cm) i jako odsetek średniej. Pokazuje, jakie zmiany u pojedynczej osoby można odróżnić od błędu pomiaru.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikStatystyka w pracy z pielęgniarstwa
Wiedza pacjentów, skale kliniczne, satysfakcja, edukacja przed i po i wypalenie personelu: plan analiz, testy, wielkość efektu, APA i kod R.
Czytaj →PoradnikStatystyka w pracy ze zdrowia publicznego
Chorobowość z CI, iloraz szans a iloraz chorobowości, standaryzacja względem wieku, ważenie próby i trend z rejestrów: analizy, APA i kod R.
Czytaj →PoradnikMEDAS – jak policzyć wynik
14 kryteriów punktu z publikacji PREDIMED, wynik 0–14, kategorie z cytowaniem, KR-20 a test–retest i porównanie grup – z przykładem w R.
Czytaj →PoradnikSCOFF – jak policzyć wynik
Pięć pytań tak/nie, wynik 0–5 i próg ≥ 2: przesiew, a nie rozpoznanie – z przykładem w R, PPV przy różnej częstości i wzorem opisu.
Czytaj →Piszesz pracę z dietetyki i nie wiesz, jak przeanalizować dane?
Pomożemy dobrać analizy do Twojego projektu, policzyć wyniki z wielkością efektu i wyjaśnić je tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bennette, C., & Vickers, A. (2012). Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents. BMC Medical Research Methodology, 12(1), Article 21. https://doi.org/10.1186/1471-2288-12-21 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1986). Statistical methods for assessing agreement between two methods of clinical measurement. The Lancet, 327(8476), 307–310. https://doi.org/10.1016/s0140-6736(86)90837-8
- Cade, J., Thompson, R., Burley, V., & Warm, D. (2002). Development, validation and utilisation of food-frequency questionnaires – a review. Public Health Nutrition, 5(4), 567–587. https://doi.org/10.1079/phn2001318 ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Lombard, M. J., Steyn, N. P., Charlton, K. E., & Senekal, M. (2015). Application and interpretation of multiple statistical tests to evaluate validity of dietary intake assessment methods. Nutrition Journal, 14(1), Article 40. https://doi.org/10.1186/s12937-015-0027-y ● Otwarty dostęp
- Masson, L. F., McNeill, G., Tomany, J. O., Simpson, J. A., Peace, H. S., Wei, L., Grubb, D. A., & Bolton-Smith, C. (2003). Statistical approaches for assessing the relative validity of a food-frequency questionnaire: Use of correlation coefficients and the kappa statistic. Public Health Nutrition, 6(3), 313–321. https://doi.org/10.1079/phn2002429 ● Otwarty dostęp
- Subar, A. F., Freedman, L. S., Tooze, J. A., Kirkpatrick, S. I., Boushey, C., Neuhouser, M. L., Thompson, F. E., Potischman, N., Guenther, P. M., Tarasuk, V., Reedy, J., & Krebs-Smith, S. M. (2015). Addressing current criticism regarding the value of self-report dietary data. The Journal of Nutrition, 145(12), 2639–2645. https://doi.org/10.3945/jn.115.219634 ● Otwarty dostęp
- Ulijaszek, S. J., & Kerr, D. A. (1999). Anthropometric measurement error and the assessment of nutritional status. British Journal of Nutrition, 82(3), 165–177. https://doi.org/10.1017/s0007114599001348 ● Otwarty dostęp
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Vickers, A. J., & Altman, D. G. (2001). Analysing controlled trials with baseline and follow up measurements. BMJ, 323(7321), 1123–1124. https://doi.org/10.1136/bmj.323.7321.1123 ● Otwarty dostęp
- World Health Organization. (2026). Obesity and overweight. https://www.who.int/news-room/fact-sheets/detail/obesity-and-overweight ● Otwarty dostęp
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bennette2012against, author={Bennette, Caroline and Vickers, Andrew}, title={{Against quantiles: Categorization of continuous variables in epidemiologic research, and its discontents}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={21}, doi={10.1186/1471-2288-12-21}}@article{bland1986statistical, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistical methods for assessing agreement between two methods of clinical measurement}}, journal={The Lancet}, year={1986}, volume={327}, number={8476}, pages={307--310}, doi={10.1016/s0140-6736(86)90837-8}}@article{cade2002development, author={Cade, Janet and Thompson, Rachel and Burley, Victoria and Warm, Daniel}, title={{Development, validation and utilisation of food-frequency questionnaires – a review}}, journal={Public Health Nutrition}, year={2002}, volume={5}, number={4}, pages={567--587}, doi={10.1079/phn2001318}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{lombard2015application, author={Lombard, Martani J. and Steyn, Nelia P. and Charlton, Karen E. and Senekal, Marjanne}, title={{Application and interpretation of multiple statistical tests to evaluate validity of dietary intake assessment methods}}, journal={Nutrition Journal}, year={2015}, volume={14}, number={1}, eid={40}, doi={10.1186/s12937-015-0027-y}}@article{masson2003statistical, author={Masson, L. F. and McNeill, G. and Tomany, J. O. and Simpson, J. A. and Peace, H. S. and Wei, L. and Grubb, D. A. and Bolton-Smith, C.}, title={{Statistical approaches for assessing the relative validity of a food-frequency questionnaire: Use of correlation coefficients and the kappa statistic}}, journal={Public Health Nutrition}, year={2003}, volume={6}, number={3}, pages={313--321}, doi={10.1079/phn2002429}}@article{subar2015addressing, author={Subar, Amy F. and Freedman, Laurence S. and Tooze, Janet A. and Kirkpatrick, Sharon I. and Boushey, Carol and Neuhouser, Marian L. and Thompson, Frances E. and Potischman, Nancy and Guenther, Patricia M. and Tarasuk, Valerie and Reedy, Jill and Krebs-Smith, Susan M.}, title={{Addressing current criticism regarding the value of self-report dietary data}}, journal={The Journal of Nutrition}, year={2015}, volume={145}, number={12}, pages={2639--2645}, doi={10.3945/jn.115.219634}}@article{ulijaszek1999anthropometric, author={Ulijaszek, Stanley J. and Kerr, Deborah A.}, title={{Anthropometric measurement error and the assessment of nutritional status}}, journal={British Journal of Nutrition}, year={1999}, volume={82}, number={3}, pages={165--177}, doi={10.1017/s0007114599001348}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{vickers2001analysing, author={Vickers, Andrew J. and Altman, Douglas G.}, title={{Analysing controlled trials with baseline and follow up measurements}}, journal={BMJ}, year={2001}, volume={323}, number={7321}, pages={1123--1124}, doi={10.1136/bmj.323.7321.1123}}@misc{who2026obesity, author={{World Health Organization}}, title={{Obesity and overweight}}, year={2026}, publisher={World Health Organization}, url={https://www.who.int/news-room/fact-sheets/detail/obesity-and-overweight}}