Typowe problemy badawcze w pracy z pedagogiki
Wiele prac z pedagogiki to badania sondażowe: opinie nauczycieli i rodziców o pracach domowych, ocenianiu czy współpracy szkoły z domem, porównania klas, szkół lub etapów edukacyjnych oraz związki między zmiennymi, np. częstością kontaktów z wychowawcą a oceną szkoły. Dane z takich badań są zwykle nominalne (wybór jednej odpowiedzi) albo porządkowe (odpowiedzi na skali Likerta), dlatego zamiast testu t i ANOVA częściej przydają się test chi-kwadrat i testy rangowe.
W tym poradniku pokazujemy pełną ścieżkę analizy na przykładzie ankiety wśród rodziców i nauczycieli (dane symulowane): od opisu odpowiedzi, przez porównania grup i tabele krzyżowe, po opis wyników w stylu APA. Wszystkie liczby pochodzą z kodu w sekcji Przykład w R. Tabela zbiera typowe pytania i pasujące do nich analizy; ogólną procedurę wyboru testu opisujemy w poradniku jak dobrać test statystyczny do hipotezy.
| Pytanie badawcze | Dane | Analiza | Wielkość efektu |
|---|---|---|---|
| Czy rodzice i nauczyciele różnią się w ocenie prac domowych? | pojedyncze stwierdzenie na skali 1–5, dwie grupy | test U Manna–Whitneya (przy kilku stwierdzeniach – z korektą Holma) | korelacja rangowo-dwuseryjna rrb |
| Czy ocena współpracy ze szkołą zależy od etapu edukacyjnego dziecka? | wynik skali, trzy grupy | test Kruskala–Wallisa i test Dunna (albo ANOVA) | ε² |
| Czy częstość kontaktów z wychowawcą wiąże się z oceną współpracy? | dwie zmienne porządkowe | korelacja Spearmana | rs |
| Czy preferowana forma kontaktu zależy od grupy respondentów? | dwie zmienne nominalne | test chi-kwadrat, przy małych liczebnościach test Fishera | V Craméra, iloraz szans |
| Czy nowy program poprawia wyniki uczniów? | wyniki testu uczniów z kilku klas | model wielopoziomowy | różnica średnich z 95% CI, ICC |
Przykładowe badanie: ankieta wśród rodziców i nauczycieli
W przykładzie ankietę wypełniło 240 rodziców i 96 nauczycieli szkół podstawowych. Obie grupy oceniły na skali od 1 („zdecydowanie się nie zgadzam”) do 5 („zdecydowanie się zgadzam”) pięć stwierdzeń:
- P1. Prace domowe pomagają uczniom utrwalić wiedzę.
- P2. Liczba zadawanych prac domowych jest odpowiednia.
- P3. Szkoła wystarczająco często informuje o postępach ucznia.
- P4. Dziennik elektroniczny ułatwia kontakt szkoły z rodzicami.
- P5. Rodzice mają realny wpływ na decyzje szkoły.
Obie grupy wskazały też preferowaną formę kontaktu szkoły z domem (dziennik elektroniczny, spotkanie w szkole, telefon lub e-mail). Rodzice dodatkowo podali etap edukacyjny dziecka (klasy 1–3: 100 osób, 4–6: 90, 7–8: 50) i częstość kontaktów z wychowawcą (od „rzadziej niż raz w semestrze” do „co najmniej raz w miesiącu”), a także wypełnili czteropozycyjną skalę oceny współpracy ze szkołą. Problem główny brzmi: jak rodzice i nauczyciele oceniają prace domowe i współpracę szkoły z domem? Problemy szczegółowe dotyczą różnic między grupami, roli etapu edukacyjnego i związku kontaktów z oceną współpracy.
Jeśli szkoły wybierasz celowo, a ankietę wypełniają osoby, które zgodziły się wziąć udział, stosujesz dobór celowy lub wygodny, więc wnioski dotyczą badanych szkół, a nie „rodziców w Polsce”. Napisz o tym w rozdziale metodologicznym, a o budowie samego kwestionariusza przeczytasz w poradnikach jak zrobić ankietę do pracy dyplomowej i najczęstsze błędy w ankietach.
Dane nominalne, porządkowe i wyniki skal – co liczyć
Zanim wybierzesz test, ustal poziom pomiaru każdej zmiennej. Od tego zależy, jakie statystyki opisowe i testy mają sens.
| Rodzaj danych | Przykład z ankiety | Opis | Porównania i związki |
|---|---|---|---|
| nominalne | preferowana forma kontaktu, grupa respondentów | liczebności i procenty | chi-kwadrat, test Fishera, V Craméra |
| porządkowe | pojedyncze stwierdzenie P1–P5, częstość kontaktów | rozkład procentowy, mediana, kwartyle | test Manna–Whitneya, Kruskala–Wallisa, korelacja Spearmana |
| wynik skali (średnia kilku pozycji) | ocena współpracy ze szkołą (W1–W4) | M, SD (przy skośnym rozkładzie także mediana) | testy rangowe albo – przy wielu pozycjach i rozkładzie zbliżonym do normalnego – test t i ANOVA |
Sullivan i Artino (2013) przypominają, że odpowiedzi na pojedynczą pozycję skali Likerta są porządkowe i lepiej opisywać je medianą i rozkładem częstości, natomiast do wyników skal złożonych z kilku pozycji można stosować testy parametryczne, jeśli łączenie pozycji uzasadniają dowody rzetelności lub struktury. W przykładzie wynik skali współpracy (średnia czterech pozycji 1–5) przyjmuje tylko 17 możliwych wartości, dlatego porównujemy go testami rangowymi. Przegląd testów nieparametrycznych i ich założeń znajdziesz w słowniku.
Rzetelność skali – tylko dla zestawu pozycji mierzących jedno
Rzetelność ocenia się dla skali, czyli zestawu pozycji mierzących ten sam konstrukt. Czteropozycyjna skala oceny współpracy miała wśród rodziców α Cronbacha = .86 i ω McDonalda = .87. Dunn i in. (2014) proponują ω jako praktyczną alternatywę dla α, łatwą do policzenia w darmowym oprogramowaniu; więcej o obu współczynnikach piszemy w poradniku alfa Cronbacha: jak oceniać rzetelność skali i w haśle omega McDonalda. Średni wynik skali wyniósł 3.44 (SD = 0.92, mediana 3.50), a wynik co najmniej 4 uzyskało 32.9% rodziców.
Nie licz α dla stwierdzeń P1–P5. Dotyczą one różnych spraw (prac domowych, informowania, dziennika, wpływu rodziców), więc nie tworzą skali i analizuje się je osobno. Wysoka lub niska α dla przypadkowego zestawu pytań nic nie mówi o jakości pomiaru.
Jak pokazać odpowiedzi na skali Likerta
Pojedyncze stwierdzenie opisz rozkładem odpowiedzi w każdej grupie. W tabeli każdy wiersz to jedna grupa, procenty sumują się w wierszu do 100, a obok procentów lub w nagłówku podajesz liczebność. Przykład dla stwierdzenia P2:
| Grupa | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| Rodzice (n = 240) | 37 (15.4%) | 63 (26.2%) | 63 (26.2%) | 65 (27.1%) | 12 (5.0%) |
| Nauczyciele (n = 96) | 4 (4.2%) | 10 (10.4%) | 26 (27.1%) | 43 (44.8%) | 13 (13.5%) |
Przy kilku stwierdzeniach czytelniejszy od tabel jest wykres. Heiberger i Robbins (2014) zalecają skumulowane słupki rozbieżne jako podstawowy sposób prezentacji skal Likerta: odpowiedzi „na nie” odkłada się w lewo od zera, „na tak” – w prawo, a odpowiedzi neutralne dzieli się po połowie. Taki wykres słupkowy od razu pokazuje, gdzie przeważa zgoda, a gdzie jej brak (rysunek 1).
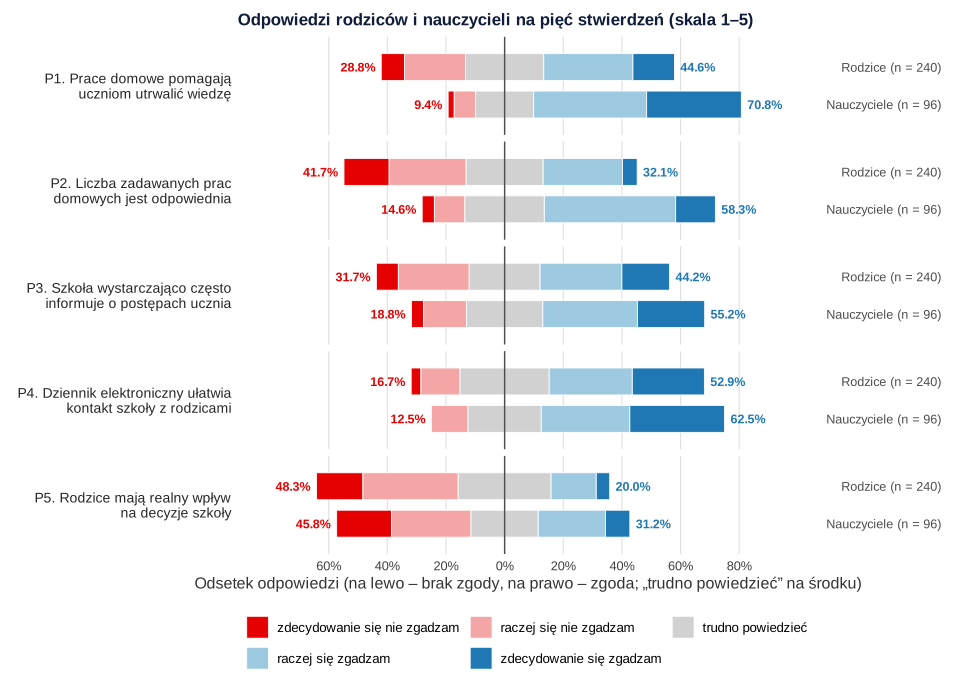
Nauczyciele częściej niż rodzice zgadzali się ze wszystkimi stwierdzeniami. Największe różnice dotyczą prac domowych: z P1 zgodziło się 70.8% nauczycieli i 44.6% rodziców, a z P2 – 58.3% i 32.1%. Najmniej zgody budziło P5: z tym, że rodzice mają realny wpływ na decyzje szkoły, zgodziło się 20.0% rodziców i 31.2% nauczycieli. Czy te różnice są większe, niż mogłaby dać przypadkowa zmienność, sprawdzisz testem.
Rodzice a nauczyciele: test U Manna–Whitneya i korekta Holma
Dwie niezależne grupy i odpowiedzi porządkowe to sytuacja dla testu U Manna–Whitneya. Jako wielkość efektu podaj korelację rangowo-dwuseryjną rrb, którą Kerby (2014) proponuje liczyć „wzorem prostej różnicy”: to odsetek par (nauczyciel, rodzic), w których nauczyciel zgadza się bardziej, minus odsetek par odwrotnych. Ponieważ wykonujesz pięć testów jednego problemu badawczego, skoryguj wartości p. Metoda Holma (1979) zapewnia z góry ustaloną ochronę przed błędem I rodzaju dla całej rodziny testów, a nigdy nie odrzuca mniej hipotez niż zwykła korekta Bonferroniego.
| Stwierdzenie | Mdn rodzice | Mdn nauczyciele | U | p | p (Holm) | rrb [95% CI] |
|---|---|---|---|---|---|---|
| P1. Prace domowe utrwalają wiedzę | 3 | 4 | 7609.5 | < .001 | < .001 | .34 [.21, .45] |
| P2. Liczba prac domowych jest odpowiednia | 3 | 4 | 7413.5 | < .001 | < .001 | .36 [.23, .47] |
| P3. Szkoła informuje o postępach | 3 | 4 | 9677.5 | .018 | .055 | .16 [.02, .29] |
| P4. Dziennik ułatwia kontakt | 4 | 4 | 10127.5 | .073 | .146 | .12 [−.02, .25] |
| P5. Rodzice mają wpływ na decyzje | 3 | 3 | 10801.0 | .356 | .356 | .06 [−.07, .20] |
Po korekcie istotne pozostały różnice w ocenie prac domowych (P1 i P2). rrb = .36 dla P2 oznacza, że par, w których nauczyciel zgadzał się bardziej niż rodzic, było o 36 punktów procentowych więcej niż par odwrotnych. Różnica w P3 była istotna bez korekty (p = .018), ale nie po niej (p = .055). Właśnie dlatego o korekcie decydujesz przed analizą, a w pracy podajesz obie wartości p. Mediany pojedynczych pozycji często są sobie równe (P4: 4 i 4), choć rozkłady się różnią – dlatego test Manna–Whitneya nie jest po prostu testem median.
Trzy grupy i więcej: test Kruskala–Wallisa i porównania post hoc
Czy ocena współpracy ze szkołą zależy od etapu edukacyjnego dziecka? Trzy niezależne grupy rodziców porównasz testem Kruskala–Wallisa, czyli rangowym odpowiednikiem jednoczynnikowej ANOVA. Kruskal i Wallis (1952) pokazali, że ich statystyka H ma w przybliżeniu rozkład χ² z k − 1 stopniami swobody. Mediany oceny wynosiły 3.50 w klasach 1–3 (kwartyle 3.25 i 4.00), 3.50 w klasach 4–6 (2.75 i 4.25) i 3.00 w klasach 7–8 (2.25 i 4.00). Różnica była istotna, H(2) = 7.11, p = .029, ale mała: ε² = .03, 95% CI [.01, .10].
Istotny wynik mówi tylko, że gdzieś jest różnica. Którą parę grup ją tworzy, sprawdzają testy post hoc. Po teście Kruskala–Wallisa można zastosować test Dunna (1964), który porównuje sumy rang ze wspólnego rangowania wszystkich grup. Po korekcie Holma istotna była tylko różnica między klasami 1–3 a 7–8, z = −2.67, p = .023: rodzice najstarszych uczniów oceniali współpracę niżej niż rodzice najmłodszych. Porównania 1–3 z 4–6 (p = .309) i 4–6 z 7–8 (p = .150) były nieistotne.
Uwaga na „porównania szkół”. Jeśli porównujesz trzy konkretne szkoły, wynik opisuje te szkoły. Jeśli chcesz mówić o szkołach wiejskich i miejskich w ogóle, potrzebujesz wielu szkół i analizy, która uwzględnia, że respondenci z jednej szkoły są do siebie podobni – wracamy do tego w części o uczniach w klasach.
Związek dwóch zmiennych porządkowych: korelacja Spearmana
Częstość kontaktów z wychowawcą ma cztery uporządkowane kategorie, więc jej związek z oceną współpracy opisze korelacja Spearmana. Rodzice, którzy częściej kontaktowali się z wychowawcą, wyżej oceniali współpracę ze szkołą, rs = .22, 95% CI [.10, .34], p < .001. To słaby, dodatni związek monotoniczny. Nie wiadomo, w którą stronę działa: częste kontakty mogą poprawiać ocenę szkoły, ale równie dobrze rodzice zadowoleni ze współpracy mogą chętniej się kontaktować.
Tabela krzyżowa: test chi-kwadrat i V Craméra
Preferowana forma kontaktu i grupa respondentów to dwie zmienne nominalne. Ich związek pokazuje tabela krzyżowa, a sprawdza test chi-kwadrat. Franke i in. (2012) zwracają uwagę, że testy niezależności, jednorodności i zgodności z rodziny chi-kwadrat mają niemal ten sam wzór, ale odpowiadają na różne pytania i bywają błędnie interpretowane. Tutaj porównujesz rozkład odpowiedzi w dwóch grupach, więc formalnie to test jednorodności: czy rodzice i nauczyciele wybierają formy kontaktu w tych samych proporcjach?
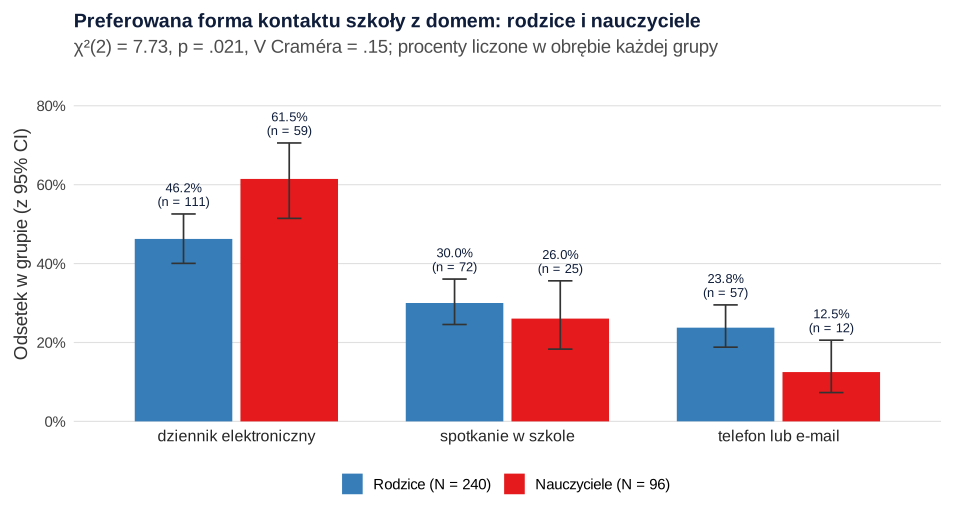
Dziennik elektroniczny wybrało 46.2% rodziców i 61.5% nauczycieli, spotkanie w szkole – 30.0% i 26.0%, a telefon lub e-mail – 23.8% i 12.5%. Rozkłady istotnie się różniły, χ²(2, N = 336) = 7.73, p = .021, V = .15. Warunek liczebności był spełniony: najmniejsza liczebność oczekiwana wynosiła 19.7. Kim (2017) przypomina, że najwyżej 20% komórek może mieć liczebność oczekiwaną mniejszą niż 5 i żadna nie może mieć mniejszej niż 1.
Gdzie leży różnica? Sharpe (2015) omawia cztery sposoby szukania źródła istotnego wyniku testu chi-kwadrat, w tym analizę reszt. Skorygowane reszty standaryzowane powyżej 1.96 co do modułu wskazują komórki, w których obserwacji jest więcej lub mniej, niż wynikałoby z braku związku. Tu takie komórki to dziennik elektroniczny (reszta 2.52 w grupie nauczycieli) oraz telefon lub e-mail (2.31 w grupie rodziców); dla spotkań w szkole reszta wynosiła 0.72.
Siłę związku opisuje V Craméra. Kim (2017) podaje progi interpretacji zależne od liczby stopni swobody; gdy jedna ze zmiennych ma dwie kategorie (tu: grupa respondentów), są to .10, .30 i .50, więc V = .15 oznacza związek słaby. Rysunek 2 pokazuje odsetki w obu grupach z 95% przedziałami ufności. Przedziały policzono metodą Wilsona, którą Brown i in. (2001) zalecają zamiast standardowego przedziału Walda, zwłaszcza przy małych liczebnościach.
Mała próba: test dokładny Fishera
Zdarza się, że badasz tylko nauczycieli jednej lub dwóch szkół. Przykład: w szkole A konsultacje online dla rodziców prowadziło 12 z 14 nauczycieli (85.7%), a w szkole B – 4 z 12 (33.3%). W takiej tabeli 2 × 2 najmniejsza liczebność oczekiwana wynosi 4.62, czyli jedna z czterech komórek (25%) nie spełnia warunku i R ostrzega, że przybliżenie chi-kwadrat może być niedokładne. Bezpiecznym wyborem jest wtedy test dokładny Fishera, który Kim (2017) wskazuje jako test przeznaczony zwłaszcza dla małych prób: p = .014, OR = 10.65, 95% CI [1.37, 145.22].
Ogromny przedział ufności ilorazu szans to uczciwa informacja: przy 26 osobach wiadomo tyle, że w szkole A konsultacje online są częstsze, ale nie wiadomo, o ile. Campbell (2007) porównał testy dla tabel 2 × 2 i zalecił test chi-kwadrat w wersji „N − 1”, gdy najmniejsza liczebność oczekiwana wynosi co najmniej 1, a test Fishera–Irwina w przeciwnym razie. W przykładzie test „N − 1” daje ten sam wniosek, χ²(1) = 7.20, p = .007. Wybór testu opisz w rozdziale metodologicznym przed podaniem wyników.
Jak pokazywać procenty w tabelach krzyżowych
Procenty łatwo pokazać tak, że wprowadzają w błąd. Kilka zasad:
- Licz procenty w kierunku porównania. Porównujesz grupy – licz procenty w obrębie każdej grupy (tu: w kolumnach), tak by sumowały się do 100 w grupie. Procenty w wierszach odpowiadają na inne pytanie: 65.3% osób wybierających dziennik to rodzice, ale wynika to głównie z tego, że rodziców było 240, a nauczycieli 96.
- Zawsze podawaj liczebności. 12.5% nauczycieli to 12 osób; bez n czytelnik nie oceni, czy procent opiera się na 8, czy na 800 odpowiedziach.
- Jedno miejsce po przecinku i opis zaokrągleń. Sumy mogą wynosić 99.9 lub 100.1 – zaznacz to w uwadze pod tabelą.
- Nie porównuj procentów „na oko”. Różnica 23.8% wobec 12.5% wygląda na dużą, ale o tym, czy wykracza poza przypadek, rozstrzyga test, a o jej precyzji – przedziały ufności.
- Pokaż braki odpowiedzi. Jeśli część osób pominęła pytanie, podaj ich liczbę albo N dla każdego pytania.
Tabela w stylu APA dla przykładu:
Tabela 1
Preferowana forma kontaktu szkoły z domem w grupach rodziców i nauczycieli
| Forma kontaktu | Rodzice | Nauczyciele | Ogółem | |||
|---|---|---|---|---|---|---|
| n | % | n | % | n | % | |
| Dziennik elektroniczny | 111 | 46.2 | 59 | 61.5 | 170 | 50.6 |
| Spotkanie w szkole | 72 | 30.0 | 25 | 26.0 | 97 | 28.9 |
| Telefon lub e-mail | 57 | 23.8 | 12 | 12.5 | 69 | 20.5 |
Uwaga. N = 336 (240 rodziców, 96 nauczycieli). Procenty obliczono w obrębie grup; z powodu zaokrągleń mogą nie sumować się do 100. Rozkłady w grupach różniły się istotnie, χ²(2, N = 336) = 7.73, p = .021, V = .15. Dane symulowane.
Uczniowie w klasach: ICC i model wielopoziomowy
Gdy badasz uczniów, pamiętaj, że uczniowie jednej klasy mają tego samego nauczyciela, ten sam plan lekcji i podobne doświadczenia, więc ich wyniki są do siebie bardziej podobne niż wyniki uczniów z różnych klas. Zwykłe testy zakładają niezależność obserwacji i w takich danych zaniżają błędy standardowe. Część wariancji przypadającą na różnice między klasami mierzy współczynnik korelacji wewnątrzklasowej (ICC).
Przykład (dane symulowane): 258 uczniów z 12 klas napisało test czytania ze zrozumieniem; 6 klas pracowało nowym programem, a 6 – standardowym, przy czym o programie decydowano dla całej klasy. Średnie wyniki wyniosły 26.65 i 24.15 punktu. ICC z modelu pustego wynosiło .175, więc przy średnio 21.5 ucznia w klasie efekt projektu (1 + (21.5 − 1) × ICC) wynosi 4.59, a efektywna liczebność próby to około 56, a nie 258 osób.
- Zwykły test t traktuje uczniów jak niezależne obserwacje: różnica 2.50 punktu, 95% CI [0.94, 4.06], t(256) = 3.15, p = .002.
- Model wielopoziomowy z losowym wyrazem wolnym dla klasy: b = 2.54, SE = 1.64, t(10.3) = 1.55, p = .152.
Ten sam wynik wygląda więc na „bardzo istotny”, dopóki nie uwzględnisz, że program przydzielono klasom, a nie uczniom. Radkiewicz i Zieliński (2010) w polskojęzycznym wprowadzeniu zalecają modele hierarchiczne właśnie wtedy, gdy naruszone jest założenie niezależności obserwacji. Przy kilkunastu klasach oszacowania są jednak mało precyzyjne, więc taki wynik traktuj ostrożnie. W pracy dyplomowej podaj co najmniej ICC i liczbę klas, a model opisz zgodnie z hasłem słownika.
Badania z udziałem dzieci: zgoda rodziców i szkoły
Ankieta wśród dorosłych – rodziców i nauczycieli – wymaga ich świadomej zgody. Badanie uczniów wymaga więcej. Wytyczne etyczne dla badań edukacyjnych Brytyjskiego Towarzystwa Badań Edukacyjnych (British Educational Research Association, 2024) wskazują, że:
- zasady świadomej zgody dotyczą także dzieci i młodzieży, a u osób poniżej wieku zgody prawnej mówi się o ich przyzwoleniu (ang. assent);
- trzeba uwzględnić prawa i obowiązki osób odpowiedzialnych za dziecko, co może oznaczać uzyskanie zgody rodziców lub opiekunów;
- materiały informacyjne i formularze należy dostosować m.in. do wieku i umiejętności czytania uczestników;
- przed kontaktem z uczestnikami warto zwrócić się do osób, które decydują o dostępie do instytucji (np. dyrekcji szkoły), i stosować jej procedury etyczne i ochronne;
- preferowana jest zgoda wyrażana aktywnie (opt-in); przy procedurze „kto nie odmówi, ten uczestniczy” (opt-out) trzeba sprawdzić lokalne prawo i praktykę.
Wymagania formalne obowiązujące Ciebie – czy potrzebna jest opinia komisji etycznej, jak ma wyglądać formularz zgody, jak przechowywać dane – sprawdź w regulaminie komisji etycznej swojej uczelni i uzgodnij z dyrekcją szkoły. Zasady informowania uczestników i ochrony danych osobowych opisujemy w haśle świadoma zgoda i RODO w badaniach. Pamiętaj też o anonimowości: w małej klasie wynik podany dla „chłopców z wadą wzroku” może wskazywać konkretne dziecko.
Jak opisać wyniki w stylu APA
Przy każdym teście podaj statystykę, stopnie swobody (jeśli są), dokładne p, wielkość efektu i opis kierunku różnicy. Wzory dla przykładu:
Zasady zapisu statystyk i więcej gotowych zdań znajdziesz w poradniku jak opisać wyniki w stylu APA, a przykład całego rozdziału – w poradniku wyniki badań własnych – przykładowy rozdział z komentarzem.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R – przepisy 2 i 3 korzystają z danych z przepisu 1, a przepis 4 tworzy własne dane. Rysunki na stronie przedstawiają te same dane narysowane w pakiecie ggplot2. W swojej pracy zastąp fragmenty tworzące dane symulowane wczytaniem własnego pliku.
1. Dane, rozkłady odpowiedzi i rzetelność skali
R
library(psych)   # alpha(), fa()

# Dane symulowane: ankieta wśród 240 rodziców i 96 nauczycieli szkół podstawowych.
# P1–P5: pięć stwierdzeń ocenianych na skali 1–5 (1 = zdecydowanie się nie zgadzam,
# 5 = zdecydowanie się zgadzam); forma: preferowana forma kontaktu szkoły z domem.
# Tylko rodzice: etap edukacyjny dziecka (klasy 1–3, 4–6, 7–8), częstość kontaktu
# z wychowawcą (1 = rzadziej niż raz w semestrze … 4 = co najmniej raz w miesiącu)
# i skala oceny współpracy ze szkołą (W1–W4). W swojej pracy wczytaj tu własny plik.
set.seed(3201)
lik <- function(lat, prog = c(-1.4, -0.5, 0.3, 1.2)) findInterval(lat + rnorm(length(lat), sd = 0.6), prog) + 1
n_r <- 240; n_n <- 96
grupa <- factor(rep(c("rodzic", "nauczyciel"), c(n_r, n_n)), levels = c("rodzic", "nauczyciel"))
naucz <- as.numeric(grupa == "nauczyciel")
przes <- c(P1 = 0.75, P2 = 0.55, P3 = 0.45, P4 = 0.08, P5 = 0.25)   # różnica nauczyciele – rodzice
baza <- c(P1 = 0.10, P2 = -0.35, P3 = 0.05, P4 = 0.55, P5 = -0.45)
ankieta <- data.frame(id = seq_along(grupa), grupa)
for (k in names(przes)) ankieta[[k]] <- lik(baza[k] + przes[k] * naucz + rnorm(length(grupa), sd = 0.8))
etap <- factor(sample(c("1–3", "4–6", "7–8"), n_r, TRUE, prob = c(.38, .34, .28)), levels = c("1–3", "4–6", "7–8"))
kontakt <- sample(1:4, n_r, TRUE, prob = c(.18, .32, .30, .20))
wsp_l <- 0.25 * (etap == "1–3") - 0.25 * (etap == "7–8") + 0.22 * (kontakt - 2.5) + rnorm(n_r, sd = 0.9)
W <- sapply(1:4, function(i) lik(0.85 * wsp_l + c(0, .1, -.1, .2)[i], prog = c(-1.6, -0.7, 0.2, 1.1)))
colnames(W) <- paste0("W", 1:4)
forma <- c(sample(1:3, n_r, TRUE, prob = c(.40, .35, .25)), sample(1:3, n_n, TRUE, prob = c(.63, .26, .11)))
ankieta$forma <- factor(forma, levels = 1:3, labels = c("dziennik elektroniczny", "spotkanie w szkole", "telefon lub e-mail"))
rodzice <- cbind(ankieta[ankieta$grupa == "rodzic", ], etap, kontakt, W)

# Krok 1: rozkład odpowiedzi – liczebności i odsetki w każdej grupie (przykład: P2)
table(ankieta$grupa)
table(ankieta$grupa, ankieta$P2)
round(100 * prop.table(table(ankieta$grupa, ankieta$P2), margin = 1), 1)
# odsetek odpowiedzi 4–5 („raczej” lub „zdecydowanie się zgadzam”) dla P1–P5
round(100 * sapply(ankieta[paste0("P", 1:5)], function(x) tapply(x >= 4, ankieta$grupa, mean)), 1)

# Krok 2: rzetelność skali oceny współpracy (rodzice, 4 pozycje)
alpha(rodzice[paste0("W", 1:4)])$total
jedno <- fa(rodzice[paste0("W", 1:4)], nfactors = 1, fm = "ml")
round(c(omega = sum(jedno$loadings)^2 / (sum(jedno$loadings)^2 + sum(jedno$uniquenesses))), 2)
rodzice$wspolpraca <- rowMeans(rodzice[paste0("W", 1:4)])
round(c(M = mean(rodzice$wspolpraca), SD = sd(rodzice$wspolpraca), Mdn = median(rodzice$wspolpraca)), 2)
table(rodzice$etap)
table(rodzice$kontakt)
Wynik w R
    rodzic nauczyciel
       240         96

              1  2  3  4  5
  rodzic     37 63 63 65 12
  nauczyciel  4 10 26 43 13

                1    2    3    4    5
  rodzic     15.4 26.2 26.2 27.1  5.0
  nauczyciel  4.2 10.4 27.1 44.8 13.5
             P1   P2   P3   P4   P5
rodzic     44.6 32.1 44.2 52.9 20.0
nauczyciel 70.8 58.3 55.2 62.5 31.2
 raw_alpha std.alpha   G6(smc) average_r     S/N        ase     mean        sd
 0.8647623 0.8646118 0.8292065 0.6148725 6.38617 0.01417739 3.442708 0.9151211
  median_r
 0.6195187
omega
 0.87
   M   SD  Mdn
3.44 0.92 3.50

1–3 4–6 7–8
100  90  50

 1  2  3  4
42 78 78 42
2. Mann–Whitney z korektą Holma, Kruskal–Wallis z testem Dunna, Spearman
R
library(effectsize)   # rank_biserial(), rank_epsilon_squared()
library(rstatix)      # dunn_test()
library(DescTools)    # SpearmanRho()

# Krok 3: rodzice a nauczyciele – test U Manna–Whitneya dla każdego stwierdzenia,
# korelacja rangowo-dwuseryjna (dodatnia = nauczyciele wyżej) i korekta Holma dla 5 testów
mw <- t(sapply(paste0("P", 1:5), function(k) {
  x <- ankieta[[k]]
  w <- wilcox.test(x ~ ankieta$grupa, exact = FALSE)
  rb <- rank_biserial(x[ankieta$grupa == "nauczyciel"], x[ankieta$grupa == "rodzic"])
  c(Mdn_rodzice = median(x[ankieta$grupa == "rodzic"]), Mdn_nauczyciele = median(x[ankieta$grupa == "nauczyciel"]),
    U = unname(w$statistic), p = w$p.value, r_rb = rb$r_rank_biserial, CI_dolna = rb$CI_low, CI_gorna = rb$CI_high)
}))
mw <- cbind(mw, p_Holm = p.adjust(mw[, "p"], method = "holm"))
round(mw, 3)

# Krok 4: rodzice – ocena współpracy a etap edukacyjny dziecka (test Kruskala–Wallisa)
tapply(rodzice$wspolpraca, rodzice$etap, median)
tapply(rodzice$wspolpraca, rodzice$etap, quantile, probs = c(.25, .75))
kruskal.test(wspolpraca ~ etap, data = rodzice)
rank_epsilon_squared(wspolpraca ~ etap, data = rodzice, alternative = "two.sided", iterations = 1000)
dunn_test(rodzice, wspolpraca ~ etap, p.adjust.method = "holm")   # porównania post hoc

# Krok 5: częstość kontaktu z wychowawcą a ocena współpracy (korelacja Spearmana)
cor.test(rodzice$kontakt, rodzice$wspolpraca, method = "spearman", exact = FALSE)
round(SpearmanRho(rodzice$kontakt, rodzice$wspolpraca, conf.level = .95), 2)
Wynik w R
Attaching package: ‘effectsize’

The following object is masked from ‘package:psych’:

    phi


Attaching package: ‘rstatix’

The following objects are masked from ‘package:effectsize’:

    cohens_d, eta_squared

The following object is masked from ‘package:stats’:

    filter


Attaching package: ‘DescTools’

The following objects are masked from ‘package:psych’:

    AUC, ICC, SD

   Mdn_rodzice Mdn_nauczyciele       U     p  r_rb CI_dolna CI_gorna p_Holm
P1           3               4  7609.5 0.000 0.339    0.213    0.454  0.000
P2           3               4  7413.5 0.000 0.356    0.232    0.470  0.000
P3           3               4  9677.5 0.018 0.160    0.024    0.290  0.055
P4           4               4 10127.5 0.073 0.121   -0.015    0.253  0.146
P5           3               3 10801.0 0.356 0.062   -0.074    0.197  0.356
1–3 4–6 7–8
3.5 3.5 3.0
$`1–3`
 25%  75%
3.25 4.00

$`4–6`
 25%  75%
2.75 4.25

$`7–8`
 25%  75%
2.25 4.00


	Kruskal-Wallis rank sum test

data:  wspolpraca by etap
Kruskal-Wallis chi-squared = 7.1116, df = 2, p-value = 0.02856

Epsilon2 (rank) |       95% CI
------------------------------
0.03            | [0.01, 0.10]
# A tibble: 3 × 9
  .y.        group1 group2    n1    n2 statistic       p  p.adj p.adj.signif
* <chr>      <chr>  <chr>  <int> <int>     <dbl>   <dbl>  <dbl> <chr>
1 wspolpraca 1–3    4–6      100    90     -1.02 0.309   0.309  ns
2 wspolpraca 1–3    7–8      100    50     -2.67 0.00767 0.0230 *
3 wspolpraca 4–6    7–8       90    50     -1.78 0.0751  0.150  ns

	Spearman's rank correlation rho

data:  rodzice$kontakt and rodzice$wspolpraca
S = 1794511, p-value = 0.0005596
alternative hypothesis: true rho is not equal to 0
sample estimates:
      rho
0.2211189

   rho lwr.ci upr.ci
  0.22   0.10   0.34
3. Tabele krzyżowe: chi-kwadrat, V Craméra, test Fishera
R
library(DescTools)   # BinomCI()

# Krok 6: tabela krzyżowa – preferowana forma kontaktu a grupa respondentów
tab <- table(ankieta$forma, ankieta$grupa)
addmargins(tab)
round(100 * prop.table(tab, margin = 2), 1)       # odsetki w kolumnach: w obrębie każdej grupy
test <- chisq.test(tab)
test
round(test$expected, 1)                           # liczebności oczekiwane (warunek: E ≥ 5)
round(test$stdres, 2)                             # skorygowane reszty standaryzowane
round(sqrt(unname(test$statistic) / (sum(tab) * (min(dim(tab)) - 1))), 3)   # V Craméra

# 95% przedziały ufności (Wilsona) dla odsetków w każdej grupie
for (g in colnames(tab)) {
  cat(g, "\n")
  print(round(100 * BinomCI(tab[, g], sum(tab[, g]), method = "wilson"), 1))
}

# Krok 7: mała próba – nauczyciele dwóch szkół (dane symulowane, n = 14 i n = 12):
# czy nauczyciel prowadzi konsultacje online dla rodziców (tak/nie)?
set.seed(3205)
szkola <- factor(rep(c("Szkoła A", "Szkoła B"), c(14, 12)))
online <- factor(rbinom(26, 1, ifelse(szkola == "Szkoła A", 0.80, 0.40)), levels = 1:0, labels = c("tak", "nie"))
tab2 <- table(szkola, online)
tab2
chi2 <- suppressWarnings(chisq.test(tab2, correct = FALSE))   # R ostrzega: przybliżenie może być niedokładne
round(chi2$expected, 2)                                       # liczebności oczekiwane: jedna komórka < 5
fisher.test(tab2)                                             # test dokładny Fishera
# wariant „N − 1” testu chi-kwadrat dla tabel 2 × 2: χ² × (N − 1) / N
chi2_n1 <- unname(chi2$statistic) * (sum(tab2) - 1) / sum(tab2)
round(c(chi2_N1 = chi2_n1, p = pchisq(chi2_n1, df = 1, lower.tail = FALSE)), 3)
Wynik w R
                         rodzic nauczyciel Sum
  dziennik elektroniczny    111         59 170
  spotkanie w szkole         72         25  97
  telefon lub e-mail         57         12  69
  Sum                       240         96 336

                         rodzic nauczyciel
  dziennik elektroniczny   46.2       61.5
  spotkanie w szkole       30.0       26.0
  telefon lub e-mail       23.8       12.5

	Pearson's Chi-squared test

data:  tab
X-squared = 7.733, df = 2, p-value = 0.02093


                         rodzic nauczyciel
  dziennik elektroniczny  121.4       48.6
  spotkanie w szkole       69.3       27.7
  telefon lub e-mail       49.3       19.7

                         rodzic nauczyciel
  dziennik elektroniczny  -2.52       2.52
  spotkanie w szkole       0.72      -0.72
  telefon lub e-mail       2.31      -2.31
[1] 0.152
rodzic
                        est lwr.ci upr.ci
dziennik elektroniczny 46.2   40.1   52.6
spotkanie w szkole     30.0   24.6   36.1
telefon lub e-mail     23.8   18.8   29.5
nauczyciel
                        est lwr.ci upr.ci
dziennik elektroniczny 61.5   51.5   70.6
spotkanie w szkole     26.0   18.3   35.6
telefon lub e-mail     12.5    7.3   20.6
          online
szkola     tak nie
  Szkoła A  12   2
  Szkoła B   4   8
          online
szkola      tak  nie
  Szkoła A 8.62 5.38
  Szkoła B 7.38 4.62

	Fisher's Exact Test for Count Data

data:  tab2
p-value = 0.01378
alternative hypothesis: true odds ratio is not equal to 1
95 percent confidence interval:
   1.371149 145.217849
sample estimates:
odds ratio
  10.65227

chi2_N1       p
  7.202   0.007
4. Uczniowie w klasach: ICC i model wielopoziomowy
R
library(lme4)       # lmer()
library(lmerTest)   # wartości p dla efektów stałych (stopnie swobody Satterthwaite’a)

# Dane symulowane: wynik testu czytania ze zrozumieniem (0–40) uczniów z 12 klas;
# 6 klas pracowało nowym programem, 6 – standardowym (o programie decydowano dla całej klasy)
set.seed(3279)
k <- 12
m <- sample(18:25, k, replace = TRUE)                        # liczba uczniów w klasach
klasa <- factor(rep(sprintf("K%02d", 1:k), m))
program <- factor(rep(rep(c("standardowy", "nowy"), each = k / 2), m), levels = c("standardowy", "nowy"))
u <- rnorm(k, 0, 2.6)[as.integer(klasa)]                     # różnice między klasami
wynik <- pmin(pmax(round(24 + 2.0 * (program == "nowy") + u + rnorm(sum(m), 0, 6)), 0), 40)
uczniowie <- data.frame(klasa, program, wynik)
table(uczniowie$program)
round(tapply(uczniowie$wynik, uczniowie$program, mean), 2)

# ICC z modelu pustego i efekt projektu (design effect) przy średniej liczebności klasy
m0 <- lmer(wynik ~ 1 + (1 | klasa), data = uczniowie)
vc <- as.data.frame(VarCorr(m0))
icc <- vc$vcov[1] / sum(vc$vcov)
deff <- 1 + (mean(m) - 1) * icc
round(c(ICC = icc, sr_liczebnosc_klasy = mean(m), DEFF = deff, n_efektywne = nrow(uczniowie) / deff), 3)

# Błąd: zwykły test t traktuje wszystkich uczniów jak niezależne obserwacje
t.test(wynik ~ program, data = uczniowie, var.equal = TRUE)
# Lepiej: model wielopoziomowy z losowym wyrazem wolnym dla klasy
m1 <- lmer(wynik ~ program + (1 | klasa), data = uczniowie)
summary(m1)$coefficients
Wynik w R
Loading required package: Matrix
Registered S3 method overwritten by 'lme4':
  method           from
  na.action.merMod car

Attaching package: ‘lmerTest’

The following object is masked from ‘package:lme4’:

    lmer

The following object is masked from ‘package:stats’:

    step


standardowy        nowy
        128         130
standardowy        nowy
      24.15       26.65
                ICC sr_liczebnosc_klasy                DEFF         n_efektywne
              0.175              21.500               4.594              56.155

	Two Sample t-test

data:  wynik by program
t = -3.149, df = 256, p-value = 0.001833
alternative hypothesis: true difference in means between group standardowy and group nowy is not equal to 0
95 percent confidence interval:
 -4.0597244 -0.9357083
sample estimates:
mean in group standardowy        mean in group nowy
                 24.14844                  26.64615

             Estimate Std. Error       df   t value     Pr(>|t|)
(Intercept) 24.235323   1.160599 10.36303 20.881731 8.320064e-10
programnowy  2.535905   1.639655 10.32361  1.546609 1.520419e-01
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Procenty bez liczebności. „75% nauczycieli uważa…” może znaczyć 3 z 4 osób. Podawaj n i N przy każdym procencie albo w nagłówku tabeli.
- Porównywanie procentów bez testu. Różnica procentów w próbie to nie dowód różnicy w populacji. Sprawdź ją testem chi-kwadrat lub Fishera i pokaż przedziały ufności.
- Procenty liczone w złym kierunku. Gdy grupy mają różną liczebność, procenty w wierszach opisują skład kategorii, a nie preferencje grup.
- Średnia z pojedynczej pozycji jako jedyny opis. Średnia 3.1 może oznaczać zgodną opinię albo silną polaryzację. Pokaż rozkład odpowiedzi.
- α dla zestawu niepowiązanych pytań. Rzetelność liczy się dla skali mierzącej jeden konstrukt, a nie dla całej ankiety.
- Wiele testów bez korekty albo korekta dobierana po fakcie. Ustal rodziny testów przed analizą i stosuj tę samą metodę, np. Holma, w całej pracy.
- Ignorowanie zagnieżdżenia. Uczniowie z jednej klasy nie są niezależnymi obserwacjami; zwykły test może wskazać „istotny” efekt, którego model wielopoziomowy nie potwierdza.
- Test chi-kwadrat przy zbyt małych liczebnościach oczekiwanych. Sprawdź liczebności oczekiwane, a gdy są za małe, użyj testu Fishera albo połącz kategorie, jeśli ma to sens merytoryczny.
- Mylenie istotności z siłą związku. Przy dużej próbie nawet słaby związek bywa istotny – zawsze podawaj V, rrb lub ε².
- Język przyczynowy i uogólnianie. Korelacja kontaktów z oceną szkoły nie dowodzi, że kontakty poprawiają ocenę, a wyniki z kilku szkół dobranych celowo nie opisują „polskiej szkoły”.
Jeśli chcesz, żeby ktoś sprawdził dobór testów, przygotował analizę i wyjaśnił Ci wyniki, zobacz ofertę analiz statystycznych dla studentów – obejmuje ona m.in. analizę danych z różnych kierunków. Wyniki musisz rozumieć i umieć obronić, a pomoc w analizie ujawnij zgodnie z zasadami swojej uczelni. Podobny przewodnik dla studentów zarządzania i ekonomii znajdziesz we wpisie statystyka w pracy z zarządzania i ekonomii.
Najczęstsze pytania
Jakie testy statystyczne stosuje się w pracy z pedagogiki?
Najczęściej testy dla danych nominalnych i porządkowych: test chi-kwadrat z V Craméra i test Fishera dla tabel krzyżowych, test U Manna–Whitneya dla dwóch grup, test Kruskala–Wallisa z testem Dunna dla trzech i więcej grup oraz korelację Spearmana. Wyniki skal złożonych z wielu pozycji można też analizować testem t, ANOVA lub regresją, a dane uczniów z kilku klas – modelem wielopoziomowym.
Kiedy w pracy z pedagogiki użyć testu chi-kwadrat, a kiedy testu Fishera?
Test chi-kwadrat wymaga odpowiednio dużych liczebności oczekiwanych: najwyżej 20% komórek może mieć liczebność oczekiwaną mniejszą niż 5 i żadna mniejszą niż 1. Gdy ten warunek nie jest spełniony, zwłaszcza w tabeli 2 × 2 przy kilkunastu lub kilkudziesięciu osobach, użyj testu dokładnego Fishera. Liczebności oczekiwane podaje chisq.test()$expected w R.
Jak przedstawić w procentach wyniki ankiety wśród rodziców i nauczycieli?
Licz procenty w obrębie każdej porównywanej grupy, tak żeby sumowały się do 100 w grupie, i zawsze podawaj liczebności (n i N). Używaj jednego miejsca po przecinku i zaznacz w uwadze pod tabelą, że z powodu zaokrągleń sumy mogą nie wynosić dokładnie 100. Różnicę procentów między grupami sprawdź testem chi-kwadrat lub Fishera, zamiast oceniać ją „na oko”.
Czy na badanie ankietowe uczniów potrzebna jest zgoda rodziców?
Zwykle tak. Wytyczne etyczne British Educational Research Association (2024) wskazują, że zasady zgody dotyczą także dzieci, trzeba uwzględnić prawa osób odpowiedzialnych za dziecko, co może oznaczać zgodę rodziców lub opiekunów, a przed kontaktem z uczniami warto zwrócić się do dyrekcji szkoły. Szczegółowe wymagania sprawdź w regulaminie komisji etycznej swojej uczelni.
Czy z odpowiedzi na skali Likerta można liczyć średnią w pracy z pedagogiki?
Dla pojedynczego stwierdzenia lepiej podać rozkład odpowiedzi i medianę, bo średnia może ukryć polaryzację opinii. Dla wyniku skali złożonej z kilku pozycji o sprawdzonej rzetelności średnia i odchylenie standardowe są w porządku, a do porównań można użyć testów parametrycznych lub rangowych.
Co zrobić, gdy uczniowie w badaniu pochodzą z kilku klas?
Uwzględnij, że uczniowie jednej klasy są do siebie podobni: policz ICC i zastosuj model wielopoziomowy z losowym wyrazem wolnym dla klasy. Zwykły test t traktuje uczniów jak niezależne obserwacje i może pokazać „istotny” efekt, którego model wielopoziomowy nie potwierdza – w przykładzie z tego poradnika p = .002 w teście t i p = .152 w modelu wielopoziomowym.
Powiązane hasła
Przeczytaj też
Analiza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikStatystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →Badasz nauczycieli, rodziców albo uczniów?
Pomożemy dobrać testy do Twoich pytań badawczych, przeprowadzić analizę i omówić wyniki tak, żebyś rozumiał(a) każdą tabelę w swojej pracy.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- British Educational Research Association. (2024). Ethical guidelines for educational research (5th ed.). https://www.bera.ac.uk/publication/ethical-guidelines-for-educational-research-fifth-edition-2024-online ● Otwarty dostęp
- Brown, L. D., Cai, T. T., & DasGupta, A. (2001). Interval estimation for a binomial proportion. Statistical Science, 16(2), 101–133. https://doi.org/10.1214/ss/1009213286
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Franke, T. M., Ho, T., & Christie, C. A. (2012). The chi-square test: Often used and more often misinterpreted. American Journal of Evaluation, 33(3), 448–458. https://doi.org/10.1177/1098214011426594
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05 ● Otwarty dostęp
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Kim, H.-Y. (2017). Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test. Restorative Dentistry & Endodontics, 42(2), 152–155. https://doi.org/10.5395/rde.2017.42.2.152 ● Otwarty dostęp
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Radkiewicz, P., & Zieliński, M. W. (2010). Hierarchiczne modele liniowe. Co nam dają i kiedy warto je stosować. Psychologia Społeczna, 5(2–3), 217–233. https://www.ceeol.com/search/article-detail?id=229295 ● Otwarty dostęp
- Sharpe, D. (2015). Chi-square test is statistically significant: Now what? Practical Assessment, Research, and Evaluation, 20, Article 8. https://doi.org/10.7275/tbfa-x148 ● Otwarty dostęp: pełny tekst
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@techreport{bera2024ethical, author={{British Educational Research Association}}, title={{Ethical guidelines for educational research}}, year={2024}, edition={5}, url={https://www.bera.ac.uk/publication/ethical-guidelines-for-educational-research-fifth-edition-2024-online}}@article{brown2001interval, author={Brown, Lawrence D. and Cai, T. Tony and DasGupta, Anirban}, title={{Interval estimation for a binomial proportion}}, journal={Statistical Science}, year={2001}, volume={16}, number={2}, pages={101--133}, doi={10.1214/ss/1009213286}}@article{campbell2007chisquared, author={Campbell, Ian}, title={{Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations}}, journal={Statistics in Medicine}, year={2007}, volume={26}, number={19}, pages={3661--3675}, doi={10.1002/sim.2832}}@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{franke2012chi, author={Franke, Todd Michael and Ho, Timothy and Christie, Christina A.}, title={{The chi-square test: Often used and more often misinterpreted}}, journal={American Journal of Evaluation}, year={2012}, volume={33}, number={3}, pages={448--458}, doi={10.1177/1098214011426594}}@article{heiberger2014design, author={Heiberger, Richard M. and Robbins, Naomi B.}, title={{Design of diverging stacked bar charts for Likert scales and other applications}}, journal={Journal of Statistical Software}, year={2014}, volume={57}, number={5}, pages={1--32}, doi={10.18637/jss.v057.i05}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{kim2017chi, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Chi-squared test and Fisher's exact test}}, journal={Restorative Dentistry \& Endodontics}, year={2017}, volume={42}, number={2}, pages={152--155}, doi={10.5395/rde.2017.42.2.152}}@article{kruskal1952use, author={Kruskal, William H. and Wallis, W. Allen}, title={{Use of ranks in one-criterion variance analysis}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={583--621}, doi={10.1080/01621459.1952.10483441}}@article{radkiewicz2010hierarchiczne, author={Radkiewicz, Piotr and Zieliński, Marcin W.}, title={{Hierarchiczne modele liniowe. Co nam dają i kiedy warto je stosować}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={217--233}, url={https://www.ceeol.com/search/article-detail?id=229295}}@article{sharpe2015chisquare, author={Sharpe, Donald}, title={{Chi-square test is statistically significant: Now what?}}, journal={Practical Assessment, Research, and Evaluation}, year={2015}, volume={20}, eid={8}, doi={10.7275/tbfa-x148}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}