Sześć typowych projektów w pracy z pedagogiki przedszkolnej i wczesnoszkolnej
Praca z pedagogiki przedszkolnej i wczesnoszkolnej różni się od pracy z pedagogiki ogólnej przede wszystkim tym, kto dostarcza danych. Pięciolatek nie wypełni kwestionariusza, więc o dziecku mówią obserwator, nauczyciel albo rodzic, a samo dziecko wykonuje zadania z osobą badającą. Grupa przedszkolna liczy zwykle kilkanaście lub dwadzieścia kilka osób i ma jednego wychowawcę. Do tego dzieci w jednym roczniku różnią się wiekiem nawet o 12 miesięcy, a w tym wieku rok to bardzo dużo. Te trzy cechy decydują o wyborze analizy częściej niż sam temat pracy.
Ogólne zasady analizy ankiet rodziców i nauczycieli, skal Likerta, tabel krzyżowych i uczniów w klasach opisuje wpis statystyka w pracy z pedagogiki, a układ samej pracy (przedmiot, problemy, zmienne i wskaźniki) – poradnik jak napisać pracę z pedagogiki. Tu zajmujemy się tym, co jest specyficzne dla najmłodszych dzieci. Tabela porządkuje sześć projektów omówionych niżej.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Arkusz obserwacji w grupie | Jak często dzieci podejmują zachowania prospołeczne w czasie zabawy swobodnej? | interwały z kategorią tak/nie, dwóch obserwatorów | kappa Cohena dla interwałów, ICC dla wyniku dziecka | κ i ICC z 95% CI |
| 2. Nauczyciel a rodzic | Czy rodzice oceniają samodzielność dziecka wyżej niż nauczyciel? | ta sama skala 0–20 od dwóch informatorów, 32 dzieci | dokładny test Wilcoxona dla par, ICC | estymator Hodgesa–Lehmanna z CI |
| 3. Program w jednej grupie | Czy po 10 tygodniach zabaw matematycznych dzieci rozwiązują więcej zadań? | 18 dzieci, pomiar przed i po | dokładny test Wilcoxona, porównanie z przyrostem wynikającym z wieku | mediana zmian, Hodges–Lehmann z CI |
| 4. Dwie grupy lub oddziały | Czy dzieci z oddziału z programem mają wyższy wynik niż z oddziału bez programu? | dwa oddziały po ok. 22 dzieci | najczęściej opis bez testu przyczynowego; przy wielu oddziałach – analiza średnich oddziałów lub model wielopoziomowy | różnica z CI, ICC |
| 5. Ankieta rodziców lub nauczycieli | Jak rodzice oceniają współpracę z przedszkolem? | skale Likerta, zwrot ankiet w oddziałach | odsetki z CI, testy nieparametryczne | odsetek zwrotów, korelacja rangowo-biseryjna |
| 6. Umiejętności a wiek w miesiącach | Czy dzieci, z którymi rodzice codziennie czytają, mają wyższy wynik? | 96 dzieci, data urodzenia i data badania, wynik zadań 0–40 | regresja z wiekiem w miesiącach (i oddziałem) | różnica skorygowana z 95% CI |
Wszystkie dane w przykładach są fikcyjne i symulowane; liczby nie opisują żadnej placówki. Zestaw zadań matematycznych w projektach 3 i 6 jest wymyślony na potrzeby przykładu i nie jest żadnym narzędziem diagnostycznym. Pełny kod znajdziesz w sekcji Przykład w R, a dane z projektu 6 możesz pobrać jako plik CSV. Jeśli nie wiesz, który test pasuje do Twojego pytania, zacznij od kreatora doboru testu, a całą drogę od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: kto jest jednostką analizy
Najpierw ustal, co jest jedną obserwacją. W pracach o najmłodszych dzieciach pomyłki biorą się zwykle stąd, że jednostki są trzy naraz: interwał obserwacji, dziecko i grupa. Trzydzieści interwałów obserwacji jednego dziecka to nie trzydzieści dzieci. Dwadzieścia dzieci z jednej grupy to nie dwadzieścia niezależnych prób programu, bo wszystkie miały tego samego nauczyciela, tę samą salę i ten sam rozkład dnia. Zanim wybierzesz test, zapisz w jednym zdaniu, na jakim poziomie formułujesz wniosek: o zachowaniu dzieci, o różnicy między informatorami czy o działaniu programu.
Wiek liczy się w miesiącach. Wszystkie dzieci w ostatniej grupie przedszkolnej mają „sześć lat”, jeśli wiek liczysz jako rok badania minus rok urodzenia. W przykładzie z projektu 6 tak zapisany wiek był identyczny dla wszystkich 96 dzieci, choć faktycznie wynosił od 63 do 76 miesięcy. Zbieraj więc datę urodzenia (albo miesiąc i rok) i datę badania każdego dziecka. Jak zapisać to w metryczce i jak potem zakodować, pokazujemy w projekcie 6.
Dostęp, zgody i dane wrażliwe – tylko z linkami. Badanie w przedszkolu wymaga zgody dyrektora placówki (wzór pisma w poradniku zgoda placówki na badanie) oraz zgody rodziców, a samo dziecko też może nie chcieć brać udziału w zadaniu. Dobór narzędzia do wieku, zgodę rodzica i dziecka oraz rozbieżności między informatorami omawia wpis badania z udziałem dzieci i młodzieży. Wymagania formalne sprawdź w zasadach komisji etycznej uczelni i placówki. Dwie zasady obowiązują w każdym projekcie: praca dyplomowa nie stawia diagnozy (wynik zadania czy arkusza obserwacji opisuje grupę badaną, a nie „dojrzałość” konkretnego dziecka), a w pracy nie publikujesz pozycji chronionych testów – podajesz nazwę narzędzia, liczbę zadań, zakres wyniku i źródło.
Projekt 1. Arkusz obserwacji zachowań w grupie przedszkolnej
Obserwacja to w przedszkolu najczęstsza metoda pomiaru zachowania. Jak zbudować system kategorii, wybrać próbkowanie zdarzeniowe albo czasowe i przeszkolić obserwatorów, opisuje poradnik obserwacja jako metoda badawcza. Tutaj liczy się jedna rzecz: zanim przeanalizujesz wyniki, wykaż, że inny obserwator zapisałby to samo. Hallgren (2012) zwraca uwagę, że wiele badań liczy zgodność obserwatorów niewłaściwą statystyką, nie podaje informacji potrzebnych do jej oceny albo pomija to, jak niska zgodność obniża moc późniejszych testów.
Przykład: dwie osoby obserwowały niezależnie 20 dzieci podczas zabawy swobodnej. Każde dziecko obserwowano przez 30 interwałów po 10 sekund i w każdym zaznaczano, czy wystąpiło zachowanie prospołeczne (pomoc, dzielenie się, pocieszanie). Daje to 600 par zapisów. Obserwatorzy zgodzili się w 85.5% interwałów, ale część tej zgodności jest przypadkowa. Kappa Cohena ją odejmuje i wyniosła κ = .670, 95% CI [.607, .733].
Do dalszej analizy rzadko używasz pojedynczych interwałów. Wynikiem dziecka jest zwykle liczba interwałów z zachowaniem, tu od 0 do 30. Dla tego wyniku policz ICC w wersji zgodności bezwzględnej. W przykładzie obserwator A zapisywał średnio 10.55 interwału z zachowaniem na dziecko, a obserwator B tylko 8.90, bo częściej pomijał zachowania, które A zapisał. Dlatego ICC zgodności bezwzględnej, ICC(A,1) = .881, 95% CI [.536, .961], jest niższe od ICC spójności, ICC(C,1) = .922, 95% CI [.814, .968], które ignoruje stałe przesunięcie. Koo i Li (2016) zalecają, by przy ICC zawsze podać model, typ i definicję współczynnika, a jego wartość oceniać według przedziału ufności, nie samego oszacowania. Szeroki przedział przy 20 dzieciach to typowa cena małej próby kontrolnej.
Co z tego wynika dla pracy: jeśli jeden obserwator systematycznie zapisuje mniej, to porównanie grup obserwowanych przez różne osoby jest skażone różnicą między obserwatorami. Przydziel więc obserwatorów tak, by każdy obserwował dzieci z obu porównywanych grup, i podwójnie koduj część sesji przez cały czas badania, a nie tylko w pilotażu. Wybór miary przy wielu kategoriach i kilku obserwatorach opisuje wpis zgodność sędziów: kappa, ICC i alfa.
Projekt 2. Ocena nauczyciela a ocena rodzica
Drugi częsty temat to porównanie, jak to samo dziecko widzą nauczyciel i rodzic. Rozbieżności między informatorami są regułą, a nie usterką, i szczegółowo omawia je wpis o badaniach z udziałem dzieci – tam znajdziesz też wykres Blanda–Altmana i kappę przy progu. Tu pokazujemy tylko plan dla małej próby z przedszkola.
Przykład: nauczyciel i rodzic 32 dzieci ocenili samodzielność w czynnościach codziennych na tej samej fikcyjnej skali 0–20. Nauczyciele dali średnio 11.97 punktu (SD = 3.19), rodzice 13.56 (SD = 2.59). Oceny korelowały słabo, r = .35. Pytanie „czy rodzice oceniają wyżej” dotyczy różnic w parach, więc użyj testu dla par. Przy 32 parach i wyniku w całych punktach wybierz test Wilcoxona w wersji dokładnej, z jawną regułą dla par z różnicą zero. Dokładny test (z metodą Pratta dla zer) dał Z = 2.27, p = .022. Wielkość różnicy opisuje estymator Hodgesa–Lehmanna: 1.5 punktu, 95% CI [0.0, 3.0].
Zgodność bezwzględna była niska, ICC(A,1) = .300, 95% CI [−.016, .572]. Oba wyniki trzeba opisać razem: rodzice oceniali nieco wyżej, a ich oceny tylko luźno porządkowały dzieci tak jak oceny nauczycieli. Nie uśredniaj więc obu ocen w jeden wynik „samodzielności”, dopóki nie uzasadnisz, że obie mierzą to samo. Rodzic widzi dziecko w domu, nauczyciel – w grupie dwudziestu rówieśników.
Projekt 3. Program w jednej grupie: przed i po bez grupy kontrolnej
Studentka prowadzi przez 10 tygodni zabawy matematyczne w swojej grupie i mierzy umiejętności w październiku i w styczniu. To bardzo częsty plan i ma wadę, która u małych dzieci jest szczególnie duża: dzieci rozwijają się między pomiarami same z siebie. U dorosłych trzy miesiące niewiele zmieniają, u pięciolatków – sporo.
Przykład: 18 dzieci rozwiązało przed programem średnio 16.94 zadania, a po programie 19.72. Wynik wzrósł u 17 dzieci, u jednego się nie zmienił. Średnia zmiana wynosiła 2.78 punktu (SD = 2.05). Dokładny test Wilcoxona dla par dał Z = 3.72, p < .001, a estymator Hodgesa–Lehmanna 2.5 punktu, 95% CI [1.5, 4.0]. Wynik jest wyraźny, ale nie mówi, ile z tej zmiany dał program.
Ile zmiany dałby sam wiek
Prosty sposób, by to oszacować, to nachylenie wyniku względem wieku z badania przekrojowego tym samym zestawem zadań. W projekcie 6 wynik rósł o 0.68 punktu na miesiąc (95% CI [0.44, 0.92]) przy tym samym oddziale i czytaniu. Trzy miesiące rozwoju to więc około 2.04 punktu, 95% CI [1.32, 2.76]. Obserwowana zmiana 2.78 punktu jest tylko nieco większa. Takie porównanie traktuj jako orientację, nie jako dowód: przekrojowe nachylenie opisuje różnice między dziećmi w różnym wieku, a nie przyrost u jednego dziecka, i w tej symulacji zawyżało prawdziwe tempo rozwoju (0.5 punktu na miesiąc). Dochodzi też efekt powtórnego rozwiązywania tych samych zadań.
Gdy do programu wybrano najsłabsze dzieci
Jeśli do zajęć wyrównawczych zaprosisz dzieci z najniższym wynikiem w pierwszym pomiarze, dołącza regresja do średniej. W symulacji 2000 grup po 24 dzieci, w której program w ogóle nie działał, średnia zmiana w całej grupie wynosiła 1.49 punktu (sam rozwój), a u sześciorga dzieci wybranych jako najsłabsze – 2.50 punktu. Barnett, van der Pols i Dobson (2005) piszą, że efekt regresji do średniej jest tym wyraźniejszy, im większy błąd pomiaru i gdy kolejne pomiary analizuje się tylko w podgrupie wybranej na podstawie wartości wyjściowej. U małych dzieci, których wynik zależy od nastroju i dnia, błąd pomiaru bywa duży.
Co możesz zrobić, nie mając drugiej grupy: dodać drugi pomiar przed programem (np. we wrześniu i październiku), który pokaże tempo zmian bez programu, albo dołączyć wynik, na który program nie powinien działać. Oba dodatki rozpisuje poradnik badanie bez grupy kontrolnej – jak wzmocnić plan. Jeśli pomiar przed i po zbierasz w ankietach rodziców bez nazwisk, zaplanuj kod łączący oba pomiary; co robić, gdy połączenie się nie udało, opisuje wpis nie da się połączyć pomiaru przed i po.
Projekt 4. Dwie grupy lub dwa oddziały: jedna grupa to jedna jednostka
Plan „program w moim oddziale, oddział koleżanki jako grupa porównawcza” wygląda na badanie z grupą kontrolną, ale ma tylko dwie jednostki. Program przydzielono całym grupom, a każda grupa ma swoją nauczycielkę, salę, porę zajęć i skład. Jeśli wyniki się różnią, nie wiesz, czy zadziałał program, czy nauczycielka. Tego nie naprawi żaden test na dzieciach, bo efekt programu jest w pełni pomieszany z efektem grupy.
Jak duży jest problem, pokazuje symulacja, w której program w ogóle nie działa, a dzieci z jednego oddziału są do siebie trochę podobne. Mierzy to ICC – udział zmienności wyniku przypadający na różnice między oddziałami. Przy ICC = .05 i 22 dzieciach w oddziale efekt schematu wynosi 2.05, przy ICC = .10 – 3.10, a przy ICC = .20 – 5.20. Zwykły test t na dzieciach traktuje je jak niezależne osoby i daje „istotny” wynik zbyt często.
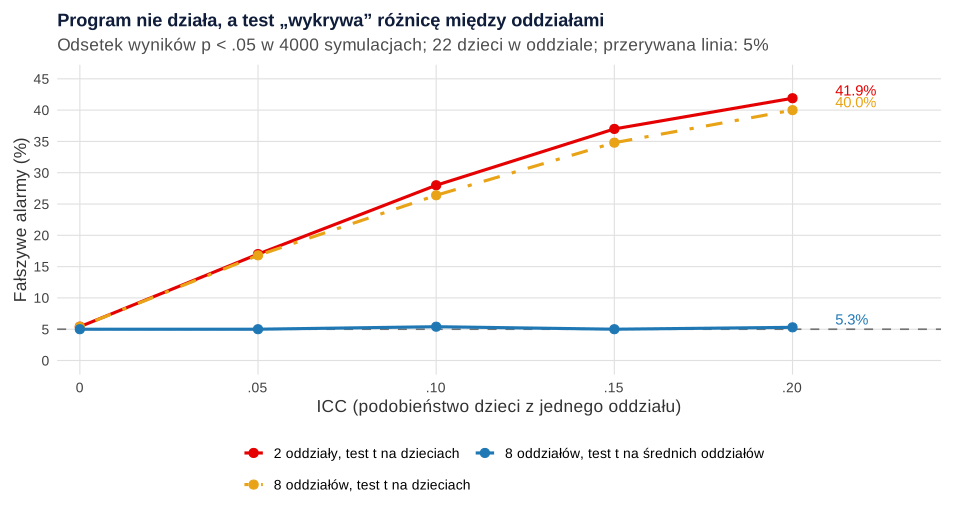
Przy dwóch oddziałach i ICC = .10 test t na dzieciach dał wynik istotny w 28.0% symulacji zamiast w 5%. Dołożenie oddziałów nie pomaga, dopóki analiza traktuje dzieci jak niezależne (8 oddziałów: 26.4%). Pomaga dopiero analiza zgodna z przydziałem: test na średnich ośmiu oddziałów (po cztery w każdej grupie) utrzymał odsetek fałszywych alarmów około 5% (od 5.0% do 5.4%). Leyrat i in. (2018) w symulacji badań z najwyżej 40 klastrami pokazali, że analizy na poziomie klastrów, modele mieszane z poprawką stopni swobody i GEE z poprawką dla małych prób utrzymują błąd I rodzaju na poziomie 5% lub niżej, ale przy mniej niż 20 klastrach mają niską moc.
Wnioski dla pracy dyplomowej:
- Dwa oddziały: opisz wyniki obu grup (średnie, rozkłady, różnicę z przedziałem), ale nie pisz, że program „spowodował” różnicę. W ograniczeniach napisz wprost, że przy jednej grupie w każdym warunku efekt programu jest nierozdzielny od efektu grupy i nauczyciela. Pomiar przed programem w obu grupach pozwala przynajmniej pokazać, czy grupy startowały z tego samego poziomu.
- Kilka oddziałów w każdym warunku: analizuj średnie oddziałów albo model wielopoziomowy, raportuj liczbę oddziałów i ICC. Wartości ICC do planowania zebrali dla osiągnięć szkolnych Hedges i Hedberg (2007); dotyczą one szkół, nie grup przedszkolnych, więc traktuj je jako punkt odniesienia. Efekt schematu dla własnych liczb policzysz w kalkulatorze ICC i efektu schematu.
- Cecha dziecka, nie grupy: gdy porównujesz dzieci według cechy indywidualnej (płeć, czytanie w domu), skupienie w oddziałach szkodzi mniej. Przy 2–4 oddziałach dodaj oddział do modelu jako czynnik stały, jak w projekcie 6. Ten sam mechanizm w grupach studenckich pokazuje wpis o ankiecie na zajęciach.
Projekt 5. Ankieta wśród rodziców lub nauczycieli
Ankieta wśród rodziców (o współpracy z przedszkolem, czytaniu w domu, czasie przed ekranem) albo wśród nauczycieli edukacji przedszkolnej i wczesnoszkolnej to najprostszy technicznie projekt. Analiza odpowiedzi na skali Likerta, test Manna–Whitneya i tabele krzyżowe są opisane we wpisie o statystyce w pracy z pedagogiki, więc tu tylko trzy rzeczy specyficzne dla przedszkola.
Kto odpowiada. Ustal z góry: jedna ankieta na dziecko czy na rodzica, kto wypełnia, gdy w grupie jest rodzeństwo, i co z ankietą wypełnioną przez oboje rodziców. Jeśli łączysz ankietę rodzica z wynikiem dziecka, potrzebujesz kodu zamiast nazwiska.
Zwrot ankiet w oddziałach. Ankiety rozdawane przez nauczycielki wracają z różnych grup w różnym tempie. W przykładzie wróciło ogółem 66.0% z 94 ankiet, ale w oddziale A 87.5% (21 z 24; 95% CI [69.0, 95.7]), a w oddziale D tylko 45.5% (10 z 22; 95% CI [26.9, 65.3]). Test dokładny Fishera dla czterech oddziałów dał p = .006. Jeśli oddziały różnią się składem, wynik „rodziców z przedszkola” będzie w praktyce wynikiem rodziców z oddziałów A i C. Podaj w pracy odsetek zwrotów w każdej grupie, a nie tylko ogólny.
Nauczyciele w placówkach. Ankieta nauczycieli z kilku przedszkoli lub szkół to znów dane pogrupowane, tym razem w placówkach. Przy kilkuosobowych gronach pedagogicznych nie podawaj wyników dla pojedynczej placówki, bo łatwo rozpoznać, kto co odpowiedział.
Projekt 6. Umiejętności i dojrzałość szkolna: wynik względem wieku w miesiącach
Prace o gotowości do nauki w szkole, umiejętnościach matematycznych czy językowych sześciolatków i uczniów klas I–III mają jedną wspólną pułapkę: nie porównuj surowych wyników dzieci w różnym wieku. Bedard i Dhuey (2006) opisali, że ze względu na jedną datę graniczną najstarsze dzieci w roczniku są przy rozpoczęciu nauki o około 20% starsze od najmłodszych, a w krajach OECD najmłodsi uzyskiwali w klasie czwartej wyniki niższe o 4–12 centyli niż najstarsi. W przedszkolu i pierwszych klasach ta różnica wieku jest jeszcze bardziej widoczna.
Przykład: czytanie w domu a wynik zadań matematycznych
Studentka zbadała 96 dzieci z rocznika 2020 z czterech oddziałów jednym zestawem 40 zadań. Badania trwały od marca do maja, więc w dniu badania dzieci miały od 63 do 76 miesięcy (średnio 69.28). Pytanie: czy dzieci, z którymi rodzice codziennie czytają, rozwiązują więcej zadań? W tych fikcyjnych danych codzienne czytanie częściej deklarowali rodzice starszych dzieci, a prawdziwa różnica przy tym samym wieku wynosiła 1 punkt. To układ ustawiony ręcznie, ale różnica wieku między porównywanymi grupami zdarza się w prawdziwych danych często, np. gdy jedną grupę bada się w marcu, a drugą w czerwcu.
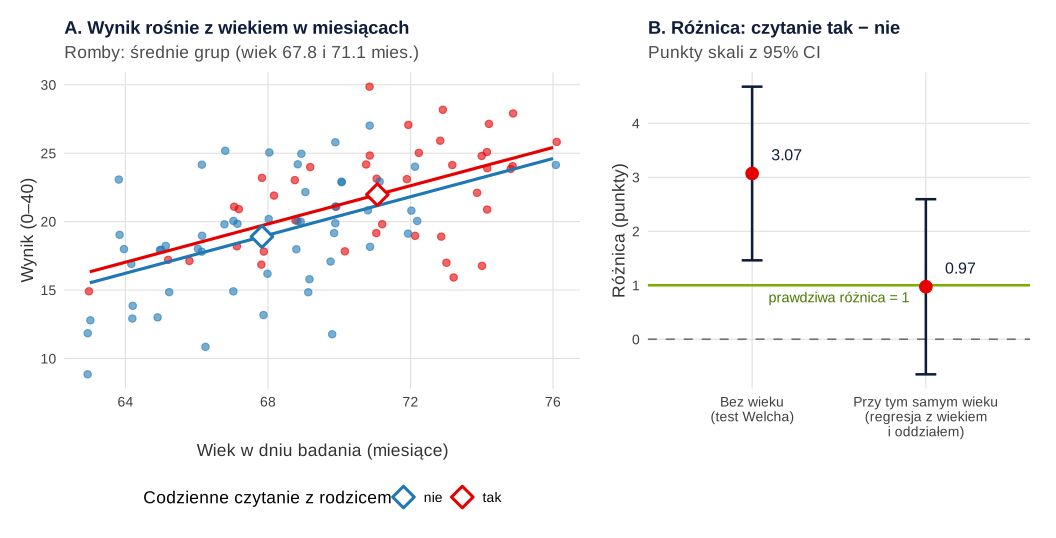
Krok 1. Surowe porównanie. Dzieci, z którymi rodzice czytają codziennie (n = 43), miały średnio 21.98 punktu (SD = 3.71), a pozostałe (n = 53) 18.91 punktu (SD = 4.22). Test Welcha: różnica 3.07 punktu, 95% CI [1.46, 4.68], t(93.36) = 3.79, p < .001, g Hedgesa = 0.77, 95% CI [0.35, 1.18]. Wygląda to na wyraźny efekt. Grupa czytająca była jednak średnio o 3.24 miesiąca starsza (71.07 wobec 67.83 miesiąca).
Krok 2. Jak mocno wynik zależy od wieku. W całej próbie każdy miesiąc wieku wiązał się z wynikiem wyższym o 0.76 punktu, 95% CI [0.55, 0.96], r = .60, p < .001. Między najmłodszymi a najstarszymi dziećmi w roczniku to około 9 punktów na 40. Wiek jest tu zmienną zakłócającą: wiąże się i z czytaniem, i z wynikiem.
Krok 3. Porównanie przy tym samym wieku. W regresji liniowej z wiekiem w miesiącach i oddziałem (czynnik stały, bo oddziałów są tylko cztery) różnica między grupami spadła do 0.97 punktu, 95% CI [−0.65, 2.60], t(90) = 1.19, p = .237. Wiek pozostał silnym predyktorem: 0.68 punktu na miesiąc, 95% CI [0.44, 0.92], p < .001. Model wyjaśniał 38.3% wariancji wyniku. Interakcja czytania z wiekiem była nieistotna (p = .636), więc różnica nie zależała wyraźnie od wieku. Przy tych danych nie można więc twierdzić, że czytanie wiąże się z wyższym wynikiem. Przedział zgadza się zarówno z brakiem różnicy, jak i z różnicą 2–3 punktów.
Ziarno losowania wybrano tak, by oszacowanie było bliskie prawdzie, więc kod powtarza ten sam schemat 1000 razy. Średnio surowa różnica wynosiła 2.49 punktu (SD = 0.75), a różnica z wiekiem w modelu 1.05 (SD = 0.76), czyli prawie dokładnie prawdziwy 1 punkt. Kiedy dodawać wiek do modelu, a kiedy nie, wyjaśnia wpis czy kontrolować wiek i płeć.
Wynik względem wieku zamiast „przedziałów wiekowych”
Drugim rozwiązaniem jest przeliczenie wyniku każdego dziecka na wynik względem wieku. Jeśli narzędzie ma normy, korzystasz z nich i podajesz ich rok i grupę odniesienia. Jeśli nie ma (np. zadania układasz sam), możesz policzyć wynik względem wieku we własnej próbie: przewidujesz wynik z regresji na wiek w miesiącach i standaryzujesz resztę. Dziecko z wynikiem 20 punktów ma wtedy z = 1.08, jeśli ma 64 miesiące, ale z = −1.34, jeśli ma 75 miesięcy. To ten sam wynik surowy i dwa zupełnie różne położenia względem rówieśników. Taki wynik opisuje miejsce dziecka w Twojej próbie, a nie w populacji, więc nie nazywaj go normą i nie używaj go do oceny pojedynczych dzieci.
Dlaczego regresja zamiast podziału na półrocza czy kwartały? Podział na przedziały wiekowe traci informację i zostawia różnice wieku wewnątrz przedziału. Oosterhuis, van der Ark i Sijtsma (2016) pokazali w symulacji, że przy spełnionych założeniach regresji normy regresyjne wymagały prób od 2.5 do 5.5 raza mniejszych niż normy tradycyjne liczone w podgrupach. Lenhard i Lenhard (2021) zalecają, by normy testów opierać na modelach statystycznych rozkładu wyników, a nie na tablicach z rang w przedziałach wiekowych. Więcej o tym, jak działają takie normy, w haśle normy wiekowe. W przykładzie dzieci urodzone w pierwszym półroczu miały średnio 71.81 miesiąca i 22.15 punktu, a urodzone w drugim półroczu 66.30 miesiąca i 18.07 punktu – to ta sama zależność od wieku, tylko zapisana zgrubnie.
Małe grupy: testy dokładne i przedziały zamiast gwiazdek
W pracach z pedagogiki przedszkolnej i wczesnoszkolnej próba to często jedna lub dwie grupy, czyli 15–50 dzieci. Kilka zasad wspólnych dla wszystkich projektów:
- Wynik w całych punktach, mało dzieci, wiele remisów: test Wilcoxona dla par albo Manna–Whitneya w wersji dokładnej z jawną regułą dla remisów i zer (w R pakiet coin, w SPSS opcja testów dokładnych). Kiedy wersja dokładna różni się od przybliżonej, opisuje poradnik analiza na małej próbie.
- Tabela 2×2 z małymi liczebnościami: test dokładny Fishera zamiast chi-kwadrat.
- Zawsze wielkość efektu z przedziałem. Przy 18 dzieciach wynik nieistotny prawie nigdy nie oznacza „braku różnicy”, tylko zbyt małą precyzję. Podaj przedział i opisz, jakie wartości są z nim zgodne.
- Wersję testu wybierz przed zebraniem danych i zapisz w planie analizy, a nie po zobaczeniu, która daje mniejsze p.
Jeśli liczysz w jamovi, testy dla par i dla dwóch grup znajdziesz w poradniku testy nieparametryczne w jamovi, a przećwiczysz je w zadaniach z testów nieparametrycznych.
Jak opisać analizę statystyczną w pracy z pedagogiki przedszkolnej
W rozdziale metodologicznym opisz oprócz testów trzy decyzje typowe dla tej dziedziny: jak liczono wiek, kto dostarczał danych (obserwator, nauczyciel, rodzic, zadanie z osobą badającą) i jak uwzględniono grupy przedszkolne. Wzór poniżej łączy projekty 1, 3 i 6. Gotowe zdania do pojedynczych testów przygotujesz w generatorze opisu wyników APA.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: wynik a wiek w miesiącach i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Przepis 1 to pełna analiza projektu 6: od obliczenia wieku w pełnych miesiącach, przez surowe porównanie i regresję z wiekiem, po wynik względem wieku i 1000 powtórzeń tego samego schematu. Przepis 2 zawiera projekty 1–5, w tym symulację fałszywych alarmów przy porównaniu oddziałów. Parametry symulacji (tempo rozwoju, różnicę wieku między grupami, różnice między obserwatorami, odsetki zwrotów) ustawiono ręcznie. Ziarno losowania (581) wybrano tak, żeby pojedynczy zbiór dał oszacowanie bliskie prawdziwej różnicy 1 punktu; jak bardzo wynik waha się między zbiorami, pokazuje 1000 powtórzeń. Kod rysunków pomijamy; rysunki powstały w pakietach ggplot2, patchwork i svglite. Dane z przepisu 1 możesz pobrać jako plik CSV.
1. Projekt 6: wiek w miesiącach, surowe porównanie, regresja z wiekiem i wynik względem wieku
R
# Projekt 6: umiejętności matematyczne a wiek w miesiącach (dane fikcyjne, symulowane).
# 96 dzieci z rocznika 2020 z czterech oddziałów, badanych od marca do maja 2026.
# Wynik: liczba rozwiązanych zadań w fikcyjnym zestawie (0–40); pytanie: czy dzieci, z którymi
# rodzice codziennie czytają, mają wyższy wynik? W symulacji czytanie częściej deklarują rodzice
# starszych dzieci, a prawdziwa różnica przy tym samym wieku wynosi 1 punkt.
suppressPackageStartupMessages(library(effectsize))
set.seed(581)
n <- 96
urodzenie <- as.Date("2020-01-01") + sample(0:365, n, replace = TRUE)
badanie <- as.Date("2026-03-02") + sample(0:88, n, replace = TRUE)
oddzial <- factor(sample(rep(c("A", "B", "C", "D"), each = n / 4)))

# Wiek w pełnych miesiącach w dniu badania (nie: rok badania minus rok urodzenia)
pelne_miesiace <- function(od, do) {
  r <- as.POSIXlt(od); b <- as.POSIXlt(do)
  (b$year - r$year) * 12 + (b$mon - r$mon) - (b$mday < r$mday)
}
wiek_mies <- pelne_miesiace(urodzenie, badanie)
czytanie <- factor(ifelse(rbinom(n, 1, plogis(0.30 * (wiek_mies - 69.5))) == 1, "tak", "nie"),
                   levels = c("nie", "tak"))
efekt_oddzialu <- c(A = 1.0, B = -0.8, C = 0.4, D = -0.6)[as.character(oddzial)]
wynik <- round(pmin(40, pmax(0, 20 + 0.50 * (wiek_mies - 69.5) + 1.0 * (czytanie == "tak") +
                                 efekt_oddzialu + rnorm(n, 0, 3.2))))
d <- data.frame(id = sprintf("D%02d", 1:n), oddzial, urodzenie, badanie, wiek_mies, czytanie, wynik)
write.csv(d, "wynik-a-wiek-dane.csv", row.names = FALSE)

# Krok 1. Opis: wiek w miesiącach i wynik; „wiek w latach” niczego tu nie różnicuje
round(c(wiek_min = min(wiek_mies), wiek_max = max(wiek_mies), wiek_M = mean(wiek_mies),
        wynik_M = mean(wynik), wynik_SD = sd(wynik)), 2)
table(wiek_w_latach_z_roku = as.numeric(format(badanie, "%Y")) - as.numeric(format(urodzenie, "%Y")))
aggregate(cbind(wiek_mies, wynik) ~ czytanie, d, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))

# Krok 2. Wynik rośnie z wiekiem: nachylenie na miesiąc
m_wiek <- lm(wynik ~ wiek_mies, data = d)
round(c(b_na_miesiac = unname(coef(m_wiek)[2]), confint(m_wiek)[2, ], r = cor(d$wiek_mies, d$wynik)), 3)
signif(summary(m_wiek)$coefficients[2, 4], 3)
# Najstarsze a najmłodsze dzieci: różnica przewidywana dla 12 miesięcy
round(12 * coef(m_wiek)[2], 2)

# Krok 3. Częsty błąd: surowe porównanie grup bez wieku (test Welcha)
tw <- t.test(wynik ~ czytanie, data = d)
round(c(roznica = unname(diff(tw$estimate)), CI_d = -tw$conf.int[2], CI_g = -tw$conf.int[1],
        t = -unname(tw$statistic), df = unname(tw$parameter)), 2); signif(tw$p.value, 3)
g <- hedges_g(wynik ~ relevel(czytanie, "tak"), data = d, pooled_sd = FALSE)
round(c(g = g$Hedges_g, CI_d = g$CI_low, CI_g = g$CI_high), 2)

# Krok 4. Porównanie przy tym samym wieku: regresja z wiekiem w miesiącach i oddziałem (czynnik stały)
m_pelny <- lm(wynik ~ czytanie + wiek_mies + oddzial, data = d)
round(cbind(b = coef(m_pelny), confint(m_pelny), t = summary(m_pelny)$coefficients[, 3]), 2)
signif(summary(m_pelny)$coefficients[, 4], 3)
round(c(df_reszt = m_pelny$df.residual, R2 = summary(m_pelny)$r.squared), 3)
# Interakcja: czy różnica zależy od wieku?
round(summary(lm(wynik ~ czytanie * wiek_mies + oddzial, data = d))$coefficients["czytanietak:wiek_mies", ], 3)

# Krok 5. Wynik względem wieku w tej próbie: reszta z regresji na wiek, zestandaryzowana (z)
d$z_wzgl_wieku <- as.numeric(scale(residuals(m_wiek)))
aggregate(z_wzgl_wieku ~ czytanie, d, function(x) round(c(M = mean(x), SD = sd(x)), 2))
# To samo dziecko z wynikiem 20: wynik surowy a wynik względem wieku przy 64 i 75 miesiącach
round(c(z_64_mies = (20 - predict(m_wiek, data.frame(wiek_mies = 64))) / sigma(m_wiek),
        z_75_mies = (20 - predict(m_wiek, data.frame(wiek_mies = 75))) / sigma(m_wiek)), 2)

# Krok 6. Półrocze urodzenia: ten sam efekt wieku w prostszej formie
d$polrocze <- factor(ifelse(as.numeric(format(d$urodzenie, "%m")) <= 6, "I półrocze", "II półrocze"))
aggregate(cbind(wiek_mies, wynik) ~ polrocze, d, function(x) round(c(n = length(x), M = mean(x)), 2))

# Krok 7. Ziarno wybrano tak, by oszacowanie było bliskie prawdzie; ten sam schemat 1000 razy
sym <- t(replicate(1000, {
  w <- sample(wiek_mies); cz <- rbinom(n, 1, plogis(0.30 * (w - 69.5)))
  y <- 20 + 0.50 * (w - 69.5) + 1.0 * cz + efekt_oddzialu + rnorm(n, 0, 3.2)
  c(surowa = mean(y[cz == 1]) - mean(y[cz == 0]), z_wiekiem = unname(coef(lm(y ~ cz + w + oddzial))["cz"]))
}))
round(rbind(srednia = colMeans(sym), SD = apply(sym, 2, sd)), 2)
Wynik w R
wiek_min wiek_max   wiek_M  wynik_M wynik_SD
   63.00    76.00    69.28    20.28     4.27
wiek_w_latach_z_roku
 6
96
  czytanie wiek_mies.n wiek_mies.M wiek_mies.SD wynik.n wynik.M wynik.SD
1      nie       53.00       67.83         2.92   53.00   18.91     4.22
2      tak       43.00       71.07         3.03   43.00   21.98     3.71
b_na_miesiac        2.5 %       97.5 %            r
       0.756        0.548        0.964        0.598
[1] 1.3e-10
wiek_mies
     9.08
roznica    CI_d    CI_g       t      df
   3.07    1.46    4.68    3.79   93.36
[1] 0.000267
   g CI_d CI_g
0.77 0.35 1.18
                 b  2.5 % 97.5 %     t
(Intercept) -26.50 -42.92 -10.08 -3.21
czytanietak   0.97  -0.65   2.60  1.19
wiek_mies     0.68   0.44   0.92  5.62
oddzialB     -0.66  -2.63   1.32 -0.66
oddzialC     -0.71  -2.71   1.28 -0.71
oddzialD     -1.64  -3.64   0.35 -1.64
(Intercept) czytanietak   wiek_mies    oddzialB    oddzialC    oddzialD
   1.87e-03    2.37e-01    2.09e-07    5.11e-01    4.77e-01    1.04e-01
df_reszt       R2
  90.000    0.383
  Estimate Std. Error    t value   Pr(>|t|)
    -0.117      0.246     -0.475      0.636
  czytanie z_wzgl_wieku.M z_wzgl_wieku.SD
1      nie          -0.08            1.05
2      tak           0.10            0.93
z_64_mies.1 z_75_mies.1
       1.08       -1.34
     polrocze wiek_mies.n wiek_mies.M wynik.n wynik.M
1  I półrocze       52.00       71.81   52.00   22.15
2 II półrocze       44.00       66.30   44.00   18.07
        surowa z_wiekiem
srednia   2.49      1.05
SD        0.75      0.76
2. Projekty 1–5: obserwacja, nauczyciel a rodzic, przed–po, dwa oddziały, zwrot ankiet
R
# Projekty 1–5: obserwacja, nauczyciel a rodzic, program w jednej grupie, dwa oddziały, ankieta rodziców.
# Wszystkie dane są fikcyjne (symulowane albo wpisane ręcznie).
suppressPackageStartupMessages({ library(psych); library(coin); library(DescTools) })

## Projekt 1. Arkusz obserwacji: dwóch obserwatorów, 20 dzieci, 30 interwałów po 10 s -----------
# Kategoria: zachowanie prospołeczne w interwale (1 = wystąpiło). Obserwator B czasem je pomija.
set.seed(5221)
dzieci <- 20; interwaly <- 30
sklonnosc <- rbeta(dzieci, 2, 5)                                    # różne dzieci, różna częstość
prawda <- matrix(rbinom(dzieci * interwaly, 1, rep(sklonnosc, each = interwaly)), ncol = dzieci)
obsA <- ifelse(runif(length(prawda)) < .93, prawda, 1 - prawda)
obsB <- ifelse(prawda == 1 & runif(length(prawda)) < .15, 0, ifelse(runif(length(prawda)) < .05, 1 - prawda, prawda))
tab <- table(A = factor(obsA, 0:1), B = factor(obsB, 0:1)); tab
round(c(zgodnosc_proc = 100 * sum(diag(tab)) / sum(tab)), 1)
k <- cohen.kappa(cbind(as.vector(obsA), as.vector(obsB)))
round(c(kappa = k$kappa, CI_d = k$confid[1, 1], CI_g = k$confid[1, 3]), 3)
# Wynik dziecka = liczba interwałów z zachowaniem; zgodność tego wyniku: ICC(A,1)
liczbaA <- colSums(matrix(obsA, ncol = dzieci)); liczbaB <- colSums(matrix(obsB, ncol = dzieci))
round(c(M_A = mean(liczbaA), M_B = mean(liczbaB)), 2)
ic <- psych::ICC(cbind(liczbaA, liczbaB), lmer = FALSE)$results
round(ic[ic$type %in% c("ICC2", "ICC3"), c("ICC", "lower bound", "upper bound")], 3)

## Projekt 2. Nauczyciel a rodzic: samodzielność w czynnościach codziennych (0–20), 32 dzieci ---
set.seed(5222)
n2 <- 32
cecha <- rnorm(n2)
nauczyciel <- round(pmin(20, pmax(0, 13 + 2.6 * cecha + rnorm(n2, 0, 2.2))))
rodzic <- round(pmin(20, pmax(0, 14.5 + 2.6 * cecha + rnorm(n2, 0, 2.6))))
roz <- rodzic - nauczyciel
round(c(M_naucz = mean(nauczyciel), SD_naucz = sd(nauczyciel), M_rodz = mean(rodzic), SD_rodz = sd(rodzic),
        r = cor(nauczyciel, rodzic), M_roznicy = mean(roz), Me_roznicy = median(roz)), 2)
wt2 <- wilcoxsign_test(rodzic ~ nauczyciel, distribution = "exact", zero.method = "Pratt")
round(c(Z = statistic(wt2), p = pvalue(wt2)), 3)
hl2 <- wilcox.test(rodzic, nauczyciel, paired = TRUE, conf.int = TRUE, exact = FALSE)
round(c(HL = unname(hl2$estimate), CI_d = hl2$conf.int[1], CI_g = hl2$conf.int[2]), 2)
ic2 <- psych::ICC(cbind(nauczyciel, rodzic), lmer = FALSE)$results
round(ic2[ic2$type %in% c("ICC2", "ICC3"), c("ICC", "lower bound", "upper bound")], 3)

## Projekt 3. Program w jednej grupie: 18 dzieci, pomiar w październiku i w styczniu (3 miesiące) -
# Ten sam fikcyjny zestaw zadań 0–40 co w projekcie 6. W symulacji: rozwój 0.5 pkt/miesiąc
# (1.5 pkt w 3 miesiące) + efekt programu 1.0 pkt + szum.
set.seed(5223)
n3 <- 18
poziom <- rnorm(n3, 17, 3.5)
przed <- round(poziom + rnorm(n3, 0, 1.8))
po <- round(poziom + 3 * 0.5 + 1.0 + rnorm(n3, 0, 1.8))
zm <- po - przed
round(c(M_przed = mean(przed), M_po = mean(po), M_zmiany = mean(zm), SD_zmiany = sd(zm),
        poprawa = sum(zm > 0), bez_zmian = sum(zm == 0), spadek = sum(zm < 0)), 2)
wt3 <- wilcoxsign_test(po ~ przed, distribution = "exact", zero.method = "Pratt")
round(c(Z = statistic(wt3)), 2); signif(pvalue(wt3), 3)
hl3 <- wilcox.test(po, przed, paired = TRUE, conf.int = TRUE, exact = FALSE)
round(c(HL = unname(hl3$estimate), CI_d = hl3$conf.int[1], CI_g = hl3$conf.int[2]), 2)
# Ile zmiany dałby sam wiek? Nachylenie z projektu 6 (0.68 pkt/miesiąc, 95% CI [0.44, 0.92]) × 3 miesiące
round(c(oczekiwane_z_wieku = 3 * 0.68, CI_d = 3 * 0.44, CI_g = 3 * 0.92), 2)
# Wariant z doborem: do programu wybrano 6 dzieci z najniższym wynikiem przed (bez efektu programu)
set.seed(5224)
sym3 <- replicate(2000, { p <- rnorm(24, 17, 3.5); a <- p + rnorm(24, 0, 1.8); b <- p + 1.5 + rnorm(24, 0, 1.8)
  wyb <- order(a)[1:6]; c(wszyscy = mean(b - a), najslabsi = mean((b - a)[wyb])) })
round(rowMeans(sym3), 2)

## Projekt 4. Dwa oddziały: program w jednym, drugi bez programu. Fałszywe alarmy przy braku efektu --
# Każdy oddział ma swojego nauczyciela, więc dzieci jednego oddziału są do siebie podobne (ICC).
set.seed(5225)
alarm <- function(icc, oddzialy, m = 22, reps = 4000) {
  rowMeans(replicate(reps, {
    g <- rep(0:1, each = oddzialy / 2)
    u <- rnorm(oddzialy, 0, sqrt(icc)); y <- rnorm(oddzialy * m, rep(u, each = m), sqrt(1 - icc))
    gr <- rep(g, each = m)
    p_dzieci <- t.test(y[gr == 1], y[gr == 0], var.equal = TRUE)$p.value
    p_srednie <- if (oddzialy > 2) { s <- tapply(y, rep(1:oddzialy, each = m), mean)
      t.test(s[g == 1], s[g == 0], var.equal = TRUE)$p.value } else NA
    c(dzieci = p_dzieci < .05, srednie = p_srednie < .05)
  }))
}
siatka <- expand.grid(ICC = c(0, .05, .10, .15, .20), oddzialy = c(2, 8))
wyn4 <- t(mapply(alarm, siatka$ICC, siatka$oddzialy))
fa <- data.frame(siatka, test_t_na_dzieciach = round(100 * wyn4[, "dzieci"], 1),
                 test_t_na_srednich_oddzialow = round(100 * wyn4[, "srednie"], 1))
fa
# Efekt schematu dla 22 dzieci w oddziale
round(1 + (22 - 1) * c(.05, .10, .20), 2)

## Projekt 5. Ankieta rodziców w czterech oddziałach: zwrot ankiet ------------------------------
rozdane <- c(A = 24, B = 23, C = 25, D = 22); zwrocone <- c(A = 21, B = 12, C = 19, D = 10)
round(cbind(rozdane, zwrocone, 100 * BinomCI(zwrocone, rozdane, method = "wilson")), 1)
round(c(ogolem_proc = 100 * sum(zwrocone) / sum(rozdane)), 1)
tab5 <- rbind(zwrocone, nie = rozdane - zwrocone)
signif(fisher.test(tab5)$p.value, 3)
Wynik w R
   B
A     0   1
  0 362  27
  1  60 151
zgodnosc_proc
         85.5
kappa  CI_d  CI_g
0.670 0.607 0.733
  M_A   M_B
10.55  8.90
                       ICC lower bound upper bound
Single_random_raters 0.881       0.536       0.961
Single_fixed_raters  0.922       0.814       0.968
   M_naucz   SD_naucz     M_rodz    SD_rodz          r  M_roznicy Me_roznicy
     11.97       3.19      13.56       2.59       0.35       1.59       1.00
    Z     p
2.274 0.022
  HL CI_d CI_g
 1.5  0.0  3.0
                       ICC lower bound upper bound
Single_random_raters 0.300      -0.016       0.572
Single_fixed_raters  0.339      -0.006       0.611
  M_przed      M_po  M_zmiany SD_zmiany   poprawa bez_zmian    spadek
    16.94     19.72      2.78      2.05     17.00      1.00      0.00
   Z
3.72
[1] 1.53e-05
  HL CI_d CI_g
 2.5  1.5  4.0
oczekiwane_z_wieku               CI_d               CI_g
              2.04               1.32               2.76
  wszyscy najslabsi
     1.49      2.50
    ICC oddzialy test_t_na_dzieciach test_t_na_srednich_oddzialow
1  0.00        2                 5.4                           NA
2  0.05        2                17.0                           NA
3  0.10        2                28.0                           NA
4  0.15        2                37.0                           NA
5  0.20        2                41.9                           NA
6  0.00        8                 5.4                          5.0
7  0.05        8                16.8                          5.0
8  0.10        8                26.4                          5.4
9  0.15        8                34.8                          5.0
10 0.20        8                40.0                          5.3
[1] 2.05 3.10 5.20
  rozdane zwrocone  est lwr.ci upr.ci
A      24       21 87.5   69.0   95.7
B      23       12 52.2   33.0   70.8
C      25       19 76.0   56.6   88.5
D      22       10 45.5   26.9   65.3
ogolem_proc
         66
[1] 0.00612
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), t.test(), wilcox.test() i fisher.test() z pakietu stats oraz pakiety wymienione niżej); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- coin (wersja 1.4.3): Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z pedagogiki przedszkolnej i wczesnoszkolnej
- Wiek zapisany w latach. Wszystkie dzieci w grupie mają „6 lat”, a faktycznie dzieli je do 13 miesięcy; w przykładzie to około 9 punktów na 40.
- Porównanie surowych wyników grup, które różnią się wiekiem. Różnica 3.07 punktu spadła do 0.97 po uwzględnieniu wieku w miesiącach.
- Przed–po w jednej grupie opisane jako „skuteczność programu”. Trzy miesiące rozwoju odpowiadały w przykładzie około 2 punktom z 2.78 punktu obserwowanej zmiany.
- Zajęcia wyrównawcze dla najsłabszych bez grupy porównawczej. Regresja do średniej dodała w symulacji średnio punkt „poprawy” bez żadnego programu.
- Dwa oddziały i test t na dzieciach jako dowód działania programu. Przy ICC = .10 fałszywy alarm pojawia się w 28% badań, a efektu programu nie da się oddzielić od nauczyciela.
- Interwały obserwacji liczone jak dzieci albo zgodność obserwatorów podana tylko jako procent zgodności, bez kappy i bez ICC dla wyniku dziecka.
- Uśrednienie oceny nauczyciela i rodzica bez sprawdzenia, czy oceny są zgodne (w przykładzie ICC = .300).
- Odsetek zwrotów ankiet podany tylko ogółem, choć w jednym oddziale wróciło 87.5%, a w innym 45.5%.
- Wynik zadania opisany jako diagnoza dziecka („dziecko nie jest gotowe do szkoły”) albo pozycje chronionego testu przepisane do załącznika.
- Wynik nieistotny przy kilkunastu dzieciach opisany jako „brak różnic”, bez przedziału ufności.
Lista kontrolna przed zebraniem danych
- Czy wiesz, co jest jednostką analizy (interwał, dziecko, oddział) i na jakim poziomie formułujesz wniosek?
- Czy zbierasz datę urodzenia (lub miesiąc i rok) i datę badania każdego dziecka?
- Czy każdy obserwator obserwuje dzieci z obu porównywanych grup i czy część sesji kodujecie podwójnie przez całe badanie?
- Czy przy pomiarze przed–po masz drugi pomiar wyjściowy, grupę porównawczą albo wynik kontrolny?
- Czy program przydzielasz całym oddziałom, a jeśli tak – ile oddziałów jest w każdym warunku?
- Czy wiesz, kto wypełnia ankietę rodzica, jak połączysz ją z wynikiem dziecka i jak policzysz zwroty w oddziałach?
- Czy wersje testów (dokładny czy przybliżony, reguła dla remisów) są zapisane w planie analizy?
- Czy masz zgodę placówki i rodziców oraz plan, co robisz, gdy dziecko nie chce wykonać zadania?
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy z pedagogiki przedszkolnej?
To zależy od danych. Arkusz obserwacji wymaga zgodności obserwatorów (kappa dla interwałów, ICC dla wyniku dziecka), oceny nauczyciela i rodzica – testu dla par i ICC, program w jednej grupie – dokładnego testu Wilcoxona z przedziałem ufności, a porównanie dzieci w różnym wieku – regresji z wiekiem w miesiącach. Przy każdej analizie podaj wielkość efektu z 95% CI.
Czy porównanie dwóch grup przedszkolnych wystarczy, żeby ocenić program?
Nie, jeśli program dostała jedna grupa, a drugą jest inny oddział. Każda grupa ma swoją nauczycielkę i skład, więc efektu programu nie da się oddzielić od efektu grupy, a zwykły test t na dzieciach zbyt często daje wynik istotny. Opisz wyniki obu grup z przedziałem ufności i napisz to wprost w ograniczeniach; wniosek o działaniu programu wymaga kilku oddziałów w każdym warunku.
Dlaczego wiek dzieci trzeba liczyć w miesiącach?
Bo w jednym roczniku dzieci różnią się wiekiem nawet o rok, a w wieku przedszkolnym to duża różnica w umiejętnościach. Wiek liczony jako rok badania minus rok urodzenia jest u wszystkich taki sam i ukrywa tę różnicę. Zbieraj datę urodzenia i datę badania, a wiek w pełnych miesiącach uwzględnij w modelu albo przelicz wynik na wynik względem wieku.
Jak opisać badanie przed i po w jednej grupie przedszkolnej?
Podaj zmianę z przedziałem ufności i dokładny test dla par, ale nie przypisuj jej programowi. Małe dzieci rozwijają się między pomiarami same z siebie, więc porównaj zmianę z przyrostem oczekiwanym z wieku albo dodaj drugi pomiar przed programem. Jeśli do zajęć wybrano dzieci z najniższym wynikiem, uwzględnij też regresję do średniej.
Czy można uśrednić ocenę nauczyciela i ocenę rodzica?
Tylko po sprawdzeniu, że obie oceny mierzą to samo i są zgodne. Nauczyciel i rodzic widzą dziecko w różnych sytuacjach, więc ich oceny często słabo się zgadzają. Policz różnicę w parach i ICC zgodności bezwzględnej, a przy niskiej zgodności analizuj obie oceny osobno i z góry wskaż, która jest wynikiem głównym.
Powiązane hasła
Przeczytaj też
Analiza wyników sprawdzianu i ewaluacja w szkole
Zadania do poprawy, porównanie klas bez rankingu nauczycieli, dwa sprawdziany, ankieta ewaluacyjna i raport dla rady: Excel, R i gotowe zdania.
Czytaj →PoradnikStatystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →PoradnikJak napisać pracę z pedagogiki
Przedmiot, problemy, hipotezy, zmienne i wskaźniki, metoda–technika–narzędzie, klasy i zgody na przykładzie motywacji do czytania, z wersjami źle i dobrze.
Czytaj →PoradnikBadania z udziałem dzieci i młodzieży
Narzędzia według wieku, buźki i skale, zgodność rodzica i dziecka w R, klasy, zgody rodziców, gotowe zdania do Metody i lista kontrolna.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z pedagogiki przedszkolnej lub wczesnoszkolnej i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – arkusza obserwacji, ocen nauczyciela i rodzica, programu w grupie albo wyników dzieci w różnym wieku – policzyć je z wielkością efektu i wyjaśnić tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bedard, K., & Dhuey, E. (2006). The persistence of early childhood maturity: International evidence of long-run age effects. Quarterly Journal of Economics, 121(4), 1437–1472. https://doi.org/10.1162/qjec.121.4.1437
- Hallgren, K. A. (2012). Computing inter-rater reliability for observational data: An overview and tutorial. Tutorials in Quantitative Methods for Psychology, 8(1), 23–34. https://doi.org/10.20982/tqmp.08.1.p023 ● Otwarty dostęp
- Hedges, L. V., & Hedberg, E. C. (2007). Intraclass correlation values for planning group-randomized trials in education. Educational Evaluation and Policy Analysis, 29(1), 60–87. https://doi.org/10.3102/0162373707299706
- Koo, T. K., & Li, M. Y. (2016). A guideline of selecting and reporting intraclass correlation coefficients for reliability research. Journal of Chiropractic Medicine, 15(2), 155–163. https://doi.org/10.1016/j.jcm.2016.02.012 ● Otwarty dostęp
- Lenhard, W., & Lenhard, A. (2021). Improvement of norm score quality via regression-based continuous norming. Educational and Psychological Measurement, 81(2), 229–261. https://doi.org/10.1177/0013164420928457 ● Otwarty dostęp
- Leyrat, C., Morgan, K. E., Leurent, B., & Kahan, B. C. (2018). Cluster randomized trials with a small number of clusters: Which analyses should be used? International Journal of Epidemiology, 47(1), 321–331. https://doi.org/10.1093/ije/dyx169
- Oosterhuis, H. E. M., van der Ark, L. A., & Sijtsma, K. (2016). Sample size requirements for traditional and regression-based norms. Assessment, 23(2), 191–202. https://doi.org/10.1177/1073191115580638 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bedard2006persistence, author={Bedard, Kelly and Dhuey, Elizabeth}, title={{The persistence of early childhood maturity: International evidence of long-run age effects}}, journal={Quarterly Journal of Economics}, year={2006}, volume={121}, number={4}, pages={1437--1472}, doi={10.1162/qjec.121.4.1437}}@article{hallgren2012computing, author={Hallgren, Kevin A.}, title={{Computing inter-rater reliability for observational data: An overview and tutorial}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2012}, volume={8}, number={1}, pages={23--34}, doi={10.20982/tqmp.08.1.p023}}@article{hedges2007intraclass, author={Hedges, Larry V. and Hedberg, E. C.}, title={{Intraclass correlation values for planning group-randomized trials in education}}, journal={Educational Evaluation and Policy Analysis}, year={2007}, volume={29}, number={1}, pages={60--87}, doi={10.3102/0162373707299706}}@article{koo2016guideline, author={Koo, Terry K. and Li, Mae Y.}, title={{A guideline of selecting and reporting intraclass correlation coefficients for reliability research}}, journal={Journal of Chiropractic Medicine}, year={2016}, volume={15}, number={2}, pages={155--163}, doi={10.1016/j.jcm.2016.02.012}}@article{lenhard2021improvement, author={Lenhard, Wolfgang and Lenhard, Alexandra}, title={{Improvement of norm score quality via regression-based continuous norming}}, journal={Educational and Psychological Measurement}, year={2021}, volume={81}, number={2}, pages={229--261}, doi={10.1177/0013164420928457}}@article{leyrat2018cluster, author={Leyrat, Clémence and Morgan, Katy E. and Leurent, Baptiste and Kahan, Brennan C.}, title={{Cluster randomized trials with a small number of clusters: Which analyses should be used?}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={1}, pages={321--331}, doi={10.1093/ije/dyx169}}@article{oosterhuis2016sample, author={Oosterhuis, Hannah E. M. and van der Ark, L. Andries and Sijtsma, Klaas}, title={{Sample size requirements for traditional and regression-based norms}}, journal={Assessment}, year={2016}, volume={23}, number={2}, pages={191--202}, doi={10.1177/1073191115580638}}