Co to jest estymator Hodgesa–Lehmanna?
Estymator Hodgesa–Lehmanna (HL) to odporny estymator przesunięcia położenia oparty na rangach. Dla dwóch niezależnych prób jest to mediana wszystkich różnic par xi − yj (przy 15 i 15 osobach – mediana 225 różnic). Dla jednej próby lub różnic w parach jest to mediana średnich Walsha, czyli średnich ze wszystkich par obserwacji. Hodges i Lehmann (1963) wyprowadzili takie estymatory ze statystyk testów rangowych, m.in. Wilcoxona, aby uzyskać ocenę położenia odporną na grube błędy. Jest to więc naturalna miara efektu do testu Manna–Whitneya i testu Wilcoxona.
Właściwości
- Odporność: pojedyncza obserwacja odstająca zmienia tylko niewielką część różnic par, więc HL prawie się nie przesuwa.
- Efektywność: asymptotyczna efektywność HL względem różnicy średnich równa się efektywności Pitmana testu rangowego względem testu t (Hodges i Lehmann, 1963), a ta dla testu Wilcoxona nie spada poniżej 0.864 (Hodges i Lehmann, 1956). Przy rozkładzie normalnym traci się więc niewiele, a przy grubych ogonach często się zyskuje.
- Przedział ufności: granice wyznacza się z tych samych statystyk rangowych (Bauer, 1972); w R zwraca je
wilcox.test(..., conf.int = TRUE).
Jak interpretować
HL nie jest różnicą median. Gdy rozkłady różnią się tylko przesunięciem, szacuje to przesunięcie. Gdy różnią się też kształtem, opisuje typową różnicę między losową osobą z jednej i z drugiej grupy. Uzupełnia go delta Cliffa, która mówi, jak często wyniki jednej grupy są wyższe.
Przykład w R
Nowa i dotychczasowa metoda nauczania (po 15 osób, dane symulowane), w grupie nowej jedna wartość odstająca (60 pkt). Różnica średnich wynosi 7.01, a HL = 4.80 pkt, 95% CI [1.50; 9.30], p = .007. Przedział z testu t jest znacznie szerszy: [1.34; 12.69].
Na rysunku
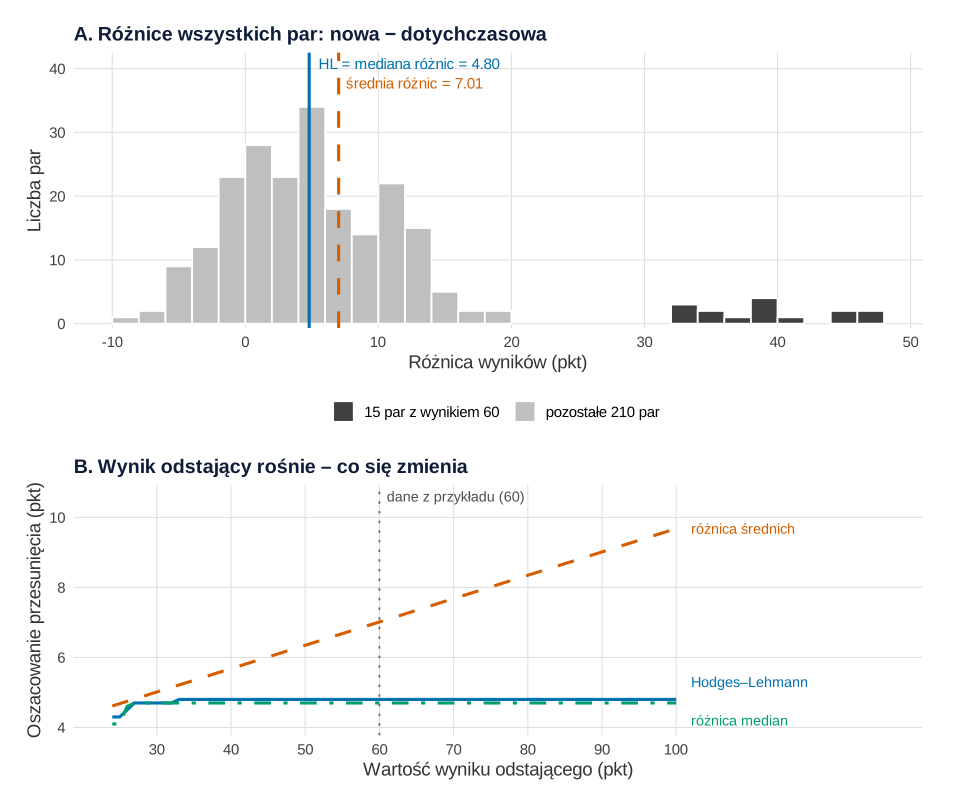
set.seed(559)).Co widać. Panel A pokazuje wszystkie 225 różnic par z przykładu. Wynik 60 pkt bierze udział w 15 z nich i wszystkie leżą osobno, od 32.2 pkt w górę (ciemne słupki). Mediana wszystkich różnic to estymator Hodgesa–Lehmanna: 4.80 pkt. Średnia tych samych różnic wynosi 7.01 pkt i jest dokładnie różnicą średnich grup, bo średnia z różnic par równa się różnicy średnich. Te skrajne różnice mocno przesuwają średnią, ale mediany prawie nie ruszają, bo to tylko 15 z 225 par. Panel B zmienia sam wynik odstający od 24 do 100 pkt. Różnica średnich rośnie po prostej od 4.61 do 9.68 pkt. HL zmienia się tylko, dopóki ten wynik jest jeszcze w środku rozkładu (4.30 pkt przy 24), a potem stoi na 4.80. Różnica median zachowuje się podobnie (4.70 pkt).
Na co uważać. Rysunek pokazuje jedną zmienianą obserwację. Gdy odstających wyników jest więcej, przesuwa się i HL, bo skrajne różnice zaczynają sięgać środka ich rozkładu. Na histogramie różnic nie widać też niepewności – przedział ufności HL trzeba policzyć osobno (kod w sekcji Estymator Hodgesa–Lehmanna w R). Płaska linia HL nie znaczy, że wynik 60 można pominąć w opisie. Napisz, że był i jak go potraktowano. Histogram różnic par dla danych bez odstających wyników i przy rozkładach o różnym kształcie pokazuje rysunek 5 we wpisie test Manna–Whitneya w obrazkach.
Podpis do pracy:
Kod rysunku używa tych samych danych co przykład (set.seed(559), wynik 60 wpisany ręcznie). Zakres 24–100 pkt w panelu B ustalono ręcznie. Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Różnice wszystkich 225 par i estymator Hodgesa–Lehmanna (dane z przykładu)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
kol <- c(HL = "#0072B2", srednie = "#D55E00", mediany = "#009E73")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

set.seed(559)                                       # te same dane co w przykładzie
nowa    <- round(rnorm(15, mean = 24, sd = 4), 1)
kontrol <- round(rnorm(15, mean = 20, sd = 4), 1)
nowa[15] <- 60                                      # obserwacja odstająca
roznice <- outer(nowa, kontrol, "-")                # 225 różnic par
pary <- data.frame(d = as.vector(roznice),
                   zrodlo = ifelse(as.vector(row(roznice)) == 15, "15 par z wynikiem 60", "pozostałe 210 par"))
round(c(HL = median(pary$d), srednia_roznic = mean(pary$d), roznica_srednich = mean(nowa) - mean(kontrol),
        min_par_z_60 = min(pary$d[pary$zrodlo != "pozostałe 210 par"])), 2)

# Panel A: histogram różnic par; mediana = HL, średnia różnic = różnica średnich
linie <- data.frame(x = c(median(pary$d), mean(pary$d)), miara = c("HL", "srednie"),
                    et = sprintf(c("HL = mediana różnic = %.2f", "średnia różnic = %.2f"), c(median(pary$d), mean(pary$d))))
pA <- ggplot(pary, aes(d, fill = zrodlo)) +
  geom_histogram(binwidth = 2, boundary = 0, colour = "white") +
  geom_vline(data = linie, aes(xintercept = x, colour = miara, linetype = miara), linewidth = 1.1, show.legend = FALSE) +
  geom_text(data = linie, aes(x = x, y = Inf, label = et, colour = miara), hjust = -0.05, vjust = c(1.5, 3.3), size = 4,
            inherit.aes = FALSE, show.legend = FALSE) +
  scale_fill_manual(values = c("15 par z wynikiem 60" = "grey25", "pozostałe 210 par" = "grey75"), name = NULL) +
  scale_colour_manual(values = kol) + scale_linetype_manual(values = c(HL = "solid", srednie = "dashed")) +
  scale_y_continuous(expand = expansion(mult = c(0.02, 0.25))) +
  labs(title = "A. Różnice wszystkich par: nowa − dotychczasowa", x = "Różnica wyników (pkt)", y = "Liczba par") +
  motyw

# Panel B: wynik odstający zmienia się od 24 do 100 pkt – co dzieje się z trzema miarami przesunięcia
siatka <- seq(24, 100, by = 1)
wrazl <- do.call(rbind, lapply(siatka, function(v) { x <- nowa; x[15] <- v
  data.frame(v = v, miara = names(kol),
             wartosc = c(median(outer(x, kontrol, "-")), mean(x) - mean(kontrol), median(x) - median(kontrol))) }))
wrazl$miara <- factor(wrazl$miara, levels = names(kol))
sapply(c(24, 60, 100), function(v) round(wrazl$wartosc[wrazl$v == v], 2))
konce <- subset(wrazl, v == max(siatka))
konce$et <- c("Hodges–Lehmann", "różnica średnich", "różnica median")
konce$y_et <- konce$wartosc + c(0.5, 0, -0.5)
pB <- ggplot(wrazl, aes(v, wartosc, colour = miara, linetype = miara)) +
  geom_vline(xintercept = 60, linetype = "dotted", colour = "grey40") +
  annotate("text", x = 61, y = 10.6, label = "dane z przykładu (60)", hjust = 0, size = 3.8, colour = "grey30") +
  geom_line(linewidth = 1.1) +
  geom_text(data = konce, aes(y = y_et, label = et), hjust = 0, nudge_x = 2, size = 3.8, show.legend = FALSE) +
  scale_colour_manual(values = kol, guide = "none") +
  scale_linetype_manual(values = c(HL = "solid", srednie = "dashed", mediany = "dotdash"), guide = "none") +
  scale_x_continuous(limits = c(24, 128), breaks = seq(30, 100, 10)) +
  labs(title = "B. Wynik odstający rośnie – co się zmienia", x = "Wartość wyniku odstającego (pkt)",
       y = "Oszacowanie przesunięcia (pkt)") +
  motyw

p <- pA / pB + plot_layout(heights = c(1.1, 1))
p
Wynik w R
              HL   srednia_roznic roznica_srednich     min_par_z_60
            4.80             7.01             7.01            32.20
     [,1] [,2] [,3]
[1,] 4.30 4.80 4.80
[2,] 4.61 7.01 9.68
[3,] 4.10 4.70 4.70
Jak opisać w pracy
Więcej miar efektu dla testów rangowych: wielkość efektu w testach nieparametrycznych.
Estymator Hodgesa–Lehmanna w R
Kod liczy HL ręcznie jako medianę różnic wszystkich par (outer()), porównuje go z różnicą średnich i median, a potem odczytuje ten sam estymator i przedział ufności z wilcox.test().
Przesunięcie przy obserwacji odstającej
R
# Estymator Hodgesa–Lehmanna: mediana wszystkich różnic par (x_i - y_j)
set.seed(559)
nowa    <- round(rnorm(15, mean = 24, sd = 4), 1)   # wynik testu, nowa metoda
kontrol <- round(rnorm(15, mean = 20, sd = 4), 1)   # wynik testu, metoda dotychczasowa
nowa[15] <- 60                                      # jedna obserwacja odstająca
roznice <- outer(nowa, kontrol, "-")                # 15 x 15 = 225 różnic
round(c(HL_recznie = median(roznice),
        roznica_srednich = mean(nowa) - mean(kontrol),
        roznica_median = median(nowa) - median(kontrol)), 2)
w <- wilcox.test(nowa, kontrol, conf.int = TRUE, exact = FALSE)
round(c(w$estimate, CI = w$conf.int, p = w$p.value), 3)
round(t.test(nowa, kontrol)$conf.int, 2)            # przedział dla różnicy średnich
Wynik w R
      HL_recznie roznica_srednich   roznica_median
            4.80             7.01             4.70
difference in location                    CI1                    CI2
                 4.800                  1.500                  9.300
                     p
                 0.007
[1]  1.34 12.69
attr(,"conf.level")
[1] 0.95
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcja wilcox.test() z pakietu stats). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy estymator Hodgesa–Lehmanna to różnica median?
Nie. To mediana różnic wszystkich par obserwacji z obu grup. Wartości bywają zbliżone, ale przy różnych kształtach rozkładów mogą się wyraźnie różnić.
Jak policzyć estymator Hodgesa–Lehmanna w R?
Funkcją wilcox.test(x, y, conf.int = TRUE): wartość „difference in location” to estymator, a conf.int – jego przedział ufności. Ręcznie: median(outer(x, y, "-")).
Kiedy podawać Hodgesa–Lehmanna zamiast różnicy średnich?
Gdy porównujesz grupy testem Manna–Whitneya lub Wilcoxona, gdy w danych są obserwacje odstające albo rozkład ma grube ogony. Podaj go w jednostkach zmiennej, z przedziałem ufności.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Test Manna–Whitneya w obrazkach
Rangi, wszystkie pary i P(X > Y), równe mediany a istotny wynik, mała próba i estymator Hodgesa–Lehmanna – pięć symulacji z kodem R.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bauer, D. F. (1972). Constructing confidence sets using rank statistics. Journal of the American Statistical Association, 67(339), 687–690. https://doi.org/10.1080/01621459.1972.10481279
- Hodges, J. L., & Lehmann, E. L. (1956). The efficiency of some nonparametric competitors of the t-test. The Annals of Mathematical Statistics, 27(2), 324–335. https://doi.org/10.1214/aoms/1177728261 ● Otwarty dostęp
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598–611. https://doi.org/10.1214/aoms/1177704172 ● Otwarty dostęp
Cytowania BibTeX
@article{bauer1972constructing, author={Bauer, David F.}, title={{Constructing confidence sets using rank statistics}}, journal={Journal of the American Statistical Association}, year={1972}, volume={67}, number={339}, pages={687--690}, doi={10.1080/01621459.1972.10481279}}@article{hodges1956efficiency, author={Hodges, J. L. and Lehmann, E. L.}, title={{The efficiency of some nonparametric competitors of the t-test}}, journal={The Annals of Mathematical Statistics}, year={1956}, volume={27}, number={2}, pages={324--335}, doi={10.1214/aoms/1177728261}}@article{hodges1963estimates, author={Hodges, J. L. and Lehmann, E. L.}, title={{Estimates of location based on rank tests}}, journal={The Annals of Mathematical Statistics}, year={1963}, volume={34}, number={2}, pages={598--611}, doi={10.1214/aoms/1177704172}}