Co testuje test U – w jednym zdaniu
Test U Manna–Whitneya sprawdza, czy losowo wybrana osoba z jednej grupy częściej ma wyższy wynik niż losowo wybrana osoba z drugiej. Tak sformułowali pytanie już Mann i Whitney (1947) – w tytule pracy pytali, czy jedna zmienna jest „stochastycznie większa” od drugiej. Popularne zdanie „test porównuje mediany” jest skrótem, który bywa fałszywy w obie strony. Divine i in. (2018) pokazują na kontrprzykładach, że procedura nie jest testem median, a jej naturalnym podsumowaniem jest prawdopodobieństwo przewagi P(X > Y). Definicję, wzór na U i przykład z opisem APA znajdziesz w haśle test U Manna–Whitneya. Tu pokazujemy na rysunkach, co dzieje się z rangami, parami osób i wartością p.
Dane są fikcyjne: czas wykonania zadania w sekundach w grupie kontrolnej i w grupie po krótkim treningu. Każdy blok kodu, który losuje, ma własne ziarno ustalone raz: 5801 (rysunek 1), 5803 (rysunek 3), 5804 (rysunek 4) i 5805 (rysunek 5). Symulacje mają po 5 000 powtórzeń na każdą liczebność. Parametry populacji – mediana 100 s, SD 20 s, kształt skośny, przesunięcie o 15 s – ustawiliśmy ręcznie tak, żeby oba zjawiska były wyraźnie widoczne. Ziarna nie zmienialiśmy. Przypadek, w którym rozkłady różnią się tylko rozproszeniem, a P(X > Y) = .5, omawia wpis testy odporne: Welch, Yuen, Brunner–Munzel. Tu bierzemy dwa inne scenariusze.
Rysunek 1: test widzi tylko kolejność
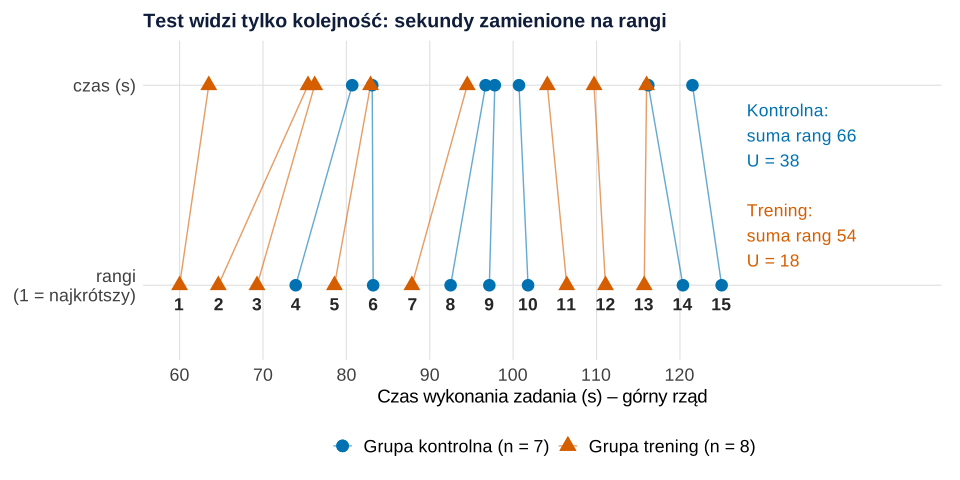
set.seed(5801)).Co widać. Górny rząd to sekundy, dolny – rangi w połączonej próbie 15 osób. Odległości znikają: wynik 63.5 s (ranga 1) i 75.4 s (ranga 2) są w rangach tak samo blisko jak 96.7 s i 97.8 s (rangi 8 i 9). Suma rang w grupie kontrolnej wynosi 66, w grupie trening 54. Po odjęciu najmniejszej możliwej sumy (28 dla 7 osób, 36 dla 8 osób) dostajemy U = 38 i U = 18. Średnia ranga jest niższa w grupie trening (6.75 wobec 9.43), czyli osoby po treningu zwykle kończyły szybciej. Dokładny test daje jednak p = .281.
Czego ten wykres nie pokazuje – i jak może zmylić. Rangi zachowują kolejność, ale gubią odległości. Gdyby najwolniejsza osoba potrzebowała 300 s zamiast 121.5 s, rangi, U i p byłyby identyczne. To zaleta przy wartościach odstających i wada, gdy liczy się wielkość różnicy w sekundach. Rysunek nie mówi też nic o medianach: mediana wynosi 97.8 s w grupie kontrolnej i 88.7 s w grupie trening, ale test tej różnicy nie liczy.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 1: dane, rangi i suma rang
Kod uruchamiaj po kolei w jednej sesji R – kolejne bloki korzystają z motywu motyw i palety kol z bloku 1, a blok 2 także z danych. Każdy blok, który losuje, ustawia własne ziarno, więc skopiowany osobno da te same liczby. Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG (w kodzie – zakomentowane wywołanie ggsave()). Dane z bloku 1 pobierzesz jako plik test-manna-whitneya-dane.csv (dane symulowane: grupa, czas w sekundach, ranga).
1. Motyw, paleta, dane i rangi
R
# Rysunek 1. Rangi na wykresie: 15 wyników, numery rang i sumy rang (dane fikcyjne: czas wykonania zadania)
library(ggplot2)
library(patchwork)

# Motyw i paleta (Okabe–Ito: niebieski i cynober są rozróżnialne także przy deuteranopii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25", size = rel(0.95)), legend.text = element_text(size = rel(0.95)),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0, size = rel(1)),
        legend.position = "bottom", plot.caption = element_text(colour = "grey30", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kol <- c(kontrolna = "#0072B2", trening = "#D55E00", jasny = "#56B4E9", szary = "grey70", ciemny = "grey25")

set.seed(5801)                                   # ziarno bloku 1, ustalone raz
kontrolna <- round(rnorm(7, 100, 15), 1)         # czas wykonania zadania (s), 7 osób
trening   <- round(rnorm(8, 88, 15), 1)          # 8 osób po krótkim treningu
d1 <- data.frame(grupa = factor(rep(c("kontrolna", "trening"), c(7, 8)), levels = c("kontrolna", "trening")),
                 czas = c(kontrolna, trening))
d1$ranga <- rank(d1$czas)                        # rangi w połączonej próbie (1 = najkrótszy czas)
d1[order(d1$czas), ]

R <- tapply(d1$ranga, d1$grupa, sum)             # sumy rang
n <- table(d1$grupa)
U <- R - n * (n + 1) / 2                         # U każdej grupy = suma rang minus najmniejsza możliwa suma
round(rbind(n = n, mediana = tapply(d1$czas, d1$grupa, median), suma_rang = R,
            najmniejsza_mozliwa = n * (n + 1) / 2, U = U, srednia_ranga = R / n), 2)
wilcox.test(trening, kontrolna)                  # W w R = U pierwszej podanej grupy (tu: trening)

# górny rząd: prawdziwe czasy; dolny rząd: rangi rozstawione równo (1–15) na tej samej szerokości
lo <- 60; hi <- 125
d1$x_ranga <- lo + (d1$ranga - 1) * (hi - lo) / 14
p1 <- ggplot(d1) +
  geom_segment(aes(x = czas, xend = x_ranga, y = 2, yend = 1, colour = grupa), linewidth = 0.5, alpha = 0.6) +
  geom_point(aes(czas, 2, colour = grupa, shape = grupa), size = 4) +
  geom_point(aes(x_ranga, 1, colour = grupa, shape = grupa), size = 4) +
  geom_text(aes(x_ranga, 1, label = ranga), vjust = 2, size = 4.6, colour = "grey15", fontface = "bold") +
  annotate("text", x = hi + 3, y = c(1.75, 1.25), hjust = 0, size = 4.6, colour = kol[c("kontrolna", "trening")],
           label = sprintf("%s:\nsuma rang %g\nU = %g", c("Kontrolna", "Trening"), R, U)) +
  scale_colour_manual(values = kol[c("kontrolna", "trening")], name = NULL,
                      labels = c("Grupa kontrolna (n = 7)", "Grupa trening (n = 8)")) +
  scale_shape_manual(values = c(kontrolna = 16, trening = 17), name = NULL,
                     labels = c("Grupa kontrolna (n = 7)", "Grupa trening (n = 8)")) +
  scale_x_continuous(breaks = seq(60, 120, 10)) +
  scale_y_continuous(breaks = c(1, 2), labels = c("rangi\n(1 = najkrótszy)", "czas (s)"), limits = c(0.7, 2.15)) +
  coord_cartesian(xlim = c(lo, hi + 22)) +
  labs(title = "Test widzi tylko kolejność: sekundy zamienione na rangi",
       x = "Czas wykonania zadania (s) – górny rząd", y = NULL) + motyw
# p1   # wyświetl; zapis: ggsave("test-manna-whitneya-rangi.svg", p1, width = 10, height = 5)
Wynik w R
       grupa  czas ranga
13   trening  63.5     1
14   trening  75.4     2
12   trening  76.2     3
6  kontrolna  80.7     4
15   trening  82.9     5
7  kontrolna  83.1     6
11   trening  94.5     7
1  kontrolna  96.7     8
4  kontrolna  97.8     9
2  kontrolna 100.7    10
8    trening 104.1    11
10   trening 109.7    12
9    trening 116.0    13
3  kontrolna 116.2    14
5  kontrolna 121.5    15
                    kontrolna trening
n                        7.00    8.00
mediana                 97.80   88.70
suma_rang               66.00   54.00
najmniejsza_mozliwa     28.00   36.00
U                       38.00   18.00
srednia_ranga            9.43    6.75

	Wilcoxon rank sum exact test

data:  trening and kontrolna
W = 18, p-value = 0.281
alternative hypothesis: true location shift is not equal to 0
Rysunek 2: wszystkie pary osób i prawdopodobieństwo przewagi
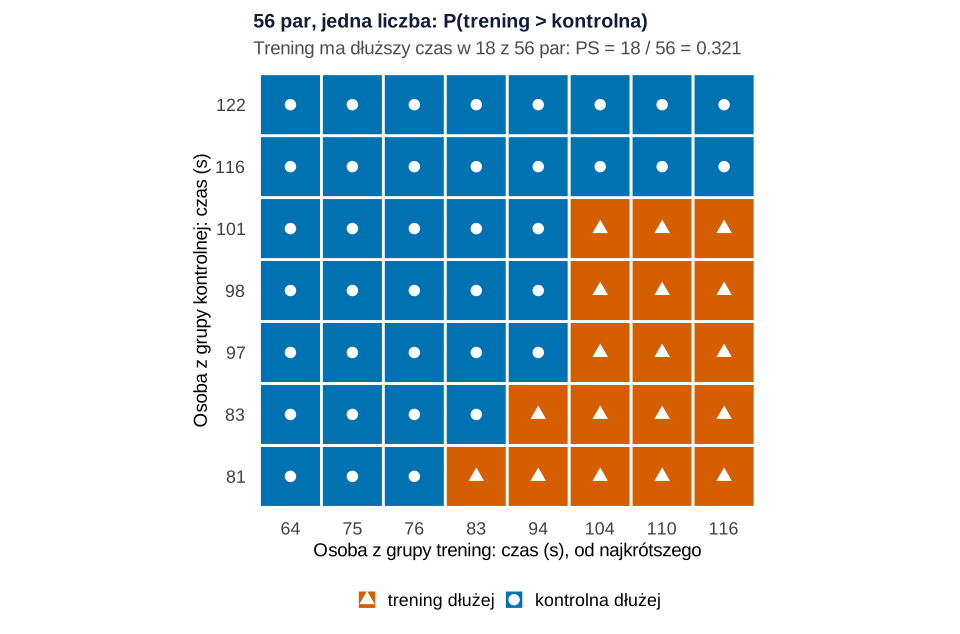
Co widać. Każde pole to jedna para osób. W 18 z 56 par dłuższy czas ma osoba z grupy trening, w 38 – osoba z grupy kontrolnej, remisów nie ma. Liczba pomarańczowych pól to dokładnie U grupy trening z rysunku 1, a ich udział to prawdopodobieństwo przewagi: P(trening > kontrolna) = 18 / 56 = .321. Ten sam wynik daje suma rang i statystyka W z R podzielona przez 56. McGraw i Wong (1992) zaproponowali taką miarę jako wielkość efektu „w języku potocznym”. Pod inną nazwą jest to miara A Varghi–Delaneya, a 2P − 1 = −.36 to korelacja rangowo-dwuseryjna. Ta sama liczba to także pole pod krzywą ROC, gdy wynik ma odróżnić dwie grupy – rozwija to wpis krzywa ROC w obrazkach.
Czego ten wykres nie pokazuje – i jak może zmylić. Pole nie mówi, o ile dłużej pracowała jedna osoba: przewaga o 0.2 s i o 40 s liczy się tak samo. Kierunek trzeba nazwać: .321 dla treningu to .679 dla grupy kontrolnej. Bez tej informacji czytelnik nie wie, która grupa „wygrywa”. Przy małych grupach PS skacze o 1/56 przy każdej zmianie kolejności jednej pary, więc podawaj ją z przedziałem ufności. Metody liczenia przedziałów opisuje wpis wielkość efektu w testach nieparametrycznych.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 2: siatka par i prawdopodobieństwo przewagi
2. Wszystkie pary, U i P(X > Y)
R
# Rysunek 2. Wszystkie 56 par (osoba z treningu, osoba z kontrolnej): kto ma dłuższy czas?
# (kontynuacja: kontrolna, trening, kol, motyw z bloku 1; ten blok niczego nie losuje)
pary <- expand.grid(k = seq_along(kontrolna), t = seq_along(trening))
pary$czas_k <- sort(kontrolna)[pary$k]           # osoby uporządkowane według czasu
pary$czas_t <- sort(trening)[pary$t]
pary$wynik <- factor(ifelse(pary$czas_t > pary$czas_k, "trening dłużej",
                     ifelse(pary$czas_t < pary$czas_k, "kontrolna dłużej", "remis")),
                     levels = c("trening dłużej", "kontrolna dłużej", "remis"))
table(pary$wynik)
U_t <- sum(pary$czas_t > pary$czas_k) + 0.5 * sum(pary$czas_t == pary$czas_k)
PS <- U_t / nrow(pary)                           # prawdopodobieństwo przewagi P(trening > kontrolna)
round(c(par = nrow(pary), U_trening = U_t, PS_trening = PS, PS_kontrolna = 1 - PS,
        r_rangowo_dwuseryjna = 2 * PS - 1), 3)
# ta sama liczba prosto z rang i z W w R
round(c(z_rang = (sum(rank(c(kontrolna, trening))[8:15]) - 8 * 9 / 2) / (7 * 8),
        z_W = unname(wilcox.test(trening, kontrolna)$statistic) / (7 * 8)), 3)

p2 <- ggplot(pary, aes(factor(t), factor(k), fill = wynik, shape = wynik)) +
  geom_tile(colour = "white", linewidth = 1) +
  geom_point(size = 3.6, colour = "white") +
  scale_fill_manual(values = c("trening dłużej" = kol[["trening"]], "kontrolna dłużej" = kol[["kontrolna"]],
                               "remis" = "grey60"), name = NULL) +
  scale_shape_manual(values = c("trening dłużej" = 17, "kontrolna dłużej" = 16, "remis" = 15), name = NULL) +
  scale_x_discrete(labels = sprintf("%.0f", sort(trening))) +
  scale_y_discrete(labels = sprintf("%.0f", sort(kontrolna))) +
  coord_equal() +
  labs(title = "56 par, jedna liczba: P(trening > kontrolna)",
       subtitle = sprintf("Trening ma dłuższy czas w %g z 56 par: PS = %g / 56 = %.3f",
                          U_t, U_t, PS),
       x = "Osoba z grupy trening: czas (s), od najkrótszego", y = "Osoba z grupy kontrolnej: czas (s)") +
  motyw + theme(panel.grid.major = element_blank())
# p2   # wyświetl; zapis: ggsave("test-manna-whitneya-wszystkie-pary.svg", p2, width = 10, height = 6.6)
Wynik w R
  trening dłużej kontrolna dłużej            remis
              18               38                0
                 par            U_trening           PS_trening
              56.000               18.000                0.321
        PS_kontrolna r_rangowo_dwuseryjna
               0.679               -0.357
z_rang    z_W
 0.321  0.321
Rysunek 3: równe mediany, a wynik istotny
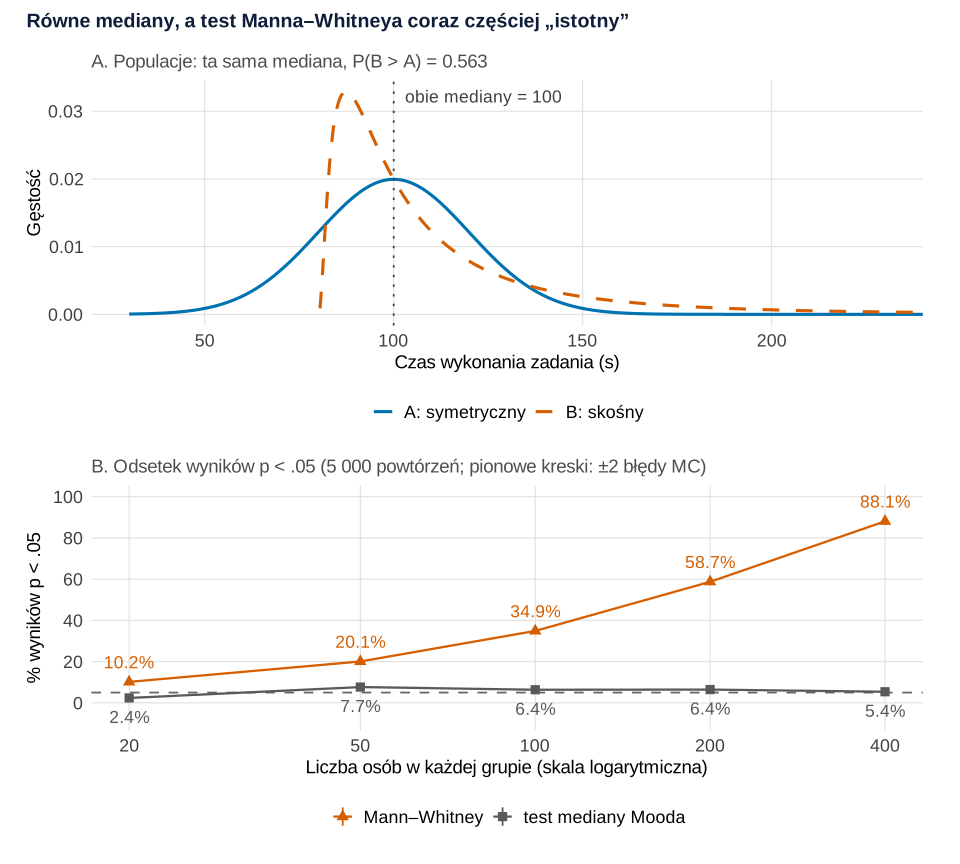
set.seed(5803), 5 000 powtórzeń na liczebność).Co widać. Grupa A ma rozkład symetryczny, grupa B – prawostronnie skośny. W grupie B nikt nie kończy szybciej niż w 80 s, ale część osób pracuje bardzo długo. Mediany obu populacji wynoszą 100 s (z miliona losowań: 100.02 i 100.01), średnie – 100.02 i 113.05 s. Mimo równych median P(B > A) = .563. Test Manna–Whitneya „widzi” tę przewagę coraz częściej: przy 20 osobach w grupie p < .05 wypadło w 10.2% badań, przy 100 – w 34.9%, a przy 400 – w 88.1% (błąd Monte Carlo najwyżej 0.7 pp). Prawdziwy test mediany Mooda na tych samych danych odrzucał hipotezę w 2.4–7.7% badań. Wahania wokół 5% wynikają z przybliżenia χ², ale z liczebnością nie rosną.
Czego ten wykres nie pokazuje – i jak może zmylić. Test nie popełnia tu błędu. Odpowiada poprawnie na swoje pytanie – czy jedna grupa jest stochastycznie większa – bo P(B > A) ≠ .5. Błąd robi osoba, która czyta wynik jako „mediany się różnią”. Hart (2001) zwraca uwagę, że test reaguje także na różnice kształtu i rozproszenia. Fagerland i Sandvik (2009) pokazali w symulacjach, że różna skośność w grupach wyraźnie zmienia rzeczywisty poziom istotności testu, gdy pytasz o średnie lub mediany. Rysunek pokazuje jeden kształt; przy innych wynik będzie inny. W przypadku, gdy P(X > Y) = .5, a grupy różnią się rozproszeniem, problemem staje się sam błąd I rodzaju. Wtedy rozważ test Brunnera–Munzela, który Karch (2021) poleca jako domyślną procedurę, bo nie zakłada identycznych rozkładów przy prawdziwej hipotezie zerowej.
Podpis do pracy:
Zdanie do Metody:
Kod rysunku 3: symulacja z równymi medianami
3. Równe mediany, różne kształty – odsetek p < .05
R
# Rysunek 3. Równe mediany, różne kształty: jak często test Manna–Whitneya daje p < .05?
# (kontynuacja: kol, motyw z bloku 1; ten blok losuje – ma własne ziarno)
set.seed(5803)                                   # ziarno bloku 3, ustalone raz
los_A <- function(n) rnorm(n, 100, 20)                       # grupa A: symetryczny, mediana 100
los_B <- function(n) 100 + 20 * (exp(rnorm(n)) - 1)          # grupa B: prawostronnie skośny, mediana też 100

# parametry populacji z miliona losowań
A <- los_A(1e6); B <- los_B(1e6)
round(c(mediana_A = median(A), mediana_B = median(B), srednia_A = mean(A), srednia_B = mean(B),
        P_B_wiekszy = mean(B > A)), 3)

# test mediany Mooda: tabela 2 × 2 „powyżej / nie powyżej wspólnej mediany”
p_mood <- function(x, y) {
  m <- median(c(x, y))
  chisq.test(rbind(c(sum(x > m), sum(x <= m)), c(sum(y > m), sum(y <= m))), correct = FALSE)$p.value
}
R_powt <- 5000                                   # powtórzeń na każdą liczebność
ns <- c(20, 50, 100, 200, 400)                   # osób w każdej grupie
sym <- do.call(rbind, lapply(ns, function(n) {
  p <- replicate(R_powt, { a <- los_A(n); b <- los_B(n)
                           c(mw = wilcox.test(b, a)$p.value, mood = p_mood(b, a)) })
  data.frame(n = n, test = c("Mann–Whitney", "test mediany Mooda"), odsetek = rowMeans(p < .05))
}))
rownames(sym) <- NULL
sym$blad_MC <- sqrt(sym$odsetek * (1 - sym$odsetek) / R_powt)  # błąd Monte Carlo odsetka
sym$odsetek_proc <- round(100 * sym$odsetek, 1); sym$blad_MC_pp <- round(100 * sym$blad_MC, 1)
sym[, c("n", "test", "odsetek_proc", "blad_MC_pp")]

gest <- rbind(data.frame(grupa = "A: symetryczny", x = seq(30, 260, 0.5), y = dnorm(seq(30, 260, 0.5), 100, 20)),
              data.frame(grupa = "B: skośny", x = seq(80.5, 260, 0.5),
                         y = dlnorm(seq(80.5, 260, 0.5) - 80, log(20))))   # B − 80 ma rozkład log-normalny
p3a <- ggplot(gest, aes(x, y, colour = grupa, linetype = grupa)) +
  geom_line(linewidth = 1.1) +
  geom_vline(xintercept = 100, colour = "grey25", linetype = "dotted") +
  annotate("text", x = 103, y = max(gest$y) * 0.98, hjust = 0, size = 4.6, colour = "grey25",
           label = "obie mediany = 100") +
  scale_colour_manual(values = c("A: symetryczny" = kol[["kontrolna"]], "B: skośny" = kol[["trening"]]), name = NULL) +
  scale_linetype_manual(values = c("A: symetryczny" = "solid", "B: skośny" = "dashed"), name = NULL) +
  coord_cartesian(xlim = c(30, 230)) +
  labs(subtitle = sprintf("A. Populacje: ta sama mediana, P(B > A) = %.3f", mean(B > A)),
       x = "Czas wykonania zadania (s)", y = "Gęstość") + motyw
p3b <- ggplot(sym, aes(n, 100 * odsetek, colour = test, shape = test)) +
  geom_hline(yintercept = 5, colour = "grey40", linetype = "dashed") +
  geom_line(linewidth = 0.8) +
  geom_pointrange(aes(ymin = 100 * (odsetek - 2 * blad_MC), ymax = 100 * (odsetek + 2 * blad_MC)), size = 0.6) +
  geom_text(aes(label = sprintf("%.1f%%", 100 * odsetek), vjust = ifelse(test == "Mann–Whitney", -1.1, 2)),
            size = 4.6, show.legend = FALSE) +
  scale_colour_manual(values = c("Mann–Whitney" = kol[["trening"]], "test mediany Mooda" = "grey35"), name = NULL) +
  scale_shape_manual(values = c("Mann–Whitney" = 17, "test mediany Mooda" = 15), name = NULL) +
  scale_x_continuous(trans = "log2", breaks = ns) +
  scale_y_continuous(limits = c(-8, 100), breaks = seq(0, 100, 20)) +
  labs(subtitle = sprintf("B. Odsetek wyników p < .05 (%s powtórzeń; pionowe kreski: ±2 błędy MC)", format(R_powt, big.mark = " ")),
       x = "Liczba osób w każdej grupie (skala logarytmiczna)", y = "% wyników p < .05") + motyw
p3 <- p3a / p3b + plot_annotation(title = "Równe mediany, a test Manna–Whitneya coraz częściej „istotny”", theme = motyw)
# p3   # wyświetl; zapis: ggsave("test-manna-whitneya-rowne-mediany.svg", p3, width = 10, height = 9)
Wynik w R
  mediana_A   mediana_B   srednia_A   srednia_B P_B_wiekszy
    100.023     100.012     100.023     113.053       0.563
     n               test odsetek_proc blad_MC_pp
1   20       Mann–Whitney         10.2        0.4
2   20 test mediany Mooda          2.4        0.2
3   50       Mann–Whitney         20.1        0.6
4   50 test mediany Mooda          7.7        0.4
5  100       Mann–Whitney         34.9        0.7
6  100 test mediany Mooda          6.4        0.3
7  200       Mann–Whitney         58.7        0.7
8  200 test mediany Mooda          6.4        0.3
9  400       Mann–Whitney         88.1        0.5
10 400 test mediany Mooda          5.4        0.3
Rysunek 4: różne mediany, a wynik nieistotny
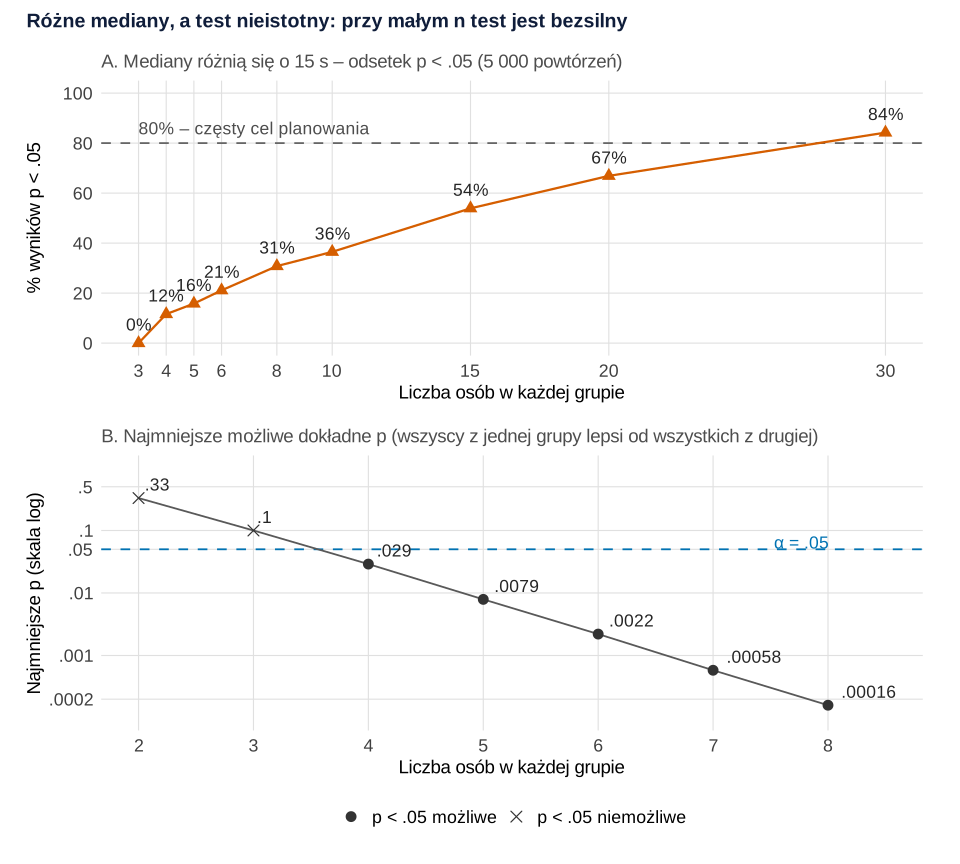
set.seed(5804), 5 000 powtórzeń na liczebność).Co widać. Teraz obie grupy mają ten sam skośny kształt, a grupa trening jest przesunięta o 15 s w lewo. Mediany populacji wynoszą 100.01 i 84.96 s, a P(trening krótszy) = .716. Różnica jest wyraźna, ale przy 6 osobach w grupie test wykrył ją tylko w 21.1% badań, przy 10 – w 36.5%. Próg 80% przekroczył dopiero przy 30 osobach (84.2%). W przykładowym badaniu z 6 osobami w grupie mediany z próby wynosiły 90.1 i 110.1 s, a mimo to p = .180. Panel B pokazuje twardą granicę. Przy 3 osobach w grupie istnieje tylko 20 równie prawdopodobnych podziałów rang, więc nawet pełne rozdzielenie grup daje p = .10. Wynik istotny na poziomie .05 jest tam niemożliwy – dlatego odsetek w panelu A wynosi 0%. Mann i Whitney (1947) podali tablice dokładnych prawdopodobieństw właśnie dla takich małych prób.
Czego ten wykres nie pokazuje – i jak może zmylić. Nieistotny wynik przy małej próbie to brak dowodu, a nie dowód braku różnicy. Krzywa w panelu A dotyczy jednego kształtu i jednej różnicy – moc testu przy innych danych będzie inna i trzeba ją policzyć osobno. Jak robić to symulacją, pokazuje wpis moc testu w obrazkach. Przy wiązaniach (np. odpowiedzi na skali 1–5) liczba możliwych układów rang jeszcze maleje, a wilcox.test() przechodzi na przybliżenie normalne.
Podpis do pracy:
Zdanie do Dyskusji:
Kod rysunku 4: moc przy małym n i najmniejsze p
4. Różne mediany, mała próba
R
# Rysunek 4. Różne mediany, mała próba: test często nieistotny – i najmniejsze możliwe p
# (kontynuacja: kol, motyw z bloku 1; ten blok losuje – ma własne ziarno)
set.seed(5804)                                   # ziarno bloku 4, ustalone raz
los_k <- function(n) 100 + 20 * (exp(rnorm(n)) - 1)          # kontrolna: skośny, mediana 100
los_t <- function(n) 100 + 20 * (exp(rnorm(n)) - 1) - 15     # trening: ten sam kształt, przesunięty o −15 s

K <- los_k(1e6); Tr <- los_t(1e6)
round(c(mediana_k = median(K), mediana_t = median(Tr), roznica_median = median(Tr) - median(K),
        P_trening_krotszy = mean(Tr < K)), 3)

R_powt <- 5000
ns <- c(3, 4, 5, 6, 8, 10, 15, 20, 30)
moc <- sapply(ns, function(n) mean(replicate(R_powt, wilcox.test(los_t(n), los_k(n))$p.value) < .05))
tab4 <- data.frame(n = ns, proc_p_ponizej_05 = round(100 * moc, 1),
                   blad_MC_pp = round(100 * sqrt(moc * (1 - moc) / R_powt), 1))
tab4
# najmniejsze dokładne p dwustronne (grupy całkowicie rozdzielone): 2 / liczba możliwych podziałów rang
minp <- data.frame(n = 2:8, najmniejsze_p = 2 / choose(2 * (2:8), 2:8))
minp$najmniejsze_p <- signif(minp$najmniejsze_p, 2)
minp

# jedno badanie z n = 6 w grupie: mediany różnią się, p > .05
x6_t <- los_t(6); x6_k <- los_k(6)
round(c(mediana_t = median(x6_t), mediana_k = median(x6_k), p = wilcox.test(x6_t, x6_k)$p.value), 3)

p4a <- ggplot(tab4, aes(n, proc_p_ponizej_05)) +
  geom_hline(yintercept = 80, colour = "grey40", linetype = "dashed") +
  geom_line(colour = kol[["trening"]], linewidth = 0.8) +
  geom_point(colour = kol[["trening"]], shape = 17, size = 3.2) +
  geom_text(aes(label = sprintf("%.0f%%", proc_p_ponizej_05)), vjust = -1, size = 4.6, colour = "grey15") +
  annotate("text", x = 3, y = 86, hjust = 0, size = 4.6, colour = "grey30", label = "80% – częsty cel planowania") +
  scale_x_continuous(breaks = ns) + scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20)) +
  labs(subtitle = sprintf("A. Mediany różnią się o 15 s – odsetek p < .05 (%s powtórzeń)", format(R_powt, big.mark = " ")),
       x = "Liczba osób w każdej grupie", y = "% wyników p < .05") + motyw
p4b <- ggplot(minp, aes(n, najmniejsze_p)) +
  geom_hline(yintercept = .05, colour = kol[["kontrolna"]], linetype = "dashed") +
  geom_line(colour = "grey35") +
  geom_point(aes(shape = najmniejsze_p > .05), colour = "grey20", size = 3.4) +
  geom_text(aes(label = sub("^0", "", format(najmniejsze_p, scientific = FALSE, drop0trailing = TRUE))),
            hjust = -0.25, vjust = -0.6, size = 4.6, colour = "grey15") +
  annotate("text", x = 8, y = .065, hjust = 1, size = 4.6, colour = kol[["kontrolna"]], label = "α = .05") +
  scale_shape_manual(values = c(`TRUE` = 4, `FALSE` = 16), labels = c(`TRUE` = "p < .05 niemożliwe", `FALSE` = "p < .05 możliwe"), name = NULL) +
  scale_x_continuous(breaks = 2:8, limits = c(2, 8.5)) +
  scale_y_log10(limits = c(.0001, 1), breaks = c(.0002, .001, .01, .05, .1, .5), labels = c(".0002", ".001", ".01", ".05", ".1", ".5")) +
  labs(subtitle = "B. Najmniejsze możliwe dokładne p (wszyscy z jednej grupy lepsi od wszystkich z drugiej)",
       x = "Liczba osób w każdej grupie", y = "Najmniejsze p (skala log)") + motyw
p4 <- p4a / p4b + plot_annotation(title = "Różne mediany, a test nieistotny: przy małym n test jest bezsilny", theme = motyw)
# p4   # wyświetl; zapis: ggsave("test-manna-whitneya-mala-proba.svg", p4, width = 10, height = 9)
Wynik w R
        mediana_k         mediana_t    roznica_median P_trening_krotszy
          100.006            84.961           -15.045             0.716
   n proc_p_ponizej_05 blad_MC_pp
1  3               0.0        0.0
2  4              11.6        0.5
3  5              15.8        0.5
4  6              21.1        0.6
5  8              30.8        0.7
6 10              36.5        0.7
7 15              53.9        0.7
8 20              66.9        0.7
9 30              84.2        0.5
  n najmniejsze_p
1 2       0.33000
2 3       0.10000
3 4       0.02900
4 5       0.00790
5 6       0.00220
6 7       0.00058
7 8       0.00016
mediana_t mediana_k         p
   90.115   110.080     0.180
Rysunek 5: przesunięcie i estymator Hodgesa–Lehmanna
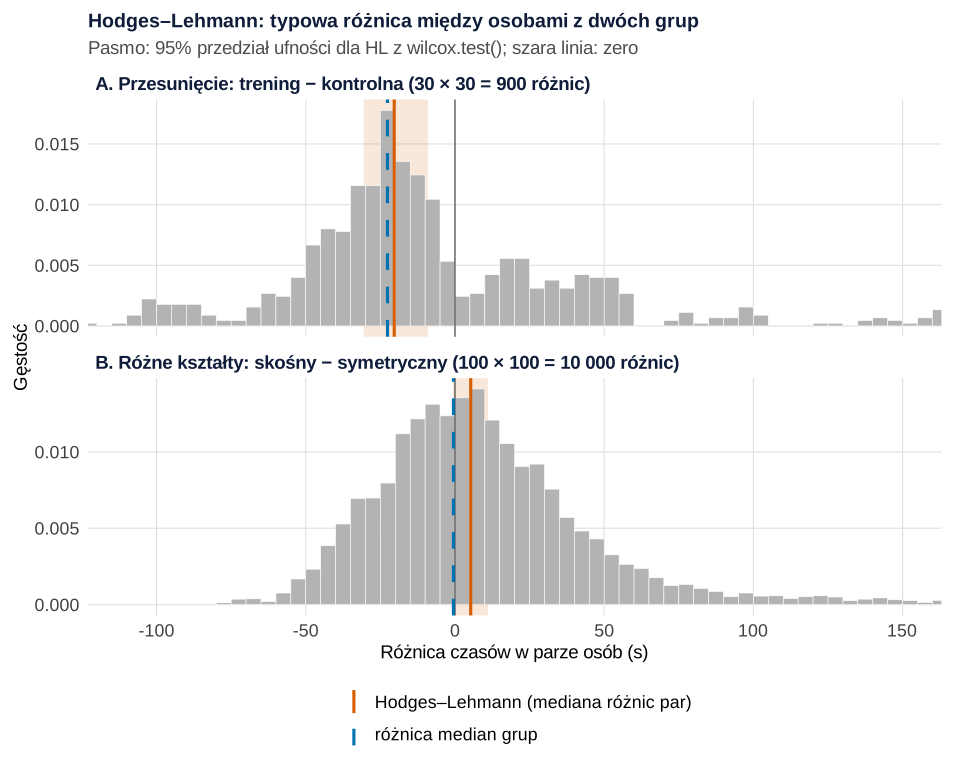
set.seed(5805)).Co widać. Estymator Hodgesa–Lehmanna (HL) to mediana wszystkich różnic par xi − yj. Hodges i Lehmann (1963) wyprowadzili go ze statystyki testu rangowego, dlatego naturalnie towarzyszy testowi Manna–Whitneya. W panelu A grupy mają ten sam kształt, a trening jest przesunięty o 15 s (30 osób w grupie). HL wynosi −20.36 s, 95% CI [−30.60, −9.03], różnica median z próby −22.60 s, różnica średnich −27.03 s, a p = .003. Wszystkie trzy liczby szacują to samo przesunięcie, a HL – w modelu przesunięcia – także różnicę median. W panelu B (100 osób w grupie) populacje mają równe mediany, ale różny kształt – jak na rysunku 3. Różnica median z próby wynosi −0.51 s, a HL 5.28 s, 95% CI [−0.70, 11.09], p = .080. W populacji różnica median to −0.02 s, a mediana różnic par – 4.59 s. To dwa różne parametry.
Czego ten wykres nie pokazuje – i jak może zmylić. Etykieta „location shift” w wydruku wilcox.test() nie sprawdza, czy model przesunięcia jest prawdziwy – to tylko nazwa parametru. Fay i Proschan (2010) opisują kilka „perspektyw”, czyli zestawów założeń, w których ten sam wynik testu znaczy co innego. Założenie przesunięcia oceniasz na wykresie rozkładów, np. na dystrybuantach empirycznych obu grup (wpis rozkład zmiennej na wykresie). Ręcznie policzona mediana różnic (5.283) i wartość z wilcox.test() (5.277) różnią się w trzecim miejscu po przecinku. Przy dużych grupach R szuka estymatora numerycznie z przybliżenia normalnego.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 5: mediana różnic par i kontrola palety
5. Hodges–Lehmann przy przesunięciu i przy różnych kształtach
R
# Rysunek 5. Estymator Hodgesa–Lehmanna: mediana wszystkich różnic par – przy przesunięciu i przy różnych kształtach
# (kontynuacja: kol, motyw z bloku 1; ten blok losuje – ma własne ziarno)
set.seed(5805)                                   # ziarno bloku 5, ustalone raz
skosny <- function(n) 100 + 20 * (exp(rnorm(n)) - 1)          # ten sam skośny kształt co w blokach 3 i 4

# Scenariusz A: model przesunięcia – trening = ten sam kształt przesunięty o −15 s (n = 30 w grupie)
kA <- skosny(30); tA <- skosny(30) - 15
# Scenariusz B: różne kształty, równe mediany populacji – skośny vs symetryczny (n = 100 w grupie)
aB <- rnorm(100, 100, 20); bB <- skosny(100)

opis_hl <- function(x, y) {                      # x − y: HL, przedział, różnica median i średnich
  w <- wilcox.test(x, y, conf.int = TRUE)
  c(HL_reczne = median(outer(x, y, "-")), HL_wilcox = unname(w$estimate), CI_dolna = w$conf.int[1],
    CI_gorna = w$conf.int[2], roznica_median = median(x) - median(y), roznica_srednich = mean(x) - mean(y),
    U = unname(w$statistic), PS = mean(outer(x, y, ">")), p = w$p.value)
}
wynik5 <- rbind(A_przesuniecie = opis_hl(tA, kA), B_rozne_ksztalty = opis_hl(bB, aB))
round(wynik5, 3)
# parametry populacji w scenariuszu B (milion par): różnica median = 0, a mediana różnic B − A – nie
duzaA <- rnorm(1e6, 100, 20); duzaB <- skosny(1e6)
round(c(roznica_median_pop = median(duzaB) - median(duzaA), mediana_roznic_pop = median(duzaB - duzaA)), 2)

roznice <- rbind(data.frame(scen = "A. Przesunięcie: trening − kontrolna (30 × 30 = 900 różnic)", r = as.vector(outer(tA, kA, "-"))),
                 data.frame(scen = "B. Różne kształty: skośny − symetryczny (100 × 100 = 10 000 różnic)", r = as.vector(outer(bB, aB, "-"))))
linie <- data.frame(scen = rep(unique(roznice$scen), each = 2),
                    miara = rep(c("Hodges–Lehmann (mediana różnic par)", "różnica median grup"), 2),
                    x = c(wynik5[1, "HL_wilcox"], wynik5[1, "roznica_median"], wynik5[2, "HL_wilcox"], wynik5[2, "roznica_median"]))
przedz <- data.frame(scen = unique(roznice$scen), lo = wynik5[, "CI_dolna"], hi = wynik5[, "CI_gorna"])
p5 <- ggplot(roznice, aes(r)) +
  geom_rect(data = przedz, aes(xmin = lo, xmax = hi, ymin = -Inf, ymax = Inf), inherit.aes = FALSE,
            fill = kol[["trening"]], alpha = 0.15) +
  geom_histogram(aes(y = after_stat(density)), binwidth = 5, boundary = 0, fill = kol[["szary"]], colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 0, colour = "grey25", linewidth = 0.4) +
  geom_vline(data = linie, aes(xintercept = x, colour = miara, linetype = miara), linewidth = 1.1) +
  facet_wrap(~ scen, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = c("Hodges–Lehmann (mediana różnic par)" = kol[["trening"]], "różnica median grup" = kol[["kontrolna"]]), name = NULL) +
  scale_linetype_manual(values = c("Hodges–Lehmann (mediana różnic par)" = "solid", "różnica median grup" = "dashed"), name = NULL) +
  coord_cartesian(xlim = c(-110, 150)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Hodges–Lehmann: typowa różnica między osobami z dwóch grup",
       subtitle = "Pasmo: 95% przedział ufności dla HL z wilcox.test(); szara linia: zero",
       x = "Różnica czasów w parze osób (s)", y = "Gęstość") + motyw
# p5   # wyświetl; zapis: ggsave("test-manna-whitneya-hodges-lehmann.svg", p5, width = 10, height = 8)
Wynik w R
                 HL_reczne HL_wilcox CI_dolna CI_gorna roznica_median
A_przesuniecie     -20.358   -20.358  -30.604   -9.025        -22.604
B_rozne_ksztalty     5.283     5.277   -0.696   11.094         -0.513
                 roznica_srednich    U    PS     p
A_przesuniecie            -27.031  254 0.282 0.003
B_rozne_ksztalty           15.104 5717 0.572 0.080
roznica_median_pop mediana_roznic_pop
             -0.02               4.59
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy kolory rysunków przetrwają zaburzenia widzenia barw? Symulacja w pakiecie colorspace
# (ten blok niczego nie losuje)
library(colorspace)
roznica <- function(k) {                        # najmniejsza odległość ΔE (CIELAB) między kolorami zestawu
  lab <- coords(as(hex2RGB(k), "LAB")); min(dist(lab))
}
zestawy <- list("kontrolna / trening (rysunki 1–5)" = c("#0072B2", "#D55E00"),
                "dwie grupy + szare tło (rysunki 3, 5)" = c("#0072B2", "#D55E00", "#B3B3B3", "#595959"),
                "czerwony – zielony (dla porównania)" = c("#E41A1C", "#4DAF4A"))
round(t(sapply(zestawy, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                      protanopia = roznica(protan(k))))), 1)
Wynik w R
                                      widzenie_typowe deuteranopia protanopia
kontrolna / trening (rysunki 1–5)               114.6        108.3       91.9
dwie grupy + szare tło (rysunki 3, 5)            35.1         35.1       35.1
czerwony – zielony (dla porównania)             121.7         21.1       31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test Manna–Whitneya z estymatorem Hodgesa–Lehmanna – funkcja wilcox.test(), test mediany Mooda – chisq.test(), losowanie i symulacje – pakiet stats). Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Co napisać w pracy
- Nazwij pytanie testu. „Wyniki w grupie A były zwykle wyższe niż w grupie B” – to pasuje do każdego wyniku testu U. „Mediany się różniły” – tylko gdy rozkłady mają podobny kształt (rysunki 3 i 5).
- Podaj wielkość efektu w skali par: prawdopodobieństwo przewagi albo korelację rangowo-dwuseryjną, z kierunkiem i przedziałem ufności (rysunek 2).
- Podaj mediany i kwartyle jako opis grup, a nie jako to, co test „porównał”.
- Przy modelu przesunięcia dodaj estymator Hodgesa–Lehmanna z 95% CI – to różnica w jednostkach wyniku, którą czytelnik zrozumie (rysunek 5).
- Przy małej próbie podaj dokładne p i napisz wprost, że moc była niska (rysunek 4).
- Pokaż rozkłady – punkty z wykresem pudełkowym albo ECDF. Hart (2001) zaleca opisywać istotne cechy danych, a nie tylko wartość p.
Jeśli pytasz o średnie, a rozkład nie jest normalny, test U nie jest automatycznym zamiennikiem testu t. Najpierw ustal, na jakie pytanie chcesz odpowiedzieć – pomagają w tym wpisy test t Studenta krok po kroku i jak sprawdzić normalność rozkładu. Odpowiednikiem testu U dla pomiarów powtarzanych jest test Wilcoxona, a dlaczego pary trzeba analizować jako pary, pokazuje wpis próby zależne w obrazkach. Jak różne miary wielkości efektu wyglądają na rozkładach normalnych, pokazuje wpis wielkość efektu w obrazkach.
Najczęstsze błędy
- „Test Manna–Whitneya wykazał różnicę median” bez sprawdzenia kształtu rozkładów. Przy równych medianach i różnych kształtach test dawał p < .05 w 88.1% badań po 400 osób (rysunek 3).
- „Brak różnicy” po nieistotnym teście w małej próbie. Przy różnicy median 15 s i 6 osobach w grupie test był istotny w 21.1% badań, a przy 3 osobach nie może być istotny wcale (rysunek 4).
- Prawdopodobieństwo przewagi bez kierunku – .321 dla jednej grupy to .679 dla drugiej (rysunek 2).
- Estymator Hodgesa–Lehmanna nazwany różnicą median przy różnych kształtach rozkładów (rysunek 5).
- Mylenie W z R z U z SPSS. R podaje U pierwszej grupy w wywołaniu, SPSS – mniejszą z dwóch wartości. Napisz, której grupy dotyczy liczba.
- Wynik bez wykresu. Rangi gubią odległości (rysunek 1) – bez rysunku rozkładów czytelnik nie wie, czy różnica dotyczy położenia, rozproszenia, czy ogona.
Najczęstsze pytania
Czy test U Manna–Whitneya porównuje mediany?
Nie wprost. Test sprawdza, czy prawdopodobieństwo, że losowa osoba z jednej grupy ma wyższy wynik niż losowa osoba z drugiej, różni się od 50% (Divine i in., 2018). W symulacji dwie populacje o tej samej medianie, ale różnym kształcie, dawały p < .05 w 88.1% badań po 400 osób w grupie. O różnicy median możesz mówić dopiero wtedy, gdy rozkłady mają ten sam kształt i różnią się tylko położeniem.
Co to jest prawdopodobieństwo przewagi w teście Manna–Whitneya?
To odsetek wszystkich par (osoba z grupy 1, osoba z grupy 2), w których wyższy wynik ma osoba z grupy 1; remisy liczą się po połowie. Jest równe U / (n1n2). W przykładzie z 7 i 8 osobami osoba z grupy trening miała dłuższy czas w 18 z 56 par, więc P = .321. Ta sama liczba to pole pod krzywą ROC, a 2P − 1 to korelacja rangowo-dwuseryjna.
Dlaczego test Manna–Whitneya jest nieistotny przy małej próbie?
Przy kilku osobach w grupie test ma mało możliwych układów rang, więc ma małą moc. Przy 3 osobach w grupie najmniejsze możliwe dokładne p dwustronne wynosi .10, więc wynik nie może być istotny na poziomie .05 nawet przy pełnym rozdzieleniu grup. W symulacji z różnicą median 15 s test wykrył ją w 21.1% badań przy 6 osobach w grupie i w 84.2% przy 30.
Co to jest estymator Hodgesa–Lehmanna przy teście Manna–Whitneya?
To mediana wszystkich różnic par xi − yj, którą R podaje w wilcox.test(..., conf.int = TRUE) razem z przedziałem ufności (Hodges i Lehmann, 1963). Gdy rozkłady różnią się tylko przesunięciem, szacuje to przesunięcie. Gdy różnią się kształtem, nie jest różnicą median: w symulacji różnica median wynosiła −0.51 s, a estymator 5.28 s.
Jak opisać wynik testu Manna–Whitneya w pracy?
Podaj U (lub W z R z informacją, której grupy dotyczy), p, prawdopodobieństwo przewagi albo korelację rangowo-dwuseryjną oraz mediany i kwartyle grup. Pisz o przewadze: „wyniki w grupie A były zwykle wyższe”. Pokaż rozkłady na wykresie, bo dopiero on pozwala ocenić, czy różnica dotyczy położenia, czy kształtu (Hart, 2001).
Powiązane hasła
Przeczytaj też
Testy odporne: Welch, Yuen, Brunner–Munzel
Co porównuje każdy test, miary efektu z CI, Brunner–Munzel liczony ręcznie w R i symulacja błędu I rodzaju przy nierównych grupach – ze wzorem opisu APA.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →PoradnikKrzywa ROC w obrazkach
Dwa rozkłady i próg, punkty na krzywej, AUC jako odsetek wygranych par, d a kształt krzywej, Youden i koszty, CI dla AUC – sześć rysunków z R.
Czytaj →Nie wiesz, jak opisać wynik testu Manna–Whitneya?
Pomożemy dobrać test do pytania badawczego, policzyć wielkość efektu z przedziałem ufności i opisać wynik tak, żebyś umiał(a) go wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Divine, G. W., Norton, H. J., Barón, A. E., & Juarez-Colunga, E. (2018). The Wilcoxon–Mann–Whitney procedure fails as a test of medians. The American Statistician, 72(3), 278–286. https://doi.org/10.1080/00031305.2017.1305291 ● Otwarty dostęp
- Fagerland, M. W., & Sandvik, L. (2009). The Wilcoxon–Mann–Whitney test under scrutiny. Statistics in Medicine, 28(10), 1487–1497. https://doi.org/10.1002/sim.3561
- Fay, M. P., & Proschan, M. A. (2010). Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules. Statistics Surveys, 4, 1–39. https://doi.org/10.1214/09-SS051 ● Otwarty dostęp
- Hart, A. (2001). Mann-Whitney test is not just a test of medians: Differences in spread can be important. BMJ, 323(7309), 391–393. https://doi.org/10.1136/bmj.323.7309.391 ● Otwarty dostęp
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598–611. https://doi.org/10.1214/aoms/1177704172 ● Otwarty dostęp
- Karch, J. D. (2021). Psychologists should use Brunner-Munzel’s instead of Mann-Whitney’s U test as the default nonparametric procedure. Advances in Methods and Practices in Psychological Science, 4(2), Article 2515245921999602. https://doi.org/10.1177/2515245921999602 ● Otwarty dostęp
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491 ● Otwarty dostęp
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
Cytowania BibTeX
@article{divine2018wilcoxon, author={Divine, George W. and Norton, H. James and Barón, Anna E. and Juarez-Colunga, Elizabeth}, title={{The Wilcoxon–Mann–Whitney procedure fails as a test of medians}}, journal={The American Statistician}, year={2018}, volume={72}, number={3}, pages={278--286}, doi={10.1080/00031305.2017.1305291}}@article{fagerland2009wilcoxon, author={Fagerland, Morten W. and Sandvik, Leiv}, title={{The Wilcoxon–Mann–Whitney test under scrutiny}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={10}, pages={1487--1497}, doi={10.1002/sim.3561}}@article{fay2010wilcoxon, author={Fay, Michael P. and Proschan, Michael A.}, title={{Wilcoxon–Mann–Whitney or t-test? On assumptions for hypothesis tests and multiple interpretations of decision rules}}, journal={Statistics Surveys}, year={2010}, volume={4}, pages={1--39}, doi={10.1214/09-ss051}}@article{hart2001mann, author={Hart, Anna}, title={{Mann-Whitney test is not just a test of medians: Differences in spread can be important}}, journal={BMJ}, year={2001}, volume={323}, number={7309}, pages={391--393}, doi={10.1136/bmj.323.7309.391}}@article{hodges1963estimates, author={Hodges, J. L. and Lehmann, E. L.}, title={{Estimates of location based on rank tests}}, journal={The Annals of Mathematical Statistics}, year={1963}, volume={34}, number={2}, pages={598--611}, doi={10.1214/aoms/1177704172}}@article{karch2021psychologists, author={Karch, Julian D.}, title={{Psychologists should use Brunner-Munzel’s instead of Mann-Whitney’s U test as the default nonparametric procedure}}, journal={Advances in Methods and Practices in Psychological Science}, year={2021}, volume={4}, number={2}, eid={2515245921999602}, doi={10.1177/2515245921999602}}@article{mann1947test, author={Mann, H. B. and Whitney, D. R.}, title={{On a test of whether one of two random variables is stochastically larger than the other}}, journal={The Annals of Mathematical Statistics}, year={1947}, volume={18}, number={1}, pages={50--60}, doi={10.1214/aoms/1177730491}}@article{mcgraw1992common, author={McGraw, Kenneth O. and Wong, S. P.}, title={{A common language effect size statistic}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={2}, pages={361--365}, doi={10.1037/0033-2909.111.2.361}}