Liczba, której nie widać
„d = 0.5, efekt średni” – takie zdanie pada w wielu pracach dyplomowych, ale mało kto potrafi powiedzieć, jak taki efekt wygląda w danych. W tym wpisie rysujemy wielkość efektu zamiast ją definiować: dwa rozkłady normalne dla kilku wartości d Cohena, tę samą różnicę średnich przy różnym rozrzucie, oszacowania d z małych i dużych prób, korelacje na wykresie rozrzutu i iloraz szans pokazany jako słupki ryzyka. Przy każdym rysunku znajdziesz: co widać, jak wykres może zmylić, gotowy podpis do pracy i zdanie do rozdziału Wyniki.
Definicje miar, wzory przeliczeń między d, r i OR oraz krytykę progów 0.2/0.5/0.8 omawia wpis wielkość efektu – interpretacja. Tu ich nie powtarzamy, a gotowe przeliczenia zrobisz w konwerterze wielkości efektu. Wszystkie dane są fikcyjne. Wartości ze wzorów sprawdzamy symulacją Monte Carlo w R. Ziarna (5691, 5693, 5694) ustalono raz, przed pierwszym uruchomieniem, bez dobierania pod ładny obraz. Pełny kod jest na końcu wpisu.
1. Jak wyglądają d = 0.2, 0.5, 0.8 i 1.2
Załóżmy, że wyniki w obu grupach mają rozkład normalny z tym samym odchyleniem standardowym. Wtedy d to odległość między średnimi wyrażona w SD. Rysunek 1 pokazuje cztery takie pary rozkładów. Pole wspólne dla obu krzywych jest zacienione na szaro.
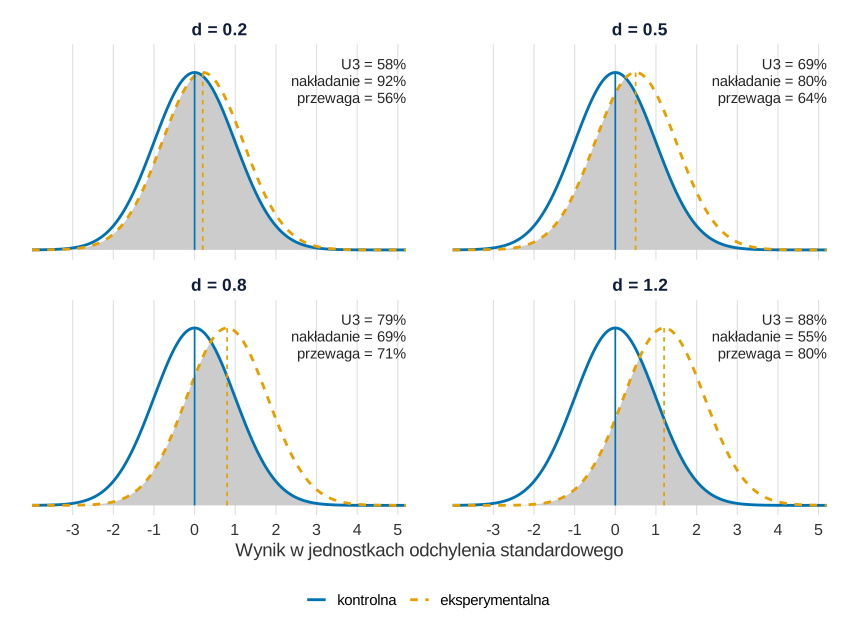
Na rysunku są trzy „ludzkie” przekłady tej samej liczby d:
- U3 Cohena – odsetek grupy eksperymentalnej powyżej średniej grupy kontrolnej. Przy d = 0.5 jest to 69.1%, a nie „wszyscy”.
- Nakładanie się rozkładów (OVL) – wspólne pole pod obiema krzywymi, czyli miara podobieństwa rozkładów (Reiser i Faraggi, 1999). Przy d = 0.8 wynosi 68.9%.
- Prawdopodobieństwo przewagi – jak często wynik losowej osoby z jednej grupy jest wyższy od wyniku losowej osoby z drugiej (McGraw i Wong, 1992). Odpowiada mu miara A Varghi–Delaneya. Przy d = 0.5 osoba z grupy eksperymentalnej „wygrywa” w 63.8% losowych par.
Sprawdzenie symulacją. Dla każdego d wylosowaliśmy po 100 000 osób w grupie i policzyliśmy te trzy wielkości wprost z danych. Wyniki różniły się od wzorów najwyżej o około 0.2 punktu procentowego, np. przewaga przy d = 0.5 wyniosła 63.7% (wzór: 63.8%). Błąd Monte Carlo tej proporcji to 0.13–0.16 pp, więc różnice mieszczą się w losowym szumie.
- Co widać. Nawet przy d = 0.8, „dużym” według konwencji, rozkłady pokrywają się w 68.9%. Osoba z grupy eksperymentalnej ma wyższy wynik niż losowa osoba z grupy kontrolnej w 71.4% par, a więc w prawie co trzeciej parze jest odwrotnie. Przy d = 0.2 krzywe są prawie nie do odróżnienia (nakładanie 92.0%).
- Czego wykres nie pokazuje i jak może zmylić. To krzywe teoretyczne: idealnie normalne i o równych SD. Przy skośnych danych albo różnych SD wartości U3 i przewagi ze wzorów przestają się zgadzać z danymi. Wtedy policz je empirycznie albo użyj miary A (zob. wielkość efektu w testach nieparametrycznych). Wykres nie mówi też nic o zmianie u konkretnych osób – U3 opisuje położenie rozkładów, a nie odsetek osób, którym „pomogło”.
- Podpis do pracy. Rysunek 1. Rozkłady wyników w grupie eksperymentalnej i kontrolnej przy różnicy średnich d = 0.5. Nota. Krzywe – rozkłady normalne o równych odchyleniach standardowych; szare pole – część wspólna rozkładów (80.3%).
- Zdanie do Wyników. „Grupa eksperymentalna uzyskała wyższe wyniki niż kontrolna, d = 0.50; przy założeniu normalności oznacza to, że około 69% osób z grupy eksperymentalnej miało wynik powyżej średniej grupy kontrolnej (U3), a rozkłady obu grup w 80% się pokrywały”.
Hanel i Mehler (2019) porównali, które sposoby podania efektu laikom wydają się najbardziej informacyjne. U3 wypadło najlepiej: 69% uczestników uznało je za bardziej informacyjne niż d. Dlatego warto dopisać jedną z tych liczb obok d – szczególnie we wnioskach i streszczeniu.
2. Ta sama różnica średnich, różne SD
d to różnica średnich podzielona przez SD. Ta sama różnica w punktach może więc dać bardzo różne d. Fikcyjny test wiedzy: grupa po szkoleniu ma średnio 55 punktów, grupa bez szkolenia 50. Różnica wynosi zawsze 5 punktów, zmienia się tylko rozrzut wyników.
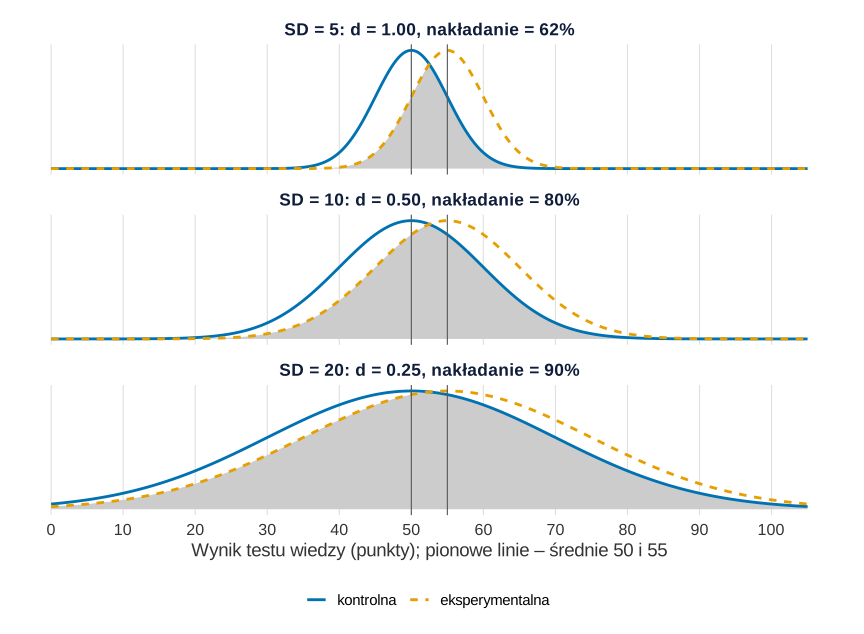
- Co widać. Przy SD = 5 ta sama różnica daje d = 1.00 i nakładanie 61.7%. Przy SD = 10 – d = 0.50 i 80.3%. Przy SD = 20 – d = 0.25 i 90.1%. Średnie stoją w tych samych miejscach, a „wielkość efektu” zmienia się czterokrotnie.
- Czego wykres nie pokazuje i jak może zmylić. Każdy panel ma własną skalę pionową, żeby kształty były czytelne. Dlatego wąska krzywa przy SD = 5 nie wygląda na wyższą, choć w rzeczywistości jest czterokrotnie wyższa niż przy SD = 20. Wykres nie mówi też, skąd bierze się różnica w SD. Może to być jednorodna próba (np. jeden rocznik jednego kierunku – zob. ograniczony zakres w kwartecie Anscombe’a), mało rzetelne narzędzie, które dokłada szumu, albo inny schemat badania. Baguley (2009) pokazuje, że rzetelność, ograniczenie zakresu i schemat badania zniekształcają standaryzowaną wielkość efektu. Radzi więc przede wszystkim podawać prostą różnicę w jednostkach skali z przedziałem ufności.
- Podpis do pracy. Rysunek 2. Ta sama różnica średnich (5 punktów) przy różnym rozrzucie wyników. Nota. Krzywe – rozkłady normalne o średnich 50 i 55 punktów i odchyleniach standardowych 5, 10 i 20; skale pionowe paneli są niezależne.
- Zdanie do Wyników. „Osoby po szkoleniu uzyskały średnio o 5 punktów więcej (na skali 0–100), co przy odchyleniu standardowym 10 punktów odpowiada d = 0.50”. Najpierw różnica w jednostkach skali, potem d.
Wniosek praktyczny: dwóch badań z różnych populacji nie porównuj samym d. Jeśli w jednym badano studentów jednego rocznika, a w drugim całą populację dorosłych, to samo d może oznaczać inną różnicę w punktach. Przy pomiarach powtarzanych dochodzi jeszcze wybór SD w mianowniku – opisuje to hasło wielkość efektu dla prób zależnych.
3. d z małej próby skacze
Wielkość efektu z jednego badania to oszacowanie, a nie stała. Zasymulowaliśmy 10 000 badań z prawdziwym d = 0.5 – osobno z 20 i z 200 osobami w każdej grupie. W każdym badaniu policzyliśmy d i jego 95% przedział ufności (z niecentralnego rozkładu t).
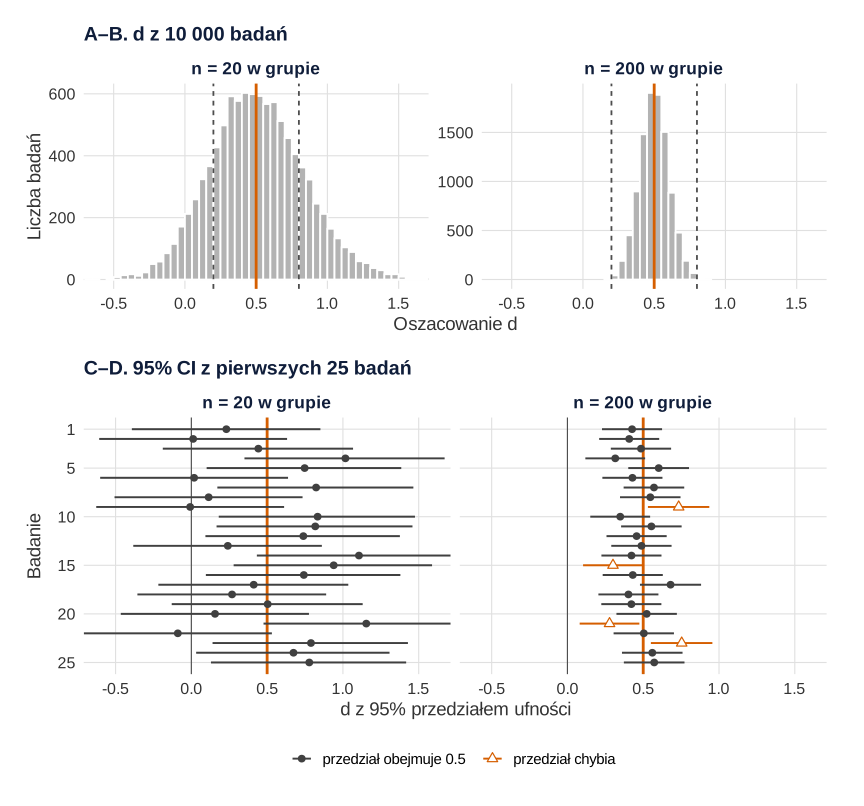
- Co widać. Przy 20 osobach w grupie 95% oszacowań leżało między −0.11 a 1.19. W 17.2% badań wyszło d < 0.2, czyli „efekt pomijalny”, w 18.8% – d > 0.8, czyli „efekt duży”, a w 5.6% – efekt o przeciwnym znaku. Przy 200 osobach zakres skurczył się do 0.30–0.71, a tylko 0.1–0.2% oszacowań przekroczyło progi 0.2 lub 0.8. Średnia szerokość 95% CI wyniosła 1.27 przy n = 20 i 0.40 przy n = 200. Pokrycie było bliskie nominalnego w obu wariantach: 94.9% i 94.7% (błąd Monte Carlo 0.2 pp).
- Czego wykres nie pokazuje i jak może zmylić. Panele C–D pokazują tylko 25 badań. Przypadkiem przy n = 20 wszystkie przedziały trafiły, a przy n = 200 chybiły 4. To nie znaczy, że małe próby dają „lepsze” przedziały. 95% to odsetek w długiej serii (tu 10 000 badań), a nie gwarancja w każdych 25. Szersze przedziały przy małym n trafiają, bo obejmują niemal wszystko – od efektu ujemnego do dużego. Panele A–B mają też różne skale pionowe. Więcej o samym przedziale ufności, także o pokryciu, jest we wpisie przedział ufności w obrazkach.
- Podpis do pracy. Rysunek 3. Rozkład oszacowań d Cohena w 10 000 symulowanych badań przy prawdziwym d = 0.5 i liczebności 20 albo 200 osób w grupie. Nota. Dane symulowane z rozkładów normalnych o równych odchyleniach standardowych.
- Zdanie do Wyników. „Różnica między grupami wyniosła d = 0.50, 95% CI [−0.13, 1.13]; przedział jest zgodny zarówno z brakiem efektu, jak i z efektem dużym, dlatego wielkości efektu nie można precyzyjnie określić”. Ten przedział dla d = 0.50 i 20 osób w grupie liczy przepis 3.
Średnie d z 10 000 małych badań wyniosło 0.510 zamiast 0.500. To niewielkie obciążenie estymatora w małych próbach, które opisał Hedges (1981). Poprawia je g Hedgesa. Znacznie groźniejsza jest jednak selekcja: jeśli do publikacji trafiają tylko wyniki istotne, z szerokiego histogramu przy n = 20 przeżywa głównie prawy ogon. Ten mechanizm, czyli klątwę zwycięzcy, pokazuje wpis moc testu w obrazkach. Jeśli chcesz oszacować efekt z określoną precyzją, planuj liczebność pod szerokość przedziału, a nie tylko pod moc. Metody takiego planowania dla d opracowali Kelley i Rausch (2006).
4. r = .1, .3 i .5 na wykresie rozrzutu
Z korelacją jest podobnie: liczba brzmi poważnie, a obraz bywa rozczarowujący. Rysunek 4 pokazuje po 200 fikcyjnych osób. Dane przekształcono tak, by korelacja Pearsona w próbie wynosiła dokładnie 0, .10, .30 i .50 (plik wielkosc-efektu-korelacje-dane.csv).
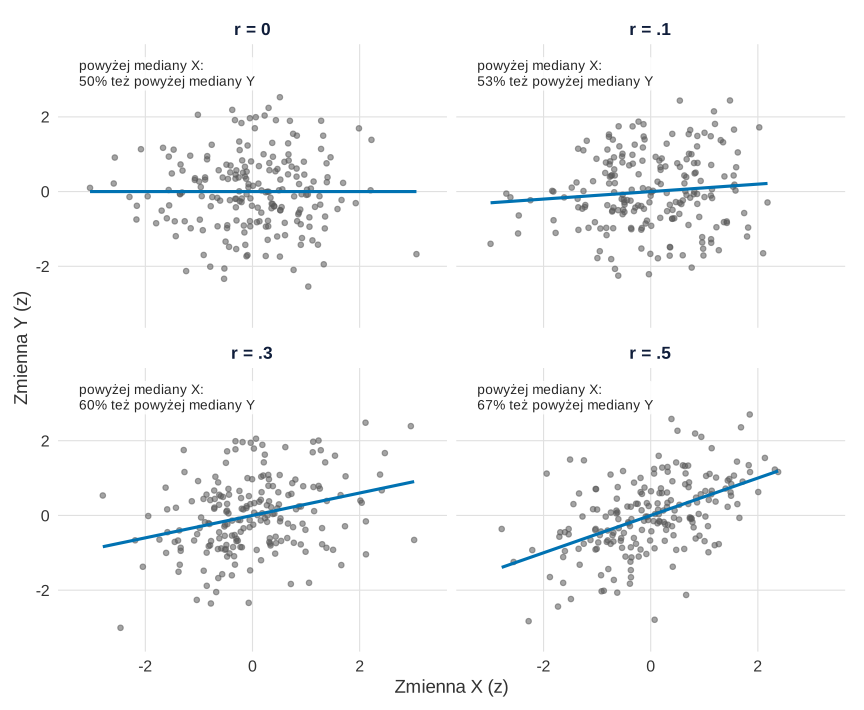
- Co widać. r = .10 jest gołym okiem nie do odróżnienia od braku związku. r = .30 to wciąż „chmura z lekkim nachyleniem”. Dopiero przy r = .50 kształt elipsy jest wyraźny. Przekład na osoby: wśród osób powyżej mediany X powyżej mediany Y jest 53.2% przy r = .10, 59.7% przy r = .30 i 66.7% przy r = .50 (wobec 50% przy braku związku). Symulacja na 100 000 osobach dała 53.3%, 59.8% i 66.5% (błąd Monte Carlo 0.2 pp).
- Czego wykres nie pokazuje i jak może zmylić. To idealne dane: normalne, liniowe, bez wartości odstających. Ta sama liczba r może opisywać zupełnie inną chmurę – stąd kwartet Anscombe’a. Wrażenie siły związku zależy też od proporcji osi i liczby punktów. Przy 2000 punktach ta sama korelacja wygląda „gęściej”, przy 30 – przypadkowo. Nie dziel też korelacji na „wyjaśnioną wariancję”: r2 = 9% przy r = .30 brzmi jak nic, a Funder i Ozer (2019) zaliczają podnoszenie r do kwadratu do błędów, które wprowadzają w błąd przy ocenie efektu.
- Podpis do pracy. Rysunek 4. Związek między zmienną X i Y (N = 200). Nota. Punkty – osoby badane; linia – prosta regresji metodą najmniejszych kwadratów; r = .30.
- Zdanie do Wyników. „Zmienne X i Y korelowały dodatnio, r(198) = .30; wśród osób z wynikiem X powyżej mediany 60% miało także wynik Y powyżej mediany (Rysunek 4)”. Przekład „powyżej mediany” podawaj tylko przy danych zbliżonych do normalnych.
Ogólne zasady rysowania korelacji (mapy cieplne, macierze rozrzutu, przedziały) są we wpisie korelacje na wykresie.
5. Iloraz szans jako słupki ryzyka
Przy wyniku „tak/nie” wielkość efektu podaje się często jako iloraz szans. Kłopot w tym, że OR nie mówi, ile osób ma zdarzenie. Rysunek 5 pokazuje dwa fikcyjne scenariusze z tym samym OR = 2. W pierwszym zdarzenie jest rzadkie (5% w grupie porównawczej), w drugim częste (40%).
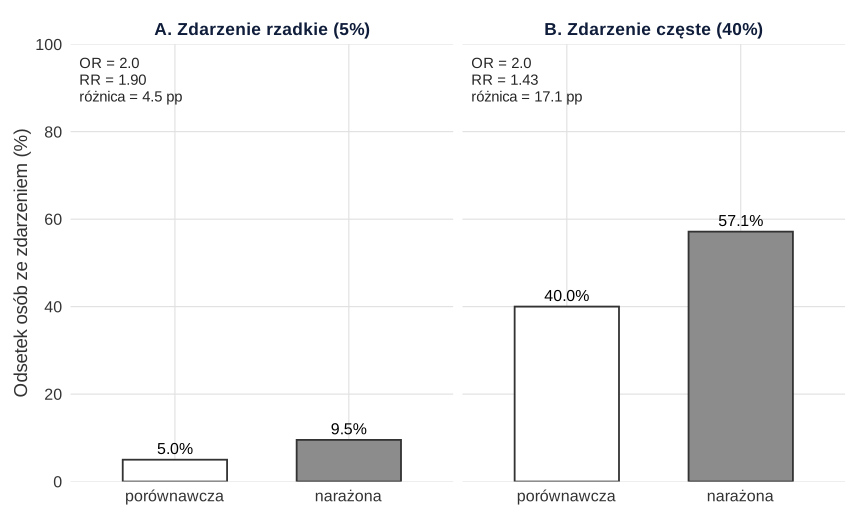
- Co widać. Przy rzadkim zdarzeniu OR = 2 oznacza wzrost z 5.0% do 9.5%: ryzyko względne 1.90, różnica 4.5 punktu procentowego, NNT około 22. Przy częstym – wzrost z 40.0% do 57.1%: RR = 1.43, różnica 17.1 pp, NNT około 6. Ten sam OR, prawie czterokrotnie większa różnica w liczbie osób.
- Czego wykres nie pokazuje i jak może zmylić. Słupki pokazują odsetki, nie liczebności – przy małych grupach dopisz n i przedziały ufności. Oś od 0 do 100% jest uczciwa, ale sprawia, że różnica 4.5 pp w panelu A wydaje się mała. Jeśli zdarzenie jest rzadkie i ważne, pokaż je też w osobnym, powiększonym panelu i podpisz skalę. Chen i in. (2010) powiązali wartości OR z d przy częstości zdarzenia 1% w grupie nienarażonej. Przy innej częstości te same OR odpowiadają innym różnicom, więc jeden uniwersalny próg „dużego OR” nie istnieje.
- Podpis do pracy. Rysunek 5. Odsetek osób ze zdarzeniem w grupie porównawczej i narażonej. Nota. OR = 2.0; RR = 1.43; różnica ryzyka 17.1 punktu procentowego.
- Zdanie do Wyników. „W grupie narażonej zdarzenie wystąpiło u 57.1% osób, a w porównawczej u 40.0% (różnica 17.1 punktu procentowego; OR = 2.00, RR = 1.43)”. Odsetki w obu grupach podawaj zawsze obok OR.
Liczenie OR, RR i NNT z tabeli krzyżowej z przedziałami ufności pokazuje sekcja o wyniku „tak/nie” we wpisie wielkość efektu – interpretacja.
Co z tych obrazków przenieść do pracy
- Obok d podaj jedną liczbę „dla ludzi” – U3, nakładanie albo prawdopodobieństwo przewagi – i zaznacz założenie normalności.
- Najpierw różnica w jednostkach skali, potem d. Zwłaszcza gdy porównujesz się z badaniem na innej populacji.
- Zawsze przedział ufności dla d. Przy kilkudziesięciu osobach w grupie etykieta „mały/średni/duży” jest prawie bez znaczenia.
- Korelację pokaż na wykresie rozrzutu i nie oceniaj jej przez r2. To samo dotyczy miar „procentu wyjaśnionej wariancji” w ANOVA, np. omega kwadrat – zawsze zestaw je z różnicą średnich.
- Przy OR podaj odsetki w obu grupach, a najlepiej także różnicę ryzyka.
Rysunki do wszystkich tych sytuacji przygotujesz według zasad z wpisu wykresy w pracy dyplomowej. Porównanie dwóch grup na rzeczywistych danych (zamiast krzywych teoretycznych) pokazuje wpis porównanie grup na wykresie.
Wielkość efektu w obrazkach – pełny kod R
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R – kolejne korzystają z motywu i palety z przepisu 1. Rysunek wyświetlisz, wpisując jego nazwę (np. rys1), a zapiszesz odkomentowaną linią ggsave(). Ziarna 5691, 5693 i 5694 ustalono raz, bez dobierania pod wynik; przepisy 2 i 5 nie losują.
1. Motyw, paleta i nakładanie się rozkładów (Rysunek 1)
R
# Rysunek 1: dwa rozkłady normalne dla d = 0.2, 0.5, 0.8 i 1.2 – U3, nakładanie się i prawdopodobieństwo przewagi
options(width = 100)
library(ggplot2)

# Krótki motyw i paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw)
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), axis.text = element_text(size = 12, colour = "grey20"),
        plot.title = element_text(face = "bold"), strip.text = element_text(face = "bold", size = 13),
        legend.position = "bottom")
paleta <- c(kontrolna = "#0072B2", eksperymentalna = "#E69F00")
linie  <- c(kontrolna = "solid", eksperymentalna = "22")

# 1. Wartości ze wzorów (rozkłady normalne, równe SD; grupa kontrolna ma średnią 0 i SD = 1)
d <- c(0.2, 0.5, 0.8, 1.2)
wzory <- data.frame(d = d,
                    U3 = pnorm(d),                  # odsetek grupy eksperymentalnej powyżej średniej kontrolnej
                    nakladanie = 2 * pnorm(-d / 2), # wspólne pole pod dwiema krzywymi (OVL)
                    przewaga = pnorm(d / sqrt(2)))  # P(losowa osoba E > losowa osoba K)
round(wzory, 3)

# 2. Sprawdzenie symulacją: 100 000 osób w każdej grupie dla każdego d
set.seed(5691)
N <- 100000
sym <- t(sapply(d, function(di) {
  k <- rnorm(N, 0, 1); e <- rnorm(N, di, 1)
  c(d = di,
    U3 = mean(e > 0),                                    # powyżej średniej populacji kontrolnej
    nakladanie = mean(pmin(1, dnorm(k, di) / dnorm(k))), # OVL = średnia min(1, g(x)/f(x)) dla x z grupy K
    przewaga = mean(e > k))                              # losowe pary: osoba E kontra osoba K
}))
round(sym, 3)
# Błąd Monte Carlo proporcji (w punktach procentowych) przy N = 100 000
round(100 * sqrt(wzory$przewaga * (1 - wzory$przewaga) / N), 2)

# 3. Rysunek: krzywe obu grup, wspólne pole zacienione na szaro
x <- seq(-4, 5.2, by = 0.05)
krzywe <- do.call(rbind, lapply(d, function(di) data.frame(
  panel = sprintf("d = %.1f", di), x = x, kontrolna = dnorm(x, 0), eksperymentalna = dnorm(x, di))))
dl <- rbind(data.frame(krzywe[, 1:2], grupa = "kontrolna", y = krzywe$kontrolna),
            data.frame(krzywe[, 1:2], grupa = "eksperymentalna", y = krzywe$eksperymentalna))
dl$grupa <- factor(dl$grupa, levels = names(paleta))
etykiety <- data.frame(panel = sprintf("d = %.1f", d),
  tekst = sprintf("U3 = %.0f%%\nnakładanie = %.0f%%\nprzewaga = %.0f%%",
                  100 * wzory$U3, 100 * wzory$nakladanie, 100 * wzory$przewaga))
srednie <- data.frame(panel = rep(sprintf("d = %.1f", d), 2), x = c(rep(0, 4), d),
                      grupa = factor(rep(names(paleta), each = 4), levels = names(paleta)))

rys1 <- ggplot() +
  geom_ribbon(data = krzywe, aes(x, ymin = 0, ymax = pmin(kontrolna, eksperymentalna)), fill = "grey80") +
  geom_line(data = dl, aes(x, y, colour = grupa, linetype = grupa), linewidth = 1) +
  geom_segment(data = srednie, aes(x = x, xend = x, y = 0, yend = 0.40, colour = grupa, linetype = grupa),
               linewidth = 0.6, show.legend = FALSE) +
  geom_text(data = etykiety, aes(x = 5.2, y = 0.43, label = tekst), hjust = 1, vjust = 1,
            size = 3.9, lineheight = 0.95, colour = "grey15") +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(values = paleta, name = NULL) + scale_linetype_manual(values = linie, name = NULL) +
  scale_x_continuous(breaks = -3:5) + scale_y_continuous(limits = c(0, 0.44), breaks = NULL) +
  labs(x = "Wynik w jednostkach odchylenia standardowego", y = NULL) + motyw
# ggsave("wielkosc-efektu-nakladanie-rozkladow.svg", rys1, width = 9, height = 6.6)
Wynik w R
    d    U3 nakladanie przewaga
1 0.2 0.579      0.920    0.556
2 0.5 0.691      0.803    0.638
3 0.8 0.788      0.689    0.714
4 1.2 0.885      0.549    0.802
       d    U3 nakladanie przewaga
[1,] 0.2 0.581      0.921    0.557
[2,] 0.5 0.691      0.802    0.637
[3,] 0.8 0.787      0.688    0.715
[4,] 1.2 0.884      0.549    0.801
[1] 0.16 0.15 0.14 0.13
2. Ta sama różnica przy różnym SD (Rysunek 2)
R
# Rysunek 2: ta sama różnica średnich (5 punktów) przy różnym SD (kontynuacja: motyw, paleta, linie)
# Test wiedzy: grupa kontrolna M = 50, eksperymentalna M = 55; trzy populacje o różnym rozrzucie
sd_pop <- c(5, 10, 20)
roznica <- 5
tabela <- data.frame(SD = sd_pop, roznica = roznica, d = roznica / sd_pop,
                     U3 = pnorm(roznica / sd_pop), nakladanie = 2 * pnorm(-roznica / sd_pop / 2),
                     przewaga = pnorm(roznica / sd_pop / sqrt(2)))
round(tabela, 3)

opis_panelu <- sprintf("SD = %d: d = %.2f, nakładanie = %.0f%%", sd_pop, tabela$d, 100 * tabela$nakladanie)
x <- seq(0, 105, by = 0.25)
krzywe2 <- do.call(rbind, lapply(seq_along(sd_pop), function(i) data.frame(
  panel = opis_panelu[i], x = x, kontrolna = dnorm(x, 50, sd_pop[i]), eksperymentalna = dnorm(x, 55, sd_pop[i]))))
krzywe2$panel <- factor(krzywe2$panel, levels = opis_panelu)
dl2 <- rbind(data.frame(panel = krzywe2$panel, x = krzywe2$x, grupa = "kontrolna", y = krzywe2$kontrolna),
             data.frame(panel = krzywe2$panel, x = krzywe2$x, grupa = "eksperymentalna", y = krzywe2$eksperymentalna))
dl2$grupa <- factor(dl2$grupa, levels = names(paleta))

rys2 <- ggplot() +
  geom_ribbon(data = krzywe2, aes(x, ymin = 0, ymax = pmin(kontrolna, eksperymentalna)), fill = "grey80") +
  geom_line(data = dl2, aes(x, y, colour = grupa, linetype = grupa), linewidth = 1) +
  geom_vline(xintercept = c(50, 55), colour = "grey35", linewidth = 0.4) +
  facet_wrap(~ panel, ncol = 1, scales = "free_y") +
  scale_colour_manual(values = paleta, name = NULL) + scale_linetype_manual(values = linie, name = NULL) +
  scale_x_continuous(breaks = seq(0, 100, 10)) + scale_y_continuous(breaks = NULL) +
  labs(x = "Wynik testu wiedzy (punkty); pionowe linie – średnie 50 i 55", y = NULL) + motyw
# ggsave("wielkosc-efektu-ta-sama-roznica-rozne-sd.svg", rys2, width = 9, height = 6.6)
Wynik w R
  SD roznica    d    U3 nakladanie przewaga
1  5       5 1.00 0.841      0.617    0.760
2 10       5 0.50 0.691      0.803    0.638
3 20       5 0.25 0.599      0.901    0.570
3. d przy 20 i 200 osobach w grupie (Rysunek 3)
R
# Rysunek 3: d z próby przy n = 20 i n = 200 osób w grupie – rozrzut oszacowań i 95% CI
# (kontynuacja: motyw). Prawdziwe d = 0.5; 10 000 powtórzeń badania dla każdego n.
set.seed(5693)
R <- 10000
d_prawdziwe <- 0.5

# 95% CI dla d z niecentralnego rozkładu t (grupy równoliczne)
ci_d <- function(d, n) {
  k <- sqrt(1 / n + 1 / n); t_obs <- d / k; df <- 2 * n - 2
  f <- function(ncp, p) pt(t_obs, df, ncp) - p
  c(dolna = uniroot(f, t_obs + c(-5, 5), p = .975)$root * k,
    gorna = uniroot(f, t_obs + c(-5, 5), p = .025)$root * k)
}
jedno_badanie <- function(n) {
  k <- rnorm(n, 0, 1); e <- rnorm(n, d_prawdziwe, 1)
  d <- (mean(e) - mean(k)) / sqrt((var(e) + var(k)) / 2)   # d Cohena z połączonym SD
  c(d = d, ci_d(d, n))
}
wyniki <- lapply(c(20, 200), function(n) {
  w <- as.data.frame(t(replicate(R, jedno_badanie(n))))
  w$n <- n; w$badanie <- seq_len(R); w })
wyniki <- do.call(rbind, wyniki)
wyniki$trafia <- wyniki$dolna <= d_prawdziwe & wyniki$gorna >= d_prawdziwe

# Podsumowanie 10 000 badań dla każdego n
podsum <- t(sapply(split(wyniki, wyniki$n), function(w) {
  pokrycie <- mean(w$trafia)
  c(sredni_d = mean(w$d), SD_d = sd(w$d), q025 = unname(quantile(w$d, .025)), q975 = unname(quantile(w$d, .975)),
    proc_ponizej_0.2 = 100 * mean(w$d < 0.2), proc_powyzej_0.8 = 100 * mean(w$d > 0.8),
    proc_ujemnych = 100 * mean(w$d < 0), srednia_szerokosc_CI = mean(w$gorna - w$dolna),
    pokrycie_proc = 100 * pokrycie, blad_MC_pp = 100 * sqrt(pokrycie * (1 - pokrycie) / R))
}))
round(podsum, 3)
# Przykład do zdania w Wynikach: 95% CI dla d = 0.50 przy 20 osobach w grupie
round(ci_d(0.50, 20), 2)

# Rysunek: A–B histogramy d z 10 000 badań; C–D 95% CI z pierwszych 25 badań
etyk_n <- c("20" = "n = 20 w grupie", "200" = "n = 200 w grupie")
wyniki$panel_n <- factor(etyk_n[as.character(wyniki$n)], levels = etyk_n)
hist_d <- ggplot(wyniki, aes(d)) +
  geom_histogram(binwidth = 0.05, boundary = 0, fill = "grey70", colour = "white") +
  geom_vline(xintercept = d_prawdziwe, colour = "#D55E00", linewidth = 1) +
  geom_vline(xintercept = c(0.2, 0.8), colour = "grey30", linetype = "22") +
  facet_wrap(~ panel_n, ncol = 2, scales = "free_y") +
  scale_x_continuous(breaks = seq(-0.5, 1.5, 0.5)) + coord_cartesian(xlim = c(-0.6, 1.6)) +
  labs(title = "A–B. d z 10 000 badań", x = "Oszacowanie d", y = "Liczba badań") + motyw

pierwsze <- subset(wyniki, badanie <= 25)
pierwsze$wynik <- factor(ifelse(pierwsze$trafia, "przedział obejmuje 0.5", "przedział chybia"),
                         levels = c("przedział obejmuje 0.5", "przedział chybia"))
# Ile z pierwszych 25 przedziałów chybia prawdziwego d = 0.5?
with(pierwsze, tapply(!trafia, n, sum))
ci_rys <- ggplot(pierwsze, aes(y = badanie, x = d)) +
  geom_vline(xintercept = d_prawdziwe, colour = "#D55E00", linewidth = 1) +
  geom_vline(xintercept = 0, colour = "grey30", linewidth = 0.4) +
  geom_linerange(aes(xmin = dolna, xmax = gorna, colour = wynik), linewidth = 0.7) +
  geom_point(aes(shape = wynik, colour = wynik), size = 2.3, fill = "white") +
  facet_wrap(~ panel_n, ncol = 2) +
  scale_colour_manual(values = c("przedział obejmuje 0.5" = "grey25", "przedział chybia" = "#D55E00"), name = NULL, drop = FALSE) +
  scale_shape_manual(values = c("przedział obejmuje 0.5" = 16, "przedział chybia" = 24), name = NULL, drop = FALSE) +
  scale_x_continuous(breaks = seq(-0.5, 1.5, 0.5)) + coord_cartesian(xlim = c(-0.6, 1.6)) +
  scale_y_reverse(breaks = c(1, 5, 10, 15, 20, 25)) +
  labs(title = "C–D. 95% CI z pierwszych 25 badań", x = "d z 95% przedziałem ufności", y = "Badanie") + motyw

library(patchwork)
rys3 <- hist_d / ci_rys + plot_layout(heights = c(1, 1.25))
# ggsave("wielkosc-efektu-d-przy-malym-n.svg", rys3, width = 9, height = 8.4)
Wynik w R
    sredni_d  SD_d   q025  q975 proc_ponizej_0.2 proc_powyzej_0.8 proc_ujemnych
20     0.510 0.333 -0.112 1.194            17.22            18.75          5.61
200    0.501 0.102  0.301 0.705             0.11             0.16          0.00
    srednia_szerokosc_CI pokrycie_proc blad_MC_pp
20                 1.269         94.90      0.220
200                0.398         94.74      0.223
dolna gorna
-0.13  1.13
 20 200
  0   4
4. Korelacje na wykresie rozrzutu (Rysunek 4)
R
# Rysunek 4: jak wygląda r = 0, .1, .3 i .5 na wykresie rozrzutu (kontynuacja: motyw)
# 200 osób na panel; dane przekształcone tak, by r w próbie było dokładnie równe wartości docelowej
set.seed(5694)
n <- 200
r_cel <- c(0, 0.1, 0.3, 0.5)
dokladne_r <- function(r, n) {
  x <- as.numeric(scale(rnorm(n)))
  z <- residuals(lm(rnorm(n) ~ x)); z <- as.numeric(scale(z))   # z nieskorelowane z x
  data.frame(x = x, y = r * x + sqrt(1 - r^2) * z)
}
punkty <- do.call(rbind, lapply(r_cel, function(r) cbind(r = r, dokladne_r(r, n))))
nazwy_r <- c("r = 0", "r = .1", "r = .3", "r = .5")
punkty$panel <- factor(nazwy_r[match(punkty$r, r_cel)], levels = nazwy_r)
write.csv(transform(punkty[, c("r", "x", "y")], x = round(x, 4), y = round(y, 4)),
          "wielkosc-efektu-korelacje-dane.csv", row.names = FALSE)

# Kontrola: r w każdej próbie i odsetek wariancji (r^2)
round(sapply(split(punkty, punkty$r), function(p) c(r = cor(p$x, p$y), r2_proc = 100 * cor(p$x, p$y)^2)), 3)

# Przekład na „ludzki” język: wśród osób powyżej mediany X – ile jest też powyżej mediany Y?
# Wzór dla rozkładu normalnego dwuwymiarowego: 1/2 + arcsin(r) / pi; sprawdzenie na 100 000 osób
N <- 100000
zgodnosc <- t(sapply(r_cel, function(r) {
  x <- rnorm(N); y <- r * x + sqrt(1 - r^2) * rnorm(N)
  p_sym <- mean(y[x > 0] > 0)
  c(r = r, wzor_proc = 100 * (0.5 + asin(r) / pi), symulacja_proc = 100 * p_sym,
    blad_MC_pp = 100 * sqrt(p_sym * (1 - p_sym) / sum(x > 0)))
}))
round(zgodnosc, 2)

opisy <- data.frame(panel = factor(levels(punkty$panel), levels = levels(punkty$panel)),
  tekst = sprintf("powyżej mediany X:\n%.0f%% też powyżej mediany Y", zgodnosc[, "wzor_proc"]))
rys4 <- ggplot(punkty, aes(x, y)) +
  geom_point(colour = "grey35", alpha = 0.55, size = 1.5) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#0072B2", linewidth = 1.1) +
  geom_label(data = opisy, aes(x = -3.3, y = 3.6, label = tekst), hjust = 0, vjust = 1, size = 3.6,
             lineheight = 0.95, linewidth = 0, fill = "white", alpha = 0.85, colour = "grey15") +
  facet_wrap(~ panel, ncol = 2) +
  coord_cartesian(xlim = c(-3.3, 3.3), ylim = c(-3.3, 3.6)) +
  labs(x = "Zmienna X (z)", y = "Zmienna Y (z)") + motyw
# ggsave("wielkosc-efektu-korelacja-r.svg", rys4, width = 9, height = 7.4)
Wynik w R
        0 0.1 0.3  0.5
r       0 0.1 0.3  0.5
r2_proc 0 1.0 9.0 25.0
       r wzor_proc symulacja_proc blad_MC_pp
[1,] 0.0     50.00          50.08       0.22
[2,] 0.1     53.19          53.28       0.22
[3,] 0.3     59.70          59.76       0.22
[4,] 0.5     66.67          66.52       0.21
5. Iloraz szans jako słupki ryzyka (Rysunek 5)
R
# Rysunek 5: ten sam iloraz szans (OR = 2) przy rzadkim i częstym zdarzeniu (kontynuacja: motyw)
OR <- 2
ryzyko_k <- c(rzadkie = 0.05, czeste = 0.40)                 # ryzyko w grupie porównawczej
szansa_e <- OR * ryzyko_k / (1 - ryzyko_k)
ryzyko_e <- szansa_e / (1 + szansa_e)                        # ryzyko w grupie narażonej
porownanie <- data.frame(ryzyko_K_proc = 100 * ryzyko_k, ryzyko_E_proc = 100 * ryzyko_e,
                         OR = (ryzyko_e / (1 - ryzyko_e)) / (ryzyko_k / (1 - ryzyko_k)),
                         RR = ryzyko_e / ryzyko_k, roznica_pp = 100 * (ryzyko_e - ryzyko_k),
                         NNT = 1 / (ryzyko_e - ryzyko_k))
round(porownanie, 2)

slupki <- data.frame(
  scenariusz = factor(rep(c("A. Zdarzenie rzadkie (5%)", "B. Zdarzenie częste (40%)"), each = 2),
                      levels = c("A. Zdarzenie rzadkie (5%)", "B. Zdarzenie częste (40%)")),
  grupa = factor(rep(c("porównawcza", "narażona"), 2), levels = c("porównawcza", "narażona")),
  ryzyko = 100 * c(ryzyko_k[1], ryzyko_e[1], ryzyko_k[2], ryzyko_e[2]))
slupki$etykieta <- sprintf("%.1f%%", slupki$ryzyko)
opis_or <- data.frame(scenariusz = levels(slupki$scenariusz),
  tekst = sprintf("OR = %.1f\nRR = %.2f\nróżnica = %.1f pp", porownanie$OR, porownanie$RR, porownanie$roznica_pp))

rys5 <- ggplot(slupki, aes(grupa, ryzyko)) +
  geom_col(aes(fill = grupa), width = 0.6, colour = "grey20") +
  geom_text(aes(label = etykieta), vjust = -0.5, size = 4.2) +
  geom_text(data = opis_or, aes(x = 0.45, y = 97, label = tekst), hjust = 0, vjust = 1, size = 3.9,
            lineheight = 0.95, colour = "grey15", inherit.aes = FALSE) +
  facet_wrap(~ scenariusz, ncol = 2) +
  scale_fill_manual(values = c("porównawcza" = "white", "narażona" = "grey55"), guide = "none") +
  scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 20), expand = c(0, 0)) +
  labs(x = NULL, y = "Odsetek osób ze zdarzeniem (%)") + motyw
# ggsave("wielkosc-efektu-iloraz-szans-ryzyko.svg", rys5, width = 9, height = 5.4)
Wynik w R
        ryzyko_K_proc ryzyko_E_proc OR   RR roznica_pp   NNT
rzadkie             5          9.52  2 1.90       4.52 22.11
czeste             40         57.14  2 1.43      17.14  5.83
Bibliografia oprogramowania
Wyniki i rysunki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; pliki SVG zapisano pakietem svglite, a czytelność palety przy deuteranopii sprawdzono funkcją colorspace::deutan(). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1), 1–49. https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „d = 0.8, więc grupy wyraźnie się różnią” – rozkłady nadal pokrywają się w 68.9%, a w prawie co trzeciej losowej parze wygrywa osoba z grupy „słabszej”.
- Porównywanie d z badań o różnym rozrzucie – jednorodna próba albo bardziej rzetelny pomiar podnoszą d bez zmiany różnicy w punktach.
- Etykieta zamiast przedziału – przy 20 osobach w grupie w 17.2% badań z prawdziwym d = 0.5 wychodzi „efekt pomijalny”, a w 18.8% – „duży”.
- Ocena korelacji przez r2 – „tylko 9% wariancji” przy r = .30 zaniża znaczenie efektu.
- OR bez odsetków – OR = 2 może oznaczać różnicę 4.5 albo 17.1 punktu procentowego.
- Przekład z wzoru przy skośnych danych – U3 = Φ(d) i przewaga ze wzoru zakładają normalność i równe SD. Gdy tak nie jest, licz je empirycznie.
Najczęstsze pytania
Jak wygląda efekt d = 0.5 na wykresie?
Dwie krzywe rozkładu normalnego przesunięte o pół odchylenia standardowego. Pokrywają się w 80.3%, powyżej średniej grupy kontrolnej leży 69.1% grupy eksperymentalnej (U3), a losowa osoba z grupy eksperymentalnej ma wyższy wynik niż losowa osoba z kontrolnej w 63.8% par. Wartości te zakładają normalność i równe SD.
Dlaczego ta sama różnica średnich daje różne d Cohena?
Bo d to różnica średnich podzielona przez odchylenie standardowe. Różnica 5 punktów daje d = 1.00 przy SD = 5, ale tylko 0.25 przy SD = 20. Jednorodna próba, rzetelność narzędzia i schemat badania zmieniają SD, a więc i d. Dlatego podawaj też różnicę w jednostkach skali.
Jak bardzo d Cohena zmienia się między badaniami przy małej próbie?
W symulacji 10 000 badań z prawdziwym d = 0.5 i 20 osobami w grupie 95% oszacowań mieściło się między −0.11 a 1.19, a 5.6% miało przeciwny znak. Przy 200 osobach w grupie zakres zawęził się do 0.30–0.71. Dlatego d zawsze podawaj z 95% przedziałem ufności.
Czy korelacja r = .3 to dużo?
Na wykresie rozrzutu r = .30 wygląda jak chmura z lekkim nachyleniem. W przekładzie na osoby: wśród osób powyżej mediany X około 60% jest też powyżej mediany Y (przy braku związku – 50%). Nie oceniaj korelacji przez r2 = 9% – to zaniża jej znaczenie. Porównaj wynik z efektami z twojej dziedziny.
Dlaczego iloraz szans trzeba podawać razem z odsetkami?
Ten sam OR = 2 oznacza wzrost z 5.0% do 9.5% przy rzadkim zdarzeniu i z 40.0% do 57.1% przy częstym. Różnica w liczbie osób jest prawie czterokrotnie większa w drugim przypadku. Podaj odsetki w obu grupach, różnicę ryzyka i dopiero obok OR.
Powiązane hasła
Przeczytaj też
Wielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikMoc testu w obrazkach
Pola α, β i mocy na dwóch rozkładach, krzywe mocy z symulacją, klątwa zwycięzcy przy niskiej mocy i moc po fakcie – pięć rysunków z kodem R.
Czytaj →PoradnikPrzedział ufności w obrazkach
Sto przedziałów na jednym wykresie, szerokość a liczebność, poziom ufności, skośne dane, SD i przedział predykcji – sześć symulacji z kodem R.
Czytaj →Nie wiesz, jak opisać wielkość efektu w swojej pracy?
Pomożemy policzyć wielkość efektu z przedziałem ufności, dobrać czytelny przekład dla czytelnika i przygotować rysunki oraz opis wyników tak, żebyś umiał(a) je wyjaśnić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Baguley, T. (2009). Standardized or simple effect size: What should be reported? British Journal of Psychology, 100(3), 603–617. https://doi.org/10.1348/000712608x377117
- Chen, H., Cohen, P., & Chen, S. (2010). How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies. Communications in Statistics—Simulation and Computation, 39(4), 860–864. https://doi.org/10.1080/03610911003650383
- Funder, D. C., & Ozer, D. J. (2019). Evaluating effect size in psychological research: Sense and nonsense. Advances in Methods and Practices in Psychological Science, 2(2), 156–168. https://doi.org/10.1177/2515245919847202 ● Otwarty dostęp
- Hanel, P. H. P., & Mehler, D. M. A. (2019). Beyond reporting statistical significance: Identifying informative effect sizes to improve scientific communication. Public Understanding of Science, 28(4), 468–485. https://doi.org/10.1177/0963662519834193 ● Otwarty dostęp: pełny tekst
- Hedges, L. V. (1981). Distribution theory for Glass’s estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Kelley, K., & Rausch, J. R. (2006). Sample size planning for the standardized mean difference: Accuracy in parameter estimation via narrow confidence intervals. Psychological Methods, 11(4), 363–385. https://doi.org/10.1037/1082-989x.11.4.363
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
- Reiser, B., & Faraggi, D. (1999). Confidence intervals for the overlapping coefficient: The normal equal variance case. Journal of the Royal Statistical Society: Series D (The Statistician), 48(3), 413–418. https://doi.org/10.1111/1467-9884.00199
Cytowania BibTeX
@article{baguley2009standardized, author={Baguley, Thom}, title={{Standardized or simple effect size: What should be reported?}}, journal={British Journal of Psychology}, year={2009}, volume={100}, number={3}, pages={603--617}, doi={10.1348/000712608x377117}}@article{chen2010how, author={Chen, Henian and Cohen, Patricia and Chen, Sophie}, title={{How big is a big odds ratio? Interpreting the magnitudes of odds ratios in epidemiological studies}}, journal={Communications in Statistics—Simulation and Computation}, year={2010}, volume={39}, number={4}, pages={860--864}, doi={10.1080/03610911003650383}}@article{funder2019evaluating, author={Funder, David C. and Ozer, Daniel J.}, title={{Evaluating effect size in psychological research: Sense and nonsense}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={2}, pages={156--168}, doi={10.1177/2515245919847202}}@article{hanel2019beyond, author={Hanel, Paul H. P. and Mehler, David M. A.}, title={{Beyond reporting statistical significance: Identifying informative effect sizes to improve scientific communication}}, journal={Public Understanding of Science}, year={2019}, volume={28}, number={4}, pages={468--485}, doi={10.1177/0963662519834193}}@article{hedges1981distribution, author={Hedges, Larry V.}, title={{Distribution theory for Glass’s estimator of effect size and related estimators}}, journal={Journal of Educational Statistics}, year={1981}, volume={6}, number={2}, pages={107--128}, doi={10.3102/10769986006002107}}@article{kelley2006sample, author={Kelley, Ken and Rausch, Joseph R.}, title={{Sample size planning for the standardized mean difference: Accuracy in parameter estimation via narrow confidence intervals}}, journal={Psychological Methods}, year={2006}, volume={11}, number={4}, pages={363--385}, doi={10.1037/1082-989x.11.4.363}}@article{mcgraw1992common, author={McGraw, Kenneth O. and Wong, S. P.}, title={{A common language effect size statistic}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={2}, pages={361--365}, doi={10.1037/0033-2909.111.2.361}}@article{reiser1999confidence, author={Reiser, Benjamin and Faraggi, David}, title={{Confidence intervals for the overlapping coefficient: The normal equal variance case}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1999}, volume={48}, number={3}, pages={413--418}, doi={10.1111/1467-9884.00199}}