Co to jest U3 Cohena?
U3 Cohena (ang. Cohen's U3) to odsetek osób z grupy o wyższej średniej, których wynik przekracza średnią drugiej grupy. Przy rozkładach normalnych o równych wariancjach średnia jest też medianą, a U3 = Φ(d), gdzie Φ to dystrybuanta standardowego rozkładu normalnego, a d – d Cohena. Brak różnicy daje U3 = 50%, a d = 0.5 – około 69%: średnia grupy eksperymentalnej wypada na 69. percentylu grupy kontrolnej. Miarę opisał Cohen (1988) obok U1 i U2.
U1, U2 i nakładanie się rozkładów
- U2 = Φ(d/2) – odsetek grupy wyższej przekraczający ten sam odsetek grupy niższej.
- U1 = (2U2 − 1)/U2 – część łącznego obszaru obu rozkładów, która się nie pokrywa.
- OVL = 2Φ(−|d|/2) – wspólne pole pod obiema krzywymi gęstości; przedziały ufności dla OVL przy równych wariancjach porównali Reiser i Faraggi (1999).
Pokrewne jest prawdopodobieństwo przewagi A = Φ(d/√2), opisane w haśle miara A Varghi–Delaneya. Dla konwencjonalnych d = 0.2, 0.5 i 0.8 U3 wynosi 58%, 69% i 79%, a OVL – 92%, 80% i 69%.
Po co podawać U3
U3 przekłada odchylenia standardowe na procenty osób. Hanel i Mehler (2019) w trzech badaniach (N = 652) pytali, która forma wyniku jest najbardziej informatywna. Najwyżej oceniono U3: 69% uczestników uznało je za bardziej informatywne niż d, a 15% – odwrotnie. Autorzy dodają, że wybór miary zależy od tego, czy chcemy pokazać różnice, czy podobieństwa grup. Szerzej o przekładaniu efektów pisze wpis Wielkość efektu – interpretacja.
Przykład
Po 80 osób przeszło trening uwagi albo nie (dane symulowane). Średnie wyniosły 57.09 i 50.82, d = 0.55. U3 = .71, 95% CI [.59, .81]; empirycznie średnią kontroli przekroczyło 69% osób po treningu. Rozkłady pokrywają się w 78%.
Na rysunku
Panel A pokazuje U3 na danych z przykładu, a panel B – wzór U3 = Φ(d) na tle pozostałych miar z tego hasła. Nakładanie się dwóch rozkładów dla d = 0.2, 0.5 i 0.8 pokazuje wpis Wielkość efektu w obrazkach, więc tu ich nie powtarzamy.
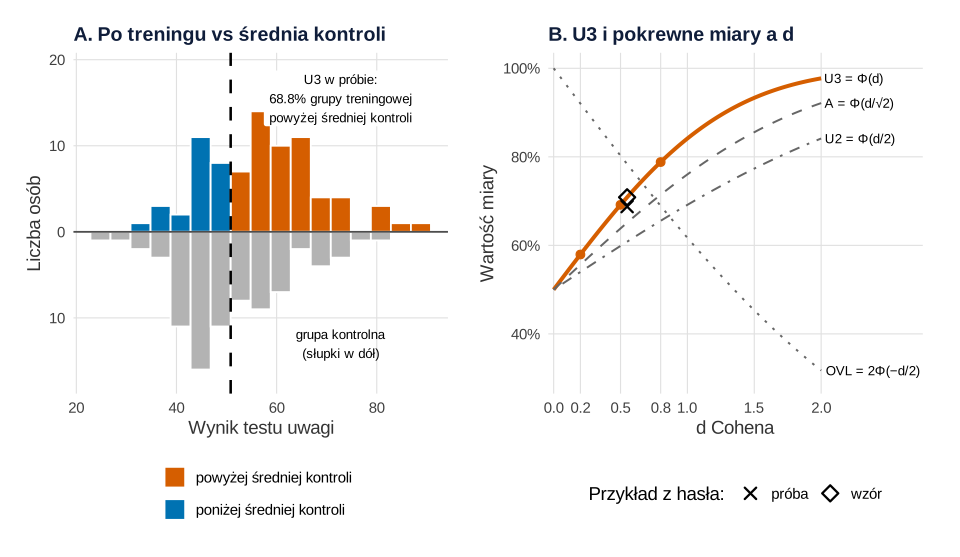
set.seed(7264)).Co widać. W panelu A 55 z 80 osób po treningu, czyli 68.8%, ma wynik na prawo od średniej kontroli – to empiryczne U3. Wzór Φ(d) dla d = 0.55 daje 70.9% (romb w panelu B), a odsetek z próby leży tuż pod nim (krzyżyk). W panelu B U3 rośnie najszybciej z trzech rosnących miar: kropki przy konwencjonalnych d = 0.2, 0.5 i 0.8 to 58%, 69% i 79% z tabeli w kodzie hasła. OVL – pole wspólne obu krzywych – maleje od 100%.
Na co uważać. Krzywe w panelu B obowiązują tylko przy rozkładach normalnych o równych wariancjach; przy skośnych danych licz odsetek z próby, jak w panelu A. Histogram nie pokazuje niepewności: 95% CI dla U3 to [.59, .81], więc różnica 68.8% vs 70.9% nic nie znaczy. Podawaj miarę obok d Cohena i nazywaj ją wprost, bo przy d = 0.5 U3 wynosi 69%, a A – 64%, choć opisują ten sam efekt.
Podpis do pracy:
Kod losuje raz, z ziarnem set.seed(7264) z przykładu, i odtwarza te same dane co blok w części „U3 Cohena w R”; d liczy wzorem z łącznym SD (przy równych grupach to samo co cohens_d()). Motyw i paletę definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku
# Rysunek 1. U3 w danych z przykładu (A) i U3 na tle innych miar nakładania w funkcji d (B)
library(ggplot2)
library(patchwork)

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))
kol <- c("powyżej średniej kontroli" = "#D55E00", "poniżej średniej kontroli" = "#0072B2")   # Okabe–Ito

set.seed(7264)                                 # te same dane co w przykładzie z hasła
trening  <- rnorm(80, mean = 56, sd = 10)
kontrola <- rnorm(80, mean = 50, sd = 10)
d <- (mean(trening) - mean(kontrola)) / sqrt((var(trening) + var(kontrola)) / 2)   # d Cohena (równe n)
m_k <- mean(kontrola)
round(c(d = d, U3_wzor = pnorm(d), U3_proba = mean(trening > m_k), liczba_powyzej = sum(trening > m_k)), 3)

# A: grupa po treningu (w górę) podzielona średnią kontroli; grupa kontrolna (w dół) szara
dA <- data.frame(wynik = trening, strona = factor(ifelse(trening > m_k, names(kol)[1], names(kol)[2]), names(kol)))
pA <- ggplot() +
  geom_histogram(data = dA, aes(wynik, fill = strona), binwidth = 4, boundary = m_k, colour = "white") +
  geom_histogram(data = data.frame(wynik = kontrola), aes(wynik, y = -after_stat(count)),
                 binwidth = 4, boundary = m_k, fill = "grey70", colour = "white") +
  geom_vline(xintercept = m_k, linewidth = 0.9, linetype = "dashed") +
  geom_hline(yintercept = 0, colour = "grey30") +
  annotate("label", x = m_k + 22, y = 15.5, size = 3.5, linewidth = 0, fill = "white",
           label = sprintf("U3 w próbie:\n%.1f%% grupy treningowej\npowyżej średniej kontroli", 100 * mean(trening > m_k))) +
  annotate("text", x = m_k + 22, y = -13, size = 3.5, label = "grupa kontrolna\n(słupki w dół)") +
  scale_fill_manual(values = kol, name = NULL) +
  scale_y_continuous(labels = abs, limits = c(-17, 19)) +
  guides(fill = guide_legend(ncol = 1)) +
  labs(title = "A. Po treningu vs średnia kontroli", x = "Wynik testu uwagi", y = "Liczba osób") +
  motyw

# B: miary nakładania przy rozkładach normalnych o równych wariancjach, d od 0 do 2
siatka <- seq(0, 2, by = 0.01)
krzywe <- rbind(data.frame(d = siatka, wartosc = pnorm(siatka), miara = "U3 = Φ(d)"),
                data.frame(d = siatka, wartosc = pnorm(siatka / sqrt(2)), miara = "A = Φ(d/√2)"),
                data.frame(d = siatka, wartosc = pnorm(siatka / 2), miara = "U2 = Φ(d/2)"),
                data.frame(d = siatka, wartosc = 2 * pnorm(-siatka / 2), miara = "OVL = 2Φ(−d/2)"))
krzywe$miara <- factor(krzywe$miara, unique(krzywe$miara))
konw <- data.frame(d = c(0.2, 0.5, 0.8), wartosc = pnorm(c(0.2, 0.5, 0.8)))
przyk <- data.frame(d = d, wartosc = c(pnorm(d), mean(trening > m_k)), co = c("wzór", "próba"))
pB <- ggplot(krzywe, aes(d, wartosc)) +
  geom_line(aes(linetype = miara, colour = miara == "U3 = Φ(d)", linewidth = miara == "U3 = Φ(d)")) +
  geom_point(data = konw, size = 2.6, colour = "#D55E00") +
  geom_point(data = przyk, aes(shape = co), size = 3.2, stroke = 1.2) +
  geom_text(data = subset(krzywe, d == 2), aes(label = miara), hjust = -0.05, size = 3.5) +
  scale_colour_manual(values = c("grey40", "#D55E00"), guide = "none") +
  scale_linewidth_manual(values = c(0.7, 1.4), guide = "none") +
  scale_linetype_manual(values = c("solid", "dashed", "dotdash", "dotted"), guide = "none") +
  scale_shape_manual(values = c(wzór = 5, próba = 4), name = "Przykład z hasła:") +
  scale_x_continuous(breaks = c(0, 0.2, 0.5, 0.8, 1, 1.5, 2), expand = expansion(mult = c(0.02, 0.38))) +
  scale_y_continuous(labels = function(x) paste0(100 * x, "%"), limits = c(0.3, 1)) +
  labs(title = "B. U3 i pokrewne miary a d", x = "d Cohena", y = "Wartość miary") +
  motyw
p1 <- pA + pB
p1   # zapis: ggsave("u3-cohena-odsetek-i-krzywe.svg", p1, width = 10, height = 5.8)
Wynik w R
             d        U3_wzor       U3_proba liczba_powyzej
         0.549          0.709          0.688         55.000
Jak opisać w pracy
Na co uważać
- Założenia wzoru. Φ(d) obowiązuje przy normalności i równych wariancjach; przy skośnych danych podaj odsetek empiryczny.
- To nie odsetek osób, którym pomogło. U3 opisuje położenie rozkładów, nie zmiany u poszczególnych osób.
- Kierunek. Napisz, która grupa jest porównywana ze średnią której.
Inne przeliczenia d zrobisz w konwerterze wielkości efektu.
U3 Cohena w R
Kod symuluje dwie grupy, liczy d, U3 ze wzoru i empirycznie, U3 i nakładanie się rozkładów z 95% CI (pakiet effectsize), a potem przelicza konwencjonalne wartości d na U3, U2, U1, OVL i A. Liczby w tekście pochodzą z tego kodu.
U3 Cohena, nakładanie się rozkładów i przeliczenia d
R
suppressPackageStartupMessages(library(effectsize))
set.seed(7264)
trening  <- rnorm(80, mean = 56, sd = 10)    # wynik testu uwagi po treningu (dane symulowane)
kontrola <- rnorm(80, mean = 50, sd = 10)    # grupa kontrolna
d <- unname(cohens_d(trening, kontrola)$Cohens_d)
round(c(M_trening = mean(trening), M_kontrola = mean(kontrola), d = d), 2)
round(c(U3_wzor = pnorm(d),                          # U3 = Phi(d)
        U3_proba = mean(trening > mean(kontrola))), 3) # odsetek grupy treningowej powyżej średniej kontroli
cohens_u3(trening, kontrola)                          # U3 z 95% CI
p_overlap(trening, kontrola)                          # nakładanie się rozkładów
d_konw <- c(0.2, 0.5, 0.8)
round(data.frame(d = d_konw, U3 = pnorm(d_konw), U2 = pnorm(d_konw / 2),
                 U1 = (2 * pnorm(d_konw / 2) - 1) / pnorm(d_konw / 2),
                 OVL = 2 * pnorm(-d_konw / 2), A = pnorm(d_konw / sqrt(2))), 3)
Wynik w R
 M_trening M_kontrola          d
     57.09      50.82       0.55
 U3_wzor U3_proba
   0.709    0.688
Cohen's U3 |       95% CI
-------------------------
0.71       | [0.59, 0.81]
Overlap |       95% CI
----------------------
0.78    | [0.67, 0.91]
    d    U3    U2    U1   OVL     A
1 0.2 0.579 0.540 0.148 0.920 0.556
2 0.5 0.691 0.599 0.330 0.803 0.638
3 0.8 0.788 0.655 0.474 0.689 0.714
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet effectsize). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Jak przeliczyć d Cohena na U3?
Weź wartość dystrybuanty standardowego rozkładu normalnego w punkcie d: U3 = Φ(d), w R pnorm(d). Dla d = 0.2, 0.5 i 0.8 daje to około 58%, 69% i 79%.
Czym U3 różni się od prawdopodobieństwa przewagi?
U3 porównuje wyniki jednej grupy ze średnią drugiej, a prawdopodobieństwo przewagi (A, CL) porównuje losowe pary osób. Przy normalności A = Φ(d/√2), więc dla d = 0.5 A ≈ .64, a U3 ≈ .69.
Czy U3 można liczyć przy danych nienormalnych?
Wzór Φ(d) zakłada normalność i równe wariancje. Przy skośnych danych policz odsetek empiryczny (ile osób z jednej grupy przekracza medianę drugiej) albo użyj miary A Varghi–Delaneya.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Wielkość efektu – interpretacja
d, g, r, η², OR i NNT na jednym przykładzie, przeliczenia, przedziały ufności, progi Cohena i interpretacja na tle SESOI – z kodem R.
Czytaj →PoradnikKonwerter wielkości efektu
Przelicz t na d Cohena, d na r i iloraz szans, η² na f albo d na NNT. Wzory ze źródłami, przykład w R i gotowe zdania do pracy.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Hanel, P. H. P., & Mehler, D. M. A. (2019). Beyond reporting statistical significance: Identifying informative effect sizes to improve scientific communication. Public Understanding of Science, 28(4), 468–485. https://doi.org/10.1177/0963662519834193 ● Otwarty dostęp: pełny tekst
- Reiser, B., & Faraggi, D. (1999). Confidence intervals for the overlapping coefficient: The normal equal variance case. Journal of the Royal Statistical Society: Series D (The Statistician), 48(3), 413–418. https://doi.org/10.1111/1467-9884.00199
Cytowania BibTeX
@book{cohen1988statistical, author={Cohen, Jacob}, title={{Statistical power analysis for the behavioral sciences}}, year={1988}, edition={2}, publisher={Lawrence Erlbaum Associates}, url={https://openlibrary.org/books/OL2035961M}}@article{hanel2019beyond, author={Hanel, Paul H. P. and Mehler, David M. A.}, title={{Beyond reporting statistical significance: Identifying informative effect sizes to improve scientific communication}}, journal={Public Understanding of Science}, year={2019}, volume={28}, number={4}, pages={468--485}, doi={10.1177/0963662519834193}}@article{reiser1999confidence, author={Reiser, Benjamin and Faraggi, David}, title={{Confidence intervals for the overlapping coefficient: The normal equal variance case}}, journal={Journal of the Royal Statistical Society: Series D (The Statistician)}, year={1999}, volume={48}, number={3}, pages={413--418}, doi={10.1111/1467-9884.00199}}