Kiedy wykres w pracy dyplomowej pomaga, a kiedy tylko zajmuje miejsce
W rozdziale wyników wykres ma jedno zadanie: pokazać wzór, którego z liczb nie widać od razu. Może to być kształt rozkładu, związek dwóch zmiennych albo różnica między grupami razem z rozrzutem wyników. Jeśli wynik mieści się w jednym zdaniu z dwiema liczbami, wykres jest zbędny. Jeśli czytelnik ma odczytać wiele dokładnych wartości, lepsza będzie tabela (wzory znajdziesz w poradniku tabele APA – wzory i przykłady).
Ten poradnik dotyczy pracy licencjackiej i magisterskiej: jak dobrać typ wykresu do zmiennych, czego nie rysować, jak podpisać rysunek i jak opisać go w tekście. Wymogi czasopism, rozdzielczość, eksport plików i kolory czytelne dla daltonistów omawiamy w osobnym tekście o tabelach i rysunkach do artykułu naukowego. Miejsce wykresów w całym rozdziale wyników pokazuje przykładowy rozdział wyników badań własnych.
Wszystkie rysunki i liczby na tej stronie pochodzą z jednego badania przykładowego: ankiety wśród 164 studentów (dane symulowane). Zmierzono w niej stres akademicki (średnia z sześciu pozycji na skali 1–5), liczbę godzin snu, kierunek i formę studiów. Kod R jest na końcu strony.
Jaki wykres do jakich danych
Typ wykresu wynika z dwóch pytań: ile zmiennych pokazujesz i na jakiej skali są mierzone: nominalnej, porządkowej czy ilościowej. Poniższa tabela obejmuje sytuacje, które zdarzają się w większości prac z psychologii, pedagogiki i nauk o zdrowiu.
| Co chcesz pokazać | Zmienne | Wykres | Czego unikać |
|---|---|---|---|
| Rozkład jednej zmiennej | Ilościowa (wynik skali, wiek) | Histogram, przy kilku zmiennych – wykres pudełkowy | Słupka z samą średnią |
| Liczebności kategorii | Nominalna lub porządkowa | Wykres słupkowy z n i odsetkami | Wykresu kołowego z wieloma kategoriami, efektu 3D |
| Odpowiedzi na pozycje skali Likerta | Kilka pozycji porządkowych | Słupki skumulowane rozbieżne | Osobnego wykresu dla każdej pozycji |
| Związek dwóch zmiennych | Dwie ilościowe | Wykres rozrzutu z linią regresji | Podawania samego r bez obejrzenia punktów |
| Różnica między grupami | Ilościowa × grupująca | Punkty z wykresem pudełkowym lub skrzypcowym, średnia z 95% CI | Słupków średnich na osi, która nie zaczyna się od początku skali |
| Zmiana w czasie, interakcja | Pomiary powtarzane, dwa czynniki | Linie średnich, wykres interakcji | Dwóch niezależnych słupków dla tych samych osób |
Rysunek 1 pokazuje cztery najczęstsze sytuacje na jednym zbiorze danych.
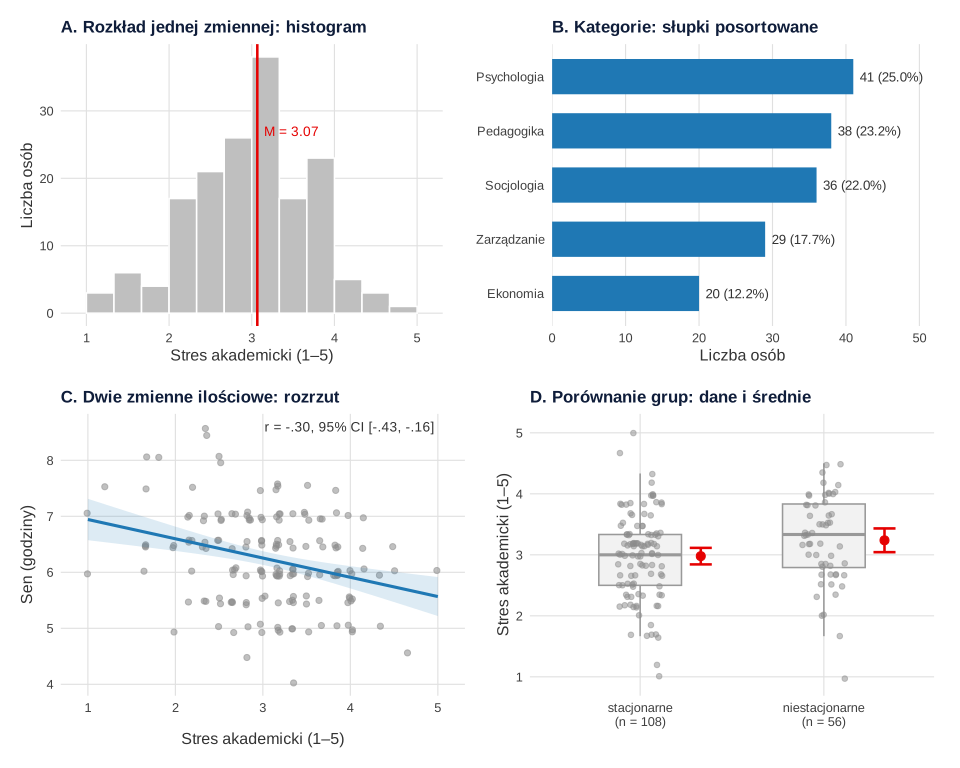
Co odczytasz z każdego panelu:
- A – histogram. Rozkład stresu jest zbliżony do symetrycznego (M = 3.07, SD = 0.72, skośność −0.26), wyniki obejmują całą skalę od 1 do 5. Szerokość przedziałów dobierz do skali: średnia z sześciu pozycji zmienia się co 1/6 punktu, więc każdy przedział powinien obejmować pełną liczbę takich kroków (tu dwa).
- B – słupki kategorii. Kategorie są posortowane od najliczniejszej, a przy słupkach stoją liczebności i odsetki. Czytelnik nie musi zgadywać wartości z osi.
- C – wykres rozrzutu. Im wyższy stres, tym krócej śpią badani: r = −.30, 95% CI [−.43, −.16]. Punkty pokazują też duży rozrzut wokół linii, więc związek jest umiarkowany, a nie „sztywny”. Anscombe (1973) pokazał cztery zbiory o niemal identycznej korelacji i zupełnie różnym obrazie na wykresie, dlatego wykres rozrzutu rysuj, zanim policzysz korelację Pearsona.
- D – porównanie grup. Studenci niestacjonarni mają nieco wyższy stres (M = 3.24 wobec 2.98), ale wyniki obu grup w dużej mierze się nakładają. Taki obraz lepiej oddaje wielkość efektu niż dwa słupki.
Dane ciągłe w wielu czasopismach wciąż pokazuje się na słupkach i wykresach liniowych, które przy bardzo różnych rozkładach mogą wyglądać tak samo (Weissgerber i in., 2015). W pracy dyplomowej masz więcej miejsca niż w artykule, więc pokaż dane. Przy dużych próbach rozważ wykres raincloud. Wiele pozycji skali Likerta najczytelniej pokażesz na skumulowanych słupkach rozbieżnych, które Heiberger i Robbins (2014) zalecają jako podstawowy sposób prezentacji takich skal.
Metryczka i typowe błędy: źle → dobrze
Najczęstszy problem w pracach dyplomowych to nie zły typ wykresu, tylko ich nadmiar. Sześć wykresów kołowych do metryczki (płeć, wiek, kierunek, rok, miejsce zamieszkania, praca) zajmuje trzy strony i nie mówi nic, czego nie zmieściłaby jedna tabela charakterystyki próby. Jak ją zbudować, pokazujemy w tekście jak opisać charakterystykę próby. Wykres zostaw dla zmiennych, o które pytają hipotezy.
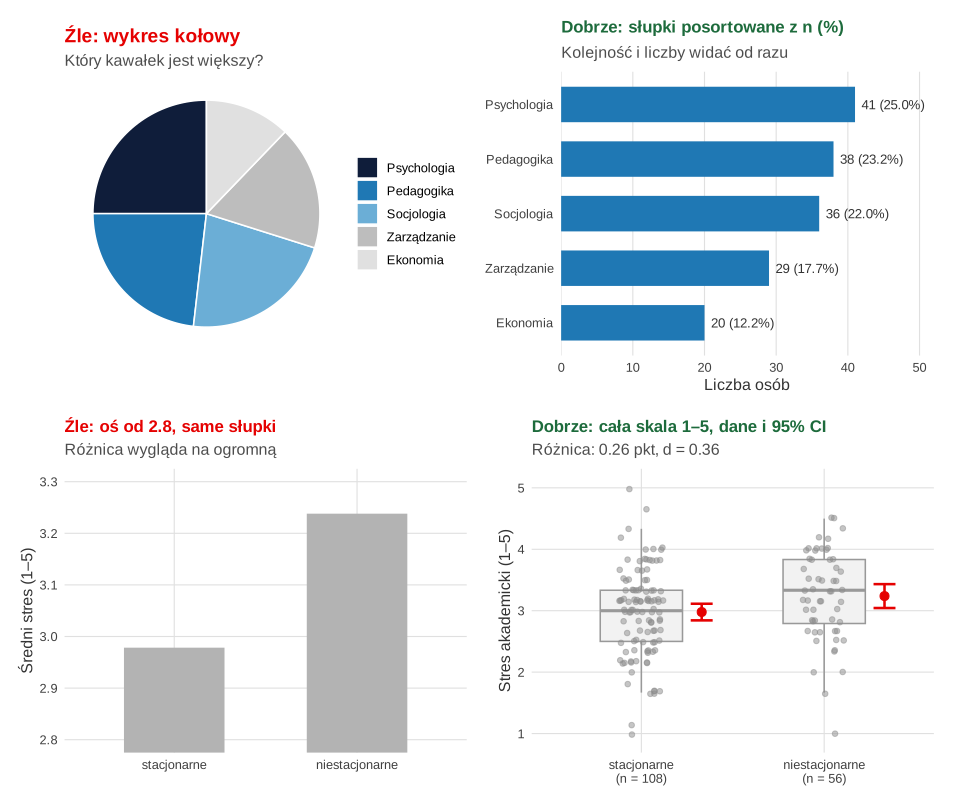
Wykres kołowy. Psychologię, pedagogikę i socjologię wybrało 25.0%, 23.2% i 22.0% osób. Na kole trudno ocenić, który wycinek jest większy, a na słupkach widać to od razu. Cleveland i McGill (1984) uporządkowali zadania percepcyjne według dokładności odczytu: porównanie położenia na wspólnej skali wypada w nich lepiej niż porównanie kątów i powierzchni. Efekt 3D dodatkowo pogarsza odczyt. W eksperymencie Siegrista (1996) osoby badane dokładniej szacowały wielkości z płaskich wykresów kołowych niż z trójwymiarowych.
Przycięta oś. Różnica średnich między formami studiów wynosi 0.26 punktu, czyli 6.5% szerokości skali 1–5. Na słupkach z osią od 2.8 słupek studentów niestacjonarnych jest 2.46 razy wyższy niż słupek stacjonarnych. Przy osi od minimum skali (1) stosunek wysokości wynosi 1.13. Długość słupka sugeruje wielkość, więc słupek musi zaczynać się od zera lub od początku skali. Jeśli chcesz pokazać małe różnice, użyj punktów i przedziałów ufności, a nie przycinaj osi pod słupkami.
| Źle | Dobrze |
|---|---|
| Osobny wykres kołowy dla każdego pytania metryczki | Jedna tabela charakterystyki próby z n i % |
| Wykres 3D, cienie, gradient, tło | Płaski wykres bez tła i cieni, z jednym kolorem akcentu |
| Słupki średnich bez rozrzutu | Punkty osób, wykres pudełkowy, średnia z 95% CI |
| Wąsy bez opisu („słupki błędu”) | W nocie: „odcinki oznaczają 95% CI” albo „±1 SD” |
| Kategorie w kolejności alfabetycznej lub z ankiety | Kategorie posortowane według liczebności (chyba że skala ma naturalny porządek) |
| Legenda z pięcioma kolorami, które w druku stają się szare | Podpisy przy danych, kształty punktów, szarości o różnej jasności |
| Ten sam wynik w tabeli, na wykresie i w tekście | Każda liczba w jednym miejscu; tekst prowadzi do wniosku |
Numer, tytuł i nota rysunku
W stylu APA każdy wykres jest rysunkiem. Nad rysunkiem stoi pogrubiony numer („Rysunek 1”), pod nim tytuł kursywą, a pod samym wykresem nota zaczynająca się od słowa „Uwaga.” (American Psychological Association, 2020). Rysunki numerujesz kolejno w całej pracy, w kolejności, w jakiej przywołujesz je w tekście. Wiele polskich uczelni ma jednak własne zasady: podpis pod rysunkiem, numerację w rozdziałach („Rysunek 3.2”), osobną numerację „wykresów” albo wymóg podania źródła, np. „Źródło: opracowanie własne”. Wzór wydziału i uwagi promotora mają pierwszeństwo przed APA. Ważne, żeby zasada była jedna w całej pracy (zob. styl APA).
Nota ma sprawić, że rysunek da się zrozumieć bez czytania tekstu. Napisz w niej:
- co jest na osiach i w jakich jednostkach (skala 1–5, godziny, punkty testu);
- co oznaczają punkty, pudełka i wąsy. Cumming i in. (2007) przypominają, że odcinki mogą oznaczać przedział ufności, błąd standardowy albo odchylenie standardowe, a każde z nich mówi co innego;
- jak zbudowano wykres pudełkowy (kwartyle, zasięg wąsów), bo nie ma jednej metody liczenia kwartyli (Krzywinski i Altman, 2014);
- liczebność próby lub grup oraz skąd są dane, jeśli nie z badania własnego.
Jeśli praca ma spis rysunków, generuj go automatycznie z podpisów w edytorze tekstu. Ręcznie wpisany spis rozjedzie się przy pierwszej zmianie numeracji.
Jak opisać wykres w tekście pracy
Najczęstsze zdanie pod wykresem w pracach dyplomowych to „Na wykresie przedstawiono rozkład odpowiedzi”. Nic z niego nie wynika. Tekst ma powiedzieć, co czytelnik powinien zobaczyć, podać liczby, które to potwierdzają, i odesłać do rysunku. Trzy zasady:
- Najpierw wniosek, potem odesłanie. „Wyższemu stresowi towarzyszył krótszy sen (Rysunek 1C)”, a nie „Rysunek 1C przedstawia zależność…”.
- Liczby z analizy, nie z oka. Wartości odczytane z osi są przybliżone. Podaj statystyki z wydruku: M, SD, r z CI, wynik testu (zob. jak opisać wyniki w stylu APA).
- Nie opisuj wyglądu. „Niebieski słupek jest najwyższy” opisuje grafikę, nie wynik. Napisz, która grupa i o ile.
| Źle | Dobrze |
|---|---|
| „Wykres 1 przedstawia histogram zmiennej stres.” | „Wyniki stresu obejmowały całą skalę, a ich rozkład był zbliżony do symetrycznego (Rysunek 1A).” |
| „Najwięcej osób studiuje psychologię, co widać na wykresie.” | „Największe grupy stanowili studenci psychologii (25.0%) i pedagogiki (23.2%), najmniejszą – ekonomii (12.2%).” |
| „Na wykresie widać, że studenci niestacjonarni są bardziej zestresowani.” | „Studenci niestacjonarni deklarowali nieco wyższy stres, choć rozkłady obu grup w dużej mierze się pokrywały (Rysunek 2).” |
Gotowe zdania do przykładowego badania (liczby z kodu R poniżej):
Kierunek różnicy podaj słowami, a statystykę t możesz zapisać jako wartość dodatnią. Wybór testu Welcha zamiast klasycznego testu t opisujemy w haśle test t dla prób niezależnych, a interpretację d – w haśle d Cohena. Gdy wykres pokazuje wynik testu, w tekście nie powtarzaj wszystkich średnich, które są już w tabeli. Wystarczy wniosek i statystyka testu.
W czym zrobić wykres: Excel, SPSS, jamovi czy R
Program ma mniejsze znaczenie niż decyzje opisane wyżej. Każdym z nich zrobisz poprawny wykres słupkowy i rozrzutu. Różnice dotyczą wykresów pokazujących dane. W R (ggplot2) i w jamovi punkty, pudełka i przedziały ufności dodasz bez kombinowania. W Excelu wymaga to więcej pracy (zob. analiza statystyczna w Excelu – możliwości i granice). Pierwsze kroki w jamovi opisujemy w poradniku jamovi krok po kroku. Niezależnie od programu:
- usuń domyślne ozdobniki (tło, ramki, cienie, legendę przy jednej serii);
- ustaw polskie opisy osi z jednostkami i kropką lub przecinkiem dziesiętnym zgodnie z resztą pracy;
- wstaw do Worda plik w wysokiej rozdzielczości albo wektorowy, a nie zrzut ekranu;
- sprawdź wydruk w skali szarości, jeśli praca będzie drukowana.
Jeśli nie wiesz, czy wybrane wykresy i opisy pasują do Twoich hipotez, możemy je sprawdzić w ramach konsultacji analiz dla studentów. Wykresy i ich interpretacja pozostają Twoje – na obronie musisz umieć je wyjaśnić.
Dane i liczby do wykresów w R
Kod tworzy dane przykładowe i liczy wszystkie wartości, które pojawiają się w opisach rysunków i w gotowych zdaniach. Rysunki 1 i 2 powstały z tych samych obiektów w ggplot2 i patchwork.
1. Dane, statystyki opisowe, korelacja, porównanie grup i przycięta oś
R
# B113 – przepis 1: dane przykładowe i liczby do opisów wykresów
# Wpis: /blog/wykresy-w-pracy-dyplomowej/ (rysunki 1–2, wzory zdań)
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R
# Badanie przykładowe (dane symulowane): ankieta wśród 164 studentów –
# kierunek studiów, forma studiów, stres akademicki (średnia z pozycji 1–5),
# liczba godzin snu w dobie roboczej.
set.seed(11302)
n <- 164
kierunek <- sample(c("Psychologia", "Pedagogika", "Socjologia", "Zarządzanie", "Ekonomia"),
                   n, replace = TRUE, prob = c(.26, .22, .19, .18, .15))
forma <- sample(c("stacjonarne", "niestacjonarne"), n, replace = TRUE, prob = c(.6, .4))
stres <- 3.0 + 0.25 * (forma == "niestacjonarne") + rnorm(n, 0, 0.62)
stres <- round(pmin(pmax(stres, 1), 5) * 6) / 6          # średnia z 6 pozycji 1–5
sen <- 7.9 - 0.55 * stres + rnorm(n, 0, 0.75)
sen <- round(pmin(pmax(sen, 3.5), 10) * 2) / 2            # deklaracja co pół godziny
dane <- data.frame(kierunek = factor(kierunek), forma = factor(forma, levels = c("stacjonarne", "niestacjonarne")),
                   stres, sen)

# 1. Jedna zmienna ilościowa – histogram: opis rozkładu
cat("N =", nrow(dane), "\n")
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), Min = min(x), Max = max(x),
                      skosnosc = psych::skew(x), kurtoza = psych::kurtosi(x))
print(round(rbind(stres = opis(dane$stres), sen = opis(dane$sen)), 2))

# 2. Jedna zmienna nominalna – liczebności i odsetki, posortowane
tab <- sort(table(dane$kierunek), decreasing = TRUE)
proc <- round(100 * prop.table(tab), 1)
print(data.frame(n = as.vector(tab), procent = as.vector(proc), row.names = names(tab)))
cat("Różnica między największą a najmniejszą grupą (pkt proc.):", max(proc) - min(proc), "\n")

# 3. Dwie zmienne ilościowe – wykres rozrzutu: korelacja Pearsona z 95% CI
kor <- cor.test(dane$stres, dane$sen)
print(kor)
model <- lm(sen ~ stres, data = dane)
print(round(coef(model), 2))

# 4. Zmienna ilościowa w dwóch grupach – punkty, pudełka, średnia z 95% CI
gr <- do.call(rbind, lapply(split(dane$stres, dane$forma), function(x)
  c(n = length(x), M = mean(x), SD = sd(x), CI_dolna = t.test(x)$conf.int[1], CI_gorna = t.test(x)$conf.int[2],
    Me = median(x))))
print(round(gr, 2))
tw <- t.test(stres ~ forma, data = dane)          # test Welcha
print(tw)
print(effectsize::cohens_d(stres ~ forma, data = dane, pooled_sd = TRUE))
cat("\n")

# 5. Oś przycięta: o ile „rośnie” różnica na rysunku z osią od 2.8 zamiast od 1?
roznica <- diff(gr[, "M"])
dol <- 2.8
wys_przyc <- gr[, "M"] - dol                       # wysokości słupków przy osi od 2.8
wys_pelna <- gr[, "M"] - 1                         # przy osi od 1 (minimum skali)
cat("Różnica średnich:", round(roznica, 2), "\n")
cat("Stosunek wysokości słupków, oś od 1:", round(wys_pelna[2] / wys_pelna[1], 2), "\n")
cat("Stosunek wysokości słupków, oś od 2.8:", round(wys_przyc[2] / wys_przyc[1], 2), "\n")
cat("Różnica jako % szerokości skali 1–5:", round(100 * roznica / 4, 1), "\n")
Wynik w R
N = 164
         M   SD   Me Min Max skosnosc kurtoza
stres 3.07 0.72 3.17   1 5.0    -0.26    0.12
sen   6.23 0.83 6.00   4 8.5     0.14   -0.15
             n procent
Psychologia 41    25.0
Pedagogika  38    23.2
Socjologia  36    22.0
Zarządzanie 29    17.7
Ekonomia    20    12.2
Różnica między największą a najmniejszą grupą (pkt proc.): 12.8

	Pearson's product-moment correlation

data:  dane$stres and dane$sen
t = -4.0243, df = 162, p-value = 8.754e-05
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 -0.4346356 -0.1553950
sample estimates:
       cor
-0.3014657

(Intercept)       stres
       7.29       -0.34
                 n    M   SD CI_dolna CI_gorna   Me
stacjonarne    108 2.98 0.71     2.84     3.11 3.00
niestacjonarne  56 3.24 0.73     3.04     3.43 3.33

	Welch Two Sample t-test

data:  stres by forma
t = -2.1885, df = 109.27, p-value = 0.03076
alternative hypothesis: true difference in means between group stacjonarne and group niestacjonarne is not equal to 0
95 percent confidence interval:
 -0.49488518 -0.02451517
sample estimates:
   mean in group stacjonarne mean in group niestacjonarne
                    2.978395                     3.238095

Cohen's d |         95% CI
--------------------------
-0.36     | [-0.69, -0.04]

- Estimated using pooled SD.
Różnica średnich: 0.26
Stosunek wysokości słupków, oś od 1: 1.13
Stosunek wysokości słupków, oś od 2.8: 2.46
Różnica jako % szerokości skali 1–5: 6.5
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje cor.test(), lm() i t.test() z pakietu stats); rysunki przygotowano w ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Lista kontrolna przed oddaniem pracy
- Każdy wykres odpowiada na pytanie z hipotez lub problemu badawczego, a metryczka jest w tabeli.
- Typ wykresu pasuje do zmiennych: histogram do rozkładu, słupki do kategorii, rozrzut do związku, punkty z pudełkami do porównań.
- Słupki zaczynają się od zera lub od początku skali; przy średnich pokazane są dane i 95% CI.
- Bez efektu 3D, wykresów kołowych z wieloma kategoriami i kolorów, które giną w druku.
- Każdy rysunek ma numer, tytuł i notę z liczebnością oraz opisem punktów i wąsów.
- Numeracja i układ podpisów są zgodne ze wzorem wydziału w całej pracy.
- Każdy rysunek jest przywołany w tekście przed miejscem, w którym się pojawia.
- Tekst podaje wniosek i statystyki, a nie opisuje kolory i kształty.
- Liczby na wykresie, w tabeli i w tekście pochodzą z tej samej analizy.
Szerszą listę dla całego rozdziału wyników znajdziesz w przewodniku po statystyce w pracy dyplomowej, a typowe uwagi do rozdziału wyników – w tekście o poprawkach promotora.
Najczęstsze pytania
Czy w pracy magisterskiej pisze się „wykres” czy „rysunek”?
W stylu APA każdy wykres, schemat czy zdjęcie to rysunek, numerowany kolejno: Rysunek 1, Rysunek 2. Część polskich uczelni wymaga jednak osobnej numeracji wykresów albo numeracji w rozdziałach. Sprawdź wzór wydziału i trzymaj się jednej zasady w całej pracy.
Czy wykres kołowy nadaje się do pracy dyplomowej?
Rzadko. Przy dwóch–trzech kategoriach o wyraźnie różnych odsetkach jest czytelny, ale przy większej liczbie podobnych kategorii trudno porównać wycinki. Posortowany wykres słupkowy z liczebnościami i odsetkami, a dla metryczki – tabela, przekazują to samo dokładniej i zajmują mniej miejsca.
Ile wykresów powinno być w pracy licencjackiej?
Nie ma limitu, ale każdy wykres powinien odpowiadać na pytanie z hipotez lub problemu badawczego. Zwykle wystarczy kilka rysunków dla głównych wyników; dane z metryczki i wyniki dokładne lepiej pokazać w tabelach, a nie na osobnym wykresie dla każdego pytania ankiety.
Gdzie umieścić podpis i źródło pod wykresem w pracy?
W APA numer i tytuł stoją nad rysunkiem, a pod nim nota zaczynająca się od „Uwaga.”, z opisem osi, symboli i liczebności. Wiele uczelni każe dodać pod rysunkiem „Źródło: opracowanie własne” albo umieszczać cały podpis pod spodem – w takim przypadku wzór wydziału ma pierwszeństwo.
Czy oś Y na wykresie słupkowym musi zaczynać się od zera?
Tak, jeśli długość słupka ma oznaczać wartość; przy skalach z minimum 1 – od początku skali. Przycięta oś wyolbrzymia różnice: w przykładzie na tej stronie różnica 0.26 punktu na skali 1–5 daje słupek 2.46 razy wyższy. Do pokazania małych różnic użyj punktów z przedziałami ufności.
Powiązane hasła
Przeczytaj też
Tabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →PoradnikTabele i rysunki do artykułu
Wymogi czasopism, wykresy z danymi zamiast słupków, kolory czytelne dla daltonistów, eksport z R w 300 dpi i materiały uzupełniające.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →Nie wiesz, które wykresy pokazać w rozdziale wyników?
Sprawdzimy, czy wykresy pasują do Twoich hipotez i danych, i wyjaśnimy, jak je opisać, a Ty zachowasz pełną kontrolę nad tekstem pracy.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.1080/00031305.1973.10478966
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. Journal of Cell Biology, 177(1), 7–11. https://doi.org/10.1083/jcb.200611141 ● Otwarty dostęp
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05 ● Otwarty dostęp
- Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
- Siegrist, M. (1996). The use or misuse of three-dimensional graphs to represent lower-dimensional data. Behaviour & Information Technology, 15(2), 96–100. https://doi.org/10.1080/014492996120300
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128 ● Otwarty dostęp
Cytowania BibTeX
@book{apa2020publication, author={{American Psychological Association}}, title={{Publication manual of the American Psychological Association}}, year={2020}, edition={7th ed.}, publisher={American Psychological Association}, doi={10.1037/0000165-000}}@article{anscombe1973graphs, author={Anscombe, Francis J.}, title={{Graphs in statistical analysis}}, journal={The American Statistician}, year={1973}, volume={27}, number={1}, pages={17--21}, doi={10.1080/00031305.1973.10478966}}@article{cleveland1984graphical, author={Cleveland, William S. and McGill, Robert}, title={{Graphical perception: Theory, experimentation, and application to the development of graphical methods}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={531--554}, doi={10.1080/01621459.1984.10478080}}@article{cumming2007error, author={Cumming, Geoff and Fidler, Fiona and Vaux, David L.}, title={{Error bars in experimental biology}}, journal={Journal of Cell Biology}, year={2007}, volume={177}, number={1}, pages={7--11}, doi={10.1083/jcb.200611141}}@article{heiberger2014design, author={Heiberger, Richard M. and Robbins, Naomi B.}, title={{Design of diverging stacked bar charts for Likert scales and other applications}}, journal={Journal of Statistical Software}, year={2014}, volume={57}, number={5}, pages={1--32}, doi={10.18637/jss.v057.i05}}@article{krzywinski2014visualizing, author={Krzywinski, Martin and Altman, Naomi}, title={{Visualizing samples with box plots}}, journal={Nature Methods}, year={2014}, volume={11}, number={2}, pages={119--120}, doi={10.1038/nmeth.2813}}@article{siegrist1996use, author={Siegrist, Michael}, title={{The use or misuse of three-dimensional graphs to represent lower-dimensional data}}, journal={Behaviour \& Information Technology}, year={1996}, volume={15}, number={2}, pages={96--100}, doi={10.1080/014492996120300}}@article{weissgerber2015beyond, author={Weissgerber, Tracey L. and Milic, Natasa M. and Winham, Stacey J. and Garovic, Vesna D.}, title={{Beyond bar and line graphs: Time for a new data presentation paradigm}}, journal={PLOS Biology}, year={2015}, volume={13}, number={4}, eid={e1002128}, doi={10.1371/journal.pbio.1002128}}