.omv i podaj w pracy wersję programu.Zanim zaczniesz: wersja programu i otwarcie danych
Ten poradnik prowadzi przez cztery analizy, które pojawiają się w niemal każdej pracy dyplomowej: statystyki opisowe, test t, korelację i jednoczynnikową ANOVA. Czym jest jamovi, jak działa i jak go zacytować, opisuje hasło jamovi. Porównanie z JASP, R i PSPP znajdziesz we wpisie o bezpłatnych programach do analizy statystycznej. Wszystkie nazwy menu i opcji podajemy po angielsku, tak jak w oficjalnej dokumentacji programu.
jamovi rozwija dwie linie programu: stabilną solid (w październiku 2026 r. wersja 2.7) i current z najnowszymi funkcjami (The jamovi project, 2026). Do pracy dyplomowej wybierz wersję solid i nie zmieniaj jej do końca analiz. Wersja na komputer jest bezpłatna i działa w systemach Windows, macOS i Linux (The jamovi project, b.d.-a).
Dane otworzysz z menu ☰ → Open → This PC. jamovi czyta m.in. pliki CSV, Excel, SPSS, Stata i SAS. Po lewej stronie zobaczysz arkusz, po prawej panel wyników. Analizy wybierasz z paska Analyses, a wyniki przeliczają się przy każdej zmianie opcji. Tabele są w formacie APA i skopiujesz je prawym przyciskiem myszy (The jamovi project, b.d.-b).
Badanie przykładowe: stres, sen i wynik egzaminu
Dziewięćdziesiąt osób studiujących podało tryb studiów (stacjonarne: 44 osoby, niestacjonarne: 46) i sposób przygotowania do egzaminu: samodzielnie (32), w grupie (30) albo na kursie (28). Wypełniły też krótką skalę stresu (wynik 1–5) i podały średnią liczbę godzin snu. Ostatnia zmienna to wynik egzaminu (0–100 punktów). Dane są symulowane. Pobierz plik CSV (kolumny: id, tryb, przygotowanie, stres, sen, wynik), otwórz go w jamovi i powtarzaj kolejne kroki.
| Pytanie | Analiza w jamovi | Ścieżka w menu |
|---|---|---|
| Jak wyglądają zmienne w obu trybach studiów? | Descriptives | Analyses → Exploration → Descriptives |
| Czy niestacjonarni są bardziej zestresowani? | Independent Samples T-Test | Analyses → T-Tests |
| Czy stres wiąże się ze snem i wynikiem egzaminu? | Correlation Matrix | Analyses → Regression |
| Czy sposób przygotowania różnicuje wynik egzaminu? | One-Way ANOVA | Analyses → ANOVA |
Krok 1. Ustaw typy zmiennych
Każda kolumna w jamovi ma dwa ustawienia. Measure type to poziom pomiaru: Continuous, Ordinal, Nominal albo ID. Data type to sposób zapisu: Integer, Decimal albo Text. Program ustawia je sam przy wczytywaniu danych. Jeśli się pomyli, zmień je w edytorze zmiennej, który otworzysz podwójnym kliknięciem nagłówka kolumny. W tym samym oknie dodasz etykiety poziomów, ustalisz ich kolejność i określisz kody braków w polu Missing values, np. −99 (The jamovi project, b.d.-b).
W przykładzie tryb i przygotowanie mają być Nominal, a stres, sen i wynik – Continuous. Kolejność poziomów zmiennej przygotowanie ustaw na: samodzielnie, grupa, kurs. W tej kolejności grupy pojawią się w tabelach i na wykresach. Jak dobrać typ do skali nominalnej, porządkowej i ilościowej, wyjaśniają hasła słownika. Jeśli kody braków zostaną bez definicji, jamovi policzy je jak zwykłe liczby. Jedna odpowiedź −99 zaniży wtedy średnią całej grupy.
Krok 2. Statystyki opisowe: Descriptives
Wybierz Analyses → Exploration → Descriptives. Zmienne stres, sen i wynik przeciągnij do pola Variables, a tryb do pola Split by. Na karcie Statistics zaznacz odchylenie standardowe, przedział ufności dla średniej, skośność i test Shapiro–Wilka. Na karcie Plots włącz Box plot, Violin i Q-Q. Dokumentacja poleca je do wykrywania obserwacji odstających i oceny rozkładu (The jamovi project, b.d.-b).
| Zmienna | Stacjonarne (n = 44) M (SD) | Niestacjonarne (n = 46) M (SD) |
|---|---|---|
| Stres (1–5) | 2.95 (0.69) | 3.34 (0.67) |
| Sen (godziny) | 7.34 (0.67) | 7.22 (0.91) |
| Wynik egzaminu (0–100) | 67.66 (13.48) | 67.04 (12.33) |
Test Shapiro–Wilka nie był istotny dla żadnej zmiennej w żadnej grupie (wszystkie p > .24). Przy kilkudziesięciu osobach w grupie ważniejszy jest jednak wykres Q-Q niż sam test (zob. jak sprawdzić normalność rozkładu). Co podać w tabeli i z jaką dokładnością, opisuje wpis statystyki opisowe w pracy.
Krok 3. Test t: Independent Samples T-Test
Wybierz Analyses → T-Tests → Independent Samples T-Test. Zmienną stres przeciągnij do pola Dependent Variables, a tryb do pola Grouping Variable (The jamovi project, b.d.-b). Potem zmień ustawienia domyślne:
- W części Tests odznacz Student's i zaznacz Welch's.
- W części Additional Statistics zaznacz Mean difference z przedziałem ufności, Effect size i Descriptives.
- W części Assumption Checks możesz zaznaczyć Homogeneity test (test Levene’a) i Normality test (Selker i in., 2025).
Porównanie jamovi z SPSS w dokumentacji programu radzi przejść na Welch's dopiero wtedy, gdy test Levene’a jest istotny (The jamovi project, b.d.-c). My zalecamy test Welcha od razu, bez wstępnego testu. Delacre i in. (2017) pokazują, że wybór testu na podstawie testu równości wariancji często zawodzi. Test Welcha lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe. Szczegóły w haśle test Welcha.
Wynik. Osoby studiujące niestacjonarnie miały wyższy stres niż stacjonarne, t(87.56) = −2.75, p = .007. Różnica średnich wyniosła −0.40, 95% CI [−0.68, −0.11]. Znak minus wynika z kolejności grup: od wyniku grupy stacjonarnej odejmowany jest wynik grupy niestacjonarnej. Wielkość efektu to d Cohena = −0.58. W naszym uruchomieniu (jmv 2.7.7) kolumna przedziału ufności dla d w wierszu Welch's t pozostała pusta, więc przedział policzyliśmy w R: 95% CI [−1.00, −0.16]. Sprawdź, czy Twoja wersja programu go wyświetla. Test Levene’a: F(1, 88) = 0.01, p = .905.
Dla dwóch pomiarów tych samych osób wybierz Paired Samples T-Test i przeciągnij obie zmienne do pola Paired Variables (The jamovi project, b.d.-b). Odpowiednikiem nieparametrycznym jest pole Mann-Whitney U w teście dla prób niezależnych (The jamovi project, b.d.-c). Kiedy po nie sięgać, wyjaśnia poradnik testy nieparametryczne krok po kroku. Pełny tok analizy testem t opisuje wpis test t Studenta krok po kroku.
Krok 4. Korelacja: Correlation Matrix
Korelację znajdziesz w grupie Regression: Analyses → Regression → Correlation Matrix. Przeciągnij stres, sen i wynik do pola zmiennych. W części Correlation Coefficients zostaw zaznaczone Pearson. W części Additional Options zaznacz Report significance, Flag significant correlations i N (The jamovi project, b.d.-c), a do tego Confidence intervals (Selker i in., 2025). jamovi pokazuje współczynniki tylko pod przekątną. Gwiazdki oznaczają p < .05, .01 i .001 (The jamovi project, b.d.-c). Do tekstu pracy przepisuj jednak dokładne p, a nie gwiazdki.
| Para zmiennych | r | 95% CI | p |
|---|---|---|---|
| Stres – sen | −.32 | [−.50, −.13] | .002 |
| Stres – wynik egzaminu | −.23 | [−.42, −.03] | .028 |
| Sen – wynik egzaminu | .04 | [−.17, .25] | .690 |
Zanim opiszesz liczby, obejrzyj wykres rozrzutu (rysunek 1). Korelacja Pearsona mierzy tylko związek liniowy, a jedna obserwacja odstająca potrafi ją wyraźnie zmienić. Przy porządkowych danych albo silnie skośnych rozkładach zaznacz Spearman. Jak wybrać miarę i jak zbudować macierz do pracy, opisują wpis korelacja Pearsona i Spearmana krok po kroku i hasło tabela korelacji w APA.
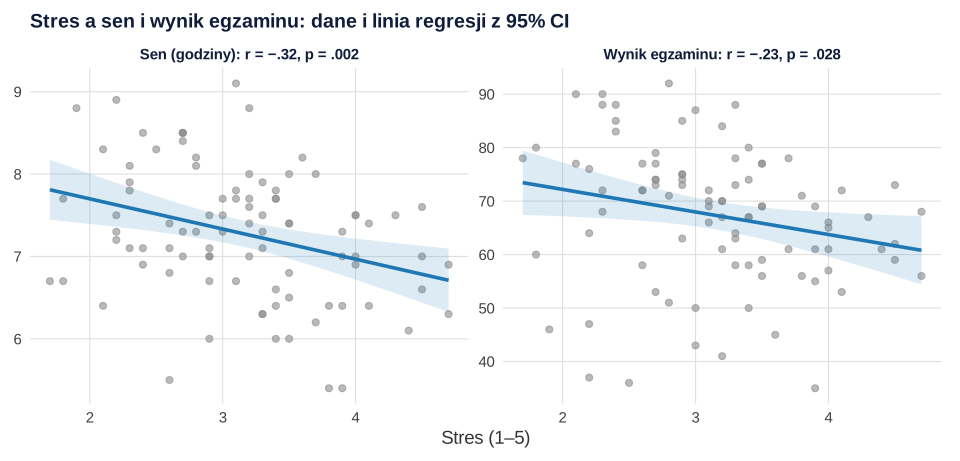
To badanie korelacyjne, więc wynik nie pokazuje, że stres obniża wynik egzaminu (zob. korelacja a przyczynowość).
Krok 5. ANOVA: One-Way ANOVA z testem Welcha
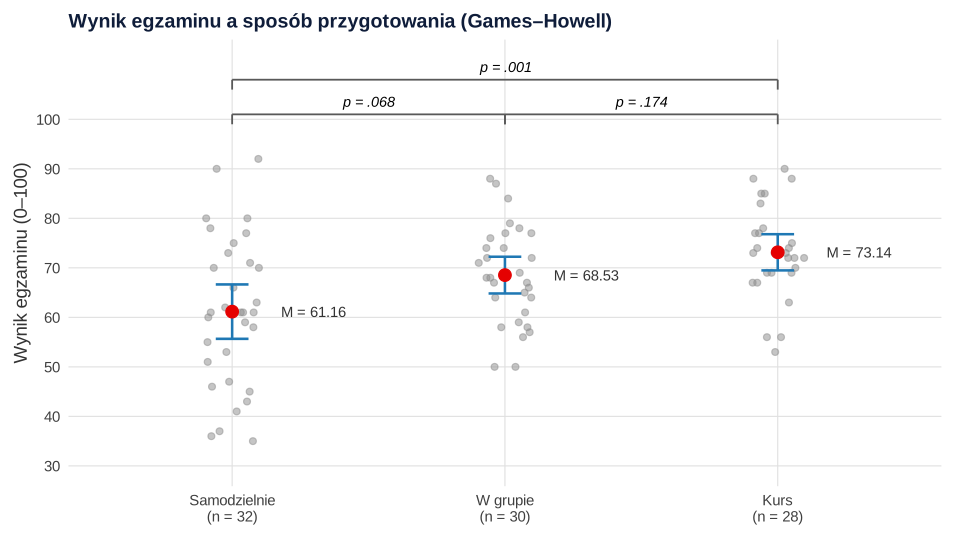
Wybierz Analyses → ANOVA → One-Way ANOVA. Zmienną wynik przeciągnij do pola zmiennych zależnych, a przygotowanie do pola Grouping Variable. W części Variances zaznacz Don't assume equal (Welch's). W części Assumption Checks włącz Homogeneity test. W części Post-Hoc Tests wybierz Games-Howell (unequal variances) (Selker i in., 2025). Taki zestaw zaleca się przy nierównych wariancjach i liczebnościach. Delacre i in. (2019) proponują ANOVA Welcha jako wybór domyślny. Games i Howell (1976) wykazali w symulacjach, że ich procedura porównań parami dobrze kontroluje błąd I rodzaju także wtedy, gdy wariancje i liczebności grup się różnią.
Wynik. Test Levene’a był istotny, F(2, 87) = 4.04, p = .021. Największe SD miała grupa ucząca się samodzielnie: 15.23 wobec 9.93 i 9.43. Wynik egzaminu zależał od sposobu przygotowania, FWelch(2, 57.29) = 6.90, p = .002. One-Way ANOVA nie podaje wielkości efektu. Ten sam model w analizie ANOVA → ANOVA z opcją Effect Size: ω² (Selker i in., 2025) dał ω² = .13. Porównania Gamesa–Howella pokazały, że różnica jest istotna tylko między nauką samodzielną a kursem (rysunek 2).
Inny przykład One-Way ANOVA w jamovi, z dobrostanem i aktywnością fizyczną, znajdziesz w haśle jamovi. Interpretację testów post hoc, ANOVA dwuczynnikową i tabelę do pracy opisuje poradnik ANOVA krok po kroku.
Krok 6. Zapisz analizy i pokaż kod
Zapisz plik .omv. Mieści on dane, ustawienia analiz i wyniki, więc po uwagach promotora otworzysz go i poprawisz jedną opcję zamiast klikać wszystko od nowa. Warto też włączyć Syntax mode w menu ⋮ w prawym górnym rogu. Każda analiza pokaże wtedy kod R, który możesz skopiować. Wszystkie wbudowane analizy jamovi są dostępne w R jako pakiet jmv (The jamovi project, b.d.-b). Dlatego kod poniżej odtwarza wyniki z tego wpisu bez uruchamiania programu. W części o metodzie podaj numer wersji jamovi. Jeśli jakąś statystykę liczyłeś(-aś) poza programem, jak tu przedział dla d, napisz to wprost.
Te same analizy w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc poniższy kod daje te same tabele co program (The jamovi project, b.d.-b). Samego jamovi tu nie uruchamialiśmy – liczby w tekście pochodzą z tego kodu. Tabele są szerokie: przewiń je w poziomie.
Opis, test t, korelacje i ANOVA funkcjami jmv
R
# Te same analizy co w jamovi, wykonane w R pakietem jmv (jamovi korzysta z tych samych funkcji)
library(jmv)
dane <- read.csv("jamovi-krok-po-kroku-dane.csv")
dane$tryb <- factor(dane$tryb, levels = c("stacjonarne", "niestacjonarne"))
dane$przygotowanie <- factor(dane$przygotowanie, levels = c("samodzielnie", "grupa", "kurs"))

# 1. Exploration → Descriptives (Split by: tryb), statystyki i Shapiro-Wilk
descriptives(data = dane, vars = c("stres", "sen", "wynik"), splitBy = "tryb",
             sd = TRUE, ci = TRUE, skew = TRUE, sw = TRUE, median = FALSE, min = TRUE, max = TRUE)

# 2. T-Tests → Independent Samples T-Test: stres w dwóch trybach studiów
ttestIS(data = dane, vars = "stres", group = "tryb",
        students = FALSE, welchs = TRUE, meanDiff = TRUE, ci = TRUE,
        effectSize = TRUE, desc = TRUE, eqv = TRUE, norm = TRUE)
# Przedział ufności dla d przy teście Welcha (w jmv 2.7.7 kolumna CI dla d w wierszu Welch's t jest pusta)
effectsize::cohens_d(stres ~ tryb, data = dane, pooled_sd = FALSE)

# 3. Regression → Correlation Matrix: stres, sen i wynik egzaminu
corrMatrix(data = dane, vars = c("stres", "sen", "wynik"), pearson = TRUE,
           sig = TRUE, flag = TRUE, n = TRUE, ci = TRUE)

# 4. ANOVA → One-Way ANOVA: wynik egzaminu a sposób przygotowania
anovaOneW(data = dane, deps = "wynik", group = "przygotowanie",
          welchs = TRUE, fishers = TRUE, desc = TRUE, eqv = TRUE, norm = TRUE,
          phMethod = "gamesHowell", phMeanDif = TRUE, phSig = TRUE)

# 5. ANOVA → ANOVA: ten sam model z wielkością efektu ω² (One-Way ANOVA jej nie podaje)
ANOVA(formula = wynik ~ przygotowanie, data = dane, effectSize = "omega")
packageVersion("jmv")
Wynik w R
 DESCRIPTIVES

 Descriptives
 ────────────────────────────────────────────────────────────────────────────────────────
                              tryb              stres          sen           wynik
 ────────────────────────────────────────────────────────────────────────────────────────
   N                          stacjonarne                44            44            44
                              niestacjonarne             46            46            46
   Missing                    stacjonarne                 0             0             0
                              niestacjonarne              0             0             0
   Mean                       stacjonarne          2.945455      7.336364      67.65909
                              niestacjonarne       3.341304      7.223913      67.04348
   95% CI mean lower bound    stacjonarne          2.735589      7.132670      63.56071
                              niestacjonarne       3.141498      6.954405      63.38283
   95% CI mean upper bound    stacjonarne          3.155320      7.540058      71.75747
                              niestacjonarne       3.541110      7.493421      70.70413
   Standard deviation         stacjonarne         0.6902829     0.6699847      13.48029
                              niestacjonarne      0.6728302     0.9075449      12.32695
   Minimum                    stacjonarne          1.700000      5.500000            35
                              niestacjonarne       1.900000      5.400000            36
   Maximum                    stacjonarne          4.700000      8.500000            90
                              niestacjonarne       4.700000      9.100000            92
   Skewness                   stacjonarne         0.4479796    -0.3726287    -0.5345215
                              niestacjonarne    -0.05450069     0.1284077    -0.3246344
   Std. error skewness        stacjonarne         0.3574838     0.3574838     0.3574838
                              niestacjonarne      0.3500963     0.3500963     0.3500963
   Shapiro-Wilk W             stacjonarne         0.9758081     0.9792773     0.9676168
                              niestacjonarne      0.9845431     0.9829046     0.9834532
   Shapiro-Wilk p             stacjonarne         0.4755232     0.6049639     0.2486926
                              niestacjonarne      0.7926251     0.7263322     0.7488822
 ────────────────────────────────────────────────────────────────────────────────────────
   Note. The CI of the mean assumes sample means follow a t-distribution with N - 1
   degrees of freedom


 INDEPENDENT SAMPLES T-TEST

 Independent Samples T-Test
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                         Statistic    df          p            Mean difference    SE difference    Lower         Upper                      Effect Size
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   stres    Welch's t    -2.753299    87.56425    0.0071727         -0.3958498        0.1437729    -0.6815880    -0.1101116    Cohen's d     -0.5807550
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Hₐ μ <sub>stacjonarne</sub> ≠ μ <sub>niestacjonarne</sub>


 ASSUMPTIONS

 Normality Test (Shapiro-Wilk)
 ───────────────────────────────────
            W            p
 ───────────────────────────────────
   stres    0.9891178    0.6661472
 ───────────────────────────────────
   Note. A low p-value suggests
   a violation of the assumption
   of normality


 Homogeneity of Variances Test (Levene's)
 ─────────────────────────────────────────────────
            F             df    df2    p
 ─────────────────────────────────────────────────
   stres    0.01429911     1     88    0.9050893
 ─────────────────────────────────────────────────
   Note. A low p-value suggests a violation of
   the assumption of equal variances


 Group Descriptives
 ────────────────────────────────────────────────────────────────────────────────────
            Group             N     Mean        Median      SD           SE
 ────────────────────────────────────────────────────────────────────────────────────
   stres    stacjonarne       44    2.945455    2.900000    0.6902829     0.1040641
            niestacjonarne    46    3.341304    3.300000    0.6728302    0.09920340
 ────────────────────────────────────────────────────────────────────────────────────

Cohen's d |         95% CI
--------------------------
-0.58     | [-1.00, -0.16]

- Estimated using un-pooled SD.
 CORRELATION MATRIX

 Correlation Matrix
 ──────────────────────────────────────────────────────────────────
                            stres         sen           wynik
 ──────────────────────────────────────────────────────────────────
   stres    Pearson's r              —
            df                       —
            p-value                  —
            95% CI Upper             —
            95% CI Lower             —
            N                        —

   sen      Pearson's r     -0.3242532             —
            df                      88             —
            p-value          0.0018219             —
            95% CI Upper    -0.1255959             —
            95% CI Lower    -0.4979097             —
            N                       90             —

   wynik    Pearson's r     -0.2320461     0.0426353            —
            df                      88            88            —
            p-value          0.0277542     0.6898920            —
            95% CI Upper    -0.0262148     0.2475408            —
            95% CI Lower    -0.4190022    -0.1659208            —
            N                       90            90            —
 ──────────────────────────────────────────────────────────────────
   Note. * p < .05, ** p < .01, *** p < .001


 ONE-WAY ANOVA

 One-Way ANOVA
 ─────────────────────────────────────────────────────────────────
                        F           df1    df2         p
 ─────────────────────────────────────────────────────────────────
   wynik    Welch's     6.895303      2    57.29130    0.0020737
            Fisher's    7.718230      2          87    0.0008209
 ─────────────────────────────────────────────────────────────────


 Group Descriptives
 ─────────────────────────────────────────────────────────────────────
            przygotowanie    N     Mean        SD           SE
 ─────────────────────────────────────────────────────────────────────
   wynik    samodzielnie     32    61.15625    15.231778    2.692623
            grupa            30    68.53333     9.929869    1.812938
            kurs             28    73.14286     9.426968    1.781529
 ─────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Normality Test (Shapiro-Wilk)
 ───────────────────────────────────
            W            p
 ───────────────────────────────────
   wynik    0.9868831    0.5069297
 ───────────────────────────────────
   Note. A low p-value suggests
   a violation of the assumption
   of normality


 Homogeneity of Variances Test (Levene's)
 ────────────────────────────────────────────────
            F           df1    df2    p
 ────────────────────────────────────────────────
   wynik    4.035276      2     87    0.0210904
 ────────────────────────────────────────────────


 POST HOC TESTS

 Games-Howell Post-Hoc Test – wynik
 ──────────────────────────────────────────────────────────────────────────────
                                      samodzielnie    grupa        kurs
 ──────────────────────────────────────────────────────────────────────────────
   samodzielnie    Mean difference               —    -7.377083    -11.986607
                   p-value                       —    0.0684491     0.0014219

   grupa           Mean difference                            —     -4.609524
                   p-value                                    —     0.1744927

   kurs            Mean difference                                          —
                   p-value                                                  —
 ──────────────────────────────────────────────────────────────────────────────


 ANOVA

 ANOVA - wynik
 ──────────────────────────────────────────────────────────────────────────────────────────────
                    Sum of Squares    df    Mean Square    F           p            ω²
 ──────────────────────────────────────────────────────────────────────────────────────────────
   przygotowanie          2209.208     2      1104.6041    7.718230    0.0008209    0.1299006
   Residuals             12451.114    87       143.1163
 ──────────────────────────────────────────────────────────────────────────────────────────────

[1] ‘2.7.7’
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv. Przedział ufności dla d policzono pakietem effectsize, a rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w jamovi
- Zostawienie ustawień domyślnych. W teście t i One-Way ANOVA zaznacz test Welcha świadomie, zanim zobaczysz wynik. Inaczej przełączanie opcji „aż wyjdzie” zamienia się w p-hacking, a wyniki na żywo bardzo to ułatwiają.
- Zły typ zmiennej. Kod grupy zapisany liczbą może zostać wczytany jako Continuous. Sprawdź typy przed pierwszą analizą.
- Niezdefiniowane kody braków. Wartości −99 albo 999 bez ustawienia w Missing values trafią do średnich.
- Gwiazdki zamiast liczb. W tekście pracy podaj r, przedział ufności i dokładne p, a gwiazdki zostaw w tabeli.
- Brak wielkości efektu. Zaznacz Effect size w teście t, a dla ANOVA policz ω² albo η² w analizie ANOVA. Wielkości efektu i ich interpretację porównasz w konwerterze wielkości efektu.
- Kopiowanie tabel bez sprawdzenia. Tabela z jamovi ma układ APA, ale liczby miejsc po kropce, zapis p i tytuł dopasuj do zasad swojej pracy.
Jeśli nie wiesz, którą analizę wybrać do swoich hipotez, albo chcesz, żeby ktoś sprawdził Twój plik .omv, zajrzyj do oferty analiz statystycznych dla studentów. Pomożemy Ci zrozumieć wyniki tak, żebyś mógł(a) je samodzielnie opisać i obronić.
Najczęstsze pytania
Jak zrobić test t dla prób niezależnych w jamovi?
Wybierz Analyses → T-Tests → Independent Samples T-Test. Zmienną wynikową przeciągnij do pola Dependent Variables, a grupującą do Grouping Variable. Zaznacz Welch's zamiast Student's, a także Mean difference, Effect size i Descriptives. Odczytaj t, ułamkowe df, p, różnicę średnich z 95% CI i d Cohena.
Gdzie w jamovi jest korelacja Pearsona?
W grupie Regression: Analyses → Regression → Correlation Matrix. Przeciągnij zmienne do pola zmiennych, zostaw zaznaczone Pearson i włącz Report significance, N oraz Confidence intervals. Współczynniki są pod przekątną macierzy. Do tekstu pracy przepisz r, przedział ufności i dokładne p.
Jak włączyć test Welcha w ANOVA w jamovi?
W analizie One-Way ANOVA zaznacz w części Variances opcję Don't assume equal (Welch's). Jako test post hoc wybierz Games-Howell (unequal variances). W tabeli odczytaj wiersz Welch's: F, dwie liczby stopni swobody (druga zwykle ułamkowa) i p. Decyzję o teście Welcha podejmij przed analizą, nie po zobaczeniu wyniku.
Jak policzyć wielkość efektu ANOVA w jamovi?
One-Way ANOVA nie podaje wielkości efektu. Uruchom ten sam model w Analyses → ANOVA → ANOVA i w opcji Effect Size zaznacz ω² (albo η² lub cząstkowe η²). Przy jednym czynniku i małej próbie ω² jest mniej obciążone niż η². W pracy napisz, którą miarę podajesz.
Jak zmienić typ zmiennej w jamovi?
Kliknij dwukrotnie nagłówek kolumny, aby otworzyć edytor zmiennej. Ustaw Measure type (Nominal, Ordinal, Continuous albo ID) i Data type (Integer, Decimal albo Text). W tym samym oknie dodasz etykiety poziomów, zmienisz ich kolejność i zdefiniujesz kody braków w Missing values.
Powiązane hasła
Przeczytaj też
R dla początkujących
Od instalacji R i RStudio do pierwszego testu t: wczytanie CSV i .sav, ramka danych, wynik skali, statystyki opisowe, d Cohena. Dane i skrypt do pobrania.
Czytaj →PoradnikAnaliza czynnikowa w jamovi
EFA i CFA w jamovi na jednym przykładzie: ustawienia, tabele do czytania, ukryte ładunki, rzetelność, opis APA i te same wyniki w R.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →Masz analizy w jamovi i nie wiesz, czy są dobrze ustawione?
Sprawdzimy Twój plik .omv, dobór testów i opcji, policzymy brakujące wielkości efektu i wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (2026). Release notes. https://www.jamovi.org/releases.html ● Otwarty dostęp
- The jamovi project. (b.d.-a). About jamovi. https://www.jamovi.org/about.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). jamovi documentation: Getting started, Data handling and Analyses. jamovi docs. https://docs.jamovi.org/ ● Otwarty dostęp
- The jamovi project. (b.d.-c). From SPSS to jamovi: Comparison of analyses and side-by-side comparisons. jamovi docs. https://docs.jamovi.org/spss2jamovi/s2j_side-by-side.html ● Otwarty dostęp
Cytowania BibTeX
@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{games1976pairwise, author={Games, Paul A. and Howell, John F.}, title={{Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={2}, pages={113--125}, doi={10.3102/10769986001002113}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovi2026releases, author={{The jamovi project}}, title={{Release notes}}, howpublished={jamovi}, year={2026}, url={https://www.jamovi.org/releases.html}}@misc{jamovindabout, author={{The jamovi project}}, title={{About jamovi}}, howpublished={jamovi}, year={b.d.-a}, url={https://www.jamovi.org/about.html}}@misc{jamovindocs, author={{The jamovi project}}, title={{jamovi documentation: Getting started, Data handling and Analyses}}, howpublished={jamovi docs}, year={b.d.-b}, url={https://docs.jamovi.org/}}@misc{jamovindspss, author={{The jamovi project}}, title={{From SPSS to jamovi: Comparison of analyses and side-by-side comparisons}}, howpublished={jamovi docs}, year={b.d.-c}, url={https://docs.jamovi.org/spss2jamovi/s2j_side-by-side.html}}