Co znajdziesz w jamovi i co liczy się „pod spodem”
W jamovi analizy czynnikowe są w zakładce Factor. Dokumentacja programu wymienia cztery: Reliability Analysis, Principal Component Analysis, Exploratory Factor Analysis i Confirmatory Factor Analysis (The jamovi project, b.d.-a, b.d.-e). jamovi celowo oddziela analizę głównych składowych, która redukuje liczbę zmiennych, od eksploracyjnej analizy czynnikowej, która szuka zmiennych ukrytych. W SPSS obie metody są w jednej procedurze (The jamovi project, b.d.-a). Jeśli chcesz opisać wymiary kwestionariusza, wybierz EFA.
Każda analiza z jamovi jest też funkcją pakietu jmv w R. Tryb składni (syntax mode, menu ⋮ w prawym górnym rogu) pokazuje kod, który odtwarza analizę (The jamovi project, b.d.-e). Dzięki temu wszystkie liczby w tym wpisie pochodzą z tych samych funkcji, których używa jamovi. Kod pakietu jmv wywołuje w EFA funkcje pakietu psych na macierzy korelacji Pearsona, a w CFA buduje model w lavaan. Wynik CFA zawiera nawet składnię lavaan użytą do dopasowania (The jamovi project, b.d.-b).
Ten wpis to instrukcja obsługi na jednym przykładzie. Teorię, czyli wybór między EFA, CFA i PCA, metody ekstrakcji i rotacje, omawia przewodnik analiza czynnikowa EFA i CFA. Jeśli dopiero zaczynasz pracę z programem, przejdź najpierw przez jamovi krok po kroku.
Przykład: skala stresu akademickiego w pracy magisterskiej
Załóżmy, że w pracy magisterskiej używasz 12-pozycyjnej skali stresu akademickiego z odpowiedziami od 1 do 5 na skali Likerta. Autorzy opisują trzy podskale po cztery pozycje: obciążenie nauką (ob1–ob4), presję ocen (pr1–pr4) i obawy o przyszłość (op1–op4). Ankietę wypełniło 420 osób studiujących. Średnie pozycji wynoszą od 3.05 do 3.13, a odchylenia standardowe od 1.03 do 1.13. Dane są symulowane. Możesz je pobrać jako plik CSV i otworzyć w jamovi.
Plan jest prosty: EFA na jednej połowie próby, CFA na drugiej. Plik ma już kolumnę probka z losowym podziałem na dwie grupy po 210 osób. Losowanie zrób przed obejrzeniem wyników. Połowę A wybierzesz filtrem: w zakładce Data kliknij Filters i wpisz probka == 'A'. Wiersze wyłączone z analizy jamovi oznaczy krzyżykiem, ale ich nie usunie (The jamovi project, b.d.-d). Do CFA zmienisz filtr na probka == 'B'.
Krok 1. Ustaw EFA: liczba czynników, ekstrakcja, rotacja
Otwórz Factor → Exploratory Factor Analysis i przenieś 12 pozycji do listy zmiennych. Dokumentacja funkcji efa opisuje te opcje i ich ustawienia domyślne (The jamovi project, b.d.-c):
| Opcja (wg dokumentacji) | Domyślnie | Co wybrać i dlaczego |
|---|---|---|
| Liczba czynników: parallel analysis, wartość własna albo liczba ustalona | analiza równoległa | Zostaw analizę równoległą. Wynik sprawdź rozwiązaniami z liczbą czynników o jeden mniejszą i o jeden większą. |
| Ekstrakcja: minimum residual, maximum likelihood, principal axis | minimum residual | Minimum residual albo osie główne przy pozycjach Likerta. ML daje dodatkowo test dopasowania. |
| Rotacja: none, varimax, quartimax, promax, oblimin, simplimax | oblimin | Rotacja ukośna (oblimin), bo wymiary stresu mogą korelować. |
| Ukrywanie ładunków poniżej progu | 0.3 | Na etapie oceny pozycji ustaw 0, a do tabeli w pracy wróć do .30. |
| KMO, test sferyczności Bartletta, wykres osypiska, korelacje czynników, podsumowanie czynników, dopasowanie modelu | wyłączone | Zaznacz wszystkie. Każdą z tych informacji podasz w opisie wyników. |
Fabrigar i in. (1999) pokazują, że każda z tych decyzji wpływa na wynik, a w przeglądzie publikacji badacze rutynowo wybierali rozwiązania wątpliwe. Ustawienia domyślne jamovi są rozsądnym punktem wyjścia, ale każdą decyzję i tak opisz w pracy.
Krok 2. Przeczytaj wynik EFA
Czy dane nadają się do analizy?
W tabeli KMO Measure of Sampling Adequacy ogólne MSA wynosi .81, a dla pojedynczych pozycji od .72 do .89. Bartlett’s Test of Sphericity daje χ²(66) = 702.49, p < .001. Oba wskaźniki opisuje hasło KMO i test sferyczności Bartletta. Test Bartletta przy setkach osób prawie zawsze wychodzi istotny, więc więcej mówi KMO.
Ile czynników?
Analiza równoległa wskazała trzy czynniki. Hayton i in. (2004) pokazują, że to jedna z najtrafniejszych metod ustalania liczby czynników. W tabeli Initial Eigenvalues trzy pierwsze wartości wynoszą 3.10, 1.27 i 0.43, a czwarta tylko 0.08. Uwaga: jamovi podaje tu wartości własne zredukowanej macierzy korelacji, a nie wartości z PCA. Dlatego trzecia jest mniejsza od 1, a kolejne bywają ujemne. Nie stosuj do nich kryterium „wartość własna > 1”. Wykres osypiska traktuj jako uzupełnienie.
Ładunki i pozycje problematyczne
W tabeli Factor Loadings każda pozycja ma jeden widoczny ładunek na swoim czynniku: od .49 do .73 dla obciążenia nauką, od .51 do .75 dla presji ocen i od .62 do .72 dla obaw o przyszłość. Kolumna Uniqueness to wariancja niewyjaśniona przez czynniki, czyli 1 minus wspólność. Tabela wygląda czysto, ale przy domyślnym progu 0.3 jamovi ukrywa część ładunków. Rysunek 1 pokazuje pełną macierz ładunków.
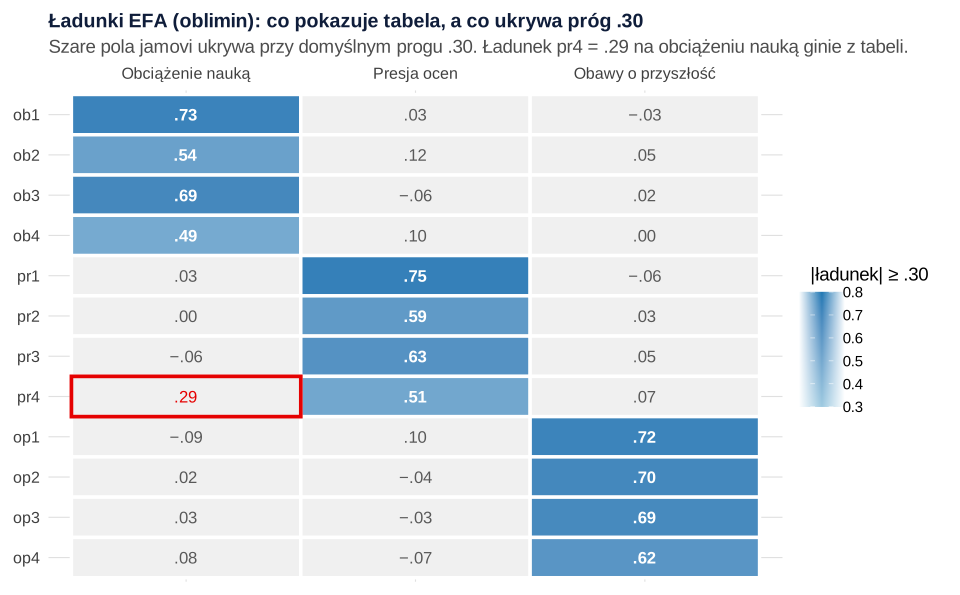
Pozycja pr4 ma ładunek .51 na presji ocen i .29 na obciążeniu nauką. Przy progu .30 ten drugi ładunek znika z tabeli. Ślad zostaje jednak w kolumnie Uniqueness: dla pr4 wynosi .45, a dla pr2 i pr3 .65 i .63. Pozycja ma więc sporo wspólnej wariancji, której nie wyjaśnia sama presja ocen. Zanim uznasz strukturę za prostą, obejrzyj ładunki bez ukrywania.
Korelacje czynników (Inter-Factor Correlations) wynoszą .61 między obciążeniem a presją oraz .22 i .19 między obawami o przyszłość a dwoma pozostałymi czynnikami. Przy korelacji .61 varimax byłby złym wyborem. Trzy czynniki wyjaśniają łącznie 45.0% wariancji pozycji. Dopasowanie modelu EFA jest dobre: RMSEA = .041, 90% CI [.000, .070], TLI = .963, χ²(33) = 44.80, p = .083.
Krok 3. Sprawdź strukturę w CFA na drugiej połowie próby
Zmień filtr na probka == 'B' i otwórz Confirmatory Factor Analysis. Utwórz trzy czynniki i do każdego przypisz jego cztery pozycje. Bez ładunków krzyżowych, bo właśnie to ma sprawdzić CFA. Domyślnie braki danych są obsługiwane metodą FIML, a model identyfikowany przez ustalenie wariancji czynników na 1. Do wyboru są wskaźniki CFI, TLI, SRMR, RMSEA, AIC i BIC, a także indeksy modyfikacji i reszty macierzy korelacji (The jamovi project, b.d.-b). Zaznacz SRMR, wartości standaryzowane i indeksy modyfikacji. Dokumentacja nie przewiduje wyboru estymatora, a kod funkcji używa domyślnej w lavaan metody największej wiarygodności (ML).
| Wskaźnik | Wynik (próba B, n = 210) | Orientacyjny punkt odniesienia |
|---|---|---|
| χ² (Test for Exact Fit) | χ²(51) = 64.37, p = .099 | przy dużych próbach prawie zawsze istotny |
| CFI / TLI | .972 / .964 | ok. .95 |
| SRMR | .049 | ok. .08 |
| RMSEA [90% CI] | .035 [.000, .060] | ok. .06 |
Punkty odniesienia pochodzą z symulacji Hu i Bentlera (1999), którzy zalecają też raportowanie dwóch wskaźników razem. Traktuj je jako orientację, a nie sztywne progi. Model trzech czynników jest dobrze dopasowany.
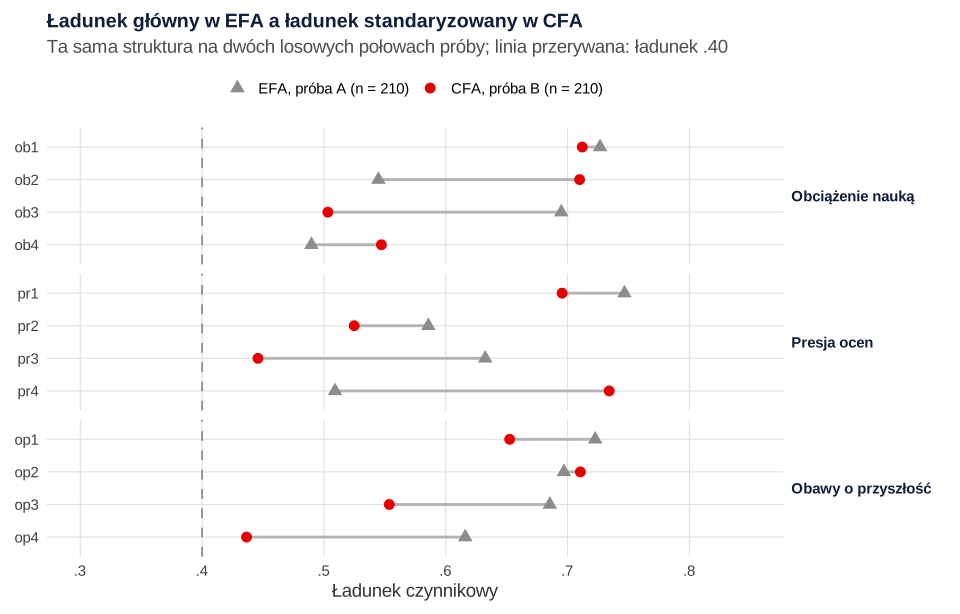
Standaryzowane ładunki wynoszą od .44 (op4) do .73 (pr4). Obciążenie nauką koreluje z presją ocen na poziomie .64, presja z obawami o przyszłość na poziomie .38 (p < .001), a obciążenie z obawami tylko na poziomie .14 (p = .154). Największy indeks modyfikacji dla ładunków dotyczy znów pr4 na obciążeniu nauką: MI = 9.72, oczekiwana zmiana standaryzowana .39. Ten sam sygnał wyszedł więc w dwóch niezależnych połowach próby. W CFA bez ładunku krzyżowego wspólna wariancja pr4 z obciążeniem przechodzi na ładunek tej pozycji na presji ocen. Dlatego ładunek pr4 rośnie z .51 w EFA do .73 w CFA (rysunek 2).
Co zrobić z pr4? Nie dopisuj ładunku krzyżowego tylko dlatego, że MI przekracza 3.84. Taki model trzeba by potwierdzić na kolejnych danych. W pracy dyplomowej z gotową skalą zostaw model autorów. W dyskusji napisz, że pr4 wiąże się także z obciążeniem nauką, i zaproponuj sprawdzenie treści tej pozycji.
Krok 4. Rzetelność podskal
W Factor → Reliability Analysis dodaj pozycje jednej podskali i zaznacz alfę Cronbacha oraz omegę McDonalda. W razie potrzeby zaznacz też wartości po usunięciu pozycji i korelacje pozycja–reszta skali. Pozycje odwrócone możesz wskazać bezpośrednio w tej analizie (The jamovi project, b.d.-f). Na próbie B wyszło:
| Podskala | M | SD | α | ω |
|---|---|---|---|---|
| Obciążenie nauką | 3.07 | 0.80 | .71 | .72 |
| Presja ocen | 3.05 | 0.76 | .70 | .71 |
| Obawy o przyszłość | 3.08 | 0.73 | .67 | .68 |
Przy czterech pozycjach o ładunkach .44–.73 takie wartości są typowe. Kiedy alfa wystarcza i jak ją raportować, omawia wpis alfa Cronbacha – rzetelność skali.
Czego jamovi w analizie czynnikowej nie zrobi
- Brak korelacji polichorycznych. EFA w jamovi liczy korelacje Pearsona, a CFA używa estymatora ML. Przy pięciu kategoriach i w miarę symetrycznych odpowiedziach to zwykle akceptowalne przybliżenie. Przy trzech–czterech kategoriach albo silnie skośnych odpowiedziach przejdź do R i użyj korelacji polichorycznych z odpornym estymatorem WLS. Flora i Curran (2004) pokazali, że to podejście sprawdza się w różnych warunkach.
- Złożone modele CFA z ładunkami krzyżowymi, czynnikiem ogólnym albo ograniczeniami parametrów wygodniej zbudujesz w lavaan, z którego jamovi i tak korzysta.
- Brak przedziałów ufności dla omegi i analizy inwariancji pomiaru w opisanych w dokumentacji opcjach. Jeśli porównujesz grupy, potrzebujesz procedury z poradnika inwariancja pomiaru krok po kroku.
Pełną ścieżkę walidacji, od pozycji do trafności, opisuje wpis jak zbudować i zwalidować skalę psychometryczną.
Jak opisać wyniki w pracy
Ładunki EFA podaj w tabeli według wzoru tabeli analizy czynnikowej w APA, a dopasowanie CFA według tabeli dopasowania modelu. Tekst może wyglądać tak:
Jeśli nie wiesz, jak potraktować pozycję podobną do pr4 albo jak dobrać estymator do swojej skali, możesz omówić analizę ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki i decyzje musisz jednak rozumieć i umieć obronić samodzielnie.
Analiza czynnikowa w R: te same funkcje, których używa jamovi
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Funkcje efa(), cfa() i reliability() pochodzą z pakietu jmv, więc ich wynik odpowiada tabelom jamovi. Różni się tylko liczbą miejsc po przecinku. Uruchom przepisy po kolei w jednej sesji R. Przepis 1 zapisuje plik CSV do pobrania.
1. Dane i EFA przez jmv::efa()
R
# Analiza czynnikowa w jamovi – przepis 1: dane i EFA przez jmv (te same funkcje co w jamovi)
# Dane symulowane, set.seed(1170): 420 osób studiujących, 12 pozycji skali stresu akademickiego (1–5)
# Trzy podskale: obciążenie nauką (ob1–ob4), presja ocen (pr1–pr4), obawy o przyszłość (op1–op4)
suppressPackageStartupMessages({ library(jmv); library(psych); library(GPArotation) })
set.seed(1170)
n <- 420
Phi <- matrix(c(1, .45, .30,
                .45, 1, .35,
                .30, .35, 1), 3)
Fz <- MASS::mvrnorm(n, rep(0, 3), Phi)
L <- matrix(0, 12, 3)
L[1:4, 1]  <- c(.75, .70, .65, .60)
L[5:8, 2]  <- c(.72, .68, .62, .40)
L[8, 1]    <- .45                       # pr4 ładuje też obciążenie nauką
L[9:12, 3] <- c(.74, .70, .66, .58)
X <- Fz %*% t(L) + matrix(rnorm(n * 12), n) %*% diag(sqrt(pmax(.2, 1 - rowSums((L %*% Phi) * L))))
progi <- c(-1.4, -0.5, 0.4, 1.3)
dane <- as.data.frame(apply(X, 2, function(x) findInterval(x, progi) + 1))
names(dane) <- c(paste0("ob", 1:4), paste0("pr", 1:4), paste0("op", 1:4))
dane$probka <- sample(rep(c("A", "B"), each = n / 2))   # losowy podział: A – EFA, B – CFA
write.csv(dane, "../analiza-czynnikowa-w-jamovi-dane.csv", row.names = FALSE)

A <- dane[dane$probka == "A", 1:12]
B <- dane[dane$probka == "B", 1:12]
sapply(dane[1:12], function(x) round(c(M = mean(x), SD = sd(x)), 2))
table(dane$probka)

# EFA w jamovi = jmv::efa(); ustawienia jak w oknie analizy
efa3 <- jmv::efa(A, vars = names(A), nFactorMethod = "parallel", extraction = "minres", rotation = "oblimin",
            hideLoadings = 0.3, sortLoadings = TRUE, screePlot = FALSE, eigen = TRUE, factorCor = TRUE,
            factorSummary = TRUE, modelFit = TRUE, kmo = TRUE, bartlett = TRUE)
efa3

# Ta sama EFA w pakiecie psych – jmv liczy ją na korelacjach Pearsona
fa3 <- fa(cor(A), nfactors = 3, n.obs = nrow(A), fm = "minres", rotate = "oblimin")
print(fa3$loadings, cutoff = 0.3, digits = 3)
round(fa3$Phi, 2)
round(unclass(fa3$loadings)["pr4", ], 2)   # pełny wiersz pr4, bez ukrywania ładunków
round(KMO(A)$MSA, 2)
Wynik w R
    ob1  ob2 ob3  ob4  pr1  pr2  pr3  pr4  op1  op2  op3  op4
M  3.05 3.07 3.1 3.12 3.11 3.07 3.05 3.09 3.09 3.13 3.05 3.09
SD 1.09 1.08 1.1 1.06 1.07 1.06 1.10 1.05 1.09 1.08 1.03 1.13

  A   B
210 210

 EXPLORATORY FACTOR ANALYSIS

 Factor Loadings
 ────────────────────────────────────────────────────────────
          1            2            3            Uniqueness
 ────────────────────────────────────────────────────────────
   op1    0.7226533                               0.4717924
   op2    0.6969760                               0.5170135
   op3    0.6854465                               0.5266125
   op4    0.6160092                               0.6117898
   ob1                 0.7266708                  0.4543768
   ob3                 0.6948157                  0.5617156
   ob2                 0.5446881                  0.5971246
   ob4                 0.4897261                  0.6881574
   pr1                              0.7467052     0.4309532
   pr3                              0.6323886     0.6314711
   pr2                              0.5857185     0.6495456
   pr4                              0.5091003     0.4539501
 ────────────────────────────────────────────────────────────
   Note. 'Minimum residual' extraction method was used in
   combination with a 'oblimin' rotation


 FACTOR STATISTICS

 Summary
 ──────────────────────────────────────────────────────────
   Factor    SS Loadings    % of Variance    Cumulative %
 ──────────────────────────────────────────────────────────
   1            1.891864         15.76553        15.76553
   2            1.781960         14.84967        30.61520
   3            1.731674         14.43061        45.04581
 ──────────────────────────────────────────────────────────


 Inter-Factor Correlations
 ────────────────────────────────────
        1    2            3
 ────────────────────────────────────
   1    —    0.2217746    0.1892921
   2                 —    0.6067776
   3                              —
 ────────────────────────────────────


 MODEL FIT

 Model Fit Measures
 ─────────────────────────────────────────────────────────────────────────────────────────────────
   RMSEA         Lower       Upper         TLI          BIC          χ²          df    p
 ─────────────────────────────────────────────────────────────────────────────────────────────────
   0.04098530    0.000000    0.06961916    0.9625201    -131.6557    44.79887    33    0.0825297
 ─────────────────────────────────────────────────────────────────────────────────────────────────


 ASSUMPTION CHECKS

 Bartlett's Test of Sphericity
 ────────────────────────────────
   χ²          df    p
 ────────────────────────────────
   702.4916    66    < .0000001
 ────────────────────────────────


 KMO Measure of Sampling Adequacy
 ────────────────────────────────
              MSA
 ────────────────────────────────
   Overall    0.8142624
   ob1        0.8329538
   ob2        0.8492749
   ob3        0.8172845
   ob4        0.8929338
   pr1        0.8186790
   pr2        0.8278300
   pr3        0.8672395
   pr4        0.8556051
   op1        0.7537226
   op2        0.7373603
   op3        0.7704670
   op4        0.7211769
 ────────────────────────────────


 EIGENVALUES

 Initial Eigenvalues
 ─────────────────────────
   Factor    Eigenvalue
 ─────────────────────────
   1          3.09766750
   2          1.27027362
   3          0.42781610
   4          0.07880541
   5          0.02600791
   6         -0.05491468
   7         -0.13166882
   8         -0.17543632
   9         -0.24159343
   10        -0.30551937
   11        -0.37145599
   12        -0.52231484
 ─────────────────────────


Loadings:
    MR2    MR1    MR3
ob1         0.727
ob2         0.545
ob3         0.695
ob4         0.490
pr1                0.747
pr2                0.586
pr3                0.632
pr4                0.509
op1  0.723
op2  0.697
op3  0.685
op4  0.616

                 MR2   MR1   MR3
SS loadings    1.873 1.649 1.606
Proportion Var 0.156 0.137 0.134
Cumulative Var 0.156 0.294 0.427
     MR2  MR1  MR3
MR2 1.00 0.22 0.19
MR1 0.22 1.00 0.61
MR3 0.19 0.61 1.00
 MR2  MR1  MR3
0.07 0.29 0.51
[1] 0.81
2. CFA przez jmv::cfa(), lavaan i rzetelność
R
# Analiza czynnikowa w jamovi – przepis 2: CFA na próbie B i rzetelność (uruchom po przepisie 1)
# jmv::cfa() buduje model w lavaan (ML, braki: FIML, wariancje czynników = 1)
modele <- list(list(label = "Obciazenie", vars = c("ob1", "ob2", "ob3", "ob4")),
               list(label = "Presja", vars = c("pr1", "pr2", "pr3", "pr4")),
               list(label = "Przyszlosc", vars = c("op1", "op2", "op3", "op4")))
cfa3 <- jmv::cfa(data = B, factors = modele, resCov = NULL, stdEst = TRUE, ci = FALSE,
            fitMeasures = c("cfi", "tli", "srmr", "rmsea"), mi = TRUE, hlMI = 3)
cfa3$factorLoadings
cfa3$factorEst$factorCov
cfa3$modelFit
cfa3$modelPerformance$modIndices$factorLoadingsMod   # indeksy modyfikacji dla ładunków

# To samo bezpośrednio w lavaan
suppressPackageStartupMessages(library(lavaan))
m <- "Obciazenie =~ ob1 + ob2 + ob3 + ob4
      Presja =~ pr1 + pr2 + pr3 + pr4
      Przyszlosc =~ op1 + op2 + op3 + op4"
fit <- lavaan::cfa(m, data = B, std.lv = TRUE, missing = "fiml", meanstructure = TRUE)
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "srmr")), 3)
mi_l <- modindices(fit, sort. = TRUE)
print(head(mi_l[mi_l$op == "=~", c("lhs", "op", "rhs", "mi", "sepc.all")], 3), digits = 3)

# Rzetelność podskal w jamovi = jmv::reliability() (alfa i omega), na próbie B
for (czynnik in modele) print(jmv::reliability(B, vars = czynnik$vars, alphaScale = TRUE, omegaScale = TRUE, meanScale = TRUE, sdScale = TRUE))
Wynik w R
 Factor Loadings
 ────────────────────────────────────────────────────────────────────────────────────────────────────
   Factor        Indicator    Estimate     SE            Z            p             Stand. Estimate
 ────────────────────────────────────────────────────────────────────────────────────────────────────
   Obciazenie    ob1          0.7907150    0.07846910    10.076770    < .0000001          0.7120584
                 ob2          0.7706945    0.07687262    10.025605    < .0000001          0.7098774
                 ob3          0.5582339    0.08260106     6.758193    < .0000001          0.5032220
                 ob4          0.5671761    0.07622435     7.440878    < .0000001          0.5471861
   Presja        pr1          0.7528046    0.07707312     9.767409    < .0000001          0.6955098
                 pr2          0.5309935    0.07547746     7.035127    < .0000001          0.5248352
                 pr3          0.4761738    0.08138761     5.850692    < .0000001          0.4458624
                 pr4          0.7595420    0.07363419    10.315072    < .0000001          0.7341679
   Przyszlosc    op1          0.6724565    0.08268699     8.132555    < .0000001          0.6524640
                 op2          0.7453887    0.08421617     8.850897    < .0000001          0.7105098
                 op3          0.5401852    0.07586912     7.119962    < .0000001          0.5536306
                 op4          0.4670547    0.08440853     5.533264    < .0000001          0.4364741
 ────────────────────────────────────────────────────────────────────────────────────────────────────


 Factor Covariances
 ──────────────────────────────────────────────────────────────────────────────────────────────────────
                               Estimate       SE            Z           p             Stand. Estimate
 ──────────────────────────────────────────────────────────────────────────────────────────────────────
   Obciazenie    Obciazenie    1.0000000 ᵃ
                 Presja        0.6430758      0.06995462    9.192756    < .0000001          0.6430758
                 Przyszlosc    0.1362628      0.09566397    1.424390     0.1543336          0.1362628
   Presja        Presja        1.0000000 ᵃ
                 Przyszlosc    0.3752971      0.08729926    4.298973     0.0000172          0.3752971
   Przyszlosc    Przyszlosc    1.0000000 ᵃ
 ──────────────────────────────────────────────────────────────────────────────────────────────────────
   ᵃ fixed parameter


 MODEL FIT

 Test for Exact Fit
 ───────────────────────────────
   χ²          df    p
 ───────────────────────────────
   64.37474    51    0.0988237
 ───────────────────────────────


 Fit Measures
 ────────────────────────────────────────────────────────────────────────────────
   CFI          TLI          SRMR          RMSEA         Lower       Upper
 ────────────────────────────────────────────────────────────────────────────────
   0.9723346    0.9641977    0.04902096    0.03533849    0.000000    0.05959564
 ────────────────────────────────────────────────────────────────────────────────


 Factor Loadings – Modification Indices
 ──────────────────────────────────────────────────
          Obciazenie    Presja         Przyszlosc
 ──────────────────────────────────────────────────
   ob1                  0.912354205    0.83578416
   ob2                  1.714588673    0.65201620
   ob3                  0.187272165    0.10886087
   ob4                  0.001491834    0.02379681
   pr1    3.45343049                   0.56296774
   pr2    2.20053192                   0.48579015
   pr3    0.06522337                   1.90123658
   pr4    9.71701106                   0.16122389
   op1    2.38135451    0.125468836
   op2    0.79594327    0.005045149
   op3    2.55024185    2.129115227
   op4    1.36254348    1.529694294
 ──────────────────────────────────────────────────

         chisq             df         pvalue            cfi            tli          rmsea rmsea.ci.lower
        64.375         51.000          0.099          0.972          0.964          0.035          0.000
rmsea.ci.upper           srmr
         0.060          0.049
          lhs op rhs   mi sepc.all
49 Obciazenie =~ pr4 9.72    0.386
46 Obciazenie =~ pr1 3.45   -0.223
52 Obciazenie =~ op3 2.55   -0.119

 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ──────────────────────────────────────────────────────────────────
            Mean        SD           Cronbach's α    McDonald's ω
 ──────────────────────────────────────────────────────────────────
   scale    3.072619    0.7975892       0.7124916       0.7165693
 ──────────────────────────────────────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ──────────────────────────────────────────────────────────────────
            Mean        SD           Cronbach's α    McDonald's ω
 ──────────────────────────────────────────────────────────────────
   scale    3.053571    0.7638978       0.7011091       0.7054027
 ──────────────────────────────────────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ──────────────────────────────────────────────────────────────────
            Mean        SD           Cronbach's α    McDonald's ω
 ──────────────────────────────────────────────────────────────────
   scale    3.080952    0.7336701       0.6706808       0.6811430
 ──────────────────────────────────────────────────────────────────
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet jmv w wersji używanej przez jamovi do analiz EFA, CFA i rzetelności); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo pakietów, których faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]. https://doi.org/10.32614/CRAN.package.jmv
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w analizie czynnikowej w jamovi
- PCA zamiast EFA, bo „to ta sama analiza”. W jamovi to dwie osobne analizy o innym celu.
- Kryterium „wartość własna > 1” stosowane do tabeli Initial Eigenvalues z EFA, która podaje wartości zredukowanej macierzy.
- Ocena pozycji tylko w tabeli z ukrytymi ładunkami. Ładunek .29 nie jest zerem.
- EFA i CFA na tych samych osobach przedstawione jako potwierdzenie struktury.
- Dopisywanie ładunków i kowariancji reszt według indeksów modyfikacji bez uzasadnienia treściowego i bez nowej próby.
- Przepisywanie p z wydruku jamovi w postaci „< .0000001” albo z siedmioma miejscami po przecinku. W pracy podaj „p < .001” i wskaźniki z dwiema lub trzema cyframi.
Najczęstsze pytania
Gdzie w jamovi jest analiza czynnikowa?
W zakładce Factor. Są tam Exploratory Factor Analysis, Confirmatory Factor Analysis, Principal Component Analysis i Reliability Analysis. Do opisu wymiarów kwestionariusza wybierz EFA, a nie PCA, bo jamovi rozdziela te metody.
Dlaczego jamovi ukrywa część ładunków czynnikowych?
Domyślnie analiza EFA nie pokazuje ładunków poniżej 0.3, żeby tabela była czytelna. Przy ocenie pozycji ustaw ten próg na 0, bo ładunek krzyżowy .29 też jest informacją. W tabeli do pracy możesz wrócić do progu .30 i zaznaczyć to w nocie.
Czy jamovi liczy korelacje polichoryczne w analizie czynnikowej?
Nie. Pakiet jmv, na którym działa jamovi, liczy EFA na korelacjach Pearsona, a CFA estymatorem największej wiarygodności. Przy pięciu w miarę symetrycznych kategoriach to zwykle wystarcza. Przy mniejszej liczbie kategorii albo skośnych odpowiedziach użyj w R korelacji polichorycznych i estymatora WLSMV.
Jak przenieść analizę czynnikową z jamovi do R?
Włącz tryb składni (syntax mode) w menu ⋮. jamovi pokaże wtedy wywołania funkcji jmv::efa() albo jmv::cfa(), które skopiujesz do R i dostaniesz te same wyniki. W CFA obiekt wyniku zawiera też składnię lavaan, od której możesz zacząć bardziej złożony model.
Jak podzielić próbę na EFA i CFA w jamovi?
Najwygodniej dodać kolumnę z losowym przydziałem do połowy A lub B, zanim obejrzysz wyniki. Potem w zakładce Data użyj Filters z warunkiem w rodzaju probka == 'A' dla EFA i zmień go na B przed CFA. Filtr wyłącza wiersze z analizy, ale ich nie usuwa.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Poradnikjamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Analiza czynnikowa nie chce wyjść tak jak u autorów skali?
Sprawdzimy ustawienia EFA i CFA na Twoich danych, wyjaśnimy problematyczne pozycje i pomożemy opisać decyzje tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Flora, D. B., & Curran, P. J. (2004). An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data. Psychological Methods, 9(4), 466–491. https://doi.org/10.1037/1082-989X.9.4.466 ● Otwarty dostęp: pełny tekst
- Hayton, J. C., Allen, D. G., & Scarpello, V. (2004). Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis. Organizational Research Methods, 7(2), 191–205. https://doi.org/10.1177/1094428104263675 ● Otwarty dostęp: pełny tekst
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- The jamovi project. (b.d.-a). Comparison of which analyses are available in SPSS and jamovi. jamovi documentation. https://docs.jamovi.org/spss2jamovi/s2j_Comparison_of_analyses.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). Confirmatory Factor Analysis. jamovi documentation. https://docs.jamovi.org/jmv/jmv_cfa.html ● Otwarty dostęp
- The jamovi project. (b.d.-c). Exploratory Factor Analysis (efa). jamovi documentation. https://docs.jamovi.org/jmv/jmv_efa.html ● Otwarty dostęp
- The jamovi project. (b.d.-d). Filtering data. jamovi documentation. https://docs.jamovi.org/data/data_6_filtering_data.html ● Otwarty dostęp
- The jamovi project. (b.d.-e). The jmv R package. jamovi documentation. https://docs.jamovi.org/jmv/jmv_overview.html ● Otwarty dostęp
- The jamovi project. (b.d.-f). Reliability Analysis (reliability). jamovi documentation. https://docs.jamovi.org/jmv/jmv_reliability.html ● Otwarty dostęp
Cytowania BibTeX
@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{flora2004empirical, author={Flora, David B. and Curran, Patrick J.}, title={{An empirical evaluation of alternative methods of estimation for confirmatory factor analysis with ordinal data}}, journal={Psychological Methods}, year={2004}, volume={9}, number={4}, pages={466--491}, doi={10.1037/1082-989x.9.4.466}}@article{hayton2004factor, author={Hayton, James C. and Allen, David G. and Scarpello, Vida}, title={{Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={2}, pages={191--205}, doi={10.1177/1094428104263675}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@misc{jamovindporownanieanaliz, author={{The jamovi project}}, title={{Comparison of which analyses are available in SPSS and jamovi}}, howpublished={jamovi documentation}, year={b.d.-a}, publisher={The jamovi project}, url={https://docs.jamovi.org/spss2jamovi/s2j_Comparison_of_analyses.html}}@misc{jamovindjmvcfa, author={{The jamovi project}}, title={{Confirmatory Factor Analysis}}, howpublished={jamovi documentation}, year={b.d.-b}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_cfa.html}}@misc{jamovindjmvefa, author={{The jamovi project}}, title={{Exploratory Factor Analysis (efa)}}, howpublished={jamovi documentation}, year={b.d.-c}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_efa.html}}@misc{jamovindfiltry, author={{The jamovi project}}, title={{Filtering data}}, howpublished={jamovi documentation}, year={b.d.-d}, publisher={The jamovi project}, url={https://docs.jamovi.org/data/data_6_filtering_data.html}}@misc{jamovindjmvpakiet, author={{The jamovi project}}, title={{The jmv R package}}, howpublished={jamovi documentation}, year={b.d.-e}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_overview.html}}@misc{jamovindjmvreliability, author={{The jamovi project}}, title={{Reliability Analysis (reliability)}}, howpublished={jamovi documentation}, year={b.d.-f}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_reliability.html}}