Co to jest analiza równoległa?
Analiza równoległa (ang. parallel analysis, PA) to metoda ustalania liczby czynników w eksploracyjnej analizie czynnikowej i liczby składowych w analizie głównych składowych. Zatrzymuje się tyle czynników, ile wartości własnych z danych przekracza wartości własne uzyskane z danych losowych o tej samej liczbie osób i zmiennych. Metodę zaproponował Horn (1965): od wartości własnych odejmuje się część przypisywaną błędowi losowania, oszacowaną na podstawie wartości własnych z wygenerowanych danych losowych.
Hayton i in. (2004) w przewodniku krok po kroku podsumowują dowody, że analiza równoległa należy do najtrafniejszych metod decyzji o liczbie czynników, a zarazem do najrzadziej stosowanych. Częściej spotyka się kryterium Kaisera i wykres osypiska – hasło o wykresie osypiska pokazuje analizę równoległą na prawdziwych danych ankietowych. Tutaj wyjaśniamy, skąd biorą się jej progi i jak wybrać między średnią a 95. centylem.
Skąd biorą się progi?
Gdyby zmienne były zupełnie niezależne, w populacji wszystkie wartości własne ich macierzy korelacji wynosiłyby 1. W próbie tak nie jest: przez błąd losowania pierwsze wartości własne wychodzą większe od 1, a ostatnie mniejsze – tym bardziej, im mniejsza próba i im więcej zmiennych. Kryterium Kaisera tego nie uwzględnia, więc w małych próbach zatrzymuje „czynniki” zbudowane z szumu. Analiza równoległa zastępuje stały próg 1 progami wyznaczonymi z danych losowych:
- Policz wartości własne macierzy korelacji z danych.
- Wygeneruj wiele losowych zbiorów (np. 1000) o tej samej liczbie osób i zmiennych i policz ich wartości własne. Dinno (2009) pokazał, że wynik nie zależy od rozkładu danych losowych, więc wystarczy zwykły rozkład normalny.
- Dla każdej pozycji – pierwszej, drugiej, trzeciej wartości własnej – wyznacz próg: średnią albo 95. centyl z danych losowych.
- Zatrzymaj tyle czynników, ile kolejnych wartości własnych przekracza swoje progi; zakończ na pierwszej, która progu nie przekracza.
Średnia czy 95. centyl?
Najprostszy próg to średnia z danych losowych. Często używa się też 95. centyla: czynnik zostaje tylko wtedy, gdy jego wartość własna przewyższa 95% wartości uzyskanych przez przypadek. Taki próg rzadziej przepuszcza czynnik z szumu, ale łatwiej gubi czynnik słaby, o niskich ładunkach. Różnica jest zwykle niewielka – w przykładzie poniżej obie wersje dają ten sam wynik – ale zawsze napisz, który próg przyjęto.
Uwaga na pakiet psych. W wersji 2.6.5 decyzja wypisywana przez fa.parallel() opiera się na 95. centylu (argument quant), ale linie na wykresie i zwracane wektory z wynikami symulacji to średnie. Jeśli raportujesz progi, policz centyle z macierzy values – tak jak w kodzie na tej stronie.
Składowe główne czy czynniki?
Analizę równoległą można prowadzić na dwóch rodzajach wartości własnych. W wersji dla składowych głównych liczy się je z pełnej macierzy korelacji (z jedynkami na przekątnej), więc sumują się do liczby zmiennych. W wersji dla czynników – z macierzy zredukowanej, w której na przekątnej stoją zasoby zmienności wspólnej; takie wartości są mniejsze, a progi z danych losowych leżą blisko zera. Obie wersje mogą dać różne odpowiedzi. Lim i Jahng (2019) porównali w symulacji 13 wariantów analizy równoległej: najlepiej wypadła zwykle tradycyjna wersja na pełnych macierzach korelacji, ale jej trafność spadała przy niskich ładunkach i silnie skorelowanych czynnikach. Zalecają więc traktować wynik jako przybliżony i rozważać także rozwiązania o jeden czynnik mniejsze i większe.
Przykład: skala wypalenia studenckiego
Stu pięćdziesięciu studentów odpowiedziało na 12 pozycji skali wypalenia (1–5) – po cztery pozycje dla wyczerpania (W1–W4), cynizmu (C1–C4) i poczucia braku skuteczności (S1–S4). Dane są symulowane, więc prawdziwą strukturę znamy: trzy czynniki skorelowane na poziomie .30, ładunki od .45 do .75. Macierz korelacji nadawała się do analizy: KMO = .67, test sferyczności Bartletta χ²(66) = 306.10, p < .001 (zob. KMO i test Bartletta).
| Składowa | Wartość własna z danych | Próg: średnia | Próg: 95. centyl | Decyzja |
|---|---|---|---|---|
| 1 | 2.68 | 1.49 | 1.62 | zachowaj |
| 2 | 1.77 | 1.36 | 1.44 | zachowaj |
| 3 | 1.58 | 1.25 | 1.33 | zachowaj |
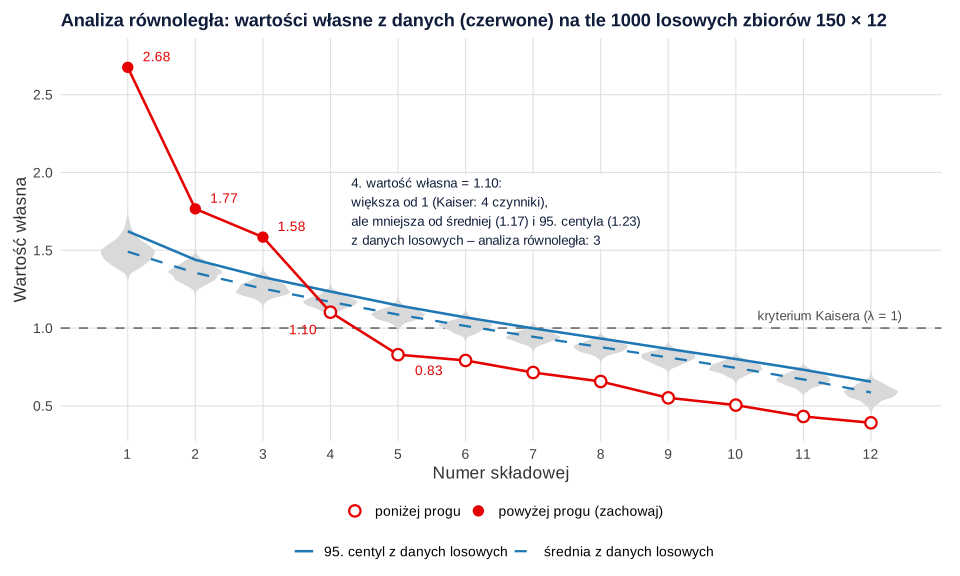
| 4 | 1.10 | 1.17 | 1.23 | odrzuć (Kaiser: zachowaj) |
| 5 | 0.83 | 1.09 | 1.15 | odrzuć |
| 6 | 0.79 | 1.01 | 1.07 | odrzuć |
Cztery wartości własne przekraczają 1, więc kryterium Kaisera wskazuje cztery czynniki. Czwarta wartość własna (1.10) jest jednak niższa zarówno od średniej (1.17), jak i od 95. centyla (1.23) z 1000 losowych zbiorów – analiza równoległa wskazuje trzy czynniki. Trzy pierwsze składowe wyjaśniają razem 50.2% wariancji. To samo wypisuje funkcja fa.parallel(): trzy składowe i trzy czynniki. W wersji czynnikowej rozstrzygnięcie jest jednak bliskie: czwarta wartość własna (0.25) ledwie nie przekracza progu (0.27). Rysunek 1 pokazuje, skąd biorą się progi: szare „skrzypce” to rozkłady wartości własnych z danych losowych.
Analiza równoległa to nie koniec. Rozwiązanie trzyczynnikowe (metoda minres, rotacja ukośna oblimin) odtworzyło zakładaną strukturę: każda pozycja miała najwyższy ładunek na swoim czynniku (od .32 do .77), a ładunki krzyżowe nie przekraczały .14. W rozwiązaniu czteroczynnikowym czwarty czynnik tworzyła jedna pozycja (S4, ładunek .82), a kryterium BIC wskazało model trzyczynnikowy (−123.85 wobec −101.97). Trzy czynniki są więc decyzją zarówno statystyczną, jak i merytoryczną.
Jak często analiza równoległa trafia? Symulacja
Jeden zbiór danych to za mało, by porównać reguły. Wygenerowaliśmy więc po 500 zbiorów z tego samego modelu trójczynnikowego dla trzech liczebności i sprawdziliśmy, ile czynników wskazuje każda reguła (rysunek 2).
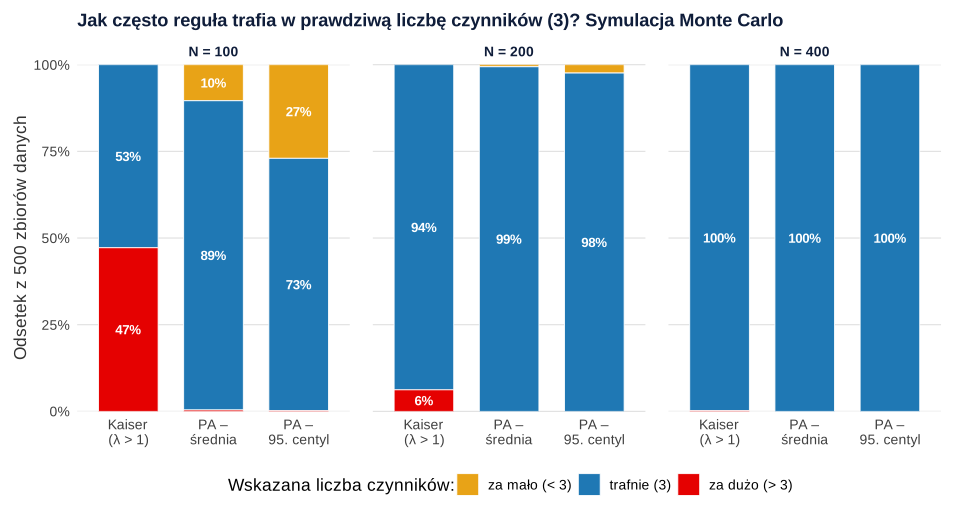
Przy N = 100 kryterium Kaisera trafiło w 52.8% zbiorów, a w 47.2% wskazało za dużo czynników. Analiza równoległa ze średnią trafiła w 89.2% zbiorów, a z 95. centylem – w 72.8%; ta druga w 27.0% zbiorów wskazała za mało czynników, bo trzeci, najsłabszy czynnik nie przebijał surowszego progu. Przy N = 200 odsetki trafień wyniosły 93.8%, 99.4% i 97.6%, a przy N = 400 – 99.8%, 100% i 100%. Wniosek zgadza się z wynikami Lim i Jahng (2019): analiza równoległa jest znacznie lepsza od reguły λ > 1, ale przy słabych czynnikach i małej próbie bywa zawodna, więc sprawdzaj rozwiązania sąsiednie.
Analiza równoległa, kryterium Kaisera i wykres osypiska
| Kryterium | Na czym polega | Wynik w przykładzie |
|---|---|---|
| Kaiser (λ > 1) | stały próg 1, bez uwzględnienia błędu losowania | 4 czynniki |
| Wykres osypiska | wzrokowa ocena „łokcia” linii wartości własnych | niejednoznaczny: największy spadek po 1. składowej, płasko od 5. |
| Analiza równoległa (składowe) | progi z danych losowych: średnia lub 95. centyl | 3 czynniki |
| Analiza równoległa (czynniki) | wartości własne macierzy zredukowanej | 3 czynniki (rozstrzygnięcie bliskie) |
| Interpretowalność rozwiązań | porównanie rozwiązań sąsiednich (3 i 4 czynniki) | 3 czynniki |
Kryterium Kaisera i wykres osypiska przydają się jako informacja pomocnicza, ale decyzję opieraj na analizie równoległej i ocenie rozwiązań – tak, jak zaleca poradnik Analiza czynnikowa EFA i CFA. Gdy liczba czynników jest już ustalona, dla każdej podskali policz rzetelność, np. omegę McDonalda, a strukturę potwierdź na nowej próbie konfirmacyjną analizą czynnikową.
Jak opisać analizę równoległą w pracy (APA)
Podaj liczbę losowych zbiorów, przyjęty próg (średnia czy 95. centyl), rodzaj wartości własnych (składowe czy czynniki), wartości własne z danych i progi oraz to, jak potwierdzono decyzję. Ładunki przedstaw w tabeli analizy czynnikowej w APA.
Taki akapit pasuje do opisu przygotowania narzędzia w rozdziale metodologicznym albo do części wyników poświęconej strukturze skali.
Przykład w R
Kod odtwarza dane z przykładu, przeprowadza analizę równoległą krok po kroku (bez pakietów) i porównuje ją z wynikiem funkcji fa.parallel() z pakietu psych. Ustaw ziarno losowania (set.seed()) i jeden rdzeń (options(mc.cores = 1)), aby wyniki dało się odtworzyć. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Analiza równoległa: ręcznie i w psych
R
library(psych); options(mc.cores = 1)
set.seed(2056)                                     # dane symulowane: 150 studentów, 12 pozycji (1–5)
L <- matrix(0, 12, 3)                              # znana struktura: 3 czynniki po 4 pozycje
L[1:4, 1] <- c(.75, .70, .65, .55); L[5:8, 2] <- c(.70, .65, .60, .50); L[9:12, 3] <- c(.65, .60, .55, .45)
Phi <- matrix(.3, 3, 3); diag(Phi) <- 1            # korelacje między czynnikami .30
F <- MASS::mvrnorm(150, rep(0, 3), Phi)
X <- F %*% t(L) + sapply(1:12, function(i) rnorm(150, 0, sqrt(1 - sum(L[i, ]^2))))
dane <- as.data.frame(apply(X, 2, function(x) as.integer(cut(x, c(-Inf, -1.5, -0.5, 0.5, 1.5, Inf)))))
names(dane) <- c(paste0("W", 1:4), paste0("C", 1:4), paste0("S", 1:4))

# Analiza równoległa krok po kroku (składowe główne): 1000 losowych zbiorów 150 × 12
lambda <- eigen(cor(dane))$values                  # wartości własne z danych
losowe <- replicate(1000, eigen(cor(matrix(rnorm(150 * 12), 150, 12)))$values)
progi <- data.frame(lambda, srednia = rowMeans(losowe), c95 = apply(losowe, 1, quantile, .95))
round(head(progi, 6), 2)
c(Kaiser = sum(lambda > 1), PA_srednia = which(lambda <= progi$srednia)[1] - 1,
  PA_c95 = which(lambda <= progi$c95)[1] - 1)

# To samo w psych: wydruk podaje decyzję, ale linie wykresu to średnie z symulacji
pa <- suppressWarnings(fa.parallel(dane, fa = "both", n.iter = 1000, plot = FALSE))
c95 <- apply(pa$values, 2, quantile, .95)          # kolumny 25–36: składowe, 37–48: czynniki (dane losowe)
round(data.frame(pc = pa$pc.values, pc_c95 = c95[25:36], fa = pa$fa.values, fa_c95 = c95[37:48],
                 row.names = 1:12)[1:5, ], 2)
Wynik w R
  lambda srednia  c95
1   2.68    1.49 1.62
2   1.77    1.36 1.44
3   1.58    1.25 1.33
4   1.10    1.17 1.23
5   0.83    1.09 1.15
6   0.79    1.01 1.07
    Kaiser PA_srednia     PA_c95
         4          3          3
Parallel analysis suggests that the number of factors =  3  and the number of components =  3
    pc pc_c95    fa fa_c95
1 2.68   1.62  1.91   1.13
2 1.77   1.44  0.88   0.48
3 1.58   1.32  0.74   0.36
4 1.10   1.23  0.25   0.27
5 0.83   1.14 -0.02   0.18
JASP i jamovi. W JASP i jamovi analiza równoległa jest jedną z opcji wyboru liczby czynników w eksploracyjnej analizie czynnikowej. W SPSS wykonuje się ją zwykle za pomocą makr lub rozszerzeń.
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://doi.org/10.32614/CRAN.package.psych
- GPArotation (wersja 2025.3-1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Samo kryterium Kaisera – w małych próbach regularnie zawyża liczbę czynników; w naszej symulacji przy N = 100 – prawie w co drugim zbiorze.
- Mieszanie wersji – wartości własne składowych porównuj z progami dla składowych, a wartości własne czynników – z progami dla czynników.
- Średnie zamiast centyli bez słowa wyjaśnienia – napisz, czy progiem była średnia, czy 95. centyl, i ile losowych zbiorów wygenerowano; pełną procedurę opisują Hayton i in. (2004).
- Analiza równoległa jako wyrok – Lim i Jahng (2019) radzą rozważyć też liczbę czynników o jeden mniejszą i większą oraz wybrać rozwiązanie najlepiej interpretowalne.
- Brak ziarna losowania – progi pochodzą z symulacji, więc bez
set.seed()przy kolejnym uruchomieniu nieco się zmienią. - Pozycje porządkowe z małą liczbą kategorii – przy kilkustopniowej skali Likerta rozważ analizę na korelacjach polichorycznych (
fa.parallel(dane, cor = "poly")).
Najczęstsze pytania
Co to jest analiza równoległa?
To metoda ustalania liczby czynników w eksploracyjnej analizie czynnikowej. Wartości własne z danych porównuje się z wartościami własnymi z wielu losowych zbiorów o tej samej liczbie osób i zmiennych i zatrzymuje tyle czynników, ile kolejnych wartości własnych przekracza wartości z danych losowych.
Czym różni się analiza równoległa od kryterium Kaisera?
Kryterium Kaisera zatrzymuje czynniki o wartości własnej większej od 1, nie uwzględniając błędu losowania – w małych próbach przypadkowe wartości własne łatwo przekraczają 1. Analiza równoległa wyznacza próg dla każdej wartości własnej z danych losowych. W przykładzie na tej stronie Kaiser wskazał 4 czynniki, a analiza równoległa – 3, zgodnie z prawdziwą strukturą danych.
Średnia czy 95. centyl w analizie równoległej?
Średnia z danych losowych to łagodniejszy próg, 95. centyl – surowszy: rzadziej zatrzymuje czynnik z szumu, ale łatwiej gubi czynnik słaby. W naszej symulacji przy N = 100 analiza ze średnią trafiała w 89.2% zbiorów, a z 95. centylem w 72.8%. Napisz w pracy, który próg przyjęto.
Jak zrobić analizę równoległą w R?
Najprościej funkcją fa.parallel() z pakietu psych, np. fa.parallel(dane, fa = "both", n.iter = 1000), po ustawieniu set.seed(). Wydruk podaje sugerowaną liczbę czynników i składowych; jeśli raportujesz progi 95. centyla, policz je z macierzy values, bo linie wykresu to średnie.
Czy analizę równoległą liczyć dla składowych głównych, czy dla czynników?
Można dla obu, ale porównuj wartości własne z progami tego samego rodzaju. W symulacji Lim i Jahng (2019) najlepiej wypadała zwykle tradycyjna wersja na pełnych macierzach korelacji, czyli dla składowych. Gdy wersje się różnią, oszacuj rozwiązania z kandydującą liczbą czynników i wybierz najlepiej interpretowalne.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Dinno, A. (2009). Exploring the sensitivity of Horn’s parallel analysis to the distributional form of random data. Multivariate Behavioral Research, 44(3), 362–388. https://doi.org/10.1080/00273170902938969 ● Otwarty dostęp: pełny tekst
- Hayton, J. C., Allen, D. G., & Scarpello, V. (2004). Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis. Organizational Research Methods, 7(2), 191–205. https://doi.org/10.1177/1094428104263675 ● Otwarty dostęp: pełny tekst
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Lim, S., & Jahng, S. (2019). Determining the number of factors using parallel analysis and its recent variants. Psychological Methods, 24(4), 452–467. https://doi.org/10.1037/met0000230
Cytowania BibTeX
@article{dinno2009exploring, author={Dinno, Alexis}, title={{Exploring the sensitivity of Horn’s parallel analysis to the distributional form of random data}}, journal={Multivariate Behavioral Research}, year={2009}, volume={44}, number={3}, pages={362--388}, doi={10.1080/00273170902938969}}@article{hayton2004factor, author={Hayton, James C. and Allen, David G. and Scarpello, Vida}, title={{Factor retention decisions in exploratory factor analysis: A tutorial on parallel analysis}}, journal={Organizational Research Methods}, year={2004}, volume={7}, number={2}, pages={191--205}, doi={10.1177/1094428104263675}}@article{horn1965rationale, author={Horn, John L.}, title={{A rationale and test for the number of factors in factor analysis}}, journal={Psychometrika}, year={1965}, volume={30}, number={2}, pages={179--185}, doi={10.1007/bf02289447}}@article{lim2019determining, author={Lim, Sangdon and Jahng, Seungmin}, title={{Determining the number of factors using parallel analysis and its recent variants}}, journal={Psychological Methods}, year={2019}, volume={24}, number={4}, pages={452--467}, doi={10.1037/met0000230}}