Co wykresy mówią o analizie czynnikowej
Wynik eksploracyjnej analizy czynnikowej to kilka tabel: wartości własne, macierz ładunków, korelacje czynników i zasoby zmienności wspólnej. Każdą z nich da się narysować, a rysunek szybciej niż tabela pokazuje trzy rzeczy:
- Ile czynników? Odpowiada wykres osypiska z progami analizy równoległej (rysunek 1).
- Która pozycja należy do którego czynnika? Odpowiada mapa cieplna ładunków i wykres ładunków przed rotacją i po niej (rysunki 2–3).
- Jak czynniki są powiązane i jak dobrze opisują pozycje? Odpowiadają wykres korelacji czynników i wykres zasobów zmienności wspólnej (rysunki 4–5).
Procedurę EFA krok po kroku opisujemy w poradniku EFA i CFA oraz we wpisach o EFA w SPSS i w jamovi, a logikę progów – w haśle analiza równoległa. Tu są rysunki, kod R i symulacja Monte Carlo: dane są fikcyjne, więc znamy prawdziwą strukturę i widzimy, co wykres oddaje wiernie. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do Wyników.
Przykład: skala nawyków uczenia się (dane symulowane)
Fikcyjna Skala Nawyków Uczenia się ma 12 pozycji z odpowiedziami 1–5 i trzy czynniki: planowanie (P1–P4), koncentracja (K1–K4) i szukanie pomocy (S1–S4). Dane 300 osób wylosowaliśmy z modelu, w którym ładunki wynoszą od .60 do .75 dla planowania i od .60 do .70 dla koncentracji, a szukanie pomocy jest czynnikiem słabszym (.45–.55). Celowo wbudowaliśmy dwie pułapki:
- K4 „Kończę zadanie, zanim zacznę kolejne” to pozycja krzyżowa: w modelu ładuje koncentrację (.45) i planowanie (.40).
- S4 „Szukam nagrań i forów” to pozycja słaba: ładunek w modelu wynosi tylko .25.
Czynniki są skorelowane: planowanie z koncentracją .40, planowanie z szukaniem pomocy .25, koncentracja z szukaniem pomocy .20. Średnie pozycji wynoszą od 3.13 do 3.28. Macierz korelacji nadaje się do analizy: KMO = .78, test sferyczności Bartletta χ²(66) = 639.93, p < .001 (zob. KMO i test Bartletta). Plik CSV pobierzesz przy pierwszym bloku kodu.
Rysunek 1: osypisko i analiza równoległa
Wykres osypiska pokazuje wartości własne macierzy korelacji w kolejności od największej. Test osypiska opisał Cattell (1966): szukasz miejsca, w którym stroma ściana przechodzi w płaskie „osypisko”, i zatrzymujesz czynniki leżące nad nim. Ocena „na oko” bywa niejednoznaczna, dlatego na ten sam wykres nanosi się progi analizy równoległej: wartości własne z danych losowych o tej samej liczbie osób i pozycji (Horn, 1965). Panel B to dodatek: osypiska 50 innych prób z tej samej populacji.
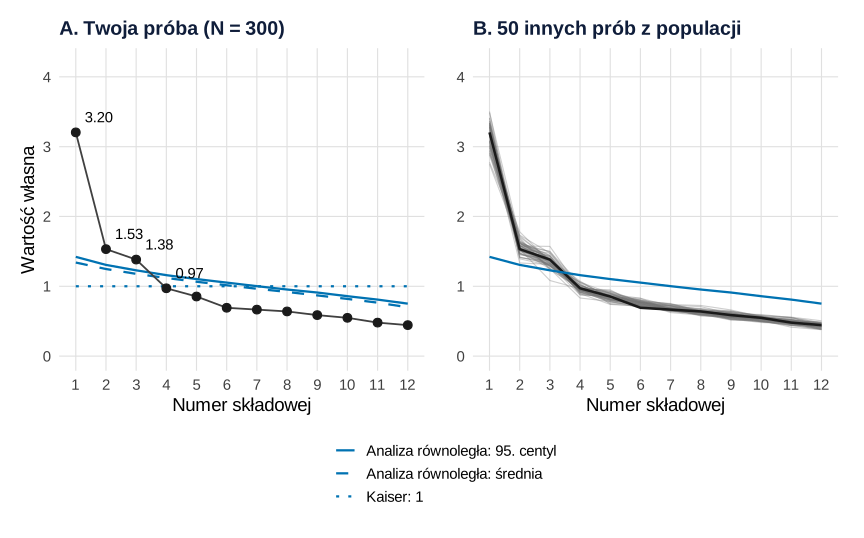
set.seed(571)).Co widać. Trzy pierwsze wartości własne (3.20, 1.53 i 1.38) leżą nad progami analizy równoległej (95. centyl: 1.42, 1.31 i 1.23), a czwarta (0.97) – pod swoim progiem (1.16). Analiza równoległa, zarówno ze średnią, jak i z 95. centylem, wskazuje trzy czynniki, a kryterium Kaisera (wartość własna > 1) w tej próbie także trzy. Panel B pokazuje, że to szczęśliwy zbieg okoliczności: w 50 innych próbach trzecia wartość własna wahała się od 1.08 do 1.57, a czwarta od 0.83 do 1.07, więc czasem przekraczała 1. W 500 próbach Monte Carlo kryterium Kaisera wskazało trzy czynniki w 74.6% prób (błąd Monte Carlo 1.9 pp), a analiza równoległa z 95. centylem – w 95.0% (błąd 1.0 pp); w pozostałych 5.0% wskazała za mało czynników, nigdy za dużo.
Czego ten wykres nie pokazuje i jak może zmylić. Osypisko w tej próbie ma dwa „łokcie”: po pierwszej i po trzeciej składowej. Kto patrzy tylko na największy spadek, wybierze jeden czynnik. Trzy wartości własne nad progiem to propozycja, którą trzeba sprawdzić w ładunkach. Lim i Jahng (2019) w symulacji pokazali, że analiza równoległa jest zawodna przy niskich ładunkach i silnie skorelowanych czynnikach, i zalecają rozważać także rozwiązania o jeden czynnik mniejsze i większe. Rysunek dotyczy składowych (pełna macierz korelacji); wersję dla czynników omawia hasło o analizie równoległej, a różnicę między podejściami – wpis PCA czy analiza czynnikowa.
Podpis do pracy (w pracy zostaw zwykle tylko panel A):
Zdanie do Wyników:
Kod rysunku 1: dane, osypisko i analiza równoległa
Pobierz plik analiza-czynnikowa-na-wykresie-dane.csv (300 osób, 12 pozycji 1–5, dane symulowane) albo wygeneruj te same dane pierwszym blokiem. Bloki uruchamiaj po kolei w jednej sesji R – kolejne korzystają z obiektów i funkcji utworzonych wcześniej (model, motyw, paleta, dopasuj()). Rysunki na tej stronie powstały dokładnie z tego kodu: motyw motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG (w kodzie – zakomentowane wywołanie ggsave()). Ziarno (571) ustalono raz, bez dobierania pod wynik; z tego samego ciągu losowego pochodzą też próby Monte Carlo.
1. Model populacyjny, dane, KMO, analiza równoległa i osypiska innych prób
R
# Rysunek 1. Wykres osypiska z analizą równoległą: fikcyjna skala 12 pozycji, N = 300 (dane symulowane)
library(ggplot2)
library(patchwork)
library(psych)                                   # fa(), fa.parallel(); rotacje ukośne liczy pakiet GPArotation

# Motyw i paleta Okabe–Ito (czytelna przy zaburzeniach widzenia barw; kolor zawsze z kształtem lub etykietą)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
        plot.margin = margin(10, 14, 10, 10))
kolory <- c(Planowanie = "#0072B2", Koncentracja = "#E69F00", `Szukanie pomocy` = "#009E73")
ksztalty <- c(Planowanie = 16, Koncentracja = 17, `Szukanie pomocy` = 15)
napis <- function(x, d = 2) {                    # zapis APA bez zera wiodącego, z minusem typograficznym
  s <- sprintf(paste0("%.", d, "f"), round(x, d) + 0)
  sub("-", "−", sub("^(-?)0\\.", "\\1.", s))
}

# Model populacyjny: prawdziwą strukturę znamy, bo sami ją ustalamy
pozycje <- c(paste0("P", 1:4), paste0("K", 1:4), paste0("S", 1:4))
czynniki <- names(kolory)
Lambda <- matrix(0, 12, 3, dimnames = list(pozycje, czynniki))
Lambda[1:4, "Planowanie"] <- c(.75, .70, .65, .60)
Lambda[5:8, "Koncentracja"] <- c(.70, .65, .60, .45)
Lambda["K4", "Planowanie"] <- .40                # K4 – pozycja krzyżowa (dwa czynniki)
Lambda[9:12, "Szukanie pomocy"] <- c(.55, .50, .45, .25)   # słabszy czynnik; S4 – pozycja słaba
Phi <- matrix(c(1, .40, .25,
                .40, 1, .20,
                .25, .20, 1), 3, dimnames = list(czynniki, czynniki))
h2_prawdziwe <- diag(Lambda %*% Phi %*% t(Lambda))         # prawdziwe zasoby zmienności wspólnej
losuj_skale <- function(n) {                     # odpowiedzi 1–5 z modelu trzech skorelowanych czynników
  F <- matrix(rnorm(n * 3), n) %*% chol(Phi)
  Z <- F %*% t(Lambda) + matrix(rnorm(n * 12), n) %*% diag(sqrt(1 - h2_prawdziwe))
  X <- apply(Z, 2, function(z) as.integer(cut(z, c(-Inf, -1.8, -0.7, 0.3, 1.3, Inf))))
  colnames(X) <- pozycje
  as.data.frame(X)
}
set.seed(571)                                    # ziarno ustalone raz, bez dobierania pod wynik
dane <- losuj_skale(300)
write.csv(dane, "analiza-czynnikowa-na-wykresie-dane.csv", row.names = FALSE)
round(colMeans(dane), 2)
c(KMO = round(KMO(dane)$MSA, 2))
b <- cortest.bartlett(cor(dane), n = nrow(dane))
c(chi2 = round(b$chisq, 2), df = b$df, p_mniejsze_niz_001 = b$p.value < .001)

# Analiza równoległa: 1000 losowych zbiorów 300 × 12 z rozkładu normalnego
pa <- fa.parallel(dane, fm = "minres", fa = "both", n.iter = 1000, plot = FALSE)
los <- pa$values[, paste0("CSim", 1:12)]         # wartości własne składowych z danych losowych
d1 <- data.frame(nr = 1:12, dane = pa$pc.values, srednia = colMeans(los),
                 c95 = apply(los, 2, quantile, .95), row.names = NULL)
round(head(d1, 6), 2)
c(Kaiser = sum(d1$dane > 1), PA_srednia = which(d1$dane <= d1$srednia)[1] - 1,
  PA_95 = which(d1$dane <= d1$c95)[1] - 1)

# Panel B: osypiska 50 innych prób z tej samej populacji (osypisko też ma błąd losowania)
inne <- do.call(rbind, lapply(1:50, function(i)
  data.frame(proba = i, nr = 1:12, wartosc = eigen(cor(losuj_skale(300)), only.values = TRUE)$values)))
round(tapply(inne$wartosc, inne$nr, range)[[3]], 2)    # zakres 3. wartości własnej w 50 próbach
round(tapply(inne$wartosc, inne$nr, range)[[4]], 2)    # zakres 4. wartości własnej

linie <- data.frame(nr = rep(1:12, 3), wartosc = c(d1$srednia, d1$c95, rep(1, 12)),
                    co = rep(c("Analiza równoległa: średnia", "Analiza równoległa: 95. centyl", "Kaiser: 1"), each = 12))
skala_linii <- scale_linetype_manual(values = c("Analiza równoległa: średnia" = "dashed",
                                                "Analiza równoległa: 95. centyl" = "solid", "Kaiser: 1" = "dotted"),
                                     name = NULL)
p1a <- ggplot(d1, aes(nr, dane)) +
  geom_line(data = linie, aes(y = wartosc, linetype = co), colour = "#0072B2", linewidth = 0.8) +
  geom_line(colour = "grey25") + geom_point(size = 2.6, colour = "grey10") +
  geom_text(data = d1[1:4, ], aes(label = sprintf("%.2f", dane)), nudge_x = 0.3, nudge_y = 0.22, hjust = 0, size = 3.9) +
  skala_linii + scale_x_continuous(breaks = 1:12) + scale_y_continuous(limits = c(0, 4.2)) +
  labs(x = "Numer składowej", y = "Wartość własna", title = "A. Twoja próba (N = 300)") +
  motyw + theme(legend.direction = "vertical")
p1b <- ggplot(inne, aes(nr, wartosc, group = proba)) +
  geom_line(colour = "grey45", alpha = 0.35, linewidth = 0.4) +
  geom_line(data = d1, aes(nr, dane), inherit.aes = FALSE, colour = "grey10", linewidth = 0.9) +
  geom_line(data = d1, aes(nr, c95), inherit.aes = FALSE, colour = "#0072B2", linewidth = 0.8) +
  scale_x_continuous(breaks = 1:12) + scale_y_continuous(limits = c(0, 4.2)) +
  labs(x = "Numer składowej", y = NULL, title = "B. 50 innych prób z populacji") + motyw
p1 <- p1a + p1b + plot_layout(guides = "collect") & theme(legend.position = "bottom")
# p1   # wyświetl; zapis: ggsave("osypisko-rownolegla.svg", p1, width = 9, height = 5.6)
Wynik w R
  P1   P2   P3   P4   K1   K2   K3   K4   S1   S2   S3   S4
3.14 3.14 3.16 3.25 3.19 3.13 3.19 3.22 3.19 3.20 3.20 3.28
 KMO
0.78
              chi2                 df p_mniejsze_niz_001
            639.93              66.00               1.00
Parallel analysis suggests that the number of factors =  3  and the number of components =  3
  nr dane srednia  c95
1  1 3.20    1.34 1.42
2  2 1.53    1.25 1.31
3  3 1.38    1.18 1.23
4  4 0.97    1.12 1.16
5  5 0.85    1.07 1.10
6  6 0.69    1.02 1.05
    Kaiser PA_srednia      PA_95
         3          3          3
[1] 1.08 1.57
[1] 0.83 1.07
Rysunek 2: mapa cieplna ładunków
Tabela ładunków czynnikowych z 36 liczbami jest czytelna dopiero wtedy, gdy pozycje ułożysz według czynnika, a w czynniku – od najsilniejszej. Mapa cieplna robi to samo kolorem: skala rozbieżna z bielą w zerze i stałymi granicami −1 i 1 (te same zasady co przy mapie cieplnej korelacji), a w polach – wartości ładunków. Rozwiązanie: trzy czynniki, metoda minres, rotacja ukośna oblimin.
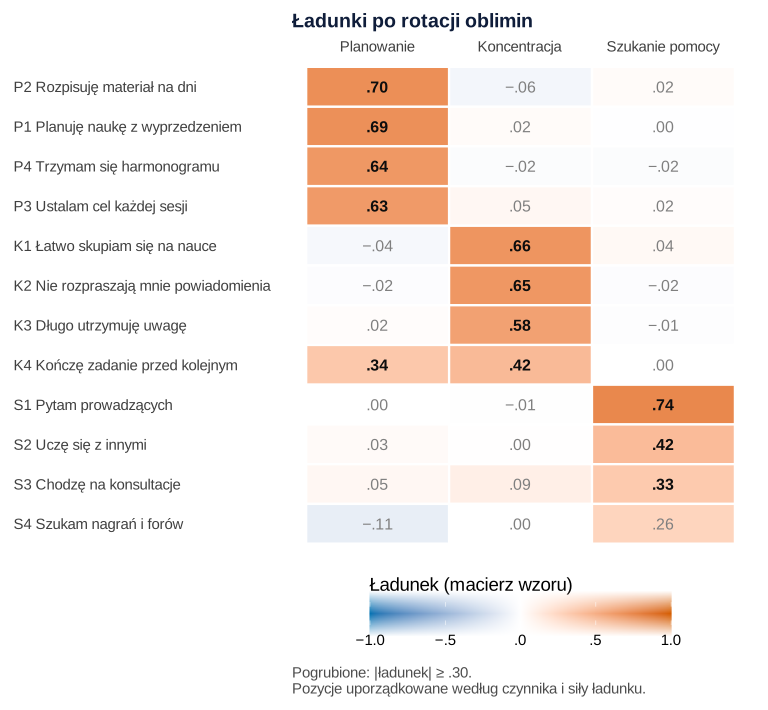
Co widać. Trzy bloki: planowanie (.63–.70), koncentracja (K1–K3: .58–.66) i szukanie pomocy (S1: .74, S2: .42, S3: .33). Ładunki poza blokami są bliskie zera: poza K4 największy co do wartości bezwzględnej to −.11 u słabej pozycji S4. Obie pułapki są widoczne od razu. K4 ma dwa jasnopomarańczowe pola (.34 na planowaniu i .42 na koncentracji), czyli ładunek krzyżowy. S4 ma ładunek .26, poniżej umownej granicy .30. W 500 próbach Monte Carlo K4 miała dwa ładunki co najmniej .30 w 82.4% prób (błąd MC 1.7 pp), a ładunek S4 spadał poniżej .30 w 75.4% prób (błąd 1.9 pp) – obie pułapki są więc wyraźne nie tylko w tej jednej próbie.
Czego ten wykres nie pokazuje i jak może zmylić. Przy rotacji ukośnej to macierz wzoru – ładunki to tu współczynniki podobne do wag regresji, a nie korelacje pozycji z czynnikiem (te są w macierzy struktury). Granica .30 jest umowna: pole .29 i pole .31 różnią się kolorem prawie niezauważalnie, a pogrubieniem już tak, więc nie traktuj pogrubienia jak wyroku. Mapa nie mówi też, jak dokładne są ładunki.
Podpis do pracy (do rozdziału o narzędziu; dokładne wartości podaj w tabeli analizy czynnikowej w APA):
Zdanie do Wyników:
Kod rysunku 2: EFA i mapa cieplna ładunków
2. Trzy czynniki (minres, oblimin), dopasowanie czynników i mapa ładunków
R
# Rysunek 2. Mapa cieplna ładunków: EFA, 3 czynniki, minres, oblimin (kontynuacja: dane, Lambda, czynniki, motyw, napis)
tresc <- c(P1 = "Planuję naukę z wyprzedzeniem", P2 = "Rozpisuję materiał na dni", P3 = "Ustalam cel każdej sesji",
           P4 = "Trzymam się harmonogramu", K1 = "Łatwo skupiam się na nauce", K2 = "Nie rozpraszają mnie powiadomienia",
           K3 = "Długo utrzymuję uwagę", K4 = "Kończę zadanie przed kolejnym", S1 = "Pytam prowadzących",
           S2 = "Uczę się z innymi", S3 = "Chodzę na konsultacje", S4 = "Szukam nagrań i forów")
# dopasowanie kolejności i znaku czynników z próby do czynników modelu (największa kongruencja Tuckera)
dopasuj <- function(L, wzor = Lambda) {
  perm <- rbind(c(1, 2, 3), c(1, 3, 2), c(2, 1, 3), c(2, 3, 1), c(3, 1, 2), c(3, 2, 1))
  kong <- factor.congruence(unclass(L), wzor)                      # wiersze: czynniki próby, kolumny: wzorca
  najl <- perm[which.max(apply(perm, 1, function(k) sum(abs(kong[cbind(k, 1:3)])))), ]
  list(kolejnosc = najl, znak = sign(kong[cbind(najl, 1:3)]))
}
efa <- fa(dane, nfactors = 3, fm = "minres", rotate = "oblimin")
dop <- dopasuj(efa$loadings)
L_obl <- unclass(efa$loadings)[, dop$kolejnosc] %*% diag(dop$znak)
dimnames(L_obl) <- list(pozycje, czynniki)
Phi_obl <- (diag(dop$znak) %*% efa$Phi[dop$kolejnosc, dop$kolejnosc] %*% diag(dop$znak))
dimnames(Phi_obl) <- list(czynniki, czynniki)
round(cbind(L_obl, h2 = efa$communality), 2)
round(Phi_obl, 2)

# kolejność pozycji: według czynnika z największym ładunkiem, w czynniku – malejąco
glowny <- apply(abs(L_obl), 1, which.max)
kolejnosc <- pozycje[order(glowny, -apply(abs(L_obl), 1, max))]
kolejnosc
etykiety <- setNames(paste(kolejnosc, tresc[kolejnosc], sep = "  "), kolejnosc)
d2 <- data.frame(pozycja = rep(pozycje, 3), czynnik = rep(czynniki, each = 12), ladunek = as.vector(L_obl))
d2$pozycja <- factor(d2$pozycja, levels = rev(kolejnosc))
d2$czynnik <- factor(d2$czynnik, levels = czynniki)
d2$wyrazny <- abs(d2$ladunek) >= .30
p2 <- ggplot(d2, aes(czynnik, pozycja, fill = ladunek)) +
  geom_tile(colour = "white", linewidth = 0.8) +
  geom_text(aes(label = napis(ladunek), colour = wyrazny, fontface = ifelse(wyrazny, "bold", "plain")),
            size = 4.2, show.legend = FALSE) +
  scale_colour_manual(values = c(`TRUE` = "grey5", `FALSE` = "grey50")) +
  scale_fill_gradient2(low = "#0072B2", mid = "white", high = "#D55E00", midpoint = 0, limits = c(-1, 1),
                       breaks = seq(-1, 1, 0.5), labels = function(x) napis(x, 1), name = "Ładunek (macierz wzoru)") +
  scale_y_discrete(labels = etykiety) + scale_x_discrete(position = "top") +
  labs(x = NULL, y = NULL, title = "Ładunki po rotacji oblimin",
       caption = "Pogrubione: |ładunek| ≥ .30.\nPozycje uporządkowane według czynnika i siły ładunku.") +
  motyw + theme(panel.grid.major = element_blank(), legend.key.width = unit(1.6, "cm"),
                legend.title.position = "top", plot.caption = element_text(colour = "grey30", hjust = 0),
                axis.text.y = element_text(hjust = 0))
# p2   # zapis: ggsave("mapa-ladunkow.svg", p2, width = 8, height = 7.4)
Wynik w R
   Planowanie Koncentracja Szukanie pomocy   h2
P1       0.69         0.02            0.00 0.49
P2       0.70        -0.06            0.02 0.46
P3       0.63         0.05            0.02 0.42
P4       0.64        -0.02           -0.02 0.40
K1      -0.04         0.66            0.04 0.42
K2      -0.02         0.65           -0.02 0.40
K3       0.02         0.58           -0.01 0.35
K4       0.34         0.42            0.00 0.42
S1       0.00        -0.01            0.74 0.54
S2       0.03         0.00            0.42 0.18
S3       0.05         0.09            0.33 0.14
S4      -0.11         0.00            0.26 0.07
                Planowanie Koncentracja Szukanie pomocy
Planowanie            1.00         0.44            0.16
Koncentracja          0.44         1.00            0.18
Szukanie pomocy       0.16         0.18            1.00
 [1] "P2" "P1" "P4" "P3" "K1" "K2" "K3" "K4" "S1" "S2" "S3" "S4"
Rysunek 3: ładunki przed rotacją i po niej
Rotacja obraca osie czynników tak, by każda pozycja ładowała możliwie jeden czynnik. Najłatwiej to zobaczyć na wykresie, na którym każda pozycja jest punktem o współrzędnych równych ładunkom na dwóch czynnikach. Rysunek 3 pokazuje te same dane bez rotacji i po trzech rotacjach: ortogonalnej varimax (Kaiser, 1958) oraz ukośnych oblimin (Jennrich i Sampson, 1966) i promax. Trzeci czynnik nie mieści się na płaszczyźnie, więc pozycje S leżą blisko początku układu.
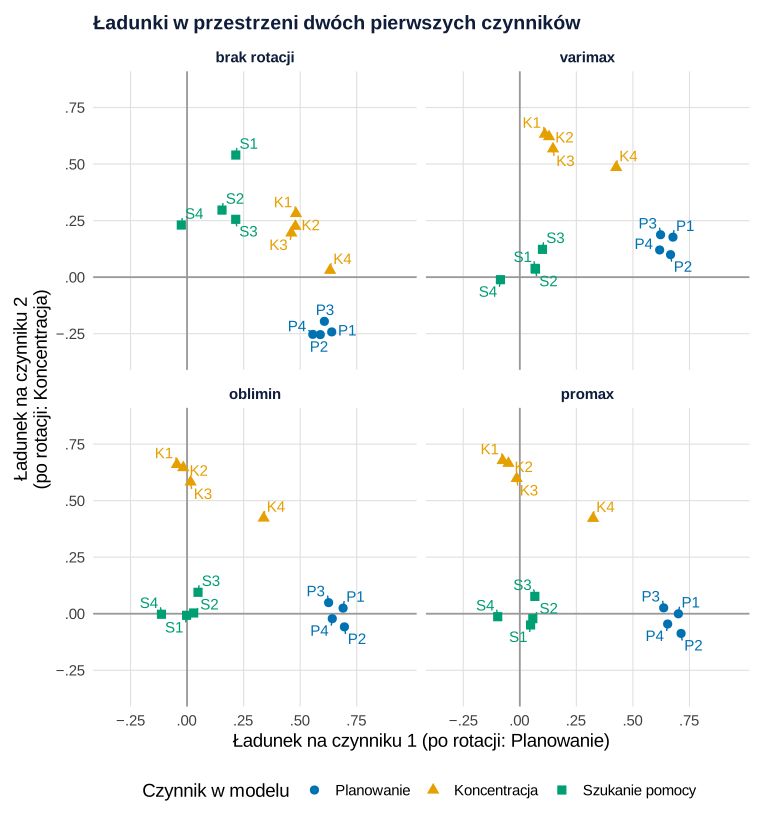
Co widać. Bez rotacji pierwszy czynnik jest „ogólny”: wszystkie pozycje planowania i koncentracji mają na nim ładunki od .46 do .64, a drugi czynnik je rozdziela (planowanie ujemnie, koncentracja dodatnio). Po varimax obie grupy leżą przy osiach, ale nie na nich – najwyższy ładunek obcy (poza K4) wynosi .19. Po oblimin i promax chmury przylegają do osi ciaśniej (najwyższy ładunek obcy .11 i .10). K4 we wszystkich rotacjach leży między osiami: .43 i .49 po varimax, .34 i .42 po oblimin. Rotacja nie zmienia zasobów zmienności wspólnej: we wszystkich czterech rozwiązaniach wynoszą od .07 do .54.
Czego ten wykres nie pokazuje i jak może zmylić. Przy rotacji ukośnej osie nie są prostopadłe, a wykres rysuje je jako prostopadłe – kąt między czynnikami widać dopiero w ich korelacji (rysunek 4). To rzut na dwa wymiary z trzech: pozycja blisko zera może mieć wysoki ładunek na trzecim czynniku. Przy skorelowanych czynnikach varimax daje wyższe ładunki obce – Sass i Schmitt (2010) pokazali, że interpretacja ładunków i korelacji czynników może się znacznie różnić zależnie od kryterium rotacji. O wyborze rotacji piszemy w hasłach o varimax i rotacji ukośnej.
Podpis do pracy (rysunek dobry do aneksu albo do uzasadnienia wyboru rotacji):
Zdanie do Wyników:
Kod rysunku 3: ładunki przed rotacją i po niej
3. Brak rotacji, varimax, oblimin i promax na jednym rysunku
R
# Rysunek 3. Te same ładunki bez rotacji, po varimax, oblimin i promax (kontynuacja: dane, Lambda, czynniki, dopasuj, motyw)
library(ggrepel)
rotacje <- c("brak rotacji" = "none", varimax = "varimax", oblimin = "oblimin", promax = "promax")
wyniki <- lapply(rotacje, function(r) fa(dane, nfactors = 3, fm = "minres", rotate = r))
ladunki <- lapply(names(rotacje), function(r) {
  L <- unclass(wyniki[[r]]$loadings)
  if (r != "brak rotacji") { d <- dopasuj(L); L <- L[, d$kolejnosc] %*% diag(d$znak) }  # bez rotacji: czynniki 1 i 2 z ekstrakcji
  data.frame(rotacja = r, pozycja = pozycje, F1 = L[, 1], F2 = L[, 2], F3 = L[, 3],
             czynnik = czynniki[apply(Lambda, 1, function(x) which.max(abs(x)))])
})
d3 <- do.call(rbind, ladunki)
d3$rotacja <- factor(d3$rotacja, levels = names(rotacje))
d3$czynnik <- factor(d3$czynnik, levels = czynniki)
# po rotacji: ładunki pozycji krzyżowej K4 i najwyższy ładunek „obcy” wśród pozostałych pozycji
round(unclass(wyniki[["brak rotacji"]]$loadings)[, 1:2], 2)   # bez rotacji: pierwszy czynnik „ogólny”
round(sapply(split(d3, d3$rotacja)[-1], function(d) {
  M <- as.matrix(d[, c("F1", "F2", "F3")]); glowny <- cbind(1:12, match(d$czynnik, czynniki))
  obce <- abs(M); obce[glowny] <- NA
  c(K4_F1 = M[8, 1], K4_F2 = M[8, 2], max_obcy_bez_K4 = max(obce[-8, ], na.rm = TRUE))
}), 2)
# te same zasoby zmienności wspólnej niezależnie od rotacji
round(sapply(wyniki, function(w) range(w$communality)), 2)

p3 <- ggplot(d3, aes(F1, F2, colour = czynnik, shape = czynnik)) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  geom_point(size = 2.8) +
  geom_text_repel(aes(label = pozycja), size = 4, show.legend = FALSE, seed = 1, min.segment.length = 0.2,
                  box.padding = 0.25, max.overlaps = Inf) +
  facet_wrap(~ rotacja, ncol = 2) +
  scale_colour_manual(values = kolory, name = "Czynnik w modelu") +
  scale_shape_manual(values = ksztalty, name = "Czynnik w modelu") +
  scale_x_continuous(limits = c(-0.35, 0.95), breaks = seq(-0.25, 0.75, 0.25), labels = function(x) napis(x)) +
  scale_y_continuous(limits = c(-0.35, 0.85), breaks = seq(-0.25, 0.75, 0.25), labels = function(x) napis(x)) +
  coord_equal() +
  labs(x = "Ładunek na czynniku 1 (po rotacji: Planowanie)", y = "Ładunek na czynniku 2\n(po rotacji: Koncentracja)",
       title = "Ładunki w przestrzeni dwóch pierwszych czynników") + motyw
# p3   # zapis: ggsave("rotacje.svg", p3, width = 8, height = 8.6)
Wynik w R
     MR1   MR2
P1  0.64 -0.24
P2  0.59 -0.25
P3  0.61 -0.20
P4  0.56 -0.25
K1  0.48  0.28
K2  0.48  0.22
K3  0.46  0.20
K4  0.63  0.03
S1  0.22  0.54
S2  0.15  0.30
S3  0.22  0.26
S4 -0.03  0.23
                varimax oblimin promax
K4_F1              0.43    0.34   0.32
K4_F2              0.49    0.42   0.42
max_obcy_bez_K4    0.19    0.11   0.10
     brak rotacji varimax oblimin promax
[1,]         0.07    0.07    0.07   0.07
[2,]         0.54    0.54    0.54   0.54
Rysunek 4: korelacje czynników
Rotacja ukośna szacuje korelacje czynników, a ortogonalna ustawia je na zero. Znamy prawdziwe korelacje, więc porównujemy z nimi oszacowania z próby i z 500 prób Monte Carlo (każda N = 300).
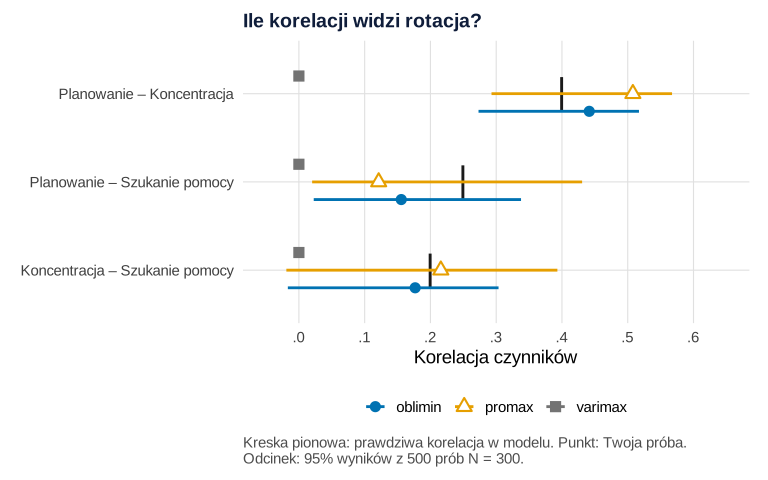
Co widać. Oblimin oszacował korelację planowania z koncentracją na .44 (prawda: .40), a promax na .51. Korelacje ze słabszym czynnikiem szukania pomocy są mniejsze i mniej dokładne: oblimin .16 i .18 (prawda: .25 i .20). W 500 próbach 95% wyników oblimin dla pary planowanie–koncentracja mieściło się między .27 a .52 (średnio .39). Promax dawał średnio wartości bliższe prawdzie przy słabszym czynniku (.24 i .20), ale z szerszym rozrzutem. Varimax we wszystkich parach pokazuje zero – nie dlatego, że czynniki nie są skorelowane, tylko dlatego, że taką ma konstrukcję.
Czego ten wykres nie pokazuje i jak może zmylić. W prawdziwym badaniu nie masz ani kresek, ani 500 prób – masz jeden punkt. Odcinki pokazują, jak bardzo ten punkt mógłby się różnić w innej próbie tej samej wielkości; to nie jest przedział ufności z Twojej analizy (ten możesz policzyć np. bootstrapem). Korelacja czynników zależy też od kryterium rotacji: przy parze planowanie–koncentracja oblimin i promax różnią się o .07 na tych samych danych.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 4: korelacje czynników i 500 prób Monte Carlo
4. Symulacja Monte Carlo: liczba czynników, pułapki i korelacje czynników
R
# Rysunek 4. Korelacje czynników: oblimin, promax i varimax wobec prawdy z modelu; 500 prób Monte Carlo
# (kontynuacja: losuj_skale, Lambda, Phi, czynniki, dopasuj, d1, wyniki, kolory, motyw, napis)
pary <- rbind(c(1, 2), c(1, 3), c(2, 3))
nazwy_par <- c("Planowanie – Koncentracja", "Planowanie – Szukanie pomocy", "Koncentracja – Szukanie pomocy")
phi_pary <- function(w) {                        # korelacje czynników po dopasowaniu kolejności i znaku
  d <- dopasuj(w$loadings)
  P <- diag(d$znak) %*% w$Phi[d$kolejnosc, d$kolejnosc] %*% diag(d$znak)
  P[pary]
}
R_mc <- 500                                      # liczba prób Monte Carlo (każda N = 300); ciąg losowy z set.seed(571)
mc <- t(replicate(R_mc, {
  X <- losuj_skale(300)
  ev <- eigen(cor(X), only.values = TRUE)$values
  w_o <- fa(X, nfactors = 3, fm = "minres", rotate = "oblimin")
  w_p <- fa(X, nfactors = 3, fm = "minres", rotate = "promax")
  d <- dopasuj(w_o$loadings); L <- unclass(w_o$loadings)[, d$kolejnosc] %*% diag(d$znak)
  c(kaiser = sum(ev > 1), pa95 = which(ev <= d1$c95)[1] - 1, obl = phi_pary(w_o), pro = phi_pary(w_p),
    K4_dwa = all(abs(L[8, 1:2]) >= .30), S4_ponizej_30 = unname(abs(L[12, 3]) < .30), w_o$communality)
}))
odsetek <- function(x) c(odsetek = round(100 * mean(x), 1), blad_MC_pp = round(100 * sqrt(mean(x) * (1 - mean(x)) / length(x)), 1))
rbind(Kaiser_3 = odsetek(mc[, "kaiser"] == 3), PA95_3 = odsetek(mc[, "pa95"] == 3),
      PA95_mniej_niz_3 = odsetek(mc[, "pa95"] < 3), K4_dwa_ladunki_30 = odsetek(mc[, "K4_dwa"] == 1),
      S4_ponizej_30 = odsetek(mc[, "S4_ponizej_30"] == 1))

# prawda, Twoja próba i rozrzut 500 prób (2.5. i 97.5. centyl)
d4 <- do.call(rbind, lapply(1:3, function(k) data.frame(
  para = nazwy_par[k], metoda = c("oblimin", "promax", "varimax"),
  prawda = Phi[pary][k],
  proba = c(phi_pary(wyniki$oblimin)[k], phi_pary(wyniki$promax)[k], 0),
  dol = c(quantile(mc[, paste0("obl", k)], .025), quantile(mc[, paste0("pro", k)], .025), 0),
  gora = c(quantile(mc[, paste0("obl", k)], .975), quantile(mc[, paste0("pro", k)], .975), 0),
  srednia_mc = c(mean(mc[, paste0("obl", k)]), mean(mc[, paste0("pro", k)]), 0))))
cbind(d4[, 1:2], round(d4[, 3:7], 2))
d4$para <- factor(d4$para, levels = rev(nazwy_par))
d4$metoda <- factor(d4$metoda, levels = c("oblimin", "promax", "varimax"))
p4 <- ggplot(d4, aes(y = para)) +
  geom_point(aes(x = prawda), data = d4[d4$metoda == "oblimin", ], shape = 124, size = 9, colour = "grey10") +
  geom_errorbar(aes(xmin = dol, xmax = gora, colour = metoda), width = 0, linewidth = 1, orientation = "y",
                position = position_dodge(width = 0.6)) +
  geom_point(aes(x = proba, colour = metoda, shape = metoda), size = 3.2, fill = "white", stroke = 1.1,
             position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c(oblimin = "#0072B2", promax = "#E69F00", varimax = "grey45"), name = NULL) +
  scale_shape_manual(values = c(oblimin = 16, promax = 24, varimax = 15), name = NULL) +
  scale_x_continuous(limits = c(-0.05, 0.65), breaks = seq(0, 0.6, 0.1), labels = function(x) napis(x, 1)) +
  labs(x = "Korelacja czynników", y = NULL, title = "Ile korelacji widzi rotacja?",
       caption = "Kreska pionowa: prawdziwa korelacja w modelu. Punkt: Twoja próba.\nOdcinek: 95% wyników z 500 prób N = 300.") +
  motyw + theme(plot.caption = element_text(colour = "grey30", hjust = 0))
# p4   # zapis: ggsave("korelacje-czynnikow.svg", p4, width = 8, height = 5)
Wynik w R
                  odsetek blad_MC_pp
Kaiser_3             74.6        1.9
PA95_3               95.4        0.9
PA95_mniej_niz_3      4.6        0.9
K4_dwa_ladunki_30    82.4        1.7
S4_ponizej_30        75.4        1.9
                            para  metoda prawda proba   dol gora srednia_mc
1      Planowanie – Koncentracja oblimin   0.40  0.44  0.27 0.52       0.39
2      Planowanie – Koncentracja  promax   0.40  0.51  0.29 0.57       0.44
3      Planowanie – Koncentracja varimax   0.40  0.00  0.00 0.00       0.00
4   Planowanie – Szukanie pomocy oblimin   0.25  0.16  0.02 0.34       0.19
5   Planowanie – Szukanie pomocy  promax   0.25  0.12  0.02 0.43       0.24
6   Planowanie – Szukanie pomocy varimax   0.25  0.00  0.00 0.00       0.00
7 Koncentracja – Szukanie pomocy oblimin   0.20  0.18 -0.02 0.30       0.15
8 Koncentracja – Szukanie pomocy  promax   0.20  0.22 -0.02 0.39       0.20
9 Koncentracja – Szukanie pomocy varimax   0.20  0.00  0.00 0.00       0.00
Rysunek 5: zasoby zmienności wspólnej
Zasób zmienności wspólnej h² to część wariancji pozycji wyjaśniona przez wszystkie czynniki razem. Na rysunku 5 obok wartości z próby są wartości prawdziwe i rozrzut w 500 próbach.
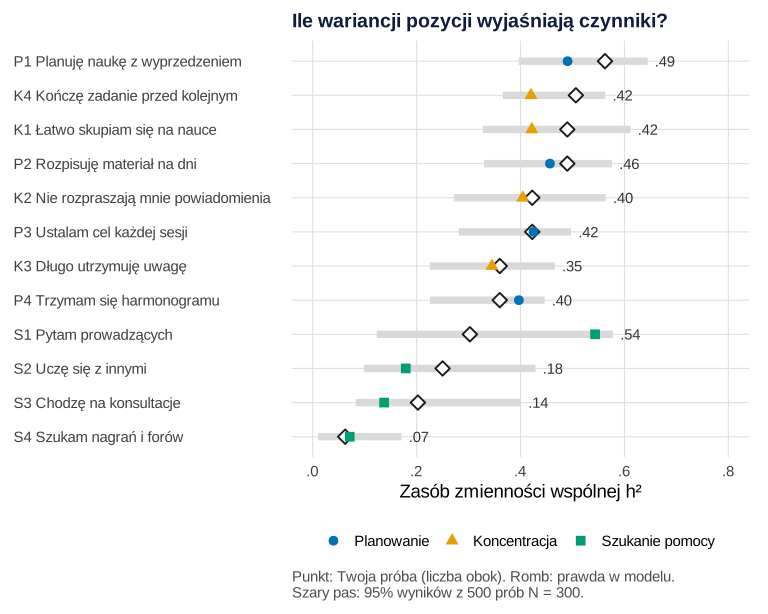
Co widać. Zasoby wynoszą od .07 (S4) do .54 (S1), średnio .36; trzy czynniki wyjaśniają razem 35.8% wariancji pozycji. S4 jest najsłabsza zarówno w próbie, jak i w modelu (.06). Ciekawsza jest S1: w próbie ma najwyższy zasób (.54), choć w modelu tylko .30. Pas rozrzutu (.12–.58) pokazuje, że w słabym czynniku pozycje „konkurują” o czynnik i jedna z nich może go przejąć.
Czego ten wykres nie pokazuje i jak może zmylić. Wartości prawdziwe dotyczą ciągłych odpowiedzi przed podziałem na pięć kategorii, a podział nieco obniża korelacje, dlatego pasy pozycji o wysokim h² leżą trochę na lewo od rombów. Nie ma jednego progu „za niskiego” zasobu: o losie pozycji decydują treść, ładunek i rola w skali, a nie sama liczba – a każda taka decyzja w EFA ma konsekwencje dla wyników (Fabrigar i in., 1999). Usunięcie S4 zmieni rozwiązanie, więc przelicz analizę i opisz tę decyzję. Zasoby przydają się też dalej: z ładunków policzysz rzetelność podskal w kalkulatorze alfy i omegi, a strukturę sprawdzisz na nowej próbie w CFA.
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 5: zasoby zmienności wspólnej
5. Zasoby zmienności wspólnej: próba, model i rozrzut w 500 próbach
R
# Rysunek 5. Zasoby zmienności wspólnej (h²): Twoja próba, prawda z modelu i rozrzut w 500 próbach
# (kontynuacja: efa, mc, h2_prawdziwe, tresc, pozycje, kolory, ksztalty, motyw, napis)
h2_mc <- mc[, pozycje]
d5 <- data.frame(pozycja = pozycje, prawda = h2_prawdziwe, proba = efa$communality,
                 dol = apply(h2_mc, 2, quantile, .025), gora = apply(h2_mc, 2, quantile, .975),
                 czynnik = czynniki[apply(Lambda, 1, function(x) which.max(abs(x)))], row.names = NULL)
cbind(d5[, c(1, 6)], round(d5[, 2:5], 2))
c(srednia_h2 = round(mean(d5$proba), 2), suma_h2 = round(sum(d5$proba), 2),
  procent_wariancji_wspolnej = round(100 * sum(d5$proba) / 12, 1))
d5$etykieta <- factor(paste(d5$pozycja, tresc[d5$pozycja], sep = "  "),
                      levels = paste(d5$pozycja, tresc[d5$pozycja], sep = "  ")[order(d5$prawda)])
d5$czynnik <- factor(d5$czynnik, levels = czynniki)
p5 <- ggplot(d5, aes(y = etykieta)) +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0, linewidth = 2.6, colour = "grey85", orientation = "y") +
  geom_point(aes(x = prawda), shape = 23, size = 3.4, fill = "white", colour = "grey10", stroke = 1) +
  geom_point(aes(x = proba, colour = czynnik, shape = czynnik), size = 3) +
  geom_text(aes(x = gora, label = napis(proba)), hjust = -0.35, size = 3.9, colour = "grey20") +
  scale_colour_manual(values = kolory, name = NULL) + scale_shape_manual(values = ksztalty, name = NULL) +
  scale_x_continuous(limits = c(0, 0.8), breaks = seq(0, 0.8, 0.2), labels = function(x) napis(x, 1)) +
  labs(x = "Zasób zmienności wspólnej h²", y = NULL, title = "Ile wariancji pozycji wyjaśniają czynniki?",
       caption = "Punkt: Twoja próba (liczba obok). Romb: prawda w modelu.\nSzary pas: 95% wyników z 500 prób N = 300.") +
  motyw + theme(axis.text.y = element_text(hjust = 0), plot.caption = element_text(colour = "grey30", hjust = 0))
# p5   # zapis: ggsave("zasoby-wspolne.svg", p5, width = 8, height = 6.4)
Wynik w R
   pozycja         czynnik prawda proba  dol gora
1       P1      Planowanie   0.56  0.49 0.40 0.64
2       P2      Planowanie   0.49  0.46 0.33 0.58
3       P3      Planowanie   0.42  0.42 0.28 0.50
4       P4      Planowanie   0.36  0.40 0.23 0.45
5       K1    Koncentracja   0.49  0.42 0.33 0.61
6       K2    Koncentracja   0.42  0.40 0.27 0.56
7       K3    Koncentracja   0.36  0.35 0.23 0.47
8       K4    Koncentracja   0.51  0.42 0.37 0.56
9       S1 Szukanie pomocy   0.30  0.54 0.12 0.58
10      S2 Szukanie pomocy   0.25  0.18 0.10 0.43
11      S3 Szukanie pomocy   0.20  0.14 0.08 0.40
12      S4 Szukanie pomocy   0.06  0.07 0.01 0.17
                srednia_h2                    suma_h2
                      0.36                       4.29
procent_wariancji_wspolnej
                     35.80
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (analiza czynnikowa, analiza równoległa, KMO i test Bartletta – pakiet psych; rotacje ukośne – GPArotation; wartości własne i losowanie – pakiet stats). Rysunki wykonano w ggplot2 z pakietami patchwork i ggrepel i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- GPArotation (wersja 2025.3.1): Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Które rysunki do rozdziału o narzędziu
Pięć rysunków to za dużo na opis narzędzia. Rozsądny podział:
- W tekście: wykres osypiska z analizą równoległą (tylko panel A) – uzasadnia liczbę czynników – oraz tabela ładunków w APA z korelacjami czynników w nocie. Mapa cieplna nie zastąpi tabeli – z koloru nikt nie odczyta ładunku do dwóch miejsc – ale może stać obok niej.
- W aneksie: mapa ładunków, wykres rotacji (gdy porównujesz rotacje) i wykres zasobów zmienności wspólnej, jeśli usuwasz pozycje.
- Tylko w Twoich plikach: symulacje Monte Carlo – służą do zrozumienia, nie do raportu.
Ogólne zasady formatowania rysunków są we wpisie wykresy w pracy dyplomowej. Paletę sprawdziliśmy w symulacji deuteranopii funkcją deutan() z pakietu colorspace (Zeileis i in., 2020): zielony staje się szarooliwkowy, ale odróżnia się od niebieskiego i pomarańczowego, a kolor zawsze idzie w parze z kształtem punktu. Ten sam pomysł „wielu prób z jednej populacji” pokazujemy we wpisie przedział ufności w obrazkach.
Najczęstsze błędy
- Osypisko bez progów. Sam „łokieć” bywa podwójny (rysunek 1); dodaj linie analizy równoległej i napisz, który próg przyjęto.
- Liczba czynników z kryterium Kaisera. W naszych 500 próbach trafiło w trzech czwartych przypadków, analiza równoległa – w 95%.
- Mapa ładunków w kolejności z kwestionariusza. Bloki znikają; sortuj według czynnika i siły ładunku.
- Varimax „z przyzwyczajenia” przy skorelowanych czynnikach. Ładunki obce rosną, a korelacje czynników znikają z wyniku (rysunki 3–4).
- Usuwanie pozycji tylko po progu .30 lub po niskim h². Pozycja słaba w jednej próbie może być przyzwoita w innej (rysunek 5); decyduj z treścią przed oczami i opisz decyzję.
- Brak informacji w nocie: metoda ekstrakcji, rotacja, N, która macierz, jaki próg pogrubienia.
Najczęstsze pytania
Jak odczytać wykres osypiska z analizą równoległą?
Zatrzymaj tyle czynników, ile kolejnych wartości własnych z danych leży nad linią progu z danych losowych (średnia albo 95. centyl), i skończ na pierwszej, która progu nie przekracza. Sam „łokieć” bywa niejednoznaczny, a wynik analizy równoległej traktuj jako propozycję – sprawdź też rozwiązania o jeden czynnik mniejsze i większe.
Jak zrobić wykres osypiska z analizą równoległą w R?
Funkcja fa.parallel() z pakietu psych liczy wartości własne z danych i z losowych zbiorów (argument n.iter). Progi, np. 95. centyl, policz z macierzy values (kolumny CSim dla składowych), a wykres narysuj w ggplot2: punkty z danych, linie progów i linię na poziomie 1.
Jak narysować mapę cieplną ładunków czynnikowych?
Ułóż pozycje według czynnika z najwyższym ładunkiem, a w czynniku – malejąco, użyj rozbieżnej skali barw z bielą w zerze i granicami −1 i 1 oraz wpisz wartości w pola. Przy rotacji ukośnej napisz w nocie, że to macierz wzoru, i podaj próg pogrubienia (np. |λ| ≥ .30).
Varimax czy oblimin – jak to zobaczyć na wykresie?
Narysuj ładunki pozycji jako punkty w układzie dwóch czynników. Gdy czynniki są skorelowane, po varimax punkty leżą obok osi (wyższe ładunki obce), a po oblimin bliżej osi; oblimin podaje też korelacje czynników, które varimax z założenia ustawia na zero. Zasoby zmienności wspólnej są w obu rozwiązaniach takie same.
Jaki zasób zmienności wspólnej (h²) jest za niski?
Nie ma jednego progu. Niski h² oznacza, że czynniki słabo wyjaśniają pozycję, ale w małej próbie i przy słabym czynniku wartość mocno się waha – w naszej symulacji ta sama pozycja miała w 95% prób h² od .12 do .58. O usunięciu pozycji decyduj z treścią przed oczami, przelicz analizę i opisz decyzję.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikKorelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →PoradnikPCA czy analiza czynnikowa?
Kiedy redukcja danych, a kiedy model konstruktu: tabela „kiedy która” i porównanie PCA z EFA na tych samych danych w R – ładunki, korelacje i wyniki osób.
Czytaj →Budujesz lub adaptujesz skalę do pracy?
Pomożemy przeprowadzić analizę czynnikową, dobrać liczbę czynników i rotację, przygotować czytelne rysunki i tabelę APA oraz opisać wyniki tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cattell, R. B. (1966). The scree test for the number of factors. Multivariate Behavioral Research, 1(2), 245–276. https://doi.org/10.1207/s15327906mbr0102_10
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989x.4.3.272
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Jennrich, R. I., & Sampson, P. F. (1966). Rotation for simple loadings. Psychometrika, 31(3), 313–323. https://doi.org/10.1007/bf02289465
- Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200. https://doi.org/10.1007/bf02289233
- Lim, S., & Jahng, S. (2019). Determining the number of factors using parallel analysis and its recent variants. Psychological Methods, 24(4), 452–467. https://doi.org/10.1037/met0000230
- Sass, D. A., & Schmitt, T. A. (2010). A comparative investigation of rotation criteria within exploratory factor analysis. Multivariate Behavioral Research, 45(1), 73–103. https://doi.org/10.1080/00273170903504810
- Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01 ● Otwarty dostęp
Cytowania BibTeX
@article{cattell1966scree, author={Cattell, Raymond B.}, title={{The scree test for the number of factors}}, journal={Multivariate Behavioral Research}, year={1966}, volume={1}, number={2}, pages={245--276}, doi={10.1207/s15327906mbr0102_10}}@article{fabrigar1999evaluating, author={Fabrigar, Leandre R. and Wegener, Duane T. and MacCallum, Robert C. and Strahan, Erin J.}, title={{Evaluating the use of exploratory factor analysis in psychological research}}, journal={Psychological Methods}, year={1999}, volume={4}, number={3}, pages={272--299}, doi={10.1037/1082-989x.4.3.272}}@article{horn1965rationale, author={Horn, John L.}, title={{A rationale and test for the number of factors in factor analysis}}, journal={Psychometrika}, year={1965}, volume={30}, number={2}, pages={179--185}, doi={10.1007/bf02289447}}@article{jennrich1966rotation, author={Jennrich, Robert I. and Sampson, P. F.}, title={{Rotation for simple loadings}}, journal={Psychometrika}, year={1966}, volume={31}, number={3}, pages={313--323}, doi={10.1007/bf02289465}}@article{kaiser1958varimax, author={Kaiser, Henry F.}, title={{The varimax criterion for analytic rotation in factor analysis}}, journal={Psychometrika}, year={1958}, volume={23}, number={3}, pages={187--200}, doi={10.1007/bf02289233}}@article{lim2019determining, author={Lim, Sangdon and Jahng, Seungmin}, title={{Determining the number of factors using parallel analysis and its recent variants}}, journal={Psychological Methods}, year={2019}, volume={24}, number={4}, pages={452--467}, doi={10.1037/met0000230}}@article{sass2010comparative, author={Sass, Daniel A. and Schmitt, Thomas A.}, title={{A comparative investigation of rotation criteria within exploratory factor analysis}}, journal={Multivariate Behavioral Research}, year={2010}, volume={45}, number={1}, pages={73--103}, doi={10.1080/00273170903504810}}@article{zeileis2020colorspace, author={Zeileis, Achim and Fisher, Jason C. and Hornik, Kurt and Ihaka, Ross and McWhite, Claire D. and Murrell, Paul and Stauffer, Reto and Wilke, Claus O.}, title={{colorspace: A toolbox for manipulating and assessing colors and palettes}}, journal={Journal of Statistical Software}, year={2020}, volume={96}, number={1}, doi={10.18637/jss.v096.i01}}