Gdzie jest CFA w jamovi i czego dotyczy ten wpis
Konfirmacyjna analiza czynnikowa (CFA) sprawdza, czy z góry zapisany model pomiaru pasuje do danych. Różnicę między EFA a CFA i decyzje teoretyczne omawia przewodnik analiza czynnikowa EFA i CFA. Wpis analiza czynnikowa w jamovi pokazuje całą ścieżkę EFA → CFA → rzetelność na jednej skali. Tutaj zajmujemy się tylko oknem CFA, za to dokładniej: kowariancją reszt, każdą tabelą wyników, indeksami modyfikacji i omegą z modelu.
Okno otwierasz z menu Analyses → Factor → Confirmatory Factor Analysis. Plik menu pakietu jmv umieszcza tę analizę w grupie Factor, w podgrupie Data Reduction (The jamovi project, b.d.-a). Nazwy opcji podajemy po angielsku według plików definicji analizy jmv 2.7.7 i dokumentacji funkcji cfa (The jamovi project, b.d.-a, b.d.-b). Polskie nazwy w nawiasach pochodzą z pliku tłumaczeń jmv, więc w Twojej wersji mogą się nieco różnić. Podstawy programu opisuje wpis jamovi krok po kroku.
Przykład i pliki do pobrania
Dane są symulowane. 320 osób studiujących wypełniło 10 pozycji z odpowiedziami od 1 do 5. Pięć pozycji mierzy motywację wewnętrzną do nauki (mw1–mw5), a pięć lęk przed egzaminem (le1–le5r). Dwie ostatnie pozycje lęku są sformułowane odwrotnie niż reszta podskali, np. „Przed egzaminem jestem spokojny/a”. W pliku są już przekodowane, więc wyższa liczba oznacza większy lęk. Jak odwrócić pozycje odwrócone we własnych danych, opisuje wpis przygotowanie danych w jamovi. U 16 osób brakuje pojedynczych odpowiedzi.
Pobierz plik CSV albo plik .sav z etykietami i powtarzaj kroki w jamovi. Średnie pozycji wynoszą od 3.18 do 3.34, a odchylenia standardowe od 1.01 do 1.13. Ziarno losowania (set.seed(5491)) wybraliśmy spośród około 50 sprawdzonych tak, żeby model bez kowariancji reszt miał jeszcze „dobre” CFI. Ten efekt omawiamy niżej.
Model zapisz przed otwarciem okna
CFA testuje model, który ustalasz przed analizą: liczbę czynników, przypisanie każdej pozycji do jednego czynnika i ewentualne dodatkowe parametry. Tu model ma dwa czynniki po pięć pozycji. Ma też jeden dodatkowy parametr: kowariancję reszt pozycji le4r i le5r.
Skąd ten parametr? Obie pozycje różnią się od reszty podskali kierunkiem sformułowania. Odpowiedzi na nie mogą zależeć od samego sposobu zadania pytania, a nie tylko od lęku. Marsh (1996) w CFA skali samooceny Rosenberga lepiej opisał odpowiedzi jednym czynnikiem z efektami metody dla pozycji sformułowanych negatywnie niż dwoma odrębnymi czynnikami. Zauważył też, że takie efekty są w skalach szacunkowych częste. Uzasadnienie dotyczy treści i formy pozycji, a nie wyniku analizy. Dlatego wpisz je do części „Metoda” przed obejrzeniem wyników.
Okno Confirmatory Factor Analysis krok po kroku
- Factors (Czynniki). Domyślny czynnik nazywa się Factor 1. Zmień nazwę na „Motywacja” i przeciągnij do niego
mw1–mw5. Dodaj drugi czynnik, „Lęk”, z pozycjamile1–le5r. Każdą pozycję przypisz do jednego czynnika. Pole przyjmuje zmienne liczbowe (The jamovi project, b.d.-a). - Residual Covariances (Kowariancje reszt). Dodaj parę
le4r–le5r. Każda para to jeden swobodny parametr więcej. - Options. Missing Values Method ma dwie możliwości: Full information maximum likelihood (domyślnie) i Exclude cases listwise. Constraints to sposób identyfikacji modelu: Factor variances = 1 (domyślnie) albo Scale factor = scale first indicator, czyli ładunek pierwszej pozycji równy 1 (The jamovi project, b.d.-b). Zostaw ustawienia domyślne. Wartości standaryzowane i dopasowanie nie zależą od tego wyboru. Więcej o tym w haśle identyfikacja modelu SEM.
- Estimates. Domyślnie zaznaczone są Factor covariances i Test statistics (Z i p). Dodaj Residual covariances, Confidence interval (95%) i Standardized estimate (The jamovi project, b.d.-a).
- Model Fit. Domyślnie zaznaczone są χ² test oraz CFI, TLI i RMSEA. Dodaj SRMR. Do wyboru są jeszcze AIC i BIC.
- Additional Output. Zaznacz Residuals observed correlation matrix i Modification indices, a jeśli chcesz, także Path diagram.
W definicji okna nie ma wyboru estymatora (The jamovi project, b.d.-a). Kod jmv przekazuje model funkcji cfa pakietu lavaan bez zmiany estymatora, więc liczy go metoda największej wiarygodności (ML). Nie ma też opcji porównania dwóch modeli. Tabele poniżej pokazujemy w układzie jamovi z wartościami zaokrąglonymi do trzech miejsc. Liczby policzyliśmy funkcją jmv::cfa, czyli tym samym kodem, którego używa program (Selker i in., 2025), a kontrolnie w lavaan. Pogrubione są liczby, które trafią do pracy.
Tabela Factor Loadings
| Factor | Indicator | Estimate | SE | Lower | Upper | Z | p | Stand. Estimate |
|---|---|---|---|---|---|---|---|---|
| Motywacja | mw1 | 0.768 | 0.057 | 0.657 | 0.880 | 13.469 | < .001 | 0.718 |
| mw2 | 0.718 | 0.057 | 0.606 | 0.831 | 12.503 | < .001 | 0.677 | |
| mw3 | 0.718 | 0.060 | 0.600 | 0.837 | 11.907 | < .001 | 0.655 | |
| mw4 | 0.839 | 0.059 | 0.725 | 0.954 | 14.328 | < .001 | 0.753 | |
| mw5 | 0.691 | 0.064 | 0.567 | 0.815 | 10.881 | < .001 | 0.611 | |
| Lęk | le1 | 0.749 | 0.058 | 0.634 | 0.863 | 12.836 | < .001 | 0.708 |
| le2 | 0.804 | 0.063 | 0.681 | 0.927 | 12.841 | < .001 | 0.708 | |
| le3 | 0.840 | 0.060 | 0.722 | 0.958 | 13.952 | < .001 | 0.757 | |
| le4r | 0.590 | 0.066 | 0.460 | 0.721 | 8.887 | < .001 | 0.523 | |
| le5r | 0.525 | 0.059 | 0.409 | 0.641 | 8.864 | < .001 | 0.520 |
Kolumna Estimate to ładunek w jednostkach odpowiedzi. Przy wariancji czynnika równej 1 oznacza, o ile punktów skali rośnie średnio odpowiedź, gdy czynnik rośnie o jedno odchylenie standardowe. Do pracy przepisuje się zwykle kolumnę Stand. Estimate. W kodzie jmv to pełne rozwiązanie standaryzowane z lavaan (The jamovi project, b.d.-a), w którym ładunek pozycji przypisanej do jednego czynnika jest korelacją pozycji z czynnikiem. W polskiej wersji ta kolumna ma nagłówek „β”.
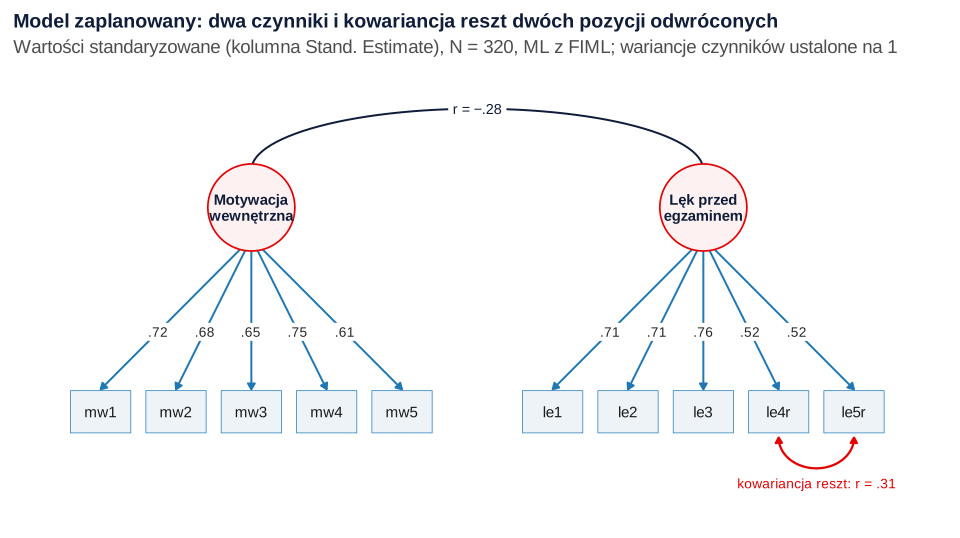
Ładunki standaryzowane wynoszą od .61 do .75 dla motywacji i od .52 do .76 dla lęku. Pozycje odwrócone mają najniższe ładunki, .52. Test Z sprawdza tylko, czy ładunek różni się od zera; ważniejsza jest jego wielkość. Ładunków krzyżowych model nie ma, więc nie ma ich w tabeli (zob. macierz ładunków i ładunków krzyżowych).
Kowariancje czynników i reszt
| Estimate | SE | Lower | Upper | Z | p | Stand. Estimate | ||
|---|---|---|---|---|---|---|---|---|
| Motywacja | Motywacja | 1.000a | ||||||
| Lęk | −0.283 | 0.065 | −0.411 | −0.155 | −4.337 | < .001 | −0.283 | |
| Lęk | Lęk | 1.000a | ||||||
| a fixed parameter | ||||||||
Wariancje czynników mają przypis fixed parameter, bo ustaliło je ograniczenie Factor variances = 1. Przy takich wariancjach kowariancja czynników jest ich korelacją: motywacja i lęk korelują na poziomie −.28, 95% CI [−.41, −.16].
| Estimate | SE | Lower | Upper | Z | p | Stand. Estimate | ||
|---|---|---|---|---|---|---|---|---|
| le4r | le4r | 0.927 | 0.082 | 0.767 | 1.088 | 11.306 | < .001 | 0.727 |
| le5r | 0.261 | 0.056 | 0.151 | 0.370 | 4.672 | < .001 | 0.314 | |
| le5r | le5r | 0.745 | 0.066 | 0.616 | 0.874 | 11.314 | < .001 | 0.730 |
Ta tabela pokazuje też wariancje reszt wszystkich pozycji, czyli wiersze z tą samą pozycją dwa razy. Standaryzowana wariancja reszty to 1 minus kwadrat ładunku, np. dla le4r: 1 − .523² = .727. Wiersz le4r–le5r to zaplanowana kowariancja reszt. Po standaryzacji to korelacja reszt, r = .31, p < .001. Obie pozycje mają więc wspólną wariancję, której nie wyjaśnia lęk (rysunek 1).
Model Fit: test χ² i wskaźniki dopasowania
| Model | χ² | df | p | CFI | TLI | SRMR | RMSEA | Lower | Upper |
|---|---|---|---|---|---|---|---|---|---|
| zaplanowany (z kowariancją reszt) | 44.308 | 33 | .090 | .988 | .983 | .034 | .033 | .000 | .056 |
| bez kowariancji reszt | 70.895 | 34 | < .001 | .960 | .947 | .042 | .058 | .039 | .077 |
W jamovi to dwie tabele. Test for Exact Fit to test χ² hipotezy, że model dokładnie odtwarza macierz kowariancji w populacji. Dla modelu zaplanowanego χ²(33) = 44.31, p = .090, więc nie ma podstaw do jej odrzucenia. Przy dużych próbach nawet drobne niedopasowanie daje istotny wynik, dlatego podaje się też tabelę Fit Measures. Ta tabela ma kolumny CFI, TLI, SRMR i RMSEA z granicami 90% przedziału ufności w kolumnach Lower i Upper (The jamovi project, b.d.-b). Model zaplanowany ma CFI = .988, TLI = .983, SRMR = .034 i RMSEA = .033, 90% CI [.000, .056].
Jak to ocenić? Hu i Bentler (1999) w symulacjach dla estymacji ML zaproponowali wartości odcięcia bliskie .95 dla CFI i TLI, .08 dla SRMR i .06 dla RMSEA. Zalecili też oceniać dwa wskaźniki razem. To konwencja z określonych warunków symulacji, a nie reguła. Marsh i in. (2004) pokazali, że wiele modeli błędnie określonych w tamtych symulacjach miało dopasowanie akceptowalne nawet według tych progów. Wskaźniki lepiej sprawdzały się przy porównywaniu modeli zagnieżdżonych niż przy ocenie jednego modelu.
Nasz przykład to dobrze ilustruje. Model bez kowariancji reszt jest błędny, bo dane pochodzą z modelu zaplanowanego. Mimo to ma CFI = .960, RMSEA = .058 i SRMR = .042, czyli „przechodzi” te trzy progi; tylko TLI = .947 jest tuż poniżej .95. Brak parametru zdradza dopiero istotny test χ², porównanie modeli i indeksy modyfikacji. W oknie CFA jamovi nie porównasz dwóch modeli. Test różnicy χ² policzysz w R z dwóch dopasowań. Tu daje Δχ²(1) = 26.59, p < .001 (przepis 2). Wyniki obu modeli zestawisz według wzoru tabeli dopasowania modelu CFA w APA.
Reszty korelacji i indeksy modyfikacji
Tabela Residuals for Observed Correlation Matrix pokazuje dla każdej pary pozycji różnicę między korelacją w danych a korelacją odtworzoną przez model. Program wyróżnia wartości, których moduł przekracza 0.1 (opcja Highlight values above). W modelu zaplanowanym są dwie takie pary: mw5–le4r (0.120) i mw2–le1 (−0.107). Pozostałe reszty mieszczą się w ±0.10.
Opcja Modification indices daje dwie tabele: Factor Loadings – Modification Indices dla ładunków krzyżowych i Residual Covariances – Modification Indices dla kowariancji reszt (The jamovi project, b.d.-a). Indeks modyfikacji (MI) to przybliżony spadek χ² po uwolnieniu jednego parametru. jamovi domyślnie wyróżnia MI powyżej 3, a wartość krytyczna χ² z jednym stopniem swobody przy α = .05 wynosi 3.84.
W modelu bez kowariancji reszt największy MI dotyczy właśnie pary le4r–le5r: 27.39 (rysunek 2, lewy panel). Gdybyś nie zaplanował(a) tego parametru, program by go podpowiedział. Uwolnienie go po takiej podpowiedzi byłoby jednak modyfikacją opartą na danych. MacCallum i in. (1992) pokazali na wielu próbach, że takie modyfikacje bywają bardzo niespójne między próbami. Zalecili porównywanie kilku modeli określonych z góry.
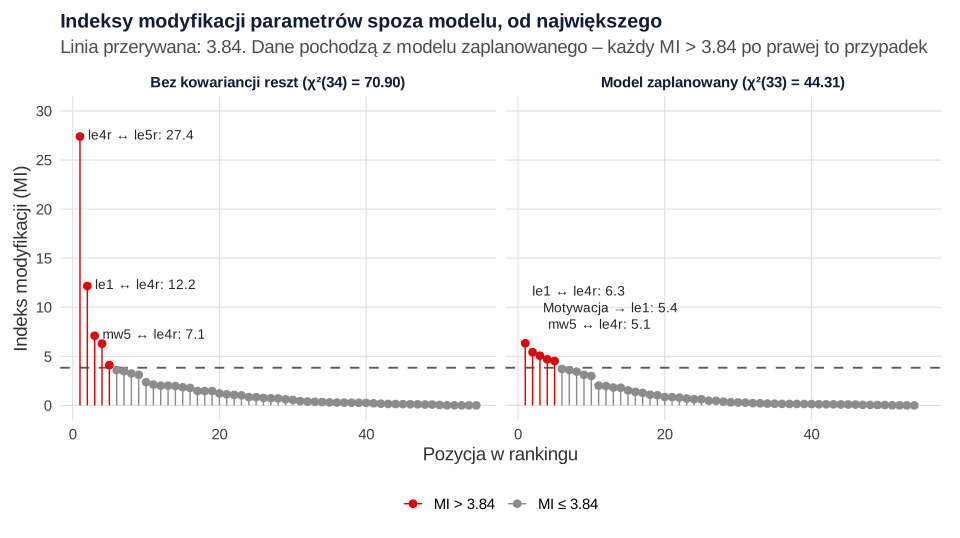
Prawy panel to model zaplanowany, czyli dokładnie ten, z którego wylosowaliśmy dane. Mimo to 9 indeksów przekracza 3, a 5 przekracza 3.84. Największy, 6.33, dotyczy kowariancji reszt le1–le4r, a dwa inne to ładunki pozycji lęku na motywacji (5.42 i 4.52). Wszystkie wynikają wyłącznie z losowości próby. Model poprawiany według nich lepiej opisze tę próbę, ale niekoniecznie następną.
Pozycje Likerta, estymator ML i braki danych
jamovi liczy CFA metodą ML i traktuje odpowiedzi 1–5 jak liczby: kod jmv zamienia zmienne na liczbowe przed dopasowaniem (The jamovi project, b.d.-a). Okno nie oferuje estymatora WLSMV dla zmiennych porządkowych ani odpornych poprawek błędów standardowych i χ². Rhemtulla i in. (2012) porównali w symulacjach odporny ML z metodą kategorialną. Przy pięciu i więcej kategoriach, w miarę symetrycznych progach i małej próbie zalecili ML, a przy mniej niż pięciu kategoriach – metodę kategorialną. Jeśli Twoja skala ma trzy lub cztery odpowiedzi albo silnie skośne rozkłady, policz model w R według wpisu kategorialna CFA: WLSMV w lavaan. Model z częścią strukturalną pokazuje wpis CB-SEM w R.
Braki danych: przy domyślnym FIML model wykorzystał wszystkie 320 osób. Po przełączeniu na Exclude cases listwise zostają 304 osoby i nieco inne wyniki, np. χ²(33) = 42.38, p = .127, CFI = .989 (przepis 2). FIML zakłada jednak, że braki są losowe w sensie MAR.
Rzetelność: omega z modelu i z Reliability Analysis
Okno CFA nie liczy rzetelności. Alfę i omegę w jamovi daje Factor → Reliability Analysis, opisana we wpisie alfa Cronbacha i omega w jamovi. W kodzie jmv 2.7.7 ω McDonalda pochodzi z modelu jednoczynnikowego bez kowariancji reszt (The jamovi project, b.d.-a). Dla podskali lęku Reliability Analysis daje α = .80 i ω = .80. Omega policzona z modelu CFA z kowariancją reszt wynosi .76 (przepis 2). Ta sama omega z modelu bez kowariancji reszt to .79. Wspólna wariancja dwóch pozycji odwróconych nie należy do lęku, a model bez tego parametru wlicza ją do wariancji prawdziwej. Dla motywacji oba sposoby dają to samo, ω = .81. Jeśli Twój model ma kowariancje reszt, podaj omegę z modelu i nazwij źródło liczby.
Zapis wyników w stylu APA
W części „Metoda” opisz model z uzasadnieniem dodatkowych parametrów, estymator, sposób obsługi braków i program z wersją. W „Wynikach” podaj test χ², co najmniej dwa wskaźniki dopasowania, zakres ładunków standaryzowanych i korelację czynników. Wzór do dostosowania:
Zdania do innych analiz przygotuje generator opisu wyników APA.
To samo w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc przepis 1 daje te same tabele co okno Confirmatory Factor Analysis (Selker i in., 2025). Argumenty funkcji cfa odpowiadają opcjom okna: factors to czynniki i pozycje, resCov – kowariancje reszt, miss i constrain – sekcja Options, a dalej stdEst, fitMeasures, corRes i mi (The jamovi project, b.d.-b). Wynik zawiera też składnię lavaan, którą jmv dopasował. Liczby we wpisie pochodzą z tego kodu, nie z uruchomienia jamovi. Przepis 2 to kontrola w lavaan i to, czego okno nie podaje, a przepis 3 tworzy pliki. Tabele wyników są szerokie: przewiń je w poziomie.
1. Okno Confirmatory Factor Analysis funkcją jmv::cfa
R
# To samo w R: okno Analyses → Factor → Confirmatory Factor Analysis wykonane pakietem jmv (silnik analiz jamovi)
library(jmv)
dane <- read.csv("cfa-w-jamovi-dane.csv")
czynniki <- list(list(label = "Motywacja", vars = c("mw1", "mw2", "mw3", "mw4", "mw5")),
                 list(label = "Lęk", vars = c("le1", "le2", "le3", "le4r", "le5r")))

# 1. Model zaplanowany przed analizą: dwa czynniki + kowariancja reszt dwóch pozycji odwróconych
m1 <- cfa(data = dane, factors = czynniki,
          resCov = list(list(i1 = "le4r", i2 = "le5r")),
          miss = "fiml", constrain = "facVar",           # ustawienia domyślne okna
          ci = TRUE, stdEst = TRUE, resCovEst = TRUE,
          fitMeasures = c("cfi", "tli", "srmr", "rmsea"),
          corRes = TRUE, mi = TRUE)
m1
cat(m1$modelSyntax, "\n")

# 2. Dla porównania: ten sam model bez kowariancji reszt (tylko dopasowanie i indeksy modyfikacji)
m0 <- cfa(data = dane, factors = czynniki, resCov = NULL, estTest = FALSE, factCovEst = FALSE,
          fitMeasures = c("cfi", "tli", "srmr", "rmsea"), mi = TRUE)
m0$modelFit
m0$modelPerformance

# 3. Factor → Reliability Analysis dla obu podskal: α i ω (omega z modelu jednoczynnikowego bez kowariancji reszt)
reliability(data = dane, vars = c("mw1", "mw2", "mw3", "mw4", "mw5"), alphaScale = TRUE, omegaScale = TRUE)
reliability(data = dane, vars = c("le1", "le2", "le3", "le4r", "le5r"), alphaScale = TRUE, omegaScale = TRUE)
Wynik:
 CONFIRMATORY FACTOR ANALYSIS

 Factor Loadings
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Factor       Indicator    Estimate     SE            Lower        Upper        Z            p             Stand. Estimate
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Motywacja    mw1          0.7683857    0.05704958    0.6565705    0.8802008    13.468736    < .0000001          0.7179911
                mw2          0.7182699    0.05744616    0.6056775    0.8308623    12.503358    < .0000001          0.6767948
                mw3          0.7184784    0.06033978    0.6002146    0.8367422    11.907209    < .0000001          0.6549495
                mw4          0.8393722    0.05858374    0.7245502    0.9541942    14.327734    < .0000001          0.7531262
                mw5          0.6910154    0.06350821    0.5665416    0.8154892    10.880726    < .0000001          0.6113336
   Lęk          le1          0.7486270    0.05832307    0.6343159    0.8629381    12.835865    < .0000001          0.7075958
                le2          0.8040495    0.06261408    0.6813281    0.9267708    12.841352    < .0000001          0.7082589
                le3          0.8401925    0.06022205    0.7221594    0.9582255    13.951575    < .0000001          0.7572034
                le4r         0.5904247    0.06643598    0.4602126    0.7206368     8.887122    < .0000001          0.5226667
                le5r         0.5248926    0.05921476    0.4088338    0.6409514     8.864219    < .0000001          0.5195445
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 FACTOR ESTIMATES

 Factor Covariances
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                             Estimate        SE            Lower         Upper         Z            p            Stand. Estimate
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Motywacja    Motywacja     1.0000000 ᵃ
                Lęk          -0.2830140      0.06524891    -0.4108995    -0.1551285    -4.337452    0.0000144         -0.2830140
   Lęk          Lęk           1.0000000 ᵃ
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   ᵃ fixed parameter


 RESIDUAL ESTIMATES

 Residual Covariances
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                   Estimate     SE            Lower        Upper        Z            p             Stand. Estimate
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   mw1     mw1     0.5548865    0.05776587    0.4416675    0.6681056     9.605785    < .0000001          0.4844888
   mw2     mw2     0.6104071    0.05948869    0.4938114    0.7270028    10.260892    < .0000001          0.5419488
   mw3     mw3     0.6871937    0.06555378    0.5587106    0.8156767    10.482899    < .0000001          0.5710411
   mw4     mw4     0.5376031    0.06034508    0.4193290    0.6558773     8.908814    < .0000001          0.4328009
   mw5     mw5     0.8001683    0.07342694    0.6562542    0.9440825    10.897476    < .0000001          0.6262712
   le1     le1     0.5588937    0.06082250    0.4396838    0.6781036     9.188930    < .0000001          0.4993082
   le2     le2     0.6422925    0.07004644    0.5050040    0.7795810     9.169524    < .0000001          0.4983694
   le3     le3     0.5252875    0.06492694    0.3980331    0.6525420     8.090440    < .0000001          0.4266430
   le4r    le4r    0.9274828    0.08203599    0.7666952    1.0882704    11.305804    < .0000001          0.7268195
           le5r    0.2608589    0.05583279    0.1514286    0.3702891     4.672145     0.0000030          0.3137774
   le5r    le5r    0.7451816    0.06586262    0.6160932    0.8742699    11.314180    < .0000001          0.7300735
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 MODEL FIT

 Test for Exact Fit
 ───────────────────────────────
   χ²          df    p
 ───────────────────────────────
   44.30771    33    0.0903306
 ───────────────────────────────


 Fit Measures
 ────────────────────────────────────────────────────────────────────────────────
   CFI          TLI          SRMR          RMSEA         Lower       Upper
 ────────────────────────────────────────────────────────────────────────────────
   0.9878142    0.9833830    0.03430378    0.03272317    0.000000    0.05572398
 ────────────────────────────────────────────────────────────────────────────────


 POST-HOC MODEL PERFORMANCE

 Residuals for Observed Correlation Matrix
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
           mw1          mw2           mw3           mw4           mw5           le1           le2          le3           le4r          le5r
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   mw1                  -0.0058502    -0.0008537    -0.0080405     0.0227826    -0.0793445    0.0646127     0.0148988     0.0144979    -0.0188444
   mw2                                -0.0091587     0.0017627     0.0084485    -0.1072097    0.0373580    -0.0195763    -0.0103839     0.0356076
   mw3                                               0.0214588    -0.0228782    -0.0152591    0.0928621    -0.0291526    -0.0026689    -0.0200505
   mw4                                                            -0.0126600    -0.0318793    0.0459268     0.0078504     0.0711160    -0.0353765
   mw5                                                                          -0.0538286    0.0357689    -0.0221583     0.1201847     0.0529671
   le1                                                                                        0.0049273    -0.0025676    -0.0589267     0.0148962
   le2                                                                                                     -0.0064941     0.0536478    -0.0152224
   le3                                                                                                                    0.0147125     0.0005400
   le4r                                                                                                                                 0.0006635
   le5r
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 MODIFICATION INDICES

 Factor Loadings – Modification Indices
 ──────────────────────────────────────
           Motywacja     Lęk
 ──────────────────────────────────────
   mw1                   3.106967e-5
   mw2                    0.63132676
   mw3                    0.05461669
   mw4                    0.15591913
   mw5                    0.01571035
   le1     5.41792648
   le2     4.52142816
   le3     0.09708566
   le4r    1.38279163
   le5r    0.19039776
 ──────────────────────────────────────


 Residual Covariances – Modification Indices
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
           mw1    mw2           mw3            mw4           mw5          le1          le2           le3           le4r         le5r
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   mw1            0.08787544    0.003637654    0.28441287    1.0377753    2.0206594    0.70964766    1.09288966    0.1772054    0.14812601
   mw2                          0.146837832    0.01033765    0.1103405    3.4475813    0.23247294    0.04338835    1.9726420    3.71585671
   mw3                                         1.27319958    0.6342804    0.7956961    2.99503754    1.81764373    0.8499086    0.11534808
   mw4                                                       0.3026444    0.3138239    0.21646675    0.11061272    3.1186419    3.60627379
   mw5                                                                    0.3874254    0.09300891    0.84726693    5.0659412    0.46897289
   le1                                                                                 0.13578825    0.04530773    6.3319433    1.80074298
   le2                                                                                               0.14863484    4.6959137    1.52623567
   le3                                                                                                             0.4792221    0.05568265
   le4r
   le5r
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────

# Latent variable definitions
Motywacja =~ mw1 + mw2 + mw3 + mw4 + mw5
Lęk =~ le1 + le2 + le3 + le4r + le5r

# Residual covariances
le4r ~~ le5r

 MODEL FIT

 Test for Exact Fit
 ───────────────────────────────
   χ²          df    p
 ───────────────────────────────
   70.89508    34    0.0002105
 ───────────────────────────────


 Fit Measures
 ──────────────────────────────────────────────────────────────────────────────────
   CFI          TLI          SRMR          RMSEA         Lower         Upper
 ──────────────────────────────────────────────────────────────────────────────────
   0.9602400    0.9473764    0.04243408    0.05823308    0.03897909    0.07730369
 ──────────────────────────────────────────────────────────────────────────────────


 POST-HOC MODEL PERFORMANCE

 MODIFICATION INDICES

 Factor Loadings – Modification Indices
 ──────────────────────────────────────
           Motywacja     Lęk
 ──────────────────────────────────────
   mw1                   0.005761769
   mw2                   0.556210712
   mw3                   0.012463598
   mw4                   0.115990495
   mw5                   0.143048796
   le1     6.29560624
   le2     3.48503499
   le3     0.38838161
   le4r    2.01468648
   le5r    0.04560482
 ──────────────────────────────────────


 Residual Covariances – Modification Indices
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
           mw1    mw2           mw3            mw4           mw5          le1          le2          le3            le4r          le5r
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   mw1            0.08645339    0.006602509    0.31167579    1.0762394    1.8481984    0.7309742    1.025780658     0.2612163     0.1802136
   mw2                          0.150509247    0.01086492    0.1290954    3.5982837    0.1146341    0.005209523     0.7122449     3.1175807
   mw3                                         1.22291005    0.6194389    0.8386576    3.2503193    1.469690354     1.1300807     0.3460677
   mw4                                                       0.2786641    0.2659153    0.2181780    0.088154510     1.9687945     2.1281362
   mw5                                                                    0.7623210    0.2890164    1.456962101     7.0988941     2.0136063
   le1                                                                                 1.4556100    1.781707313    12.1675540     0.2938412
   le2                                                                                              0.370001194     0.4440163     4.1065936
   le3                                                                                                              0.8425271     2.3736939
   le4r                                                                                                                          27.3907536
   le5r
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ─────────────────────────────────────────
            Cronbach's α    McDonald's ω
 ─────────────────────────────────────────
   scale       0.8092371       0.8108340
 ─────────────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ─────────────────────────────────────────
            Cronbach's α    McDonald's ω
 ─────────────────────────────────────────
   scale       0.7988731       0.7999392
 ─────────────────────────────────────────
2. Kontrola w lavaan: porównanie modeli, MI, braki i omega z modelu
R
# Kontrola liczb z jamovi w lavaan i to, czego okno CFA nie podaje
suppressPackageStartupMessages({library(lavaan); library(semTools)})
dane <- read.csv("cfa-w-jamovi-dane.csv")
m0 <- 'Motywacja =~ mw1 + mw2 + mw3 + mw4 + mw5
       Lek =~ le1 + le2 + le3 + le4r + le5r'
m1 <- paste(m0, "\n le4r ~~ le5r")

# 1. Te same ustawienia co w jmv: ML, FIML, wariancje czynników = 1, struktura średnich
f1 <- cfa(m1, data = dane, std.lv = TRUE, missing = "fiml", meanstructure = TRUE)
f0 <- cfa(m0, data = dane, std.lv = TRUE, missing = "fiml", meanstructure = TRUE)
cat("Estymator:", lavInspect(f1, "options")$estimator, "  osoby w analizie:", lavInspect(f1, "nobs"), "\n")
miary <- c("chisq", "df", "pvalue", "cfi", "tli", "srmr", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper")
print(round(rbind(bez_kowariancji = fitMeasures(f0, miary), z_kowariancja = fitMeasures(f1, miary)), 3))

# 2. Standaryzowane ładunki, korelacja czynników i korelacja reszt (std.all – kolumna Stand. Estimate)
s <- standardizedSolution(f1)
print(s[s$op %in% c("=~", "~~") & (s$op == "=~" | s$lhs != s$rhs), c("lhs", "op", "rhs", "est.std", "ci.lower", "ci.upper")],
      digits = 3, row.names = FALSE)

# 3. Test różnicy χ² modeli zagnieżdżonych (w oknie CFA jamovi nie ma porównania modeli)
print(anova(f0, f1))

# 4. Indeksy modyfikacji: model bez kowariancji i model zaplanowany (dane pochodzą z modelu zaplanowanego,
#    więc każdy MI > 3.84 w drugim modelu to przypadek)
mi0 <- modindices(f0, sort. = TRUE); mi1 <- modindices(f1, sort. = TRUE)
print(head(mi0[, c("lhs", "op", "rhs", "mi", "sepc.all")], 3), digits = 3, row.names = FALSE)
print(mi1[mi1$mi > 3.84, c("lhs", "op", "rhs", "mi", "sepc.all")], digits = 3, row.names = FALSE)
cat("MI > 3 w modelu zaplanowanym:", sum(mi1$mi > 3), " MI > 3.84:", sum(mi1$mi > 3.84), "z", nrow(mi1), "\n")

# 5. FIML a usuwanie przypadków (Exclude cases listwise)
fl <- cfa(m1, data = dane, std.lv = TRUE, missing = "listwise", meanstructure = TRUE)
cat("Listwise – osoby:", lavInspect(fl, "nobs"), "\n")
print(round(fitMeasures(fl, miary), 3))

# 6. Rzetelność z modelu: omega dla obu czynników (kowariancja reszt nie trafia do wariancji prawdziwej)
print(round(unlist(compRelSEM(f1)), 3))
print(round(unlist(compRelSEM(f0)), 3))
Wynik:
Estymator: ML   osoby w analizie: 320
                 chisq df pvalue   cfi   tli  srmr rmsea rmsea.ci.lower rmsea.ci.upper
bez_kowariancji 70.895 34   0.00 0.960 0.947 0.042 0.058          0.039          0.077
z_kowariancja   44.308 33   0.09 0.988 0.983 0.034 0.033          0.000          0.056
       lhs op  rhs est.std ci.lower ci.upper
 Motywacja =~  mw1   0.718    0.649    0.787
 Motywacja =~  mw2   0.677    0.602    0.751
 Motywacja =~  mw3   0.655    0.577    0.732
 Motywacja =~  mw4   0.753    0.688    0.818
 Motywacja =~  mw5   0.611    0.528    0.695
       Lek =~  le1   0.708    0.632    0.783
       Lek =~  le2   0.708    0.633    0.783
       Lek =~  le3   0.757    0.687    0.827
       Lek =~ le4r   0.523    0.426    0.619
       Lek =~ le5r   0.520    0.424    0.615
      le4r ~~ le5r   0.314    0.205    0.422
 Motywacja ~~  Lek  -0.283   -0.411   -0.155

Chi-Squared Difference Test

   Df    AIC    BIC  Chisq Chisq diff Df diff Pr(>Chisq)
f1 33 8723.9 8844.5 44.308
f0 34 8748.5 8865.3 70.895     26.587       1  2.519e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  lhs op  rhs   mi sepc.all
 le4r ~~ le5r 27.4    0.347
  le1 ~~ le4r 12.2   -0.255
  mw5 ~~ le4r  7.1    0.167
       lhs op  rhs   mi sepc.all
       le1 ~~ le4r 6.33   -0.169
 Motywacja =~  le1 5.42   -0.126
       mw5 ~~ le4r 5.07    0.130
       le2 ~~ le4r 4.70    0.146
 Motywacja =~  le2 4.52    0.116
MI > 3 w modelu zaplanowanym: 9  MI > 3.84: 5 z 54
Listwise – osoby: 304
         chisq             df         pvalue            cfi            tli           srmr
        42.376         33.000          0.127          0.989          0.986          0.033
         rmsea rmsea.ci.lower rmsea.ci.upper
         0.031          0.000          0.055
Motywacja       Lek
    0.815     0.757
Motywacja       Lek
    0.815     0.790
3. Dane symulowane i pliki CSV oraz .sav
R
# Dane symulowane do wpisu „Konfirmacyjna analiza czynnikowa (CFA) w jamovi”
# 320 osób studiujących wypełnia 10 pozycji (1–5): motywacja wewnętrzna (mw1–mw5) i lęk przed egzaminem (le1–le5r).
# le4r i le5r są sformułowane odwrotnie („Przed egzaminem jestem spokojny/a”) i już przekodowane (6 − odpowiedź);
# mają wspólny efekt sformułowania, czyli w modelu prawdziwym kowariancję reszt.
library(haven)
set.seed(5491)  # ziarno wybrane spośród ok. 50 tak, by model bez kowariancji reszt miał jeszcze „dobre” CFI
n <- 320
mw <- rnorm(n)
le <- -0.35 * mw + sqrt(1 - 0.35^2) * rnorm(n)   # korelacja czynników −.35
met <- rnorm(n)                                    # efekt sformułowania odwróconego
lam_mw <- c(.75, .70, .65, .72, .55)
lam_le <- c(.78, .72, .68, .55, .58)
met_l <- c(0, 0, 0, .45, .45)
X <- sapply(1:5, function(j) lam_mw[j] * mw + sqrt(1 - lam_mw[j]^2) * rnorm(n))
Y <- sapply(1:5, function(j) lam_le[j] * le + met_l[j] * met + sqrt(1 - lam_le[j]^2 - met_l[j]^2) * rnorm(n))
kat <- function(z) findInterval(z, c(-1.6, -0.7, 0.2, 1.1)) + 1   # odpowiedzi 1–5
dane <- data.frame(id = seq_len(n), apply(X, 2, kat), apply(Y, 2, kat))
names(dane)[-1] <- c(paste0("mw", 1:5), "le1", "le2", "le3", "le4r", "le5r")
for (v in c("mw3", "le2", "le5r", "mw5")) dane[[v]][sample(n, 4)] <- NA   # pojedyncze braki odpowiedzi
write.csv(dane, "cfa-w-jamovi-dane.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Ten sam zbiór w .sav: etykiety zmiennych i wartości 1–5
etyk <- c(mw1 = "Uczę się, bo ciekawi mnie mój kierunek", mw2 = "Lubię zgłębiać nowe tematy z zajęć",
          mw3 = "Nauka daje mi satysfakcję", mw4 = "Czytam o kierunku także poza zajęciami",
          mw5 = "Zadania na studiach są dla mnie wyzwaniem, które lubię",
          le1 = "Przed egzaminem czuję silne napięcie", le2 = "Martwię się, że zapomnę materiał",
          le3 = "Myśl o egzaminie psuje mi sen", le4r = "Przed egzaminem jestem spokojny/a (odwrócona)",
          le5r = "Na egzaminie myślę jasno (odwrócona)")
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
for (v in names(etyk)) {
  sav[[v]] <- labelled(as.numeric(dane[[v]]), label = etyk[[v]],
                       labels = c("zdecydowanie nie" = 1, "raczej nie" = 2, "trudno powiedzieć" = 3,
                                  "raczej tak" = 4, "zdecydowanie tak" = 5))
}
write_sav(sav, "cfa-w-jamovi-dane.sav")
cat("Zapisano", nrow(dane), "wierszy; osoby z co najmniej jednym brakiem:", sum(!complete.cases(dane)), "\n")
print(head(dane, 4), row.names = FALSE)
print(round(sapply(dane[-1], function(x) c(M = mean(x, na.rm = TRUE), SD = sd(x, na.rm = TRUE))), 2))
Wynik:
Zapisano 320 wierszy; osoby z co najmniej jednym brakiem: 16
 id mw1 mw2 mw3 mw4 mw5 le1 le2 le3 le4r le5r
  1   4   3   3   4   3   3   3   3    2    3
  2   5   4   5   4   4   4   5   4    3    4
  3   4   4   3   3   5   3   3   2    3    3
  4   3   2   2   1   1   3   2   3    2    4
    mw1  mw2  mw3  mw4  mw5  le1  le2  le3 le4r le5r
M  3.25 3.27 3.22 3.18 3.19 3.34 3.31 3.31 3.23 3.29
SD 1.07 1.06 1.10 1.12 1.13 1.06 1.14 1.11 1.13 1.01
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który model CFA dopasowuje pakietem lavaan, a omegę w Reliability Analysis liczy pakietem psych. Omegę z modelu policzono pakietem semTools, pliki .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersję jamovi albo R, której faktycznie użyłeś(-aś).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- CFA na tych samych osobach, na których zrobiono EFA, przedstawiona jako potwierdzenie struktury.
- Kowariancje reszt i ładunki krzyżowe dodawane według indeksów modyfikacji, aż wskaźniki „przejdą” progi. W pracy wszystkie dodatkowe parametry wymień i uzasadnij treścią pozycji.
- Progi Hu i Bentlera jako zero-jedynkowy test. Dobre CFI nie dowodzi, że model jest poprawny.
- Estimate zamiast Stand. Estimate opisane jako ładunek standaryzowany.
- ML przy trzech–czterech kategoriach odpowiedzi bez sprawdzenia wyników metodą kategorialną.
- Omega z Reliability Analysis podana jako rzetelność skali, której model wymaga kowariancji reszt.
Najczęstsze pytania
Gdzie w jamovi jest konfirmacyjna analiza czynnikowa?
W menu Analyses → Factor → Confirmatory Factor Analysis; plik menu pakietu jmv umieszcza ją w grupie Factor, w podgrupie Data Reduction (The jamovi project, b.d.-a). W polskiej wersji interfejsu według pliku tłumaczeń jmv analiza nazywa się „Konfirmacyjna analiza czynnikowa”. Ta sama grupa zawiera EFA, PCA i Reliability Analysis.
Jak w jamovi dodać kowariancję reszt i kiedy wolno to zrobić?
W sekcji Residual Covariances przeciągasz parę pozycji; każda para to jeden parametr więcej (The jamovi project, b.d.-a). Dodaj ją tylko z powodu treści lub formy pozycji, zapisanego przed analizą, np. wspólnego odwrotnego sformułowania (Marsh, 1996). Kowariancja dodana po obejrzeniu indeksów modyfikacji to modyfikacja oparta na danych, która w innych próbach często się nie powtarza (MacCallum i in., 1992).
Czy jamovi ma estymator WLSMV dla pozycji Likerta?
Nie. W oknie CFA nie ma wyboru estymatora, a kod jmv dopasowuje model w lavaan metodą największej wiarygodności i traktuje odpowiedzi jak liczby (The jamovi project, b.d.-a). Przy pięciu i więcej kategoriach i w miarę symetrycznych odpowiedziach ML jest zwykle rozsądny (Rhemtulla i in., 2012). Przy trzech–czterech kategoriach policz model metodą WLSMV w R, w pakiecie lavaan.
Które wskaźniki dopasowania z jamovi podać w pracy?
Test χ² z tabeli Test for Exact Fit oraz co najmniej dwa wskaźniki z Fit Measures, np. CFI i SRMR albo RMSEA z 90% przedziałem ufności. Hu i Bentler (1999) zaproponowali dla ML wartości bliskie .95 dla CFI i TLI, .08 dla SRMR i .06 dla RMSEA. Marsh i in. (2004) przestrzegają jednak przed traktowaniem ich jak złotych reguł. W przykładzie błędny model bez kowariancji reszt i tak miał CFI = .960.
Omegę z Reliability Analysis czy z modelu CFA?
Reliability Analysis w jamovi liczy omegę z modelu jednoczynnikowego bez kowariancji reszt (The jamovi project, b.d.-a). Jeśli Twój model CFA ma kowariancje reszt, podaj omegę z tego modelu, np. policzoną w R. W przykładzie dla podskali lęku Reliability Analysis daje ω = .80, a omega z modelu z kowariancją reszt pozycji odwróconych wynosi .76.
Powiązane hasła
Przeczytaj też
Analiza czynnikowa w jamovi
EFA i CFA w jamovi na jednym przykładzie: ustawienia, tabele do czytania, ukryte ładunki, rzetelność, opis APA i te same wyniki w R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →PoradnikKategorialna CFA: WLSMV w lavaan
Kiedy pozycje Likerta są porządkowe, jak czytać progi, ML, MLR i WLSMV na tych samych danych, indeksy robust, rzadkie kategorie i opis APA.
Czytaj →PoradnikAlfa Cronbacha i omega w jamovi
Reliability Analysis krok po kroku: alfa i omega, pozycje odwrócone bez pułapki ze średnią, if item dropped, braki danych, zapis wyniku skali i zdania APA.
Czytaj →Masz CFA w jamovi i nie wiesz, czy model jest dobrze dopasowany?
Sprawdzimy Twój plik .omv, przypisanie pozycji, kowariancje reszt, estymator przy pozycjach Likerta i wskaźniki dopasowania i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490–504. https://doi.org/10.1037/0033-2909.111.3.490
- Marsh, H. W. (1996). Positive and negative global self-esteem: A substantively meaningful distinction or artifactors? Journal of Personality and Social Psychology, 70(4), 810–819. https://doi.org/10.1037/0022-3514.70.4.810
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. https://doi.org/10.1207/s15328007sem1103_2
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.-a). jmv: Confirmatory Factor Analysis – analysis definition files (cfa.a.yaml, cfa.u.yaml, cfa.r.yaml). GitHub – jamovi/jmv. https://github.com/jamovi/jmv/tree/master/jamovi ● Otwarty dostęp
- The jamovi project. (b.d.-b). Confirmatory Factor Analysis. jamovi documentation. https://docs.jamovi.org/jmv/jmv_cfa.html ● Otwarty dostęp
Cytowania BibTeX
@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{maccallum1992model, author={MacCallum, Robert C. and Roznowski, Mary and Necowitz, Lawrence B.}, title={{Model modifications in covariance structure analysis: The problem of capitalization on chance}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={3}, pages={490--504}, doi={10.1037/0033-2909.111.3.490}}@article{marsh1996positive, author={Marsh, Herbert W.}, title={{Positive and negative global self-esteem: A substantively meaningful distinction or artifactors?}}, journal={Journal of Personality and Social Psychology}, year={1996}, volume={70}, number={4}, pages={810--819}, doi={10.1037/0022-3514.70.4.810}}@article{marsh2004search, author={Marsh, Herbert W. and Hau, Kit-Tai and Wen, Zhonglin}, title={{In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler's (1999) findings}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2004}, volume={11}, number={3}, pages={320--341}, doi={10.1207/s15328007sem1103_2}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovigithubjmvcfa, author={{The jamovi project}}, title={{jmv: Confirmatory Factor Analysis – analysis definition files (cfa.a.yaml, cfa.u.yaml, cfa.r.yaml)}}, howpublished={GitHub – jamovi/jmv}, year={b.d.-a}, url={https://github.com/jamovi/jmv/tree/master/jamovi}}@misc{jamovindjmvcfa, author={{The jamovi project}}, title={{Confirmatory Factor Analysis}}, howpublished={jamovi documentation}, year={b.d.-b}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_cfa.html}}