Do czego służy Reliability Analysis w jamovi
Gdy wynik kwestionariusza liczysz jako sumę albo średnią kilku pozycji, w pracy musisz podać jego rzetelność. Najczęściej jest to spójność wewnętrzna: alfa Cronbacha, a coraz częściej także omega McDonalda. W jamovi obie miary daje jedno okno, Reliability Analysis. W tym samym oknie wskażesz pozycje odwrócone, sprawdzisz, która pozycja słabo pasuje do skali, i zapiszesz wynik skali jako nową kolumnę.
Ten wpis to instrukcja tej jednej analizy: co zaznaczyć, jak czytać dwie tabele i jak opisać wynik. Interfejs programu, instalację i moduły opisuje wpis jamovi krok po kroku. Tę samą procedurę w SPSS, z tabelą Item-Total Statistics i przedziałem ufności z ICC, pokazuje wpis alfa Cronbacha w SPSS krok po kroku. Tu skupiamy się na tym, czym jamovi się różni: omega jest na wyciągnięcie ręki, pozycje odwraca się w oknie analizy, ale program nie pokazuje, na ilu osobach policzył wynik.
Wszystkie liczby w tabelach policzyliśmy funkcją reliability() z pakietu jmv. To ten sam kod analiz, który uruchamia jamovi (Selker i in., 2025). Tabele różnią się od ekranu programu tylko zaokrągleniem.
Przykład i przygotowanie danych
Dane są symulowane. 240 osób studiujących odpowiedziało na siedem pozycji przykładowej skali poczucia przynależności do uczelni (1 – zdecydowanie się nie zgadzam, 5 – zdecydowanie się zgadzam). Dwie pozycje są sformułowane odwrotnie: pp3 („Na uczelni czuję się obco”) i pp6 („Myślę o przeniesieniu się na inną uczelnię”). Dziewięć osób pominęło po jednym pytaniu. Pobierz plik CSV albo plik .sav z etykietami zmiennych i odpowiedzi. Kolumna rok to rok studiów.
Przed analizą sprawdź trzy rzeczy (szczegóły we wpisie przygotowanie danych i statystyki opisowe w jamovi):
- Typ zmiennych. W edytorze zmiennej (dwuklik na nagłówku kolumny) każda zmienna ma Measure type i Data type (The jamovi project, b.d.). Okno Reliability Analysis przyjmuje zmienne liczbowe i podpowiada typy Continuous oraz Ordinal (Selker i in., 2025). Pozycje skali 1–5 ustaw jako Ordinal albo Continuous z typem danych Integer.
- Braki i zakres odpowiedzi. Wpisz pozycje do Exploration → Descriptives. Wiersz Missing pokaże braki, a Minimum i Maximum – kody spoza skali. Kody braków, np. 99, zadeklaruj w edytorze zmiennej w Missing values, bo inaczej analizy potraktują je jak odpowiedzi (The jamovi project, b.d.).
- Kierunek pozycji. Odwrócone pozycje wskażesz w samym oknie analizy albo przekodujesz wcześniej. Oba sposoby porównujemy w sekcji o pozycjach odwróconych, bo dają różne średnie.
Descriptives
| pp1 | pp2 | pp3 | pp4 | pp5 | pp6 | pp7 | |
|---|---|---|---|---|---|---|---|
| N | 239 | 239 | 240 | 239 | 237 | 239 | 238 |
| Missing | 1 | 1 | 0 | 1 | 3 | 1 | 2 |
| Mean | 3.423 | 3.540 | 2.804 | 3.498 | 3.376 | 1.967 | 3.223 |
| Standard deviation | 1.093 | 1.036 | 1.062 | 1.080 | 1.057 | 0.883 | 1.046 |
| Minimum | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
| Maximum | 5 | 5 | 5 | 5 | 5 | 4 | 5 |
Braki ma sześć z siedmiu pozycji, razem dziewięć, a każdy dotyczy innej osoby. Kompletne odpowiedzi ma więc 231 osób. Druga ważna informacja jest w wierszu Maximum: w pozycji pp6 nikt nie wybrał odpowiedzi 5. Za chwilę zobaczysz, dlaczego to ma znaczenie.
Alfa i omega w jamovi krok po kroku
Dokumentacja jamovi podaje ścieżkę Factor → (Scale analysis) → Reliability analysis jako odpowiednik SPSS Scale → Reliability Analysis (The jamovi project, b.d.). Nazwy pól i opcji poniżej pochodzą z plików definicji tej analizy w pakiecie jmv 2.7.7 (Selker i in., 2025).
- Na pasku Analyses kliknij Factor i wybierz Reliability Analysis z grupy Scale Analysis.
- Przenieś pp1–pp7 do pola Items. Wpisz tylko pozycje jednej skali; każdą podskalę analizuj osobno.
- W grupie Scale Statistics zostaw zaznaczone Cronbach's α (domyślne) i dodaj McDonald's ω, Mean oraz Standard deviation.
- W grupie Item Statistics zaznacz Cronbach's α (if item is dropped), McDonald's ω (if item is dropped), Mean, Standard deviation i Item-rest correlation.
- Rozwiń sekcję Reverse Scaled Items i przenieś pp3 oraz pp6 z listy Normal Scaled Items do listy Reverse Scaled Items.
- Opcjonalnie zaznacz Correlation heatmap w grupie Additional Options, a w sekcji Save – Mean score albo Sum score.
Interfejs ma polską wersję językową. Plik tłumaczeń pakietu jmv 2.7.7 podaje polskie etykiety zebrane w tabeli. W Twojej wersji programu nazwy mogą się jednak różnić.
| Etykieta angielska | Polska etykieta (plik tłumaczeń jmv) | Co robi |
|---|---|---|
| Reliability Analysis | Analiza rzetelności | nazwa analizy i nagłówek wyników |
| Scale Reliability Statistics | Statystyki rzetelności | tabela dla całej skali |
| Item Reliability Statistics | Statystyki rzetelności pozycji testowych | tabela dla pozycji |
| Item-rest correlation | Korelacja pozycji z wynikiem ogólnym | korelacja pozycji z sumą pozostałych pozycji |
| If item dropped | Po usunięciu danej pozycji | α i ω bez danej pozycji |
| Reverse Scaled Items | Pozycje kodowane odwrotnie | pozycje odwracane przed obliczeniami |
| Save: Mean score / Sum score | Zapisz: Średni wynik / Wynik sumaryczny | nowa kolumna z wynikiem skali |
Uwaga na polską nazwę „korelacja pozycji z wynikiem ogólnym”. Kod analizy liczy korelację pozycji z sumą pozostałych pozycji, czyli korelację pozycja–reszta, a nie z wynikiem obejmującym tę pozycję (Selker i in., 2025).
Jak czytać tabele z Reliability Analysis
Przy tych ustawieniach jamovi pokaże dwie tabele. Mapa korelacji pojawi się tylko wtedy, gdy ją zaznaczysz.
Scale Reliability Statistics
Scale Reliability Statistics
| Mean | SD | Cronbach's α | McDonald's ω | |
|---|---|---|---|---|
| scale | 3.316 | 0.698 | 0.798 | 0.805 |
Alfa Cronbacha wynosi .798, a omega McDonalda .805. Mean i SD opisują wynik skali jako średnią siedmiu pozycji, już po odwróceniu pp3 i pp6: M = 3.32, SD = 0.70 na skali 1–5. Kod jmv bierze te wartości z funkcji alpha() pakietu psych, która uśrednia pozycje (Selker i in., 2025). Jeśli w pracy podajesz wynik jako sumę, pomnóż średnią przez 7 albo zapisz kolumnę Sum score. Co wybrać, wyjaśnia wpis jak policzyć wynik kwestionariusza.
Item Reliability Statistics
Item Reliability Statistics
| If item dropped | |||||
|---|---|---|---|---|---|
| Mean | SD | Item-rest correlation | Cronbach's α | McDonald's ω | |
| pp1 | 3.424 | 1.088 | 0.655 | 0.747 | 0.755 |
| pp2 | 3.528 | 1.037 | 0.587 | 0.761 | 0.771 |
| pp3 a | 3.169 | 1.060 | 0.610 | 0.756 | 0.766 |
| pp4 | 3.502 | 1.079 | 0.575 | 0.763 | 0.772 |
| pp5 | 3.364 | 1.054 | 0.546 | 0.768 | 0.779 |
| pp6 a | 3.013 | 0.882 | 0.484 | 0.780 | 0.789 |
| pp7 | 3.212 | 1.052 | 0.262 | 0.819 | 0.820 |
- Mean i SD dla pozycji odwróconych (oznaczonych literą ᵃ) są już po odwróceniu. Średnia pp6 = 3.013 to nie średnia odpowiedzi z ankiety.
- Item-rest correlation – sześć pozycji ma od .484 do .655, pp7 tylko .262. Tak niska wartość sygnalizuje, że pozycja słabo mierzy to co pozostałe.
- If item dropped – bez pp7 alfa wzrosłaby do .819, a omega do .820. Bez każdej innej pozycji obie miary by spadły.
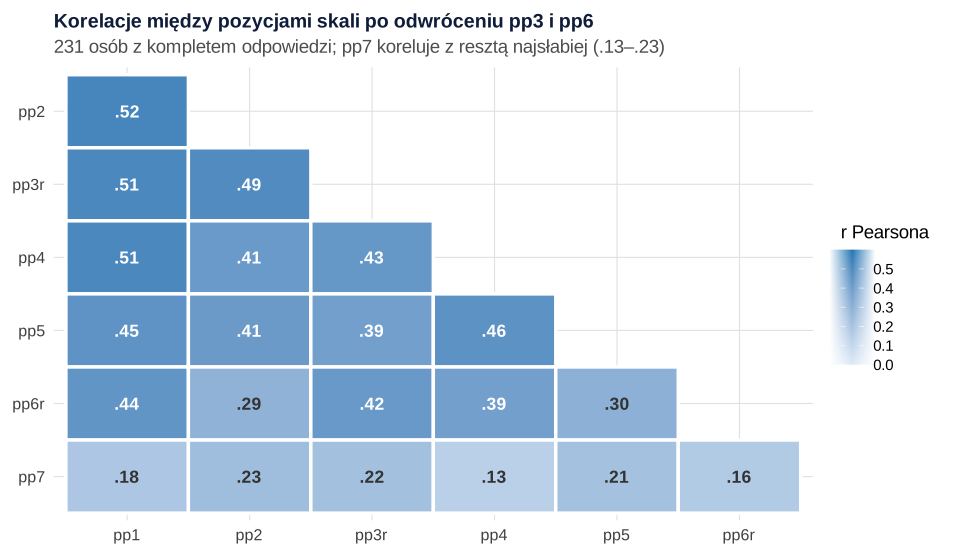
Mapę korelacji, podobną do tej z opcji Correlation heatmap, pokazuje rysunek 1. Wyjaśnia, skąd bierze się słaby wynik pp7.
Pozycje odwrócone: pole Reverse Scaled Items czy przekodowanie
Najczęstszy błąd to analiza z nieodwróconymi pozycjami. jamovi go wychwytuje. Gdy wpiszesz pp1–pp7 bez listy pozycji odwróconych, pod tabelą skali pojawi się uwaga, że pozycje pp3 i pp6 korelują ujemnie z wynikiem skali i prawdopodobnie powinny zostać odwrócone. W przykładzie alfa spadła wtedy do .159, omega do .437, a korelacje pozycja–reszta pp3 i pp6 wynosiły −.532 i −.388. Uwaga pojawia się, gdy pozycja ma ujemny ładunek w pierwszej głównej składowej (Selker i in., 2025). Nie zastąpi jednak znajomości klucza kwestionariusza. Więcej o takich pozycjach przeczytasz w haśle pozycja odwrócona.
Pozycję odwrócisz na dwa sposoby:
- W oknie analizy, przez listę Reverse Scaled Items. Odwrócenie działa tylko w tej analizie.
- W danych, zmienną przekształconą: Data → Add → Transformed Variable, źródło pp3, Create New Transform… i formuła
6 - $source. Ta sama reguła obsłuży wiele kolumn naraz. Dokumentacja jamovi radzi odwracać pozycje przed liczeniem sumy lub średniej (The jamovi project, b.d.).
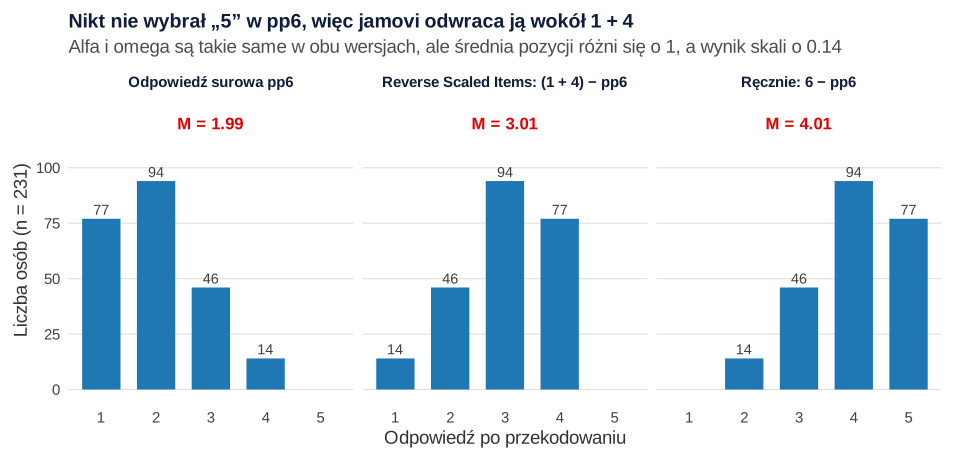
Alfa i omega wychodzą w obu sposobach identyczne. Średnie mogą się jednak różnić. Kod pakietu jmv odwraca pozycję wokół sumy najmniejszej i największej wartości występującej w danych, a nie końców skali (Selker i in., 2025). W pp3 odpowiedzi obejmują 1–5, więc wynik to 6 − pp3, tak jak przy ręcznym przekodowaniu. W pp6 nikt nie wybrał 5, więc jamovi liczy (1 + 4) − pp6 = 5 − pp6. Przy przekodowaniu 6 - $source średnia pp6 wynosi 4.013, w polu Reverse Scaled Items – 3.013. Wynik skali przesuwa się z 3.459 do 3.316 (rysunek 2).
Praktyczna rada: pole Reverse Scaled Items wystarczy do sprawdzenia rzetelności. Jeśli wynik skali trafi do dalszych analiz albo porównujesz go z normami, przekoduj pozycje formułą z końcami skali (6 - $source dla 1–5). Wtedy wynik nie zależy od tego, czy ktoś w Twojej próbie wybrał skrajną odpowiedź.
Liczebność, braki danych i zapis wyniku skali
Tabele jamovi nie podają liczby osób, na których policzono alfę. Kod analizy usuwa każdą osobę z brakiem w którejkolwiek z wybranych pozycji (Selker i in., 2025), czyli stosuje usuwanie przypadków listwise. W przykładzie analiza objęła 231 z 240 osób. Sprawdziliśmy to, licząc tę samą analizę tylko na osobach z kompletem odpowiedzi – wyszło identycznie (α = .798, ω = .805). Liczbę osób z kompletem odpowiedzi odczytasz z Descriptives albo z filtra, a w pracy podaj ją obok alfy.
Sekcja Save dodaje do arkusza kolumnę Mean Score lub Sum Score. W kodzie jmv zapis korzysta z tych samych danych co tabele (Selker i in., 2025). Wynika z tego, że:
- pozycje z listy Reverse Scaled Items wchodzą do wyniku odwrócone w opisany wyżej sposób (min + max z danych);
- dziewięć osób z jednym brakiem dostanie pustą komórkę, choć odpowiedziały na sześć z siedmiu pytań.
Jeśli zasady kwestionariusza dopuszczają wynik przy pojedynczym braku, policz go zmienną obliczaną z funkcją MEAN(...). Kod funkcji w repozytorium jamovi ma argumenty ignore_missing i min_valid, np. MEAN(pp1, pp2, pp3r, pp4, pp5, pp6r, pp7, min_valid = 6). Zanim go użyjesz, sprawdź opis funkcji w swojej wersji programu (przycisk fx w edytorze zmiennej) i zasady autorów kwestionariusza.
Alfa czy omega – co dokładnie liczy jamovi
Alfa zakłada, że wszystkie pozycje są jednakowo silnie związane z mierzoną cechą (model tau-ekwiwalentny) i mają nieskorelowane błędy. McNeish (2018) pokazuje, że w praktyce te założenia zwykle nie są spełnione i alfa zaniża rzetelność. Hayes i Coutts (2020) przypominają, że metodolodzy uważają omegę za lepszą miarę niż alfa. W przykładzie ładunki są różne, od wysokich (pp1) po niski (pp7), dlatego omega (.805) jest nieco wyższa od alfy (.798).
Omega ma jednak kilka odmian. Flora (2020) pokazuje, że właściwą wybiera się na podstawie modelu czynnikowego skali. Revelle i Condon (2019) zalecają ωt i ωh. jamovi podaje jedną wartość. Kod jmv liczy ją funkcją omega() pakietu psych z jednym czynnikiem (metoda minres, macierz korelacji Pearsona) i przepisuje omegę całkowitą (Selker i in., 2025). Taka omega ma sens, gdy skala jest jednowymiarowa. Jeśli kwestionariusz ma podskale albo nie wiesz, czy pozycje mierzą jedną cechę, najpierw zrób analizę czynnikową. Jak ją przeprowadzić w tym samym programie, pokazuje wpis analiza czynnikowa w jamovi.
W porównaniu z SPSS jamovi nie podaje alfy dla pozycji standaryzowanych ani przedziału ufności dla alfy i omegi. W analizie Reliability Analysis pakietu jmv 2.7.7 nie ma takich opcji (Selker i in., 2025). Gdy znasz ładunki z analizy czynnikowej, omegę możesz sprawdzić w kalkulatorze alfy i omegi.
Czy usunąć pozycję pp7?
Rysunek 3 zestawia kolumny If item dropped z wartościami dla całej skali. Wniosek z obu miar jest ten sam: tylko pp7 obniża rzetelność.
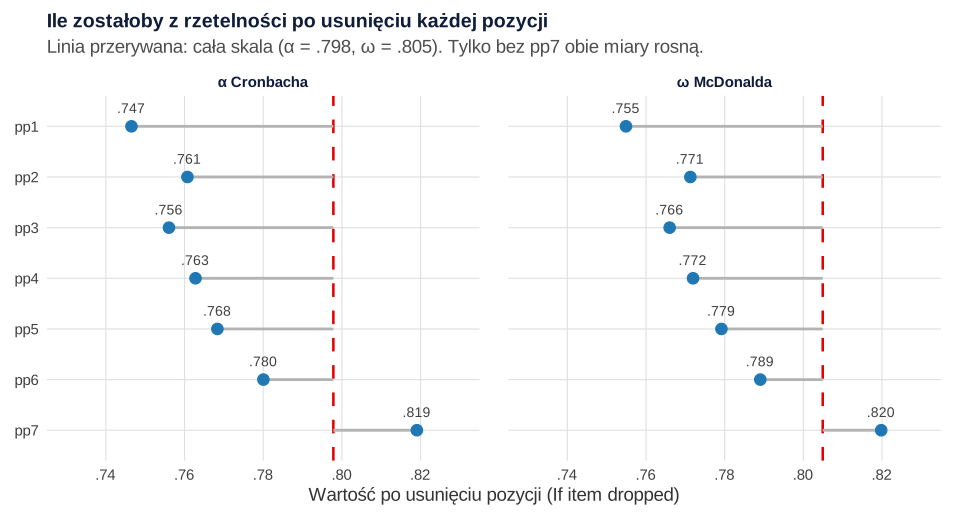
Różnica jest niewielka: .798 wobec .819. Zanim usuniesz pozycję, odpowiedz na pytania z wpisu o SPSS: czy to opublikowane narzędzie, co mówi treść pozycji i czy opiszesz zmianę. W gotowym kwestionariuszu zwykle zostawiasz wszystkie pozycje i opisujesz słabszą pozycję w dyskusji. Jeśli alfa wychodzi wyraźnie niska, zajrzyj do wpisu alfa Cronbacha poniżej .70 – co zrobić. Nie usuwaj pozycji po kolei, aż alfa przestanie rosnąć.
Zapis APA
Rzetelność opisujesz w podrozdziale o narzędziach. Pisz dwa miejsca po przecinku, bez zera przed kropką. Liczbę osób podaj sam(a), bo jamovi jej nie pokazuje:
Gdy masz kilka skal, zbierz alfy i omegi w jednej tabeli (wzór w haśle tabela rzetelności w APA). Wynik skali posłuży potem np. w teście t w jamovi albo w korelacji i regresji w jamovi. Kolejne wyniki opisze generator opisu wyników APA, a test dobierze kreator doboru testu. Rachunek alfy na papierze przećwiczysz w zadaniach z psychometrii.
To samo w R (jmv)
Każda analiza jamovi jest funkcją pakietu jmv, więc ten sam wynik dostaniesz w R. Kod tworzy dane i pliki do pobrania, a potem uruchamia descriptives() i reliability() z opcjami odpowiadającymi polom okna: omegaScale to McDonald's ω, itemRestCor to Item-rest correlation, alphaItems i omegaItems to kolumny If item dropped, a revItems to lista Reverse Scaled Items (The jamovi project, b.d.). Wynik różni się od ekranu jamovi tylko liczbą miejsc po przecinku. Zapis !!poz przekazuje funkcji wektor nazw pozycji.
1. Rzetelność skali przez jmv::reliability()
R
# B412 – alfa Cronbacha i omega McDonalda w jamovi: te same analizy w R przez pakiet jmv
# Dane symulowane, set.seed(4120): 240 osób studiujących, skala poczucia przynależności
# do uczelni (pp1–pp7, odpowiedzi 1–5), pozycje pp3 i pp6 sformułowane odwrotnie, braki u 9 osób.
suppressPackageStartupMessages({ library(jmv); library(haven) })
set.seed(4120)
n <- 240
f <- rnorm(n)                                         # poczucie przynależności (cecha ukryta)
ladunki <- c(.78, .74, -.70, .68, .62, -.58, .36)     # pp3 i pp6 – pozycje odwrócone
progi <- list(c(-1.6, -.6, .3, 1.2), c(-1.6, -.6, .3, 1.2), c(-1.5, -.5, .4, 1.3), c(-1.6, -.6, .3, 1.2),
              c(-1.6, -.6, .3, 1.2), c(-.9, .1, 1.0, 9), c(-1.6, -.6, .3, 1.2))
przes <- c(.3, .3, -.2, .3, .2, -.6, .1)
X <- sapply(1:7, function(j) {
  x <- ladunki[j] * f + rnorm(n, sd = sqrt(1 - ladunki[j]^2)) + przes[j]
  findInterval(x, progi[[j]]) + 1
})
colnames(X) <- paste0("pp", 1:7)
pp <- as.data.frame(X)
braki <- cbind(sample(n, 9), sample(1:7, 9, replace = TRUE))
for (i in 1:9) pp[braki[i, 1], braki[i, 2]] <- NA
dane <- data.frame(id = 1:n, rok = sample(1:3, n, replace = TRUE), pp)

# Zapis danych do pobrania: CSV oraz .sav z etykietami zmiennych i wartości
write.csv(dane, "../alfa-cronbacha-i-omega-w-jamovi-dane.csv", row.names = FALSE, na = "")
etyk <- c("zdecydowanie się nie zgadzam" = 1, "raczej się nie zgadzam" = 2, "ani tak, ani nie" = 3,
          "raczej się zgadzam" = 4, "zdecydowanie się zgadzam" = 5)
opisy <- c(pp1 = "Czuję się częścią społeczności mojej uczelni", pp2 = "Na uczelni mam osoby, na które mogę liczyć",
           pp3 = "Na uczelni czuję się obco (odwrócona)", pp4 = "Jestem dumny/dumna, że tu studiuję",
           pp5 = "Prowadzący traktują mnie jak członka społeczności", pp6 = "Myślę o przeniesieniu się na inną uczelnię (odwrócona)",
           pp7 = "Biorę udział w wydarzeniach uczelni")
sav <- dane
attr(sav$id, "label") <- "Numer osoby"
sav$rok <- labelled_spss(as.numeric(sav$rok), labels = c("I rok" = 1, "II rok" = 2, "III rok" = 3), label = "Rok studiów")
for (v in names(opisy)) sav[[v]] <- labelled_spss(as.numeric(sav[[v]]), labels = etyk, label = opisy[[v]])
write_sav(sav, "../alfa-cronbacha-i-omega-w-jamovi-dane.sav")

poz <- paste0("pp", 1:7)                              # nazwy pozycji; w funkcjach jmv podajemy je jako !!poz

# 1. Kontrola danych: Exploration → Descriptives (liczba braków, minimum i maksimum pozycji)
descriptives(dane, vars = !!poz, median = FALSE)

# 2. Błąd: wszystkie pozycje bez wskazania odwróconych (Factor → Reliability Analysis)
reliability(dane, vars = !!poz, omegaScale = TRUE, itemRestCor = TRUE)

# 3. Właściwa analiza: pp3 i pp6 w polu Reverse Scaled Items, wszystkie statystyki skali i pozycji
rel <- reliability(dane, vars = !!poz, alphaScale = TRUE, omegaScale = TRUE, meanScale = TRUE, sdScale = TRUE,
                   meanItems = TRUE, sdItems = TRUE, itemRestCor = TRUE, alphaItems = TRUE, omegaItems = TRUE,
                   revItems = c("pp3", "pp6"))
rel

# 4. Te same pozycje odwrócone ręcznie (Transformed Variables: 6 - $source)
dane$pp3r <- 6 - dane$pp3
dane$pp6r <- 6 - dane$pp6
reliability(dane, vars = c("pp1", "pp2", "pp3r", "pp4", "pp5", "pp6r", "pp7"),
            omegaScale = TRUE, meanScale = TRUE, sdScale = TRUE, meanItems = TRUE)

# 5. Ile osób weszło do analizy: jmv usuwa osoby z brakiem w którejkolwiek pozycji (listwise)
kompletne <- complete.cases(dane[poz])
table(kompletne)
reliability(dane[kompletne, ], vars = !!poz, omegaScale = TRUE, revItems = c("pp3", "pp6"))

# 6. Skala bez pozycji pp7 (sprawdzenie kolumn "If item dropped")
reliability(dane, vars = !!poz[-7], omegaScale = TRUE, revItems = c("pp3", "pp6"))
Wynik w R
 DESCRIPTIVES

 Descriptives
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────
                         pp1         pp2         pp3         pp4         pp5         pp6          pp7
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────
   N                          239         239         240         239         237          239         238
   Missing                      1           1           0           1           3            1           2
   Mean                  3.422594    3.539749    2.804167    3.497908    3.375527     1.966527    3.222689
   Standard deviation    1.092984    1.035854    1.062475    1.080283    1.056814    0.8833954    1.045782
   Minimum               1.000000    1.000000    1.000000    1.000000    1.000000     1.000000    1.000000
   Maximum               5.000000    5.000000    5.000000    5.000000    5.000000     4.000000    5.000000
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ─────────────────────────────────────────
            Cronbach's α    McDonald's ω
 ─────────────────────────────────────────
   scale       0.1593637       0.4366197
 ─────────────────────────────────────────
   Note. items 'pp3' and 'pp6'
   correlate negatively with the total
   scale and probably should be
   reversed


 Item Reliability Statistics
 ────────────────────────────────
          Item-rest correlation
 ────────────────────────────────
   pp1                0.3436563
   pp2                0.3823334
   pp3               -0.5318995
   pp4                0.3352415
   pp5                0.4046668
   pp6               -0.3876664
   pp7                0.1670991
 ────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ──────────────────────────────────────────────────────────────────
            Mean        SD           Cronbach's α    McDonald's ω
 ──────────────────────────────────────────────────────────────────
   scale    3.316017    0.6978612       0.7978346       0.8049247
 ──────────────────────────────────────────────────────────────────


 Item Reliability Statistics
 ───────────────────────────────────────────────────────────────────────────────────────────
            Mean        SD           Item-rest correlation    Cronbach's α    McDonald's ω
 ───────────────────────────────────────────────────────────────────────────────────────────
   pp1      3.424242    1.0883259                0.6551878       0.7465041       0.7549052
   pp2      3.528139    1.0374867                0.5867685       0.7607375       0.7712724
   pp3 ᵃ    3.168831    1.0599745                0.6097871       0.7560355       0.7660090
   pp4      3.502165    1.0789466                0.5745539       0.7627846       0.7719571
   pp5      3.363636    1.0538842                0.5460137       0.7683524       0.7791765
   pp6 ᵃ    3.012987    0.8820949                0.4835905       0.7800479       0.7890521
   pp7      3.212121    1.0521325                0.2615358       0.8190640       0.8197852
 ───────────────────────────────────────────────────────────────────────────────────────────
   ᵃ reverse scaled item


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ──────────────────────────────────────────────────────────────────
            Mean        SD           Cronbach's α    McDonald's ω
 ──────────────────────────────────────────────────────────────────
   scale    3.458874    0.6978612       0.7978346       0.8049247
 ──────────────────────────────────────────────────────────────────


 Item Reliability Statistics
 ───────────────────────────
           Mean
 ───────────────────────────
   pp1     3.424242
   pp2     3.528139
   pp3r    3.168831
   pp4     3.502165
   pp5     3.363636
   pp6r    4.012987
   pp7     3.212121
 ───────────────────────────

kompletne
FALSE  TRUE
    9   231

 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ─────────────────────────────────────────
            Cronbach's α    McDonald's ω
 ─────────────────────────────────────────
   scale       0.7978346       0.8049247
 ─────────────────────────────────────────


 RELIABILITY ANALYSIS

 Scale Reliability Statistics
 ─────────────────────────────────────────
            Cronbach's α    McDonald's ω
 ─────────────────────────────────────────
   scale       0.8187991       0.8195288
 ─────────────────────────────────────────
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Pakiet jmv wywołuje funkcje alpha(), omega() i principal() z pakietu psych. W pracy podaj wersję jamovi, w której liczysz rzetelność (menu programu), a jeśli liczysz w R – wersje pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://CRAN.R-project.org/package=jmv
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org (rysunki)
Najczęstsze błędy przy alfie i omedze w jamovi
- Pozycje odwrócone pominięte w analizie. W przykładzie alfa spadła z .798 do .159. Uwaga pod tabelą skali to sygnał, którego nie wolno pominąć.
- Odwrócenie dwa razy. Jeśli przekodowałeś(-aś) pozycję w danych, nie wpisuj jej już do Reverse Scaled Items.
- Średnia skali z pola Reverse Scaled Items użyta jako wynik do norm, gdy w którejś pozycji nikt nie wybrał skrajnej odpowiedzi.
- Pełne N w pracy zamiast liczby osób z kompletem odpowiedzi.
- Jedna alfa dla całego kwestionariusza z podskalami zamiast osobnej dla każdej podskali.
- Omega z jamovi dla skali wielowymiarowej. Wartość z jednoczynnikowego modelu nie opisuje wtedy dobrze rzetelności.
Jeśli chcesz, żeby ktoś sprawdził Twoją analizę rzetelności i dalsze analizy, zajrzyj do oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Gdzie w jamovi jest alfa Cronbacha i omega McDonalda?
W zakładce Analyses wybierz Factor → Reliability Analysis (grupa Scale Analysis). Pozycje skali przenieś do pola Items. Alfa Cronbacha jest zaznaczona domyślnie, a omegę dodasz polem McDonald's ω w grupie Scale Statistics. Obie wartości pojawią się w tabeli Scale Reliability Statistics.
Jak w jamovi odwrócić pozycje przed policzeniem alfy?
Najprościej w oknie Reliability Analysis: rozwiń Reverse Scaled Items i przenieś tam pozycje sformułowane odwrotnie. Do dalszych analiz lepiej jednak przekodować je w danych zmienną przekształconą z formułą 6 - $source (dla skali 1–5). Pole w oknie analizy odwraca pozycję względem najmniejszej i największej odpowiedzi w danych, co zmienia średnią, gdy nikt nie wybrał skrajnej odpowiedzi.
Na ilu osobach jamovi liczy alfę Cronbacha, gdy są braki danych?
Tylko na osobach z kompletem odpowiedzi we wszystkich wybranych pozycjach – kod analizy usuwa resztę całymi wierszami. Tabele tej liczby nie pokazują. Policz ją sam(a), np. z wiersza Missing w Descriptives albo filtrem, i podaj w pracy obok alfy. W przykładzie było to 231 z 240 osób.
Którą omegę McDonalda podaje jamovi?
Omegę całkowitą z modelu z jednym czynnikiem, liczoną funkcją omega() pakietu psych na macierzy korelacji pozycji. Taka wartość dobrze opisuje skalę jednowymiarową. Przy kwestionariuszu z podskalami licz omegę osobno dla każdej podskali i najpierw sprawdź strukturę w analizie czynnikowej.
Jak zapisać wynik skali jako nową zmienną w jamovi?
W oknie Reliability Analysis rozwiń sekcję Save i zaznacz Mean score albo Sum score – jamovi doda kolumnę z wynikiem. Osoby z brakiem w którejkolwiek pozycji dostaną pustą komórkę, a pozycje z listy Reverse Scaled Items wejdą odwrócone względem zakresu odpowiedzi w danych. Jeśli chcesz kontrolować te zasady, policz wynik zmienną obliczaną z funkcją MEAN.
Powiązane hasła
Przeczytaj też
Alfa Cronbacha w SPSS krok po kroku
Reliability Analysis od okna Statistics po tabelę Item-Total Statistics: co zaznaczyć, co przepisać do pracy, ICC w tym samym oknie, składnia i plik .sav do ćwiczeń.
Czytaj →PoradnikAnaliza czynnikowa w jamovi
EFA i CFA w jamovi na jednym przykładzie: ustawienia, tabele do czytania, ukryte ładunki, rzetelność, opis APA i te same wyniki w R.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Liczysz rzetelność w jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy przygotowanie pozycji, ustawienia analizy rzetelności i dobór dalszych analiz oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Flora, D. B. (2020). Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates. Advances in Methods and Practices in Psychological Science, 3(4), 484–501. https://doi.org/10.1177/2515245920951747 ● Otwarty dostęp
- Hayes, A. F., & Coutts, J. J. (2020). Use omega rather than Cronbach’s alpha for estimating reliability. But…. Communication Methods and Measures, 14(1), 1–24. https://doi.org/10.1080/19312458.2020.1718629
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Revelle, W., & Condon, D. M. (2019). Reliability from α to ω: A tutorial. Psychological Assessment, 31(12), 1395–1411. https://doi.org/10.1037/pas0000754 ● Otwarty dostęp
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.). jamovi documentation: Data Variables, Transformed Variables, Common Data Recipes, Reliability Analysis (jmv) and Comparison of analyses available in SPSS and jamovi. jamovi documentation. https://docs.jamovi.org/jmv/jmv_reliability.html ● Otwarty dostęp
Cytowania BibTeX
@article{flora2020your, author={Flora, David B.}, title={{Your coefficient alpha is probably wrong, but which coefficient omega is right? A tutorial on using R to obtain better reliability estimates}}, journal={Advances in Methods and Practices in Psychological Science}, year={2020}, volume={3}, number={4}, pages={484--501}, doi={10.1177/2515245920951747}}@article{hayes2020use, author={Hayes, Andrew F. and Coutts, Jacob J.}, title={{Use omega rather than Cronbach’s alpha for estimating reliability. But…}}, journal={Communication Methods and Measures}, year={2020}, volume={14}, number={1}, pages={1--24}, doi={10.1080/19312458.2020.1718629}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{revelle2019reliability, author={Revelle, William and Condon, David M.}, title={{Reliability from α to ω: A tutorial}}, journal={Psychological Assessment}, year={2019}, volume={31}, number={12}, pages={1395--1411}, doi={10.1037/pas0000754}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@misc{jamovi2026rzetelnoscdocs, author={{The jamovi project}}, title={{jamovi documentation: Data Variables, Transformed Variables, Common Data Recipes, Reliability Analysis (jmv) and Comparison of analyses available in SPSS and jamovi}}, howpublished={jamovi documentation}, year={b.d.}, publisher={The jamovi project}, url={https://docs.jamovi.org/jmv/jmv_reliability.html}}