Psychometria – zadania z rozwiązaniami: jak z nich korzystać
Poniżej znajdziesz psychometrię – zadania z rozwiązaniami w formie, w jakiej pojawiają się na kolokwium z psychometrii lub diagnozy psychologicznej: mała tabela odpowiedzi kilku osób albo gotowe parametry testu z podręcznika. Zadania idą od rzetelności skali (alfa Cronbacha, analiza pozycji, omega) przez błąd pomiaru u jednej osoby i wiarygodną zmianę po terapii do norm, długości testu i korekty na atenuację.
Każde zadanie ma ten sam układ: treść, rozwiązanie krok po kroku, interpretacja i typowy błąd. Rzetelność, korelacje i wskaźniki pozycji podajemy do trzech miejsc po kropce bez zera wiodącego (np. α = .868), pozostałe wyniki do dwóch miejsc. Wszystkie liczby sprawdziliśmy w R (kod na końcu wpisu); inna ostatnia cyfra przy liczeniu na kalkulatorze to zwykle skutek zaokrągleń pośrednich. Zbiór nie powtarza zadania 2 z zadań ze statystyki na psychologii (wynik surowy na z, IQ, sten i centyl) – tu liczysz normy z rangi centylowej i porównujesz je z przeliczeniem liniowym.
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | skala lęku przed wystąpieniami, 5 pozycji, 8 osób | wariancje pozycji i sumy, alfa Cronbacha |
| 2 | te same dane | alfa po usunięciu pozycji |
| 3 | te same dane | korelacja pozycja–reszta (moc dyskryminacyjna pozycji) |
| 4 | test wiedzy z metodologii, 6 pytań 0/1, 10 studentów | wskaźnik trudności, wskaźnik dyskryminacji D, KR-20 |
| 5 | skala wsparcia społecznego, podane ładunki | omega McDonalda i alfa z ładunków |
| 6 | kwestionariusz neurotyczności, jedna osoba | błąd standardowy pomiaru, przedział dla wyniku prawdziwego |
| 7 | 6 pacjentów przed i po terapii | wskaźnik wiarygodnej zmiany (RCI) |
| 8 | skala objawów z prawoskośnymi normami | wynik T, sten i stanin liniowo i z rangi centylowej |
| 9 | test 20 pozycji | wzór Spearmana–Browna: wydłużenie, skrócenie, potrzebna liczba pozycji |
| 10 | perfekcjonizm a wypalenie | korekta na atenuację |
Odpowiedzi z zadań 1–4 i wyniki pacjentów z zadania 7 pobierzesz w pliku psychometria-zadania-dane.csv (format długi: zadanie, osoba, zmienna, wartość) – przyda się do ćwiczeń w R, SPSS lub jamovi.
Zadanie 1. Alfa Cronbacha ręcznie z wariancji pozycji i sumy
Treść zadania
W badaniu pilotażowym 8 studentów wypełniło 5-pozycyjną skalę lęku przed wystąpieniami publicznymi (odpowiedzi 1–5, wyższy wynik = większy lęk). Oblicz alfę Cronbacha.
| Osoba | p1 | p2 | p3 | p4 | p5 | Suma |
|---|---|---|---|---|---|---|
| 1 | 4 | 5 | 4 | 4 | 2 | 19 |
| 2 | 2 | 2 | 3 | 2 | 4 | 13 |
| 3 | 5 | 4 | 5 | 5 | 3 | 22 |
| 4 | 3 | 3 | 2 | 3 | 2 | 13 |
| 5 | 1 | 2 | 1 | 2 | 3 | 9 |
| 6 | 4 | 4 | 5 | 3 | 5 | 21 |
| 7 | 2 | 1 | 2 | 2 | 2 | 9 |
| 8 | 3 | 4 | 3 | 4 | 4 | 18 |
| Wariancja | 1.714 | 1.839 | 2.125 | 1.268 | 1.268 | 26.857 |
Rozwiązanie krok po kroku
Krok 1. Wariancje pozycji. Dla każdej kolumny policz wariancję z próby (dzielnik n − 1 = 7). Np. p1: średnia 3.00, kwadraty odchyleń 1, 1, 4, 0, 4, 1, 1, 0 – suma 12, więc s² = 12 / 7 = 1.714. Suma wariancji pięciu pozycji: Σsi² = 8.214.
Krok 2. Wariancja sumy. Średnia sumy wynosi 15.50, a jej wariancja sX² = 26.857 (ten sam dzielnik 7).
Krok 3. Wzór na alfę (Cronbach, 1951), k = 5 pozycji:
Krok 4. Kontrola. Średnia korelacja między pozycjami wynosi .549, a alfa standaryzowana kr̄ / [1 + (k − 1)r̄] = .859 – blisko alfy z wariancji, bo pozycje mają podobne wariancje.
Interpretacja
Alfa mierzy spójność wewnętrzną, a przy 8 osobach jest oszacowaniem bardzo niepewnym. Pełny przykład z przedziałem ufności znajdziesz we wpisie alfa Cronbacha – rzetelność skali.
Typowy błąd
Mieszanie dzielników: wariancje pozycji z n − 1, a wariancja sumy z n. Wtedy wychodzi .813 zamiast .868. Wybierz jeden dzielnik i stosuj go wszędzie – przy jednolitym wyborze wynik jest identyczny.
Zadanie 2. Alfa po usunięciu pozycji
Treść zadania
Dla danych z zadania 1 oblicz alfę skali po usunięciu każdej pozycji. Którą pozycję warto przejrzeć? Policz krok po kroku wariant bez p5.
Rozwiązanie krok po kroku
Krok 1. Skala bez p5. Zostają 4 pozycje. Suma ich wariancji: 1.714 + 1.839 + 2.125 + 1.268 = 6.946. Nowa suma punktów (bez p5) ma wariancję 23.411.
Krok 2. Pozostałe pozycje liczysz tak samo. Wyniki zebrano w tabeli.
| Pozycja | Wariancja sumy bez pozycji | Alfa po usunięciu | Korelacja pozycja–reszta | Korelacja z sumą (z pozycją) |
|---|---|---|---|---|
| p1 | 16.000 | .792 | .873 | .926 |
| p2 | 16.268 | .811 | .800 | .884 |
| p3 | 14.839 | .786 | .881 | .936 |
| p4 | 18.268 | .826 | .761 | .845 |
| p5 | 23.411 | .938 | .200 | .404 |
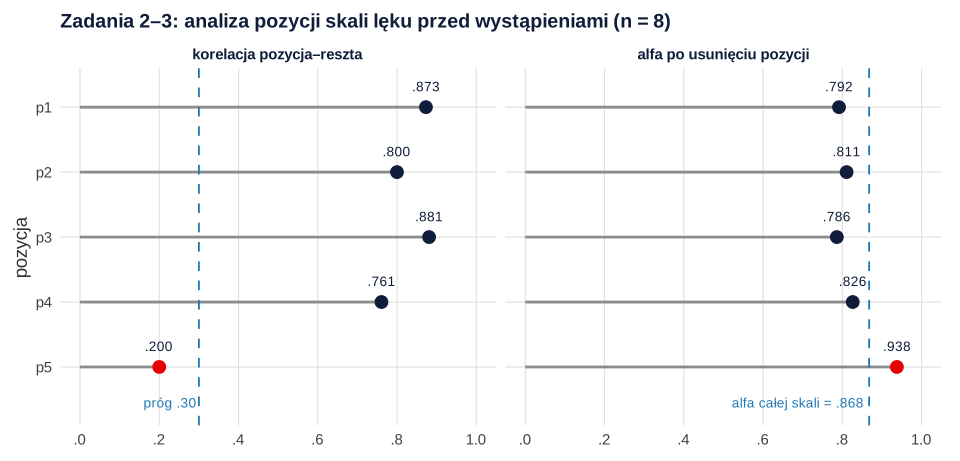
Krok 3. Porównanie z alfą całej skali (.868). Usunięcie p1–p4 obniża alfę (do .786–.826), a usunięcie p5 ją podnosi (do .938). Kandydatem do przejrzenia jest p5.
Interpretacja
Pozycja p5 słabo pasuje do pozostałych – jej korelacje z p1–p4 wynoszą .097, .175, .424 i −.014. Zanim ją usuniesz, sprawdź treść (może mierzy inny aspekt, np. tempo mówienia, a nie lęk), czy nie jest pozycją odwróconą bez przekodowania i czy wynik powtarza się w większej próbie. Decyzja o skróceniu skali wpływa na trafność treściową, nie tylko na rzetelność.
Typowy błąd
Usuwanie pozycji „po kolei, dopóki alfa rośnie”. Po usunięciu p5 dalsze usunięcie p4 obniża alfę do .924, a przy 8 osobach różnice rzędu kilku setnych są w granicach przypadku. Kolumna „alfa po usunięciu” to wskazówka do przejrzenia pozycji, a nie automatyczna reguła.
Zadanie 3. Korelacja pozycja–reszta, czyli moc dyskryminacyjna pozycji
Treść zadania
Dla tych samych danych oblicz korelację każdej pozycji z sumą pozostałych pozycji (pozycja–reszta) oraz – dla porównania – z sumą wszystkich pozycji. Dlaczego te dwie liczby się różnią? Która pozycja nie spełnia orientacyjnego progu .30?
Rozwiązanie krok po kroku
Krok 1. Reszta skali. Dla p5 reszta to suma p1–p4: 17, 9, 19, 11, 6, 16, 7, 14 (suma całej skali minus p5).
Krok 2. Korelacja Pearsona p5 z resztą: r = .200. Analogicznie dla pozostałych pozycji: .873, .800, .881, .761 (tabela w zadaniu 2).
Krok 3. Wersja nieskorygowana. Korelacja p5 z sumą, która zawiera p5, wynosi .404 – dwa razy więcej. Pozycja koreluje sama ze sobą, więc ta wersja zawyża moc dyskryminacyjną pozycji, najbardziej przy krótkich skalach.
Interpretacja
Próg .30 (czasem .20) to reguła orientacyjna, a nie twarde kryterium. Jak budować skalę z analizą pozycji na dużej próbie, opisuje wpis budowa i walidacja skali psychometrycznej.
Typowy błąd
Raportowanie korelacji pozycji z całą sumą zamiast z resztą. W SPSS i w psych::alpha() szukaj kolumny „skorygowana korelacja pozycji z całością” (r.drop), nie zwykłej korelacji z sumą.
Zadanie 4. Trudność i moc dyskryminacyjna pytań testu wiedzy
Treść zadania
Prowadzący dał 10 studentom krótki test z metodologii: 6 pytań, 1 = odpowiedź poprawna, 0 = błędna. Oblicz dla każdego pytania wskaźnik trudności pi i wskaźnik dyskryminacji D (grupa górna = 3 najlepszych, dolna = 3 najsłabszych), a potem rzetelność testu wzorem KR-20.
| Student | z1 | z2 | z3 | z4 | z5 | z6 | Wynik |
|---|---|---|---|---|---|---|---|
| 1 | 1 | 1 | 1 | 1 | 1 | 1 | 6 |
| 2 | 1 | 1 | 1 | 1 | 1 | 0 | 5 |
| 3 | 1 | 1 | 1 | 0 | 1 | 0 | 4 |
| 4 | 1 | 1 | 0 | 1 | 0 | 0 | 3 |
| 5 | 1 | 0 | 1 | 0 | 1 | 0 | 3 |
| 6 | 1 | 1 | 0 | 1 | 0 | 0 | 3 |
| 7 | 1 | 0 | 0 | 1 | 1 | 0 | 3 |
| 8 | 0 | 0 | 0 | 0 | 0 | 1 | 1 |
| 9 | 1 | 0 | 0 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 | 0 | 1 | 2 |
Rozwiązanie krok po kroku
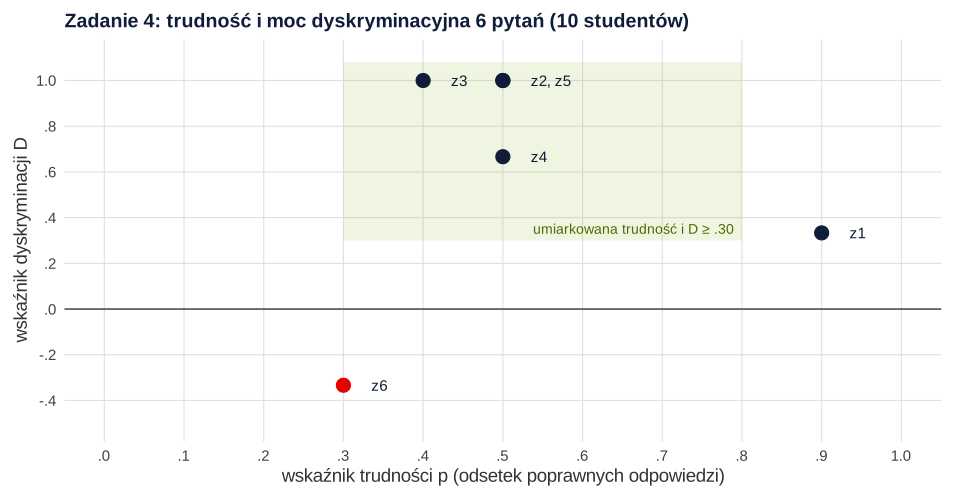
Krok 1. Trudność. pi to odsetek poprawnych odpowiedzi (im wyższy, tym pytanie łatwiejsze). Dla z1: 9/10 = .900; dalej .500, .400, .500, .500, .300.
Krok 2. Grupy skrajne. Grupa górna: studenci 1–3 (wyniki 6, 5, 4); dolna: studenci 8, 9, 10 (wyniki 1, 1, 2). Granice grup nie przecinają remisów, więc podział jest jednoznaczny.
Krok 3. Dyskryminacja D = pgórna − pdolna.
| Pytanie | pi | p w grupie górnej | p w grupie dolnej | D | Korelacja pozycja–reszta |
|---|---|---|---|---|---|
| z1 | .900 | 1.000 | .667 | .333 | .286 |
| z2 | .500 | 1.000 | .000 | 1.000 | .500 |
| z3 | .400 | 1.000 | .000 | 1.000 | .550 |
| z4 | .500 | .667 | .000 | .667 | .312 |
| z5 | .500 | 1.000 | .000 | 1.000 | .500 |
| z6 | .300 | .333 | .667 | −.333 | −.327 |
Krok 4. KR-20 (szczególny przypadek alfy dla pytań 0/1; Cronbach, 1951). Σp(1 − p) = 1.290; wariancja wyników liczona z dzielnikiem n (jak pq) wynosi 2.290:
Interpretacja
Pytania z2, z3 i z5 dobrze różnicują studentów. z1 jest bardzo łatwe – niewiele mówi o różnicach w wiedzy. z6 ma ujemne D: częściej odpowiadali na nie poprawnie słabsi studenci, co zwykle oznacza błędny klucz, dwuznaczne sformułowanie albo zgadywanie. Po usunięciu z6 KR-20 rośnie z .524 do .723. Orientacyjne progi (pi ok. .30–.80, D ≥ .30) to reguły robocze; w dużych testach analizę pozycji robi się często w modelu IRT.
Typowy błąd
Łączenie pq (wariancja z dzielnikiem n) z wariancją wyników z dzielnikiem n − 1: wychodzi .592 zamiast .524. Drugi błąd to nazywanie pi „trudnością” i czytanie go odwrotnie – wysoki pi oznacza pytanie łatwe.
Zadanie 5. Omega McDonalda z ładunków standaryzowanych
Treść zadania
W konfirmacyjnej analizie czynnikowej 6-pozycyjnej skali wsparcia społecznego otrzymano standaryzowane ładunki: .72, .65, .80, .55, .70, .45. Zakładając model jednoczynnikowy bez skorelowanych błędów, oblicz omegę McDonalda i porównaj ją z alfą standaryzowaną wynikającą z tych samych ładunków.
Rozwiązanie krok po kroku
Krok 1. Suma ładunków i jej kwadrat. Σλ = 3.87; (Σλ)² = 14.977.
Krok 2. Wariancje błędów przy ładunkach standaryzowanych: 1 − λ² = 0.482, 0.577, 0.360, 0.698, 0.510, 0.797; suma 3.424.
Krok 3. Alfa z ładunków. Model przewiduje korelacje rij = λiλj; ich średnia to .413, a alfa standaryzowana 6 × .413 / (1 + 5 × .413) = .809.
Interpretacja
Omega (McDonald, 1999) nie zakłada równych ładunków, dlatego jest zalecana zamiast alfy, gdy pozycje różnią się siłą związku z czynnikiem (Dunn i in., 2014). Tu ładunki różnią się umiarkowanie, więc obie miary prawie się pokrywają (.814 vs .809); przy równych ładunkach (średnia .645) omega spadłaby do .810, czyli praktycznie do alfy. Obliczenia sprawdzisz w kalkulatorze alfy i omegi.
Typowy błąd
Wstawianie do wzoru ładunków niestandaryzowanych razem z 1 − λ² albo pomijanie kwadratu w liczniku. Drugi błąd: liczenie jednej omegi dla skali wielowymiarowej – wzór dotyczy modelu jednoczynnikowego.
Zadanie 6. Błąd standardowy pomiaru i przedział dla wyniku prawdziwego
Treść zadania
Kwestionariusz neurotyczności ma w normach M = 24, SD = 6 i rzetelność rxx = .84. Osoba uzyskała 33 punkty. Oblicz błąd standardowy pomiaru (SEM) oraz 68%, 90% i 95% przedział wokół wyniku obserwowanego. Następnie oszacuj wynik prawdziwy metodą Kelleya. Czy można z pewnością powiedzieć, że wynik przekracza próg „wysoki” (M + 1 SD = 30)?
Rozwiązanie krok po kroku
Krok 1. SEM.
Krok 2. Przedziały wokół wyniku obserwowanego (X ± z × SEM):
| Poziom | z | Przedział |
|---|---|---|
| 68% | 0.994 | [30.61, 35.39] |
| 90% | 1.645 | [29.05, 36.95] |
| 95% | 1.960 | [28.30, 37.70] |
Krok 3. Wynik prawdziwy oszacowany (Kelley). Wynik obserwowany „cofa się” ku średniej proporcjonalnie do rzetelności:
błąd estymacji = SD × √[rxx(1 − rxx)] = 6 × √(.84 × .16) = 2.20 → 95%: [27.25, 35.87]
Interpretacja
Z 95% pewnością wynik prawdziwy mieści się w przybliżeniu między 28 a 38 punktami. Dolna granica (28.30) leży poniżej progu 30, więc nie można stanowczo twierdzić, że osoba ma wynik wysoki – można powiedzieć „wynik wysoki lub przeciętny”. Przy słabszej rzetelności (.70) SEM rośnie do 3.29, a 95% przedział rozszerza się do [26.56, 39.44].
Typowy błąd
Mylenie SEM z błędem standardowym średniej (SD / √n). SEM dotyczy pojedynczej osoby i nie maleje, gdy przebadasz więcej osób – zależy tylko od SD i rzetelności testu.
Zadanie 7. Wskaźnik wiarygodnej zmiany (RCI) przed i po terapii
Treść zadania
Sześciu pacjentów wypełniło skalę objawów depresyjnych (0–63, wyższy wynik = więcej objawów) przed terapią i po niej. Odchylenie standardowe wyników przed terapią wynosi 7.5, a rzetelność test–retest .86. Dla każdego pacjenta oblicz RCI według Jacobsona i Truaxa (1991) i oceń, czy zmiana jest wiarygodna (|RCI| ≥ 1.96).
Rozwiązanie krok po kroku
Krok 1. SEM i błąd różnicy.
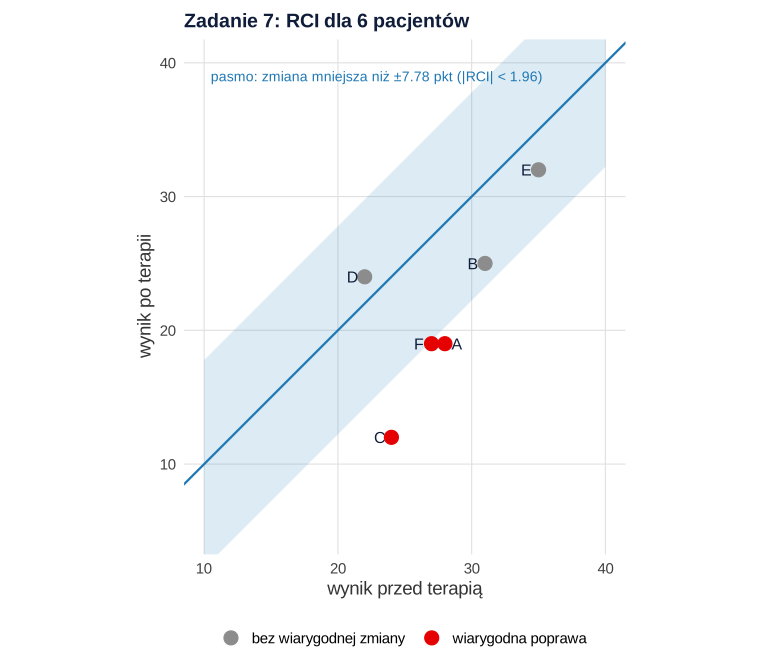
Krok 2. RCI = (po − przed) / Sdiff. Pacjent A: (19 − 28) / 3.969 = −2.27.
| Pacjent | Przed | Po | Zmiana | RCI | Ocena |
|---|---|---|---|---|---|
| A | 28 | 19 | −9 | −2.27 | wiarygodna poprawa |
| B | 31 | 25 | −6 | −1.51 | bez wiarygodnej zmiany |
| C | 24 | 12 | −12 | −3.02 | wiarygodna poprawa |
| D | 22 | 24 | 2 | 0.50 | bez wiarygodnej zmiany |
| E | 35 | 32 | −3 | −0.76 | bez wiarygodnej zmiany |
| F | 27 | 19 | −8 | −2.02 | wiarygodna poprawa |
Krok 3. Próg w punktach. Zmiana jest wiarygodna, gdy przekracza 1.96 × 3.969 = 7.78 punktu, czyli w tej skali co najmniej 8 punktów.
Interpretacja
Pacjent B poprawił się o 6 punktów – tyle samo co średnio cała grupa (−6.00) – ale u pojedynczej osoby taka zmiana mieści się w błędzie pomiaru. Drugą część kryterium (przejście do zakresu populacji funkcjonalnej) i MCID omawia wpis RCI, MDC i MCID; obliczenia dla jednej osoby zrobisz w kalkulatorze RCI i MDC.
Typowy błąd
Dzielenie zmiany przez SEM zamiast przez Sdiff. Różnica dwóch pomiarów ma dwa błędy, stąd √2. Bez niego pacjent B dostałby RCI = −2.14 i fałszywie trafiłby do grupy z wiarygodną poprawą.
Zadanie 8. Wynik T, sten i stanin: liniowo i z rangi centylowej
Treść zadania
Skala objawów lękowych ma w grupie normalizacyjnej (N = 400) M = 12.4 i SD = 6.0, a jej rozkład jest prawoskośny. Osoba uzyskała 17 punktów; w normach 268 osób miało wynik niższy, a 16 osób – dokładnie 17. (a) Przelicz wynik liniowo na z, wynik T, sten i stanin. (b) Oblicz rangę centylową i wyniki znormalizowane. (c) Ta sama osoba w innym teście (M = 80, SD = 12) uzyskała 92 punkty. W którym teście wypadła lepiej?
Rozwiązanie krok po kroku
Krok 1. Przeliczenie liniowe. z = (17 − 12.4) / 6.0 = 0.767. Wynik T (skala tenowa: M = 50, SD = 10): 50 + 10 × 0.767 = 57.67. Sten: 5.5 + 2 × 0.767 = 7.03 → 7. Stanin: 5 + 2 × 0.767 = 6.53 → 7.
Krok 2. Ranga centylowa (osobom z tym samym wynikiem przypisz połowę):
Krok 3. Wyniki znormalizowane. Odczytaj z, dla którego pole pod krzywą normalną na lewo wynosi .690: z = 0.496. Stąd T = 54.96 ≈ 55, sten = 6.49 → 6. Stanin z rangi centylowej odczytasz z rozkładu 4–7–12–17–20–17–12–7–4%: skumulowane granice 4, 11, 23, 40, 60, 77, 89, 96, 100, więc centyl 69 (między 60 a 77) to stanin 6.
Krok 4. Porównanie testów. W drugim teście z = (92 − 80) / 12 = 1.000, T = 60.00. Liniowo osoba wypada lepiej w teście drugim (T = 60 vs 58).
Interpretacja
Przy rozkładzie skośnym przeliczenie liniowe zakłada normalność, której nie ma: według krzywej normalnej z = 0.767 odpowiadałoby centylowi 77.8, a w rzeczywistości 69% grupy ma wynik niższy. Dlatego normy większości testów psychologicznych podaje się jako wyniki znormalizowane z rang centylowych – tu sten 6 i stanin 6, a nie 7. Przeliczenia sprawdzisz w konwerterze wyników na normy.
Typowy błąd
Liczenie stanina „ze wzoru” przy skośnych normach i porównywanie wyników surowych z różnych testów. Porównuj wyniki przeliczone na tę samą skalę, a do decyzji diagnostycznych używaj tabel norm z podręcznika testu.
Zadanie 9. Wzór Spearmana–Browna: wydłużenie i skrócenie testu
Treść zadania
Test uwagi ma 20 pozycji i rzetelność .72. (a) Jaka będzie rzetelność po dodaniu 20 pozycji równoległych (40 pozycji)? (b) Po skróceniu do 10 pozycji? (c) Ile pozycji potrzeba, aby osiągnąć rzetelność .85? (d) Korelacja dwóch połówek innego testu wynosi .58 – jaka jest rzetelność całości?
Rozwiązanie krok po kroku
Krok 1. Wzór (Spearman, 1910; Brown, 1910), gdzie m = nowa długość / stara długość:
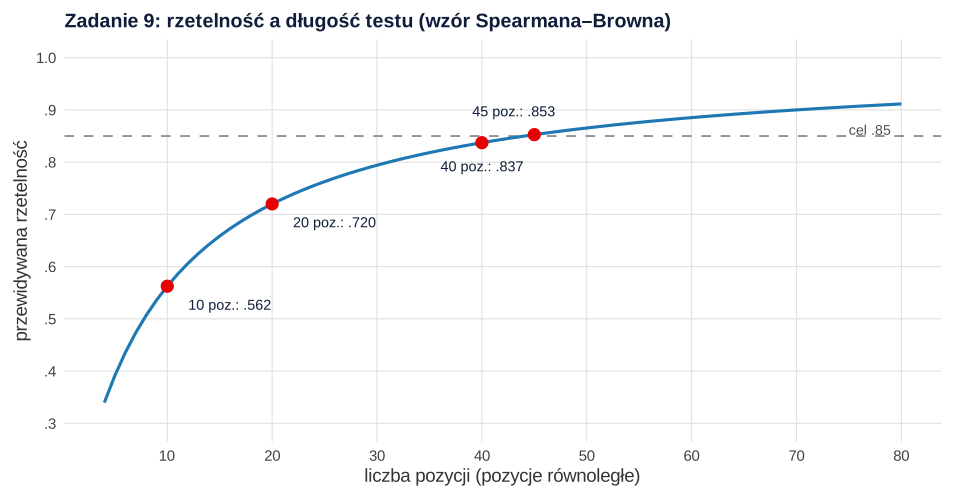
Krok 2. (a) m = 2: 2 × .72 / (1 + .72) = .837. (b) m = 0.5: 0.5 × .72 / (1 − 0.5 × .72) = .36 / .64 = .562.
Krok 3. (c) Wzór odwrócony.
Kontrola: dla 45 pozycji (m = 2.25) rzetelność wynosi .853. Zaokrąglaj zawsze w górę – 44 pozycje dałyby nieco mniej niż .85.
Krok 4. (d) Rzetelność połówkowa. Korelacja połówek dotyczy testu o połowę krótszego, więc m = 2: 2 × .58 / 1.58 = .734.
Interpretacja
Podwojenie testu podnosi rzetelność z .72 do .84, a skrócenie o połowę obniża ją do .56. Aby osiągnąć .85, test musiałby mieć 45 pozycji – to ponad dwa razy więcej i dużo więcej czasu badanego. Wzór zakłada, że dodane lub usunięte pozycje są równoległe do obecnych; więcej w haśle rzetelność połówkowa i wzór Spearmana–Browna.
Typowy błąd
Podawanie korelacji połówek (.58) jako rzetelności całego testu – to rzetelność testu o połowie długości i trzeba ją „wydłużyć” wzorem. Drugi błąd: m jako liczba dodanych pozycji (20) zamiast stosunku długości (2).
Zadanie 10. Korekta na atenuację
Treść zadania
W badaniu nauczycieli korelacja perfekcjonizmu z wypaleniem zawodowym wyniosła r = .38. Rzetelność (alfa) skali perfekcjonizmu to .78, a skali wypalenia .85. (a) Jaka jest największa korelacja możliwa do zaobserwowania przy tych rzetelnościach? (b) Oblicz korelację skorygowaną na atenuację dla obu zmiennych i (c) tylko dla kryterium. (d) Co się stanie, gdy rzetelności wynoszą .60 i .55, a obserwowana korelacja .62?
Rozwiązanie krok po kroku
Krok 1. Górna granica. √(rxx × ryy) = √(.78 × .85) = .814.
Krok 2. Korekta podwójna (wzór Spearmana):
Krok 3. Korekta pojedyncza (tylko błąd pomiaru kryterium): .38 / √.85 = .412.
Krok 4. Słabe rzetelności. Przy .60 i .55 ta sama korelacja .38 urosłaby do .661, a obserwowana .62 dałaby 1.079 – wartość niemożliwą dla korelacji.
Interpretacja
Korekta na atenuację pokazuje, jak silny byłby związek przy bezbłędnym pomiarze. Muchinsky (1996) omawia, kiedy stosować korektę podwójną, a kiedy pojedynczą, oraz skąd biorą się skorygowane współczynniki większe niż 1. Podawaj zawsze obie wartości – obserwowaną i skorygowaną.
Typowy błąd
Raportowanie samej skorygowanej korelacji i testowanie jej istotności jak zwykłego r. Wynik powyżej 1 nie oznacza „idealnego związku”, tylko że rzetelności są niedoszacowane albo korelacja obserwowana jest zawyżona przez przypadek.
Ściąga wzorów do zadań z psychometrii
| Wielkość | Wzór | Szybka kontrola |
|---|---|---|
| Alfa Cronbacha | k/(k − 1) × (1 − Σsi² / sX²) | ten sam dzielnik wariancji wszędzie |
| KR-20 | k/(k − 1) × (1 − Σpq / sX²) | sX² z dzielnikiem n |
| Trudność, dyskryminacja | pi = odsetek poprawnych; D = pgórna − pdolna | ujemne D – sprawdź klucz |
| Omega | (Σλ)² / [(Σλ)² + Σ(1 − λ²)] | przy równych ładunkach ≈ alfa |
| SEM | SD√(1 − rxx) | zawsze mniejszy niż SD |
| RCI | (po − przed) / (√2 × SEM) | |RCI| ≥ 1.96 – zmiana wiarygodna |
| Wynik T, sten, stanin | 50 + 10z; 5.5 + 2z; 5 + 2z | przy skośnych normach – z rangi centylowej |
| Spearman–Brown | mr / [1 + (m − 1)r] | m to stosunek długości |
| Korekta na atenuację | rxy / √(rxxryy) | wynik > 1 – sygnał problemu |
Inne zbiory zadań ze statystyki
Ten wpis należy do serii, którą zbiera strona zadania ze statystyki z rozwiązaniami. Najbliższe tematycznie są: zadania ze statystyki na psychologii (wynik z, sten i centyl w rozkładzie normalnym), korelacja i regresja (korelacja Pearsona, na której opiera się analiza pozycji) i metodologia badań (operacjonalizacja i trafność). Jeśli liczysz rzetelność skal do własnej pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone wzorem, tak jak na kartce; w zadaniach 1–3 wynik sprawdza dodatkowo funkcja psych::alpha(). Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–4: alfa Cronbacha, alfa po usunięciu pozycji, korelacja pozycja–reszta, trudność, dyskryminacja i KR-20
R
# B390 – zadania 1–4: alfa Cronbacha ręcznie, alfa po usunięciu pozycji, korelacja pozycja–reszta, trudność i moc dyskryminacyjna pozycji
# Dane wpisane na sztywno – te same co w treści zadań. Funkcje bazowego R; psych::alpha() tylko jako kontrola.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (alfa, r, p)
alfa <- function(X) { k <- ncol(X); k / (k - 1) * (1 - sum(apply(X, 2, var)) / var(rowSums(X))) }

# Zadania 1–3. Skala lęku przed wystąpieniami publicznymi: 5 pozycji (1–5), 8 osób z badania pilotażowego
lek <- data.frame(
  p1 = c(4, 2, 5, 3, 1, 4, 2, 3),
  p2 = c(5, 2, 4, 3, 2, 4, 1, 4),
  p3 = c(4, 3, 5, 2, 1, 5, 2, 3),
  p4 = c(4, 2, 5, 3, 2, 3, 2, 4),
  p5 = c(2, 4, 3, 2, 3, 5, 2, 4))
suma <- rowSums(lek)
cat("Zadanie 1\n")
print(data.frame(osoba = 1:8, lek, suma = suma), row.names = FALSE)
wariancje <- apply(lek, 2, var)
cat("Średnie pozycji:", z2(colMeans(lek)), "\n")
cat("Wariancje pozycji (n - 1):", z3(wariancje), "; suma =", z3(sum(wariancje)), "\n")
cat("Średnia sumy =", z2(mean(suma)), "; wariancja sumy (n - 1) =", z3(var(suma)), "\n")
k <- ncol(lek)
a1 <- k / (k - 1) * (1 - sum(wariancje) / var(suma))
cat("alfa = 5/4 * (1 -", z3(sum(wariancje)), "/", z3(var(suma)), ") =", bz(a1), "\n")
var_pop <- function(x) mean((x - mean(x))^2)
cat("Ten sam wynik z wariancjami populacyjnymi (n) w obu miejscach:",
    bz(k / (k - 1) * (1 - sum(apply(lek, 2, var_pop)) / var_pop(suma))), "\n")
cat("Błąd: wariancje pozycji z n - 1, wariancja sumy z n:",
    bz(k / (k - 1) * (1 - sum(wariancje) / var_pop(suma))), "\n")
r_sr <- mean(cor(lek)[lower.tri(cor(lek))])
cat("Średnia korelacja między pozycjami =", bz(r_sr), "; alfa standaryzowana =", bz(k * r_sr / (1 + (k - 1) * r_sr)), "\n")
ps <- suppressWarnings(psych::alpha(lek))
cat("Kontrola psych::alpha(): raw_alpha =", bz(ps$total$raw_alpha), "; std.alpha =", bz(ps$total$std.alpha), "\n\n")

cat("Zadania 2–3\n")
bez <- sapply(names(lek), function(j) alfa(lek[, names(lek) != j]))
r_reszta <- sapply(names(lek), function(j) cor(lek[[j]], suma - lek[[j]]))
r_calosc <- sapply(names(lek), function(j) cor(lek[[j]], suma))
tab <- data.frame(pozycja = names(lek), war_sumy_bez = z3(sapply(names(lek), function(j) var(suma - lek[[j]]))),
                  alfa_bez = bz(bez), r_reszta = bz(r_reszta), r_z_suma = bz(r_calosc))
print(tab, row.names = FALSE)
cat("Alfa bez p5 krok po kroku: 4/3 * (1 -", z3(sum(wariancje[1:4])), "/", z3(var(suma - lek$p5)), ") =", bz(bez[["p5"]]), "\n")
cat("Kontrola psych::alpha(): alfa po usunięciu =", bz(ps$alpha.drop$raw_alpha), "\n")
cat("Kontrola psych::alpha(): r.drop =", bz(ps$item.stats$r.drop), "\n")
cat("Korelacje p5 z pozostałymi pozycjami:", bz(cor(lek)[5, 1:4]), "\n")
cat("Alfa skali 4 pozycji przy n = 8: ", bz(bez[["p5"]]), "; alfa bez p5 i p4 =", bz(alfa(lek[, 1:3])), "\n\n")

# Zadanie 4. Test wiedzy z metodologii: 6 pytań (1 = dobrze, 0 = źle), 10 studentów
test <- data.frame(
  z1 = c(1, 1, 1, 1, 1, 1, 1, 0, 1, 1),
  z2 = c(1, 1, 1, 1, 0, 1, 0, 0, 0, 0),
  z3 = c(1, 1, 1, 0, 1, 0, 0, 0, 0, 0),
  z4 = c(1, 1, 0, 1, 0, 1, 1, 0, 0, 0),
  z5 = c(1, 1, 1, 0, 1, 0, 1, 0, 0, 0),
  z6 = c(1, 0, 0, 0, 0, 0, 0, 1, 0, 1))
wynik <- rowSums(test)
cat("Zadanie 4\n")
cat("Wyniki studentów (suma punktów):", wynik, "\n")
p <- colMeans(test)
kol <- order(-wynik)
gora <- kol[1:3]; dol <- kol[8:10]
cat("Grupa górna (studenci):", gora, "; wyniki:", wynik[gora], "\n")
cat("Grupa dolna (studenci):", dol, "; wyniki:", wynik[dol], "\n")
D <- colMeans(test[gora, ]) - colMeans(test[dol, ])
r_pr <- sapply(names(test), function(j) cor(test[[j]], wynik - test[[j]]))
print(data.frame(pytanie = names(test), p = bz(p), p_gora = bz(colMeans(test[gora, ])), p_dol = bz(colMeans(test[dol, ])),
                 D = bz(D), r_reszta = bz(r_pr)), row.names = FALSE)
kk <- ncol(test)
cat("Suma pq =", z3(sum(p * (1 - p))), "; wariancja wyników (n) =", z3(var_pop(wynik)), "; (n - 1) =", z3(var(wynik)), "\n")
kr20 <- kk / (kk - 1) * (1 - sum(p * (1 - p)) / var_pop(wynik))
cat("KR-20 = 6/5 * (1 -", z3(sum(p * (1 - p))), "/", z3(var_pop(wynik)), ") =", bz(kr20), "\n")
cat("Kontrola: alfa z wariancji (n - 1) =", bz(alfa(test)), "\n")
cat("Błąd: pq z wariancją wyników (n - 1) =", bz(kk / (kk - 1) * (1 - sum(p * (1 - p)) / var(wynik))), "\n")
cat("KR-20 bez pytania z6 =", bz(alfa(test[, -6])), "\n")
Wynik w R
Zadanie 1
 osoba p1 p2 p3 p4 p5 suma
     1  4  5  4  4  2   19
     2  2  2  3  2  4   13
     3  5  4  5  5  3   22
     4  3  3  2  3  2   13
     5  1  2  1  2  3    9
     6  4  4  5  3  5   21
     7  2  1  2  2  2    9
     8  3  4  3  4  4   18
Średnie pozycji: 3.00 3.12 3.12 3.12 3.12
Wariancje pozycji (n - 1): 1.714 1.839 2.125 1.268 1.268 ; suma = 8.214
Średnia sumy = 15.50 ; wariancja sumy (n - 1) = 26.857
alfa = 5/4 * (1 - 8.214 / 26.857 ) = .868
Ten sam wynik z wariancjami populacyjnymi (n) w obu miejscach: .868
Błąd: wariancje pozycji z n - 1, wariancja sumy z n: .813
Średnia korelacja między pozycjami = .549 ; alfa standaryzowana = .859
Kontrola psych::alpha(): raw_alpha = .868 ; std.alpha = .859

Zadania 2–3
 pozycja war_sumy_bez alfa_bez r_reszta r_z_suma
      p1       16.000     .792     .873     .926
      p2       16.268     .811     .800     .884
      p3       14.839     .786     .881     .936
      p4       18.268     .826     .761     .845
      p5       23.411     .938     .200     .404
Alfa bez p5 krok po kroku: 4/3 * (1 - 6.946 / 23.411 ) = .938
Kontrola psych::alpha(): alfa po usunięciu = .792 .811 .786 .826 .938
Kontrola psych::alpha(): r.drop = .873 .800 .881 .761 .200
Korelacje p5 z pozostałymi pozycjami: .097 .175 .424 -.014
Alfa skali 4 pozycji przy n = 8:  .938 ; alfa bez p5 i p4 = .924

Zadanie 4
Wyniki studentów (suma punktów): 6 5 4 3 3 3 3 1 1 2
Grupa górna (studenci): 1 2 3 ; wyniki: 6 5 4
Grupa dolna (studenci): 10 8 9 ; wyniki: 2 1 1
 pytanie    p p_gora p_dol     D r_reszta
      z1 .900  1.000  .667  .333     .286
      z2 .500  1.000  .000 1.000     .500
      z3 .400  1.000  .000 1.000     .550
      z4 .500   .667  .000  .667     .312
      z5 .500  1.000  .000 1.000     .500
      z6 .300   .333  .667 -.333    -.327
Suma pq = 1.290 ; wariancja wyników (n) = 2.290 ; (n - 1) = 2.544
KR-20 = 6/5 * (1 - 1.290 / 2.290 ) = .524
Kontrola: alfa z wariancji (n - 1) = .524
Błąd: pq z wariancją wyników (n - 1) = .592
KR-20 bez pytania z6 = .723
Zadania 5–10: omega, SEM i wynik prawdziwy, RCI, normy, Spearman–Brown i korekta na atenuację
R
# B390 – zadania 5–10: omega z ładunków, błąd standardowy pomiaru, RCI, normy (T, sten, stanin), Spearman–Brown, korekta na atenuację
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))

# Zadanie 5. Omega McDonalda z ładunków standaryzowanych (6 pozycji skali wsparcia społecznego)
lam <- c(.72, .65, .80, .55, .70, .45)
cat("Zadanie 5\n")
S <- sum(lam); bl <- 1 - lam^2
cat("Suma ładunków =", z2(S), "; (suma)^2 =", z3(S^2), "\n")
cat("Wariancje błędów 1 - lambda^2:", z3(bl), "; suma =", z3(sum(bl)), "\n")
omega <- S^2 / (S^2 + sum(bl))
cat("omega = ", z3(S^2), "/ (", z3(S^2), "+", z3(sum(bl)), ") =", bz(omega), "\n")
R <- outer(lam, lam); diag(R) <- 1
k5 <- length(lam); rbar <- mean(R[lower.tri(R)])
cat("Średnia korelacja wynikająca z ładunków =", bz(rbar), "; alfa standaryzowana =", bz(k5 * rbar / (1 + (k5 - 1) * rbar)), "\n")
cat("Kontrola: alfa z macierzy korelacji =", bz(k5 / (k5 - 1) * (1 - k5 / sum(R))), "\n")
lam_r <- rep(mean(lam), 6)
cat("Ładunki równe (średnia", z3(mean(lam)), "): omega =", bz(sum(lam_r)^2 / (sum(lam_r)^2 + sum(1 - lam_r^2))), "\n")
cat("Omega bez pozycji 6 =", bz(sum(lam[-6])^2 / (sum(lam[-6])^2 + sum(bl[-6]))), "\n\n")

# Zadanie 6. Błąd standardowy pomiaru i przedział dla wyniku prawdziwego (kwestionariusz neurotyczności)
M6 <- 24; SD6 <- 6; rxx6 <- .84; X6 <- 33
cat("Zadanie 6\n")
sem6 <- SD6 * sqrt(1 - rxx6)
cat("SEM = 6 * sqrt(1 - .84) =", z2(sem6), "\n")
for (pz in c(.68, .90, .95)) {
  zq <- qnorm(1 - (1 - pz) / 2)
  cat(sprintf("%d%%: z = %s; %d +/- %s -> [%s, %s]\n", round(pz * 100), z3(zq), X6, z2(zq * sem6), z2(X6 - zq * sem6), z2(X6 + zq * sem6)))
}
T_est <- M6 + rxx6 * (X6 - M6); see <- SD6 * sqrt(rxx6 * (1 - rxx6))
cat("Wynik prawdziwy oszacowany (Kelley) =", M6, "+ .84 * (", X6, "-", M6, ") =", z2(T_est), "\n")
cat("Błąd standardowy estymacji = 6 * sqrt(.84 * .16) =", z2(see), "; 95%: [", z2(T_est - qnorm(.975) * see), ",", z2(T_est + qnorm(.975) * see), "]\n")
cat("Próg wyniku wysokiego (M + 1 SD) =", M6 + SD6, "; dolna granica 95% przedziału wokół X =", z2(X6 - qnorm(.975) * sem6), "\n")
cat("Ta sama osoba przy rxx = .70: SEM =", z2(SD6 * sqrt(.30)), "; 95%: [", z2(X6 - qnorm(.975) * SD6 * sqrt(.30)), ",", z2(X6 + qnorm(.975) * SD6 * sqrt(.30)), "]\n\n")

# Zadanie 7. Wskaźnik wiarygodnej zmiany (RCI, Jacobson i Truax) – skala objawów depresyjnych 0–63, 6 pacjentów przed i po terapii
SD7 <- 7.5; rtt7 <- .86
przed <- c(28, 31, 24, 22, 35, 27)
po    <- c(19, 25, 12, 24, 32, 19)
cat("Zadanie 7\n")
sem7 <- SD7 * sqrt(1 - rtt7); sdiff <- sqrt(2) * sem7
cat("SEM = 7.5 * sqrt(1 - .86) =", z3(sem7), "; S_diff = sqrt(2) * SEM =", z3(sdiff), "\n")
rci <- (po - przed) / sdiff
kat <- ifelse(rci <= -qnorm(.975), "wiarygodna poprawa", ifelse(rci >= qnorm(.975), "wiarygodne pogorszenie", "bez wiarygodnej zmiany"))
print(data.frame(pacjent = LETTERS[1:6], przed, po, zmiana = po - przed, RCI = z2(rci), ocena = kat), row.names = FALSE)
cat("Najmniejsza wiarygodna zmiana = 1.96 * S_diff =", z2(qnorm(.975) * sdiff), "pkt\n")
cat("Średnia zmiana w grupie =", z2(mean(po - przed)), "\n")
cat("Błąd: S_diff = SEM (bez sqrt(2)) -> RCI pacjenta B =", z2((po[2] - przed[2]) / sem7), "\n\n")

# Zadanie 8. Normy: wynik T (skala tenowa), sten i stanin – liniowo i z rangi centylowej
M8 <- 12.4; SD8 <- 6.0; X8 <- 17; N8 <- 400; nizej <- 268; rowno <- 16
cat("Zadanie 8\n")
z8 <- (X8 - M8) / SD8
cat("z =", z3(z8), "; T = 50 + 10z =", z2(50 + 10 * z8), "; sten = 5.5 + 2z =", z2(5.5 + 2 * z8),
    "; stanin = 5 + 2z =", z2(5 + 2 * z8), "\n")
pr <- (nizej + rowno / 2) / N8
cat("Ranga centylowa = (", nizej, "+", rowno, "/ 2 ) /", N8, "=", z3(pr), "\n")
zn <- qnorm(pr)
cat("z znormalizowane = qnorm(", z3(pr), ") =", z3(zn), "; T znormalizowane =", z2(50 + 10 * zn), "; sten =", z2(5.5 + 2 * zn), "\n")
granice <- cumsum(c(4, 7, 12, 17, 20, 17, 12, 7, 4))
cat("Skumulowane procenty staninów 1–9:", granice, "\n")
cat("Stanin z rangi centylowej", z2(100 * pr), "=", findInterval(100 * pr, c(0, granice[-9]), left.open = TRUE), "\n")
cat("Pole na lewo od z liniowego =", z3(pnorm(z8)), "(centyl z założenia normalności)\n")
cat("Ta sama osoba w teście 2 (M = 80, SD = 12), wynik 92: z =", z3((92 - 80) / 12), "; T =", z2(50 + 10 * (92 - 80) / 12), "\n\n")

# Zadanie 9. Wzór Spearmana–Browna: wydłużenie i skrócenie testu (20 pozycji, rxx = .72)
sb <- function(r, m) m * r / (1 + (m - 1) * r)
r9 <- .72
cat("Zadanie 9\n")
cat("40 pozycji (m = 2):", bz(sb(r9, 2)), "; 10 pozycji (m = 0.5):", bz(sb(r9, .5)), "; 30 pozycji (m = 1.5):", bz(sb(r9, 1.5)), "\n")
m_cel <- (.85 * (1 - r9)) / (r9 * (1 - .85))
cat("m dla rxx = .85:", z3(m_cel), "; liczba pozycji =", z2(20 * m_cel), "-> zaokrąglij w górę:", ceiling(20 * m_cel), "\n")
cat("Kontrola dla", ceiling(20 * m_cel), "pozycji:", bz(sb(r9, ceiling(20 * m_cel) / 20)), "\n")
cat("Rzetelność połówkowa: r połówek = .58 -> pełny test", bz(sb(.58, 2)), "\n\n")

# Zadanie 10. Korekta na atenuację: perfekcjonizm (alfa = .78) a wypalenie (alfa = .85), r = .38
r10 <- .38; rx <- .78; ry <- .85
cat("Zadanie 10\n")
cat("Maksymalna obserwowalna korelacja = sqrt(.78 * .85) =", bz(sqrt(rx * ry)), "\n")
cat("r skorygowane (obie zmienne) = .38 / sqrt(.78 * .85) =", bz(r10 / sqrt(rx * ry)), "\n")
cat("r skorygowane (tylko kryterium) = .38 / sqrt(.85) =", bz(r10 / sqrt(ry)), "\n")
cat("Przy rzetelnościach .60 i .55: r = .38 ->", bz(r10 / sqrt(.60 * .55)), "\n")
cat("r = .62 przy rzetelnościach .60 i .55 ->", z3(.62 / sqrt(.60 * .55)), "\n")
Wynik w R
Zadanie 5
Suma ładunków = 3.87 ; (suma)^2 = 14.977
Wariancje błędów 1 - lambda^2: 0.482 0.577 0.360 0.698 0.510 0.797 ; suma = 3.424
omega =  14.977 / ( 14.977 + 3.424 ) = .814
Średnia korelacja wynikająca z ładunków = .413 ; alfa standaryzowana = .809
Kontrola: alfa z macierzy korelacji = .809
Ładunki równe (średnia 0.645 ): omega = .810
Omega bez pozycji 6 = .817

Zadanie 6
SEM = 6 * sqrt(1 - .84) = 2.40
68%: z = 0.994; 33 +/- 2.39 -> [30.61, 35.39]
90%: z = 1.645; 33 +/- 3.95 -> [29.05, 36.95]
95%: z = 1.960; 33 +/- 4.70 -> [28.30, 37.70]
Wynik prawdziwy oszacowany (Kelley) = 24 + .84 * ( 33 - 24 ) = 31.56
Błąd standardowy estymacji = 6 * sqrt(.84 * .16) = 2.20 ; 95%: [ 27.25 , 35.87 ]
Próg wyniku wysokiego (M + 1 SD) = 30 ; dolna granica 95% przedziału wokół X = 28.30
Ta sama osoba przy rxx = .70: SEM = 3.29 ; 95%: [ 26.56 , 39.44 ]

Zadanie 7
SEM = 7.5 * sqrt(1 - .86) = 2.806 ; S_diff = sqrt(2) * SEM = 3.969
 pacjent przed po zmiana   RCI                  ocena
       A    28 19     -9 -2.27     wiarygodna poprawa
       B    31 25     -6 -1.51 bez wiarygodnej zmiany
       C    24 12    -12 -3.02     wiarygodna poprawa
       D    22 24      2  0.50 bez wiarygodnej zmiany
       E    35 32     -3 -0.76 bez wiarygodnej zmiany
       F    27 19     -8 -2.02     wiarygodna poprawa
Najmniejsza wiarygodna zmiana = 1.96 * S_diff = 7.78 pkt
Średnia zmiana w grupie = -6.00
Błąd: S_diff = SEM (bez sqrt(2)) -> RCI pacjenta B = -2.14

Zadanie 8
z = 0.767 ; T = 50 + 10z = 57.67 ; sten = 5.5 + 2z = 7.03 ; stanin = 5 + 2z = 6.53
Ranga centylowa = ( 268 + 16 / 2 ) / 400 = 0.690
z znormalizowane = qnorm( 0.690 ) = 0.496 ; T znormalizowane = 54.96 ; sten = 6.49
Skumulowane procenty staninów 1–9: 4 11 23 40 60 77 89 96 100
Stanin z rangi centylowej 69.00 = 6
Pole na lewo od z liniowego = 0.778 (centyl z założenia normalności)
Ta sama osoba w teście 2 (M = 80, SD = 12), wynik 92: z = 1.000 ; T = 60.00

Zadanie 9
40 pozycji (m = 2): .837 ; 10 pozycji (m = 0.5): .562 ; 30 pozycji (m = 1.5): .794
m dla rxx = .85: 2.204 ; liczba pozycji = 44.07 -> zaokrąglij w górę: 45
Kontrola dla 45 pozycji: .853
Rzetelność połówkowa: r połówek = .58 -> pełny test .734

Zadanie 10
Maksymalna obserwowalna korelacja = sqrt(.78 * .85) = .814
r skorygowane (obie zmienne) = .38 / sqrt(.78 * .85) = .467
r skorygowane (tylko kryterium) = .38 / sqrt(.85) = .412
Przy rzetelnościach .60 i .55: r = .38 -> .661
r = .62 przy rzetelnościach .60 i .55 -> 1.079
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakietu psych); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak policzyć alfę Cronbacha ręcznie z wariancji pozycji?
Policz wariancję każdej pozycji i wariancję sumy punktów, a potem wstaw je do wzoru α = k/(k − 1) × (1 − Σsi² / sX²). W zadaniu 1 pięć pozycji ma łączną wariancję 8.214, suma punktów 26.857, więc α = 1.25 × (1 − 8.214 / 26.857) = .868.
Czy w alfie Cronbacha liczyć wariancje z n czy z n − 1?
Obojętnie, byle tak samo w liczniku i mianowniku – wtedy wynik jest identyczny. Błąd powstaje przy mieszaniu: w zadaniu 1 wariancje pozycji z n − 1 i wariancja sumy z n dają .813 zamiast .868. W KR-20 iloczyny pq są wariancjami z dzielnikiem n, więc wariancję wyników też licz z n.
Jak obliczyć wskaźnik trudności pytania testowego?
Wskaźnik trudności to odsetek osób, które odpowiedziały poprawnie, np. 9 z 10 daje .90 – pytanie bardzo łatwe. Mimo nazwy wyższa wartość oznacza pytanie łatwiejsze. Uzupełnij go wskaźnikiem dyskryminacji D (różnica odsetków poprawnych odpowiedzi w grupie najlepszych i najsłabszych); ujemne D zwykle oznacza błąd w kluczu lub dwuznaczne pytanie.
Czym różni się przedział dla wyniku obserwowanego od przedziału wokół wyniku prawdziwego?
Pierwszy buduje się wokół wyniku osoby: X ± 1.96 × SEM. Drugi wokół wyniku prawdziwego oszacowanego metodą Kelleya, który jest przesunięty ku średniej: M + rxx(X − M), z błędem SD√[rxx(1 − rxx)]. W zadaniu 6 daje to [28.30, 37.70] i [27.25, 35.87]; przy wynikach skrajnych różnica jest wyraźniejsza.
Ile pozycji dodać do testu, żeby osiągnąć zakładaną rzetelność?
Użyj odwróconego wzoru Spearmana–Browna: m = rcel(1 − r) / [r(1 − rcel)] i pomnóż obecną liczbę pozycji przez m, zaokrąglając w górę. Test 20 pozycji o rzetelności .72 potrzebuje 45 pozycji, aby osiągnąć .85. Wzór zakłada, że nowe pozycje są równoległe do obecnych.
Powiązane hasła
Przeczytaj też
Alfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikRCI, MDC i MCID
SEM, MDC95, RCI i kryteria Jacobsona–Truaxa, MCID z kotwicy i metod rozkładowych, analiza responderów z 95% CI i koszt dychotomizacji – z kodem R.
Czytaj →PoradnikJak zbudować i zwalidować skalę psychometryczną?
Od definicji konstruktu i tworzenia pozycji po pilotaż, EFA, CFA, rzetelność, trafność teoretyczną, różnicową i niezmienniczość.
Czytaj →Liczysz rzetelność skal do pracy dyplomowej?
Pomożemy policzyć alfę, omegę i analizę pozycji, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, W. (1910). Some experimental results in the correlation of mental abilities. British Journal of Psychology, 3(3), 296–322. https://doi.org/10.1111/j.2044-8295.1910.tb00207.x ● Otwarty dostęp: pełny tekst
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/bf02310555 ● Otwarty dostęp
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12–19. https://doi.org/10.1037/0022-006x.59.1.12
- McDonald, R. P. (1999). Test theory: A unified treatment. Lawrence Erlbaum Associates.
- Muchinsky, P. M. (1996). The correction for attenuation. Educational and Psychological Measurement, 56(1), 63–75. https://doi.org/10.1177/0013164496056001004
- Spearman, C. (1910). Correlation calculated from faulty data. British Journal of Psychology, 3(3), 271–295. https://doi.org/10.1111/j.2044-8295.1910.tb00206.x
Cytowania BibTeX
@article{brown1910some, author={Brown, William}, title={{Some experimental results in the correlation of mental abilities}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={296--322}, doi={10.1111/j.2044-8295.1910.tb00207.x}}@article{cronbach1951coefficient, author={Cronbach, Lee J.}, title={{Coefficient alpha and the internal structure of tests}}, journal={Psychometrika}, year={1951}, volume={16}, number={3}, pages={297--334}, doi={10.1007/bf02310555}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{jacobson1991clinical, author={Jacobson, Neil S. and Truax, Paula}, title={{Clinical significance: A statistical approach to defining meaningful change in psychotherapy research}}, journal={Journal of Consulting and Clinical Psychology}, year={1991}, volume={59}, number={1}, pages={12--19}, doi={10.1037/0022-006x.59.1.12}}@book{mcdonald1999test, author={McDonald, Roderick P.}, title={{Test theory: A unified treatment}}, year={1999}, publisher={Lawrence Erlbaum Associates}}@article{muchinsky1996correction, author={Muchinsky, Paul M.}, title={{The correction for attenuation}}, journal={Educational and Psychological Measurement}, year={1996}, volume={56}, number={1}, pages={63--75}, doi={10.1177/0013164496056001004}}@article{spearman1910correlation, author={Spearman, Charles}, title={{Correlation calculated from faulty data}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={271--295}, doi={10.1111/j.2044-8295.1910.tb00206.x}}