Co to jest korekta na atenuację?
Korekta na atenuację (ang. correction for attenuation, dezatenuacja, korekta Spearmana) szacuje korelację między wynikami prawdziwymi dwóch konstruktów z korelacji obserwowanej i rzetelności obu miar. Losowy błąd pomiaru osłabia (atenuuje) korelację: obserwowana zależy od korelacji prawdziwej i rzetelności obu miar (Schmidt i Hunter, 1996). Im niższa rzetelność, tym słabszy związek widzimy w danych, nawet gdy konstrukty są silnie powiązane. Muchinsky (1996) przypomina, że korekta powstała na potrzeby konstrukcji testów, a dziś służy też w metaanalizie.
Wzór
rkor = rxy / √(rxx × ryy), gdzie rxx i ryy to rzetelności, np. alfa Cronbacha albo omega McDonalda. To korekta podwójna. W korekcie pojedynczej dzieli się tylko przez pierwiastek z rzetelności jednej miary, np. kryterium w badaniu trafności.
Przykład
Zasymulowaliśmy w R 400 osób o prawdziwej korelacji konstruktów .50 (w próbie .524) i skale o rzetelności .70 i .80. Oczekiwana korelacja obserwowana to .50 × √(.70 × .80) = .374. W próbie wyniosła .423, 95% CI [.339, .500], a po korekcie .565 [.453, .668]. Przy rzetelnościach .60 i .55 obserwowana korelacja .60 dałaby po korekcie 1.04 – wartość niemożliwą.
Na rysunku
Jak bardzo obserwowane r waha się w 1000 symulowanych badaniach przy różnej rzetelności, pokazuje wpis Rzetelność i błąd pomiaru – wizualizacja na obrazkach. Tu widać samą regułę, którą odwraca korekta, i 400 osób z przykładu powyżej.
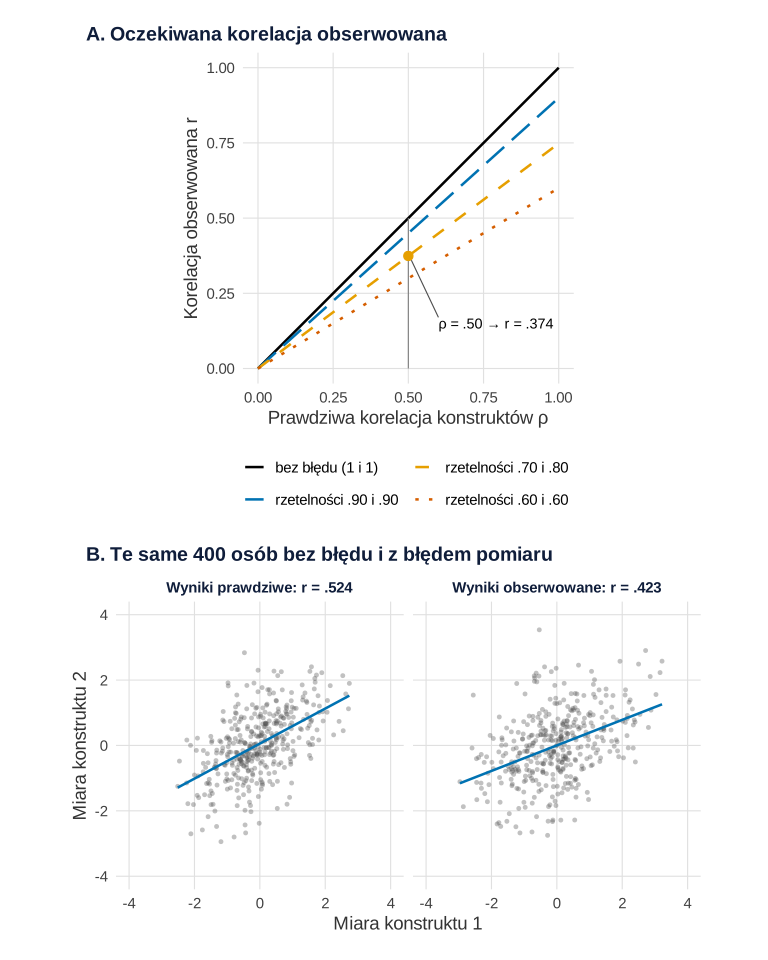
set.seed(4610)).Co widać. Błąd pomiaru mnoży korelację przez √(rxx × ryy), więc każda para rzetelności daje prostą o innym nachyleniu. Przy rzetelnościach .90 i .90 prawdziwe ρ = .50 staje się .450, przy .70 i .80 – .374, a przy .60 i .60 – .300. Korekta na atenuację to droga z powrotem: z pionowej osi na poziomą. Panel B pokazuje mechanizm na danych z przykładu. Wyniki prawdziwe korelują na poziomie .524, obserwowane – .423. Losowy błąd rozciąga chmurę w obu kierunkach (SD pierwszej miary rośnie z 0.994 do 1.167), a linia regresji spłaszcza się z 0.536 do 0.391.
Na co uważać. Panel A to wartości oczekiwane. W pojedynczej próbie obserwowane r leży nad prostą albo pod nią – w przykładzie .423 zamiast .374. Ta zmienność przechodzi do skorygowanego wyniku i rośnie, gdy dzielimy przez mały pierwiastek; stąd wartości powyżej 1. Proste zakładają też, że rzetelności są znane dokładnie i że błąd jest czysto losowy. Wykres nie pokazuje błędu systematycznego ani tego, jak korekta działa w regresji wielu predyktorów – o tym wpis Błąd pomiaru w regresji.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu. Jest samowystarczalny: paletę Okabe–Ito i prosty motyw definiuje sam. Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka. Panel A nic nie losuje; panel B używa tych samych danych co przykład (set.seed(4610); ziarna nie zmieniano). Pary rzetelności w panelu A dobrano ręcznie, żeby objąć zakres od bardzo dobrej do słabej skali.
Kod R rysunku 1
# Rysunek 1. Atenuacja korelacji: krzywe r_obs = ρ·√(rxx·ryy) i te same osoby bez błędu i z błędem pomiaru
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito; rzetelność kodują też rodzaje linii
pary <- data.frame(rxx = c(1, 0.9, 0.7, 0.6), ryy = c(1, 0.9, 0.8, 0.6))
pary$etyk <- c("bez błędu (1 i 1)", "rzetelności .90 i .90", "rzetelności .70 i .80", "rzetelności .60 i .60")
kol <- setNames(c("#000000", "#0072B2", "#E69F00", "#D55E00"), pary$etyk)
lin <- setNames(c("solid", "longdash", "dashed", "dotted"), pary$etyk)
motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# A: oczekiwana korelacja obserwowana w funkcji prawdziwej (bez losowania)
pary$mnoznik <- sqrt(pary$rxx * pary$ryy)
pary$r_obs_przy_0.5 <- 0.5 * pary$mnoznik
data.frame(pary["etyk"], round(pary[, c("mnoznik", "r_obs_przy_0.5")], 3))
krzywe <- do.call(rbind, lapply(seq_len(nrow(pary)), function(i)
  data.frame(rho = c(0, 1), r_obs = c(0, 1) * pary$mnoznik[i], etyk = pary$etyk[i])))
krzywe$etyk <- factor(krzywe$etyk, pary$etyk)
pa <- ggplot(krzywe, aes(rho, r_obs, colour = etyk, linetype = etyk)) +
  geom_line(linewidth = 0.9) +
  annotate("segment", x = 0.5, xend = 0.5, y = 0, yend = 0.5, colour = "grey50", linewidth = 0.4) +
  annotate("point", x = 0.5, y = 0.5 * sqrt(0.7 * 0.8), size = 2.8, colour = "#E69F00") +
  annotate("segment", x = 0.6, xend = 0.51, y = 0.17, yend = 0.36, colour = "grey30", linewidth = 0.4) +
  annotate("text", x = 0.6, y = 0.15, hjust = 0, size = 3.8,
           label = sub("0\\.", ".", sprintf("ρ = .50 → r = %.3f", 0.5 * sqrt(0.7 * 0.8)))) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = lin, name = NULL) +
  guides(colour = guide_legend(nrow = 2)) +
  coord_equal() +
  labs(title = "A. Oczekiwana korelacja obserwowana",
       x = "Prawdziwa korelacja konstruktów ρ", y = "Korelacja obserwowana r") + motyw

# B: te same 400 osób co w przykładzie hasła – wyniki prawdziwe i obserwowane
set.seed(4610)
n <- 400; rho <- 0.50
T1 <- rnorm(n); T2 <- rho * T1 + sqrt(1 - rho^2) * rnorm(n)
rxx <- 0.70; ryy <- 0.80
X <- T1 + rnorm(n, sd = sqrt((1 - rxx) / rxx))
Y <- T2 + rnorm(n, sd = sqrt((1 - ryy) / ryy))
r_T <- cor(T1, T2); r_XY <- cor(X, Y)
round(c(r_prawdziwe = r_T, r_obserwowane = r_XY, SD_T1 = sd(T1), SD_X = sd(X),
        nachylenie_T = unname(coef(lm(T2 ~ T1))[2]), nachylenie_obs = unname(coef(lm(Y ~ X))[2])), 3)
chmury <- rbind(data.frame(x = T1, y = T2, panel = paste("Wyniki prawdziwe: r =", sub("^0", "", sprintf("%.3f", r_T)))),
                data.frame(x = X, y = Y, panel = paste("Wyniki obserwowane: r =", sub("^0", "", sprintf("%.3f", r_XY)))))
chmury$panel <- factor(chmury$panel, unique(chmury$panel))
pb <- ggplot(chmury, aes(x, y)) +
  geom_point(alpha = 0.35, size = 1.3, colour = "grey30", shape = 16) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "#0072B2", linewidth = 0.9) +
  facet_wrap(~ panel, ncol = 2) +
  coord_equal(xlim = c(-4, 4), ylim = c(-4, 4)) +
  labs(title = "B. Te same 400 osób bez błędu i z błędem pomiaru",
       x = "Miara konstruktu 1", y = "Miara konstruktu 2") + motyw

p1 <- pa / pb + plot_layout(heights = c(1.15, 1))
p1   # zapis: ggsave("korekta-na-atenuacje-krzywe-i-chmury.svg", p1, width = 8, height = 10)
Wynik w R
                   etyk mnoznik r_obs_przy_0.5
1     bez błędu (1 i 1)   1.000          0.500
2 rzetelności .90 i .90   0.900          0.450
3 rzetelności .70 i .80   0.748          0.374
4 rzetelności .60 i .60   0.600          0.300
   r_prawdziwe  r_obserwowane          SD_T1           SD_X   nachylenie_T
         0.524          0.423          0.994          1.167          0.536
nachylenie_obs
         0.391
Jak opisać w pracy
Na co uważać
- Niepewność. Charles (2005) pokazuje, że wnioskowanie ze skorygowanego współczynnika jest trudne; podział granic przedziału przez stałą pomija niepewność samych rzetelności.
- Wartości powyżej 1. Muchinsky (1996) omawia współczynniki większe niż 1.00 i błędne zastosowania korekty. Zwykle oznaczają zaniżoną rzetelność albo zmienność z próby.
- Tylko błąd losowy. Korekta nie usuwa błędu systematycznego. Na poziomie osoby błąd opisuje standardowy błąd pomiaru.
- Regresja. Przy kilku predyktorach lepszy jest model SEM z błędem pomiaru – zob. wpis Błąd pomiaru w regresji.
Korekta na atenuację w R
Kod symuluje wyniki prawdziwe dwóch konstruktów, dodaje błąd pomiaru zgodny z zadaną rzetelnością, liczy korelację obserwowaną z przedziałem ufności i koryguje ją na atenuację.
Korelacja obserwowana i skorygowana przy rzetelności .70 i .80
R
set.seed(4610)
n <- 400; rho <- 0.50                       # prawdziwa korelacja konstruktów
T1 <- rnorm(n); T2 <- rho * T1 + sqrt(1 - rho^2) * rnorm(n)   # wyniki prawdziwe
rxx <- 0.70; ryy <- 0.80                    # rzetelności obu skal
X <- T1 + rnorm(n, sd = sqrt((1 - rxx) / rxx))   # wynik obserwowany = prawdziwy + błąd
Y <- T2 + rnorm(n, sd = sqrt((1 - ryy) / ryy))
r_obs <- cor(X, Y)
r_kor <- r_obs / sqrt(rxx * ryy)            # korekta na atenuację (podwójna)
ci <- tanh(atanh(r_obs) + c(-1, 1) * qnorm(.975) / sqrt(n - 3))   # CI dla r_obs
round(c(r_prawdziwe = cor(T1, T2), oczekiwane_obs = rho * sqrt(rxx * ryy),
        r_obs = r_obs, r_kor = r_kor), 3)
round(rbind(CI_obs = ci, CI_kor = ci / sqrt(rxx * ryy)), 3)  # kolumny: dolna, górna granica
round(0.60 / sqrt(0.60 * 0.55), 2)          # niska rzetelność: wynik powyżej 1
Wynik w R
   r_prawdziwe oczekiwane_obs          r_obs          r_kor
         0.524          0.374          0.423          0.565
        [,1]  [,2]
CI_obs 0.339 0.500
CI_kor 0.453 0.668
[1] 1.04
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (obliczenia bez dodatkowych pakietów). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czy korelacja po korekcie na atenuację może być większa niż 1?
Tak, choć prawdziwa korelacja nie może przekroczyć 1. Zdarza się to przy zaniżonych rzetelnościach albo dużym błędzie losowym w małej próbie i jest sygnałem ostrzegawczym, a nie wynikiem.
Którą rzetelność wstawić do wzoru na korektę na atenuację?
Najlepiej oszacowaną w tej samej próbie, np. alfę lub omegę dla spójności wewnętrznej. Podaj, który współczynnik użyto, bo różne rzetelności dają różne korekty.
Czy w pracy dyplomowej podawać korelację skorygowaną zamiast obserwowanej?
Podaj obie. Korelacja obserwowana jest wynikiem głównym, a skorygowana – dodatkowym szacunkiem związku konstruktów, z wartościami rzetelności użytymi we wzorze.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Rzetelność i błąd pomiaru – wizualizacja
Wynik prawdziwy i błąd przy rzetelności .9/.7/.5, atenuacja w 1000 badań, alfa a liczba pozycji, nachylenie regresji i SEM – pięć rysunków z R.
Czytaj →PoradnikBłąd pomiaru w regresji i korekta na atenuację
Atenuacja i zakłócenie resztkowe przy nierzetelnych skalach, korekta Spearmana, SEM z jednym wskaźnikiem w lavaan, pełny SEM i symulacja estymatorów.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Charles, E. P. (2005). The correction for attenuation due to measurement error: Clarifying concepts and creating confidence sets. Psychological Methods, 10(2), 206–226. https://doi.org/10.1037/1082-989x.10.2.206
- Muchinsky, P. M. (1996). The correction for attenuation. Educational and Psychological Measurement, 56(1), 63–75. https://doi.org/10.1177/0013164496056001004
- Schmidt, F. L., & Hunter, J. E. (1996). Measurement error in psychological research: Lessons from 26 research scenarios. Psychological Methods, 1(2), 199–223. https://doi.org/10.1037/1082-989x.1.2.199
Cytowania BibTeX
@article{charles2005correction, author={Charles, Eric P.}, title={{The correction for attenuation due to measurement error: Clarifying concepts and creating confidence sets}}, journal={Psychological Methods}, year={2005}, volume={10}, number={2}, pages={206--226}, doi={10.1037/1082-989x.10.2.206}}@article{muchinsky1996correction, author={Muchinsky, Paul M.}, title={{The correction for attenuation}}, journal={Educational and Psychological Measurement}, year={1996}, volume={56}, number={1}, pages={63--75}, doi={10.1177/0013164496056001004}}@article{schmidt1996measurement, author={Schmidt, Frank L. and Hunter, John E.}, title={{Measurement error in psychological research: Lessons from 26 research scenarios}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={199--223}, doi={10.1037/1082-989x.1.2.199}}