Błąd pomiaru w regresji: gdzie jest i co psuje
Regresja na wynikach skal zakłada po cichu, że predyktory są zmierzone bez błędu. W badaniach kwestionariuszowych to założenie prawie nigdy nie jest spełnione. Klasyczny model pomiaru zapisuje wynik obserwowany jako sumę wyniku prawdziwego i błędu, X = T + E. Błąd jest losowy i nieskorelowany z T, a rzetelność to udział wariancji wyniku prawdziwego w wariancji wyniku obserwowanego. Przy rzetelności .70 prawie jedna trzecia zmienności wyniku skali to szum.
Skutek zależy od tego, w której zmiennej jest błąd. Keogh i in. (2020) w przewodniku STRATOS osobno omawiają błąd w zmiennych objaśniających i w zmiennej wynikowej. Cole i Preacher (2014) pokazują, że w modelach z kilkoma predyktorami współczynnik może być zarówno zaniżony, jak i zawyżony.
| Gdzie jest błąd | Co się dzieje ze współczynnikiem | Konsekwencja dla wniosków |
|---|---|---|
| Jedyny predyktor | osłabienie (atenuacja): b zbliża się do zera proporcjonalnie do rzetelności predyktora | zaniżony efekt i mniejsza moc testu |
| Zmienna zależna | niestandaryzowane b bez obciążenia, ale większy błąd standardowy; β i R² zaniżone | mniejsza moc, zaniżone miary standaryzowane |
| Zmienna kontrolna | kontrola niepełna: część zakłócenia przechodzi na predyktor badany | pozorny efekt predyktora i zawyżony błąd I rodzaju |
| Kilka predyktorów naraz | obciążenie w dowolnym kierunku, zależne od korelacji i rzetelności | kierunku błędu nie da się przewidzieć bez modelu |
Ten wpis dotyczy regresji. Sam wzór korekty korelacji, jego wersje i przykłady liczbowe opisuje hasło korekta na atenuację. Rzetelność pojedynczego wyniku osoby wyraża standardowy błąd pomiaru. Tutaj zajmujemy się tym, co dzieje się ze współczynnikami regresji i jak je skorygować.
Atenuacja: dlaczego współczynnik maleje
Spearman (1904) zauważył, że korelacja dwóch miar obarczonych błędem jest słabsza od korelacji wyników prawdziwych. Wynosi w przybliżeniu rT × √(rxx × ryy), gdzie rxx i ryy to rzetelności obu miar. W prostej regresji wariancja błędu zwiększa wariancję predyktora, ale nie jego kowariancję z wynikiem. Nachylenie zostaje więc pomnożone przez rzetelność predyktora. Przy rxx = .70 oczekiwane b to 70% prawdziwego. Większa próba tego nie naprawia, daje jedynie węższy przedział wokół złej wartości. Schmidt i Hunter (1996) na 26 scenariuszach badawczych pokazali, jak takie osłabienie zmienia wnioski merytoryczne.
Błąd w zmiennej zależnej działa inaczej. Trafia do reszt i nie obciąża niestandaryzowanego b, ale zwiększa jego błąd standardowy. Zmniejsza też współczynnik standaryzowany i R², bo te miary dzielą przez obserwowane odchylenie standardowe wyniku. Jeśli raportujesz β, a nie b (zob. współczynniki standaryzowane czy niestandaryzowane), błąd w wyniku także zaniża efekt.
Błąd w zmiennej kontrolnej: zakłócenie resztkowe
Najgroźniejszy jest błąd w zmiennej kontrolnej. Dodajemy ją do regresji wielorakiej, żeby usunąć wpływ zmiennej zakłócającej. Jeśli jednak zakłócenie zmierzyliśmy z rzetelnością α = .68 (jak w przykładzie niżej), model kontroluje tylko jego obserwowaną, zaszumioną wersję. Niewyjaśniona część zakłócenia nadal łączy predyktor z wynikiem i pojawia się jako „efekt” predyktora. Spearman (1904) opisywał już, jak błąd w zmiennych zakłócających zniekształca współczynniki. Dziś mówimy o zakłóceniu resztkowym.
Westfall i Yarkoni (2016) pokazali, że przy takiej strategii błąd I rodzaju rośnie z liczebnością próby. W ich przykładzie zmienna zakłócająca o rzetelności .40 pozostawiała fałszywą, istotną korelację cząstkową w 92% symulacji. W duże próby wierzymy najbardziej, a to właśnie w nich pozorny efekt najczęściej wychodzi istotny. Problem dotyczy każdej analizy, w której pytamy, czy konstrukt „wnosi coś ponad” inne zmienne, np. w ocenie trafności przyrostowej.
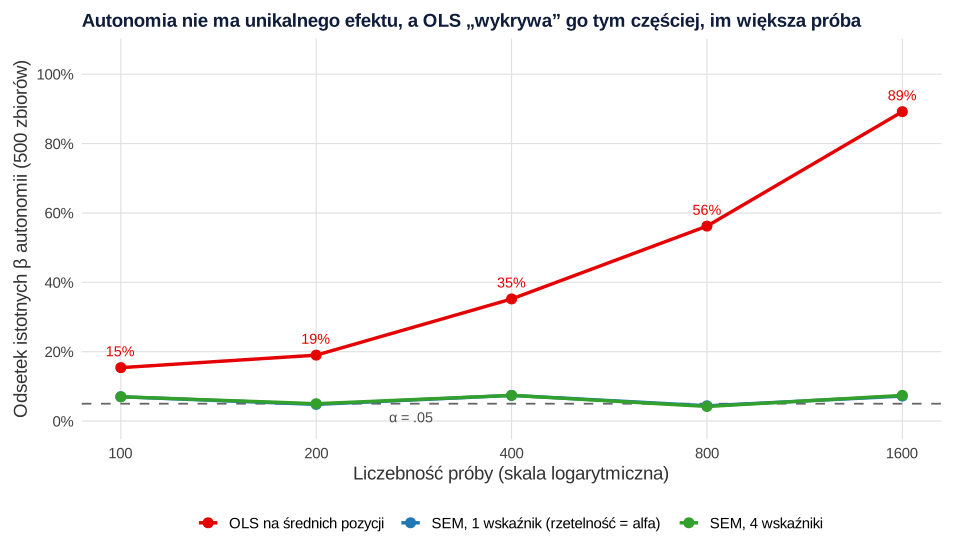
Przy n = 100 OLS odrzucał prawdziwą hipotezę zerową w 15.4% zbiorów, przy n = 400 w 35.2%, a przy n = 1600 w 89.2%. Oba modele uwzględniające błąd pomiaru utrzymywały odsetek od 4.2% do 7.4%.
Przykład: autonomia, wypalenie i zaangażowanie
Badamy 400 nauczycieli. Pytanie brzmi: czy autonomia w pracy (X) wiąże się z zaangażowaniem (Y) po kontroli wypalenia zawodowego (C)? Każdą skalę mierzą cztery pozycje o różnych ładunkach, czyli w modelu kongenerycznym (zob. model tau-ekwiwalentny a kongeneryczny). Dane są symulowane (set.seed(3231)) i znamy prawdę. Autonomia nie ma unikalnego związku z zaangażowaniem (βX = 0). Wypalenie ma efekt βC = −0.50, a korelacja autonomii z wypaleniem na poziomie konstruktów wynosi −.50. Dane możesz pobrać jako plik CSV (pozycje x1–y4 i średnie trzech skal).
| Skala (4 pozycje) | α Cronbacha | ω (CFA) |
|---|---|---|
| Autonomia (X) | .76 | .76 |
| Wypalenie (C, zmienna kontrolna) | .68 | .68 |
| Zaangażowanie (Y) | .84 | .84 |
Rzetelność wypalenia jest przeciętna. Takie wartości często spotyka się w krótkich skalach i nikt nie uznałby ich za dyskwalifikujące. Alfa i omega prawie się nie różnią, bo ładunki w każdej skali są do siebie zbliżone. Jak je liczyć i raportować, opisują wpisy o alfie Cronbacha i omedze McDonalda. Omegę z ładunków policzysz też w kalkulatorze alfy i omegi.
Korekta Spearmana i jej ograniczenia
Obserwowana korelacja autonomii z zaangażowaniem wynosi r = .25. Po korekcie Spearmana z alfami obu skal rośnie do .31, a z omegami do .31. W populacji konstruktów ta korelacja wynosi .25, więc w tej próbie korekta „przestrzeliła”. To nie błąd wzoru, tylko zmienność próby, którą korekta wzmacnia. Charles (2005) przypomina, że skorygowany współczynnik ma większą zmienność niż surowy, a zwykłe przedziały ufności do niego nie pasują.
W regresji wielorakiej korektę stosuje się do całej macierzy korelacji. Każdą korelację dzielimy przez √(rii × rjj), a współczynniki standaryzowane liczymy ze skorygowanej macierzy: β = Rxx−1rxy. Metoda ma cztery ograniczenia:
- Rzetelność musi pasować do błędu. Alfa zakłada model tau-ekwiwalentny i przy ładunkach nierównych zaniża rzetelność (McNeish, 2018), więc wtedy korekta jest zbyt silna. Alfa nie obejmuje też błędu zmienności w czasie. Ten błąd mierzy rzetelność test–retest.
- Brak gotowego błędu standardowego. Wzór daje tylko oszacowanie punktowe. Przedział trzeba wyznaczyć bootstrapem, licząc rzetelność od nowa w każdej próbie, albo metodą Monte Carlo (Charles, 2005).
- Wartości niemożliwe. Skorygowana korelacja może przekroczyć 1, a skorygowana macierz może nie być dodatnio określona. To sygnał, że rzetelności są zaniżone albo błędy pomiaru są skorelowane.
- Tylko błąd klasyczny i model liniowy. Jeśli błędy dwóch skal są skorelowane (ten sam kwestionariusz, ta sama osoba odpowiadająca), korekta nie działa. W regresji logistycznej i modelach przeżycia potrzebne są inne metody, np. kalibracja regresji albo SIMEX (Keogh i in., 2020).
SEM z jednym wskaźnikiem i ustaloną wariancją błędu
Tę samą korektę można zapisać jako model równań strukturalnych. Każdy konstrukt ma jeden wskaźnik, czyli średnią swojej skali. Ładunek ustalamy na 1, a wariancję błędu na (1 − rzetelność) × wariancja wyniku skali. Model ścieżek łączy potem zmienne ukryte, a nie zaszumione średnie. Hayduk i Littvay (2012) zachęcają do modeli z jednym lub kilkoma najlepszymi wskaźnikami. Dzięki nim można uwzględnić więcej zmiennych ukrytych, w tym zmienne zakłócające. Savalei (2019) wykazała w symulacjach dla małych prób (N = 30–200), że takie modele z rzetelnością ustaloną z góry dawały dokładniejsze oszacowania i większą moc niż pełny SEM z wieloma wskaźnikami.
W naszym przykładzie model z jednym wskaźnikiem i alfą jako rzetelnością dał te same oszacowania punktowe co macierzowa korekta Spearmana (różnica rzędu 10−8). Dodatkowo podaje jednak błędy standardowe i przedziały ufności. Trzeba pamiętać, że traktuje rzetelność jako znaną, bez niepewności jej oszacowania. Kod w lavaan (Rosseel, 2012) mieści się w kilku liniach, a składnię modeli omawiamy we wpisach CB-SEM w R i analiza ścieżek w lavaan.
Model z wieloma wskaźnikami
Gdy masz odpowiedzi na wszystkie pozycje, nie musisz podawać rzetelności z zewnątrz. Pełny model SEM szacuje ładunek i wariancję błędu każdej pozycji z danych, a część pomiarowa pozwala sprawdzić, czy skala jest jednowymiarowa. W przykładzie model z czterema wskaźnikami na konstrukt był dobrze dopasowany: χ²(51) = 61.19, p = .155, CFI = .993, RMSEA = .022, SRMR = .032. Pełny model wymaga jednak większej próby (zob. liczebność próby do SEM) i bywa niestabilny, gdy pozycji jest mało albo ładunki są niskie.
| Metoda | βX autonomii [95% CI] | p | βC wypalenia [95% CI] |
|---|---|---|---|
| OLS na średnich pozycji | 0.14 [0.04, 0.24] | .006 | −0.26 [−0.36, −0.16] |
| Macierzowa korekta Spearmana (α), CI bootstrap | 0.11 [−0.09, 0.27] | — | −0.36 [−0.55, −0.19] |
| SEM, 1 wskaźnik, rzetelność = α | 0.11 [−0.05, 0.27] | .183 | −0.36 [−0.52, −0.20] |
| SEM, 1 wskaźnik, rzetelność = ω | 0.11 [−0.05, 0.27] | .180 | −0.36 [−0.52, −0.20] |
| SEM, 4 wskaźniki na konstrukt | 0.11 [−0.05, 0.26] | .175 | −0.37 [−0.52, −0.21] |
OLS na średnich pozycji przypisuje autonomii istotny efekt, choć prawdziwy efekt jest zerowy, a efekt wypalenia zaniża prawie o połowę. Wszystkie metody uwzględniające błąd pomiaru dają βX około 0.11 z przedziałem obejmującym zero oraz efekt wypalenia bliższy prawdziwemu. Ceną są szersze przedziały. To nie wada, tylko uczciwy obraz niepewności.
Symulacja: obciążenie a zmienność estymatorów
Pojedyncza próba może przypadkiem wypaść korzystnie albo niekorzystnie. Dlatego powtórzyliśmy analizę na 1000 zbiorach po n = 400 w dwóch scenariuszach. Scenariusz A to ten z przykładu. W scenariuszu B autonomia ma prawdziwy efekt βX = 0.30, a wypalenie βC = −0.40.
| Scenariusz i metoda | Średnie βX (SD) | RMSE βX | Pokrycie 95% CI | % istotnych βX | Średnie βC |
|---|---|---|---|---|---|
| A: OLS na średnich | 0.079 (.050) | .094 | 63.3% | 36.7% | −0.350 |
| A: SEM, 1 wskaźnik (α) | −0.001 (.075) | .075 | 94.2% | 5.8% | −0.504 |
| A: SEM, 4 wskaźniki | 0.001 (.074) | .074 | 93.9% | 6.1% | −0.501 |
| B: OLS na średnich | 0.296 (.045) | .046 | 95.3% | 100.0% | −0.309 |
| B: SEM, 1 wskaźnik (α) | 0.299 (.070) | .070 | 94.1% | 97.8% | −0.403 |
| B: SEM, 4 wskaźniki | 0.299 (.068) | .068 | 94.2% | 98.4% | −0.401 |
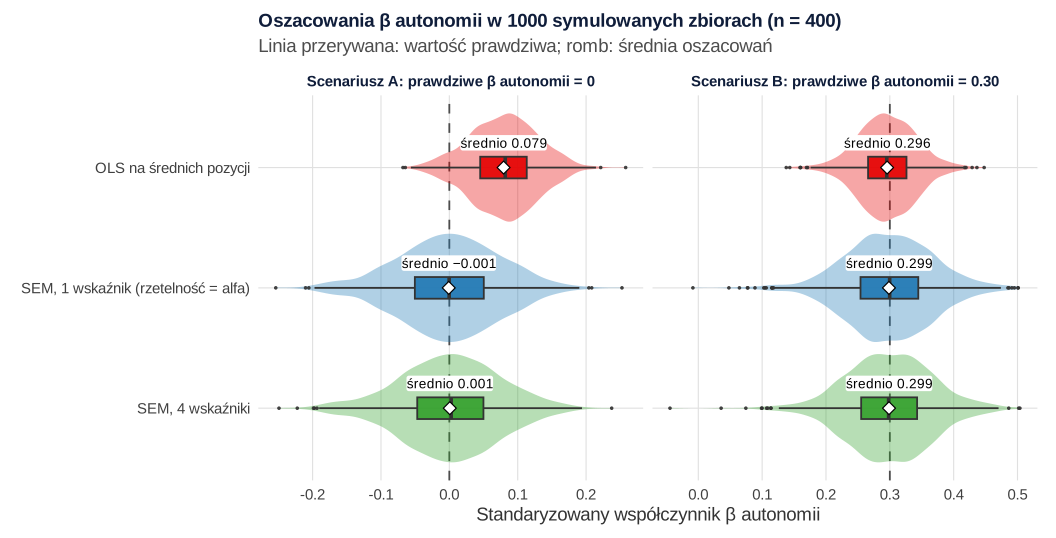
Wnioski są trzy. Po pierwsze, w scenariuszu A OLS ma średnie βX = 0.079 zamiast 0. Jego 95% przedział obejmuje zero tylko w 63.3% zbiorów, a istotny efekt pojawia się w 36.7%. Po drugie, w scenariuszu B OLS trafia w βX prawie idealnie (0.296), bo zaniżenie z powodu nierzetelności autonomii i zawyżenie z powodu nierzetelności wypalenia przypadkiem się znoszą. Efekt wypalenia nadal jest jednak zaniżony (−0.309 zamiast −0.40). To dokładnie ostrzeżenie Cole’a i Preachera (2014): kierunku obciążenia w modelu z wieloma predyktorami nie da się zgadnąć. Po trzecie, korekta usuwa obciążenie kosztem zmienności. SD oszacowań rośnie z około .05 do .07, dlatego tam, gdzie OLS przypadkiem nie jest obciążony, ma mniejszy RMSE. Pełny SEM i model z jednym wskaźnikiem dały przy n = 400 prawie identyczne wyniki.
Jak opisać korektę w artykule
Recenzent musi wiedzieć, jaką rzetelność przyjęto, skąd pochodzi i jak bardzo wynik od niej zależy. Podaj wynik nieskorygowany i skorygowany obok siebie. Opisz błąd pomiaru jako ograniczenie badania, jeśli nie da się go skorygować. Gdy rzetelność jest niepewna, pokaż analizę wrażliwości dla kilku wartości, np. .60, .70 i .80.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy dane i zapisuje plik blad-pomiaru-regresja-dane.csv (możesz go pobrać tutaj). Potrzebne pakiety: lavaan i MASS.
1. Dane i rzetelność skal
R
# Dane symulowane: 400 nauczycieli; trzy skale po 4 pozycje (odpowiedzi ciągłe, wyniki standaryzowane):
# autonomia w pracy (x1–x4), wypalenie zawodowe (c1–c4, zmienna kontrolna) i zaangażowanie w pracę (y1–y4).
# Model prawdziwy na poziomie konstruktów: zaangażowanie = 0 × autonomia − 0.50 × wypalenie + zakłócenie,
# korelacja autonomii z wypaleniem = −.50. Autonomia NIE ma więc unikalnego związku z zaangażowaniem.
suppressPackageStartupMessages({ library(MASS); library(lavaan) })
set.seed(3231)
n <- 400
b_x <- 0; b_c <- -0.50; r_xc <- -0.50
lam <- list(x = c(.60, .65, .70, .75), c = c(.50, .55, .60, .65), y = c(.70, .75, .80, .85))
generuj <- function(n, b_x, b_c, r_xc) {
  T <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, r_xc, r_xc, 1), 2))       # wyniki prawdziwe X i C (wariancja 1)
  var_z <- 1 - (b_x^2 + b_c^2 + 2 * b_x * b_c * r_xc)                    # wariancja zakłócenia, by Var(Y) = 1
  ty <- b_x * T[, 1] + b_c * T[, 2] + rnorm(n, 0, sqrt(var_z))
  poz <- function(t, l, p) { m <- sapply(l, function(li) li * t + rnorm(length(t), 0, sqrt(1 - li^2)))
                             colnames(m) <- paste0(p, 1:4); m }
  data.frame(poz(T[, 1], lam$x, "x"), poz(T[, 2], lam$c, "c"), poz(ty, lam$y, "y"))
}
dane <- generuj(n, b_x, b_c, r_xc)
dane$autonomia <- rowMeans(dane[, paste0("x", 1:4)])
dane$wypalenie <- rowMeans(dane[, paste0("c", 1:4)])
dane$zaangazowanie <- rowMeans(dane[, paste0("y", 1:4)])
write.csv(round(dane, 3), "blad-pomiaru-regresja-dane.csv", row.names = FALSE)

# Rzetelność: alfa Cronbacha (wzór) i omega z jednoczynnikowej CFA (model kongeneryczny)
omega_cfa <- function(d) { f <- cfa(paste("F =~", paste(names(d), collapse = " + ")), data = d, std.lv = TRUE)
  pe <- parameterEstimates(f); l <- pe$est[pe$op == "=~"]; th <- pe$est[pe$op == "~~" & pe$lhs != "F" & pe$lhs == pe$rhs]
  sum(l)^2 / (sum(l)^2 + sum(th)) }
alfa <- function(d) { k <- ncol(d); k / (k - 1) * (1 - sum(apply(d, 2, var)) / var(rowSums(d))) }
rzet <- t(sapply(c(x = "x", c = "c", y = "y"), function(p) { d <- dane[, paste0(p, 1:4)]
  c(alfa = alfa(d), omega = omega_cfa(d)) }))
rownames(rzet) <- c("autonomia", "wypalenie", "zaangazowanie")
print(round(rzet, 3))
cat("Korelacje skal (średnie pozycji):\n"); print(round(cor(dane[, c("autonomia", "wypalenie", "zaangazowanie")]), 3))
# Korekta Spearmana dla jednej korelacji: autonomia–zaangażowanie
r_obs <- cor(dane$autonomia, dane$zaangazowanie)
cat(sprintf("r obserwowane = %.3f; po korekcie (alfa) = %.3f; po korekcie (omega) = %.3f; w populacji konstruktów = %.3f\n",
            r_obs, r_obs / sqrt(rzet[1, 1] * rzet[3, 1]), r_obs / sqrt(rzet[1, 2] * rzet[3, 2]), b_x + b_c * r_xc))
Wynik w R
               alfa omega
autonomia     0.759 0.762
wypalenie     0.678 0.679
zaangazowanie 0.840 0.845
Korelacje skal (średnie pozycji):
              autonomia wypalenie zaangazowanie
autonomia         1.000    -0.403         0.248
wypalenie        -0.403     1.000        -0.319
zaangazowanie     0.248    -0.319         1.000
r obserwowane = 0.248; po korekcie (alfa) = 0.311; po korekcie (omega) = 0.310; w populacji konstruktów = 0.250
2. Pięć estymatorów na jednych danych
R
# Pięć sposobów oszacowania standaryzowanego współczynnika autonomii (β_X) i wypalenia (β_C) w modelu
# zaangażowanie ~ autonomia + wypalenie. Wartości prawdziwe: β_X = 0, β_C = −0.50 (uruchom najpierw przepis 1).
skale <- c("autonomia", "wypalenie", "zaangazowanie")
# (1) OLS na średnich pozycji, zmienne standaryzowane
ols <- lm(scale(zaangazowanie) ~ scale(autonomia) + scale(wypalenie), data = dane)
w_ols <- cbind(coef(summary(ols))[-1, c(1, 2, 4)], confint(ols)[-1, ])
# (2) Korekta Spearmana w wersji macierzowej: korelacje skorygowane r_ij / sqrt(rel_i * rel_j), potem β = R_xx^-1 r_xy
korekta <- function(d, rel) { R <- cor(d[, skale]); Rk <- R / sqrt(outer(rel, rel)); diag(Rk) <- 1
  solve(Rk[1:2, 1:2], Rk[1:2, 3]) }
b_sp <- korekta(dane, rzet[, "alfa"])
set.seed(3232)                                        # bootstrap przypadków (rzetelność liczona w każdej próbie)
boot_sp <- t(replicate(2000, { d <- dane[sample(nrow(dane), replace = TRUE), ]
  rel <- sapply(c("x", "c", "y"), function(p) alfa(d[, paste0(p, 1:4)])); korekta(d, rel) }))
# (3) i (4) SEM z jednym wskaźnikiem: ładunek 1, wariancja błędu ustalona na (1 − rel) × wariancja wyniku skali
model_si <- function(rel, d) { v <- sapply(d[, skale], var) * (nrow(d) - 1) / nrow(d)  # wariancja z dzielnikiem n, jak w lavaan
  e <- (1 - rel) * v
  paste0("X =~ 1*autonomia\nC =~ 1*wypalenie\nY =~ 1*zaangazowanie\n",
         "autonomia ~~ ", e[1], "*autonomia\nwypalenie ~~ ", e[2], "*wypalenie\nzaangazowanie ~~ ", e[3], "*zaangazowanie\n",
         "Y ~ X + C") }
std_beta <- function(fit) { s <- standardizedSolution(fit); s <- s[s$op == "~", ]
  data.frame(efekt = s$rhs, beta = s$est.std, se = s$se, p = s$pvalue, ci_l = s$ci.lower, ci_u = s$ci.upper) }
si_alfa <- sem(model_si(rzet[, "alfa"], dane), data = dane)
si_omega <- sem(model_si(rzet[, "omega"], dane), data = dane)
# (5) Pełny model SEM z czterema wskaźnikami na konstrukt
pelny <- sem("X =~ x1 + x2 + x3 + x4\nC =~ c1 + c2 + c3 + c4\nY =~ y1 + y2 + y3 + y4\nY ~ X + C", data = dane)
tab <- rbind(
  data.frame(metoda = "OLS na średnich", efekt = c("X", "C"), beta = w_ols[, 1], se = w_ols[, 2], p = w_ols[, 3],
             ci_l = w_ols[, 4], ci_u = w_ols[, 5]),
  data.frame(metoda = "Korekta Spearmana (alfa)", efekt = c("X", "C"), beta = b_sp, se = apply(boot_sp, 2, sd), p = NA,
             ci_l = apply(boot_sp, 2, quantile, .025), ci_u = apply(boot_sp, 2, quantile, .975)),
  cbind(metoda = "SEM, 1 wskaźnik (alfa)", std_beta(si_alfa)),
  cbind(metoda = "SEM, 1 wskaźnik (omega)", std_beta(si_omega)),
  cbind(metoda = "SEM, 4 wskaźniki", std_beta(pelny)))
rownames(tab) <- NULL
print(cbind(tab[, 1:2], round(tab[, -(1:2)], 3)), row.names = FALSE)
cat("Różnica punktowa: korekta Spearmana a SEM z jednym wskaźnikiem (alfa):",
    format(max(abs(b_sp - std_beta(si_alfa)$beta)), digits = 2), "\n")
fm <- fitMeasures(pelny, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr"))
print(round(fm, 3))
Wynik w R
                   metoda efekt   beta    se     p   ci_l   ci_u
          OLS na średnich     X  0.143 0.051 0.006  0.042  0.244
          OLS na średnich     C -0.261 0.051 0.000 -0.362 -0.160
 Korekta Spearmana (alfa)     X  0.108 0.089    NA -0.086  0.272
 Korekta Spearmana (alfa)     C -0.362 0.090    NA -0.548 -0.189
   SEM, 1 wskaźnik (alfa)     X  0.108 0.081 0.183 -0.051  0.267
   SEM, 1 wskaźnik (alfa)     C -0.362 0.082 0.000 -0.522 -0.202
  SEM, 1 wskaźnik (omega)     X  0.108 0.080 0.180 -0.050  0.265
  SEM, 1 wskaźnik (omega)     C -0.360 0.081 0.000 -0.519 -0.202
         SEM, 4 wskaźniki     X  0.107 0.079 0.175 -0.048  0.261
         SEM, 4 wskaźniki     C -0.366 0.079 0.000 -0.521 -0.211
Różnica punktowa: korekta Spearmana a SEM z jednym wskaźnikiem (alfa): 2.4e-08
 chisq     df pvalue    cfi  rmsea   srmr
61.186 51.000  0.155  0.993  0.022  0.032
3. Symulacja dwóch scenariuszy
R
# Symulacja: 1000 zbiorów po n = 400 w dwóch scenariuszach (uruchom najpierw przepis 1: funkcje generuj, alfa).
# A: β_X = 0, β_C = −0.50 (autonomia bez unikalnego związku); B: β_X = 0.30, β_C = −0.40. W obu r(X, C) = −.50.
# Estymatory: OLS na średnich, SEM z jednym wskaźnikiem i rzetelnością = alfa z próby (te same oszacowania
# punktowe co macierzowa korekta Spearmana), pełny SEM z czterema wskaźnikami.
suppressPackageStartupMessages(library(lavaan))
set.seed(3233)
jeden <- function(b_x, b_c, n = 400) {
  d <- generuj(n, b_x, b_c, -0.50)
  d$autonomia <- rowMeans(d[, paste0("x", 1:4)]); d$wypalenie <- rowMeans(d[, paste0("c", 1:4)])
  d$zaangazowanie <- rowMeans(d[, paste0("y", 1:4)])
  o <- coef(summary(lm(scale(zaangazowanie) ~ scale(autonomia) + scale(wypalenie), data = d)))
  ci_o <- o[2, 1] + c(-1, 1) * qt(.975, n - 3) * o[2, 2]
  rel <- sapply(c("x", "c", "y"), function(p) alfa(d[, paste0(p, 1:4)]))
  wyn <- function(fit) { s <- standardizedSolution(fit); s <- s[s$op == "~", ]
    c(s$est.std[1], s$est.std[2], s$ci.lower[1], s$ci.upper[1], s$pvalue[1]) }
  si <- tryCatch(wyn(sem(model_si(rel, d), data = d)), error = function(e) rep(NA, 5))
  pe <- tryCatch(wyn(sem("X =~ x1 + x2 + x3 + x4\nC =~ c1 + c2 + c3 + c4\nY =~ y1 + y2 + y3 + y4\nY ~ X + C", data = d)),
                 error = function(e) rep(NA, 5))
  rbind(OLS = c(o[2, 1], o[3, 1], ci_o, o[2, 4]), SI_alfa = si, SEM_4 = pe)
}
podsumuj <- function(r, b_x, b_c) {
  do.call(rbind, lapply(dimnames(r)[[1]], function(m) { x <- r[m, , ]
    data.frame(metoda = m, sr_bx = mean(x[1, ], na.rm = TRUE), sd_bx = sd(x[1, ], na.rm = TRUE),
               rmse_bx = sqrt(mean((x[1, ] - b_x)^2, na.rm = TRUE)), sr_bc = mean(x[2, ], na.rm = TRUE),
               pokrycie_bx = mean(x[3, ] <= b_x & x[4, ] >= b_x, na.rm = TRUE), istotne_bx = mean(x[5, ] < .05, na.rm = TRUE),
               bledy = sum(is.na(x[1, ]))) }))
}
sym <- list()
for (sc in list(c(A = 0, -0.50), c(B = 0.30, -0.40))) {
  r <- suppressWarnings(replicate(1000, jeden(sc[1], sc[2])))
  sym[[names(sc)[1]]] <- r
  cat("Scenariusz", names(sc)[1], ": β_X =", sc[1], ", β_C =", sc[2], "\n")
  print(cbind(podsumuj(r, sc[1], sc[2])[1], round(podsumuj(r, sc[1], sc[2])[-1], 3)), row.names = FALSE)
}
saveRDS(lapply(sym, function(r) r[, 1, ]), "b323-3-symulacja-bx.rds")   # oszacowania β_X do rysunku
Wynik w R
Scenariusz A : β_X = 0 , β_C = -0.5
  metoda  sr_bx sd_bx rmse_bx  sr_bc pokrycie_bx istotne_bx bledy
     OLS  0.079 0.050   0.094 -0.350       0.633      0.367     0
 SI_alfa -0.001 0.075   0.075 -0.504       0.942      0.058     0
   SEM_4  0.001 0.074   0.074 -0.501       0.939      0.061     0
Scenariusz B : β_X = 0.3 , β_C = -0.4
  metoda sr_bx sd_bx rmse_bx  sr_bc pokrycie_bx istotne_bx bledy
     OLS 0.296 0.045   0.046 -0.309       0.953      1.000     0
 SI_alfa 0.299 0.070   0.070 -0.403       0.941      0.978     0
   SEM_4 0.299 0.068   0.068 -0.401       0.942      0.984     0
4. Błąd I rodzaju a liczebność próby
R
# Błąd I rodzaju dla β_X (prawdziwe β_X = 0) w zależności od liczebności próby: 500 zbiorów na każde n.
# Uruchom najpierw przepisy 1–3 (funkcje generuj, alfa, model_si, jeden).
set.seed(3234)
blad_I <- do.call(rbind, lapply(c(100, 200, 400, 800, 1600), function(n) {
  r <- suppressWarnings(replicate(500, jeden(0, -0.50, n = n)))
  data.frame(n = n, OLS = mean(r["OLS", 5, ] < .05), SI_alfa = mean(r["SI_alfa", 5, ] < .05, na.rm = TRUE),
             SEM_4 = mean(r["SEM_4", 5, ] < .05, na.rm = TRUE), sr_bx_OLS = mean(r["OLS", 1, ]),
             bledy = sum(is.na(r["SI_alfa", 5, ])) + sum(is.na(r["SEM_4", 5, ])))
}))
print(round(blad_I, 3), row.names = FALSE)
Wynik w R
    n   OLS SI_alfa SEM_4 sr_bx_OLS bledy
  100 0.154   0.070 0.070     0.090     0
  200 0.190   0.048 0.050     0.079     0
  400 0.352   0.074 0.074     0.081     0
  800 0.562   0.044 0.042     0.077     0
 1600 0.892   0.072 0.074     0.079     0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan i MASS; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Kontrolowaliśmy wypalenie, więc efekt autonomii jest unikalny”. Kontrola zmiennej o rzetelności .70 jest kontrolą częściową. W dużej próbie pozorny efekt łatwo wychodzi istotny.
- Korekta z alfą „z literatury”. Rzetelność zależy od próby. Użyj wartości z własnych danych albo pokaż analizę wrażliwości.
- Raportowanie tylko wyniku skorygowanego. Podawaj oba, z wzorem i użytymi rzetelnościami.
- Korekta przy skorelowanych błędach. Skale z jednego kwestionariusza mogą dzielić błąd metody. Wtedy model z wieloma wskaźnikami i wspólnym czynnikiem metody jest bezpieczniejszy niż wzór.
- Mylenie problemu z współliniowością. Wysoki VIF zwiększa niepewność, ale nie wytwarza obciążenia. Błąd pomiaru je wytwarza.
- Utożsamianie kompozytu z konstruktem w PLS. Klasyczny PLS-SEM również nie usuwa błędu pomiaru z kompozytów (zob. PLS-SEM czy CB-SEM).
Najczęstsze pytania
Czy korekta na atenuację zawsze zwiększa współczynnik regresji?
Tylko w regresji z jednym predyktorem. Przy kilku predyktorach korekta zmienia cały układ korelacji i współczynnik może zmaleć. W przykładzie po uwzględnieniu błędu pomiaru β autonomii spadł z 0.14 do 0.11, a β wypalenia wzrósł co do wartości bezwzględnej z 0.26 do 0.36. Część pozornego efektu autonomii była w rzeczywistości niedokładnie kontrolowanym wypaleniem.
Jaką rzetelność wstawić do modelu z jednym wskaźnikiem?
Najlepiej rzetelność z własnej próby, dopasowaną do rodzaju błędu. Przy nierównych ładunkach lepsza jest omega niż alfa, bo alfa zaniża wtedy rzetelność i korekta jest za silna. Przy konstruktach mierzonych w czasie przyda się rzetelność test–retest. W małych próbach Savalei (2019) uzyskiwała dobre wyniki, ustalając rzetelność z góry na .7 lub .8. Niezależnie od wyboru pokaż analizę wrażliwości dla kilku wartości.
Czy błąd pomiaru w zmiennej zależnej też obciąża regresję?
Niestandaryzowany współczynnik b pozostaje bez obciążenia, bo losowy błąd wyniku trafia do reszt. Rosną jednak błędy standardowe, a maleje moc. Współczynniki standaryzowane i R² są zaniżone, bo dzielimy przez zawyżone odchylenie standardowe wyniku. W modelu z jednym wskaźnikiem można więc ustalić wariancję błędu także dla zmiennej zależnej, tak jak w przykładzie.
Czy duża próba chroni przed skutkami nierzetelnej zmiennej kontrolnej?
Nie, w praktyce jest odwrotnie. Obciążenie nie maleje z liczebnością, a błąd standardowy tak, więc pozorny efekt coraz częściej przekracza próg istotności. W naszej symulacji, przy prawdziwym efekcie równym zero, OLS dawał istotny wynik w 15.4% zbiorów przy n = 100 i w 89.2% przy n = 1600. Modele uwzględniające błąd pomiaru utrzymywały odsetek od 4.2% do 7.4%.
Kiedy wybrać pełny SEM zamiast modelu z jednym wskaźnikiem?
Gdy masz odpowiedzi na pozycje, wystarczająco dużą próbę i chcesz sprawdzić strukturę skal, np. jednowymiarowość albo skorelowane błędy pozycji. Pełny model szacuje rzetelność z danych i nie zakłada równych ładunków. Model z jednym wskaźnikiem jest prostszy i stabilniejszy w małych próbach, ale przyjmuje rzetelność jako znaną. Przy n = 400 oba podejścia dały w symulacji prawie identyczne wyniki.
Powiązane hasła
Przeczytaj też
Rzetelność i błąd pomiaru – wizualizacja
Wynik prawdziwy i błąd przy rzetelności .9/.7/.5, atenuacja w 1000 badań, alfa a liczba pozycji, nachylenie regresji i SEM – pięć rysunków z R.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikCB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →Recenzent pyta, czy wynik nie wynika z nierzetelnych skal?
Pomożemy ocenić rzetelność skal, dobrać korektę albo model z błędem pomiaru (SEM z jednym lub wieloma wskaźnikami) i przygotować analizę wrażliwości tak, żebyś mógł(a) samodzielnie opisać i obronić wyniki.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Charles, E. P. (2005). The correction for attenuation due to measurement error: Clarifying concepts and creating confidence sets. Psychological Methods, 10(2), 206–226. https://doi.org/10.1037/1082-989x.10.2.206
- Cole, D. A., & Preacher, K. J. (2014). Manifest variable path analysis: Potentially serious and misleading consequences due to uncorrected measurement error. Psychological Methods, 19(2), 300–315. https://doi.org/10.1037/a0033805
- Hayduk, L. A., & Littvay, L. (2012). Should researchers use single indicators, best indicators, or multiple indicators in structural equation models? BMC Medical Research Methodology, 12(1), Article 159. https://doi.org/10.1186/1471-2288-12-159 ● Otwarty dostęp
- Keogh, R. H., Shaw, P. A., Gustafson, P., Carroll, R. J., Deffner, V., Dodd, K. W., Küchenhoff, H., Tooze, J. A., Wallace, M. P., Kipnis, V., & Freedman, L. S. (2020). STRATOS guidance document on measurement error and misclassification of variables in observational epidemiology: Part 1—Basic theory and simple methods of adjustment. Statistics in Medicine, 39(16), 2197–2231. https://doi.org/10.1002/sim.8532 ● Otwarty dostęp: pełny tekst
- McNeish, D. (2018). Thanks coefficient alpha, we’ll take it from here. Psychological Methods, 23(3), 412–433. https://doi.org/10.1037/met0000144
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Savalei, V. (2019). A comparison of several approaches for controlling measurement error in small samples. Psychological Methods, 24(3), 352–370. https://doi.org/10.1037/met0000181
- Schmidt, F. L., & Hunter, J. E. (1996). Measurement error in psychological research: Lessons from 26 research scenarios. Psychological Methods, 1(2), 199–223. https://doi.org/10.1037/1082-989x.1.2.199
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
Cytowania BibTeX
@article{charles2005correction, author={Charles, Eric P.}, title={{The correction for attenuation due to measurement error: Clarifying concepts and creating confidence sets}}, journal={Psychological Methods}, year={2005}, volume={10}, number={2}, pages={206--226}, doi={10.1037/1082-989x.10.2.206}}@article{cole2014manifest, author={Cole, David A. and Preacher, Kristopher J.}, title={{Manifest variable path analysis: Potentially serious and misleading consequences due to uncorrected measurement error}}, journal={Psychological Methods}, year={2014}, volume={19}, number={2}, pages={300--315}, doi={10.1037/a0033805}}@article{hayduk2012should, author={Hayduk, Leslie A. and Littvay, Levente}, title={{Should researchers use single indicators, best indicators, or multiple indicators in structural equation models?}}, journal={BMC Medical Research Methodology}, year={2012}, volume={12}, number={1}, eid={159}, doi={10.1186/1471-2288-12-159}}@article{keogh2020stratos, author={Keogh, Ruth H. and Shaw, Pamela A. and Gustafson, Paul and Carroll, Raymond J. and Deffner, Veronika and Dodd, Kevin W. and Küchenhoff, Helmut and Tooze, Janet A. and Wallace, Michael P. and Kipnis, Victor and Freedman, Laurence S.}, title={{STRATOS guidance document on measurement error and misclassification of variables in observational epidemiology: Part 1—Basic theory and simple methods of adjustment}}, journal={Statistics in Medicine}, year={2020}, volume={39}, number={16}, pages={2197--2231}, doi={10.1002/sim.8532}}@article{mcneish2018thanks, author={McNeish, Daniel}, title={{Thanks coefficient alpha, we’ll take it from here}}, journal={Psychological Methods}, year={2018}, volume={23}, number={3}, pages={412--433}, doi={10.1037/met0000144}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{savalei2019comparison, author={Savalei, Victoria}, title={{A comparison of several approaches for controlling measurement error in small samples}}, journal={Psychological Methods}, year={2019}, volume={24}, number={3}, pages={352--370}, doi={10.1037/met0000181}}@article{schmidt1996measurement, author={Schmidt, Frank L. and Hunter, John E.}, title={{Measurement error in psychological research: Lessons from 26 research scenarios}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={199--223}, doi={10.1037/1082-989x.1.2.199}}@article{spearman1904proof, author={Spearman, Charles}, title={{The proof and measurement of association between two things}}, journal={The American Journal of Psychology}, year={1904}, volume={15}, number={1}, pages={72--101}, doi={10.2307/1412159}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}