Wynik prawdziwy plus błąd – na rysunkach
Każdy wynik kwestionariusza to suma dwóch części: wyniku prawdziwego, którego nie widać, i błędu pomiaru. Definicje i rodzaje rzetelności znajdziesz w słowniku, a obliczenia alfy krok po kroku – we wpisie alfa Cronbacha – rzetelność skali. Tutaj pokazujemy na rysunkach, co błąd pomiaru robi z danymi i z wynikami analiz: z chmurą punktów, z korelacją, z alfą, z nachyleniem regresji i z wynikiem jednej osoby.
W symulacji wynik prawdziwy znamy, bo sami go losujemy. Przykład jest fikcyjny: skala motywacji do nauki, wynik prawdziwy ze średnią 24 punkty i SD = 6. Do wyniku dodajemy błąd o takim rozrzucie, by rzetelność wynosiła .9, .7 albo .5. Te wartości, a także liczebności i liczby powtórzeń, ustawiliśmy ręcznie tak, by różnice między poziomami rzetelności były wyraźne. Ziarno 597 ustalono raz i nie zmieniano go. Dane do rysunku 1 pobierzesz jako rzetelnosc-blad-pomiaru-250-osob.csv.
Rysunek 1: ten sam wynik prawdziwy, trzy rzetelności
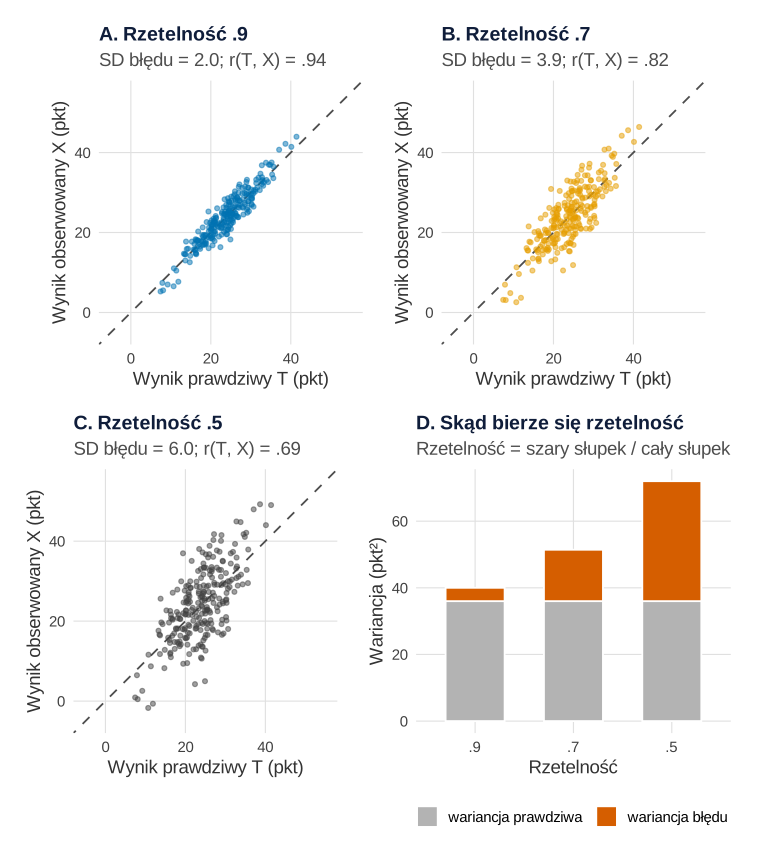
set.seed(597)).Co widać. Na osi poziomej jest wynik prawdziwy, na pionowej – zmierzony. Pomiar bez błędu leżałby na przekątnej. Wszystkie trzy panele mają te same wyniki prawdziwe i ten sam wzór losowych błędów, zmienia się tylko jego skala. Przy rzetelności .9 błąd ma SD = 2 punkty, a przy .5 – aż 6 punktów. Korelacja wyniku zmierzonego z prawdziwym spada z .94 do .82 i .69. Panel D pokazuje, skąd bierze się rzetelność: wariancja prawdziwa jest stała (36), a rośnie tylko wariancja błędu. Rzetelność to udział szarej części w całym słupku. Dlatego przy gorszym pomiarze SD wyników rośnie z 6.49 do 9.19, choć ludzie się nie zmienili.
Czego ten wykres nie pokazuje. W prawdziwych danych wyniku prawdziwego nikt nie zna. Rzetelność trzeba oszacować, na przykład z korelacji dwóch pomiarów (rzetelność test–retest) albo ze spójności wewnętrznej. W próbie 250 osób udział wariancji prawdziwej wyszedł .848, .620 i .424 zamiast .9, .7 i .5 – nawet przy znanym modelu oszacowanie się waha. Model nie ma granic skali, dlatego pojedyncze wyniki obserwowane wychodzą od −1.7 do 49.2 punktu. Rysunek zakłada też błąd losowy, niezależny od wyniku prawdziwego, o tym samym rozrzucie u wszystkich. Błąd systematyczny (np. zawyżanie odpowiedzi) wygląda inaczej i rzetelność go nie wykrywa.
Podpis do pracy (np. w rozdziale teoretycznym o narzędziu):
Zdanie do Metody:
Rysunek 2: atenuacja w 1000 badań
Teraz dwie skale, na przykład motywacja i zaangażowanie. Ich wyniki prawdziwe korelują na poziomie ρ = .5. Symulujemy po 1000 badań w sześciu scenariuszach: obie skale mają rzetelność .9, .7 albo .5, a każde badanie liczy 80 albo 300 osób. Oczekiwana obserwowana korelacja Pearsona to .5 × √(rzetelność × rzetelność), czyli tutaj .5 × rzetelność.
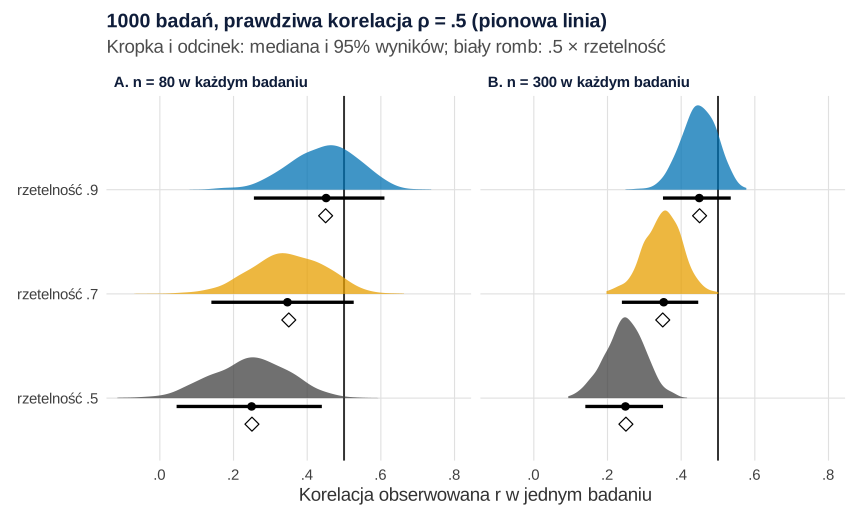
set.seed(597)).Co widać. Żaden rozkład nie jest wyśrodkowany na .5. Średnia korelacja przy n = 80 wyniosła .445, .347 i .246 – prawie dokładnie tyle, ile przewiduje wzór (.45, .35 i .25). To atenuacja, opisana już przez Spearmana (1904): błąd pomiaru zaniża korelację. Większa próba nie przesuwa rozkładu, tylko go zwęża. Przy n = 300 i rzetelności .5 95% wyników mieści się między .140 a .351, więc prawie każde badanie z pewnością pokaże „słaby związek”. Na tym samym wzorze klasycznej teorii testów Schmidt i Hunter (1996) oparli analizę 26 rzeczywistych scenariuszy badawczych.
Atenuacja zabiera też moc testu. Przy n = 80 istotną korelację (p < .05) dało 98.5% badań przy rzetelności .9, 89.4% przy .7 i tylko 61.3% przy .5. Błąd Monte Carlo tych odsetków to od 0.4 do 1.5 punktu procentowego. Przy n = 300 istotnych było co najmniej 99.4% badań w każdym scenariuszu.
Czego ten wykres nie pokazuje. Przy n = 80 i rzetelności .9 aż 29.6% badań dało r ≥ .5, mimo zaniżenia średniego wyniku. Przy rzetelności .5 – tylko 0.4%. Pojedyncze badanie może więc wypaść wyżej od prawdy, a wtedy korekta na atenuację jeszcze zawyży wynik. Ten rozrzut wynika z błędu losowania, nie z błędu pomiaru. Symulacja zakłada rozkład normalny, pełny zakres zmiennych i błędy niezależne w obu skalach. Zawężony zakres zaniża korelację z innego powodu – zob. ograniczony zakres zmiennej – wizualizacja na obrazkach. Wzór korekty i jej przedziały omawia wpis błąd pomiaru w regresji i korekta na atenuację.
Podpis do pracy:
Zdanie do Dyskusji:
Rysunek 3: alfa a liczba pozycji
Rzetelność zależy nie tylko od jakości pozycji, ale też od ich liczby. Wzór Spearmana–Browna – nazwany od dwóch prac z tego samego zeszytu czasopisma (Brown, 1910; Spearman, 1910) – przewiduje rzetelność skali z k równoważnych pozycji na podstawie średniej korelacji między nimi. Szczegóły wzoru i rzetelność połówkowa są w haśle rzetelność połówkowa i wzór Spearmana–Browna.
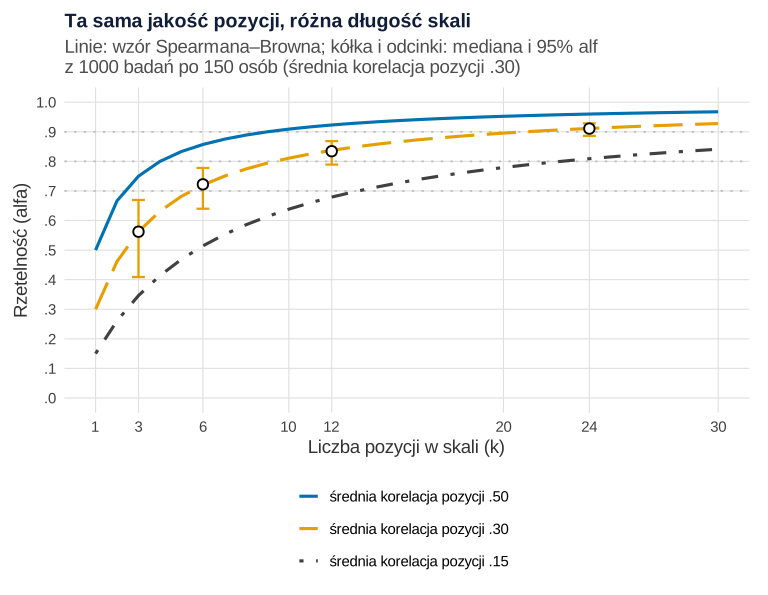
set.seed(597)).Co widać. Do alfy .80 wystarczą 4 pozycje o średniej korelacji .50, ale potrzeba 10 pozycji o korelacji .30 i 23 o korelacji .15. Słabo powiązane pozycje (.15) dają .41 przy 4 pozycjach i .81 przy 24 – ta sama jakość pozycji, dwie różne oceny skali. Kółka to symulacja: 1000 badań po 150 osób dla skal z 3, 6, 12 i 24 pozycji o średniej korelacji .30. Mediany alf (.562, .722, .834 i .911) leżą na krzywej wzoru. Przy krótkiej skali alfa bardzo się jednak waha między badaniami. Przy 3 pozycjach 95% wyników mieści się między .409 a .669, a przy 6 pozycjach 27.5% badań daje alfę poniżej .70, choć wartość oczekiwana wynosi .720.
Czego ten wykres nie pokazuje. Wysoka alfa długiej skali nie znaczy, że pozycje mierzą jedną rzecz. Cortina (1993) pokazał na hipotetycznych testach, jak długość skali i liczba niezależnych wymiarów wpływają na alfę. Symulacja zakłada pozycje równoległe, czyli jednakowo dobre. Gdy ładunki się różnią, lepszą miarą jest omega McDonalda. Co zrobić z niską alfą krótkiej skali, opisuje wpis alfa Cronbacha poniżej .70.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: błąd w predyktorze spłaszcza nachylenie
Ten sam mechanizm działa w regresji, ale tylko w jedną stronę. Prawdziwy model: liczba godzin nauki w tygodniu = 4 + 0.40 × motywacja + reszta (SD reszty = 4; parametry ustalone ręcznie). Błąd pomiaru dodajemy raz do motywacji (predyktora), raz do godzin nauki (wyniku).
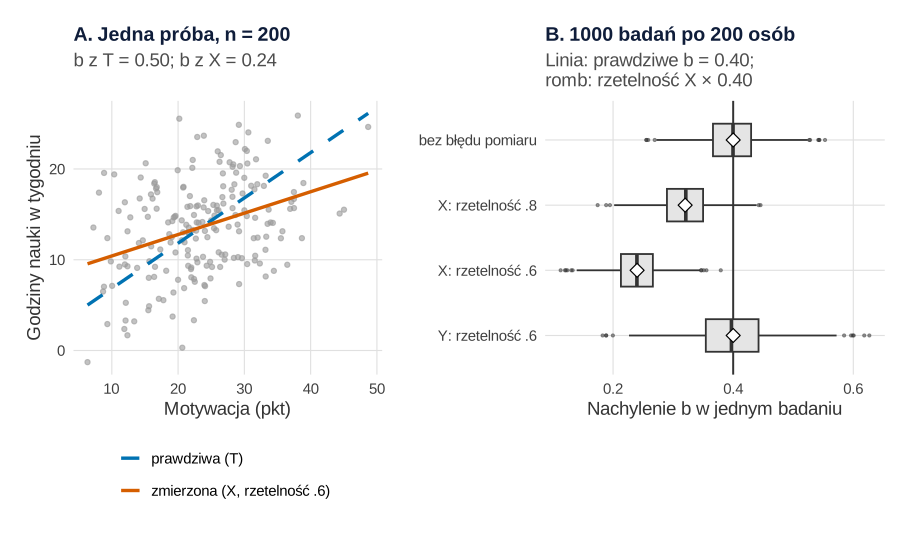
set.seed(597)).Co widać. Panel A to jedna próba 200 osób. Z prawdziwej motywacji wychodzi b = 0.50, 95% CI [0.40, 0.60] – więcej niż 0.40 w populacji, to zwykły błąd losowania. Z motywacji zmierzonej z rzetelnością .6 wychodzi b = 0.24 [0.15, 0.32]. Średnie nachylenie wyniosło 0.399 bez błędu, 0.319 przy rzetelności predyktora .8 i 0.240 przy .6 – czyli rzetelność × 0.40. Przedział ufności objął prawdziwe 0.40 w 95.2% badań bez błędu, w 56.5% przy rzetelności .8 i tylko w 1.8% przy .6. Błąd w wyniku działa inaczej: średnie b = 0.398 i pokrycie 94.9%, ale SD nachyleń rośnie z 0.047 do 0.067. Wynik mierzony z błędem kosztuje więc precyzję, a predyktor mierzony z błędem obciąża wynik.
Czego ten wykres nie pokazuje. To przypadek z jednym predyktorem i błędem losowym. Przegląd grupy STRATOS (Keogh i in., 2020) opisuje, jak różne rodzaje błędu w zmiennych objaśniających i w wyniku zmieniają estymację i testy w regresji, oraz dwie proste metody korekty: kalibrację regresji i SIMEX. Gdy predyktorów jest kilka, błąd w jednym z nich może zawyżyć współczynnik drugiego, bo niedokładnie mierzona zmienna kontrolna słabiej kontroluje zakłócenie (zob. zmienna zakłócająca i collider – wizualizacja na obrazkach). Ten sam problem dotyczy kowariantu w ANCOVA (zob. ANCOVA – wizualizacja na obrazkach), a przy interakcji błąd obu zmiennych dodatkowo osłabia iloczyn (moderacja – wizualizacja na obrazkach).
Podpis do pracy:
Zdanie do Dyskusji (ograniczenia):
Rysunek 5: SEM jako przedział wokół wyniku osoby
Standardowy błąd pomiaru (SEM) to SD wyników pomnożone przez √(1 − rzetelność). Harvill (1991) opisuje go jako odchylenie standardowe błędów pomiaru w danej grupie, z którego buduje się przedziały wokół wyników uzyskanych. Symulujemy 10 000 osób z tym samym rozkładem wyników prawdziwych co na rysunku 1 i budujemy przedział X ± 1.96 × SEM.
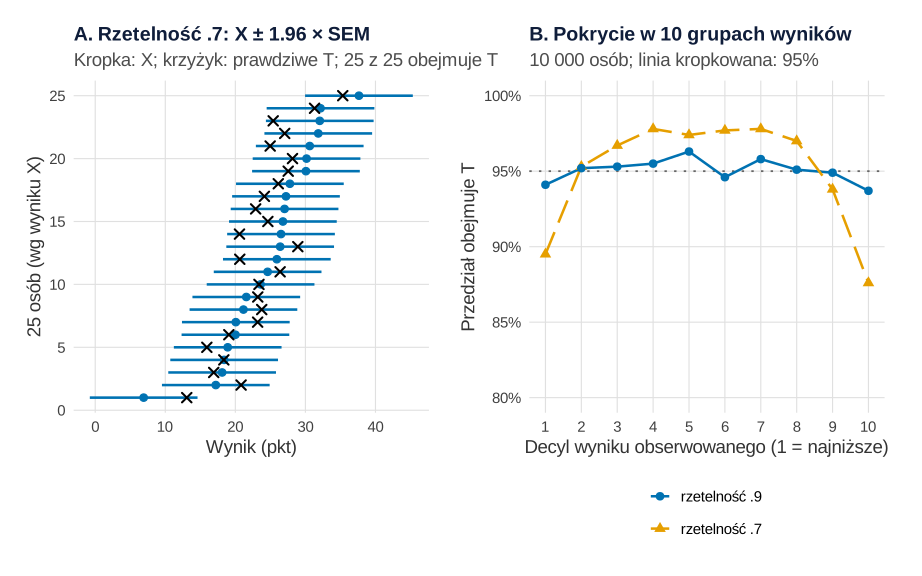
set.seed(597)).Co widać. Przy rzetelności .7 SEM wynosi 3.92 punktu, więc przedział ma ±7.69 punktu. Osoba z wynikiem 30 dostaje przedział od 22.3 do 37.7. Przy rzetelności .9 SEM = 2.00, a przedział to 26.1–33.9. W panelu A wszystkie 25 przedziałów objęło wynik prawdziwy. W całej grupie 10 000 osób odsetek wyniósł 95.06% przy rzetelności .7 i 95.05% przy .9 (błąd Monte Carlo 0.22 punktu procentowego). Panel B pokazuje, że te 95% to średnia. Przy rzetelności .7 przedział trafia w 96.7–97.8% osób ze środkowych decyli (od 3. do 8.), ale tylko w 89.5% osób z najniższego i 87.6% z najwyższego decyla (błąd Monte Carlo w decylu do 1 punktu). Skrajny wynik częściej zawiera duży błąd w tę samą stronę, więc wynik prawdziwy leży zwykle bliżej średniej. To ten sam mechanizm co regresja do średniej – zob. regresja do średniej – wizualizacja na obrazkach.
Czego ten wykres nie pokazuje. Model ma jeden SEM dla wszystkich. W prawdziwych testach błąd bywa różny na różnych poziomach wyniku. Harvill (1991) zaleca dlatego liczyć SEM osobno dla różnych poziomów i przestrzega przed nadinterpretacją przybliżeń. Różnica dwóch osób (albo dwóch pomiarów tej samej osoby) ma błąd √2 razy większy. Przy rzetelności .7 dopiero różnica powyżej 10.87 punktu przekracza 1.96 takiego błędu, a przy .9 – powyżej 5.53. Na tej logice opiera się wskaźnik wiarygodnej zmiany (RCI).
Podpis do pracy:
Zdanie do Wyników (opis indywidualny):
Co zrobić w praktyce
- Podaj rzetelność każdej skali z Twojej próby, nie tylko z podręcznika testu. Przy krótkich podskalach dodaj liczbę pozycji i średnią korelację między pozycjami (rysunek 3).
- Interpretuj słabą korelację ostrożnie, gdy rzetelność jest niska. Napisz w Dyskusji, ile wynosiłaby korelacja oczekiwana przy Twoich rzetelnościach (rysunek 2). Korektę na atenuację podaj obok wyniku surowego, nigdy zamiast niego.
- Zaplanuj liczebność z uwzględnieniem rzetelności. Zakładaną korelację pomnóż przez √(rzetelność × rzetelność), zanim wpiszesz go do analizy mocy (zob. moc testu w obrazkach).
- Przy regresji pamiętaj, gdzie jest błąd: w predyktorze zaniża nachylenie, w wyniku zmniejsza precyzję (rysunek 4).
- Wyników pojedynczych osób nie podawaj bez przedziału SEM i nie interpretuj różnic mniejszych niż 1.96 × SEM × √2 (rysunek 5).
Gotowe zdanie do rozdziału o ograniczeniach pracy dyplomowej:
Na wykresach rozrzutu wielu zmiennych naraz efekt atenuacji widać w każdej komórce macierzy – zob. korelacje na wykresie.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i funkcję pomocniczą, z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1–5), zaczyna się od własnego set.seed(597), więc skopiowany osobno da te same liczby co na stronie. Ziarno 597 ustalono raz i nie zmieniano go. Ręcznie ustalono: rozkład wyników prawdziwych (średnia 24, SD = 6), poziomy rzetelności .9, .7 i .5, liczebności (250, 80 i 300, 150, 200 i 10 000 osób), prawdziwą korelację .5, średnie korelacje pozycji .15, .30 i .50, model regresji (4 + 0.40 × motywacja, SD reszty 4), 1000 powtórzeń w każdej symulacji i 25 osób w panelu A rysunku 5. Cały kod liczy się w kilka sekund.
1. Wyniki prawdziwe, trzy rzetelności i podział wariancji: Rysunek 1
R
# Rysunek 1. Te same wyniki prawdziwe zmierzone z rzetelnością .9, .7 i .5 (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski, pomarańczowy, ciemnoszary; sprawdzona w symulacji deuteranopii) i prosty motyw
kol <- c(r90 = "#0072B2", r70 = "#E69F00", r50 = "grey25", prawdziwa = "grey70", blad = "#D55E00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03

# 250 osób, skala motywacji do nauki (wynik w punktach). Parametry ustalone ręcznie:
# wynik prawdziwy T ~ N(24, 6); błąd E ~ N(0, SD_E), a SD_E dobrane tak, by rzetelność
# var(T) / [var(T) + var(E)] wynosiła .9, .7 albo .5. Ten sam wzór losowych błędów (z) we wszystkich wersjach
n <- 250; mu_T <- 24; sd_T <- 6; rzet <- c(0.9, 0.7, 0.5)
sd_E <- sd_T * sqrt((1 - rzet) / rzet)
set.seed(597)                                    # ziarno ustalone raz, bez dobierania pod wynik
T_prawdziwy <- rnorm(n, mu_T, sd_T)
z <- rnorm(n)
X <- sapply(sd_E, function(s) T_prawdziwy + s * z)
colnames(X) <- c("X_rzet_90", "X_rzet_70", "X_rzet_50")
dane <- data.frame(osoba = 1:n, T_prawdziwy = round(T_prawdziwy, 2), round(X, 2))
write.csv(dane, "rzetelnosc-blad-pomiaru-250-osob.csv", row.names = FALSE)

# Dla każdej wersji: SD błędu, SD wyniku obserwowanego, udział wariancji prawdziwej,
# korelacja T z X i jej kwadrat (w populacji wszystkie trzy ostatnie miary to rzetelność lub jej pierwiastek)
opis <- data.frame(rzetelnosc = rzet, SD_bledu = sd_E, SD_T = sd(T_prawdziwy), SD_X = apply(X, 2, sd),
                   udzial_var_T = var(T_prawdziwy) / apply(X, 2, var),
                   r_TX = apply(X, 2, cor, T_prawdziwy))
opis$r_TX_kwadrat <- opis$r_TX^2
print(round(opis, 3), row.names = FALSE)
round(range(X), 1)                               # zakres wyników obserwowanych (model bez granic skali)

# A–C: wynik obserwowany względem prawdziwego; linia przerywana: X = T (pomiar bez błędu)
chmura <- function(k, kolor, litera) {
  d <- data.frame(T = T_prawdziwy, X = X[, k])
  ggplot(d, aes(T, X)) +
    geom_abline(slope = 1, intercept = 0, colour = "grey30", linetype = "dashed") +
    geom_point(colour = kolor, alpha = 0.5, size = 1.3) +
    coord_equal(xlim = c(-5, 55), ylim = c(-5, 55)) +
    labs(x = "Wynik prawdziwy T (pkt)", y = "Wynik obserwowany X (pkt)",
         title = sprintf("%s. Rzetelność %s", litera, bz(rzet[k], 1)),
         subtitle = sprintf("SD błędu = %.1f; r(T, X) = %s", sd_E[k], bz(opis$r_TX[k]))) + motyw
}
pa <- chmura(1, kol[["r90"]], "A"); pb <- chmura(2, kol[["r70"]], "B"); pc <- chmura(3, kol[["r50"]], "C")

# D: wariancja wyniku obserwowanego = wariancja prawdziwa (stała) + wariancja błędu (rośnie)
skl <- data.frame(wersja = factor(rep(bz(rzet, 1), 2), bz(rzet, 1)),
                  skladnik = factor(rep(c("wariancja prawdziwa", "wariancja błędu"), each = 3),
                                    c("wariancja błędu", "wariancja prawdziwa")),
                  wartosc = c(rep(sd_T^2, 3), sd_E^2))
pd <- ggplot(skl, aes(wersja, wartosc, fill = skladnik)) +
  geom_col(width = 0.6, colour = "white") +
  scale_fill_manual(values = c("wariancja prawdziwa" = kol[["prawdziwa"]], "wariancja błędu" = kol[["blad"]]),
                    name = NULL, breaks = c("wariancja prawdziwa", "wariancja błędu")) +
  labs(x = "Rzetelność", y = "Wariancja (pkt²)", title = "D. Skąd bierze się rzetelność",
       subtitle = "Rzetelność = szary słupek / cały słupek") + motyw
p1 <- (pa + pb) / (pc + pd)
p1   # zapis: ggsave("rzetelnosc-chmury-prawdziwy-obserwowany.svg", p1, width = 8, height = 9)
Wynik w R
 rzetelnosc SD_bledu  SD_T  SD_X udzial_var_T  r_TX r_TX_kwadrat
        0.9    2.000 5.979 6.492        0.848 0.940        0.884
        0.7    3.928 5.979 7.590        0.620 0.820        0.673
        0.5    6.000 5.979 9.187        0.424 0.692        0.478
[1] -1.7 49.2
2. Atenuacja w 1000 badań: Rysunek 2
R
# Rysunek 2. Atenuacja: 1000 badań przy prawdziwej korelacji ρ = .5 i rzetelności obu skal .9, .7 albo .5
# (symulacja Monte Carlo; kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)
library(ggdist)

# Jedno badanie: n osób, wyniki prawdziwe T1, T2 o korelacji rho (w jednostkach z),
# do każdego dodany błąd tak, by rzetelność obu skal wynosiła rzet. Zwraca obserwowane r i p
badanie <- function(n, rzet, rho = 0.5) {
  T1 <- rnorm(n); T2 <- rho * T1 + sqrt(1 - rho^2) * rnorm(n)
  s <- sqrt((1 - rzet) / rzet)
  r <- cor(T1 + s * rnorm(n), T2 + s * rnorm(n))
  c(r = r, p = 2 * pt(-abs(r * sqrt((n - 2) / (1 - r^2))), n - 2))
}
R <- 1000                                        # liczba badań w każdym scenariuszu
siatka <- expand.grid(rzet = c(0.9, 0.7, 0.5), n = c(80, 300))
set.seed(597)
sym <- do.call(rbind, lapply(seq_len(nrow(siatka)), function(i) {
  w <- t(replicate(R, badanie(siatka$n[i], siatka$rzet[i])))
  data.frame(rzet = siatka$rzet[i], n = siatka$n[i], r = w[, "r"], p = w[, "p"])
}))

# Oczekiwana korelacja obserwowana: ρ × √(rzet × rzet) = .5 × rzet; odsetek istotnych (p < .05) z błędem
# Monte Carlo i odsetek badań, w których r wyszło co najmniej .5
podsum <- do.call(rbind, lapply(split(sym, list(sym$rzet, sym$n)), function(d) {
  ist <- mean(d$p < .05); pow <- mean(d$r >= 0.5)
  data.frame(rzet = d$rzet[1], n = d$n[1], oczek_r = 0.5 * d$rzet[1], sr_r = mean(d$r), SD_r = sd(d$r),
             r_2.5 = unname(quantile(d$r, .025)), r_97.5 = unname(quantile(d$r, .975)),
             proc_ist = 100 * ist, bladMC = 100 * sqrt(ist * (1 - ist) / R), proc_r_od_.5 = 100 * pow)
}))
print(round(podsum, 3), row.names = FALSE)

sym$wersja <- factor(sym$rzet, c(0.5, 0.7, 0.9), paste("rzetelność", bz(c(0.5, 0.7, 0.9), 1)))
sym$panel <- factor(sym$n, c(80, 300), c("A. n = 80 w każdym badaniu", "B. n = 300 w każdym badaniu"))
oczek <- unique(sym[c("wersja", "panel", "rzet")]); oczek$r <- 0.5 * oczek$rzet
p2 <- ggplot(sym, aes(r, wersja, fill = wersja)) +
  geom_vline(xintercept = 0.5, colour = "grey20", linewidth = 0.7) +
  stat_slab(alpha = 0.75, height = 0.9, colour = NA) +
  stat_pointinterval(.width = 0.95, point_interval = "median_qi", colour = "black", point_size = 2,
                     position = position_nudge(y = -0.08)) +
  geom_point(data = oczek, aes(r, wersja), shape = 23, size = 3.5, fill = "white", colour = "black",
             position = position_nudge(y = -0.25)) +
  facet_wrap(~ panel, ncol = 2) +
  scale_fill_manual(values = c("rzetelność .5" = kol[["r50"]], "rzetelność .7" = kol[["r70"]],
                               "rzetelność .9" = kol[["r90"]]), guide = "none") +
  scale_x_continuous(breaks = seq(0, 0.8, 0.2), labels = function(x) bz(x, 1)) +
  coord_cartesian(xlim = c(-0.1, 0.8)) +
  labs(x = "Korelacja obserwowana r w jednym badaniu", y = NULL,
       title = "1000 badań, prawdziwa korelacja ρ = .5 (pionowa linia)",
       subtitle = "Kropka i odcinek: mediana i 95% wyników; biały romb: .5 × rzetelność") + motyw
p2   # zapis: ggsave("rzetelnosc-atenuacja-1000-badan.svg", p2, width = 9, height = 5.4)
Wynik w R
 rzet   n oczek_r  sr_r  SD_r r_2.5 r_97.5 proc_ist bladMC proc_r_od_.5
  0.5  80    0.25 0.246 0.105 0.045  0.440     61.3  1.540          0.4
  0.7  80    0.35 0.347 0.102 0.140  0.526     89.4  0.973          5.7
  0.9  80    0.45 0.445 0.094 0.255  0.610     98.5  0.384         29.6
  0.5 300    0.25 0.248 0.054 0.140  0.351     99.4  0.244          0.0
  0.7 300    0.35 0.350 0.051 0.239  0.446    100.0  0.000          0.1
  0.9 300    0.45 0.448 0.048 0.351  0.535    100.0  0.000         14.5
3. Alfa a liczba pozycji: Rysunek 3
R
# Rysunek 3. Alfa a liczba pozycji: krzywe Spearmana–Browna i alfa z 1000 symulowanych badań
# (kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)

# Wzór Spearmana–Browna dla k równoważnych pozycji o średniej korelacji między pozycjami r_sr
# (dla pozycji równoległych to także oczekiwana alfa standaryzowana)
sb <- function(k, r_sr) k * r_sr / (1 + (k - 1) * r_sr)
krzywe <- expand.grid(k = 1:30, r_sr = c(0.15, 0.30, 0.50))
krzywe$rzetelnosc <- sb(krzywe$k, krzywe$r_sr)
# Ile pozycji potrzeba do .70, .80 i .90 przy danej średniej korelacji między pozycjami
ile <- sapply(c(0.15, 0.30, 0.50), function(r) sapply(c(0.70, 0.80, 0.90), function(cel) min(which(sb(1:200, r) >= cel))))
dimnames(ile) <- list(cel = c(".70", ".80", ".90"), r_sr = c(".15", ".30", ".50")); ile
round(sb(c(4, 8, 24), 0.15), 3)          # te same pozycje słabo powiązane: 4, 8 i 24 sztuki

# Symulacja: skala z k pozycjami równoległymi (r_sr = .30), n = 150 osób, 1000 badań na każdą długość.
# Alfa Cronbacha liczona wprost ze wzoru: k/(k − 1) × (1 − suma wariancji pozycji / wariancja sumy)
alfa <- function(m) { k <- ncol(m); k / (k - 1) * (1 - sum(apply(m, 2, var)) / var(rowSums(m))) }
jedno_badanie <- function(k, n = 150, r_sr = 0.30) {
  f <- rnorm(n)                                                   # wspólny czynnik
  alfa(sqrt(r_sr) * f + sqrt(1 - r_sr) * matrix(rnorm(n * k), n)) # pozycja = czynnik + błąd pozycji
}
set.seed(597)
dlug <- c(3, 6, 12, 24)
sym <- do.call(rbind, lapply(dlug, function(k) {
  a <- replicate(1000, jedno_badanie(k))
  data.frame(k = k, wzor = sb(k, 0.30), mediana = median(a), q2.5 = unname(quantile(a, .025)),
             q97.5 = unname(quantile(a, .975)), proc_ponizej_.70 = 100 * mean(a < 0.70))
}))
print(round(sym, 3), row.names = FALSE)

krzywe$wersja <- factor(krzywe$r_sr, c(0.50, 0.30, 0.15), paste("średnia korelacja pozycji", bz(c(0.50, 0.30, 0.15))))
p3 <- ggplot(krzywe, aes(k, rzetelnosc, colour = wersja, linetype = wersja)) +
  geom_hline(yintercept = c(0.70, 0.80, 0.90), colour = "grey75", linetype = "dotted") +
  geom_line(linewidth = 1.1) +
  geom_errorbar(data = sym, aes(x = k, ymin = q2.5, ymax = q97.5), inherit.aes = FALSE, width = 0.6,
                colour = kol[["r70"]], linewidth = 0.8) +
  geom_point(data = sym, aes(k, mediana), inherit.aes = FALSE, shape = 21, size = 3, fill = "white",
             colour = "black", stroke = 1) +
  scale_colour_manual(values = c(kol[["r90"]], kol[["r70"]], kol[["r50"]]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash"), name = NULL) +
  scale_x_continuous(breaks = c(1, 3, 6, 10, 12, 20, 24, 30)) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.1), labels = function(x) bz(x, 1)) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(x = "Liczba pozycji w skali (k)", y = "Rzetelność (alfa)",
       title = "Ta sama jakość pozycji, różna długość skali",
       subtitle = "Linie: wzór Spearmana–Browna; kółka i odcinki: mediana i 95% alf\nz 1000 badań po 150 osób (średnia korelacja pozycji .30)") + motyw
p3   # zapis: ggsave("rzetelnosc-alfa-a-liczba-pozycji.svg", p3, width = 8, height = 6.2)
Wynik w R
     r_sr
cel   .15 .30 .50
  .70  14   6   3
  .80  23  10   4
  .90  52  21   9
[1] 0.414 0.585 0.809
  k  wzor mediana  q2.5 q97.5 proc_ponizej_.70
  3 0.562   0.562 0.409 0.669             99.3
  6 0.720   0.722 0.640 0.778             27.5
 12 0.837   0.834 0.789 0.868              0.0
 24 0.911   0.911 0.886 0.929              0.0
4. Błąd w predyktorze i w wyniku: Rysunek 4
R
# Rysunek 4. Błąd pomiaru w predyktorze spłaszcza nachylenie, błąd w wyniku – nie
# (symulacja Monte Carlo; kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)

# Model w populacji (parametry ustalone ręcznie): godziny nauki w tygodniu Y = 4 + 0.40 × T + e,
# T – prawdziwa motywacja ~ N(24, 6), SD(e) = 4. Błąd dodajemy do motywacji (X) albo do wyniku (Y)
b_prawdziwe <- 0.40
dane_reg <- function(n, rzet_X = 1, rzet_Y = 1) {
  T <- rnorm(n, 24, 6); Y_T <- 4 + b_prawdziwe * T + rnorm(n, 0, 4)
  var_Y <- b_prawdziwe^2 * 36 + 16                       # wariancja prawdziwego Y (21.76)
  data.frame(T = T, X = T + rnorm(n, 0, 6 * sqrt((1 - rzet_X) / rzet_X)),
             Y = Y_T + rnorm(n, 0, sqrt(var_Y * (1 - rzet_Y) / rzet_Y)))
}

# A: jedna próba 200 osób, motywacja zmierzona z rzetelnością .6
set.seed(597)
d <- dane_reg(200, rzet_X = 0.6)
m_T <- lm(Y ~ T, d); m_X <- lm(Y ~ X, d)
wsp <- rbind(prawdziwa_motywacja_T = c(coef(m_T), confint(m_T)[2, ]),
             zmierzona_motywacja_X = c(coef(m_X), confint(m_X)[2, ]))
colnames(wsp) <- c("wyraz_wolny", "b", "CI_dolna", "CI_gorna"); round(wsp, 3)

# B: 1000 badań po 200 osób w czterech scenariuszach; oczekiwane b = rzetelność X × 0.40
scen <- data.frame(nazwa = c("bez błędu pomiaru", "X: rzetelność .8", "X: rzetelność .6", "Y: rzetelność .6"),
                   rzet_X = c(1, 0.8, 0.6, 1), rzet_Y = c(1, 1, 1, 0.6))
set.seed(597)
sym <- do.call(rbind, lapply(seq_len(nrow(scen)), function(i) {
  w <- t(replicate(1000, {
    m <- lm(Y ~ X, dane_reg(200, scen$rzet_X[i], scen$rzet_Y[i]))
    ci <- confint(m)[2, ]
    c(b = unname(coef(m)[2]), pokrywa = unname(ci[1] <= b_prawdziwe & b_prawdziwe <= ci[2]))
  }))
  data.frame(scenariusz = scen$nazwa[i], b = w[, "b"], pokrywa = w[, "pokrywa"])
}))
podsum <- do.call(rbind, lapply(split(sym, sym$scenariusz), function(s) {
  pk <- mean(s$pokrywa); i <- match(s$scenariusz[1], scen$nazwa)
  data.frame(scenariusz = s$scenariusz[1], oczekiwane_b = b_prawdziwe * scen$rzet_X[i], srednie_b = mean(s$b),
             SD_b = sd(s$b), proc_CI_z_0.40 = 100 * pk, bladMC = 100 * sqrt(pk * (1 - pk) / 1000))
}))
podsum <- podsum[match(scen$nazwa, podsum$scenariusz), ]
print(podsum, row.names = FALSE, digits = 3)

dl <- rbind(data.frame(motywacja = "prawdziwa (T)", x = d$T, y = d$Y),
            data.frame(motywacja = "zmierzona (X, rzetelność .6)", x = d$X, y = d$Y))
pa <- ggplot(dl, aes(x, y)) +
  geom_point(data = dl[dl$motywacja != "prawdziwa (T)", ], colour = "grey60", alpha = 0.6, size = 1.4) +
  geom_smooth(aes(colour = motywacja, linetype = motywacja), method = "lm", se = FALSE, formula = y ~ x,
              linewidth = 1.2, fullrange = TRUE) +
  scale_colour_manual(values = c(kol[["r90"]], kol[["blad"]]), name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(x = "Motywacja (pkt)", y = "Godziny nauki w tygodniu", title = "A. Jedna próba, n = 200",
       subtitle = sprintf("b z T = %.2f; b z X = %.2f", coef(m_T)[2], coef(m_X)[2])) + motyw
sym$scenariusz <- factor(sym$scenariusz, rev(scen$nazwa))
pb <- ggplot(sym, aes(b, scenariusz)) +
  geom_vline(xintercept = b_prawdziwe, colour = "grey20", linewidth = 0.7) +
  geom_boxplot(width = 0.5, fill = "grey90", outlier.size = 0.8, outlier.alpha = 0.5) +
  geom_point(data = podsum, aes(oczekiwane_b, factor(scenariusz, levels(sym$scenariusz))), shape = 23,
             size = 3.5, fill = "white") +
  labs(x = "Nachylenie b w jednym badaniu", y = NULL, title = "B. 1000 badań po 200 osób",
       subtitle = "Linia: prawdziwe b = 0.40;\nromb: rzetelność X × 0.40") + motyw
p4 <- pa + pb + plot_layout(widths = c(1, 1.1))
p4   # zapis: ggsave("rzetelnosc-nachylenie-blad-w-predyktorze.svg", p4, width = 9.6, height = 5.6)
Wynik w R
                      wyraz_wolny     b CI_dolna CI_gorna
prawdziwa_motywacja_T       1.846 0.499    0.398    0.599
zmierzona_motywacja_X       8.058 0.236    0.150    0.322
        scenariusz oczekiwane_b srednie_b   SD_b proc_CI_z_0.40 bladMC
 bez błędu pomiaru         0.40     0.399 0.0472           95.2  0.676
  X: rzetelność .8         0.32     0.319 0.0448           56.5  1.568
  X: rzetelność .6         0.24     0.240 0.0397            1.8  0.420
  Y: rzetelność .6         0.40     0.398 0.0668           94.9  0.696
5. SEM i przedział wokół wyniku osoby: Rysunek 5
R
# Rysunek 5. Standardowy błąd pomiaru (SEM) jako przedział wokół wyniku jednej osoby
# (symulacja; kontynuacja: kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)

# 10 000 osób z tym samym rozkładem wyników prawdziwych co w bloku 1: T ~ N(24, 6).
# Skala o rzetelności .9 albo .7; SEM = SD(X) × √(1 − rzetelność), przedział 95%: X ± 1.96 × SEM
set.seed(597)
N <- 10000
T <- rnorm(N, 24, 6); z <- rnorm(N)
osoby <- do.call(rbind, lapply(c(0.9, 0.7), function(rz) {
  X <- T + 6 * sqrt((1 - rz) / rz) * z
  SEM <- sd(X) * sqrt(1 - rz)
  data.frame(rzet = rz, id = 1:N, T = T, X = X, SEM = SEM,
             dolna = X - 1.96 * SEM, gorna = X + 1.96 * SEM)
}))
osoby$trafia <- osoby$dolna <= osoby$T & osoby$T <= osoby$gorna

# SEM, szerokość przedziału, pokrycie z błędem Monte Carlo i najmniejsza różnica dwóch osób
# „większa niż błąd”: 1.96 × SEM × √2 (błąd różnicy dwóch wyników z tej samej skali)
podsum <- do.call(rbind, lapply(split(osoby, osoby$rzet), function(d) {
  pk <- mean(d$trafia)
  data.frame(rzet = d$rzet[1], SD_X = sd(d$X), SEM = d$SEM[1], polowa_przedzialu = 1.96 * d$SEM[1],
             pokrycie_proc = 100 * pk, bladMC = 100 * sqrt(pk * (1 - pk) / N),
             roznica_dwoch_osob = 1.96 * d$SEM[1] * sqrt(2))
}))
print(round(podsum, 2), row.names = FALSE)
# Przykład: osoba z wynikiem obserwowanym 30 pkt
round(sapply(split(osoby, osoby$rzet), function(d) 30 + c(dolna = -1, gorna = 1) * 1.96 * d$SEM[1]), 1)

# Pokrycie w dziesięciu grupach według wyniku obserwowanego (decyle X): przy skrajnych wynikach
# błąd pomiaru częściej „pchał” wynik w tę samą stronę, więc przedział rzadziej obejmuje T
osoby$decyl <- ave(osoby$X, osoby$rzet, FUN = function(x) cut(x, quantile(x, 0:10 / 10), include.lowest = TRUE, labels = FALSE))
dec <- aggregate(trafia ~ rzet + decyl, osoby, mean)
dec$bladMC <- sqrt(dec$trafia * (1 - dec$trafia) / (N / 10))
print(reshape(transform(dec[, 1:3], trafia = round(100 * trafia, 1)), idvar = "decyl", timevar = "rzet",
              direction = "wide"), row.names = FALSE)

# A: 25 losowo wybranych osób, skala o rzetelności .7 – przedziały wokół X i prawdziwe T
set.seed(597)
wyb <- sample(N, 25)
a <- osoby[osoby$rzet == 0.7 & osoby$id %in% wyb, ]
a$poz <- rank(a$X)
a$status <- factor(ifelse(a$trafia, "przedział obejmuje T", "przedział chybia T"),
                   c("przedział obejmuje T", "przedział chybia T"))
pa <- ggplot(a, aes(y = poz)) +
  geom_segment(aes(x = dolna, xend = gorna, yend = poz, colour = status, linetype = status), linewidth = 0.9) +
  geom_point(aes(x = X, colour = status), size = 2.2) +
  geom_point(aes(x = T), shape = 4, size = 2.6, stroke = 1.1) +
  scale_colour_manual(values = c("przedział obejmuje T" = kol[["r90"]], "przedział chybia T" = kol[["blad"]]),
                      guide = "none") +
  scale_linetype_manual(values = c("przedział obejmuje T" = "solid", "przedział chybia T" = "dashed"), guide = "none") +
  labs(x = "Wynik (pkt)", y = "25 osób (wg wyniku X)", title = "A. Rzetelność .7: X ± 1.96 × SEM",
       subtitle = sprintf("Kropka: X; krzyżyk: prawdziwe T; %d z 25 obejmuje T", sum(a$trafia))) +
  motyw + theme(axis.text.y = element_blank())

dec$wersja <- factor(dec$rzet, c(0.9, 0.7), paste("rzetelność", bz(c(0.9, 0.7), 1)))
pb <- ggplot(dec, aes(decyl, trafia, colour = wersja, shape = wersja, linetype = wersja)) +
  geom_hline(yintercept = 0.95, colour = "grey40", linetype = "dotted") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.6) +
  scale_colour_manual(values = c(kol[["r90"]], kol[["r70"]]), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  guides(colour = guide_legend(ncol = 1)) +
  scale_x_continuous(breaks = 1:10) +
  scale_y_continuous(limits = c(0.80, 1), labels = function(x) paste0(round(100 * x), "%")) +
  labs(x = "Decyl wyniku obserwowanego (1 = najniższe)", y = "Przedział obejmuje T",
       title = "B. Pokrycie w 10 grupach wyników", subtitle = "10 000 osób; linia kropkowana: 95%") + motyw
p5 <- pa + pb
p5   # zapis: ggsave("rzetelnosc-sem-przedzial-osoby.svg", p5, width = 9.6, height = 6)
Wynik w R
 rzet SD_X  SEM polowa_przedzialu pokrycie_proc bladMC roznica_dwoch_osob
  0.7 7.16 3.92              7.69         95.06   0.22              10.87
  0.9 6.31 2.00              3.91         95.05   0.22               5.53
       0.7  0.9
dolna 22.3 26.1
gorna 37.7 33.9
 decyl trafia.0.7 trafia.0.9
     1       89.5       94.1
     2       95.3       95.2
     3       96.7       95.3
     4       97.8       95.5
     5       97.4       96.3
     6       97.7       94.6
     7       97.8       95.8
     8       97.0       95.1
     9       93.8       94.9
    10       87.6       93.7
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – pomarańczowy (rzetelność .9 / .7)" = c("#0072B2", "#E69F00"),
             "niebieski – ciemnoszary (rzetelność .9 / .5)" = c("#0072B2", "#404040"),
             "pomarańczowy – ciemnoszary (rzetelność .7 / .5)" = c("#E69F00", "#404040"),
             "jasnoszary – cynober (wariancja prawdziwa / błędu)" = c("#B3B3B3", "#D55E00"),
             "niebieski – cynober (T / X; obejmuje / chybia)" = c("#0072B2", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                   widzenie_typowe deuteranopia
niebieski – pomarańczowy (rzetelność .9 / .7)                120.2        121.5
niebieski – ciemnoszary (rzetelność .9 / .5)                  45.6         48.0
pomarańczowy – ciemnoszary (rzetelność .7 / .5)               88.0         86.5
jasnoszary – cynober (wariancja prawdziwa / błędu)            78.9         64.4
niebieski – cynober (T / X; obejmuje / chybia)               114.6        108.3
czerwony – zielony (do unikania)                             121.7         21.1
                                                   protanopia
niebieski – pomarańczowy (rzetelność .9 / .7)           109.3
niebieski – ciemnoszary (rzetelność .9 / .5)             44.2
pomarańczowy – ciemnoszary (rzetelność .7 / .5)          80.3
jasnoszary – cynober (wariancja prawdziwa / błędu)       59.5
niebieski – cynober (T / X; obejmuje / chybia)           91.9
czerwony – zielony (do unikania)                         31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania, korelacje, regresja i przedziały ufności – pakiet stats; rozkłady korelacji – pakiet ggdist. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggdist (wersja 3.3.3): Kay, M. (2024). ggdist: Visualizations of distributions and uncertainty in the grammar of graphics. IEEE Transactions on Visualization and Computer Graphics, 30(1), 414–424. https://doi.org/10.1109/TVCG.2023.3327195
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Większa próba naprawi niską rzetelność”. Zwęża rozkład wyników wokół zaniżonej wartości, ale go nie przesuwa (rysunek 2).
- Porównywanie alf skal o różnej długości jak miary jakości pozycji. Alfa rośnie z liczbą pozycji przy tej samej jakości (rysunek 3).
- Wysoka alfa jako dowód jednowymiarowości. Na alfę wpływa i długość skali, i liczba wymiarów, więc sama alfa nie mówi, ile wymiarów ma skala (Cortina, 1993).
- Traktowanie błędu w predyktorze i w wyniku tak samo. Tylko ten pierwszy obciąża nachylenie (rysunek 4).
- Wynik pojedynczej osoby jako dokładna liczba. Przy rzetelności .70 i SD około 7 punktów przedział ma szerokość ponad 15 punktów, a przy skrajnych wynikach trafia rzadziej niż w 95% (rysunek 5).
Najczęstsze pytania
Dlaczego niska rzetelność zaniża korelację?
Bo błąd pomiaru dodaje do wyników wariancję, która z niczym nie koreluje. Oczekiwana korelacja obserwowana to korelacja prawdziwa pomnożona przez pierwiastek z iloczynu rzetelności obu skal. W naszej symulacji 1000 badań po 80 osób przy prawdziwej korelacji .5 średnia obserwowana korelacja wyniosła .445 przy rzetelności obu skal .9, .347 przy .7 i .246 przy .5.
Czy większa próba rozwiązuje problem niskiej rzetelności?
Nie. Większa próba zmniejsza błąd losowania, ale nie przesuwa wyniku w stronę prawdziwej wartości. Przy rzetelności .5 i 300 osobach 95% obserwowanych korelacji mieściło się między .14 a .35, choć prawdziwa korelacja wynosiła .5. Rośnie za to moc: istotną korelację dało 99.4% badań wobec 61.3% przy 80 osobach.
Dlaczego krótka skala ma niską alfę Cronbacha?
Bo alfa zależy od liczby pozycji, nie tylko od ich jakości. Przy średniej korelacji między pozycjami .30 oczekiwana alfa wynosi .56 dla 3 pozycji, .72 dla 6 i .91 dla 24. Krótka skala ma też alfę mniej stabilną: w symulacji 1000 badań po 150 osób alfa skali z 3 pozycji wahała się od .41 do .67 (95% wyników).
Czy błąd pomiaru w zmiennej zależnej zaniża współczynnik regresji?
Nie zaniża niestandaryzowanego nachylenia, ale zwiększa jego rozrzut. W symulacji 1000 badań po 200 osób błąd w wyniku (rzetelność .6) dał średnie b = 0.398 przy prawdziwym 0.40, ale SD nachyleń wzrosło z 0.047 do 0.067. Błąd w predyktorze o tej samej rzetelności zaniżył średnie b do 0.240.
Jak obliczyć przedział wokół wyniku jednej osoby?
Policz standardowy błąd pomiaru: SD wyników razy pierwiastek z (1 − rzetelność), a potem wynik ± 1.96 × SEM. Przy SD = 7.16 i rzetelności .70 SEM wynosi 3.92, więc wynik 30 punktów to przedział od 22.3 do 37.7. Różnicę dwóch osób uznaj za wyraźną dopiero, gdy przekracza 1.96 × SEM × √2, tu 10.87 punktu.
Powiązane hasła
Przeczytaj też
Błąd pomiaru w regresji i korekta na atenuację
Atenuacja i zakłócenie resztkowe przy nierzetelnych skalach, korekta Spearmana, SEM z jednym wskaźnikiem w lavaan, pełny SEM i symulacja estymatorów.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikRegresja do średniej – wizualizacja na obrazkach
Wynik prawdziwy i błąd, strzałki przed–po, chmura pomiarów w przód i wstecz, korelacja test–retest i 1000 badań kursu bez efektu – pięć rysunków z kodem R.
Czytaj →PoradnikANCOVA – wizualizacja na obrazkach
Równoległe proste i średnie skorygowane, precyzja w 1000 badaniach, złamane nachylenia i pozorny efekt w grupach nielosowych – pięć rysunków z kodem R.
Czytaj →Masz skalę o niskiej rzetelności albo słabe korelacje?
Pomożemy ocenić rzetelność skal, zinterpretować wyniki z uwzględnieniem błędu pomiaru i opisać ograniczenia w pracy – tak, żebyś umiał(a) wyjaśnić promotorowi i recenzentowi, co z nich wynika.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, W. (1910). Some experimental results in the correlation of mental abilities. British Journal of Psychology, 3(3), 296–322. https://doi.org/10.1111/j.2044-8295.1910.tb00207.x ● Otwarty dostęp: pełny tekst
- Cortina, J. M. (1993). What is coefficient alpha? An examination of theory and applications. Journal of Applied Psychology, 78(1), 98–104. https://doi.org/10.1037/0021-9010.78.1.98
- Harvill, L. M. (1991). Standard error of measurement. Educational Measurement: Issues and Practice, 10(2), 33–41. https://doi.org/10.1111/j.1745-3992.1991.tb00195.x
- Keogh, R. H., Shaw, P. A., Gustafson, P., Carroll, R. J., Deffner, V., Dodd, K. W., Küchenhoff, H., Tooze, J. A., Wallace, M. P., Kipnis, V., & Freedman, L. S. (2020). STRATOS guidance document on measurement error and misclassification of variables in observational epidemiology: Part 1—Basic theory and simple methods of adjustment. Statistics in Medicine, 39(16), 2197–2231. https://doi.org/10.1002/sim.8532 ● Otwarty dostęp: pełny tekst
- Schmidt, F. L., & Hunter, J. E. (1996). Measurement error in psychological research: Lessons from 26 research scenarios. Psychological Methods, 1(2), 199–223. https://doi.org/10.1037/1082-989x.1.2.199
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Spearman, C. (1910). Correlation calculated from faulty data. British Journal of Psychology, 3(3), 271–295. https://doi.org/10.1111/j.2044-8295.1910.tb00206.x
Cytowania BibTeX
@article{brown1910some, author={Brown, William}, title={{Some experimental results in the correlation of mental abilities}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={296--322}, doi={10.1111/j.2044-8295.1910.tb00207.x}}@article{cortina1993what, author={Cortina, Jose M.}, title={{What is coefficient alpha? An examination of theory and applications}}, journal={Journal of Applied Psychology}, year={1993}, volume={78}, number={1}, pages={98--104}, doi={10.1037/0021-9010.78.1.98}}@article{harvill1991standard, author={Harvill, Leo M.}, title={{Standard error of measurement}}, journal={Educational Measurement: Issues and Practice}, year={1991}, volume={10}, number={2}, pages={33--41}, doi={10.1111/j.1745-3992.1991.tb00195.x}}@article{keogh2020stratos, author={Keogh, Ruth H. and Shaw, Pamela A. and Gustafson, Paul and Carroll, Raymond J. and Deffner, Veronika and Dodd, Kevin W. and Küchenhoff, Helmut and Tooze, Janet A. and Wallace, Michael P. and Kipnis, Victor and Freedman, Laurence S.}, title={{STRATOS guidance document on measurement error and misclassification of variables in observational epidemiology: Part 1—Basic theory and simple methods of adjustment}}, journal={Statistics in Medicine}, year={2020}, volume={39}, number={16}, pages={2197--2231}, doi={10.1002/sim.8532}}@article{schmidt1996measurement, author={Schmidt, Frank L. and Hunter, John E.}, title={{Measurement error in psychological research: Lessons from 26 research scenarios}}, journal={Psychological Methods}, year={1996}, volume={1}, number={2}, pages={199--223}, doi={10.1037/1082-989x.1.2.199}}@article{spearman1904proof, author={Spearman, Charles}, title={{The proof and measurement of association between two things}}, journal={The American Journal of Psychology}, year={1904}, volume={15}, number={1}, pages={72--101}, doi={10.2307/1412159}}@article{spearman1910correlation, author={Spearman, Charles}, title={{Correlation calculated from faulty data}}, journal={British Journal of Psychology}, year={1910}, volume={3}, number={3}, pages={271--295}, doi={10.1111/j.2044-8295.1910.tb00206.x}}