Ta sama regresja, trzy różne odpowiedzi
„Kontrolowaliśmy zmienne X i Z” brzmi jak gwarancja rzetelności. Tymczasem dodanie trzeciej zmiennej do regresji może usunąć obciążenie, ale może też je wprowadzić. Wysocki i in. (2022) podkreślają, że kontrola statystyczna działa tylko w idealnych warunkach, a źle dobrana zmienna kontrolna może dać oszacowanie bardziej obciążone niż brak kontroli. O tym, co kontrolować, decyduje struktura przyczynowa, której nie widać w danych.
Definicje znajdziesz w hasłach zmienna zakłócająca i zmienna zderzeniowa (collider), a pełną procedurę doboru zmiennych na grafie – we wpisie grafy przyczynowe (DAG). Tu pokazujemy tylko mechanizm: trzy najprostsze grafy, jedno badanie z każdego, 1000 badań z każdego i dobór próby według zderzacza. Wszystkie dane są fikcyjne.
Przykład. Pytanie badawcze: czy praca zarobkowa w czasie studiów obniża wynik egzaminu? Wszystkie zmienne są w jednostkach odchylenia standardowego (wyniki z). W każdym z trzech światów prawdziwy (całkowity) efekt pracy wynosi −0.30: o tyle SD spada wynik egzaminu na każde SD godzin pracy. Wszystkie współczynniki ustawiliśmy ręcznie tak, by efekty były wyraźne. Ziarno 592 ustalono raz i nie zmieniano go. Przy każdym rysunku: co widać, czego wykres nie pokazuje, podpis i zdanie do pracy.
Rysunek 1: trzy grafy, trzy decyzje
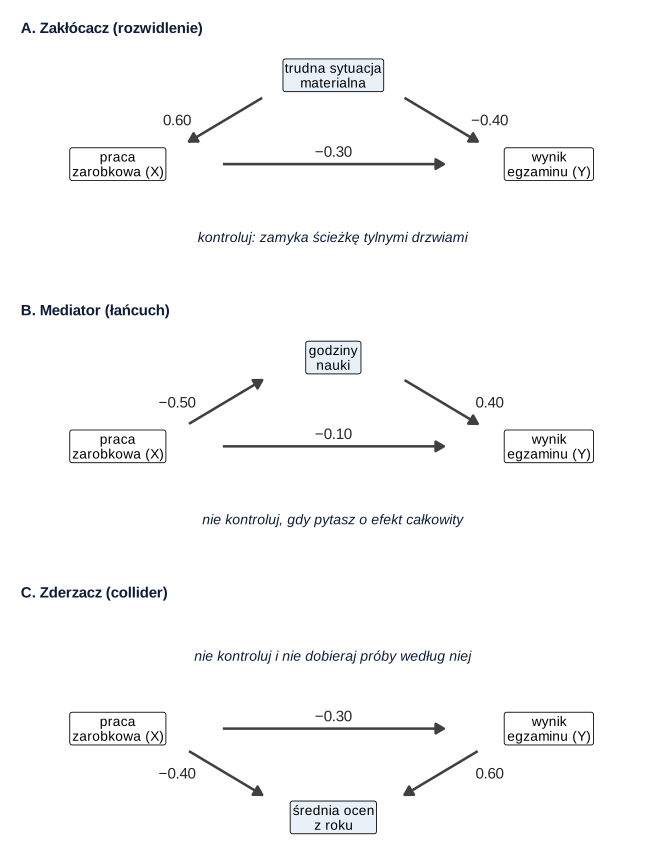
Co widać. Trzecia zmienna jest w każdym grafie połączona i z pracą, i z egzaminem. W tabeli korelacji wszystkie trzy wyglądałyby podobnie. Różni je tylko kierunek strzałek. (A) Trudna sytuacja materialna to zakłócacz: zwiększa liczbę godzin pracy i osobno obniża wynik egzaminu. Tworzy więc ścieżkę „tylnymi drzwiami”, którą trzeba zamknąć (kryterium tylnych drzwi). (B) Godziny nauki to mediator: praca zabiera czas na naukę, a dopiero to obniża wynik. Efekt całkowity to −0.10 + (−0.50 × 0.40) = −0.30. (C) Średnia ocen z całego roku to zderzacz: obniża ją praca i podnosi dobry wynik egzaminu. Ścieżka przez zderzacz jest zamknięta, dopóki go nie kontrolujesz.
Czego ten wykres nie pokazuje. Grafu nie wyprowadza się z danych – rysuje się go z wiedzy o tym, co poprzedza co. Rohrer (2018) przypomina, że wnioski przyczynowe z danych obserwacyjnych zawsze opierają się na założeniach z wiedzy dziedzinowej. Prawdziwe badanie ma zwykle wiele zmiennych naraz i ta sama zmienna może być na jednej ścieżce zakłócaczem, a na innej zderzaczem. Takie przypadki rozpisuje wpis o grafach przyczynowych.
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: jak wygląda „kontrola” na wykresie rozrzutu
Z każdego grafu losujemy jedno badanie (n = 200). Punkty kolorujemy według tercyla trzeciej zmiennej i rysujemy linię regresji dla wszystkich oraz osobno w każdym tercylu. Linia w tercylu to zgrubne przybliżenie tego, co robi kontrola w regresji: porównuje osoby o podobnej wartości trzeciej zmiennej.
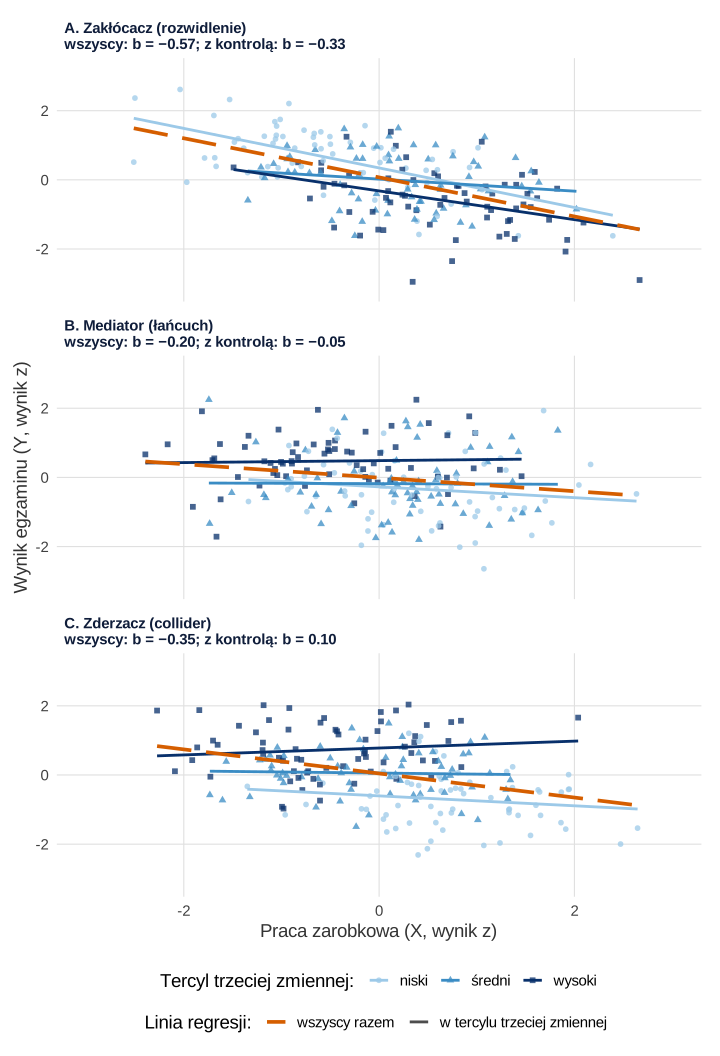
set.seed(592)).Co widać. (A) Bez kontroli współczynnik pracy wynosi −0.57, 95% CI [−0.68, −0.45], czyli prawie dwa razy więcej niż prawdziwe −0.30. Część spadku to sytuacja materialna, nie praca. Z kontrolą: −0.33, 95% CI [−0.46, −0.20]. (B) Bez kontroli −0.20, 95% CI [−0.33, −0.06]. Z kontrolą godzin nauki zostaje −0.05, 95% CI [−0.19, 0.10], czyli tylko efekt bezpośredni. (C) Bez kontroli −0.35, 95% CI [−0.48, −0.22]. Po dodaniu średniej ocen współczynnik zmienia znak: 0.10, 95% CI [−0.01, 0.22]. W tercylach średniej punkty układają się piętrami. Wśród osób o podobnej średniej ten, kto więcej pracuje, musiał mieć lepszy egzamin, żeby tę średnią utrzymać.
Czego ten wykres nie pokazuje. To jedno badanie. W panelu B współczynnik bez kontroli (−0.20) wyszedł przypadkowo słabszy od prawdziwego −0.30 – jak często tak bywa, pokazuje rysunek 3. Tercyle to tylko trzy przedziały, więc kontrolują trzecią zmienną niedokładnie. Gdy linie w warstwach różnią się nachyleniem, a nie tylko położeniem, chodzi raczej o modyfikację efektu (czynnik zakłócający a modyfikator efektu). Skrajny przypadek, w którym linie w grupach i linia łączna mają przeciwne znaki, pokazuje wpis paradoks Simpsona – wizualizacja na obrazkach.
Podpis do pracy (np. w aneksie):
Zdanie do Wyników:
Rysunek 3: 1000 badań z każdego grafu
Teraz powtarzamy badanie 1000 razy w każdym świecie (n = 300) i liczymy regresję bez kontroli i z kontrolą trzeciej zmiennej. W grafie A dodajemy trzecią wersję: kontrolę sytuacji materialnej zmierzonej z rzetelnością .60 (wartość ustalona ręcznie), np. krótkim pytaniem w ankiecie. Pokrycie to odsetek 95% przedziałów ufności, które obejmują prawdziwe −0.30. Błąd Monte Carlo pokrycia bliskiego 95% wynosi 0.69 punktu procentowego.
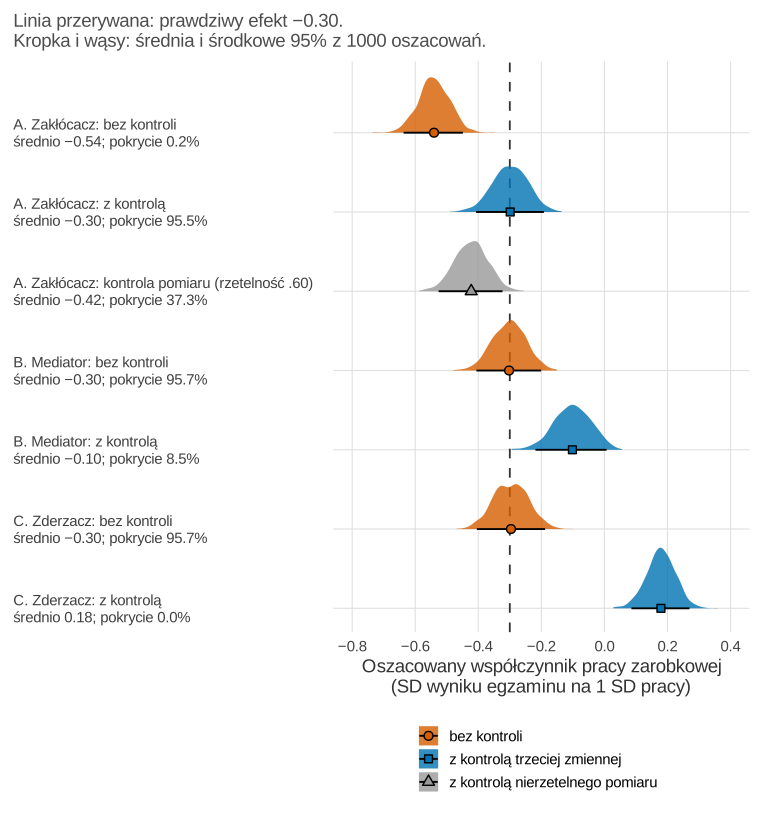
set.seed(592)).Co widać. Kontrola pomaga tylko w grafie A: średnie oszacowanie przesuwa się z −0.54 na −0.30, a pokrycie rośnie z 0.2% do 95.5%. W grafie B kontrola mediatora daje średnio −0.10. To poprawne oszacowanie efektu bezpośredniego (zob. efekt bezpośredni), ale błędne dla pytania o efekt całkowity: pokrycie spada do 8.5%, a wynik jest istotny tylko w 40.4% badań. Najgorzej wypada graf C. Bez kontroli wszystko działa (−0.30, pokrycie 95.7%). Z kontrolą zderzacza średnie oszacowanie to +0.18, a żaden z 1000 przedziałów nie obejmuje prawdy. W 96.5% badań wynik jest istotny – ze złym znakiem.
Dwie lekcje z liczb. Po pierwsze, Schisterman i in. (2009) zwracają uwagę, że obciążenie z kontroli zmiennej pośredniczącej nie jest problemem małej próby – większe n zwęża tylko rozkład wokół złej wartości. To samo dotyczy zderzacza. Po drugie, kontrola nierzetelnego pomiaru zakłócacza usuwa tylko część obciążenia (−0.42 zamiast −0.30, pokrycie 37.3%). Westfall i Yarkoni (2016) pokazali, że typowe sposoby wykazywania, iż zmienna wnosi coś ponad zmienne kontrolne, przy pominięciu nierzetelności pomiaru dają bardzo wysoki odsetek błędów I rodzaju – najwyższy przy dużych próbach i umiarkowanej rzetelności. Szerzej o błędzie pomiaru piszemy we wpisie rzetelność i błąd pomiaru – wizualizacja na obrazkach.
Czego ten wykres nie pokazuje. Regresja nie „wie”, który świat ją wygenerował. W grafie C model z kontrolą ma nawet lepsze dopasowanie, bo średnia ocen silnie wiąże się z egzaminem. Cinelli i in. (2024) nazywają to problemem „złej kontroli”: dodana zmienna sprawia, że współczynnik przestaje odpowiadać efektowi, który miał reprezentować. Dopasowanie modelu tego nie wykrywa.
Podpis do pracy (do prezentacji albo aneksu metodologicznego):
Zdanie do Dyskusji:
Rysunek 4: zderzacz przez dobór próby
Zderzacza nie trzeba wpisywać do modelu, żeby go kontrolować. Wystarczy dobrać próbę według niego. Elwert i Winship (2014) opisują warunkowanie na zderzaczu jako kontrolę, warstwowanie albo dobór próby, a Hernán i in. (2004) pokazują, że wiele odmian błędu selekcji ma właśnie tę strukturę. Scenariusz: rocznik 500 studentów z grafu C. Na II rok przechodzi 70% osób z najwyższą średnią ocen (odsetek ustalony ręcznie). Badacz ankietuje dopiero studentów II roku. Dane pobierzesz jako zaklocajaca-collider-rocznik.csv, a trzy badania z rysunku 2 – jako zaklocajaca-collider-trzy-badania.csv.
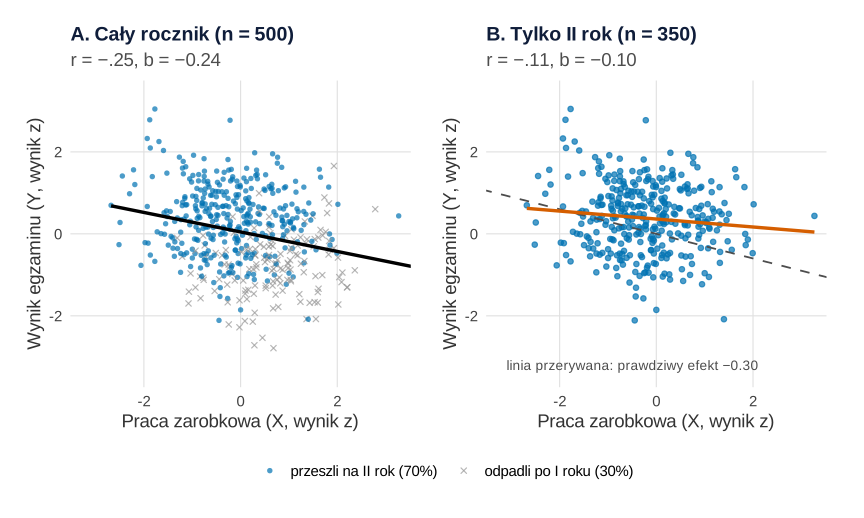
set.seed(592)).Co widać. W całym roczniku r = −.25, a współczynnik pracy wynosi −0.24, 95% CI [−0.32, −0.16]. Wśród 350 osób z II roku: r = −.11 i −0.10, 95% CI [−0.191, −0.004]. Związek osłabł ponad dwukrotnie, choć nikt niczego nie kontrolował w modelu. Panel A pokazuje, kto odpadł: osoby, które dużo pracowały (średnio 0.69 SD) i słabo napisały egzamin (−0.78 SD). Usunięcie prawego dolnego rogu chmury spłaszcza linię. Spośród osób, które dużo pracowały, na II roku zostały głównie te, które mimo to dobrze zdawały.
Czego ten wykres nie pokazuje. Badacz z II roku widzi tylko panel B i nie ma danych o osobach, które odpadły, więc w jego danych selekcji nie widać. Podobnie wygląda ograniczenie zakresu zmiennej, gdy próbę dobiera się według jednej z badanych zmiennych. Tamten mechanizm pokazuje wpis ograniczony zakres zmiennej – wizualizacja na obrazkach. Tu selekcja zależy od wspólnego skutku obu zmiennych. Rohrer (2018) przypomina, że niereprezentatywna próba może działać jak kontrola zderzacza.
Podpis do pracy:
Zdanie do ograniczeń pracy:
Rysunek 5: im ostrzejsza selekcja, tym większe obciążenie
Ile zależy od progu? Losujemy 1000 roczników po 1000 osób i dla każdego sprawdzamy sześć wariantów: na II rok przechodzi 100%, 90%, 70%, 50%, 30% albo 10% osób (siatka ustalona ręcznie).
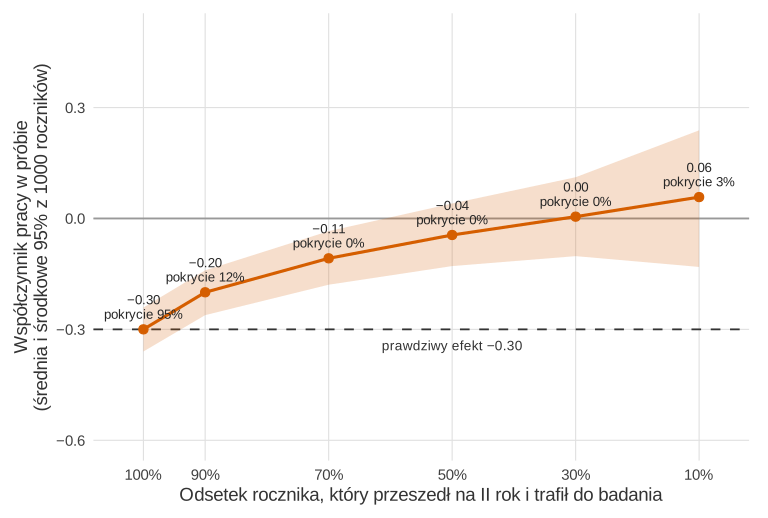
set.seed(592)).Co widać. Bez selekcji średnie oszacowanie to −0.30, a pokrycie 94.9%. Już odsiew 10% najsłabszych przesuwa średnią do −0.20, a pokrycie spada do 11.7%. Przy 70% jest −0.11. Przy 50% (−0.04) efekt jest istotny w 19.5% badań, przy 30% (0.00) – w 5.8%, czyli blisko 5%, które dają same fałszywe alarmy. Przy 10% (n = 100) średnia ma już przeciwny znak (+0.06).
Czego ten wykres nie pokazuje. Wielkość obciążenia zależy od tego, jak silnie oba czynniki wpływają na selekcję. W naszej symulacji ustawiliśmy to ręcznie. W prawdziwym badaniu tych sił nie znasz, ale zwykle znasz kierunek: jeśli obie zmienne pchają ludzi do próby (albo z niej wypychają), związek w próbie będzie przesunięty. Korekty wagami i analizę wrażliwości opisuje wpis błąd selekcji i zmienna zderzeniowa w praktyce.
Podpis do pracy (np. do Dyskusji na prezentacji):
Zdanie do Dyskusji:
Co zrobić w praktyce
- Narysuj graf przed analizą. Dla każdej kandydującej zmiennej kontrolnej zapisz, czy poprzedza X, czy jest jego skutkiem. Zmienne mierzone po X (zadowolenie, średnia ocen, „zaangażowanie”) są podejrzane jako mediatory albo zderzacze.
- Nie dodawaj zmiennych „na wszelki wypadek”. Rysunek 3 pokazuje, że zła kontrola może zmienić znak efektu przy 96.5% istotnych wyników. Krótką odpowiedź dla prac dyplomowych daje wpis czy kontrolować wiek i płeć.
- Sprawdź, kto mógł nie trafić do próby i dlaczego. Jeśli o udziale decydują i X, i Y, opisz to w ograniczeniach badania i podaj kierunek możliwego obciążenia.
- Mediator – osobne pytanie. Jeśli interesuje Cię mechanizm, zrób analizę mediacji (wpis mediacja w obrazkach), a nie „kontrolę” godzin nauki w modelu dla efektu całkowitego.
- Raportuj model z i bez kontroli. Różnica nie mówi, który jest poprawny, ale pokazuje czytelnikowi, ile zależy od decyzji. Jak dodanie zmiennej zmienia współczynnik na wykresie, pokazuje wpis regresja wieloraka w obrazkach.
Gotowe zdanie do rozdziału „Metoda” (do przerobienia na własne zmienne):
Który rysunek do pracy
- Do Metody – rysunek 1 z własnymi zmiennymi (bez liczb przy strzałkach albo ze znakami „+/−”), jako uzasadnienie doboru zmiennych kontrolnych.
- Do aneksu albo na obronę – rysunki 2 i 3, gdy recenzent pyta, dlaczego czegoś nie kontrolowano.
- Do Dyskusji – rysunki 4 i 5, gdy próba powstała przez kwalifikację (rok studiów, zatrudnienie, leczenie w poradni).
Dlaczego sam związek nie wystarcza do wniosku przyczynowego, wyjaśnia hasło korelacja a przyczynowość, a co znaczy pokrycie przedziału – wpis przedział ufności w obrazkach.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw i prawdziwe współczynniki, a przepis 2 – funkcję losuj(), z których korzystają następne. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne. Grafy rysujemy zwykłym ggplot2 (węzły jako etykiety, strzałki jako odcinki), bez pakietów do grafów przyczynowych.
Każdy przepis, który losuje (2, 3, 4 i 5), zaczyna się od własnego set.seed(592), więc uruchomiony po przepisach 1 i 2 da te same liczby co na stronie. Ziarno 592 ustalono raz i nie zmieniano go. Ręcznie ustalono: współczynniki przy strzałkach (rysunek 1), rzetelność .60 pomiaru sytuacji materialnej, liczebności (200 na rysunku 2, 300 na rysunku 3, rocznik 500 na rysunku 4 i 1000 na rysunku 5), 1000 powtórzeń, próg 70% i siatkę odsetków od 100% do 10%. Cały kod liczy się w kilkanaście sekund.
1. Trzy grafy przyczynowe w ggplot2: Rysunek 1
R
# Rysunek 1. Trzy proste grafy przyczynowe (DAG) narysowane w ggplot2: zakłócacz, mediator, zderzacz
# Pytanie badawcze (fikcyjne): czy praca zarobkowa w czasie studiów (X) obniża wynik egzaminu (Y)?
library(ggplot2)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(bez = "#D55E00", z = "#0072B2", nierzetelny = "grey60", szary = "grey60")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^-", "−", sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x)))  # −.03 zamiast -0.03
liczba <- function(x, d = 2) sub("^-", "−", sprintf(paste0("%.", d, "f"), x))         # −0.30 z prawdziwym minusem

# Prawdziwe współczynniki przyczynowe (ustalone ręcznie; wszystkie zmienne w jednostkach SD).
# Efekt pracy na egzamin: −0.30 SD w każdym grafie (w grafie z mediatorem to efekt całkowity).
wsp <- list(zaklocacz = c(z_x = 0.6, z_y = -0.4, x_y = -0.3),          # sytuacja materialna → praca, → egzamin
            mediator = c(x_m = -0.5, m_y = 0.4, x_y = -0.1),           # praca → godziny nauki → egzamin
            zderzacz = c(x_y = -0.3, x_c = -0.4, y_c = 0.6))           # praca → średnia z roku ← egzamin
round(c(efekt_calkowity_w_grafie_z_mediatorem = unname(wsp$mediator["x_y"] + wsp$mediator["x_m"] * wsp$mediator["m_y"])), 2)

# Węzły: X i Y w tym samym miejscu w każdym panelu, trzecia zmienna nad nimi albo pod nimi
grafy <- c("A. Zakłócacz (rozwidlenie)", "B. Mediator (łańcuch)", "C. Zderzacz (collider)")
wezly <- data.frame(graf = factor(rep(grafy, each = 3), grafy),
                    rola = rep(c("X", "Y", "T"), 3),
                    x = rep(c(0, 4, 2), 3), y = c(0, 0, 1.4, 0, 0, 1.4, 0, 0, -1.4),
                    etykieta = c("praca\nzarobkowa (X)", "wynik\negzaminu (Y)", "trudna sytuacja\nmaterialna",
                                 "praca\nzarobkowa (X)", "wynik\negzaminu (Y)", "godziny\nnauki",
                                 "praca\nzarobkowa (X)", "wynik\negzaminu (Y)", "średnia ocen\nz roku"))
# Strzałki (początek → koniec, skrócone, żeby nie wchodziły pod etykiety) i ich współczynniki
strzalka <- function(graf, x0, y0, x1, y1, w, skrot = 0.62) {
  d <- sqrt((x1 - x0)^2 + (y1 - y0)^2); ux <- (x1 - x0) / d; uy <- (y1 - y0) / d
  data.frame(graf = factor(graf, grafy), x = x0 + skrot * 1.3 * ux, y = y0 + skrot * uy,
             xend = x1 - skrot * 1.3 * ux, yend = y1 - skrot * uy, w = w,
             tx = (x0 + x1) / 2, ty = (y0 + y1) / 2)
}
krawedzie <- rbind(
  strzalka(grafy[1], 2, 1.4, 0, 0, wsp$zaklocacz[["z_x"]]), strzalka(grafy[1], 2, 1.4, 4, 0, wsp$zaklocacz[["z_y"]]),
  strzalka(grafy[1], 0, 0, 4, 0, wsp$zaklocacz[["x_y"]], skrot = 0.75),
  strzalka(grafy[2], 0, 0, 2, 1.4, wsp$mediator[["x_m"]]), strzalka(grafy[2], 2, 1.4, 4, 0, wsp$mediator[["m_y"]]),
  strzalka(grafy[2], 0, 0, 4, 0, wsp$mediator[["x_y"]], skrot = 0.75),
  strzalka(grafy[3], 0, 0, 2, -1.4, wsp$zderzacz[["x_c"]]), strzalka(grafy[3], 4, 0, 2, -1.4, wsp$zderzacz[["y_c"]]),
  strzalka(grafy[3], 0, 0, 4, 0, wsp$zderzacz[["x_y"]], skrot = 0.75))
krawedzie$ty <- krawedzie$ty + ifelse(krawedzie$y == krawedzie$yend, 0.2, 0)          # napis nad poziomą strzałką
krawedzie$tx <- krawedzie$tx + ifelse(krawedzie$y == krawedzie$yend, 0, ifelse(krawedzie$tx < 2, -0.45, 0.45))
rada <- data.frame(graf = factor(grafy, grafy), x = 2, y = c(-1.15, -1.15, 1.15),
                   tekst = c("kontroluj: zamyka ścieżkę tylnymi drzwiami",
                             "nie kontroluj, gdy pytasz o efekt całkowity",
                             "nie kontroluj i nie dobieraj próby według niej"))
p1 <- ggplot() +
  geom_segment(data = krawedzie, aes(x, y, xend = xend, yend = yend), linewidth = 0.9, colour = "grey25",
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  geom_text(data = krawedzie, aes(tx, ty, label = liczba(w)), size = 4, colour = "grey15") +
  geom_label(data = wezly, aes(x, y, label = etykieta, fill = rola), size = 3.6, lineheight = 0.9,
             linewidth = 0.3, label.padding = unit(0.25, "lines"), show.legend = FALSE) +
  geom_text(data = rada, aes(x, y, label = tekst), size = 3.7, fontface = "italic", colour = "#0f1d3a") +
  scale_fill_manual(values = c(X = "white", Y = "white", T = "#E8F1F8")) +
  facet_wrap(~graf, ncol = 1) + coord_cartesian(xlim = c(-0.7, 4.7), ylim = c(-1.75, 1.75)) +
  labs(x = NULL, y = NULL) + motyw +
  theme(axis.text = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("zaklocajaca-collider-trzy-grafy.svg", p1, width = 7, height = 9)
Wynik w R
efekt_calkowity_w_grafie_z_mediatorem
                                 -0.3
2. Generator danych i jedno badanie z każdego grafu: Rysunek 2
R
# Rysunek 2. Jak wygląda „kontrola” trzeciej zmiennej: jedno badanie (n = 200) z każdego grafu
# (kontynuacja: wsp, grafy, kol, motyw, bz, liczba z bloku 1)
library(ggplot2)

# Generator danych zgodny z rysunkiem 1 (wszystkie zmienne mają w populacji średnią 0 i SD 1).
# T – trzecia zmienna; T_pomiar – jej pomiar z rzetelnością .60 (tylko przy zakłócaczu, do rysunku 3).
losuj <- function(graf, n) {
  e <- function() rnorm(n)
  if (graf == "zaklocacz") {
    w <- wsp$zaklocacz; t <- e(); x <- w[["z_x"]] * t + sqrt(1 - w[["z_x"]]^2) * e()
    y_bez_szumu <- w[["x_y"]] * x + w[["z_y"]] * t
    t_pomiar <- t + sqrt(1 / 0.6 - 1) * e()                     # rzetelność = 1 / (1 + wariancja błędu) = .60
  } else if (graf == "mediator") {
    w <- wsp$mediator; x <- e(); t <- w[["x_m"]] * x + sqrt(1 - w[["x_m"]]^2) * e()
    y_bez_szumu <- w[["x_y"]] * x + w[["m_y"]] * t; t_pomiar <- NA
  } else {
    w <- wsp$zderzacz; x <- e(); y_bez_szumu <- w[["x_y"]] * x; t_pomiar <- NA
  }
  y <- y_bez_szumu + sqrt(1 - var_y_bez_szumu(graf)) * e()      # reszta dopełnia wariancję Y do 1
  if (graf == "zderzacz") {                                     # średnia z roku: skutek pracy i egzaminu
    w <- wsp$zderzacz; c0 <- w[["x_c"]] * x + w[["y_c"]] * y
    t <- c0 + sqrt(1 - var_c_bez_szumu()) * e()
  }
  data.frame(x, y, t, t_pomiar)
}
# Wariancje części systematycznych w populacji (potrzebne, żeby Y i średnia z roku miały SD = 1)
var_y_bez_szumu <- function(graf) {
  if (graf == "zaklocacz") with(as.list(wsp$zaklocacz), x_y^2 + z_y^2 + 2 * x_y * z_y * z_x)
  else if (graf == "mediator") with(as.list(wsp$mediator), x_y^2 + m_y^2 + 2 * x_y * m_y * x_m)
  else wsp$zderzacz[["x_y"]]^2
}
var_c_bez_szumu <- function() with(as.list(wsp$zderzacz), x_c^2 + y_c^2 + 2 * x_c * y_c * x_y)

set.seed(592)                                  # ziarno ustalone raz, bez dobierania pod wynik
jedno <- lapply(c(zaklocacz = "zaklocacz", mediator = "mediator", zderzacz = "zderzacz"), losuj, n = 200)
write.csv(do.call(rbind, lapply(names(jedno), function(g) data.frame(graf = g, jedno[[g]][, c("x", "y", "t")]))),
          "zaklocajaca-collider-trzy-badania.csv", row.names = FALSE)

# Współczynnik pracy (X) bez kontroli i z kontrolą trzeciej zmiennej, z 95% CI
wsp_x <- function(m) c(b = unname(coef(m)["x"]), confint(m)["x", ])
tab <- t(sapply(jedno, function(d) c(bez = wsp_x(lm(y ~ x, d)), z = wsp_x(lm(y ~ x + t, d)))))
colnames(tab) <- c("b_bez", "CI_d_bez", "CI_g_bez", "b_z", "CI_d_z", "CI_g_z")   # bez kontroli / z kontrolą T
round(tab, 3)

# Wykres: punkty w kolorze tercyla trzeciej zmiennej, linie regresji w tercylach i linia dla wszystkich
dd <- do.call(rbind, lapply(seq_along(jedno), function(i) {
  d <- jedno[[i]]
  d$tercyl <- cut(d$t, quantile(d$t, 0:3 / 3), include.lowest = TRUE, labels = c("niski", "średni", "wysoki"))
  d$graf <- factor(sprintf("%s\nwszyscy: b = %s; z kontrolą: b = %s", grafy[i], liczba(tab[i, "b_bez"]),
                           liczba(tab[i, "b_z"])))
  d
}))
dd$graf <- factor(dd$graf, unique(dd$graf))
kol_terc <- c(niski = "#9CC9E8", średni = "#3A8CC4", wysoki = "#08306B")   # od jasnego do ciemnego
p2 <- ggplot(dd, aes(x, y)) +
  geom_point(aes(colour = tercyl, shape = tercyl), size = 1.6, alpha = 0.75) +
  geom_smooth(aes(colour = tercyl, linetype = "w tercylu trzeciej zmiennej"), method = "lm", se = FALSE,
              formula = y ~ x, linewidth = 1) +
  geom_smooth(aes(linetype = "wszyscy razem"), method = "lm", se = FALSE, formula = y ~ x,
              colour = kol[["bez"]], linewidth = 1.3) +
  scale_colour_manual(values = kol_terc, name = "Tercyl trzeciej zmiennej:") +
  scale_shape_manual(values = c(16, 17, 15), name = "Tercyl trzeciej zmiennej:") +
  scale_linetype_manual(values = c("wszyscy razem" = "longdash", "w tercylu trzeciej zmiennej" = "solid"),
                        breaks = c("wszyscy razem", "w tercylu trzeciej zmiennej"), name = "Linia regresji:") +
  facet_wrap(~graf, ncol = 1) + coord_cartesian(xlim = c(-3, 3), ylim = c(-3.2, 3.2)) +
  labs(x = "Praca zarobkowa (X, wynik z)", y = "Wynik egzaminu (Y, wynik z)") + motyw +
  theme(legend.box = "vertical", legend.spacing.y = unit(0, "pt")) +
  guides(colour = guide_legend(order = 1), shape = guide_legend(order = 1),
         linetype = guide_legend(order = 2, override.aes = list(colour = c(kol[["bez"]], "grey30"))))
p2   # zapis: ggsave("zaklocajaca-collider-jedno-badanie.svg", p2, width = 7.5, height = 11)
Wynik w R
           b_bez CI_d_bez CI_g_bez    b_z CI_d_z CI_g_z
zaklocacz -0.565   -0.684   -0.447 -0.331 -0.464 -0.199
mediator  -0.195   -0.332   -0.059 -0.049 -0.194  0.097
zderzacz  -0.348   -0.475   -0.222  0.104 -0.013  0.221
3. 1000 badań z każdego grafu: Rysunek 3
R
# Rysunek 3. 1000 badań z każdego grafu: współczynnik pracy bez kontroli i z kontrolą trzeciej zmiennej
# (kontynuacja: wsp, kol, motyw, bz, liczba z bloku 1 oraz losuj() z bloku 2)
library(ggplot2)
library(ggdist)

R <- 1000; n <- 300; prawda <- -0.3        # prawdziwy efekt (całkowity) pracy na egzamin w każdym grafie
modele <- list(zaklocacz = c(bez = "y ~ x", z = "y ~ x + t", nierzetelny = "y ~ x + t_pomiar"),
               mediator = c(bez = "y ~ x", z = "y ~ x + t"),
               zderzacz = c(bez = "y ~ x", z = "y ~ x + t"))
set.seed(592)                              # ziarno ustalone raz, bez dobierania pod wynik
sym <- do.call(rbind, lapply(names(modele), function(g) do.call(rbind, lapply(1:R, function(r) {
  d <- losuj(g, n)
  do.call(rbind, lapply(names(modele[[g]]), function(m) {
    fit <- lm(as.formula(modele[[g]][[m]]), d); ci <- confint(fit)["x", ]
    data.frame(graf = g, model = m, badanie = r, b = unname(coef(fit)["x"]), dolna = ci[[1]], gorna = ci[[2]])
  }))
}))))
sym$trafia <- sym$dolna <= prawda & sym$gorna >= prawda     # czy 95% CI obejmuje prawdziwy efekt −0.30

# Średnie oszacowanie, obciążenie, rozrzut (SD), pokrycie 95% CI i odsetek istotnych (p < .05) w 1000 badaniach
pods <- do.call(rbind, lapply(split(sym, list(sym$graf, sym$model), drop = TRUE), function(s)
  data.frame(graf = s$graf[1], model = s$model[1], sredni_b = mean(s$b), obciazenie = mean(s$b) - prawda,
             SD_b = sd(s$b), pokrycie = mean(s$trafia), istotne = mean(s$dolna > 0 | s$gorna < 0))))
pods <- pods[order(match(pods$graf, names(modele)), match(pods$model, c("bez", "z", "nierzetelny"))), ]
print(pods, digits = 3, row.names = FALSE)
round(sqrt(0.95 * 0.05 / R) * 100, 2)      # błąd Monte Carlo odsetka pokrycia przy 95% (punkty procentowe)

# Wykres: rozkład 1000 oszacowań (półskrzypce), środkowe 95% oszacowań i pokrycie przedziałów
etyk <- c(zaklocacz.bez = "A. Zakłócacz: bez kontroli", zaklocacz.z = "A. Zakłócacz: z kontrolą",
          zaklocacz.nierzetelny = "A. Zakłócacz: kontrola pomiaru (rzetelność .60)",
          mediator.bez = "B. Mediator: bez kontroli", mediator.z = "B. Mediator: z kontrolą",
          zderzacz.bez = "C. Zderzacz: bez kontroli", zderzacz.z = "C. Zderzacz: z kontrolą")
pods$opis <- sprintf("%s\nśrednio %s; pokrycie %.1f%%", etyk[paste(pods$graf, pods$model, sep = ".")],
                     liczba(pods$sredni_b), 100 * pods$pokrycie)
sym$wiersz <- factor(pods$opis[match(paste(sym$graf, sym$model), paste(pods$graf, pods$model))], rev(pods$opis))
sym$typ <- factor(ifelse(sym$model == "bez", "bez kontroli", ifelse(sym$model == "z", "z kontrolą trzeciej zmiennej",
                                                                    "z kontrolą nierzetelnego pomiaru")),
                  c("bez kontroli", "z kontrolą trzeciej zmiennej", "z kontrolą nierzetelnego pomiaru"))
p3 <- ggplot(sym, aes(b, wiersz)) +
  geom_vline(xintercept = prawda, linetype = "dashed", colour = "grey20") +
  stat_halfeye(aes(fill = typ, shape = typ), .width = 0.95, point_interval = "mean_qi", slab_alpha = 0.8,
               point_size = 2.6, interval_size = 1.4, height = 0.85) +
  scale_fill_manual(values = c(kol[["bez"]], kol[["z"]], kol[["nierzetelny"]]), name = NULL) +
  scale_shape_manual(values = c(21, 22, 24), name = NULL) +
  scale_x_continuous(breaks = seq(-0.8, 0.4, 0.2), labels = function(x) liczba(x, 1)) +
  scale_y_discrete(expand = expansion(add = c(0.3, 0.9))) + coord_cartesian(xlim = c(-0.8, 0.4)) +
  labs(x = "Oszacowany współczynnik pracy zarobkowej\n(SD wyniku egzaminu na 1 SD pracy)", y = NULL,
       subtitle = "Linia przerywana: prawdziwy efekt −0.30.\nKropka i wąsy: średnia i środkowe 95% z 1000 oszacowań.") +
  motyw + theme(legend.position = "bottom", legend.direction = "vertical", plot.title.position = "plot",
                axis.text.y = element_text(hjust = 0, lineheight = 0.95))
p3   # zapis: ggsave("zaklocajaca-collider-1000-badan.svg", p3, width = 8, height = 8)
Wynik w R
      graf       model sredni_b obciazenie   SD_b pokrycie istotne
 zaklocacz         bez   -0.540   -0.24042 0.0495    0.002   1.000
 zaklocacz           z   -0.299    0.00126 0.0556    0.955   1.000
 zaklocacz nierzetelny   -0.422   -0.12242 0.0529    0.373   1.000
  mediator         bez   -0.302   -0.00226 0.0531    0.957   1.000
  mediator           z   -0.101    0.19858 0.0585    0.085   0.404
  zderzacz         bez   -0.296    0.00367 0.0552    0.957   0.999
  zderzacz           z    0.179    0.47938 0.0462    0.000   0.965
[1] 0.69
4. Dobór próby według zderzacza: Rysunek 4
R
# Rysunek 4. Zderzacz przez dobór próby: cały rocznik i tylko osoby, które przeszły na II rok
# (kontynuacja: wsp, kol, motyw, bz, liczba z bloku 1 oraz losuj() z bloku 2)
library(ggplot2)
library(patchwork)

# Rocznik 500 studentów I roku z grafu C. Na II rok przechodzi 70% osób z najwyższą średnią ocen z roku
# (odsetek ustalony ręcznie). Badacz ankietuje dopiero studentów II roku.
set.seed(592)                              # ziarno ustalone raz, bez dobierania pod wynik
rocznik <- losuj("zderzacz", 500)
names(rocznik)[names(rocznik) == "t"] <- "srednia"
rocznik$przeszedl <- rocznik$srednia >= quantile(rocznik$srednia, 0.30)
write.csv(rocznik[, c("x", "y", "srednia", "przeszedl")], "zaklocajaca-collider-rocznik.csv", row.names = FALSE)

ii_rok <- subset(rocznik, przeszedl)
m_caly <- lm(y ~ x, rocznik); m_ii <- lm(y ~ x, ii_rok)
wyn <- rbind(caly_rocznik = c(n = nrow(rocznik), r = cor(rocznik$x, rocznik$y), b = coef(m_caly)[["x"]], confint(m_caly)["x", ]),
             tylko_II_rok = c(n = nrow(ii_rok), r = cor(ii_rok$x, ii_rok$y), b = coef(m_ii)[["x"]], confint(m_ii)["x", ]))
round(wyn, 3)
# Kto odpadł? Średnia pracy i egzaminu (w SD) u osób, które przeszły i nie przeszły
round(aggregate(cbind(praca = x, egzamin = y) ~ przeszedl, rocznik, mean), 2)

rocznik$grupa <- factor(ifelse(rocznik$przeszedl, "przeszli na II rok (70%)", "odpadli po I roku (30%)"),
                        c("przeszli na II rok (70%)", "odpadli po I roku (30%)"))
osie <- list(coord_cartesian(xlim = c(-3.2, 3.2), ylim = c(-3.4, 3.4)),
             labs(x = "Praca zarobkowa (X, wynik z)", y = "Wynik egzaminu (Y, wynik z)"))
pa <- ggplot(rocznik, aes(x, y)) +
  geom_point(aes(colour = grupa, shape = grupa), size = 1.5, alpha = 0.7) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "black", linewidth = 1.2) +
  scale_colour_manual(values = c(kol[["z"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(16, 4), name = NULL) +
  labs(title = "A. Cały rocznik (n = 500)",
       subtitle = sprintf("r = %s, b = %s", bz(wyn["caly_rocznik", "r"]), liczba(wyn["caly_rocznik", "b"]))) +
  osie + motyw
pb <- ggplot(ii_rok, aes(x, y)) +
  geom_point(colour = kol[["z"]], size = 1.5, alpha = 0.7) +
  geom_abline(intercept = 0, slope = wsp$zderzacz[["x_y"]], linetype = "dashed", colour = "grey30") +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["bez"]], linewidth = 1.2) +
  annotate("text", x = -3.1, y = -3.2, hjust = 0, size = 3.6, colour = "grey30",
           label = "linia przerywana: prawdziwy efekt −0.30") +
  labs(title = sprintf("B. Tylko II rok (n = %d)", nrow(ii_rok)),
       subtitle = sprintf("r = %s, b = %s", bz(wyn["tylko_II_rok", "r"]), liczba(wyn["tylko_II_rok", "b"]))) +
  osie + motyw
p4 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("zaklocajaca-collider-selekcja-proby.svg", p4, width = 9, height = 5.4)
Wynik w R
               n      r      b  2.5 % 97.5 %
caly_rocznik 500 -0.248 -0.238 -0.320 -0.156
tylko_II_rok 350 -0.109 -0.097 -0.191 -0.004
  przeszedl praca egzamin
1         0  0.69   -0.78
2         1 -0.21    0.38
5. Siła selekcji w 1000 rocznikach: Rysunek 5
R
# Rysunek 5. Im ostrzejsza selekcja na zderzaczu, tym większe obciążenie: 1000 roczników dla każdego progu
# (kontynuacja: wsp, kol, motyw, bz, liczba z bloku 1 oraz losuj() z bloku 2)
library(ggplot2)

R <- 1000; N <- 1000; prawda <- -0.3
odsetki <- c(1, 0.9, 0.7, 0.5, 0.3, 0.1)  # jaka część rocznika przechodzi na II rok (siatka ustalona ręcznie)
set.seed(592)                              # ziarno ustalone raz, bez dobierania pod wynik
sel <- do.call(rbind, lapply(1:R, function(r) {
  d <- losuj("zderzacz", N)
  do.call(rbind, lapply(odsetki, function(q) {
    w <- d[d$t >= quantile(d$t, 1 - q), ]; fit <- lm(y ~ x, w); ci <- confint(fit)["x", ]
    data.frame(odsetek = q, n = nrow(w), b = coef(fit)[["x"]], trafia = ci[[1]] <= prawda & ci[[2]] >= prawda,
               istotne = ci[[1]] > 0 | ci[[2]] < 0)
  }))
}))
pods <- do.call(rbind, lapply(split(sel, sel$odsetek), function(s)
  data.frame(odsetek = s$odsetek[1], n = s$n[1], sredni_b = mean(s$b), dolny_2.5 = unname(quantile(s$b, 0.025)),
             gorny_97.5 = unname(quantile(s$b, 0.975)), pokrycie = mean(s$trafia), istotne = mean(s$istotne))))
pods <- pods[order(-pods$odsetek), ]
print(pods, digits = 3, row.names = FALSE)

p5 <- ggplot(pods, aes(100 * odsetek, sredni_b)) +
  geom_hline(yintercept = prawda, linetype = "dashed", colour = "grey20") +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_ribbon(aes(ymin = dolny_2.5, ymax = gorny_97.5), fill = kol[["bez"]], alpha = 0.2) +
  geom_line(colour = kol[["bez"]], linewidth = 1.1) +
  geom_point(colour = kol[["bez"]], size = 2.8) +
  geom_text(aes(label = sprintf("%s\npokrycie %.0f%%", liczba(sredni_b), 100 * pokrycie)),
            vjust = -0.45, size = 3.5, lineheight = 0.9, colour = "grey15") +
  annotate("text", x = 50, y = prawda - 0.03, label = "prawdziwy efekt −0.30", hjust = 0.5, vjust = 1,
           size = 3.6, colour = "grey20") +
  scale_x_reverse(breaks = 100 * odsetki, labels = function(x) paste0(x, "%"), expand = expansion(mult = 0.09)) +
  scale_y_continuous(labels = function(x) liczba(x, 1), limits = c(-0.6, 0.5)) +
  labs(x = "Odsetek rocznika, który przeszedł na II rok i trafił do badania",
       y = "Współczynnik pracy w próbie\n(średnia i środkowe 95% z 1000 roczników)") + motyw
p5   # zapis: ggsave("zaklocajaca-collider-sila-selekcji.svg", p5, width = 8, height = 5.4)
Wynik w R
 odsetek    n sredni_b dolny_2.5 gorny_97.5 pokrycie istotne
     1.0 1000 -0.29992    -0.360    -0.2408    0.949   1.000
     0.9  900 -0.19965    -0.261    -0.1402    0.117   1.000
     0.7  700 -0.10781    -0.179    -0.0342    0.000   0.860
     0.5  500 -0.04470    -0.129     0.0405    0.000   0.195
     0.3  300  0.00489    -0.102     0.1116    0.000   0.058
     0.1  100  0.05784    -0.131     0.2385    0.032   0.098
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (bez kontroli / z kontrolą)" = c("#D55E00", "#0072B2"),
             "cynober – szary (bez kontroli / pomiar nierzetelny)" = c("#D55E00", "#999999"),
             "niebieski – szary (z kontrolą / pomiar nierzetelny; przeszli / odpadli)" = c("#0072B2", "#999999"),
             "tercyle: jasny – średni niebieski" = c("#9CC9E8", "#3A8CC4"),
             "tercyle: średni – ciemny niebieski" = c("#3A8CC4", "#08306B"),
             "tercyle: jasny – ciemny niebieski" = c("#9CC9E8", "#08306B"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                        widzenie_typowe
cynober – niebieski (bez kontroli / z kontrolą)                                   114.6
cynober – szary (bez kontroli / pomiar nierzetelny)                                77.2
niebieski – szary (z kontrolą / pomiar nierzetelny; przeszli / odpadli)            44.9
tercyle: jasny – średni niebieski                                                  28.2
tercyle: średni – ciemny niebieski                                                 39.4
tercyle: jasny – ciemny niebieski                                                  63.7
czerwony – zielony (do unikania)                                                  121.7
                                                                        deuteranopia
cynober – niebieski (bez kontroli / z kontrolą)                                108.3
cynober – szary (bez kontroli / pomiar nierzetelny)                             62.9
niebieski – szary (z kontrolą / pomiar nierzetelny; przeszli / odpadli)         48.9
tercyle: jasny – średni niebieski                                               29.9
tercyle: średni – ciemny niebieski                                              34.2
tercyle: jasny – ciemny niebieski                                               61.1
czerwony – zielony (do unikania)                                                21.1
                                                                        protanopia
cynober – niebieski (bez kontroli / z kontrolą)                               91.9
cynober – szary (bez kontroli / pomiar nierzetelny)                           56.0
niebieski – szary (z kontrolą / pomiar nierzetelny; przeszli / odpadli)       40.6
tercyle: jasny – średni niebieski                                             26.7
tercyle: średni – ciemny niebieski                                            35.7
tercyle: jasny – ciemny niebieski                                             60.3
czerwony – zielony (do unikania)                                              31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania, regresje (lm()) i przedziały ufności (confint()) – pakiet stats. Rysunki wykonano w pakiecie ggplot2, rozkłady oszacowań na rysunku 3 – pakietem ggdist, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggdist (wersja 3.3.3): Kay, M. (2025). ggdist: Visualizations of distributions and uncertainty [R package]. https://doi.org/10.5281/zenodo.3879620
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Kontrolowaliśmy wszystkie dostępne zmienne”. Wśród nich zwykle są mediatory i zderzacze (rysunek 3).
- Wybór zmiennych kontrolnych według istotności albo zmiany R². Zderzacz poprawia dopasowanie, a mimo to zniekształca współczynnik.
- Kontrola zakłócacza mierzonego jednym pytaniem jako „problem rozwiązany”. Przy rzetelności .60 zostaje około połowy obciążenia (rysunek 3).
- Interpretacja braku związku w próbie po kwalifikacji jako braku efektu. Dobór według wspólnego skutku może go ukryć (rysunki 4 i 5).
- Kontrola mediatora przy pytaniu o efekt całkowity. Zostaje tylko efekt bezpośredni (−0.10 zamiast −0.30).
Najczęstsze pytania
Czym różni się zmienna zakłócająca od zderzacza (collidera)?
Kierunkiem strzałek. Zakłócacz jest wspólną przyczyną X i Y (X ← Z → Y) i trzeba go kontrolować. Zderzacz jest wspólnym skutkiem (X → C ← Y) i nie wolno go kontrolować ani dobierać według niego próby. W danych obie zmienne wyglądają podobnie – korelują i z X, i z Y – więc rozstrzyga graf przyczynowy, a nie statystyka.
Co się stanie, jeśli skontroluję mediator?
Zostanie tylko efekt bezpośredni. W naszej symulacji efekt całkowity pracy zarobkowej na wynik egzaminu wynosił −0.30, a po kontroli godzin nauki średnie oszacowanie spadło do −0.10; 95% przedział ufności objął −0.30 tylko w 8.5% z 1000 badań. To poprawna odpowiedź na pytanie o efekt bezpośredni, ale błędna na pytanie o efekt całkowity.
Czy kontrola zderzacza może odwrócić znak efektu?
Tak. W symulacji prawdziwy efekt wynosił −0.30, a po dodaniu do modelu zderzacza (średniej ocen z roku, na którą wpływają i praca, i wynik egzaminu) średnie oszacowanie wyniosło +0.18. W 96.5% z 1000 badań wynik był istotny ze złym znakiem, a dopasowanie modelu się poprawiło.
Jak collider może zepsuć wynik, jeśli nie ma go w modelu?
Przez dobór próby. Jeśli badasz tylko osoby, które przeszły kwalifikację zależną od X i od Y (np. tylko studentów II roku), warunkujesz na zderzaczu. W symulacji przy 70% rocznika w badaniu współczynnik spadł średnio z −0.30 do −0.11, przy 30% – do zera.
Czy kontrola zakłócacza zmierzonego jednym pytaniem wystarczy?
Zwykle nie w pełni. Gdy sytuację materialną zmierzono z rzetelnością .60, kontrola usunęła mniej więcej połowę obciążenia: średnie oszacowanie wyniosło −0.42 zamiast −0.30, a przedział objął prawdziwy efekt w 37.3% badań. Opisz to w ograniczeniach i podaj kierunek możliwego obciążenia.
Powiązane hasła
Przeczytaj też
Grafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikBłąd selekcji i zmienna zderzeniowa w praktyce
Ochotnicy online, rezygnacje i biobanki: symulacje w R, korekta wagami IPW i sytuacje, w których żadna korekta nie wystarczy.
Czytaj →PoradnikParadoks Simpsona – wizualizacja
Chmury punktów z przeciwnymi znakami, zmiana znaku w regresji w 1000 badaniach, odsetki jako średnia ważona i graf przyczynowy – pięć rysunków z kodem R.
Czytaj →PoradnikOgraniczony zakres zmiennej – wizualizacja
Progi przyjęcia, selekcja po X i po Y, skrajne grupy i 1000 badań z poprawką Thorndike’a – pięć rysunków z kodem R.
Czytaj →Nie wiesz, które zmienne kontrolować w swoim modelu?
Pomożemy narysować założony graf przyczynowy, dobrać zmienne kontrolne, policzyć model z kontrolą i bez niej i opisać decyzje w Metodzie i ograniczeniach – tak, żebyś umiał(a) je obronić przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cinelli, C., Forney, A., & Pearl, J. (2024). A crash course in good and bad controls. Sociological Methods & Research, 53(3), 1071–1104. https://doi.org/10.1177/00491241221099552 ● Otwarty dostęp: pełny tekst
- Elwert, F., & Winship, C. (2014). Endogenous selection bias: The problem of conditioning on a collider variable. Annual Review of Sociology, 40(1), 31–53. https://doi.org/10.1146/annurev-soc-071913-043455 ● Otwarty dostęp
- Hernán, M. A., Hernández-Díaz, S., & Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629 ● Otwarty dostęp
- Schisterman, E. F., Cole, S. R., & Platt, R. W. (2009). Overadjustment bias and unnecessary adjustment in epidemiologic studies. Epidemiology, 20(4), 488–495. https://doi.org/10.1097/ede.0b013e3181a819a1 ● Otwarty dostęp: pełny tekst
- Westfall, J., & Yarkoni, T. (2016). Statistically controlling for confounding constructs is harder than you think. PLOS ONE, 11(3), Article e0152719. https://doi.org/10.1371/journal.pone.0152719 ● Otwarty dostęp
- Wysocki, A. C., Lawson, K. M., & Rhemtulla, M. (2022). Statistical control requires causal justification. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095823. https://doi.org/10.1177/25152459221095823 ● Otwarty dostęp
Cytowania BibTeX
@article{cinelli2024crash, author={Cinelli, Carlos and Forney, Andrew and Pearl, Judea}, title={{A crash course in good and bad controls}}, journal={Sociological Methods \& Research}, year={2024}, volume={53}, number={3}, pages={1071--1104}, doi={10.1177/00491241221099552}}@article{elwert2014endogenous, author={Elwert, Felix and Winship, Christopher}, title={{Endogenous selection bias: The problem of conditioning on a collider variable}}, journal={Annual Review of Sociology}, year={2014}, volume={40}, number={1}, pages={31--53}, doi={10.1146/annurev-soc-071913-043455}}@article{hernan2004structural, author={Hernán, Miguel A. and Hernández-Díaz, Sonia and Robins, James M.}, title={{A structural approach to selection bias}}, journal={Epidemiology}, year={2004}, volume={15}, number={5}, pages={615--625}, doi={10.1097/01.ede.0000135174.63482.43}}@article{rohrer2018thinking, author={Rohrer, Julia M.}, title={{Thinking clearly about correlations and causation: Graphical causal models for observational data}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={1}, pages={27--42}, doi={10.1177/2515245917745629}}@article{schisterman2009overadjustment, author={Schisterman, Enrique F. and Cole, Stephen R. and Platt, Robert W.}, title={{Overadjustment bias and unnecessary adjustment in epidemiologic studies}}, journal={Epidemiology}, year={2009}, volume={20}, number={4}, pages={488--495}, doi={10.1097/ede.0b013e3181a819a1}}@article{westfall2016statistically, author={Westfall, Jacob and Yarkoni, Tal}, title={{Statistically controlling for confounding constructs is harder than you think}}, journal={PLOS ONE}, year={2016}, volume={11}, number={3}, eid={e0152719}, doi={10.1371/journal.pone.0152719}}@article{wysocki2022statistical, author={Wysocki, Anna C. and Lawson, Katherine M. and Rhemtulla, Mijke}, title={{Statistical control requires causal justification}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095823}, doi={10.1177/25152459221095823}}