Poprawa, której nikt nie spowodował
Definicję i wzór znajdziesz w haśle regresja do średniej. Badanie przed–po z progiem kwalifikacji, grupą kontrolną i czterema definicjami pomiaru wyjściowego omawia wpis regresja do średniej w badaniu przed–po. Tu pokazujemy samo zjawisko na rysunkach: skąd się bierze, od czego zależy jego siła i co zostaje z „efektu” interwencji, która nie działa.
Przykład jest fikcyjny. 600 osób z pierwszego roku pisze test diagnostyczny z matematyki (0–100 punktów). Najsłabsze 10% trafia na kurs wyrównawczy, a najlepsze 10% do koła olimpijskiego. Dwa tygodnie później wszyscy piszą ten sam test jeszcze raz, ale w naszych danych nikt w tym czasie nie chodził na żadne zajęcia. Każdy wynik to suma dwóch części: wyniku prawdziwego (stałego poziomu umiejętności, średnio 60 punktów, SD = 9) i błędu pomiaru (SD = 5), który przy każdym podejściu losuje się od nowa. Rzetelność testu wynosi więc 81 / (81 + 25) = .76, a w próbie korelacja obu pomiarów wyszła r = .785. Parametry ustaliliśmy ręcznie tak, by zjawisko było wyraźne; ziarno 590 ustalono raz i go nie zmieniano. Dane pobierzesz jako regresja-do-sredniej-600-osob.csv.
Rysunek 1: kogo naprawdę wybiera próg
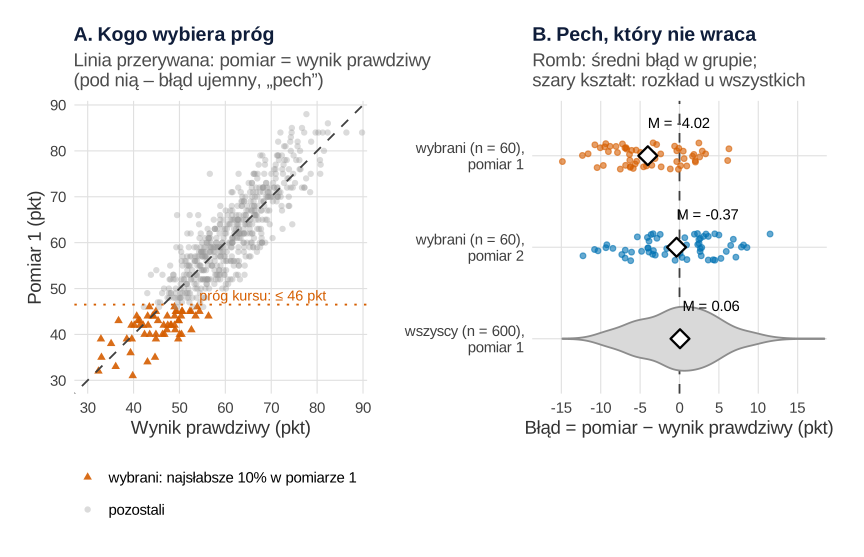
set.seed(590)).Co widać. Próg kursu (do 46 punktów) wybiera 60 osób. Ich średni wynik w pierwszym pomiarze to 41.13 punktu, ale ich średni wynik prawdziwy – 45.16. Różnicę robi błąd: u wybranych wynosi średnio −4.02 punktu, a ujemny jest u 77% z nich. Na panelu A wybrani leżą przeważnie pod przekątną: są naprawdę słabsi i mieli gorszy dzień. Dwa tygodnie później (panel B) wynik prawdziwy zostaje, a błąd losuje się od nowa: średnio −0.37, prawie zero. Średnia wybranych rośnie więc do 44.78, choć nikt niczego się nie nauczył. W całej grupie 600 osób średni błąd to 0.06, a średnie obu pomiarów są prawie równe (60.07 i 59.92).
Czego ten wykres nie pokazuje. Wyniku prawdziwego nie znasz, więc panelu A nie narysujesz z własnych danych – to model, nie diagnoza. Rozrzut błędów zależy od standardowego błędu pomiaru (tu 5 punktów). Model zakłada też stały wynik prawdziwy; przy dłuższym odstępie dochodzi naturalna zmienność. Więcej o rozkładzie wyniku na część prawdziwą i błąd – we wpisie rzetelność i błąd pomiaru – wizualizacja na obrazkach.
Podpis do pracy (np. w rozdziale teoretycznym lub na obronę):
Zdanie do Dyskusji:
Rysunek 2: przed–po ze strzałkami
Te same dane, dwie skrajne grupy po 60 osób; strzałka prowadzi od pierwszego pomiaru osoby do drugiego.
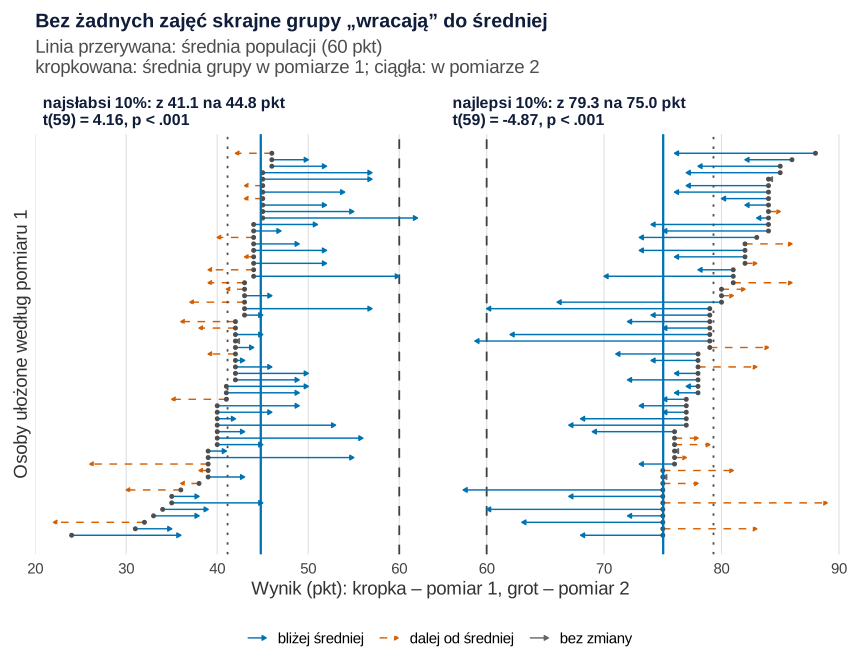
Co widać. Najsłabsi „poprawili się” średnio o 3.65 punktu, 95% CI [1.89, 5.41], t(59) = 4.16, p < .001. Najlepsi „pogorszyli się” o 4.28 punktu, t(59) = −4.87, p < .001. W raporcie z kursu i koła olimpijskiego wyglądałoby to na sukces i porażkę, choć w obu grupach nie zrobiono nic. Ale nie każdy wraca do średniej. Wśród najsłabszych 41 osób zbliżyło się do średniej populacji, a 18 oddaliło (wśród najlepszych: 42 i 15). Zjawisko dotyczy średniej grupy, nie każdej osoby.
Czego ten wykres nie pokazuje. Strzałki wyglądają jak „ruch”, ale nie mówią, czy ruch ma przyczynę – ten sam obraz dałby kurs działający i niedziałający. Rozróżnia je dopiero grupa porównawcza (rysunek 5). Osób ze środka rozkładu tu nie ma; ich średnia prawie się nie zmienia. Linie par przy mniejszych grupach omawia wpis próby zależne w obrazkach.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: pomiar 1 × pomiar 2, w przód i wstecz
Te same 600 osób podzieliliśmy na dziesiątki (decyle) – raz według pierwszego, raz według drugiego pomiaru – i w każdej policzyliśmy średnie obu pomiarów.
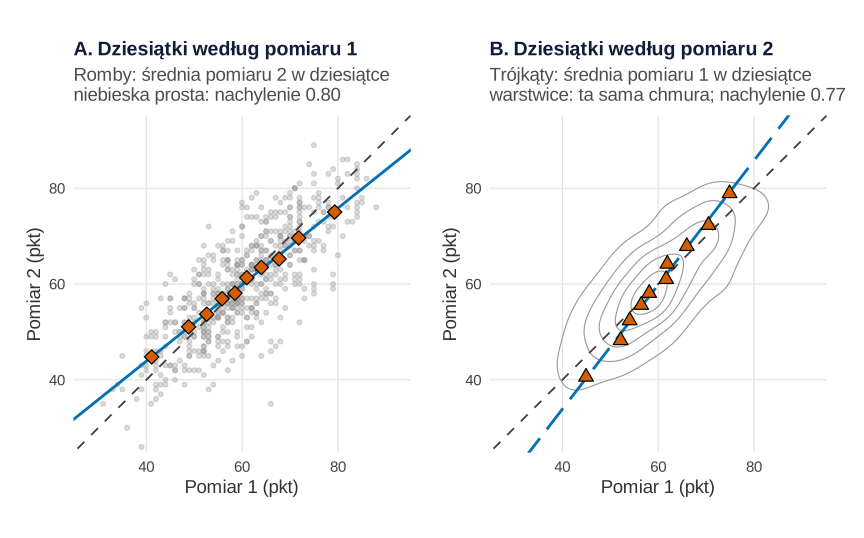
Co widać. Na panelu A romby leżą nie na przekątnej, lecz na prostej regresji o nachyleniu 0.80 – mniej stromej, bo korelacja pomiarów jest mniejsza od 1. Dolna dziesiątka: 41.13 i 44.78 punktu, górna: 79.32 i 75.03. Panel B odwraca kierunek: grupujemy według drugiego pomiaru i patrzymy wstecz. Dolna dziesiątka drugiego pomiaru miała w nim 40.62 punktu, a w pierwszym – 44.95. Górna: 78.92 i 74.90. Zjawisko działa więc także „pod prąd czasu”. To najprostszy dowód, że nie wywołuje go żaden proces między pomiarami – wystarczy korelacja mniejsza od 1 i wybór grup po skrajnym wyniku.
Czego ten wykres nie pokazuje. Punkty zbliżają się do średniej, ale chmura się nie zwęża. SD pomiaru drugiego jest takie samo jak pierwszego, więc regresja do średniej nie oznacza, że grupa z czasem „się wyrównuje”. Pojęcie pochodzi od Francisa Galtona, a Stigler (1997) opisuje, jak je później rozumiano i jak często mylnie interpretowano. Dwie proste z obu paneli omawia wpis metoda najmniejszych kwadratów w obrazkach.
Podpis do pracy:
Zdanie do Metody (rzetelność test–retest):
Rysunek 4: siła zjawiska a korelacja test–retest
Ile „poprawy” bez przyczyny można się spodziewać? To zależy od tego, jak skrajną grupę wybierasz i jak silnie korelują pomiary (czyli od rzetelności test–retest, gdy cecha się nie zmienia). Krzywe na panelu A pochodzą ze wzoru dla rozkładu normalnego (ten sam wzór z progiem kwalifikacji pokazuje wpis o badaniu przed–po). Punkty to symulacja: 50 000 osób dla każdej z korelacji .5, .7 i .9.
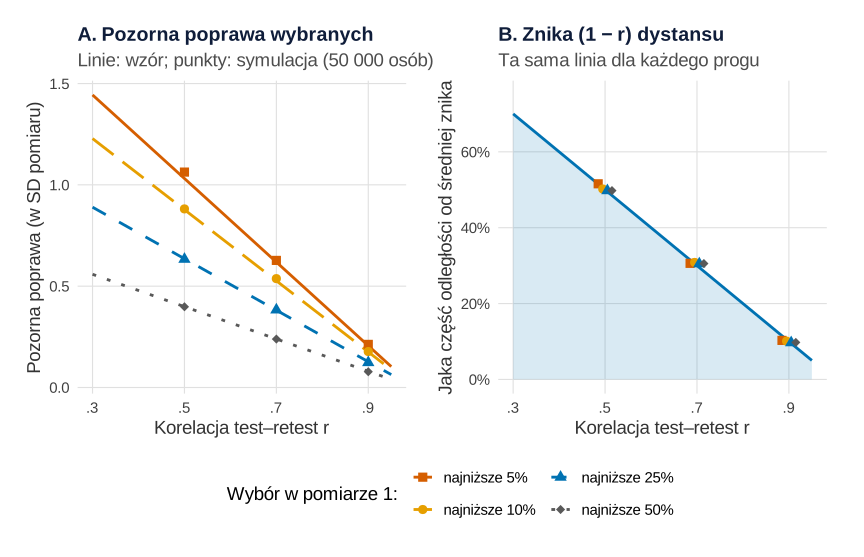
set.seed(590)).Co widać. Przy wyborze najsłabszych 10% i korelacji .5 pozorna poprawa wynosi według wzoru 0.88 SD (symulacja: 0.88). Przy korelacji .7 – 0.53 SD (0.54), a przy .9 – 0.18 SD (0.18). Im ostrzejsza selekcja, tym wyżej krzywa. Panel B pokazuje prostszą prawidłowość: niezależnie od progu w drugim pomiarze znika ta sama część odległości od średniej, 1 − r. W symulacji przy r = .5 zostawało od 48% do 50% odległości, przy .7 – około 69%, przy .9 – około 90%. W naszym teście (rzetelność .76, SD 10.30 punktu) wzór przewiduje dla najsłabszych 10% poprawę o 0.41 SD, czyli 4.26 punktu; w próbie 600 osób wyszło 3.65.
Czego ten wykres nie pokazuje. Wzór zakłada rozkład normalny i tę samą zmienność w obu pomiarach. Linden (2013) pokazał w symulacji, że przy danych skośnych taki wzór zaniża efekt (wyniki we wpisie o badaniu przed–po). Potrzebne r weź z badania bez interwencji, w podobnym odstępie czasu i populacji, a nie alfa Cronbacha. Bland i Altman (1994) podkreślają, że im słabsza korelacja dwóch pomiarów, tym silniejsza regresja do średniej. W próbie o wąskim zakresie korelacja jest niższa niż w populacji – zob. ograniczony zakres zmiennej – wizualizacja na obrazkach.
Podpis do pracy (np. w aneksie metodologicznym):
Zdanie do Metody (planowanie):
Rysunek 5: 1000 badań kursu, który nie działa
Teraz powtarzamy całe badanie 1000 razy. W każdym 200 osób pisze test, 40 najsłabszych (20%) kwalifikuje się na kurs, a dwa tygodnie później wszyscy piszą test ponownie. Kurs nie ma żadnego efektu. Każde badanie liczymy na cztery sposoby: (1) przed–po tylko u zakwalifikowanych; (2) różnica zmian między zakwalifikowanymi a 40 losowymi osobami spośród niezakwalifikowanych – grupa kontrolna „z innym kryterium”; (3) losowy przydział 20 zakwalifikowanych na kurs i 20 do kontroli, różnica zmian; (4) ten sam plan, ANCOVA z pierwszym pomiarem jako kowariantem. Liczebności, odsetek kwalifikowanych i 1000 powtórzeń ustaliliśmy ręcznie; ziarno 590.
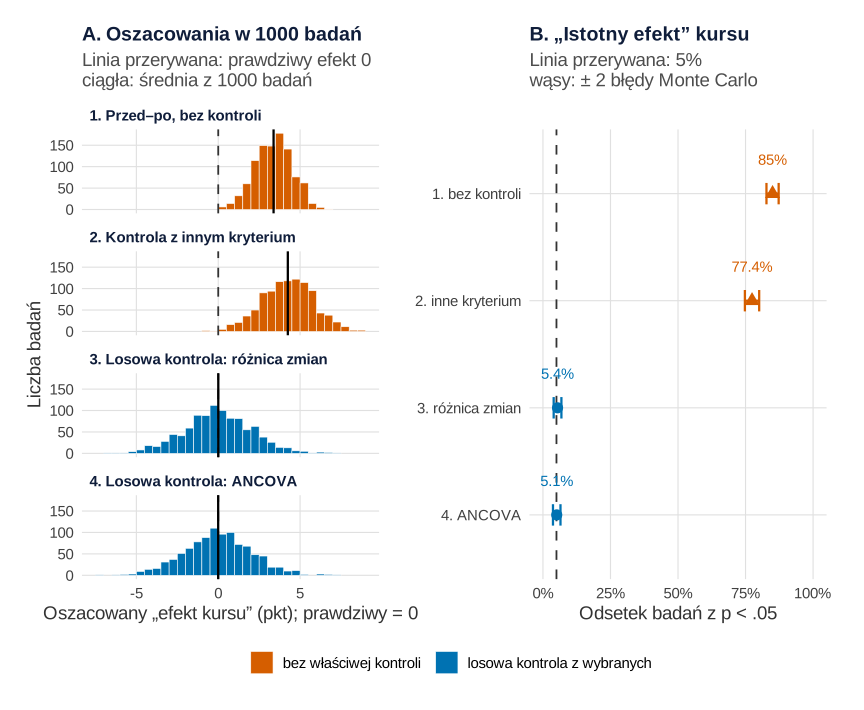
set.seed(590)).Co widać. Analiza przed–po bez kontroli „znajduje” średnio 3.38 punktu poprawy i daje p < .05 w 85.0% badań (błąd Monte Carlo 1.1 punktu procentowego). Kontrola z innym kryterium nie pomaga, a nawet szkodzi: średnio 4.25 punktu i 77.4% „istotnych” wyników (błąd MC 1.3 pp). Osoby spoza dolnych 20% lekko się „pogarszają”, więc różnica zmian rośnie. Dopiero losowa kontrola z tej samej puli zakwalifikowanych trafia w prawdziwe zero: średnio 0.00 punktu i 5.4% istotnych dla różnicy zmian, 5.1% dla ANCOVA (błąd MC po 0.7 pp). Tyle, ile powinno być przy α = .05; ANCOVA miała nieco mniejszy rozrzut oszacowań (SD 2.07 wobec 2.10).
Czego ten wykres nie pokazuje. Symulacja zakłada stały wynik prawdziwy, ten sam test w obu pomiarach i brak efektu uczenia się testu. W prawdziwym badaniu dochodzą efekt ponownego badania i naturalny przebieg – losowa kontrola usuwa je razem z regresją do średniej, bo działają w obu grupach. Clifton i Clifton (2019) zwracają uwagę, że analiza samych zmian nie rozwiązuje problemu regresji do średniej ani nierównowagi wyjściowej, i zalecają ANCOVA z pomiarem wyjściowym. Precyzję ANCOVA przy większej liczbie badań pokazuje wpis ANCOVA – wizualizacja na obrazkach. Gdy grupy nie są losowane, ANCOVA i wynik różnicowy mogą dawać różne odpowiedzi – zob. paradoks Lorda.
Podpis do pracy:
Zdanie do Metody:
Co zrobić w praktyce
Davis (1976) pisał, że regresja do średniej bywa duża i prowadzi do błędnych wniosków o skuteczności leczenia. Opisał sposoby uwzględniania jej zarówno przy planowaniu badania, jak i w analizie. W pracy dyplomowej oznacza to kilka decyzji:
- Grupa kontrolna wybrana tym samym kryterium, najlepiej z losowym przydziałem spośród zakwalifikowanych (rysunek 5). Planowanie opisuje wpis grupa kontrolna w badaniu interwencji, a losowanie – losowy przydział w obrazkach.
- ANCOVA z pomiarem wyjściowym zamiast samego testu przed–po (procedura we wpisie ANCOVA w badaniu przed i po).
- Osobny pomiar do kwalifikacji i osobny wyjściowy – szczegóły w symulacji czterech strategii.
- Rzetelniejszy pomiar (średnia z kilku pomiarów, dłuższa skala) – przy wyższym r zjawisko słabnie, ale nie znika (rysunek 4).
- Bez grupy kontrolnej – nazwij problem w ograniczeniach badania i podaj oczekiwaną wielkość regresji (rysunek 4). Nie odejmuj jej od wyniku jako „prawdziwego efektu”. Zob. hasło schemat pretest–posttest bez grupy kontrolnej.
Zjawisko dotyczy też średnich całych grup. Smith i Smith (2005) pokazali na wynikach szkół, że bez uwzględnienia regresji do średniej zmiany średniego wyniku grupy łatwo wziąć za zmianę jej rzeczywistych umiejętności. Kahneman i Tversky (1973) pokazali, że przewidywania intuicyjne są niewrażliwe na rzetelność przesłanek, i właśnie z tym wiązali rozpowszechnione błędne intuicje dotyczące regresji. Barnett i in. (2005) przypominają, że regresję do średniej trzeba zawsze rozważyć jako możliwe wyjaśnienie obserwowanej zmiany.
Zdanie do ograniczeń (badanie bez grupy kontrolnej):
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane 600 osób, paletę, motyw i funkcje pomocnicze, z których korzystają przepisy 2 i 3 (te dwa niczego nie losują). Każdy przepis kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R. Do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 4 i 5), zaczyna się od własnego set.seed(590), więc skopiowany osobno da te same liczby co na stronie (przepis 1 ustawia też seed = 590 w rozrzuceniu punktów na rysunku 1B). Ziarno 590 ustalono raz i nie zmieniano go. Ręcznie ustalono: średnią wyniku prawdziwego 60, SD wyniku prawdziwego 9 i błędu 5 punktów, 600 osób i próg 10% w przykładzie; odsetki 5/10/25/50%, korelacje .5/.7/.9 i 50 000 osób w symulacji na rysunku 4; 200 osób, kwalifikację 20% (40 osób), podział 20/20, 40 osób kontroli z innym kryterium i 1000 powtórzeń w symulacji na rysunku 5. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, wynik prawdziwy i błąd: Rysunek 1
R
# Rysunek 1. Wynik obserwowany = wynik prawdziwy + błąd: kogo wybiera najniższy wynik (dane fikcyjne)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", szary = "grey60", ciemny = "#0f1d3a")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .76 zamiast 0.76
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))

# 600 osób na pierwszym roku pisze dwa razy ten sam test diagnostyczny z matematyki (0–100 pkt),
# w odstępie dwóch tygodni, bez żadnych zajęć pomiędzy. Parametry ustalone ręcznie:
# wynik prawdziwy ~ N(60, 9), błąd każdego pomiaru ~ N(0, 5), więc rzetelność = 81 / (81 + 25)
N <- 600; mu <- 60; sd_T <- 9; sd_E <- 5
set.seed(590)                                    # ziarno ustalone raz, bez dobierania pod wynik
T  <- rnorm(N, mu, sd_T)                         # wynik prawdziwy (stały między pomiarami)
P1 <- round(T + rnorm(N, 0, sd_E))               # pomiar 1 = wynik prawdziwy + błąd 1
P2 <- round(T + rnorm(N, 0, sd_E))               # pomiar 2 = ten sam wynik prawdziwy + nowy błąd 2
dane <- data.frame(osoba = 1:N, T, P1, P2, E1 = P1 - T, E2 = P2 - T)
pozycja <- rank(dane$P1, ties.method = "first")   # remisy na progu rozstrzyga kolejność na liście
dane$grupa <- ifelse(pozycja <= 0.1 * N, "najsłabsi 10%", ifelse(pozycja > 0.9 * N, "najlepsi 10%", "pozostali"))
write.csv(transform(dane, T = round(T, 1), E1 = round(E1, 1), E2 = round(E2, 1)),
          "regresja-do-sredniej-600-osob.csv", row.names = FALSE)

# Rzetelność: teoretyczna, kwadrat korelacji wynik prawdziwy–pomiar i korelacja test–retest w próbie
round(c(rzetelnosc_teoretyczna = sd_T^2 / (sd_T^2 + sd_E^2), r_T_P1_kwadrat = cor(T, P1)^2,
        r_test_retest = cor(P1, P2), M_P1 = mean(P1), M_P2 = mean(P2), SD_P1 = sd(P1)), 3)

# Dla każdej grupy: średni wynik prawdziwy, średni błąd w pomiarze 1 i 2, średnie obu pomiarów
opis <- do.call(rbind, lapply(split(dane, dane$grupa), function(d)
  data.frame(n = nrow(d), M_T = mean(d$T), M_E1 = mean(d$E1), M_E2 = mean(d$E2),
             M_P1 = mean(d$P1), M_P2 = mean(d$P2), odsetek_E1_ujemny = mean(d$E1 < 0))))
round(opis[c("najsłabsi 10%", "pozostali", "najlepsi 10%"), ], 2)
prog <- max(dane$P1[dane$grupa == "najsłabsi 10%"])
prog                                             # najwyższy wynik, który jeszcze kwalifikował na kurs

# A: wynik prawdziwy a pomiar 1 – wybrani to ci, którzy są nisko ORAZ mieli pecha (pod przekątną)
dane$wybor <- factor(ifelse(dane$grupa == "najsłabsi 10%", "wybrani: najsłabsze 10% w pomiarze 1", "pozostali"),
                     c("wybrani: najsłabsze 10% w pomiarze 1", "pozostali"))
pa <- ggplot(dane, aes(T, P1)) +
  geom_point(aes(colour = wybor, shape = wybor, alpha = wybor), size = 1.8) +
  geom_abline(slope = 1, intercept = 0, colour = "grey25", linetype = "dashed") +
  geom_hline(yintercept = prog + 0.5, colour = kol[["cynober"]], linetype = "dotted") +
  annotate("text", x = 82, y = prog + 2.5, label = sprintf("próg kursu: ≤ %d pkt", prog),
           colour = kol[["cynober"]], hjust = 1, size = 3.8) +
  scale_colour_manual(values = c(kol[["cynober"]], kol[["szary"]]), name = NULL) +
  scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_alpha_manual(values = c(0.9, 0.35), name = NULL) +
  coord_equal(xlim = c(30, 88), ylim = c(30, 88)) +
  labs(x = "Wynik prawdziwy (pkt)", y = "Pomiar 1 (pkt)", title = "A. Kogo wybiera próg",
       subtitle = "Linia przerywana: pomiar = wynik prawdziwy\n(pod nią – błąd ujemny, „pech”)") +
  motyw + guides(colour = guide_legend(ncol = 1))

# B: błąd pomiaru u wszystkich i u wybranych – w pomiarze 1 i w pomiarze 2
wyb <- dane[dane$grupa == "najsłabsi 10%", ]
bl <- data.frame(wiersz = rep(c("wszyscy (n = 600),\npomiar 1", "wybrani (n = 60),\npomiar 1", "wybrani (n = 60),\npomiar 2"),
                              c(N, nrow(wyb), nrow(wyb))),
                 blad = c(dane$E1, wyb$E1, wyb$E2))
bl$wiersz <- factor(bl$wiersz, rev(unique(bl$wiersz)))
sr_bl <- aggregate(blad ~ wiersz, bl, mean)
pb <- ggplot(bl, aes(blad, wiersz)) +
  geom_vline(xintercept = 0, colour = "grey25", linetype = "dashed") +
  geom_violin(data = bl[bl$wiersz == levels(bl$wiersz)[3], ], fill = "grey85", colour = "grey55", width = 0.7) +
  geom_point(data = bl[bl$wiersz != levels(bl$wiersz)[3], ], aes(colour = wiersz),
             position = position_jitter(width = 0, height = 0.15, seed = 590), alpha = 0.6, size = 1.6) +
  geom_point(data = sr_bl, shape = 23, size = 4.5, fill = "white", colour = "black", stroke = 1.2) +
  geom_text(data = sr_bl, aes(label = sprintf("M = %.2f", blad)), nudge_y = 0.36, nudge_x = 4, size = 3.9) +
  scale_colour_manual(values = c(kol[["niebieski"]], kol[["cynober"]]), guide = "none") +
  scale_x_continuous(breaks = seq(-15, 15, 5)) + coord_cartesian(xlim = c(-17, 17)) +
  labs(x = "Błąd = pomiar − wynik prawdziwy (pkt)", y = NULL, title = "B. Pech, który nie wraca",
       subtitle = "Romb: średni błąd w grupie;\nszary kształt: rozkład u wszystkich") +
  motyw

p1 <- pa + pb + plot_layout(widths = c(1, 1))
p1   # zapis: ggsave("regresja-do-sredniej-wynik-prawdziwy-i-blad.svg", p1, width = 9, height = 5.8)
Wynik w R
rzetelnosc_teoretyczna         r_T_P1_kwadrat          r_test_retest
                 0.764                  0.789                  0.785
                  M_P1                   M_P2                  SD_P1
                60.072                 59.923                 10.887
                n   M_T  M_E1  M_E2  M_P1  M_P2 odsetek_E1_ujemny
najsłabsi 10%  60 45.16 -4.02 -0.37 41.13 44.78              0.77
pozostali     480 60.09 -0.06 -0.17 60.03 59.93              0.49
najlepsi 10%   60 74.20  5.12  0.84 79.32 75.03              0.15
[1] 46
2. Strzałki przed–po w skrajnych grupach: Rysunek 2
R
# Rysunek 2. Najsłabsi i najlepsi w pomiarze 1: strzałki do pomiaru 2 (te same dane co w przepisie 1)
# Wymaga obiektów z przepisu 1: dane, mu, kol, motyw, bz(), p_apa()
skrajni <- dane[dane$grupa != "pozostali", ]
skrajni$grupa <- factor(skrajni$grupa, c("najsłabsi 10%", "najlepsi 10%"))
# Kierunek zmiany względem średniej populacji (60 pkt): bliżej, dalej czy bez zmiany
odl1 <- abs(skrajni$P1 - mu); odl2 <- abs(skrajni$P2 - mu)
skrajni$kierunek <- factor(ifelse(odl2 < odl1, "bliżej średniej", ifelse(odl2 > odl1, "dalej od średniej", "bez zmiany")),
                           c("bliżej średniej", "dalej od średniej", "bez zmiany"))
table(skrajni$grupa, skrajni$kierunek)

# Średnie i test dla par w każdej grupie – „efekt” bez żadnych zajęć
testy <- do.call(rbind, lapply(split(skrajni, skrajni$grupa), function(d) {
  tt <- t.test(d$P2, d$P1, paired = TRUE)
  data.frame(M_P1 = mean(d$P1), M_P2 = mean(d$P2), zmiana = mean(d$P2 - d$P1),
             CI_dolna = tt$conf.int[1], CI_gorna = tt$conf.int[2], t = unname(tt$statistic),
             df = unname(tt$parameter), p = tt$p.value)
}))
print(round(testy[names(testy) != "p"], 2))
signif(testy$p, 3)

# Osoby ułożone według pomiaru 1; strzałka od pomiaru 1 do pomiaru 2
skrajni <- skrajni[order(skrajni$grupa, skrajni$P1, skrajni$osoba), ]
skrajni$miejsce <- ave(skrajni$P1, skrajni$grupa, FUN = seq_along)
testy$grupa <- factor(rownames(testy), levels(skrajni$grupa))
testy$etykieta <- sprintf("%s: z %.1f na %.1f pkt\nt(%d) = %.2f, %s", testy$grupa, testy$M_P1, testy$M_P2,
                          round(testy$df), testy$t, sapply(testy$p, p_apa))
skrajni$panel <- factor(testy$etykieta[match(skrajni$grupa, testy$grupa)], testy$etykieta)
testy$panel <- factor(testy$etykieta, testy$etykieta)
p2 <- ggplot(skrajni) +
  geom_vline(xintercept = mu, colour = "grey25", linetype = "dashed") +
  geom_segment(aes(x = P1, xend = P2, y = miejsce, yend = miejsce, colour = kierunek, linetype = kierunek),
               arrow = arrow(length = unit(0.12, "cm"), type = "closed"), linewidth = 0.5) +
  geom_point(aes(P1, miejsce), size = 0.9, colour = "grey30") +
  geom_vline(data = testy, aes(xintercept = M_P1), colour = "grey30", linetype = "dotted") +
  geom_vline(data = testy, aes(xintercept = M_P2), colour = kol[["niebieski"]], linewidth = 0.8) +
  facet_wrap(~ panel, ncol = 2, scales = "free_x") +
  scale_colour_manual(values = c("bliżej średniej" = kol[["niebieski"]], "dalej od średniej" = kol[["cynober"]],
                                 "bez zmiany" = "grey40"), name = NULL, drop = FALSE) +
  scale_linetype_manual(values = c("bliżej średniej" = "solid", "dalej od średniej" = "dashed",
                                   "bez zmiany" = "solid"), name = NULL, drop = FALSE) +
  scale_y_continuous(breaks = NULL) +
  labs(x = "Wynik (pkt): kropka – pomiar 1, grot – pomiar 2", y = "Osoby ułożone według pomiaru 1",
       title = "Bez żadnych zajęć skrajne grupy „wracają” do średniej",
       subtitle = "Linia przerywana: średnia populacji (60 pkt)\nkropkowana: średnia grupy w pomiarze 1; ciągła: w pomiarze 2") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p2   # zapis: ggsave("regresja-do-sredniej-strzalki-przed-po.svg", p2, width = 9, height = 7)
Wynik w R
                bliżej średniej dalej od średniej bez zmiany
  najsłabsi 10%              41                18          1
  najlepsi 10%               42                15          3
               M_P1  M_P2 zmiana CI_dolna CI_gorna     t df
najsłabsi 10% 41.13 44.78   3.65     1.89     5.41  4.16 59
najlepsi 10%  79.32 75.03  -4.28    -6.04    -2.52 -4.87 59
[1] 1.05e-04 8.77e-06
3. Pomiar 1 × pomiar 2 i dziesiątki: Rysunek 3
R
# Rysunek 3. Pomiar 1 × pomiar 2: linia y = x, prosta regresji i średnie w dziesiątkach (przód i wstecz)
# Wymaga obiektów z przepisu 1: dane, mu, kol, motyw, bz()
m21 <- lm(P2 ~ P1, data = dane)                  # przewidywanie pomiaru 2 z pomiaru 1
m12 <- lm(P1 ~ P2, data = dane)                  # i odwrotnie: pomiaru 1 z pomiaru 2
round(c(r = cor(dane$P1, dane$P2), nachylenie_P2_na_P1 = unname(coef(m21)[2]),
        nachylenie_P1_na_P2 = unname(coef(m12)[2])), 3)

# Dziesiątki (decyle) według pomiaru 1 i – osobno – według pomiaru 2
dane$decyl_P1 <- cut(rank(dane$P1, ties.method = "first"), 10, labels = FALSE)
dane$decyl_P2 <- cut(rank(dane$P2, ties.method = "first"), 10, labels = FALSE)
przod <- aggregate(cbind(P1, P2) ~ decyl_P1, dane, mean)
wstecz <- aggregate(cbind(P1, P2) ~ decyl_P2, dane, mean)
skrajne <- data.frame(podzial = rep(c("wg pomiaru 1", "wg pomiaru 2"), each = 2), dziesiatka = c(1, 10, 1, 10),
                      M_P1 = c(przod$P1[c(1, 10)], wstecz$P1[c(1, 10)]), M_P2 = c(przod$P2[c(1, 10)], wstecz$P2[c(1, 10)]))
print(transform(skrajni_tab <- skrajne, M_P1 = round(M_P1, 2), M_P2 = round(M_P2, 2)), row.names = FALSE)

pa <- ggplot(dane, aes(P1, P2)) +
  geom_point(colour = kol[["szary"]], alpha = 0.35, size = 1.3) +
  geom_abline(slope = 1, intercept = 0, colour = "grey25", linetype = "dashed") +
  geom_abline(intercept = coef(m21)[1], slope = coef(m21)[2], colour = kol[["niebieski"]], linewidth = 1) +
  geom_point(data = przod, shape = 23, size = 3.6, fill = kol[["cynober"]], colour = "black") +
  coord_equal(xlim = c(28, 92), ylim = c(28, 92)) +
  labs(x = "Pomiar 1 (pkt)", y = "Pomiar 2 (pkt)", title = "A. Dziesiątki według pomiaru 1",
       subtitle = sprintf("Romby: średnia pomiaru 2 w dziesiątce\nniebieska prosta: nachylenie %.2f", coef(m21)[2])) +
  motyw
pb <- ggplot(dane, aes(P1, P2)) +
  geom_density_2d(colour = "grey60", bins = 6, linewidth = 0.4) +     # ta sama chmura jako warstwice
  geom_abline(slope = 1, intercept = 0, colour = "grey25", linetype = "dashed") +
  geom_abline(intercept = -coef(m12)[1] / coef(m12)[2], slope = 1 / coef(m12)[2],   # prosta P1 = a + b·P2
              colour = kol[["niebieski"]], linewidth = 1, linetype = "longdash") +
  geom_point(data = wstecz, shape = 24, size = 3.4, fill = kol[["cynober"]], colour = "black") +
  coord_equal(xlim = c(28, 92), ylim = c(28, 92)) +
  labs(x = "Pomiar 1 (pkt)", y = "Pomiar 2 (pkt)", title = "B. Dziesiątki według pomiaru 2",
       subtitle = sprintf("Trójkąty: średnia pomiaru 1 w dziesiątce\nwarstwice: ta sama chmura; nachylenie %.2f", coef(m12)[2])) +
  motyw
p3 <- pa + pb
p3   # zapis: ggsave("regresja-do-sredniej-chmura-pomiarow.svg", p3, width = 9, height = 5.6)
Wynik w R
                  r nachylenie_P2_na_P1 nachylenie_P1_na_P2
              0.785               0.799               0.771
      podzial dziesiatka  M_P1  M_P2
 wg pomiaru 1          1 41.13 44.78
 wg pomiaru 1         10 79.32 75.03
 wg pomiaru 2          1 44.95 40.62
 wg pomiaru 2         10 74.90 78.92
4. Wzór i symulacja w funkcji korelacji: Rysunek 4
R
# Rysunek 4. Siła regresji do średniej w funkcji korelacji test–retest (wzór + symulacja)
# Wymaga obiektów z przepisu 1: kol, motyw, bz(); wartości populacji ustawione tu od nowa
library(ggplot2)
library(patchwork)
odsetki <- c(0.05, 0.10, 0.25, 0.50)             # wybieramy najniższe 5%, 10%, 25% albo 50% w pomiarze 1
r_siatka <- seq(0.30, 0.95, by = 0.01)
# Wzór dla rozkładu normalnego (SD obu pomiarów = 1): średnia wybranych leży φ(z)/Φ(z) SD poniżej średniej,
# a w pomiarze 2 wraca o (1 − r) tej odległości
krzywe <- expand.grid(r = r_siatka, odsetek = odsetki)
krzywe$odleglosc <- dnorm(qnorm(krzywe$odsetek)) / krzywe$odsetek          # w jednostkach SD
krzywe$zmiana_SD <- (1 - krzywe$r) * krzywe$odleglosc
krzywe$zostaje <- krzywe$r                                                   # część odległości, która zostaje

# Symulacja kontrolna: dla r = .5, .7, .9 po 50 000 osób, dwa pomiary bez żadnej zmiany
set.seed(590)
sym <- do.call(rbind, lapply(c(0.5, 0.7, 0.9), function(r) {
  z1 <- rnorm(50000); z2 <- r * z1 + sqrt(1 - r^2) * rnorm(50000)
  do.call(rbind, lapply(odsetki, function(f) {
    w <- z1 <= quantile(z1, f)
    data.frame(r = r, odsetek = f, zmiana_SD = mean(z2[w]) - mean(z1[w]), zostaje = mean(z2[w]) / mean(z1[w]))
  }))
}))
porownanie <- merge(sym, krzywe[abs(krzywe$r - 0.5) < 1e-9 | abs(krzywe$r - 0.7) < 1e-9 | abs(krzywe$r - 0.9) < 1e-9,
                                c("r", "odsetek", "zmiana_SD")], by = c("r", "odsetek"), suffixes = c("_sym", "_wzor"))
print(round(porownanie, 3), row.names = FALSE)
# Przeliczenie na punkty testu z przepisu 1 (SD pomiaru ok. 10.3 pkt, rzetelność .76), wybór najniższych 10%
zmiana_SD_10proc <- (1 - 0.764) * dnorm(qnorm(0.10)) / 0.10
round(c(SD_pomiaru = sqrt(81 + 25), zmiana_SD_10proc = zmiana_SD_10proc,
        zmiana_pkt_10proc = zmiana_SD_10proc * sqrt(81 + 25)), 2)

krzywe$odsetek_et <- factor(paste0("najniższe ", krzywe$odsetek * 100, "%"), paste0("najniższe ", odsetki * 100, "%"))
sym$odsetek_et <- factor(paste0("najniższe ", sym$odsetek * 100, "%"), levels(krzywe$odsetek_et))
linie <- c("solid", "longdash", "dashed", "dotted")
ksztalty <- c(15, 16, 17, 18)
odcienie <- c(kol[["cynober"]], "#E69F00", kol[["niebieski"]], "grey35")
pa <- ggplot(krzywe, aes(r, zmiana_SD, colour = odsetek_et, linetype = odsetek_et)) +
  geom_line(linewidth = 1) +
  geom_point(data = sym, aes(shape = odsetek_et), size = 2.8) +
  scale_colour_manual(values = odcienie, name = "Wybór w pomiarze 1:") +
  scale_linetype_manual(values = linie, name = "Wybór w pomiarze 1:") +
  scale_shape_manual(values = ksztalty, name = "Wybór w pomiarze 1:") +
  scale_x_continuous(breaks = seq(0.3, 0.9, 0.2), labels = function(x) bz(x, 1)) +
  labs(x = "Korelacja test–retest r", y = "Pozorna poprawa (w SD pomiaru)",
       title = "A. Pozorna poprawa wybranych", subtitle = "Linie: wzór; punkty: symulacja (50 000 osób)") +
  motyw + guides(colour = guide_legend(ncol = 2))
pb <- ggplot(krzywe[krzywe$odsetek == 0.10, ], aes(r, 1 - zostaje)) +
  geom_area(fill = kol[["niebieski"]], alpha = 0.15) +
  geom_line(colour = kol[["niebieski"]], linewidth = 1) +
  geom_point(data = sym, aes(r, 1 - zostaje, colour = odsetek_et, shape = odsetek_et), size = 2.8,
             position = position_dodge(width = 0.04)) +
  scale_colour_manual(values = odcienie, guide = "none") +
  scale_shape_manual(values = ksztalty, guide = "none") +
  scale_x_continuous(breaks = seq(0.3, 0.9, 0.2), labels = function(x) bz(x, 1)) +
  scale_y_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 0.75)) +
  labs(x = "Korelacja test–retest r", y = "Jaka część odległości od średniej znika",
       title = "B. Znika (1 − r) dystansu", subtitle = "Ta sama linia dla każdego progu") +
  motyw
p4 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("regresja-do-sredniej-a-korelacja.svg", p4, width = 9, height = 5.6)
Wynik w R
   r odsetek zmiana_SD_sym zostaje zmiana_SD_wzor
 0.5    0.05         1.063   0.484          1.031
 0.5    0.10         0.881   0.498          0.877
 0.5    0.25         0.633   0.502          0.636
 0.5    0.50         0.398   0.502          0.399
 0.7    0.05         0.627   0.694          0.619
 0.7    0.10         0.537   0.692          0.526
 0.7    0.25         0.383   0.695          0.381
 0.7    0.50         0.239   0.695          0.239
 0.9    0.05         0.213   0.897          0.206
 0.9    0.10         0.177   0.899          0.175
 0.9    0.25         0.123   0.903          0.127
 0.9    0.50         0.078   0.902          0.080
       SD_pomiaru  zmiana_SD_10proc zmiana_pkt_10proc
            10.30              0.41              4.26
5. 1000 badań kursu bez efektu: Rysunek 5
R
# Rysunek 5. 1000 badań „kursu wyrównawczego” bez żadnego efektu – cztery sposoby analizy
# Wymaga obiektów z przepisu 1: kol, motyw, bz(); populacja jak w przepisie 1 (60 ± 9, błąd 5)
library(ggplot2)
library(patchwork)
mu <- 60; sd_T <- 9; sd_E <- 5
jedno_badanie <- function() {
  T <- rnorm(200, mu, sd_T)                      # 200 osób z rocznika pisze test diagnostyczny
  P1 <- T + rnorm(200, 0, sd_E); P2 <- T + rnorm(200, 0, sd_E)   # kurs NIE działa: P2 bez zmiany
  wyb <- which(rank(P1, ties.method = "first") <= 40)            # 20% najsłabszych → kwalifikacja
  zm <- P2 - P1
  # (1) tylko wybrani, przed–po
  t1 <- t.test(P2[wyb], P1[wyb], paired = TRUE)
  # (2) kontrola z innym kryterium: 40 losowych osób spośród niezakwalifikowanych
  kon <- sample(setdiff(1:200, wyb), 40)
  t2 <- t.test(zm[wyb], zm[kon])
  # (3) i (4) losowy przydział wśród zakwalifikowanych: 20 na kurs, 20 do kontroli
  kurs <- sample(wyb, 20); kontr <- setdiff(wyb, kurs)
  t3 <- t.test(zm[kurs], zm[kontr])
  d <- data.frame(P1 = P1[c(kurs, kontr)], P2 = P2[c(kurs, kontr)], kurs = rep(1:0, each = 20))
  a4 <- summary(lm(P2 ~ kurs + P1, data = d))$coefficients["kurs", ]
  c(est1 = mean(zm[wyb]), p1 = t1$p.value, est2 = mean(zm[wyb]) - mean(zm[kon]), p2 = t2$p.value,
    est3 = mean(zm[kurs]) - mean(zm[kontr]), p3 = t3$p.value, est4 = a4[["Estimate"]], p4 = a4[["Pr(>|t|)"]])
}
set.seed(590)
B <- 1000
wyn <- t(replicate(B, jedno_badanie()))
nazwy <- c("1. Przed–po, bez kontroli", "2. Kontrola z innym kryterium", "3. Losowa kontrola: różnica zmian",
           "4. Losowa kontrola: ANCOVA")
pods <- data.frame(analiza = nazwy, sredni_efekt = colMeans(wyn[, c(1, 3, 5, 7)]),
                   SD_efektu = apply(wyn[, c(1, 3, 5, 7)], 2, sd),
                   odsetek_p_ponizej_05 = colMeans(wyn[, c(2, 4, 6, 8)] < .05))
pods$blad_MC <- sqrt(pods$odsetek_p_ponizej_05 * (1 - pods$odsetek_p_ponizej_05) / B)   # błąd Monte Carlo odsetka
print(transform(pods, sredni_efekt = round(sredni_efekt, 2), SD_efektu = round(SD_efektu, 2),
                odsetek_p_ponizej_05 = round(odsetek_p_ponizej_05, 3), blad_MC = round(blad_MC, 3)), row.names = FALSE)

oszac <- data.frame(analiza = factor(rep(nazwy, each = B), nazwy), efekt = c(wyn[, c(1, 3, 5, 7)]))
oszac$kontrola <- ifelse(oszac$analiza %in% nazwy[1:2], "bez właściwej kontroli", "losowa kontrola z wybranych")
pods$analiza <- factor(pods$analiza, nazwy)
pods$kontrola <- ifelse(pods$analiza %in% nazwy[1:2], "bez właściwej kontroli", "losowa kontrola z wybranych")
kol_k <- c("bez właściwej kontroli" = kol[["cynober"]], "losowa kontrola z wybranych" = kol[["niebieski"]])
pa <- ggplot(oszac, aes(efekt, fill = kontrola)) +
  geom_histogram(binwidth = 0.5, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 0, colour = "grey20", linetype = "dashed") +
  geom_vline(data = pods, aes(xintercept = sredni_efekt), colour = "black", linewidth = 0.8) +
  facet_wrap(~ analiza, ncol = 1) +
  scale_fill_manual(values = kol_k, name = NULL) +
  labs(x = "Oszacowany „efekt kursu” (pkt); prawdziwy = 0", y = "Liczba badań",
       title = "A. Oszacowania w 1000 badań", subtitle = "Linia przerywana: prawdziwy efekt 0\nciągła: średnia z 1000 badań") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.8)))
pb <- ggplot(pods, aes(odsetek_p_ponizej_05, analiza, colour = kontrola, shape = kontrola)) +
  geom_vline(xintercept = 0.05, colour = "grey20", linetype = "dashed") +
  geom_errorbar(aes(xmin = odsetek_p_ponizej_05 - 2 * blad_MC, xmax = odsetek_p_ponizej_05 + 2 * blad_MC),
                width = 0.2, linewidth = 0.8, orientation = "y") +
  geom_point(size = 3.5) +
  geom_text(aes(label = paste0(round(100 * odsetek_p_ponizej_05, 1), "%")), nudge_y = 0.32, size = 3.9,
            show.legend = FALSE) +
  scale_colour_manual(values = kol_k, guide = "none") +
  scale_shape_manual(values = c("bez właściwej kontroli" = 17, "losowa kontrola z wybranych" = 16), guide = "none") +
  scale_y_discrete(limits = rev(nazwy), labels = c("4. ANCOVA", "3. różnica zmian", "2. inne kryterium", "1. bez kontroli")) +
  scale_x_continuous(labels = function(x) paste0(round(100 * x), "%"), limits = c(0, 1)) +
  labs(x = "Odsetek badań z p < .05", y = NULL, title = "B. „Istotny efekt” kursu",
       subtitle = "Linia przerywana: 5%\nwąsy: ± 2 błędy Monte Carlo") +
  motyw
p5 <- pa + pb + plot_layout(widths = c(1, 1), guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("regresja-do-sredniej-1000-badan.svg", p5, width = 9, height = 7)
Wynik w R
                           analiza sredni_efekt SD_efektu odsetek_p_ponizej_05
         1. Przed–po, bez kontroli         3.38      1.12                0.850
     2. Kontrola z innym kryterium         4.25      1.58                0.774
 3. Losowa kontrola: różnica zmian         0.00      2.10                0.054
        4. Losowa kontrola: ANCOVA         0.00      2.07                0.051
 blad_MC
   0.011
   0.013
   0.007
   0.007
6. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (bliżej / dalej; z kontrolą / bez)" = c("#0072B2", "#D55E00"),
             "cynober – szary (wybrani / pozostali)" = c("#D55E00", "#999999"),
             "cynober – pomarańczowy (5% / 10%)" = c("#D55E00", "#E69F00"),
             "pomarańczowy – niebieski (10% / 25%)" = c("#E69F00", "#0072B2"),
             "niebieski – ciemnoszary (25% / 50%)" = c("#0072B2", "#595959"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                       widzenie_typowe
niebieski – cynober (bliżej / dalej; z kontrolą / bez)           114.6
cynober – szary (wybrani / pozostali)                             77.2
cynober – pomarańczowy (5% / 10%)                                 33.4
pomarańczowy – niebieski (10% / 25%)                             120.2
niebieski – ciemnoszary (25% / 50%)                               42.2
czerwony – zielony (do unikania)                                 121.7
                                                       deuteranopia protanopia
niebieski – cynober (bliżej / dalej; z kontrolą / bez)        108.3       91.9
cynober – szary (wybrani / pozostali)                          62.9       56.0
cynober – pomarańczowy (5% / 10%)                              18.4       24.9
pomarańczowy – niebieski (10% / 25%)                          121.5      109.3
niebieski – ciemnoszary (25% / 50%)                            45.3       39.9
czerwony – zielony (do unikania)                               21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania, testy t i modele liniowe – pakiet stats. Rysunki wykonano w pakiecie ggplot2 (warstwice gęstości liczy funkcja kde2d() pakietu MASS), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Istotny test przed–po w grupie wybranej za skrajny wynik jako dowód skuteczności. Bez żadnej interwencji p < .05 wyszło w 85% badań (rysunek 5).
- Grupa kontrolna z innej części rozkładu. Pogłębia obciążenie zamiast je usuwać (rysunek 5, analiza 2).
- „Najbardziej skorzystali najsłabsi”. Skrajne grupy przesuwają się do średniej same z siebie, w obie strony (rysunek 2).
- Myślenie, że regresja do średniej dotyczy każdej osoby. To prawidłowość średnich – część osób oddala się od średniej jeszcze bardziej (rysunek 2).
- Szukanie przyczyny w czasie. Zjawisko działa także wstecz, od drugiego pomiaru do pierwszego (rysunek 3).
Najczęstsze pytania
Dlaczego najsłabsi w pierwszym pomiarze poprawiają się bez żadnych zajęć?
Bo wynik w teście to wynik prawdziwy plus błąd pomiaru. Próg „najniższe 10%” wybiera osoby, które są naprawdę słabsze, ale też takie, którym akurat poszło gorzej niż zwykle. W naszej symulacji średni błąd wybranych wynosił −4.02 punktu w pierwszym pomiarze i −0.37 w drugim, więc ich średnia wzrosła z 41.13 do 44.78 punktu, choć nikt niczego się nie nauczył.
Czy regresja do średniej oznacza, że każdy skrajny wynik się zmniejszy?
Nie. To prawidłowość dotycząca średniej grupy. Wśród 60 najsłabszych osób w przykładzie 41 zbliżyło się do średniej populacji, ale 18 oddaliło się od niej jeszcze bardziej. Rozrzut wyników w drugim pomiarze też się nie zmniejsza – grupa nie „wyrównuje się” z czasem.
Od czego zależy, jak duża będzie pozorna poprawa?
Od korelacji test–retest i od tego, jak skrajną grupę wybierasz. W drugim pomiarze znika średnio część 1 − r odległości wybranej grupy od średniej. Przy wyborze najsłabszych 10% pozorna poprawa wynosi około 0.88 SD przy r = .5, 0.53 SD przy .7 i 0.18 SD przy .9.
Czy grupa kontrolna ze średnimi wynikami chroni przed regresją do średniej?
Nie. Grupa kontrolna musi być wybrana tym samym kryterium co grupa badana. W 1000 symulowanych badaniach kursu bez żadnego efektu kontrola z losowych osób spoza kwalifikacji dała średnio 4.25 punktu „efektu” i 77.4% wyników istotnych. Losowy przydział zakwalifikowanych do kursu i kontroli dał średnio 0.00 punktu i 5.1–5.4% wyników istotnych.
Jak opisać regresję do średniej w ograniczeniach pracy bez grupy kontrolnej?
Napisz, że osoby kwalifikowano na podstawie skrajnego wyniku, podaj rzetelność test–retest i oczekiwaną wielkość zjawiska, a zmiany nie interpretuj jako efektu programu. Gotowe zdanie do ograniczeń znajdziesz na końcu części „Co zrobić w praktyce”.
Powiązane hasła
Przeczytaj też
Regresja do średniej w badaniu przed–po
Dlaczego osoby zakwalifikowane za wysoki wynik „poprawiają się” bez leczenia, ile wynosi ten efekt i jak go usunąć grupą kontrolną, ANCOVA i osobnym pomiarem wyjściowym.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikPróby zależne w obrazkach
Te same 30 par dwoma testami, rozkład różnic, korelacja pomiarów od −.5 do .8, moc z symulacji i regresja do średniej – pięć rysunków z kodem R.
Czytaj →PoradnikRzetelność i błąd pomiaru – wizualizacja
Wynik prawdziwy i błąd przy rzetelności .9/.7/.5, atenuacja w 1000 badań, alfa a liczba pozycji, nachylenie regresji i SEM – pięć rysunków z R.
Czytaj →PoradnikANCOVA – wizualizacja na obrazkach
Równoległe proste i średnie skorygowane, precyzja w 1000 badaniach, złamane nachylenia i pozorny efekt w grupach nielosowych – pięć rysunków z kodem R.
Czytaj →PoradnikKampania miesiąca i regresja do średniej
Sieć szkół jazdy i 60 kampanii: wykres lejkowy, spadek zwycięzcy w następnym miesiącu, ściąganie w modelu mieszanym i symulacja – z kodem R.
Czytaj →Kwalifikujesz osoby do badania po skrajnym wyniku?
Pomożemy zaplanować grupę kontrolną i pomiar wyjściowy, policzyć ANCOVA i opisać regresję do średniej w Metodzie lub ograniczeniach – tak, żebyś umiał(a) to uzasadnić promotorowi i recenzentowi.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bland, J. M., & Altman, D. G. (1994). Statistics notes: Some examples of regression towards the mean. BMJ, 309(6957), 780. https://doi.org/10.1136/bmj.309.6957.780 ● Otwarty dostęp
- Clifton, L., & Clifton, D. A. (2019). The correlation between baseline score and post-intervention score, and its implications for statistical analysis. Trials, 20(1), Article 43. https://doi.org/10.1186/s13063-018-3108-3 ● Otwarty dostęp
- Davis, C. E. (1976). The effect of regression to the mean in epidemiologic and clinical studies. American Journal of Epidemiology, 104(5), 493–498. https://doi.org/10.1093/oxfordjournals.aje.a112321
- Kahneman, D., & Tversky, A. (1973). On the psychology of prediction. Psychological Review, 80(4), 237–251. https://doi.org/10.1037/h0034747
- Smith, G., & Smith, J. (2005). Regression to the mean in average test scores. Educational Assessment, 10(4), 377–399. https://doi.org/10.1207/s15326977ea1004_4
- Stigler, S. M. (1997). Regression towards the mean, historically considered. Statistical Methods in Medical Research, 6(2), 103–114. https://doi.org/10.1177/096228029700600202
Cytowania BibTeX
@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bland1994some, author={Bland, J. Martin and Altman, Douglas G.}, title={{Statistics notes: Some examples of regression towards the mean}}, journal={BMJ}, year={1994}, volume={309}, number={6957}, pages={780}, doi={10.1136/bmj.309.6957.780}}@article{clifton2019correlation, author={Clifton, Lei and Clifton, David A.}, title={{The correlation between baseline score and post-intervention score, and its implications for statistical analysis}}, journal={Trials}, year={2019}, volume={20}, number={1}, eid={43}, doi={10.1186/s13063-018-3108-3}}@article{davis1976effect, author={Davis, Clarence E.}, title={{The effect of regression to the mean in epidemiologic and clinical studies}}, journal={American Journal of Epidemiology}, year={1976}, volume={104}, number={5}, pages={493--498}, doi={10.1093/oxfordjournals.aje.a112321}}@article{kahneman1973psychology, author={Kahneman, Daniel and Tversky, Amos}, title={{On the psychology of prediction}}, journal={Psychological Review}, year={1973}, volume={80}, number={4}, pages={237--251}, doi={10.1037/h0034747}}@article{smith2005regression, author={Smith, Gary and Smith, Joanna}, title={{Regression to the mean in average test scores}}, journal={Educational Assessment}, year={2005}, volume={10}, number={4}, pages={377--399}, doi={10.1207/s15326977ea1004_4}}@article{stigler1997regression, author={Stigler, Stephen M.}, title={{Regression towards the mean, historically considered}}, journal={Statistical Methods in Medical Research}, year={1997}, volume={6}, number={2}, pages={103--114}, doi={10.1177/096228029700600202}}