Dwa losowania, dwa różne pytania
Losowanie pojawia się w eksperymencie w dwóch miejscach i każde chroni co innego. Losowanie próby z populacji decyduje, kogo badasz, i wspiera trafność zewnętrzną (zob. schematy losowania w obrazkach). Losowy przydział do grup, czyli randomizacja, decyduje, kto dostaje który warunek, i chroni trafność wewnętrzną. Listy przydziałów w R zawiera wpis randomizacja w praktyce; tu pokazujemy na rysunkach, co każde losowanie robi z wynikiem.
Przykład jest fikcyjny. Uczelnia ma 2000 studentów na 8 wydziałach (po 250 osób). Sprawdzamy, czy materiał powtórkowy online podnosi wynik egzaminu (0–100 punktów). Dane są symulowane, więc znamy wynik każdego studenta z materiałem i bez niego, a zatem prawdziwy efekt: średnio 5.00 punktu. Parametry ustawiono ręcznie tak, by zjawiska były wyraźne. Efekt różni się między wydziałami (od 2 do 8 punktów; na Zarządzaniu 8). Niemierzona motywacja podnosi zarówno wynik wyjściowy z poprzedniego egzaminu (r = .47), jak i wynik egzaminu. Wiek z wynikiem prawie nie koreluje (r = −.04). Ziarno 588 ustalono raz i nie zmieniano go. Dane pobierzesz jako losowy-przydzial-populacja.csv.
Rysunek 1: dwa losowania na jednej mapie
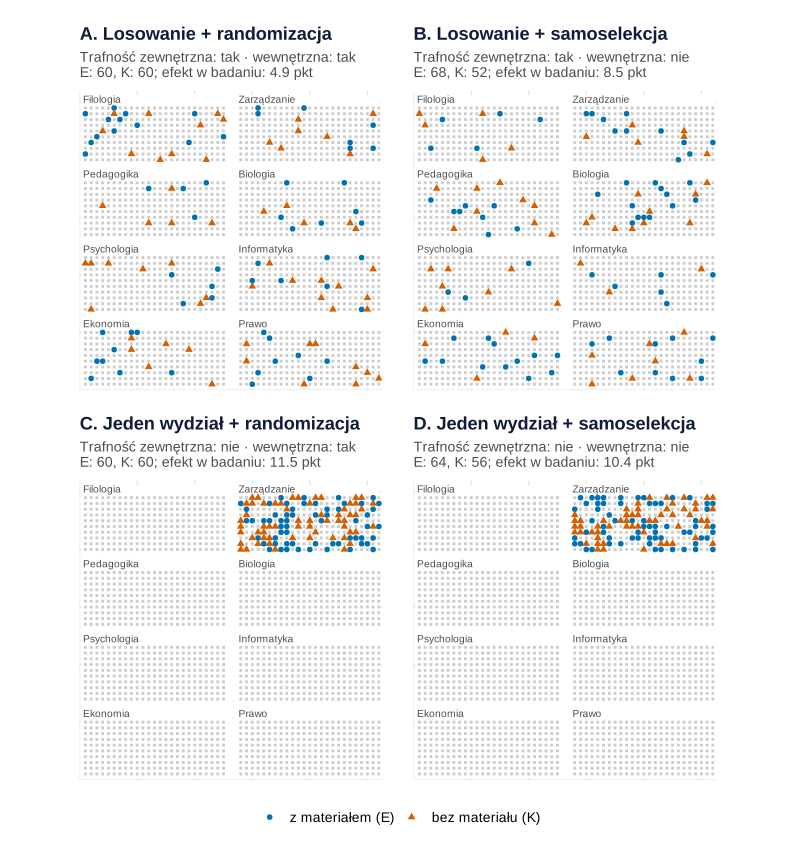
set.seed(588)).Co widać. Szara kratka to student, pełny znak – osoba w badaniu, kolor i kształt – grupa. W A i B próba jest rozsiana po uczelni, w C i D skupiona na jednym wydziale, jak próba wygodna. W A i C przydział losowano z listy 60:60. W B i D materiał wybierali sami studenci: w B sięgnęło po niego 68 osób o motywacji średnio o 0.90 SD wyższej niż pozostali (w A różnica wyniosła 0.29 SD – przypadek). Oszacowany efekt: 4.9 punktu w A, 8.5 w B, 11.5 w C i 10.4 w D.
Czego ten wykres nie pokazuje. Każdy panel to jedno losowanie; ile w wyniku 11.5 jest obciążenia, a ile szumu, pokazuje rysunek 2. Mapa nie pokazuje motywacji, bo badacz jej nie mierzy – dlatego samoselekcja jest groźna.
Podpis do pracy (np. w aneksie metodologicznym):
Zdanie do Metody:
Rysunek 2: 1000 badań w każdej komórce
Każdy wariant powtórzyliśmy 1000 razy z nową próbą i nowym przydziałem. Przesunięcie środka histogramu względem prawdziwej wartości to obciążenie, szerokość – precyzja.
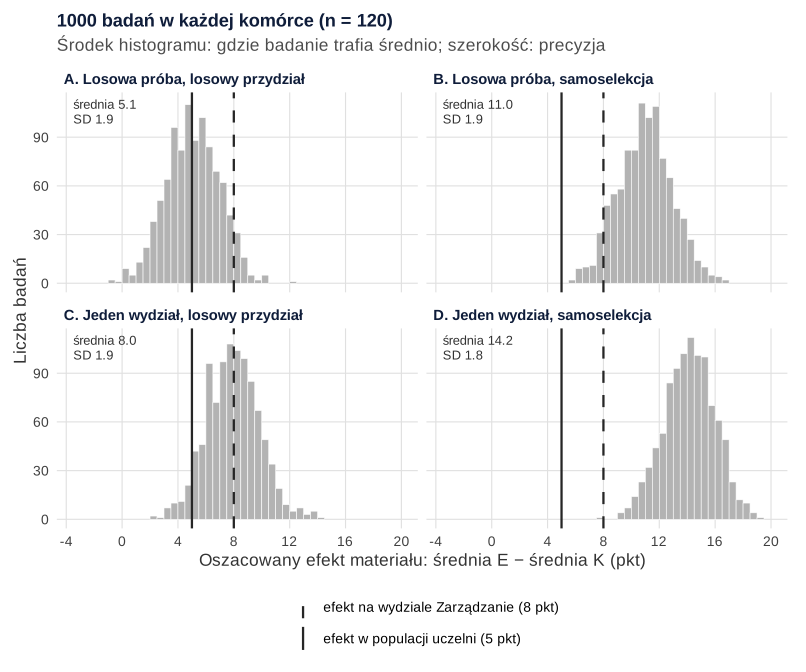
set.seed(588)).Co widać. W panelu A średnie oszacowanie to 5.07 przy prawdziwym efekcie 5.00 (błąd Monte Carlo średniej 0.06), a SD oszacowań to 1.91. W panelu C średnio wyszło 7.96, czyli prawdziwy efekt na Zarządzaniu (8), a nie na uczelni: randomizacja zadziałała, ale dla tych osób. W panelu B próba była losowa, a mimo to wyszło 10.98 – obciążenie 5.98 punktu. W panelu D oba problemy się sumują (14.15). Szerokość jest podobna we wszystkich panelach (SD 1.82–1.94). Większa próba zwęziłaby histogramy, ale ich nie przesunie.
Czego ten wykres nie pokazuje. Panel C wypada źle tylko dlatego, że efekt różni się między wydziałami – a zwykle nie wiesz, czy tak jest. Próby w badaniach z randomizacją bywają silnie wyselekcjonowane. W przeglądzie Kennedy-Martin i in. (2015) 71.2% włączonych badań wprost stwierdziło, że uczestnicy badań klinicznych nie byli szeroko reprezentatywni dla pacjentów z codziennej praktyki. Co wolno wnioskować z próby dostępnej, omawia wpis dobór próby w pracy dyplomowej, a próbę wygodną na podobnej mapie pokazuje wpis dobór nielosowy w obrazkach.
Podpis do pracy:
Zdanie do Dyskusji:
Rysunek 3: randomizacja prosta i blokowa przy 20 osobach
Eksperyment w pracy dyplomowej ma często kilkadziesiąt osób. Dla 20 osób 10 000 razy wylosowaliśmy listę przydziału trzema sposobami: randomizacją prostą (rzut monetą dla każdej osoby), blokami po 4 i blokami po 4 lub 6 osób o losowej długości. Gotową listę przygotujesz w generatorze listy randomizacji.
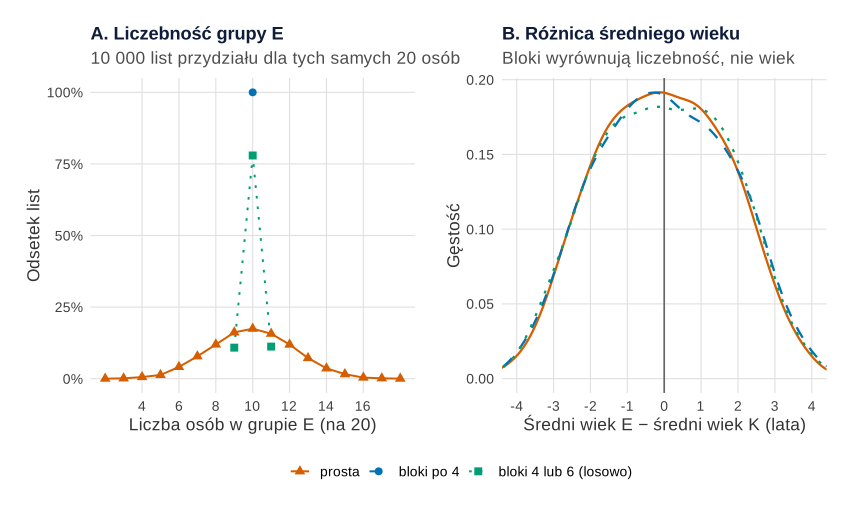
set.seed(588)).Co widać. Panel A: przy randomizacji prostej równy podział 10:10 wypadł tylko w 17.4% list, a podział 7:13 lub bardziej nierówny – w 26.8% (skrajnie 2:18). Bloki po 4 zawsze dały 10:10. Bloki losowej długości – 10:10 w 77.9% list, a w pozostałych 9:11 (niedokończony ostatni blok). Panel B: różnica średniego wieku grup ma przy wszystkich metodach prawie ten sam rozkład. SD wynosi 1.76, 1.80 i 1.79 roku, a różnica większa niż 2 lata zdarza się w 27–28% list. Bloki pilnują liczebności, a nie cech osób. Błąd Monte Carlo odsetków nie przekracza 0.5 punktu procentowego.
Czego ten wykres nie pokazuje. Nierówne cechy przy małym n to cena małej próby, nie błąd randomizacji: SD różnicy średniego wieku wyniosło 1.77 roku przy 20 osobach, 0.84 przy 40, 0.43 przy 100 i 0.22 przy 400. Schulz i Grimes (2002) przypominają, że żadna metoda nie chroni przed stronniczością lepiej niż randomizacja prosta, a nierówne liczebności trzeba akceptować. Jeśli używasz bloków, zalecają losować ich długość, bo stałe bloki da się odgadnąć.
Podpis do pracy (np. w aneksie metodologicznym):
Zdanie do Metody:
Rysunek 4: randomizacja warstwowa – równowaga i precyzja
Gdy znasz zmienną silnie związaną z wynikiem – tu wynik wyjściowy – możesz losować osobno w warstwach (randomizacja warstwowa). Czterdzieści osób podzieliliśmy na 4 warstwy (płeć × poziom wyjściowy poniżej mediany lub nie, po 8–11 osób) i w każdej losowaliśmy bloki po 4; 10 000 losowań. Prawdziwy efekt w tej grupie to 4.85 punktu.
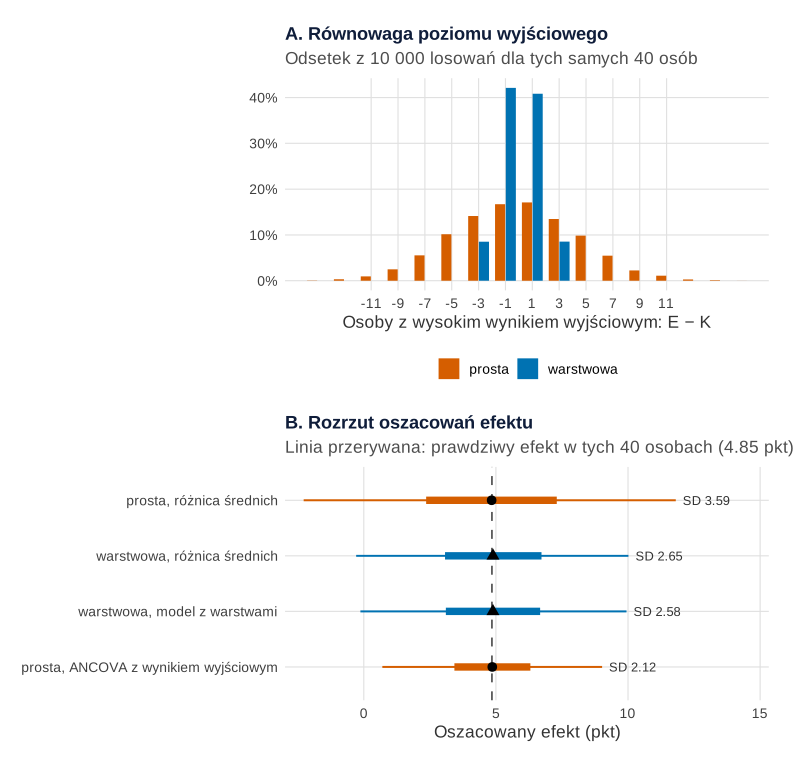
set.seed(588)).Co widać. Panel A: przy randomizacji prostej grupy różniły się liczbą osób z wysokim wynikiem wyjściowym o co najmniej 5 w 38.6% losowań. Przy warstwowej – ani razu (najwyżej 3). Panel B: wszystkie warianty trafiają średnio w prawdziwy efekt (4.84–4.89), ale różnią się rozrzutem. Przy randomizacji prostej i różnicy średnich SD oszacowań wynosi 3.59. Przy warstwowej spada do 2.65, a po dodaniu warstw do modelu – do 2.58. Najwęższy rozrzut daje ANCOVA z ciągłym wynikiem wyjściowym: 2.12 przy randomizacji prostej i 2.035 przy warstwowej.
Czego ten wykres nie pokazuje. Program pokaże co innego: test t po randomizacji warstwowej podawał średnio błąd standardowy 3.54, choć prawdziwy rozrzut wynosił 2.65 – za szerokie przedziały i mniejsza moc. Kahan i Morris (2012) pokazali to w symulacjach i zalecają uwzględnić zmienne warstwujące w analizie. Według przeglądu Kernana i in. (1999) warstwowanie opłaca się głównie w małych badaniach (poniżej 400 osób) i tylko przy czynnikach silnie związanych z wynikiem. Przy wielu warstwach rozważ minimalizację przydziału.
Podpis do pracy:
Zdanie do Metody:
Randomizacja klastrowa: gdy losujesz całe grupy
Gdy studenci w grupie ćwiczeniowej i tak dzieliliby się materiałem, losuje się całe grupy – na mapie z rysunku 1 trafiałyby do eksperymentu całe fragmenty prostokątów. Jednostek losowania jest mało, a osoby w jednej grupie są do siebie podobne, więc efektywna liczebność jest mniejsza niż liczba osób (efekt schematu). Plan, ICC i analizę takiego badania omawia wpis randomizacja klastrowa.
Rysunek 5: co się dzieje bez randomizacji
Wracamy do panelu B z rysunku 1: losowa próba 120 osób, ale materiał wybierali sami studenci. Im wyższa motywacja, tym częściej po niego sięgali (siłę tej zależności ustawiono ręcznie).
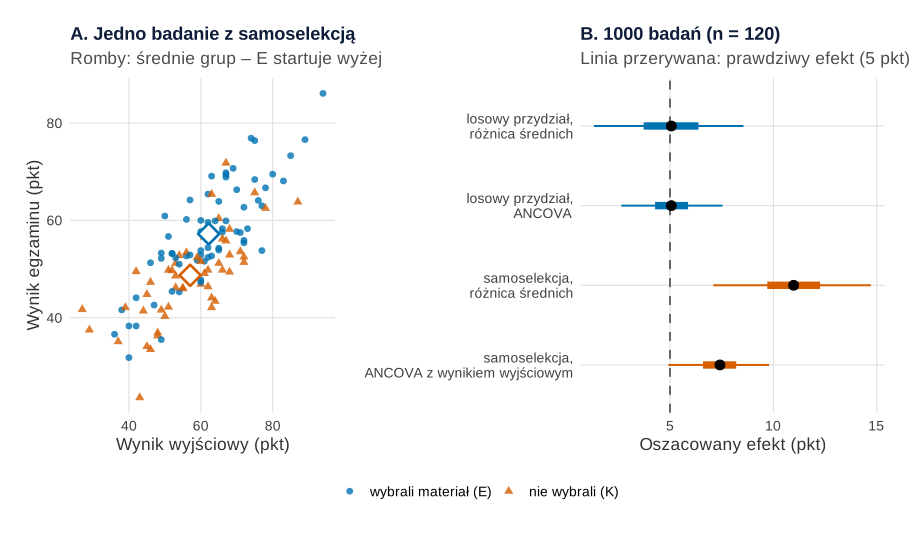
Co widać. Panel A: grupa, która wybrała materiał, startowała wyżej: wynik wyjściowy 62.19 wobec 57.04 punktu, motywacja 0.34 wobec −0.55 SD. Różnica średnich (8.51 punktu) miesza efekt materiału z tym, kim byli wybierający. Panel B: w 1000 takich badań różnica średnich daje średnio 10.98 zamiast 5, czyli obciążenie 5.98 punktu. ANCOVA z wynikiem wyjściowym zmniejsza obciążenie do 2.42 punktu (średnio 7.42), ale go nie usuwa, bo wynik wyjściowy tylko częściowo odzwierciedla motywację. Przy losowym przydziale obie analizy trafiają w prawdziwą wartość (5.07 i 5.06), a ANCOVA jest dokładniejsza (SD 1.24 zamiast 1.91).
Czego ten wykres nie pokazuje. W pokazanym badaniu korekta trafiła prawie idealnie (5.21 przy prawdziwym 5.01) – stałe przesunięcie widać dopiero w 1000 powtórzeń. Shadish i in. (2008) losowo skierowali uczestników do eksperymentu z randomizacją albo do takiego, w którym sami wybierali trening. Korekty statystyczne zmniejszały obciążenie, ale ich skuteczność zależała od tego, czy zmierzono zmienne związane z wyborem. Gdy losować nie możesz, zaplanuj schemat quasi-eksperymentalny i zmierz przed badaniem to, co może wpływać na wybór.
Podpis do pracy:
Zdanie do Ograniczeń:
Rysunek 6: test różnic wyjściowych – dlaczego nie p
Częsty odruch po randomizacji: „grupy nie różniły się wiekiem, p = .41”. Symulacja: 10 000 eksperymentów po 40 osób (przydział 20:20), w każdym test t dla wyniku wyjściowego i wieku oraz błąd oszacowania efektu.
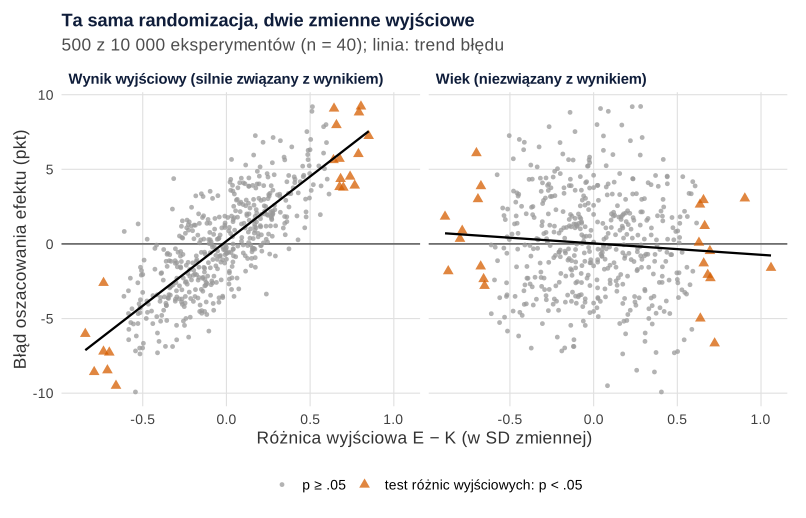
set.seed(588)).Co widać. „Istotną” różnicę wyjściową dało 5.0% eksperymentów, zarówno dla wyniku wyjściowego, jak i dla wieku (błąd Monte Carlo 0.2 punktu procentowego). Tyle zakłada poziom .05 przy losowym przydziale, więc test nie mówi, czy losowanie się udało. Przy wyniku wyjściowym błąd oszacowania efektu rośnie razem z różnicą wyjściową (r = .78), przy wieku praktycznie nie (r = −.07). W eksperymentach, w których test dla wyniku wyjściowego dał p ≥ .05, SD błędu wynosiło wciąż 3.18 punktu (przy p < .05 – 6.38). ANCOVA z wynikiem wyjściowym zmniejszyła SD błędu z 3.41 do 2.14 – niezależnie od wyniku testu.
Czego ten wykres nie pokazuje. Na rysunku jest 500 z 10 000 eksperymentów. Liczy się związek zmiennej z wynikiem, nie istotność różnicy. Senn (1994) uważa testy jednorodności wyjściowej za filozoficznie nieuzasadnione i bezużyteczne w praktyce. Zaleca wskazać zmienne prognostyczne w planie badania i uwzględnić je w analizie kowariancji niezależnie od ich rozkładu wyjściowego. De Boer i in. (2015) dodają, że dobór kowariantów na podstawie takich testów może pominąć ważne zmienne. W tabeli cech wyjściowych podaj więc średnie i SD w grupach, bez wartości p.
Podpis do pracy (np. na obronę):
Zdanie do Metody:
Co z tego wziąć do pracy dyplomowej
- Zwykle masz panel C: próbę dostępną i losowy przydział. To uczciwa sytuacja – wniosek przyczynowy dotyczy badanych, a uogólnienie opisujesz ostrożnie.
- Do Metody opisz oba losowania osobno: jak dobrano osoby, jak losowano przydział (prosta, bloki, warstwy), kto wygenerował listę i kto ją znał (ukrycie przydziału). Gotowy podrozdział znajdziesz we wpisie eksperyment z losowym przydziałem – jak opisać metodę, a wersję ankietową – we wpisie jak opisać eksperyment ankietowy.
- Do Wyników: tabela cech wyjściowych bez p i efekt z ANCOVA z kowariantami zaplanowanymi przed badaniem (rysunki 4 i 6). Skoro przydział był losowy, efekt możesz też ocenić wnioskowaniem randomizacyjnym.
- Na obronę: rysunek 2 tłumaczy różnicę między trafnością wewnętrzną a zewnętrzną. Zasady rysunków w pracy – wpis wykresy w pracy dyplomowej.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy populację, paletę, motyw i funkcję badanie(), z których korzystają następne. Każdy przepis kończy się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy przepis, który losuje (1, 2, 3, 4 i 6), zaczyna się od własnego set.seed(588), więc uruchomiony po przepisie 1 da te same liczby co na stronie; przepis 5 korzysta z wyników przepisów 1 i 2 i niczego nie losuje. Ziarno 588 ustalono raz i nie zmieniano go. Ręcznie ustalono: populację 2000 osób na 8 wydziałach, efekty wydziałów 2–8 punktów, wpływ motywacji na wynik wyjściowy i egzamin, siłę samoselekcji (1.2 w skali logitu), liczebności 120, 20 i 40 osób, warstwy (płeć × mediana wyniku wyjściowego), bloki 4 i 4/6 oraz liczby powtórzeń (1000 i 10 000). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się kilkanaście sekund.
1. Populacja, cztery badania i mapa: Rysunek 1
R
# Rysunek 1. Losowanie próby a losowy przydział: cztery badania na mapie fikcyjnej uczelni
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (niebieski i cynober rozróżnialne także przy deuteranopii) i prosty motyw
kol <- c(E = "#0072B2", K = "#D55E00", zielony = "#009E73", fiolet = "#CC79A7", czarny = "grey15")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
bz <- function(x, d = 2) sub("^(-?)0\\.", "\\1.", sprintf(paste0("%.", d, "f"), x))   # .03 zamiast 0.03
p_apa <- function(p) ifelse(p < .001, "p < .001", paste("p =", bz(p, 3)))

# Fikcyjna uczelnia: 2000 studentów, 8 wydziałów po 250 osób. Każdy student to kratka na „mapie”
# (wydział = blok 25 × 10 kratek). Parametry ustalone ręcznie: efekt materiału powtórkowego różni się
# między wydziałami (2–8 pkt, średnio 5), motywacja (niemierzona) podnosi wynik wyjściowy i wynik egzaminu.
wydzialy <- c("Ekonomia", "Prawo", "Psychologia", "Informatyka", "Pedagogika", "Biologia", "Filologia", "Zarządzanie")
efekt_wydzialu <- c(2, 3, 4, 5, 5, 6, 7, 8)
N <- 2000
set.seed(588)                                    # ziarno ustalone raz, bez dobierania pod wynik
pop <- data.frame(id = 1:N, wydzial = factor(rep(wydzialy, each = 250), wydzialy))
blok <- as.integer(pop$wydzial) - 1
pop$x <- (blok %% 2) * 27 + rep(1:25, length.out = N)
pop$y <- (blok %/% 2) * 13 + rep(rep(1:10, each = 25), 8)
pop$kobieta <- rbinom(N, 1, 0.6)
pop$wiek <- round(19 + rgamma(N, shape = 2, scale = 1.6))
pop$motywacja <- rnorm(N)                                         # cecha, której badacz nie mierzy (skala z)
pop$wyjsciowy <- round(pmin(100, pmax(0, 60 + 12 * (0.5 * pop$motywacja + sqrt(0.75) * rnorm(N)))))
pop$y0 <- round(15 + 0.6 * pop$wyjsciowy + 3 * pop$motywacja + rnorm(N, 0, 6), 1)   # wynik egzaminu bez materiału
pop$y1 <- pop$y0 + efekt_wydzialu[as.integer(pop$wydzial)]                         # ten sam student z materiałem
write.csv(pop, "losowy-przydzial-populacja.csv", row.names = FALSE)
PATE <- mean(pop$y1 - pop$y0)                    # prawdziwy średni efekt w populacji – znany, bo dane są fikcyjne
round(c(PATE = PATE, efekt_Zarzadzanie = 8, M_wiek = mean(pop$wiek), M_wyjsciowy = mean(pop$wyjsciowy),
        r_motywacja_wyjsciowy = cor(pop$motywacja, pop$wyjsciowy), r_wyjsciowy_y0 = cor(pop$wyjsciowy, pop$y0),
        r_wiek_y0 = cor(pop$wiek, pop$y0)), 2)

# Jedno badanie: dobór próby (losowy z całej uczelni albo wygodny – jeden wydział) i przydział do grup
# (losowy 60:60 albo samoselekcja: im wyższa motywacja, tym częściej student sam wybiera materiał)
badanie <- function(dobor, przydzial, n = 120) {
  kandydaci <- if (dobor == "losowy") pop$id else pop$id[pop$wydzial == "Zarządzanie"]
  d <- pop[sample(kandydaci, n), ]
  d$E <- if (przydzial == "losowy") sample(rep(0:1, n / 2)) else rbinom(n, 1, plogis(1.2 * d$motywacja))
  d$wynik <- ifelse(d$E == 1, d$y1, d$y0)       # obserwujemy tylko jeden z dwóch potencjalnych wyników
  d
}
komorki <- expand.grid(przydzial = c("losowy", "samoselekcja"), dobor = c("losowy", "wygodny"),
                       stringsAsFactors = FALSE)
set.seed(588)
cztery <- lapply(seq_len(nrow(komorki)), function(i) badanie(komorki$dobor[i], komorki$przydzial[i]))
ef <- sapply(cztery, function(d) mean(d$wynik[d$E == 1]) - mean(d$wynik[d$E == 0]))
cbind(komorki, n_E = sapply(cztery, function(d) sum(d$E)), efekt_w_badaniu = round(ef, 2),
      M_motywacji_E_minus_K = round(sapply(cztery, function(d) mean(d$motywacja[d$E == 1]) - mean(d$motywacja[d$E == 0])), 2))

# Mapa: niewybrani – jasnoszare kratki (raster), wybrani – pełne punkty, kolor i kształt = grupa
siatka <- expand.grid(x = seq(0.5, 52, 0.5), y = seq(0.5, 51, 0.5))   # kratka studenta i biały odstęp wokół niej
siatka$fill <- ifelse(paste(siatka$x, siatka$y) %in% paste(pop$x, pop$y), "grey80", "white")
etyk_wydz <- data.frame(wydzial = wydzialy, x = (0:7 %% 2) * 27 + 0.6, y = (0:7 %/% 2) * 13 + 10.9)
tytuly <- c("A. Losowanie + randomizacja", "B. Losowanie + samoselekcja",
            "C. Jeden wydział + randomizacja", "D. Jeden wydział + samoselekcja")
trafnosc <- c("zewnętrzna: tak · wewnętrzna: tak", "zewnętrzna: tak · wewnętrzna: nie",
              "zewnętrzna: nie · wewnętrzna: tak", "zewnętrzna: nie · wewnętrzna: nie")
mapa <- function(i) {
  d <- cztery[[i]]; d$grupa <- factor(ifelse(d$E == 1, "z materiałem (E)", "bez materiału (K)"),
                                      c("z materiałem (E)", "bez materiału (K)"))
  ggplot() +
    geom_raster(data = siatka, aes(x, y, fill = fill), interpolate = FALSE) + scale_fill_identity() +
    geom_text(data = etyk_wydz, aes(x, y, label = wydzial), size = 2.7, colour = "grey30", hjust = 0, vjust = 0) +
    geom_point(data = d, aes(x, y, colour = grupa, shape = grupa), size = 1.6) +
    scale_colour_manual(values = c("z materiałem (E)" = kol[["E"]], "bez materiału (K)" = kol[["K"]]),
                        name = NULL, drop = FALSE) +
    scale_shape_manual(values = c("z materiałem (E)" = 16, "bez materiału (K)" = 17), name = NULL, drop = FALSE) +
    coord_equal(xlim = c(0, 52.5), ylim = c(0, 52), expand = FALSE) +
    labs(title = tytuly[i], subtitle = sprintf("Trafność %s\nE: %d, K: %d; efekt w badaniu: %.1f pkt",
                                               trafnosc[i], sum(d$E), sum(1 - d$E), ef[i]), x = NULL, y = NULL) +
    motyw + theme(axis.text = element_blank(), panel.grid = element_blank(),
                  plot.subtitle = element_text(size = rel(0.82)))
}
p1 <- (mapa(1) + mapa(2)) / (mapa(3) + mapa(4)) + plot_layout(guides = "collect") &
  theme(legend.position = "bottom")
p1   # zapis: ggsave("losowy-przydzial-mapa-2x2.svg", p1, width = 8.4, height = 9)
Wynik w R
                 PATE     efekt_Zarzadzanie                M_wiek
                 5.00                  8.00                 22.14
          M_wyjsciowy r_motywacja_wyjsciowy        r_wyjsciowy_y0
                60.12                  0.47                  0.78
            r_wiek_y0
                -0.04
     przydzial   dobor n_E efekt_w_badaniu M_motywacji_E_minus_K
1       losowy  losowy  60            4.86                  0.29
2 samoselekcja  losowy  68            8.51                  0.90
3       losowy wygodny  60           11.55                  0.31
4 samoselekcja wygodny  64           10.36                  0.94
2. 1000 badań w każdej komórce: Rysunek 2
R
# Rysunek 2. 1000 badań w każdej z czterech komórek: gdzie leżą oszacowania efektu
# (kontynuacja: pop, PATE, badanie(), komorki, kol, motyw z bloku 1)
library(ggplot2)

# Każde badanie: różnica średnich E − K oraz ANCOVA z wynikiem wyjściowym (motywacji badacz nie zna)
oszacuj <- function(d) {
  c(surowa = mean(d$wynik[d$E == 1]) - mean(d$wynik[d$E == 0]),
    ancova = unname(coef(lm(wynik ~ E + wyjsciowy, data = d))["E"]),
    SATE = mean(d$y1 - d$y0))                     # prawdziwy efekt w tej konkretnej próbie
}
R <- 1000
set.seed(588)
sym <- do.call(rbind, lapply(seq_len(nrow(komorki)), function(i) {
  w <- t(replicate(R, oszacuj(badanie(komorki$dobor[i], komorki$przydzial[i]))))
  data.frame(dobor = komorki$dobor[i], przydzial = komorki$przydzial[i], w)
}))
podsum <- aggregate(cbind(surowa, ancova, SATE) ~ dobor + przydzial, data = sym,
                    FUN = function(x) round(mean(x), 2))
podsum$SD_surowej <- aggregate(surowa ~ dobor + przydzial, data = sym, FUN = sd)$surowa
podsum$obciazenie_wzgl_PATE <- podsum$surowa - PATE
podsum$blad_MC_sredniej <- podsum$SD_surowej / sqrt(R)
print(cbind(podsum[1:2], round(podsum[-(1:2)], 2)), row.names = FALSE)

etyk <- c("losowy.losowy" = "A. Losowa próba, losowy przydział", "losowy.samoselekcja" = "B. Losowa próba, samoselekcja",
          "wygodny.losowy" = "C. Jeden wydział, losowy przydział", "wygodny.samoselekcja" = "D. Jeden wydział, samoselekcja")
sym$panel <- factor(etyk[paste(sym$dobor, sym$przydzial, sep = ".")], etyk)
podsum$panel <- factor(etyk[paste(podsum$dobor, podsum$przydzial, sep = ".")], etyk)
linie <- data.frame(wartosc = c(PATE, 8), co = c("efekt w populacji uczelni (5 pkt)", "efekt na wydziale Zarządzanie (8 pkt)"))
p2 <- ggplot(sym, aes(surowa)) +
  geom_histogram(binwidth = 0.5, boundary = 0, fill = "grey70", colour = "white", linewidth = 0.2) +
  geom_vline(data = linie, aes(xintercept = wartosc, linetype = co), colour = kol[["czarny"]], linewidth = 0.8) +
  geom_text(data = podsum, aes(x = -3.5, y = Inf, label = sprintf("średnia %.1f\nSD %.1f", surowa, SD_surowej)),
            hjust = 0, vjust = 1.3, size = 3.4, colour = "grey20", lineheight = 0.95) +
  facet_wrap(~ panel, ncol = 2) +
  scale_linetype_manual(values = c("efekt w populacji uczelni (5 pkt)" = "solid",
                                   "efekt na wydziale Zarządzanie (8 pkt)" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = seq(-4, 20, 4)) +
  coord_cartesian(xlim = c(-3.5, 20)) +
  labs(x = "Oszacowany efekt materiału: średnia E − średnia K (pkt)", y = "Liczba badań",
       title = "1000 badań w każdej komórce (n = 120)",
       subtitle = "Środek histogramu: gdzie badanie trafia średnio; szerokość: precyzja") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85))) +
  guides(linetype = guide_legend(nrow = 2))
p2   # zapis: ggsave("losowy-przydzial-tysiac-badan.svg", p2, width = 8.4, height = 7)
Wynik w R
   dobor    przydzial surowa ancova SATE SD_surowej obciazenie_wzgl_PATE
  losowy       losowy   5.07   5.06    5       1.91                 0.07
 wygodny       losowy   7.96   7.99    8       1.89                 2.96
  losowy samoselekcja  10.98   7.42    5       1.94                 5.98
 wygodny samoselekcja  14.15  10.76    8       1.82                 9.15
 blad_MC_sredniej
             0.06
             0.06
             0.06
             0.06
3. Randomizacja prosta i blokowa przy 20 osobach: Rysunek 3
R
# Rysunek 3. Randomizacja prosta i blokowa przy 20 osobach: liczebności grup i różnica średniego wieku
# (kontynuacja: pop, N, kol, motyw, bz z bloku 1)
library(ggplot2)
library(patchwork)

# Trzy sposoby losowania listy przydziałów dla n osób (E – materiał, K – bez materiału)
prosta <- function(n) sample(c("E", "K"), n, replace = TRUE)                     # rzut monetą dla każdej osoby
bloki <- function(n, dlugosci) {                                                  # bloki permutowane
  lista <- character()
  while (length(lista) < n) {
    b <- if (length(dlugosci) == 1) dlugosci else sample(dlugosci, 1)
    lista <- c(lista, sample(rep(c("E", "K"), b / 2)))
  }
  lista[1:n]                                      # ostatni blok może zostać niedokończony
}
metody <- list("prosta" = function(n) prosta(n), "bloki po 4" = function(n) bloki(n, 4),
               "bloki 4 lub 6 (losowo)" = function(n) bloki(n, c(4, 6)))

set.seed(588)
grupa20 <- pop[sample(N, 20), ]                   # 20 osób, które zgłosiły się do eksperymentu
R <- 10000
wyn <- do.call(rbind, lapply(names(metody), function(m) {
  w <- t(replicate(R, {
    g <- metody[[m]](20)
    c(n_E = sum(g == "E"), roznica_wieku = mean(grupa20$wiek[g == "E"]) - mean(grupa20$wiek[g == "K"]))
  }))
  data.frame(metoda = m, w)
}))
wyn$metoda <- factor(wyn$metoda, names(metody))
# Podział 10:10 i podział 7:13 albo bardziej nierówny; SD różnicy średniego wieku (lata)
print(do.call(rbind, lapply(split(wyn, wyn$metoda), function(d) round(c(
  rowno_10_10 = mean(d$n_E == 10), co_najmniej_7_13 = mean(abs(d$n_E - 10) >= 3), min_n_E = min(d$n_E),
  max_n_E = max(d$n_E), SD_roznicy_wieku = sd(d$roznica_wieku, na.rm = TRUE),
  roznica_wieku_ponad_2_lata = mean(abs(d$roznica_wieku) > 2, na.rm = TRUE)), 3))))
round(c(SD_wieku_w_grupie20 = sd(grupa20$wiek), blad_MC_przy_0.5 = sqrt(.25 / R)), 3)

# Randomizacja prosta: jak SD różnicy średniego wieku maleje z liczebnością (mniej więcej jak 1/√n)
set.seed(588)
sapply(c(20, 40, 100, 400), function(n) {
  g <- pop[sample(N, n), ]
  round(sd(replicate(2000, { e <- prosta(n); mean(g$wiek[e == "E"]) - mean(g$wiek[e == "K"]) }), na.rm = TRUE), 2)
})

# A: rozkład liczebności grupy E; B: rozkład różnicy średniego wieku E − K
liczeb <- as.data.frame(table(metoda = wyn$metoda, n_E = wyn$n_E))
liczeb$n_E <- as.integer(as.character(liczeb$n_E)); liczeb$odsetek <- liczeb$Freq / R
liczeb <- subset(liczeb, odsetek > 0)
skala <- list(scale_colour_manual(values = setNames(c(kol[["K"]], kol[["E"]], kol[["zielony"]]), names(metody)), name = NULL),
              scale_shape_manual(values = setNames(c(17, 16, 15), names(metody)), name = NULL),
              scale_linetype_manual(values = setNames(c("solid", "dashed", "dotted"), names(metody)), name = NULL))
pa <- ggplot(liczeb, aes(n_E, odsetek, colour = metoda, shape = metoda, linetype = metoda)) +
  geom_line(linewidth = 0.7) + geom_point(size = 2.4) + skala +
  scale_x_continuous(breaks = seq(4, 16, 2)) + scale_y_continuous(labels = scales::percent) +
  labs(x = "Liczba osób w grupie E (na 20)", y = "Odsetek list", title = "A. Liczebność grupy E",
       subtitle = "10 000 list przydziału dla tych samych 20 osób") + motyw
pb <- ggplot(wyn, aes(roznica_wieku, colour = metoda, linetype = metoda)) +
  geom_vline(xintercept = 0, colour = "grey40") +
  geom_density(linewidth = 0.8, adjust = 1.5, key_glyph = "path") + skala[-2] +
  scale_x_continuous(breaks = seq(-4, 4, 1)) + coord_cartesian(xlim = c(-4, 4)) +
  labs(x = "Średni wiek E − średni wiek K (lata)", y = "Gęstość", title = "B. Różnica średniego wieku",
       subtitle = "Bloki wyrównują liczebność, nie wiek") + motyw +
  guides(colour = "none", linetype = "none")      # legenda wspólna z panelem A
p3 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p3   # zapis: ggsave("losowy-przydzial-prosta-i-blokowa.svg", p3, width = 9, height = 5.4)
Wynik w R
                       rowno_10_10 co_najmniej_7_13 min_n_E max_n_E
prosta                       0.174            0.268       2      18
bloki po 4                   1.000            0.000      10      10
bloki 4 lub 6 (losowo)       0.779            0.000       9      11
                       SD_roznicy_wieku roznica_wieku_ponad_2_lata
prosta                            1.763                      0.280
bloki po 4                        1.802                      0.276
bloki 4 lub 6 (losowo)            1.793                      0.274
SD_wieku_w_grupie20    blad_MC_przy_0.5
              3.837               0.005
[1] 1.77 0.84 0.43 0.22
4. Randomizacja warstwowa: Rysunek 4
R
# Rysunek 4. Randomizacja warstwowa według płci i poziomu wyjściowego: równowaga i precyzja efektu
# (kontynuacja: pop, N, kol, motyw, prosta(), bloki() z bloków 1 i 3)
library(ggplot2)
library(patchwork)

set.seed(588)
g40 <- pop[sample(N, 40), ]                       # 40 osób w eksperymencie
g40$poziom <- ifelse(g40$wyjsciowy >= median(pop$wyjsciowy), "wysoki", "niski")
g40$warstwa <- interaction(ifelse(g40$kobieta == 1, "K", "M"), g40$poziom)   # 4 warstwy: płeć × poziom wyjściowy
SATE40 <- mean(g40$y1 - g40$y0)                   # prawdziwy efekt w tych 40 osobach
table(g40$warstwa)

warstwowa <- function(d) {                        # osobna lista z bloków po 4 w każdej warstwie
  g <- character(nrow(d))
  for (w in unique(d$warstwa)) { ind <- which(d$warstwa == w); g[ind] <- bloki(length(ind), 4) }
  g
}
# Jedno losowanie: różnica liczby osób z wysokim wynikiem wyjściowym (E − K) i trzy oszacowania efektu
jedno <- function(g, d = g40) {
  E <- as.numeric(g == "E"); y <- ifelse(E == 1, d$y1, d$y0)
  X_w <- cbind(1, E, model.matrix(~ warstwa, d)[, -1]); X_a <- cbind(1, E, d$wyjsciowy)
  c(roznica_wysokich = sum(E == 1 & d$poziom == "wysoki") - sum(E == 0 & d$poziom == "wysoki"),
    surowa = mean(y[E == 1]) - mean(y[E == 0]),
    SE_z_testu_t = sqrt(var(y[E == 1]) / sum(E) + var(y[E == 0]) / sum(1 - E)),   # błąd, który poda test t
    z_warstwami = .lm.fit(X_w, y)$coefficients[2],       # regresja z warstwami jako zmiennymi
    ancova = .lm.fit(X_a, y)$coefficients[2])           # regresja z ciągłym wynikiem wyjściowym
}
R <- 10000
set.seed(588)
pr <- t(replicate(R, { g <- prosta(40); while (length(unique(g)) < 2) g <- prosta(40); jedno(g) }))
wa <- t(replicate(R, jedno(warstwowa(g40))))
# Równowaga w poziomie wyjściowym i rozrzut (SD) oszacowań efektu wokół prawdziwego efektu w próbie
# oraz średni błąd standardowy, który dla różnicy średnich podaje test t (bez uwzględnienia warstw)
tab <- rbind(prosta = c(mean(abs(pr[, 1]) >= 5), apply(pr[, c(2, 4, 5)], 2, sd), mean(pr[, 3])),
             warstwowa = c(mean(abs(wa[, 1]) >= 5), apply(wa[, c(2, 4, 5)], 2, sd), mean(wa[, 3])))
colnames(tab) <- c("roznica_wysokich_co_najmniej_5", "SD_surowej", "SD_z_warstwami", "SD_ancova", "sredni_SE_testu_t")
round(tab, 3)
round(c(SATE40 = SATE40, srednia_prosta_surowa = mean(pr[, "surowa"]), srednia_warstwowa_surowa = mean(wa[, "surowa"]),
        srednia_warstwowa_z_warstwami = mean(wa[, "z_warstwami"])), 2)

# A: różnica liczby osób z wysokim wynikiem wyjściowym; B: rozrzut oszacowań efektu (punkt = średnia,
# gruby odcinek = środkowe 50%, cienki = środkowe 95% z 10 000 losowań)
dA <- rbind(data.frame(metoda = "prosta", roz = pr[, 1]), data.frame(metoda = "warstwowa", roz = wa[, 1]))
dA <- as.data.frame(table(metoda = dA$metoda, roz = dA$roz)); dA$roz <- as.integer(as.character(dA$roz))
dA$odsetek <- dA$Freq / R; dA <- subset(dA, odsetek > 0)
pa <- ggplot(dA, aes(roz, odsetek, fill = metoda)) +
  geom_col(position = position_dodge(width = 1.6, preserve = "single"), width = 1.5) +
  scale_fill_manual(values = c(prosta = kol[["K"]], warstwowa = kol[["E"]]), name = NULL) +
  scale_x_continuous(breaks = seq(-11, 11, 2)) + scale_y_continuous(labels = scales::percent) +
  labs(x = "Osoby z wysokim wynikiem wyjściowym: E − K", y = NULL,
       title = "A. Równowaga poziomu wyjściowego", subtitle = "Odsetek z 10 000 losowań dla tych samych 40 osób") + motyw
dB <- data.frame(wariant = factor(c("prosta, różnica średnich", "warstwowa, różnica średnich",
                                    "warstwowa, model z warstwami", "prosta, ANCOVA z wynikiem wyjściowym"),
                                  rev(c("prosta, różnica średnich", "warstwowa, różnica średnich",
                                        "warstwowa, model z warstwami", "prosta, ANCOVA z wynikiem wyjściowym"))),
                 metoda = c("prosta", "warstwowa", "warstwowa", "prosta"),
                 x = list(pr[, "surowa"], wa[, "surowa"], wa[, "z_warstwami"], pr[, "ancova"]) |>
                   lapply(function(v) quantile(v, c(.025, .25, .5, .75, .975))) |> do.call(what = rbind))
dB$srednia <- c(mean(pr[, "surowa"]), mean(wa[, "surowa"]), mean(wa[, "z_warstwami"]), mean(pr[, "ancova"]))
dB$SD <- c(sd(pr[, "surowa"]), sd(wa[, "surowa"]), sd(wa[, "z_warstwami"]), sd(pr[, "ancova"]))
pb <- ggplot(dB, aes(y = wariant, colour = metoda, shape = metoda)) +
  geom_vline(xintercept = SATE40, colour = "grey30", linetype = "dashed") +
  geom_linerange(aes(xmin = x.2.5., xmax = x.97.5.), linewidth = 0.7) +
  geom_linerange(aes(xmin = x.25., xmax = x.75.), linewidth = 2.6) +
  geom_point(aes(x = srednia), size = 3, colour = "black") +
  geom_text(aes(x = x.97.5., label = sprintf("SD %.2f", SD)), hjust = -0.15, size = 3.4, colour = "grey20") +
  scale_colour_manual(values = c(prosta = kol[["K"]], warstwowa = kol[["E"]]), name = NULL) +
  scale_x_continuous(expand = expansion(mult = c(0.05, 0.25))) +
  labs(x = "Oszacowany efekt (pkt)", y = NULL, title = "B. Rozrzut oszacowań efektu",
       subtitle = sprintf("Linia przerywana: prawdziwy efekt w tych 40 osobach (%.2f pkt)", SATE40)) +
  motyw + guides(colour = "none", shape = "none")
p4 <- pa / pb + plot_layout(heights = c(1, 1.1))
p4   # zapis: ggsave("losowy-przydzial-warstwowa.svg", p4, width = 8.4, height = 8)
Wynik w R
 K.niski  M.niski K.wysoki M.wysoki
      11        8       11       10
          roznica_wysokich_co_najmniej_5 SD_surowej SD_z_warstwami SD_ancova
prosta                             0.386      3.590          2.905     2.123
warstwowa                          0.000      2.646          2.581     2.035
          sredni_SE_testu_t
prosta                3.558
warstwowa             3.538
                       SATE40         srednia_prosta_surowa
                         4.85                          4.84
     srednia_warstwowa_surowa srednia_warstwowa_z_warstwami
                         4.89                          4.89
5. Samoselekcja do grupy: Rysunek 5
R
# Rysunek 5. Samoselekcja do grupy: kto sam wybiera materiał i co z tego wychodzi
# (kontynuacja: cztery – badanie B z bloku 1, sym i PATE z bloku 2, kol, motyw; ten blok niczego nie losuje)
library(ggplot2)
library(patchwork)

d <- cztery[[2]]                                  # losowa próba 120 osób, materiał wybierali sami studenci
d$grupa <- factor(ifelse(d$E == 1, "wybrali materiał (E)", "nie wybrali (K)"), c("wybrali materiał (E)", "nie wybrali (K)"))
# Grupy różnią się już przed badaniem – w wyniku wyjściowym (mierzonym) i motywacji (niemierzonej)
round(sapply(split(d[c("wyjsciowy", "motywacja", "wynik")], d$grupa), colMeans), 2)
# Oszacowania z tego jednego badania: surowa różnica i ANCOVA z wynikiem wyjściowym
round(c(surowa = mean(d$wynik[d$E == 1]) - mean(d$wynik[d$E == 0]),
        ancova = unname(coef(lm(wynik ~ E + wyjsciowy, data = d))["E"]), SATE = mean(d$y1 - d$y0)), 2)

# 1000 badań z bloku 2 (losowa próba): losowy przydział vs samoselekcja, bez korekty i z ANCOVA
s <- subset(sym, dobor == "losowy")
warianty <- rbind(
  data.frame(wariant = "losowy przydział, różnica średnich", v = s$surowa[s$przydzial == "losowy"]),
  data.frame(wariant = "losowy przydział, ANCOVA", v = s$ancova[s$przydzial == "losowy"]),
  data.frame(wariant = "samoselekcja, różnica średnich", v = s$surowa[s$przydzial == "samoselekcja"]),
  data.frame(wariant = "samoselekcja, ANCOVA z wynikiem wyjściowym", v = s$ancova[s$przydzial == "samoselekcja"]))
warianty$wariant <- factor(warianty$wariant, rev(unique(warianty$wariant)))
ws <- do.call(rbind, lapply(split(warianty$v, warianty$wariant), function(v)
  data.frame(srednia = mean(v), SD = sd(v), obciazenie = mean(v) - PATE, q025 = quantile(v, .025),
             q25 = quantile(v, .25), q75 = quantile(v, .75), q975 = quantile(v, .975))))
ws$wariant <- factor(rownames(ws), levels(warianty$wariant))
print(round(ws[c("srednia", "SD", "obciazenie")], 2))
ws$przydzial <- ifelse(grepl("^losowy", ws$wariant), "losowy", "samoselekcja")

pa <- ggplot(d, aes(wyjsciowy, wynik, colour = grupa, shape = grupa)) +
  geom_point(size = 2, alpha = 0.8) +
  geom_point(data = aggregate(cbind(wyjsciowy, wynik) ~ grupa, data = d, FUN = mean), size = 5, shape = 23,
             fill = "white", stroke = 1.4, show.legend = FALSE) +
  scale_colour_manual(values = c("wybrali materiał (E)" = kol[["E"]], "nie wybrali (K)" = kol[["K"]]), name = NULL) +
  scale_shape_manual(values = c("wybrali materiał (E)" = 16, "nie wybrali (K)" = 17), name = NULL) +
  labs(x = "Wynik wyjściowy (pkt)", y = "Wynik egzaminu (pkt)", title = "A. Jedno badanie z samoselekcją",
       subtitle = "Romby: średnie grup – E startuje wyżej") + motyw
pb <- ggplot(ws, aes(y = wariant, colour = przydzial)) +
  geom_vline(xintercept = PATE, colour = "grey30", linetype = "dashed") +
  geom_linerange(aes(xmin = q025, xmax = q975), linewidth = 0.7) +
  geom_linerange(aes(xmin = q25, xmax = q75), linewidth = 2.6) +
  geom_point(aes(x = srednia), size = 3, colour = "black") +
  scale_colour_manual(values = c(losowy = kol[["E"]], samoselekcja = kol[["K"]]), guide = "none") +
  scale_y_discrete(labels = function(x) sub(", ", ",\n", x)) +
  labs(x = "Oszacowany efekt (pkt)", y = NULL, title = "B. 1000 badań (n = 120)",
       subtitle = "Linia przerywana: prawdziwy efekt (5 pkt)") + motyw
p5 <- pa + pb + plot_layout(widths = c(1, 1.15), guides = "collect") & theme(legend.position = "bottom")
p5   # zapis: ggsave("losowy-przydzial-samoselekcja.svg", p5, width = 9.6, height = 5.6)
Wynik w R
          wybrali materiał (E) nie wybrali (K)
wyjsciowy                62.19           57.04
motywacja                 0.34           -0.55
wynik                    57.23           48.72
surowa ancova   SATE
  8.51   5.21   5.01
                                           srednia   SD obciazenie
samoselekcja, ANCOVA z wynikiem wyjściowym    7.42 1.24       2.42
samoselekcja, różnica średnich               10.98 1.94       5.98
losowy przydział, ANCOVA                      5.06 1.23       0.06
losowy przydział, różnica średnich            5.07 1.91       0.07
6. Test różnic wyjściowych: Rysunek 6
R
# Rysunek 6. Test różnic wyjściowych po randomizacji: co mówi p, a co różnica w ważnej zmiennej
# (kontynuacja: pop, N, kol, motyw z bloku 1)
library(ggplot2)

# 10 000 eksperymentów: losowa próba 40 osób, losowy przydział 20:20. W każdym: test t różnic wyjściowych
# dla wyniku wyjściowego (silnie związany z wynikiem egzaminu) i dla wieku (niezwiązany) oraz błąd oszacowania
R <- 10000
set.seed(588)
ekspe <- t(replicate(R, {
  d <- pop[sample(N, 40), ]; E <- sample(rep(0:1, 20)); y <- ifelse(E == 1, d$y1, d$y0)
  sate <- mean(d$y1 - d$y0)
  c(d_wyjsciowy = (mean(d$wyjsciowy[E == 1]) - mean(d$wyjsciowy[E == 0])) / sd(d$wyjsciowy),
    p_wyjsciowy = t.test(d$wyjsciowy[E == 1], d$wyjsciowy[E == 0], var.equal = TRUE)$p.value,
    d_wiek = (mean(d$wiek[E == 1]) - mean(d$wiek[E == 0])) / sd(d$wiek),
    p_wiek = t.test(d$wiek[E == 1], d$wiek[E == 0], var.equal = TRUE)$p.value,
    blad_surowej = mean(y[E == 1]) - mean(y[E == 0]) - sate,
    blad_ancova = .lm.fit(cbind(1, E, d$wyjsciowy), y)$coefficients[2] - sate)
}))
ekspe <- as.data.frame(ekspe)
# Odsetek „istotnych” różnic wyjściowych (z błędem Monte Carlo), związek różnicy z błędem oszacowania,
# rozrzut błędu w badaniach z p ≥ .05 i p < .05 oraz po ANCOVA
round(c(istotne_wyjsciowy = mean(ekspe$p_wyjsciowy < .05), istotne_wiek = mean(ekspe$p_wiek < .05),
        blad_MC = sqrt(.05 * .95 / R),
        r_blad_z_roznica_wyjsciowego = cor(ekspe$blad_surowej, ekspe$d_wyjsciowy),
        r_blad_z_roznica_wieku = cor(ekspe$blad_surowej, ekspe$d_wiek),
        SD_bledu_p_wyjsciowy_ponad_05 = sd(ekspe$blad_surowej[ekspe$p_wyjsciowy >= .05]),
        SD_bledu_p_wyjsciowy_ponizej_05 = sd(ekspe$blad_surowej[ekspe$p_wyjsciowy < .05]),
        SD_bledu_surowej = sd(ekspe$blad_surowej), SD_bledu_ancova = sd(ekspe$blad_ancova)), 3)

# Na rysunku 500 pierwszych eksperymentów (wszystkie 10 000 dałyby za duży plik SVG)
pokaz <- ekspe[1:500, ]
dl <- rbind(data.frame(zmienna = "Wynik wyjściowy (silnie związany z wynikiem)", d = pokaz$d_wyjsciowy,
                       p = pokaz$p_wyjsciowy, blad = pokaz$blad_surowej),
            data.frame(zmienna = "Wiek (niezwiązany z wynikiem)", d = pokaz$d_wiek, p = pokaz$p_wiek,
                       blad = pokaz$blad_surowej))
dl$zmienna <- factor(dl$zmienna, unique(dl$zmienna))
dl$test <- factor(ifelse(dl$p < .05, "test różnic wyjściowych: p < .05", "p ≥ .05"),
                  c("p ≥ .05", "test różnic wyjściowych: p < .05"))
p6 <- ggplot(dl, aes(d, blad)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_point(aes(colour = test, shape = test, size = test), alpha = 0.75) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = "black", linewidth = 0.8) +
  facet_wrap(~ zmienna, ncol = 2) +
  scale_colour_manual(values = c("p ≥ .05" = "grey60", "test różnic wyjściowych: p < .05" = kol[["K"]]), name = NULL) +
  scale_shape_manual(values = c("p ≥ .05" = 16, "test różnic wyjściowych: p < .05" = 17), name = NULL) +
  scale_size_manual(values = c("p ≥ .05" = 1.3, "test różnic wyjściowych: p < .05" = 2.4), name = NULL) +
  labs(x = "Różnica wyjściowa E − K (w SD zmiennej)", y = "Błąd oszacowania efektu (pkt)",
       title = "Ta sama randomizacja, dwie zmienne wyjściowe",
       subtitle = "500 z 10 000 eksperymentów (n = 40); linia: trend błędu") +
  motyw + theme(strip.text = element_text(hjust = 0, size = rel(0.85)))
p6   # zapis: ggsave("losowy-przydzial-test-rownowagi.svg", p6, width = 8.4, height = 5.4)
Wynik w R
              istotne_wyjsciowy                    istotne_wiek
                          0.050                           0.050
                        blad_MC    r_blad_z_roznica_wyjsciowego
                          0.002                           0.780
         r_blad_z_roznica_wieku   SD_bledu_p_wyjsciowy_ponad_05
                         -0.070                           3.177
SD_bledu_p_wyjsciowy_ponizej_05                SD_bledu_surowej
                          6.377                           3.411
                SD_bledu_ancova
                          2.143
7. Kontrola palety: symulacja zaburzeń widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("niebieski – cynober (E / K; warstwowa / prosta)" = c("#0072B2", "#D55E00"),
             "niebieski – zielony (bloki po 4 / bloki 4 lub 6)" = c("#0072B2", "#009E73"),
             "cynober – zielony (prosta / bloki 4 lub 6)" = c("#D55E00", "#009E73"),
             "jasnoszary – niebieski (niewybrani / grupa E)" = c("#CCCCCC", "#0072B2"),
             "jasnoszary – cynober (niewybrani / grupa K)" = c("#CCCCCC", "#D55E00"),
             "szary – cynober (p ≥ .05 / p < .05)" = c("#999999", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                 widzenie_typowe deuteranopia
niebieski – cynober (E / K; warstwowa / prosta)            114.6        108.3
niebieski – zielony (bloki po 4 / bloki 4 lub 6)            70.1         55.4
cynober – zielony (prosta / bloki 4 lub 6)                 102.4         53.5
jasnoszary – niebieski (niewybrani / grupa E)               55.0         58.9
jasnoszary – cynober (niewybrani / grupa K)                 81.6         67.1
szary – cynober (p ≥ .05 / p < .05)                         77.2         62.9
czerwony – zielony (do unikania)                           121.7         21.1
                                                 protanopia
niebieski – cynober (E / K; warstwowa / prosta)        91.9
niebieski – zielony (bloki po 4 / bloki 4 lub 6)       58.0
cynober – zielony (prosta / bloki 4 lub 6)             37.3
jasnoszary – niebieski (niewybrani / grupa E)          50.3
jasnoszary – cynober (niewybrani / grupa K)            63.9
szary – cynober (p ≥ .05 / p < .05)                    56.0
czerwony – zielony (do unikania)                       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowania, testy t i modele liniowe (lm(), .lm.fit()) – pakiety base i stats. Rysunki wykonano w pakiecie ggplot2 z osiami opisanymi przez pakiet scales, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- „Próba była losowa”, gdy losowy był tylko przydział (rysunki 1 i 2).
- Przydział według kolejności zgłoszeń, dnia tygodnia albo wyboru uczestnika. To nie randomizacja (rysunek 5).
- Bloki traktowane jak gwarancja równych grup pod względem cech. Bloki wyrównują liczebność, nie wiek ani wynik wyjściowy (rysunek 3).
- Warstwy w losowaniu, ale nie w analizie. Przedziały wychodzą wtedy za szerokie (rysunek 4).
- Testy istotności w tabeli cech wyjściowych zamiast kowariantów zaplanowanych przed badaniem (rysunek 6).
Najczęstsze pytania
Czym różni się losowy dobór próby od losowego przydziału do grup w eksperymencie?
Dobór próby decyduje, kto trafia do badania, i uzasadnia uogólnienie na populację (trafność zewnętrzna). Przydział decyduje, kto dostaje który warunek, i uzasadnia wniosek przyczynowy (trafność wewnętrzna). W naszej symulacji próba z jednego wydziału z losowym przydziałem dawała średnio 7.96 punktu – trafnie dla tego wydziału, ale nie dla uczelni (5.00). Samodzielny wybór grupy przy losowej próbie dawał 10.98, czyli obciążenie prawie 6 punktów.
Czy przy 20 uczestnikach wystarczy losować przydział rzutem monetą?
Wystarczy w tym sensie, że nie wprowadza stronniczości, ale grupy często wychodzą nierówne: w 10 000 losowań podział 10:10 wypadł w 17.4%, a 7:13 lub bardziej nierówny w 26.8%. Bloki po 4 zawsze dają 10:10, a bloki losowej długości (4 lub 6) – 10:10 albo 9:11. Żadna z tych metod nie wyrównuje jednak cech, np. wieku – to robi warstwowanie albo kowariant w analizie.
Czy po randomizacji trzeba testować, czy grupy nie różnią się na starcie?
Nie. Przy losowym przydziale około 5% takich testów wychodzi „istotnych” z definicji – w naszej symulacji dokładnie 5.0%. O jakości wyniku decyduje różnica w zmiennych silnie związanych z wynikiem, także wtedy, gdy test daje p ≥ .05. Takie zmienne wskaż przed badaniem i uwzględnij w ANCOVA, a w tabeli cech wyjściowych podaj średnie i SD bez wartości p.
Czy ANCOVA naprawi brak losowego przydziału, gdy uczestnicy sami wybierają grupę?
Tylko częściowo. W symulacji, w której bardziej zmotywowani studenci częściej wybierali materiał, różnica średnich była obciążona o 5.98 punktu, a ANCOVA z wynikiem wyjściowym – nadal o 2.42 punktu, bo motywacji nikt nie mierzył. Korekta pomaga tylko w takim stopniu, w jakim zmierzono to, co wpływało na wybór.
Kiedy w małym eksperymencie warto losować w warstwach?
Gdy znasz zmienną silnie związaną z wynikiem, np. wynik wyjściowy, a próba jest mała. W symulacji z 40 osobami warstwy według płci i poziomu wyjściowego zmniejszyły rozrzut oszacowań efektu z 3.59 do 2.65 punktu. Zmienne warstwujące trzeba jednak uwzględnić w analizie – test t bez nich podawał błąd standardowy 3.54 zamiast faktycznych 2.65.
Powiązane hasła
Przeczytaj też
Randomizacja w praktyce
Bloki o losowej długości, warstwy, minimalizacja Pococka–Simona i ukrycie przydziału – lista przydziału w R, symulacja i wzór opisu CONSORT.
Czytaj →PoradnikEksperyment z losowym przydziałem – jak opisać metodę
Warunki, jednostka randomizacji, lista blokowa, ukrycie przydziału, zaślepienie i gotowy podrozdział Metoda z kodem R.
Czytaj →PoradnikSchematy losowania w obrazkach
Sześć schematów losowania na mapach jednej populacji, 1000 symulowanych badań, efekt schematu i efektywna liczebność – pięć rysunków z kodem R.
Czytaj →PoradnikRandomizacja klastrowa – plan i analiza
ICC z przedziałem ufności, efekt schematu przy nierównych oddziałach, cztery analizy tych samych danych, poprawki df i raport CONSORT – z kodem R.
Czytaj →Planujesz eksperyment do pracy dyplomowej?
Pomożemy zaplanować losowanie przydziału, dobrać liczebność i kowarianty, policzyć efekt i opisać metodę tak, żebyś umiał(a) uzasadnić te decyzje przed promotorem i recenzentem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- de Boer, M. R., Waterlander, W. E., Kuijper, L. D. J., Steenhuis, I. H. M., & Twisk, J. W. R. (2015). Testing for baseline differences in randomized controlled trials: An unhealthy research behavior that is hard to eradicate. International Journal of Behavioral Nutrition and Physical Activity, 12(1), Article 4. https://doi.org/10.1186/s12966-015-0162-z ● Otwarty dostęp
- Kahan, B. C., & Morris, T. P. (2012). Improper analysis of trials randomised using stratified blocks or minimisation. Statistics in Medicine, 31(4), 328–340. https://doi.org/10.1002/sim.4431
- Kennedy-Martin, T., Curtis, S., Faries, D., Robinson, S., & Johnston, J. (2015). A literature review on the representativeness of randomized controlled trial samples and implications for the external validity of trial results. Trials, 16(1), Article 495. https://doi.org/10.1186/s13063-015-1023-4 ● Otwarty dostęp
- Kernan, W. N., Viscoli, C. M., Makuch, R. W., Brass, L. M., & Horwitz, R. I. (1999). Stratified randomization for clinical trials. Journal of Clinical Epidemiology, 52(1), 19–26. https://doi.org/10.1016/S0895-4356(98)00138-3 ● Otwarty dostęp
- Schulz, K. F., & Grimes, D. A. (2002). Generation of allocation sequences in randomised trials: Chance, not choice. The Lancet, 359(9305), 515–519. https://doi.org/10.1016/s0140-6736(02)07683-3
- Senn, S. (1994). Testing for baseline balance in clinical trials. Statistics in Medicine, 13(17), 1715–1726. https://doi.org/10.1002/sim.4780131703
- Shadish, W. R., Clark, M. H., & Steiner, P. M. (2008). Can nonrandomized experiments yield accurate answers? A randomized experiment comparing random and nonrandom assignments. Journal of the American Statistical Association, 103(484), 1334–1344. https://doi.org/10.1198/016214508000000733
Cytowania BibTeX
@article{deboer2015testing, author={de Boer, Michiel R. and Waterlander, Wilma E. and Kuijper, Lothar D. J. and Steenhuis, Ingrid H. M. and Twisk, Jos W. R.}, title={{Testing for baseline differences in randomized controlled trials: An unhealthy research behavior that is hard to eradicate}}, journal={International Journal of Behavioral Nutrition and Physical Activity}, year={2015}, volume={12}, number={1}, eid={4}, doi={10.1186/s12966-015-0162-z}}@article{kahan2012improper, author={Kahan, Brennan C. and Morris, Tim P.}, title={{Improper analysis of trials randomised using stratified blocks or minimisation}}, journal={Statistics in Medicine}, year={2012}, volume={31}, number={4}, pages={328--340}, doi={10.1002/sim.4431}}@article{kennedymartin2015literature, author={Kennedy-Martin, Tessa and Curtis, Sarah and Faries, Douglas and Robinson, Susan and Johnston, Joseph}, title={{A literature review on the representativeness of randomized controlled trial samples and implications for the external validity of trial results}}, journal={Trials}, year={2015}, volume={16}, number={1}, eid={495}, doi={10.1186/s13063-015-1023-4}}@article{kernan1999stratified, author={Kernan, Walter N. and Viscoli, Catherine M. and Makuch, Robert W. and Brass, Lawrence M. and Horwitz, Ralph I.}, title={{Stratified randomization for clinical trials}}, journal={Journal of Clinical Epidemiology}, year={1999}, volume={52}, number={1}, pages={19--26}, doi={10.1016/s0895-4356(98)00138-3}}@article{schulz2002generation, author={Schulz, Kenneth F. and Grimes, David A.}, title={{Generation of allocation sequences in randomised trials: Chance, not choice}}, journal={The Lancet}, year={2002}, volume={359}, number={9305}, pages={515--519}, doi={10.1016/s0140-6736(02)07683-3}}@article{senn1994testing, author={Senn, Stephen}, title={{Testing for baseline balance in clinical trials}}, journal={Statistics in Medicine}, year={1994}, volume={13}, number={17}, pages={1715--1726}, doi={10.1002/sim.4780131703}}@article{shadish2008can, author={Shadish, William R. and Clark, M. H. and Steiner, Peter M.}, title={{Can nonrandomized experiments yield accurate answers? A randomized experiment comparing random and nonrandom assignments}}, journal={Journal of the American Statistical Association}, year={2008}, volume={103}, number={484}, pages={1334--1344}, doi={10.1198/016214508000000733}}