Co trzeba opisać, gdy o warunku decyduje losowanie
W eksperymencie badacz sam wytwarza warunki, a o tym, kto trafi do którego, decyduje losowanie. Dlatego różnicę między warunkami można przypisać manipulacji. Logikę tego schematu i jego granice klasycznie omawiają Shadish i in. (2002). W rozdziale metodologicznym nie powtarzasz tej definicji. Pokazujesz, że w Twoim badaniu losowanie zadziałało tak, jak zadziałać miało.
Ogólny układ rozdziału opisuje rozdział metodologiczny, a eksperyment prowadzony w formularzu ma osobny wpis: jak opisać eksperyment ankietowy. Tutaj chodzi o sytuację, w której uczestnik przychodzi na badanie osobiście. Losowania nie wykona za Ciebie narzędzie ankietowe. Musisz sam wyznaczyć, kto przygotuje listę, kto ją zna i w którym momencie przydział staje się znany.
Przykład w całym wpisie (fikcyjny, dane symulowane). Studentka psychologii sprawdza, czy sześciominutowe nagranie z ćwiczeniem oddechowym zmniejsza napięcie przed krótkim wystąpieniem bardziej niż nagranie kontrolne o tej samej długości, czytane przez tego samego lektora (o historii map). Uczestnicy słuchają przez słuchawki, przy osobnych stanowiskach. Napięcie mierzy skala 0–100 przed nagraniem i po nim. Nagrania mają w plikach nazwy A i B. To przykład metodologiczny, a nie zalecenie zdrowotne. Wszystkie liczby pochodzą z kodu R.
Warunki: co dokładnie różni grupy
Napisz, co robili uczestnicy każdego warunku, a nie tylko jak go nazwałeś. Określenie „grupa kontrolna” może oznaczać brak działania, zwykłą opiekę albo inną czynność. Odpowiedź na pytanie badawcze zależy od tego wyboru, co rozwija wpis o warunku kontrolnym. Wymień też, co było stałe: czas, lektor, głośność, sala. Manipulacja ma zmieniać jedną rzecz, a pełne materiały trafiają do aneksu (zob. materiały do manipulacji).
Jednostka randomizacji: co właściwie losujesz
Jednostka randomizacji to to, co otrzymuje przydział. Nie zawsze jest nią osoba, a od tej decyzji zależy cała analiza.
| Jak prowadzisz badanie | Co jest jednostką | Co z tego wynika |
|---|---|---|
| Każdy słucha sam, przez słuchawki | Osoba | Porównujesz osoby. W tekście napisz, że osoby badane były w tej samej sali, ale warunku nie dało się usłyszeć. |
| Nagranie leci z głośników dla całej sesji | Sesja | Osoby z jednej sesji mają wspólne warunki (godzina, atmosfera, prowadzący). Liczba jednostek to liczba sesji, nie osób. |
| Losujesz klasy, grupy zajęciowe, oddziały | Klasa, oddział | Potrzebujesz analizy badania klastrowego. Dwie klasy to jedna jednostka na warunek i nie da się oszacować efektu warunku. |
W przykładzie losowana jest osoba. Gdyby uczestnicy mogli rozmawiać między sesjami o tym, czego słuchali, w ograniczeniach trzeba by to nazwać przenikaniem warunków.
Losowanie: prosta czy blokowa, ile osób na warunek
Liczebność. Przy założonym d = 0.50, mocy .80 i α = .05 potrzeba 64 osób na warunek. Założonych 10% utraty daje 72 osoby na warunek, czyli 144 losowania. Założenia uzasadnij (zob. analiza mocy a priori). Tabela pokazuje, jak szybko rośnie liczba osób przy mniejszym efekcie.
| Założone d | Do analizy (na warunek) | Z zapasem 10% (na warunek) | Razem losowanych |
|---|---|---|---|
| 0.30 | 176 | 196 | 392 |
| 0.40 | 100 | 112 | 224 |
| 0.50 | 64 | 72 | 144 |
| 0.60 | 45 | 50 | 100 |
| 0.80 | 26 | 29 | 58 |
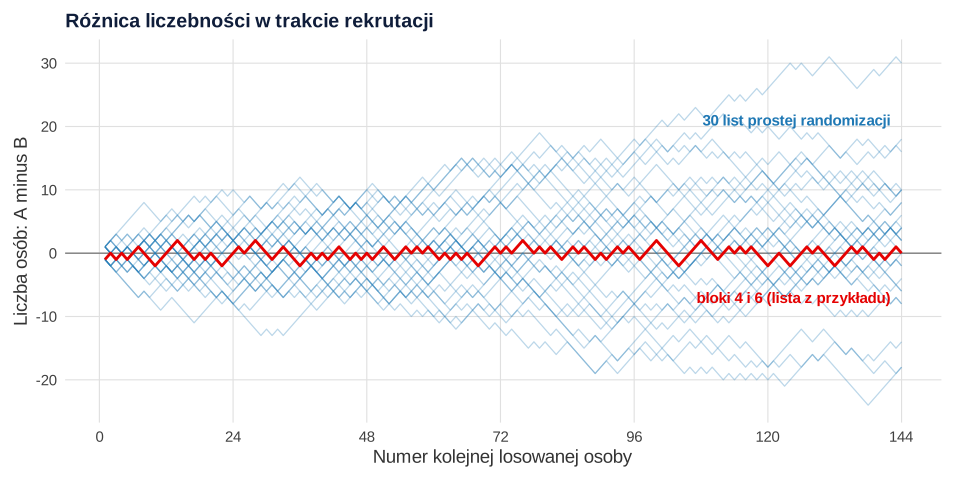
Metoda losowania. Randomizacja prosta to rzut monetą dla każdej osoby. Jest najmniej przewidywalna, ale nie pilnuje równych grup. W 10000 powtórzeń dla 144 osób różnica liczebności wynosiła co najmniej 10 osób w 45.6% list i co najmniej 20 osób w 11.3%. Bloki pilnują równych grup przez całą rekrutację: co 4 albo 6 osób liczebności się wyrównują.
Lista z przykładu ma 146 pozycji w 29 blokach (14 bloków po 4 i 15 po 6). Dla pierwszych 144 osób dała podział 72:72, a różnica w trakcie rekrutacji nigdy nie przekroczyła 2 osób. Dwie ostatnie pozycje zostają niewykorzystane. Efird (2011) opisuje losowanie długości bloków po to, by kolejny przydział trudniej było odgadnąć. Porównanie metod, warstwy i minimalizację omawia randomizacja w praktyce; tu potrzebujesz tylko listy i zdania, które ją opisze.
| Numery | Blok (długość) | Warunek |
|---|---|---|
| 1–6 | 1 (6) | B, A, B, A, B, A |
| 7–12 | 2 (6) | A, B, B, B, A, A |
Ukrycie przydziału: kto zna listę
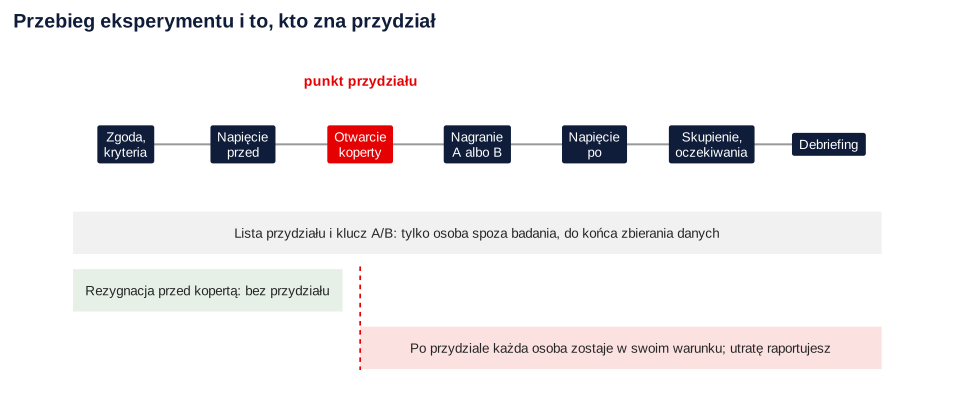
Dobra lista nic nie da, jeśli osoba zapraszająca uczestników widzi, kto będzie następny. Przydział musi pozostać nieznany do chwili włączenia osoby, a osoba generująca sekwencję nie powinna kwalifikować ani włączać uczestników (Altman i Schulz, 2001). Bez pomocy z zewnątrz najprostsze są kolejno numerowane, nieprzezroczyste i zaklejone koperty, otwierane dopiero po wpisaniu danych uczestnika. To właśnie ukrycie przydziału, które da się zapewnić w każdym badaniu.
W przykładzie listę wygenerowała koleżanka spoza badania, przygotowała koperty i zachowała klucz (co to A, a co B). Studentka wpisywała numer uczestnika i godzinę do rejestru, a dopiero wtedy uczestnik otwierał kopertę ze swoim numerem.
Zaślepienie: kto o czym nie wie
Nie pisz „badanie podwójnie ślepe”, bo różni autorzy rozumieją to inaczej. Schulz i Grimes (2002) zalecają wprost opisać, kto i jak był zaślepiony. Zaślepienie dotyczy tego, co dzieje się po przydziale, i nie zawsze jest możliwe. Ukrycie przydziału chroni moment losowania (Altman i Schulz, 2001).
| Kto | Czy wie, w jakim warunku jest osoba | Jak to opisać |
|---|---|---|
| Uczestnik | Wie, czego słucha, ale nie zna hipotezy | „Uczestnikom nie ujawniono, którego warunku dotyczy hipoteza”; pełne wyjaśnienie w debriefingu |
| Prowadząca | Nie zna klucza A/B i nie słyszy nagrań | „Prowadząca nie znała przydziału ani zawartości plików” |
| Analiza | Skrypt działa na kodach A i B; klucz odkrywany po zamknięciu analizy | „Analizę wykonano na kodach warunków” |
Kontrola manipulacji i oczekiwania
Sprawdzenie manipulacji odpowiada na pytanie, czy warunki różniły się tym, czym miały. W przeglądzie 207 eksperymentów Ejelöv i Luke (2020) znaleźli poważne braki w stosowaniu i interpretacji takich pomiarów, dlatego siłę manipulacji warto podać liczbowo. Pytanie może jednak samo działać jak interwencja (Hauser i in., 2018). W przykładzie stoi więc po pomiarze napięcia.
W badaniu interwencji psychologicznej zbadaj także oczekiwania. Aktywna grupa kontrolna nie wystarczy, jeśli warunki wywołują różne oczekiwania poprawy, a Boot i in. (2013) proponują je mierzyć. Tutaj służy do tego jedno pytanie: „W jakim stopniu spodziewał(a)eś się, że to nagranie pomoże Ci się odprężyć?”. Dlatego efektów oczekiwań nie pomijaj w dyskusji.
Reguły wykluczeń spisane przed badaniem
Kryteria sprawdzane przed otwarciem koperty nie zależą od warunku. Wykluczanie po przydziale jest ryzykowne. Usuwanie osób, które nie zaliczyły sprawdzenia manipulacji, może poważnie obciążyć wyniki (Aronow i in., 2019). Szczegóły i analizę wrażliwości opisuje wykluczanie respondentów w eksperymencie. Reguły dopisz do planu analizy, a utratę osób raportuj w obu warunkach.
Pięć zdań do poprawienia
| Jak bywa napisane | Co jest nie tak | Poprawiona wersja |
|---|---|---|
| „Osoby badane podzielono losowo na dwie grupy.” | Nie wiadomo, kto, czym i kiedy losował. | „Przydział 1:1 wygenerowano w R (bloki o losowej długości 4 lub 6).” |
| „Grupa kontrolna nie otrzymała interwencji.” | Nie wiadomo, co robiła. | „Grupa kontrolna wysłuchała nagrania o historii map o tej samej długości.” |
| „Przydział był tajny.” | Nie wiadomo, przed kim i jak. | „Listę przygotowała osoba spoza badania; koperty otwierano po wpisaniu uczestnika do rejestru.” |
| „Badanie było podwójnie ślepe.” | Etykieta bez treści. | „Prowadząca nie znała przydziału; uczestnicy nie znali hipotezy.” |
| „Usunięto osoby, które nie przyłożyły się do zadania.” | Kryterium po przydziale, ustalone po fakcie. | „Zgodnie z planem nie analizowano osób z awarią odtwarzania, zapisaną przed odkryciem klucza.” |
Gotowy podrozdział „Metoda” z komentarzem
Fragmenty są fikcyjne. Wstaw w nie swoje liczby i usuń to, czego nie zrobiłeś. Wymagania uczelni i promotora mają pierwszeństwo.
Schemat
Komentarz. Schemat międzyobiektowy nazwij wprost i dodaj jednostkę randomizacji. Gdy czynników jest więcej, podaj ich liczbę i poziomy.
Uczestnicy
Komentarz. Liczby sprzed przydziału podaj w tej części, a utratę po przydziale w wynikach. Cechy próby umieść w tabeli 1, bez testów różnic między warunkami.
Materiały i narzędzia
Komentarz. Przy skalach wieloitemowych dodaj autorów, adaptację i rzetelność. Pomiar jednym pytaniem wymień w ograniczeniach.
Losowanie, ukrycie przydziału i zaślepienie
Komentarz. To serce opisu: mówisz, kto generował listę, jak ją ukryto, kiedy poznano przydział i kto o czym nie wiedział. Długości bloków nie umieszczaj w materiałach dostępnych dla osoby rekrutującej. W raporcie końcowym podajesz je już swobodnie.
Procedura
Komentarz. Kolejność ma znaczenie, bo pytania zadane po manipulacji mogą od niej zależeć. Tak jest też w kolejności pytań w eksperymencie.
Plan analizy
Komentarz. Dlaczego ANCOVA z pomiarem wyjściowym zwykle ma przewagę nad porównaniem wyniku zmiany, wyjaśnia ANCOVA w badaniu przed i po.
Co wolno napisać we wnioskach
Z przydzielonych 144 osób w analizie zostało 137. Odpadło 7 (A: 3 rezygnacje; B: 3 rezygnacje i 1 awaria). Tak wygląda opis zaplanowanej analizy:
Obie analizy przedstaw uczciwie. Warunek A startował tu z napięciem wyższym o 2.68 punktu (SMD = 0.18), więc samo porównanie po nagraniu częściowo maskuje efekt. Taka nierównowaga po losowaniu jest przypadkowa. Dlatego główną analizę wybierasz przed badaniem i nie zmieniasz jej po obejrzeniu wyniku. W symulacji prawdziwy efekt wynosi −6, a przedział obejmuje tę wartość.
Losowy przydział daje prawo do słowa „spowodowało”, ale tylko dla tej próby, tego porównania i tego pomiaru. Przedział dla oczekiwań jest szeroki i obejmuje różnicę umiarkowaną, więc nie można jej wykluczyć.
| Wolno napisać | Nie wolno napisać | Dlaczego |
|---|---|---|
| „Wysłuchanie nagrania z ćwiczeniem oddechowym obniżyło deklarowane napięcie bardziej niż nagranie kontrolne.” | „Ćwiczenia oddechowe redukują lęk.” | Mierzono deklarowane napięcie zaraz po nagraniu, a nie lęk i nie w dłuższym czasie. |
| „Efekt dotyczył studentów badanych w warunkach laboratoryjnych.” | „Wyniki potwierdzają skuteczność metody u dorosłych.” | Próba i warunki ograniczają uogólnianie. |
| „Różnica może częściowo wynikać z oczekiwań.” | „Efekt wynika wyłącznie z techniki oddychania.” | Nagrania różniły się więcej niż samą techniką, a oczekiwań nie wykluczono. |
| „Oszacowanie było nieprecyzyjne, 95% CI [−8.55, −1.03].” | „Efekt jest duży i klinicznie istotny.” | Przedział sięga prawie zera, a próg znaczenia praktycznego nie był ustalony. |
Ograniczenia zapisz według wzoru dla ograniczeń badania.
Etyka, debriefing, CONSORT
Podaj zgodę komisji, jeśli jest wymagana, oraz sposób uzyskania świadomej zgody. Gdy ukrywasz hipotezę, napisz, co wyjaśniono na końcu w debriefingu; wyczerpująco opisuje to wpis o zwodzeniu i debriefingu.
CONSORT to wytyczne raportowania badań randomizowanych, używane przede wszystkim w naukach o zdrowiu. Ich wersja z 2025 roku to lista 30 punktów i diagram przepływu uczestników (Hopewell i in., 2025). W pracy z fizjoterapii albo pielęgniarstwa zwykle warto ją przejść, punkt po punkcie. W jednorazowym eksperymencie psychologicznym nie jest wymogiem, ale diagram przepływu i tak porządkuje opis. Zakres list omawia wpis o STROBE, CONSORT i TRIPOD.
Na co zwrócić uwagę w różnych dziedzinach
| Dziedzina | Główny akcent | Typowe pytanie recenzenta |
|---|---|---|
| Psychologia | Sprawdzenie manipulacji, oczekiwania, maskowanie celu, styl APA | Czy badani domyślili się hipotezy? |
| Nauki o zdrowiu | Opis „zwykłej opieki”, zgoda komisji, rejestracja, CONSORT | Czy przydział był ukryty? |
| Fizjoterapia | Pełny opis programu, oceniający nieznający przydziału, znaczenie kliniczne | Kto mierzył wynik i czy wiedział, w jakiej grupie jest pacjent? |
| Zarządzanie | Losowanie zespołów, przenikanie warunków, wpływ przełożonych | Czy jednostką była osoba, czy zespół? |
To obserwacje ogólne, a nie reguły.
Najczęstsze błędy
- Grupy tworzone naprzemiennie (co druga osoba) albo według dnia zgłoszenia. Taki przydział jest przewidywalny i nie jest losowy.
- Lista w rękach osoby rekrutującej. Sama sekwencja nie wystarczy, jeśli nie jest ukryta.
- Dwie klasy, po jednej na warunek. Efektu warunku nie da się oddzielić od klasy.
- Dobieranie nowych osób w miejsce rezygnujących po przydziale. Osoby po przydziale raportujesz w ich warunku, a utratę opisujesz.
- Testowanie różnic na starcie jako dowód losowania. Różnice przy losowaniu są przypadkowe, a jego poprawność wynika z procedury.
- Usuwanie osób po wyniku sprawdzenia manipulacji bez analizy wszystkich przydzielonych.
- Zmiana głównej analizy po obejrzeniu danych. Tu wynik zależałby od tej decyzji.
Lista przydziału i analiza w R
Trzy przepisy liczą wszystkie liczby z tekstu i uruchamiasz je po kolei w jednym folderze. Pierwszy liczy liczebność, drugi tworzy listę przydziału i zapisuje ją w pliku CSV, trzeci symuluje dane i wykonuje plan analizy. Do pobrania: lista-przydzialu-blokowa.csv (146 pozycji) i eksperyment-nagranie-napiecie.csv (144 osoby, dane symulowane). Rysunki powstały w osobnym skrypcie na tych samych danych.
1. Liczebność na warunek
R
# Krok 1. Ile osób na warunek: analiza mocy dla porównania dwóch warunków i zapas na utratę osób
library(pwr)
moc <- 0.80; alfa <- 0.05; ubytek <- 0.10         # założenia ustalone przed badaniem
efekty <- c(0.30, 0.40, 0.50, 0.60, 0.80)
n_warunek <- sapply(efekty, function(d)
  ceiling(pwr.t.test(d = d, power = moc, sig.level = alfa, type = "two.sample")$n))
z_zapasem <- ceiling(n_warunek / (1 - ubytek))
print(data.frame(d = efekty, n_na_warunek = n_warunek, z_zapasem = z_zapasem, razem = 2 * z_zapasem), row.names = FALSE)

# Założony efekt: d = 0.50. Liczba losowanych osób musi być parzysta przy przydziale 1:1.
n_plan <- n_warunek[efekty == 0.50]
N_los <- 2 * ceiling(n_plan / (1 - ubytek))
cat(sprintf("\nPlan: %d osób na warunek do analizy, %d osób do losowania (po %d na warunek)\n",
            n_plan, N_los, N_los / 2))
cat(sprintf("Moc, gdyby do analizy zostało po 60 osób w warunku: %.2f\n",
            pwr.t.test(n = 60, d = 0.50, sig.level = alfa, type = "two.sample")$power))
cat(sprintf("Oczekiwana połowa szerokości 95%% CI dla d przy %d osobach na warunek: %.2f\n",
            n_plan, qnorm(.975) * sqrt(2 / n_plan)))
Wynik w R
   d n_na_warunek z_zapasem razem
 0.3          176       196   392
 0.4          100       112   224
 0.5           64        72   144
 0.6           45        50   100
 0.8           26        29    58

Plan: 64 osób na warunek do analizy, 144 osób do losowania (po 72 na warunek)
Moc, gdyby do analizy zostało po 60 osób w warunku: 0.78
Oczekiwana połowa szerokości 95% CI dla d przy 64 osobach na warunek: 0.35
2. Tabela przydziału blokowego
R
# Krok 2. Lista przydziału: bloki permutowane o losowej długości (4 albo 6), przydział 1:1
set.seed(46801)
lista_blokowa <- function(n_min, dlugosci = c(4, 6), warunki = c("A", "B")) {
  bloki <- list(); suma <- 0; b <- 0
  while (suma < n_min) {
    b <- b + 1
    dl <- dlugosci[sample.int(length(dlugosci), 1)]                # losowa długość bloku
    kolejnosc <- sample(rep(warunki, each = dl / length(warunki))) # losowa kolejność w bloku
    bloki[[b]] <- data.frame(blok = b, dlugosc_bloku = dl, warunek = kolejnosc)
    suma <- suma + dl
  }
  d <- do.call(rbind, bloki)
  d$numer <- seq_len(nrow(d))
  d[, c("numer", "blok", "dlugosc_bloku", "warunek")]
}

N_los <- 144
lista <- lista_blokowa(N_los)
write.csv(lista, "lista-przydzialu-blokowa.csv", row.names = FALSE)   # plik trafia do osoby spoza badania

cat("Początek listy:\n"); print(head(lista, 12), row.names = FALSE)
cat(sprintf("\nPozycji na liście: %d, bloków: %d (długość 4: %d, długość 6: %d)\n", nrow(lista), max(lista$blok),
            sum(tapply(lista$dlugosc_bloku, lista$blok, `[`, 1) == 4),
            sum(tapply(lista$dlugosc_bloku, lista$blok, `[`, 1) == 6)))

# Liczebność i równowaga na pierwszych 144 pozycjach
pierwsze <- lista[lista$numer <= N_los, ]
cat("\nn na warunek (pierwsze 144 pozycje):\n"); print(table(pierwsze$warunek))
roznica <- cumsum(ifelse(pierwsze$warunek == "A", 1, -1))
cat(sprintf("Największa różnica A - B w trakcie rekrutacji: %d osoby\n", max(abs(roznica))))

# Dla porównania: prosta randomizacja tych samych 144 osób
set.seed(46802)
prosta <- abs(2 * rbinom(10000, N_los, 0.5) - N_los)
cat(sprintf("Prosta randomizacja, 10000 powtórzeń: różnica końcowa >= 10 w %.1f%%, >= 20 w %.1f%% list\n",
            100 * mean(prosta >= 10), 100 * mean(prosta >= 20)))
Wynik w R
Początek listy:
 numer blok dlugosc_bloku warunek
     1    1             6       B
     2    1             6       A
     3    1             6       B
     4    1             6       A
     5    1             6       B
     6    1             6       A
     7    2             6       A
     8    2             6       B
     9    2             6       B
    10    2             6       B
    11    2             6       A
    12    2             6       A

Pozycji na liście: 146, bloków: 29 (długość 4: 14, długość 6: 15)

n na warunek (pierwsze 144 pozycje):

 A  B
72 72
Największa różnica A - B w trakcie rekrutacji: 2 osoby
Prosta randomizacja, 10000 powtórzeń: różnica końcowa >= 10 w 45.6%, >= 20 w 11.3% list
3. Dane i zaplanowana analiza
R
# Krok 3. Dane z przykładu (symulowane) i analiza zaplanowana przed zdjęciem kodów A/B
set.seed(46803)
lista <- read.csv("lista-przydzialu-blokowa.csv")
d <- lista[lista$numer <= 144, c("numer", "warunek")]
n <- nrow(d)
A <- d$warunek == "A"                          # A = nagranie z ćwiczeniem oddechowym; B = nagranie kontrolne

d$napiecie_przed <- round(pmin(pmax(rnorm(n, 58, 15), 0), 100))     # napięcie 0-100 przed nagraniem
d$napiecie_po <- round(pmin(pmax(16 + 0.70 * d$napiecie_przed - 6 * A + rnorm(n, 0, 11), 0), 100))
d$skupienie_na_oddechu <- pmin(pmax(round(ifelse(A, 5.3, 2.6) + rnorm(n, 0, 1.2)), 1), 7)  # sprawdzenie manipulacji
d$oczekiwania <- pmin(pmax(round(ifelse(A, 4.5, 4.1) + rnorm(n, 0, 1.3)), 1), 7)           # oczekiwana pomoc

# Utrata po losowaniu: rezygnacja albo awaria sprzętu, zapisane przed zdjęciem kodów
d$status <- sample(c("ukończono", "rezygnacja", "awaria"), n, replace = TRUE, prob = c(.95, .03, .02))
brak <- d$status != "ukończono"
d[brak, c("napiecie_po", "skupienie_na_oddechu", "oczekiwania")] <- NA
write.csv(d, "eksperyment-nagranie-napiecie.csv", row.names = FALSE, na = "")

# Przepływ uczestników przed losowaniem (rejestr rekrutacji)
zgloszenia <- 168; niespelnia_kryteriow <- 14; nie_przyszlo <- 10
cat(sprintf("Zgłoszenia: %d; niespełnione kryteria: %d; nie przyszło: %d; wylosowano: %d\n\n",
            zgloszenia, niespelnia_kryteriow, nie_przyszlo, zgloszenia - niespelnia_kryteriow - nie_przyszlo))
cat("Status według kodu warunku:\n"); print(table(d$warunek, d$status)[, c("ukończono", "rezygnacja", "awaria")])
a <- d[d$status == "ukończono", ]
a$warunek <- factor(a$warunek, levels = c("B", "A"))        # B = poziom odniesienia
cat(sprintf("\nWylosowano: %d; do analizy: %d (A: %d, B: %d)\n", n, nrow(a), sum(a$warunek == "A"), sum(a$warunek == "B")))

opis <- function(x, g) sprintf("A: M = %.2f, SD = %.2f; B: M = %.2f, SD = %.2f",
                               mean(x[g == "A"]), sd(x[g == "A"]), mean(x[g == "B"]), sd(x[g == "B"]))
smd <- function(x, g) (mean(x[g == "A"]) - mean(x[g == "B"])) /
  sqrt((var(x[g == "A"]) + var(x[g == "B"])) / 2)
format_p <- function(p) if (p < .001) "p < .001" else paste0("p = ", sub("^0", "", sprintf("%.3f", p)))

cat("\nNapięcie przed nagraniem:", opis(a$napiecie_przed, a$warunek), sprintf("| SMD = %.2f\n", smd(a$napiecie_przed, a$warunek)))
cat("Napięcie po nagraniu:   ", opis(a$napiecie_po, a$warunek), "\n")

# Analiza główna: ANCOVA z pomiarem wyjściowym
m <- lm(napiecie_po ~ warunek + napiecie_przed, data = a)
ci <- confint(m)["warunekA", ]; s <- summary(m)$coefficients["warunekA", ]
cat(sprintf("\nANCOVA, różnica A - B: %.2f, 95%% CI [%.2f, %.2f], t(%d) = %.2f, %s\n",
            s[1], ci[1], ci[2], m$df.residual, s[3], format_p(s[4])))
sd_po <- sqrt((var(a$napiecie_po[a$warunek == "A"]) + var(a$napiecie_po[a$warunek == "B"])) / 2)
cat(sprintf("Różnica skorygowana w jednostkach SD pomiaru po nagraniu: d = %.2f, 95%% CI [%.2f, %.2f]\n",
            s[1] / sd_po, ci[1] / sd_po, ci[2] / sd_po))

# Analiza wrażliwości: same wyniki po nagraniu
w <- t.test(napiecie_po ~ warunek, data = a)
roz <- unname(w$estimate[2] - w$estimate[1])                 # A - B
d_po <- effectsize::cohens_d(a$napiecie_po[a$warunek == "A"], a$napiecie_po[a$warunek == "B"])
cat(sprintf("Test Welcha (po nagraniu), różnica A - B: %.2f, t(%.2f) = %.2f, %s, d = %.2f, 95%% CI [%.2f, %.2f]\n",
            roz, w$parameter, -w$statistic, format_p(w$p.value), d_po$Cohens_d, d_po$CI_low, d_po$CI_high))

# Sprawdzenie manipulacji i oczekiwania (pytania zadane po pomiarze napięcia)
spr <- function(zm, etykieta) {
  x <- a[[zm]]; tt <- t.test(x ~ a$warunek)
  ef <- effectsize::cohens_d(x[a$warunek == "A"], x[a$warunek == "B"])
  cat(sprintf("%s: %s; t(%.2f) = %.2f, %s, d = %.2f, 95%% CI [%.2f, %.2f]\n", etykieta, opis(x, a$warunek),
              tt$parameter, -tt$statistic, format_p(tt$p.value), ef$Cohens_d, ef$CI_low, ef$CI_high))
}
cat("\n"); spr("skupienie_na_oddechu", "Skupienie na oddechu"); spr("oczekiwania", "Oczekiwana pomoc")
Wynik w R
Zgłoszenia: 168; niespełnione kryteria: 14; nie przyszło: 10; wylosowano: 144

Status według kodu warunku:

    ukończono rezygnacja awaria
  A        69          3      0
  B        68          3      1

Wylosowano: 144; do analizy: 137 (A: 69, B: 68)

Napięcie przed nagraniem: A: M = 59.78, SD = 14.86; B: M = 57.10, SD = 15.48 | SMD = 0.18
Napięcie po nagraniu:    A: M = 52.10, SD = 17.17; B: M = 54.76, SD = 15.46

ANCOVA, różnica A - B: -4.79, 95% CI [-8.55, -1.03], t(134) = -2.52, p = .013
Różnica skorygowana w jednostkach SD pomiaru po nagraniu: d = -0.29, 95% CI [-0.52, -0.06]
Test Welcha (po nagraniu), różnica A - B: -2.66, t(133.92) = -0.95, p = .342, d = -0.16, 95% CI [-0.50, 0.17]

Skupienie na oddechu: A: M = 5.29, SD = 1.11; B: M = 2.72, SD = 1.20; t(134.01) = 13.02, p < .001, d = 2.23, 95% CI [1.80, 2.65]
Oczekiwana pomoc: A: M = 4.30, SD = 1.22; B: M = 4.01, SD = 1.25; t(134.75) = 1.37, p = .172, d = 0.23, 95% CI [-0.10, 0.57]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base, stats i utils oraz pakiety pwr i effectsize); rysunki przygotowano w pakietach ggplot2 i svglite. W pracy podaj wersje faktycznie użytych programów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Przed oddaniem podrozdziału sprawdź
- Czy opisano, co robił każdy warunek, i co było w nich stałe?
- Czy nazwano jednostkę randomizacji i zgadza się z nią analiza?
- Czy podano metodę losowania, proporcję i długość bloków?
- Czy wiadomo, kto wygenerował listę i kto ją znał przed przydziałem?
- Czy zaślepienie opisano osobno dla każdej roli?
- Czy sprawdzenie manipulacji i oczekiwania stoją po pomiarze zmiennej zależnej?
- Czy reguły wykluczeń i główna analiza powstały przed zebraniem danych?
- Czy podano liczbę osób na każdym etapie w obu warunkach?
- Czy wnioski ograniczają się do tej próby, tego porównania i tego pomiaru?
Najczęstsze pytania
Czy w pracy magisterskiej muszę stosować losowanie blokowe?
Nie jest to wymóg, ale przy kilkudziesięciu osobach na warunek bloki chronią przed wyraźnie nierównymi grupami. W przykładzie dla 144 osób prosta randomizacja dawała różnicę co najmniej 10 osób w 45.6% list. Jeśli stosujesz losowanie proste, opisz je i pokaż uzyskane liczebności.
Co zrobić, gdy ktoś zrezygnuje po otwarciu koperty?
Osoba zostaje w warunku, do którego ją przydzielono, i pojawia się w opisie przepływu jako utracona. Nie zastępuj jej nową osobą z tym samym przydziałem. Podaj powody rezygnacji w obu warunkach i sprawdź, czy utrata nie jest wyraźnie większa w jednym z nich.
Czy mogę wylosować całe grupy zajęciowe zamiast pojedynczych osób?
Możesz, ale wtedy jednostką randomizacji jest grupa, a osoby w niej są do siebie podobne. Analiza musi to uwzględnić, a liczba grup powinna być wystarczająca. Przy jednej grupie na warunek nie da się oddzielić efektu warunku od cech grupy.
Grupy po losowaniu różnią się na starcie. Czy losowanie się nie udało?
Różnica sama w sobie tego nie oznacza. Losowanie wyrównuje grupy średnio, a w konkretnym badaniu różnice przypadkowe są normalne. O poprawności świadczy procedura. Pomiar wyjściowy najlepiej uwzględnić w zaplanowanej wcześniej analizie, zamiast dopiero po fakcie decydować, co z nim zrobić.
Czy mogę napisać, że badanie było podwójnie ślepe, jeśli uczestnicy wiedzą, czego słuchają?
Lepiej tego nie pisać, bo ta etykieta bywa rozumiana różnie. Opisz każdą rolę osobno: czy uczestnicy znali hipotezę, czy prowadząca znała przydział, czy osoba analizująca dane pracowała na kodach. Jeżeli czegoś nie zaślepiono, powiedz o tym wprost w ograniczeniach.
Powiązane hasła
Przeczytaj też
Powtarzane pomiary – jak opisać metodę
Kontrbalansowanie, kwadrat łaciński i zrównoważony, odstępy, wprawa, przeniesienie, ubytek i łączenie pomiarów po kodzie – wzór metody z komentarzem i symulacja efektu kolejności w R.
Czytaj →PoradnikPorównanie grup istniejących
Pacjenci i osoby bez choroby, zawody, płeć: źródło każdej grupy, dobór grupy porównawczej, standaryzowane różnice, ANCOVA ostrożnie i gotowa metoda – z kodem R.
Czytaj →PoradnikJak opisać eksperyment ankietowy
Co napisać w metodzie i wynikach eksperymentu online: bodziec, losowanie, sprawdzenie manipulacji, schemat przepływu, efekt z CI i gotowe zdania APA.
Czytaj →PoradnikRandomizacja w praktyce
Bloki o losowej długości, warstwy, minimalizacja Pococka–Simona i ukrycie przydziału – lista przydziału w R, symulacja i wzór opisu CONSORT.
Czytaj →PoradnikWykluczanie respondentów w eksperymencie
Pytania kontrolne przed i po bodźcu, czas wypełniania, przerwania i granice Lee: które wykluczenia zachowują losowe porównanie.
Czytaj →PoradnikWarunek kontrolny w eksperymencie
Brak bodźca, placebo, status quo czy drugi bodziec? Co szacuje każda kontrola, jak zmienia efekt i jak zbudować placebo w ankiecie.
Czytaj →PoradnikRozdział metodologiczny – jak go napisać
Co napisać w każdym podrozdziale metody: hipotezy, zmienne, próba, narzędzia, procedura, etyka i plan analiz – z wzorami zdań i listą JARS.
Czytaj →Planujesz eksperyment do pracy i nie wiesz, jak opisać losowanie?
Pomożemy przygotować listę przydziału, policzyć liczebność, ustalić plan analizy i policzyć wyniki w R lub SPSS, tak żebyś umiał(a) samodzielnie opisać metodę i ją obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Altman, D. G., & Schulz, K. F. (2001). Concealing treatment allocation in randomised trials. BMJ, 323(7310), 446.1–447. https://doi.org/10.1136/bmj.323.7310.446 ● Otwarty dostęp
- Aronow, P. M., Baron, J., & Pinson, L. (2019). A note on dropping experimental subjects who fail a manipulation check. Political Analysis, 27(4), 572–589. https://doi.org/10.1017/pan.2019.5
- Boot, W. R., Simons, D. J., Stothart, C., & Stutts, C. (2013). The pervasive problem with placebos in psychology: Why active control groups are not sufficient to rule out placebo effects. Perspectives on Psychological Science, 8(4), 445–454. https://doi.org/10.1177/1745691613491271
- Efird, J. (2011). Blocked randomization with randomly selected block sizes. International Journal of Environmental Research and Public Health, 8(1), 15–20. https://doi.org/10.3390/ijerph8010015 ● Otwarty dostęp
- Ejelöv, E., & Luke, T. J. (2020). “Rarely safe to assume”: Evaluating the use and interpretation of manipulation checks in experimental social psychology. Journal of Experimental Social Psychology, 87, Article 103937. https://doi.org/10.1016/j.jesp.2019.103937 ● Otwarty dostęp: pełny tekst
- Hauser, D. J., Ellsworth, P. C., & Gonzalez, R. (2018). Are manipulation checks necessary? Frontiers in Psychology, 9, Article 998. https://doi.org/10.3389/fpsyg.2018.00998 ● Otwarty dostęp
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 statement: Updated guideline for reporting randomised trials. BMJ, 389, Article e081123. https://doi.org/10.1136/bmj-2024-081123 ● Otwarty dostęp
- Schulz, K. F., & Grimes, D. A. (2002). Blinding in randomised trials: Hiding who got what. The Lancet, 359(9307), 696–700. https://doi.org/10.1016/s0140-6736(02)07816-9
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
Cytowania BibTeX
@article{altman2001concealing, author={Altman, Douglas G. and Schulz, Kenneth F.}, title={{Concealing treatment allocation in randomised trials}}, journal={BMJ}, year={2001}, volume={323}, number={7310}, pages={446.1--447}, doi={10.1136/bmj.323.7310.446}}@article{aronow2019note, author={Aronow, Peter M. and Baron, Jonathon and Pinson, Lauren}, title={{A note on dropping experimental subjects who fail a manipulation check}}, journal={Political Analysis}, year={2019}, volume={27}, number={4}, pages={572--589}, doi={10.1017/pan.2019.5}}@article{boot2013pervasive, author={Boot, Walter R. and Simons, Daniel J. and Stothart, Cary and Stutts, Cassie}, title={{The pervasive problem with placebos in psychology: Why active control groups are not sufficient to rule out placebo effects}}, journal={Perspectives on Psychological Science}, year={2013}, volume={8}, number={4}, pages={445--454}, doi={10.1177/1745691613491271}}@article{efird2011blocked, author={Efird, Jimmy}, title={{Blocked randomization with randomly selected block sizes}}, journal={International Journal of Environmental Research and Public Health}, year={2011}, volume={8}, number={1}, pages={15--20}, doi={10.3390/ijerph8010015}}@article{ejelov2020rarely, author={Ejelöv, Emma and Luke, Timothy J.}, title={{“Rarely safe to assume”: Evaluating the use and interpretation of manipulation checks in experimental social psychology}}, journal={Journal of Experimental Social Psychology}, year={2020}, volume={87}, eid={103937}, doi={10.1016/j.jesp.2019.103937}}@article{hauser2018are, author={Hauser, David J. and Ellsworth, Phoebe C. and Gonzalez, Richard}, title={{Are manipulation checks necessary?}}, journal={Frontiers in Psychology}, year={2018}, volume={9}, eid={998}, doi={10.3389/fpsyg.2018.00998}}@article{hopewell2025consortstatement, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 statement: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081123}, doi={10.1136/bmj-2024-081123}}@article{schulz2002blinding, author={Schulz, Kenneth F. and Grimes, David A.}, title={{Blinding in randomised trials: Hiding who got what}}, journal={The Lancet}, year={2002}, volume={359}, number={9307}, pages={696--700}, doi={10.1016/s0140-6736(02)07816-9}}@book{shadish2002experimental, author={Shadish, William R. and Cook, Thomas D. and Campbell, Donald T.}, title={{Experimental and quasi-experimental designs for generalized causal inference}}, year={2002}, publisher={Houghton Mifflin}}