tbl_summary() z pakietu gtsummary.Czym jest Tabela 1 i po co ją robić
W artykułach empirycznych pierwsza tabela prawie zawsze opisuje próbę. Stąd jej potoczna nazwa: „Tabela 1”. Zawiera cechy uczestników zmierzone na początku badania, czyli demografię, cechy kliniczne i wartości wyjściowe najważniejszych zmiennych. Nie zawiera wyników testów hipotez. To czysta statystyka opisowa, ale od jej jakości zależy, czy czytelnik zrozumie resztę pracy.
Hayes-Larson i in. (2019) piszą, że dobrze zbudowana Tabela 1 pozwala ocenić zagrożenia trafności wewnętrznej i zewnętrznej. Pokazuje, kogo zbadano, czy grupy są porównywalne i na kogo można przenieść wyniki. W badaniach z randomizacją tabela jest obowiązkowa. Zarówno CONSORT 2010, jak i CONSORT 2025 wymagają tabeli cech demograficznych i klinicznych na początku badania, osobno dla każdej grupy (Hopewell i in., 2025; Moher i in., 2010). W badaniach obserwacyjnych podobny punkt ma lista STROBE (Vandenbroucke i in., 2007). Którą listę wybrać do swojego schematu, wyjaśnia wpis o wytycznych raportowania STROBE, CONSORT i TRIPOD.
Ten wpis dotyczy samej tabeli jako obiektu: co wpisać w wiersze, jak ułożyć kolumny, co zrobić z brakami i z wartościami p oraz jak wygenerować tabelę w R pakietem gtsummary. Wybór cech do opisu, wiek w przedziałach i porównanie próby z populacją omawia wpis jak opisać charakterystykę próby. Gotowe tabele dla czterech typów badań znajdziesz we wzorze charakterystyki próby.
Przykład: program redukcji stresu
Wszystkie liczby pochodzą z jednego badania symulowanego. 160 osób studiujących przydzielono losowo, po 80, do programu redukcji stresu online albo do grupy kontrolnej, czyli na listę oczekujących. Na początku zmierzono wiek, płeć, tryb studiów, pracę zarobkową, stres (PSS-10, 0–40), sen w dni powszednie i wcześniejsze korzystanie z pomocy psychologicznej. W trzech zmiennych zdarzyły się braki odpowiedzi. Dane są w pliku CSV, a kod – w sekcji Tabela 1 w R.
Wiersze: co podać przy jakiej zmiennej
Każda cecha to jeden wiersz albo blok wierszy. Sposób zapisu zależy od typu zmiennej.
| Typ zmiennej | Co podać | Przykład z badania |
|---|---|---|
| Ilościowa, rozkład zbliżony do symetrycznego | M (SD) | PSS-10: 21.62 (6.53) |
| Ilościowa, rozkład wyraźnie skośny | Me [Q1, Q3], ewentualnie zakres | wiek: 22 [21, 23], zakres 19–34 |
| Dwie kategorie (tak/nie) | jeden wiersz z n (%) dla kategorii „tak” | praca zarobkowa: 73 (47.4) |
| Kilka kategorii, także porządkowych | nagłówek cechy i n (%) dla każdej kategorii | płeć: kobieta, mężczyzna, inna lub wolę nie odpowiadać |
Zasada dla zmiennych ilościowych pochodzi wprost z objaśnień do CONSORT. Średnią i odchylenie standardowe podaje się przy rozkładach zbliżonych do symetrycznego. Przy rozkładzie asymetrycznym lepsza jest mediana z 25. i 75. centylem (Moher i in., 2010). Tak samo radzą objaśnienia do STROBE (Vandenbroucke i in., 2007). Decyzję podejmij na podstawie histogramu i skośności, a nie testu normalności. W przykładzie wiek miał skośność 1.43, więc dostał medianę i kwartyle. Stres (skośność 0.03) i sen (0.17) opisano średnią i odchyleniem standardowym.
Trzy zasady formy:
- Zmienność opisuj przez SD, nie przez błąd standardowy ani przedział ufności. Objaśnienia CONSORT nazywają je miarami wnioskowania, a nie opisu (Moher i in., 2010). Różnicę wyjaśnia hasło błąd standardowy.
- Zmiennej porządkowej o kilku kategoriach nie zamieniaj na średnią. Rok studiów czy wykształcenie opisz liczebnościami i odsetkami każdej kategorii (Moher i in., 2010).
- Przy zmiennej dwukategorialnej pokaż jedną kategorię. „Praca zarobkowa: 73 (47.4)” wystarczy, bo drugą da się odjąć. Nazwa wiersza musi jednak jasno mówić, której kategorii dotyczy liczba.
Liczbę miejsc po przecinku ustal raz dla całej tabeli: zwykle dwa dla M i SD oraz jedno dla odsetków. Szerzej o zaokrąglaniu pisze wpis statystyki opisowe w pracy. Ten wpis dotyczy jednak zmiennych badanych, a nie opisu próby.
Braki danych w Tabeli 1
STROBE wymaga, by dla każdej ważnej zmiennej podać liczbę uczestników z brakami danych. Braki mogą bowiem zniekształcić wyniki i ograniczyć ich uogólnialność (Vandenbroucke i in., 2007). W Tabeli 1 najczytelniej pokazać je w osobnym wierszu „brak danych” pod cechą, której dotyczą. Tak robi gtsummary z opcją missing = "ifany". Wiersz pojawia się tylko tam, gdzie braki wystąpiły.
Druga decyzja to mianownik procentów. Pracę zarobkową zgłosiły 73 osoby. Na pytanie odpowiedziały 154 z 160 osób, a 6 go pominęło. Od osób, które odpowiedziały, daje to 47.4%, a od całej próby – 45.6%. gtsummary domyślnie liczy odsetki od osób z odpowiedzią i w tabeli przykładowej też tak liczymy. Wybrany mianownik zapisz w nocie pod tabelą. Gdy braków jest dużo albo pochodzą głównie z jednej grupy, sam wiersz nie wystarczy. Wtedy warto zastanowić się nad ich mechanizmem (MCAR, MAR, MNAR), a praktyczne kroki opisuje wpis braki danych w ankiecie.
Hayes-Larson i in. (2019) zwracają uwagę, że przy brakach, wagach albo danych zagnieżdżonych podstawowy układ tabeli trzeba zmodyfikować. Każdą taką zmianę opisz w nocie, bo inaczej czytelnik nie odtworzy liczb.
Kolumny: ogółem i według grup
Jeśli badanie porównuje grupy, każda grupa dostaje własną kolumnę, a w nagłówku jej liczebność. Wymagają tego CONSORT dla badań z randomizacją (Moher i in., 2010) i STROBE dla badań obserwacyjnych z porównaniem grup (Vandenbroucke i in., 2007). Kolumna „Ogółem” jest opcjonalna, ale przydaje się w pracy dyplomowej, bo z niej bierzesz liczby do akapitu o uczestnikach. Stawiaj ją na początku albo na końcu, ale wszędzie w tym samym miejscu.
Ważniejsze jest to, według czego dzielisz kolumny:
- w eksperymencie i badaniu z randomizacją – według przydzielonej grupy;
- w badaniu kohortowym i przekrojowym – według ekspozycji, czyli głównego predyktora. Objaśnienia STROBE wskazują, że taki układ pokazuje związek ekspozycji z innymi cechami i potencjalnymi zmiennymi zakłócającymi (Vandenbroucke i in., 2007);
- w badaniu kliniczno-kontrolnym – według statusu przypadku i kontroli.
W ankiecie korelacyjnej bez grup wystarczy jedna kolumna. Nie dziel próby sztucznie, np. według płci, tylko po to, żeby tabela wyglądała na bogatszą.
Czy w Tabeli 1 podawać wartości p?
W badaniu z randomizacją – nie. Objaśnienia CONSORT podają prosty argument: test różnic wyjściowych sprawdza, czy różnica mogła powstać przypadkiem, a po losowaniu wiadomo, że każda różnica jest przypadkowa. Taki test nie jest błędny, tylko nielogiczny i może wprowadzać w błąd (Moher i in., 2010). Senn (1994) nazywa testy „jednorodności wyjściowej” filozoficznie nieuzasadnionymi i bezużytecznymi w praktyce. De Boer i in. (2015) dodają, że wybór kowariantów według takich testów może pominąć ważne zmienne prognostyczne. Pocock i in. (2002) w przeglądzie 50 raportów badań klinicznych z czołowych czasopism wskazali nadużywanie porównań wyjściowych i błędne użycie testów istotności jako jeden z głównych problemów.
Symulacja pokazuje, dlaczego taka kolumna prowadzi na manowce. Przy prawdziwej różnicy równej zero 4.9% wszystkich testów dało p < .05, czyli dokładnie tyle, ile wynosi poziom istotności. Im więcej cech w tabeli, tym częściej jakaś wartość p „wychodzi” (rysunek 1). Przy siedmiu cechach było tak w 29.8% badań, a przy dwudziestu – w 62.6%.
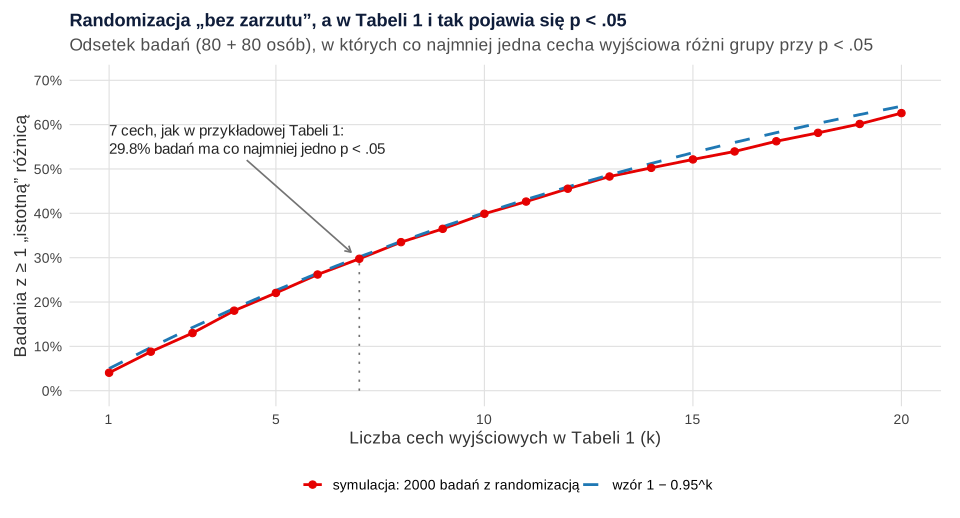
W naszym przykładzie stało się dokładnie to. Pracę zarobkową miało 58.4% osób w grupie kontrolnej i 36.4% w grupie programu. Test chi-kwadrat dał p = .006, a pozostałe testowane cechy – p od .171 do .894. Nie znaczy to, że randomizacja „się nie udała”. To przypadek, który przy siedmiu cechach zdarza się prawie w co trzecim badaniu. Według CONSORT liczy się co innego: jak silnie cecha wiąże się z wynikiem i jak duża jest przypadkowa nierównowaga (Moher i in., 2010). Do oceny jej wielkości lepiej niż p nadaje się standaryzowana różnica (Austin, 2009). Tu dla pracy wyniosła −0.45, a dla pozostałych cech od −0.22 do 0.04.
Co z tym zrobić? Zmienne prognostyczne, np. stres wyjściowy, wskaż w planie badania i uwzględnij w analizie kowariancji niezależnie od ich rozkładu wyjściowego (Senn, 1994). Nie dodawaj kowariantu tylko dlatego, że w Tabeli 1 miał p < .05. Analizę z pomiarem wyjściowym pokazuje wpis ANCOVA w badaniu przed i po, a dobór zmiennych kontrolnych – wpis czy kontrolować wiek i płeć.
W badaniach obserwacyjnych argument o losowaniu nie działa, ale wniosek jest podobny. Objaśnienia STROBE zalecają unikać testów istotności w tabelach opisowych. Dodają, że p nie jest właściwym kryterium wyboru zmiennych zakłócających, bo nawet mała różnica w silnym zakłócaczu może mieć znaczenie (Vandenbroucke i in., 2007). Jeśli promotor wymaga kolumny p, dodaj ją, ale opisz w nocie jako informację opisową, a obok podaj SMD.
Wzór Tabeli 1 w stylu APA
Poniższa tabela ma układ APA 7: numer pogrubiony, tytuł kursywą, tylko poziome linie i notę „Uwaga.” pod spodem. Zasady formy tabel omawia hasło tabela statystyk opisowych w APA i wpis tabele APA w pracy z psychologii. Przycisk kopiuje tabelę do Worda razem z formatowaniem. Wersję wygenerowaną przez gtsummary możesz też pobrać jako .docx.
Tabela 1
Charakterystyka uczestników na początku badania według grupy
| Cecha | Ogółem (N = 160) | Kontrolna (n = 80) | Program (n = 80) |
|---|---|---|---|
| Wiek w latach, Me [Q1, Q3] | 22 [21, 23] | 22 [20, 23] | 22 [21, 24] |
| Płeć, n (%) | |||
| kobieta | 114 (71.3) | 56 (70.0) | 58 (72.5) |
| mężczyzna | 37 (23.1) | 20 (25.0) | 17 (21.3) |
| inna lub wolę nie odpowiadać | 9 (5.6) | 4 (5.0) | 5 (6.3) |
| Studia niestacjonarne, n (%) | 33 (20.6) | 20 (25.0) | 13 (16.3) |
| Praca zarobkowa, n (%) | 73 (47.4) | 45 (58.4) | 28 (36.4) |
| brak danych, n | 6 | 3 | 3 |
| Stres wyjściowy (PSS-10, 0–40), M (SD) | 21.62 (6.53) | 22.15 (6.68) | 21.09 (6.38) |
| Sen w dni powszednie (godz.), M (SD) | 6.85 (0.89) | 6.84 (0.97) | 6.86 (0.79) |
| brak danych, n | 9 | 5 | 4 |
| Wcześniejsza pomoc psychologiczna, n (%) | 37 (23.7) | 18 (22.8) | 19 (24.7) |
| brak danych, n | 4 | 1 | 3 |
Uwaga. Uczestników przydzielono do grup losowo, dlatego nie podano testów istotności różnic wyjściowych. Odsetki obliczono od osób, które odpowiedziały na dane pytanie; liczbę braków podano w wierszach „brak danych”. Me – mediana; Q1, Q3 – pierwszy i trzeci kwartyl; PSS-10 – Skala Odczuwanego Stresu. Dane symulowane.
Zwróć uwagę na kilka szczegółów. Nagłówki kolumn podają liczebność grup. Wiersz „Płeć” nie ma liczb, bo jest nagłówkiem bloku kategorii. Wiersze „brak danych” podają same liczebności, a nota wyjaśnia, od czego liczono procenty. Liczebności kategorii płci sumują się do liczebności kolumny. Nie ma kolumny p, bo grupy przydzielono losowo.
Akapit, który towarzyszy tabeli
Tekst nie powtarza całej tabeli. Podaje liczebność, przydział, najważniejsze cechy i odsyła do tabeli. W pracy dyplomowej akapit trafia do podrozdziału „Uczestnicy” w rozdziale metod. Jak łączy się z dalszą częścią wyników, pokazuje przykładowy rozdział wyników.
Ostatnie zdanie wpisz tylko wtedy, gdy korektę naprawdę zaplanowano przed zebraniem danych. Zdania do opisu dalszych testów przygotuje generator opisu wyników w stylu APA.
Tabela 1 w R: pakiet gtsummary
Pakiet gtsummary tworzy w R gotowe do publikacji, reprodukowalne tabele podsumowujące przy niewielkiej ilości kodu (Sjoberg i in., 2021). Najważniejsza funkcja to tbl_summary(): argument by tworzy kolumny grup, statistic ustala zapis (np. "{mean} ({sd})"), type i value zamieniają cechy tak/nie w jeden wiersz, a missing = "ifany" dodaje wiersze z brakami. add_overall() dokłada kolumnę „Ogółem”. Przepis 1 zapisuje dane do pliku CSV i tabelę do pliku .docx. Przepis 2 to symulacja z rysunku 1.
1. Tabela 1, braki, wartości p i SMD
R
# B228 – Tabela 1: charakterystyka próby w badaniu z dwiema grupami (gtsummary)
# Dane symulowane, set.seed(2315): 160 osób studiujących przydzielonych losowo
# (po 80) do programu redukcji stresu online albo do grupy kontrolnej (lista oczekujących).
suppressPackageStartupMessages(library(gtsummary))
set.seed(2315)
n <- 160
grupa <- factor(rep(c("Kontrolna", "Program"), each = 80)[sample(n)], levels = c("Kontrolna", "Program"))
wiek <- round(19 + rgamma(n, shape = 1.6, scale = 2.2)); wiek[wiek > 52] <- 52
plec <- factor(sample(c("kobieta", "mężczyzna", "inna lub wolę nie odpowiadać"), n, TRUE, c(.68, .28, .04)),
               levels = c("kobieta", "mężczyzna", "inna lub wolę nie odpowiadać"))
tryb <- ifelse(wiek >= 25 & runif(n) < .6 | runif(n) < .12, "niestacjonarne", "stacjonarne")
praca <- rbinom(n, 1, ifelse(tryb == "niestacjonarne", .75, .4))
pss <- round(pmin(40, pmax(0, rnorm(n, 21 - 1.5 * (tryb == "niestacjonarne"), 6))))
sen <- round(rnorm(n, 6.8, 1.0), 1)
pomoc <- rbinom(n, 1, .22)
dane <- data.frame(grupa, wiek, plec, tryb, praca, pss, sen, pomoc)
dane$praca[sample(n, 6)] <- NA; dane$sen[sample(n, 9)] <- NA; dane$pomoc[sample(n, 4)] <- NA
write.csv(dane, "../tabela-1-dane-przyklad.csv", row.names = FALSE, na = "", fileEncoding = "UTF-8")

# Krok 1. Kształt rozkładów zmiennych ciągłych: decyzja M (SD) czy Me [Q1, Q3]
skos <- function(x) { x <- na.omit(x); mean((x - mean(x))^3) / sd(x)^3 }
round(sapply(dane[c("wiek", "pss", "sen")], skos), 2)

# Krok 2. Etykiety zmiennych (gtsummary używa ich w pierwszej kolumnie)
etykiety <- c(wiek = "Wiek w latach", plec = "Płeć", tryb = "Studia niestacjonarne", praca = "Praca zarobkowa",
              pss = "Stres wyjściowy (PSS-10, 0–40)", sen = "Sen w dni powszednie (godz.)",
              pomoc = "Wcześniejsza pomoc psychologiczna")
for (v in names(etykiety)) attr(dane[[v]], "label") <- etykiety[[v]]

# Krok 3. Tabela 1: kolumna „Ogółem” i kolumny grup, braki w osobnym wierszu
t1 <- tbl_summary(
  dane, by = grupa,
  type = list(c(tryb, praca, pomoc) ~ "dichotomous"),
  value = list(tryb ~ "niestacjonarne", praca ~ 1, pomoc ~ 1),
  statistic = list(all_continuous() ~ "{mean} ({sd})", wiek ~ "{median} [{p25}, {p75}]",
                   all_categorical() ~ "{n} ({p})"),
  digits = list(all_continuous() ~ 2, wiek ~ 0, all_categorical() ~ c(0, 1)),
  missing = "ifany", missing_text = "Brak danych"
) |>
  add_overall(last = FALSE, col_label = "Ogółem (N = {N})") |>
  modify_header(label ~ "Cecha", all_stat_cols(FALSE) ~ "{level} (n = {n})") |>
  modify_footnote_header("Me [Q1, Q3] dla wieku; M (SD) dla pozostałych zmiennych ciągłych; n (%)", columns = all_stat_cols())
print(as_tibble(t1, col_labels = TRUE), n = Inf, width = 120)
c(min = min(dane$wiek), max = max(dane$wiek))

# Krok 4. Odsetki z brakami: od kogo liczy gtsummary? (praca zarobkowa w całej próbie)
c(tak = sum(dane$praca, na.rm = TRUE), odpowiedzi = sum(!is.na(dane$praca)), brak = sum(is.na(dane$praca)))
round(100 * c(od_odpowiedzi = mean(dane$praca, na.rm = TRUE), od_N = sum(dane$praca, na.rm = TRUE) / n), 1)

# Krok 5. Czego NIE robić w badaniu z randomizacją: kolumna p (pokazujemy tylko dla ilustracji)
t1p <- tbl_summary(dane, by = grupa, include = -plec, type = list(c(tryb, praca, pomoc) ~ "dichotomous"),
                   value = list(tryb ~ "niestacjonarne", praca ~ 1, pomoc ~ 1), missing = "no") |>
  add_p(test = list(all_continuous() ~ "t.test", wiek ~ "wilcox.test", all_categorical() ~ "chisq.test.no.correct"),
        pvalue_fun = label_style_pvalue(digits = 3))
print(as_tibble(t1p, col_labels = FALSE)[, c("label", "p.value")], n = Inf)

# Krok 6. Zamiast p: standaryzowana różnica (SMD, Program minus Kontrolna)
smd_c <- function(x, g) { a <- x[g == "Program"]; b <- x[g == "Kontrolna"]
  (mean(a, na.rm = TRUE) - mean(b, na.rm = TRUE)) / sqrt((var(a, na.rm = TRUE) + var(b, na.rm = TRUE)) / 2) }
smd_b <- function(x, g) { p1 <- mean(x[g == "Program"], na.rm = TRUE); p0 <- mean(x[g == "Kontrolna"], na.rm = TRUE)
  (p1 - p0) / sqrt((p1 * (1 - p1) + p0 * (1 - p0)) / 2) }
round(c(wiek = smd_c(dane$wiek, dane$grupa), pss = smd_c(dane$pss, dane$grupa), sen = smd_c(dane$sen, dane$grupa),
        niestacjonarne = smd_b(dane$tryb == "niestacjonarne", dane$grupa), praca = smd_b(dane$praca, dane$grupa),
        pomoc = smd_b(dane$pomoc, dane$grupa)), 2)

# Krok 7. Zapis Tabeli 1 do Worda (flextable + officer; autor pliku: Metodolog.pl)
suppressPackageStartupMessages({ library(flextable); library(officer) })
doc <- read_docx() |> body_add_flextable(as_flex_table(t1)) |> set_doc_properties(creator = "Metodolog.pl", values = list(lastModifiedBy = "Metodolog.pl"))
print(doc, target = "../tabela-1-gtsummary.docx")
Wynik w R
wiek  pss  sen
1.43 0.03 0.17
# A tibble: 13 × 4
   Cecha                             `Ogółem (N = 160)` `Kontrolna (n = 80)` `Program (n = 80)`
   <chr>                             <chr>              <chr>                <chr>
 1 Wiek w latach                     22 [21, 23]        22 [20, 23]          22 [21, 24]
 2 Płeć                              <NA>               <NA>                 <NA>
 3 kobieta                           114 (71.3)         56 (70.0)            58 (72.5)
 4 mężczyzna                         37 (23.1)          20 (25.0)            17 (21.3)
 5 inna lub wolę nie odpowiadać      9 (5.6)            4 (5.0)              5 (6.3)
 6 Studia niestacjonarne             33 (20.6)          20 (25.0)            13 (16.3)
 7 Praca zarobkowa                   73 (47.4)          45 (58.4)            28 (36.4)
 8 Brak danych                       6                  3                    3
 9 Stres wyjściowy (PSS-10, 0–40)    21.62 (6.53)       22.15 (6.68)         21.09 (6.38)
10 Sen w dni powszednie (godz.)      6.85 (0.89)        6.84 (0.97)          6.86 (0.79)
11 Brak danych                       9                  5                    4
12 Wcześniejsza pomoc psychologiczna 37 (23.7)          18 (22.8)            19 (24.7)
13 Brak danych                       4                  1                    3
min max
 19  34
       tak odpowiedzi       brak
        73        154          6
od_odpowiedzi          od_N
         47.4          45.6
# A tibble: 6 × 2
  label                             p.value
  <chr>                             <chr>
1 Wiek w latach                     0.350
2 Studia niestacjonarne             0.171
3 Praca zarobkowa                   0.006
4 Stres wyjściowy (PSS-10, 0–40)    0.305
5 Sen w dni powszednie (godz.)      0.894
6 Wcześniejsza pomoc psychologiczna 0.781
          wiek            pss            sen niestacjonarne          praca          pomoc
          0.03          -0.16           0.02          -0.22          -0.45           0.04
2. Symulacja: ile różnic wyjściowych z p < .05 daje losowanie
R
# B228 – ile „istotnych” różnic wyjściowych daje sama randomizacja? (symulacja, set.seed(2281))
# 2000 badań z losowym przydziałem 80 + 80 osób; w każdym 20 niezależnych cech wyjściowych
# z tego samego rozkładu w obu grupach (prawdziwe różnice = 0). Każdą cechę testujemy testem t Welcha.
set.seed(2281)
R <- 2000; k_max <- 20; grupa <- rep(0:1, each = 80)
p <- t(replicate(R, {
  X <- matrix(rnorm(160 * k_max), 160, k_max)
  apply(X, 2, function(x) t.test(x[grupa == 1], x[grupa == 0])$p.value)
}))
# Odsetek wszystkich testów z p < .05 (oczekiwane: około 5%)
round(100 * mean(p < .05), 1)
# Odsetek badań z co najmniej jedną „istotną” różnicą, gdy tabela ma k cech
k <- c(1, 5, 10, 15, 20)
wynik <- data.frame(k = k,
                    symulacja = sapply(k, function(j) 100 * mean(apply(p[, 1:j, drop = FALSE] < .05, 1, any))),
                    wzor = 100 * (1 - 0.95^k))
round(wynik, 1)
Wynik w R
[1] 4.9
   k symulacja wzor
1  1       4.0  5.0
2  5      22.0 22.6
3 10      39.9 40.1
4 15      52.1 53.7
5 20      62.6 64.2
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; plik .docx utworzono w pakietach flextable i officer, a rysunek – w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- gtsummary (wersja 2.5.0): Sjoberg, D. D., Whiting, K., Curry, M., Lavery, J. A., & Larmarange, J. (2021). Reproducible summary tables with the gtsummary package. The R Journal, 13(1), 570–580. https://doi.org/10.32614/RJ-2021-053
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting [R package]. https://doi.org/10.32614/CRAN.package.flextable
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents [R package]. https://doi.org/10.32614/CRAN.package.officer
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w Tabeli 1
- Kolumna p w badaniu z randomizacją i wniosek „randomizacja się nie udała”, bo jedna cecha ma p < .05. Przy wielu cechach to normalny wynik losowania (rysunek 1).
- Zapis „±” bez wyjaśnienia. Czytelnik nie wie, czy chodzi o SD, błąd standardowy, czy przedział. Pisz M (SD) i nazwij miarę w wierszu albo w nocie.
- Średnia przy silnie skośnym rozkładzie, np. czasu choroby czy dochodu. Podaj medianę z kwartylami.
- Same odsetki bez liczebności. Z „58.4%” nie da się odtworzyć liczby osób. Zawsze pisz n (%).
- Braki ukryte w mianowniku. Odsetki liczone raz od N, a raz od osób z odpowiedzią, bez informacji w nocie.
- Wyniki główne w Tabeli 1. Tabela opisuje stan wyjściowy. Pomiar po interwencji i efekty należą do tabel wyników.
- Kategorie, które identyfikują osoby. W małych próbach połącz rzadkie kategorie, np. kierunek i rok, żeby nie dało się rozpoznać konkretnej osoby (zob. metryczka).
Tabela 1 to zwykle pierwsza tabela w rozdziale, ale nie jedyna. Plan całej analizy, od opisu próby po testy hipotez, znajdziesz w przewodniku po statystyce w pracy dyplomowej. Jeśli chcesz, żeby ktoś sprawdził Tabelę 1 i dobór analiz w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Co to jest Tabela 1 w artykule naukowym?
To pierwsza tabela artykułu empirycznego, w której opisuje się cechy uczestników na początku badania: demografię, cechy kliniczne i wartości wyjściowe ważnych zmiennych, zwykle osobno dla każdej grupy. Zawiera tylko statystyki opisowe, bez testów hipotez. W badaniach z randomizacją wymaga jej lista CONSORT (punkt 15 w wersji 2010, punkt 25 w wersji 2025).
Dlaczego w Tabeli 1 badania z randomizacją nie podaje się wartości p?
Bo test sprawdza, czy różnica mogła powstać przypadkiem, a po losowaniu wiadomo, że każda różnica jest przypadkowa (Moher i in., 2010). Przy wielu cechach któraś prawie zawsze da p < .05 – w symulacji z siedmioma cechami zdarzyło się to w 29.8% badań. Zamiast p oceń wielkość nierównowagi (np. SMD) i znaczenie cechy dla wyniku.
Czy w Tabeli 1 badania obserwacyjnego można dodać kolumnę z p?
Objaśnienia STROBE zalecają unikać testów istotności w tabelach opisowych i przypominają, że p nie jest dobrym kryterium wyboru zmiennych zakłócających (Vandenbroucke i in., 2007). Jeśli promotor albo czasopismo wymaga kolumny p, opisz ją w nocie jako informację opisową i podaj obok standaryzowane różnice.
Jak w Tabeli 1 pokazać osoby, które nie odpowiedziały na pytanie?
Dodaj pod cechą wiersz „brak danych” z liczebnością w każdej kolumnie i w nocie napisz, od czego liczono procenty. W pakiecie gtsummary robi to opcja missing = "ifany", która dodaje wiersz tylko przy zmiennych z brakami i liczy odsetki od osób z odpowiedzią.
Czy w Tabeli 1 potrzebna jest kolumna „Ogółem”?
Nie jest obowiązkowa, bo CONSORT wymaga opisu każdej grupy, a nie całej próby. W pracy dyplomowej jest jednak wygodna: z niej bierzesz liczby do akapitu o uczestnikach. Umieść ją jako pierwszą albo ostatnią kolumnę danych; w gtsummary dodaje ją funkcja add_overall().
Powiązane hasła
Przeczytaj też
Jak opisać charakterystykę próby
Które cechy opisać, średnia czy mediana wieku, przedziały wiekowe, małe kategorie i braki oraz porównanie próby z populacją – z kodem R.
Czytaj →PoradnikWzór charakterystyki próby
Gotowe tabele APA i akapity do podrozdziału „Uczestnicy” dla ankiety, dwóch grup, eksperymentu i badania z dwoma pomiarami – z plikiem .docx.
Czytaj →PoradnikSTROBE, CONSORT i TRIPOD – która lista
Jak dobrać listę raportowania do schematu badania, wypełnić ją z numerami stron i obsłużyć punkty „nie dotyczy” – z tabelą i schematem wyboru.
Czytaj →Robisz Tabelę 1 i nie wiesz, co podać przy każdej cesze?
Sprawdzimy układ tabeli, zapis zmiennych i braków oraz dobór dalszych analiz i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- de Boer, M. R., Waterlander, W. E., Kuijper, L. D. J., Steenhuis, I. H. M., & Twisk, J. W. R. (2015). Testing for baseline differences in randomized controlled trials: An unhealthy research behavior that is hard to eradicate. International Journal of Behavioral Nutrition and Physical Activity, 12(1), Article 4. https://doi.org/10.1186/s12966-015-0162-z ● Otwarty dostęp
- Hayes-Larson, E., Kezios, K. L., Mooney, S. J., & Lovasi, G. (2019). Who is in this study, anyway? Guidelines for a useful Table 1. Journal of Clinical Epidemiology, 114, 125–132. https://doi.org/10.1016/j.jclinepi.2019.06.011 ● Otwarty dostęp: pełny tekst
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., Tunn, R., Aggarwal, R., Berkwits, M., Berlin, J. A., Bhandari, N., Butcher, N. J., Campbell, M. K., Chidebe, R. C. W., Elbourne, D., Farmer, A., Fergusson, D. A., Golub, R. M., Goodman, S. N., . . . Boutron, I. (2025). CONSORT 2025 statement: Updated guideline for reporting randomised trials. BMJ, 389, Article e081123. https://doi.org/10.1136/bmj-2024-081123 ● Otwarty dostęp
- Moher, D., Hopewell, S., Schulz, K. F., Montori, V., Gøtzsche, P. C., Devereaux, P. J., Elbourne, D., Egger, M., & Altman, D. G. (2010). CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, Article c869. https://doi.org/10.1136/bmj.c869 ● Otwarty dostęp
- Pocock, S. J., Assmann, S. E., Enos, L. E., & Kasten, L. E. (2002). Subgroup analysis, covariate adjustment and baseline comparisons in clinical trial reporting: Current practice and problems. Statistics in Medicine, 21(19), 2917–2930. https://doi.org/10.1002/sim.1296
- Senn, S. (1994). Testing for baseline balance in clinical trials. Statistics in Medicine, 13(17), 1715–1726. https://doi.org/10.1002/sim.4780131703
- Sjoberg, D. D., Whiting, K., Curry, M., Lavery, J. A., & Larmarange, J. (2021). Reproducible summary tables with the gtsummary package. The R Journal, 13(1), 570–580. https://doi.org/10.32614/rj-2021-053 ● Otwarty dostęp
- Vandenbroucke, J. P., von Elm, E., Altman, D. G., Gøtzsche, P. C., Mulrow, C. D., Pocock, S. J., Poole, C., Schlesselman, J. J., Egger, M., & STROBE Initiative. (2007). Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration. PLOS Medicine, 4(10), Article e297. https://doi.org/10.1371/journal.pmed.0040297 ● Otwarty dostęp
Cytowania BibTeX
@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{deboer2015testing, author={de Boer, Michiel R. and Waterlander, Wilma E. and Kuijper, Lothar D. J. and Steenhuis, Ingrid H. M. and Twisk, Jos W. R.}, title={{Testing for baseline differences in randomized controlled trials: An unhealthy research behavior that is hard to eradicate}}, journal={International Journal of Behavioral Nutrition and Physical Activity}, year={2015}, volume={12}, number={1}, eid={4}, doi={10.1186/s12966-015-0162-z}}@article{hayeslarson2019who, author={Hayes-Larson, Eleanor and Kezios, Katrina L. and Mooney, Stephen J. and Lovasi, Gina}, title={{Who is in this study, anyway? Guidelines for a useful Table 1}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={114}, pages={125--132}, doi={10.1016/j.jclinepi.2019.06.011}}@article{hopewell2025consortstatement, author={Hopewell, Sally and Chan, An-Wen and Collins, Gary S. and Hróbjartsson, Asbjørn and Moher, David and Schulz, Kenneth F. and Tunn, Ruth and Aggarwal, Rakesh and Berkwits, Michael and Berlin, Jesse A. and Bhandari, Nita and Butcher, Nancy J. and Campbell, Marion K. and Chidebe, Runcie C. W. and Elbourne, Diana and Farmer, Andrew and Fergusson, Dean A. and Golub, Robert M. and Goodman, Steven N. and Hoffmann, Tammy C. and Ioannidis, John P. A. and Kahan, Brennan C. and Knowles, Rachel L. and Lamb, Sarah E. and Lewis, Steff and Loder, Elizabeth and Offringa, Martin and Ravaud, Philippe and Richards, Dawn P. and Rockhold, Frank W. and Schriger, David L. and Siegfried, Nandi L. and Staniszewska, Sophie and Taylor, Rod S. and Thabane, Lehana and Torgerson, David and Vohra, Sunita and White, Ian R. and Boutron, Isabelle}, title={{CONSORT 2025 statement: Updated guideline for reporting randomised trials}}, journal={BMJ}, year={2025}, volume={389}, eid={e081123}, doi={10.1136/bmj-2024-081123}}@article{moher2010consort, author={Moher, David and Hopewell, Sally and Schulz, Kenneth F. and Montori, Victor and Gøtzsche, Peter C. and Devereaux, P. J. and Elbourne, Diana and Egger, Matthias and Altman, Douglas G.}, title={{CONSORT 2010 explanation and elaboration: Updated guidelines for reporting parallel group randomised trials}}, journal={BMJ}, year={2010}, volume={340}, eid={c869}, doi={10.1136/bmj.c869}}@article{pocock2002subgroup, author={Pocock, Stuart J. and Assmann, Susan E. and Enos, Laura E. and Kasten, Linda E.}, title={{Subgroup analysis, covariate adjustment and baseline comparisons in clinical trial reporting: Current practice and problems}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={19}, pages={2917--2930}, doi={10.1002/sim.1296}}@article{senn1994testing, author={Senn, Stephen}, title={{Testing for baseline balance in clinical trials}}, journal={Statistics in Medicine}, year={1994}, volume={13}, number={17}, pages={1715--1726}, doi={10.1002/sim.4780131703}}@article{sjoberg2021reproducible, author={Sjoberg, Daniel D. and Whiting, Karissa and Curry, Michael and Lavery, Jessica A. and Larmarange, Joseph}, title={{Reproducible summary tables with the gtsummary package}}, journal={The R Journal}, year={2021}, volume={13}, number={1}, pages={570--580}, doi={10.32614/rj-2021-053}}@article{vandenbroucke2007strengthening, author={Vandenbroucke, Jan P. and von Elm, Erik and Altman, Douglas G. and Gøtzsche, Peter C. and Mulrow, Cynthia D. and Pocock, Stuart J. and Poole, Charles and Schlesselman, James J. and Egger, Matthias and {STROBE Initiative}}, title={{Strengthening the Reporting of Observational Studies in Epidemiology (STROBE): Explanation and elaboration}}, journal={PLOS Medicine}, year={2007}, volume={4}, number={10}, eid={e297}, doi={10.1371/journal.pmed.0040297}}