Losowanie chroni tylko porównanie wszystkich wylosowanych
Dane z eksperymentu w ankiecie online prawie nigdy nie są czyste. Część osób klika bez czytania, część przechodzi ankietę w dwie minuty, część przerywa zaraz po zobaczeniu bodźca. Odruch jest jeden: usunąć te osoby i analizować „porządne” odpowiedzi. W badaniu korelacyjnym to głównie kwestia mocy i reprezentatywności (zob. nieuważne odpowiedzi w ankietach online). W eksperymencie stawka jest wyższa, bo wykluczenie może zniszczyć to, po co w ogóle losowałeś warunki.
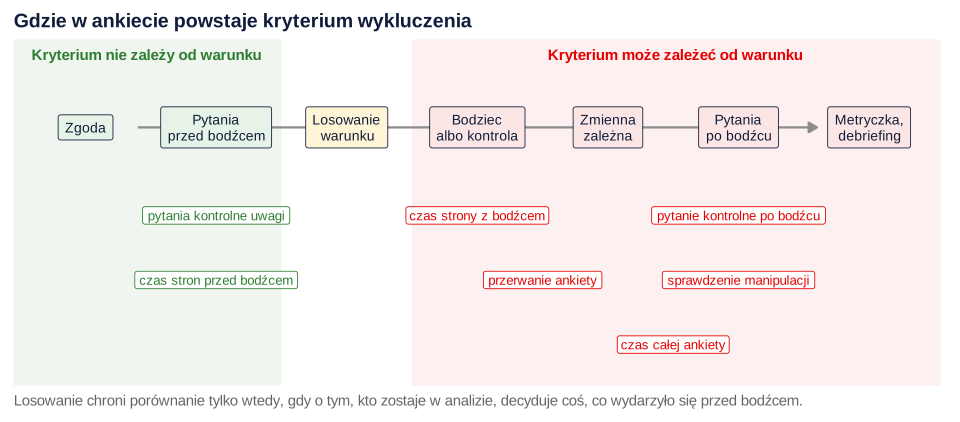
Randomizacja gwarantuje, że grupy są porównywalne w momencie losowania. Każda późniejsza selekcja zachowuje tę porównywalność tylko wtedy, gdy o tym, kto zostaje w analizie, decyduje coś, co wydarzyło się przed bodźcem. Jeśli kryterium wykluczenia może zależeć od warunku, porównujesz już inne osoby w każdej grupie. To ten sam mechanizm, który opisuje zmienna zderzeniowa: warunek i cechy respondenta wpływają na to, czy ktoś „zda” kryterium, więc selekcja na nim wiąże warunek z tymi cechami. Montgomery i in. (2018) zaliczają usuwanie obserwacji według kryteriów mierzonych po bodźcu do praktyk, które obciążają oszacowania efektów, a mimo to często pojawiają się w czołowych czasopismach.
Rysunek 1 pokazuje, gdzie w typowej ankiecie powstają kryteria wykluczeń. Ten wpis rozwija jeden krok z przewodnika eksperyment w ankiecie online krok po kroku. Kolejność pytań i kontrolowanie zmiennych zmierzonych po bodźcu w modelu omawia osobny wpis o błędzie kontrolowania zmiennych po bodźcu. Tu chodzi o to, kogo w ogóle wpuścić do analizy.
Przykład: artykuł o śnie i pięć reguł wykluczeń
W symulowanym eksperymencie 1600 osób losowo przydzielono po równo do dwóch warunków. W warunku z bodźcem respondent czyta artykuł o skutkach niedoboru snu (ok. 450 słów), w kontroli – krótką notkę o historii kalendarza (ok. 120 słów). Zmienną zależną jest zamiar ograniczenia ekranów przed snem (średnia z trzech pozycji, 1–7). Przed bodźcem ankieta mierzy zainteresowanie tematem zdrowia (1–7) i zawiera dwa pytania kontrolne. Po bodźcu, w bloku zmiennej zależnej, jest trzecie pytanie kontrolne. Program zapisuje też czas na każdej stronie.
Część osób odpowiada nieuważnie i na nie bodziec nie działa. U uważnych bodziec podnosi zamiar o 0.45 punktu. Dwa szczegóły odpowiadają za to, co dzieje się dalej. Długi artykuł męczy osoby mało zaangażowane w temat, więc częściej mylą się w pytaniu kontrolnym po bodźcu. Osoby zaangażowane czytają wolniej, a artykuł wydłuża ankietę tylko w jednym warunku. Ponieważ to symulacja, znamy prawdziwy efekt: 0.36 punktu wśród wszystkich wylosowanych i 0.43 wśród osób bez błędów w pytaniach kontrolnych przed bodźcem.
| Reguła | Wykluczeni: kontrola / bodziec | Różnica średnich [95% CI] | SMD zainteresowania |
|---|---|---|---|
| A. Wszyscy wylosowani | 0.0% / 0.0% | 0.35 [0.23, 0.48] | −0.01 |
| B. Pytania kontrolne przed bodźcem | 21.2% / 22.5% | 0.42 [0.28, 0.55] | 0.01 |
| C. Pytanie kontrolne po bodźcu | 13.5% / 30.0% | 0.53 [0.39, 0.67] | 0.19 |
| D. Czas całej ankiety < 0.5 mediany | 27.0% / 17.5% | 0.36 [0.22, 0.49] | −0.13 |
| E. Czas stron przed bodźcem < 0.5 mediany | 17.9% / 17.6% | 0.43 [0.30, 0.57] | −0.03 |
Ostatnia kolumna to standaryzowana różnica średnich zainteresowania tematem między warunkami w próbie, która zostaje po wykluczeniu. Zainteresowanie zmierzono przed bodźcem, więc w każdej uczciwie wylosowanej próbie SMD powinna być bliska zera. Tak jest dla reguł A, B i E. Reguły C i D przesuwają ją do 0.19 i −0.13. To sygnał, który możesz policzyć we własnych danych bez znajomości prawdziwego efektu.
Pytania kontrolne przed bodźcem: zmieniasz pytanie, nie psujesz porównania
Reguła B usuwa osoby, które pomyliły się w pytaniu kontrolnym przed losowaniem albo przed bodźcem. Odsetek wykluczonych jest prawie taki sam w obu warunkach (21.2% i 22.5%), bo bodziec nie mógł na niego wpłynąć. Oszacowanie 0.42, 95% CI [0.28, 0.55], jest bliskie prawdziwemu efektowi w tej grupie (0.43). Takie wykluczenie nie wprowadza obciążenia, ale zmienia estymandę: szacujesz efekt wśród osób uważnych przed bodźcem, a nie wśród wszystkich, którzy wypełnili ankietę.
To nie jest drobiazg. Berinsky i in. (2014) pokazali, że zdawanie pytań kontrolnych wiąże się z cechami respondentów. Wykluczenie osób, które je oblały, ogranicza więc uogólnianie wyników. Autorzy zalecają mierzyć uwagę kilkoma pytaniami i pokazywać wyniki warunkowo dla różnych poziomów uwagi. Kane i in. (2023) zaproponowali wariant przeznaczony dla eksperymentów: przed właściwym bodźcem wszyscy czytają ten sam krótki tekst i odpowiadają na pytania o jego treść. Miara uwagi jest wtedy wspólna dla obu warunków, a jej interakcja z warunkiem pozwala na nieobciążone testy. W ich replikacjach osoby, które lepiej odpowiadały na te pytania, reagowały na bodziec silniej.
Praktyczny wniosek: pytania kontrolne, na podstawie których chcesz wykluczać, umieść przed losowaniem albo przed bodźcem. Gdy ankieta przydziela warunek dopiero po nich (zob. randomizacja w ankiecie online), osoby wykluczone w ogóle nie trafiają do warunków i nie musisz ich raportować jako ubytku z grup.
Pytanie kontrolne po bodźcu: wykluczenie zależne od warunku
Reguła C wygląda niewinnie. To samo pytanie kontrolne, tylko umieszczone w bloku zmiennej zależnej. Ale bodziec zmienił to, kto je zdaje. W kontroli pomyliło się 13.5% osób, w warunku z artykułem 30.0% (p < .001). Odpadły głównie osoby mało zainteresowane tematem, które i tak miały niski zamiar zmiany nawyków. W warunku z bodźcem zostali więc bardziej zaangażowani niż w kontroli (SMD = 0.19), a efekt urósł do 0.53, 95% CI [0.39, 0.67].
Ten wzrost nie jest „czystszym” efektem bez szumu. Porównujesz zaangażowanych z bodźcem z przeciętnymi z kontroli. Kierunek obciążenia zależy od tego, kogo bodziec skłania do błędu. Gdyby to on wyostrzał uwagę osób o wysokich wartościach zmiennej zależnej, efekt by zmalał. Dlatego z pytania kontrolnego po bodźcu korzystaj jako z diagnozy, a nie jako kryterium wykluczenia. Policz odsetek błędów w warunkach i pokaż go w raporcie. Jeśli bardzo się różni, sam jest wynikiem: bodziec zmienił uwagę respondentów.
Sprawdzenie manipulacji to nie bramka do analizy
Najczęstsza wersja błędu z reguły C dotyczy sprawdzenia manipulacji. Osoby, które „nie zauważyły” bodźca albo nie poczuły zamierzonego stanu, kusi usunąć, żeby „analizować tylko tych, na których manipulacja zadziałała”. Aronow i in. (2019) wykazali, że wykluczanie osób, które nie zaliczyły sprawdzenia manipulacji zmierzonego po przydziale do warunku, może prowadzić do poważnego obciążenia. Zalecają analizę bez odrzucania tych osób i zmiany w projekcie badania. Symulację tego błędu na przykładzie fałszywej informacji zwrotnej znajdziesz w haśle manipulacja eksperymentalna, więc nie powtarzamy jej tutaj.
Inaczej jest z faktograficznym pytaniem o treść bodźca („O czym był artykuł?”). Kane i Barabas (2019) pokazali, że takie pytania mierzą uwagę wobec informacji eksperymentalnej, a ich miejsce w ankiecie w czterech replikacjach niewiele zmieniało efekty bodźca. To dobra miara do opisu, kto bodziec przeczytał. Do wykluczeń nadal się nie nadaje, bo odpowiedź powstaje po bodźcu, a pytania o treść długiego artykułu i krótkiej notki mogą być różnie trudne.
Czas wypełniania, gdy bodźce mają różną długość
Czas wypełniania to jeden z najlepszych wskaźników nieuważnych odpowiedzi. Leiner (2019) stwierdził, że spośród porównywanych wskaźników to właśnie czas najlepiej identyfikował bezwartościowe dane, i zaproponował indeks szybkości do rutynowego czyszczenia. Typowa reguła brzmi: wyklucz osoby, które wypełniły ankietę szybciej niż połowa mediany (zob. speeding). W eksperymencie z bodźcami różnej długości ta reguła ma ukryty warunek.
Artykuł o śnie wydłuża ankietę, ale tylko w jednym warunku. Wspólny próg policzony z całej ankiety (reguła D) łatwiej „złapać” w krótszej kontroli: wykluczył 27.0% osób w kontroli i 17.5% w warunku z bodźcem (p < .001). W kontroli odpadli też uważni, ale szybko czytający, czyli w tej symulacji mniej zaangażowani. Kontrola zrobiła się „lepsza”, SMD zainteresowania spadła do −0.13, a efekt – do 0.36, mimo że w podobnej grupie wynosi on 0.43. Ten sam próg policzony z czasu na stronach przed bodźcem (reguła E) wykluczył po równo w obu warunkach (17.9% i 17.6%) i dał 0.43, 95% CI [0.30, 0.57].
Co z tego wynika:
- Do wykluczeń używaj czasu stron sprzed bodźca. Jeśli to za mało, by wychwycić speederów, licz czas reszty ankiety bez strony z bodźcem.
- Czas na stronie z bodźcem traktuj jak sprawdzenie manipulacji: opisz go w warunkach, ale nie wykluczaj na jego podstawie.
- Progi warunkowe (połowa mediany osobno w każdym warunku) wyrównują odsetki, ale nadal wybierają osoby według reakcji na bodziec. To lepsze niż wspólny próg, lecz gorsze niż czas sprzed bodźca.
Paradane potrzebne do takich reguł opisuje wpis o paradanych w ankiecie online. O botach, których nie zatrzyma żadna reguła czasu, piszemy we wpisie o fałszywych respondentach.
Przerwania po bodźcu: wykluczenie, którego nie wybierasz
Przerwanie ankiety to wykluczenie, o którym decyduje respondent. Zhou i Fishbach (2016) opisali eksperymenty internetowe, w których odsetek przerwań sięgał 30–50% i systematycznie różnił się między warunkami. Nieuwzględniony ubytek prowadził do absurdalnych, fałszywych wniosków. Jak sprawdzić przerwania w eksporcie, omawia wpis o randomizacji. Tu zajmiemy się tym, co zrobić z analizą, gdy przerwania już się różnią (zob. też utrata uczestników).
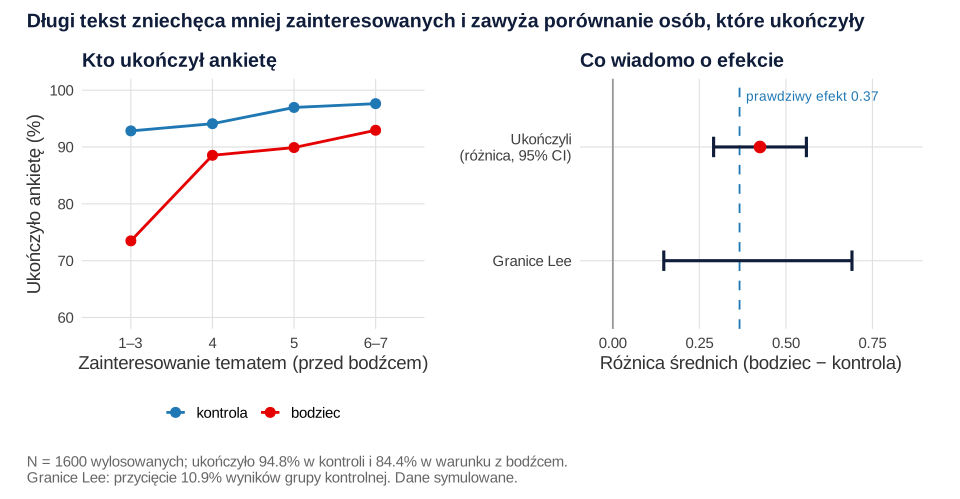
W drugiej wersji przykładu część osób przerywa tuż po bodźcu. W kontroli ankietę ukończyło 94.8% osób, w warunku z artykułem 84.4% (p < .001). Długi tekst zniechęcał głównie mniej zainteresowanych (Rysunek 2, lewy panel). Wśród osób, które ukończyły, różnica zainteresowania wyniosła SMD = 0.08. To niewiele, ale wystarczy, by porównanie ukończonych ankiet dało 0.43, 95% CI [0.29, 0.56], podczas gdy prawdziwy efekt wśród osób, które ukończyłyby ankietę w obu warunkach, wynosi 0.37.
Zmiennej zależnej osób, które przerwały, nie znasz, więc nie policzysz klasycznej analizy wszystkich wylosowanych. Możesz za to wyznaczyć granice Lee. Lee (2009) zaproponował procedurę przycinania dla sytuacji, w której wynik widać tylko u części osób, a ta część zależy od warunku. Procedura wymaga założenia, że bodziec może tylko zniechęcać do dokończenia ankiety, a nie zachęcać. W grupie z wyższym odsetkiem ukończeń (tu: kontrola) odcinasz 10.9% najwyższych albo najniższych wyników, czyli tyle, ile wynosi nadwyżka ukończeń. Dwa przycięte porównania wyznaczają przedział, w którym mieści się efekt wśród osób, które ukończyłyby ankietę niezależnie od warunku. W przykładzie granice wynoszą 0.15 i 0.69. Są szerokie, ale obie dodatnie: nawet w najgorszym razie bodziec nie obniżył zamiaru. Aronow i in. (2019) uogólnili to samo podejście na osoby, które zdałyby sprawdzenie manipulacji w każdym warunku. Granice bywają tam bardzo szerokie, co pokazuje, jak mało dane mówią o tej podgrupie.
Jeden przykład to za mało: 1000 powtórzeń
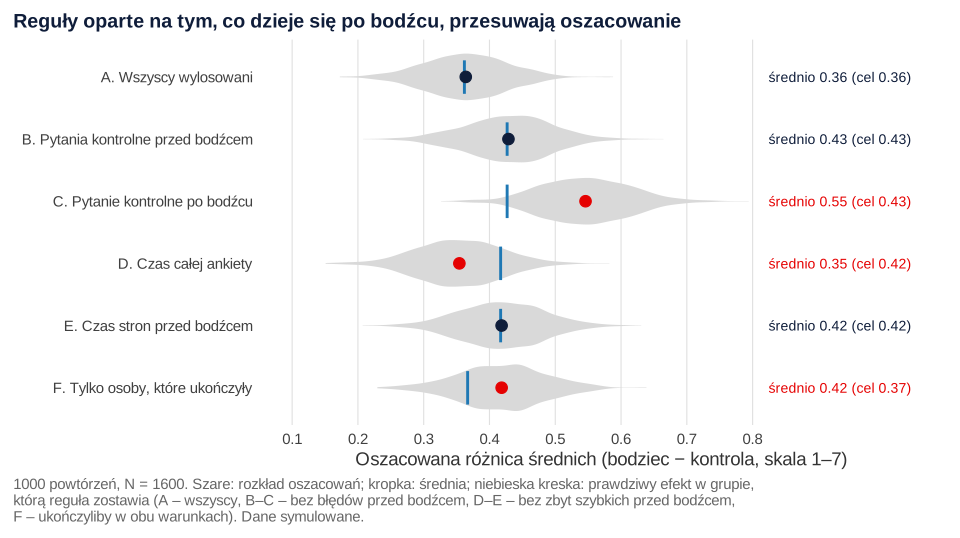
Pojedyncza próba może przypadkiem wyglądać lepiej albo gorzej. Dlatego powtórzyliśmy ten sam eksperyment 1000 razy, za każdym razem z nowymi osobami. Każdą regułę porównujemy z prawdziwym efektem w grupie, którą ona zostawia (Rysunek 3).
| Reguła | Średnie oszacowanie (SD) | Prawdziwy efekt w zostawionej grupie | Obciążenie |
|---|---|---|---|
| A. Wszyscy wylosowani | 0.364 (0.062) | 0.362 | 0.002 |
| B. Pytania kontrolne przed bodźcem | 0.429 (0.066) | 0.427 | 0.002 |
| C. Pytanie kontrolne po bodźcu | 0.546 (0.068) | 0.427 | 0.119 |
| D. Czas całej ankiety | 0.354 (0.065) | 0.418 | −0.063 |
| E. Czas stron przed bodźcem | 0.418 (0.064) | 0.418 | 0.001 |
| F. Tylko osoby, które ukończyły | 0.418 (0.066) | 0.367 | 0.051 |
Reguły oparte na informacji sprzed bodźca (A, B, E) trafiają w swój cel. Reguła C zawyża efekt o 0.119 punktu, a reguła D zaniża go o 0.063. Porównanie samych ukończonych ankiet (F) zawyża efekt o 0.051. Granice Lee średnio wynosiły od 0.150 do 0.691 i objęły prawdziwy efekt w 99.7% powtórzeń. Błąd Monte Carlo średnich nie przekracza 0.002.
Wszyscy wylosowani czy uważni? Podaj oba wyniki
Reguły A i B odpowiadają na różne pytania i obie są uprawnione. Analiza wszystkich wylosowanych, czyli odpowiednik analizy ITT, mówi, co bodziec robi w realnych warunkach, w których część ludzi czyta nieuważnie. Analiza osób uważnych przed bodźcem mówi, co robi bodziec, który ktoś przeczytał. W przykładzie to 0.35 wobec 0.42. Pierwsza liczba jest bliższa temu, czego można się spodziewać po kampanii informacyjnej. Druga – temu, czy sam przekaz działa.
Wybierz jedną analizę jako główną przed zebraniem danych, zgodnie z hipotezą. Drugą pokaż jako analizę wrażliwości. Jeśli mimo wszystko stosujesz kryterium mierzone po bodźcu, np. bo wymaga tego replikacja oryginalnego badania, podaj wynik z wykluczeniem i bez niego, odsetki wykluczonych w warunkach i SMD zmiennych sprzed bodźca w obu próbach. Jak całość opisać w metodzie i wynikach, pokazuje wpis jak opisać eksperyment ankietowy, a kolejność analiz – analiza eksperymentu ankietowego.
Kryteria wykluczeń w prerejestracji
Reguły wykluczeń to najłatwiejsze miejsce na decyzje podjęte po obejrzeniu wyników. Przy pięciu sensownie brzmiących regułach z przykładu efekt wahał się od 0.35 do 0.53. Zapisz je w planie analizy albo w prerejestracji przed startem. Podaj: brzmienie i miejsce pytań kontrolnych, próg czasu i strony, z których go liczysz, regułę dla przerwań i analizę główną. Doliczenie zapasu na wykluczenia do liczebności opisuje wpis liczebność próby w eksperymencie ankietowym. Wzór zapisu dla przykładu z tego wpisu:
Próg 5 punktów procentowych w tym wzorze jest przykładowy. Ustal własny przed zebraniem danych i uzasadnij go wielkością próby. Jeśli przygotowujesz prerejestrację eksperymentu albo recenzent kwestionuje wykluczenia, możemy wspólnie sprawdzić reguły i analizę wrażliwości w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R: drugi i trzeci korzystają z funkcji z poprzednich. Pierwszy zapisuje dane z przykładu do pliku wykluczenia-eksperyment.csv (możesz go pobrać tutaj). Wystarczą funkcje bazowe R.
1. Pięć reguł wykluczeń w jednym eksperymencie
R
# Krok 1. Pięć reguł wykluczeń w jednym eksperymencie ankietowym (dane symulowane)
# Bodziec: artykuł o skutkach niedoboru snu (ok. 450 słów); kontrola: krótka notka o historii kalendarza (ok. 120 słów).
# Zmienna zależna: zamiar ograniczenia ekranów przed snem (średnia z 3 pozycji, 1–7).
symuluj <- function(n, ubytek = FALSE) {
  zaang <- rnorm(n)                                    # zaangażowanie w temat (badacz go nie widzi)
  uwazny <- rbinom(n, 1, plogis(1.6 + 0.6 * zaang)) == 1
  d <- data.frame(id = 1:n, warunek = sample(rep(0:1, length.out = n)))   # zrównoważone losowanie 1:1
  d$zainteresowanie <- round(pmin(pmax(4 + 0.9 * zaang + rnorm(n, 0, 0.8), 1), 7))   # pytanie PRZED bodźcem
  # Dwa pytania kontrolne PRZED bodźcem (pozycje z poleceniem); błąd: 3% uważnych, 60% nieuważnych
  p_bl <- ifelse(uwazny, 0.03, 0.60)
  d$kontrola_przed <- rbinom(n, 1, p_bl) + rbinom(n, 1, p_bl)                # liczba błędów 0–2
  # Pytanie kontrolne PO bodźcu: długi artykuł męczy mało zaangażowanych, więc częściej klikają bez czytania
  p_po <- ifelse(uwazny, ifelse(d$warunek == 1, plogis(-1.7 - 1.4 * zaang), 0.03),
                 ifelse(d$warunek == 1, 0.75, 0.60))
  d$kontrola_po <- rbinom(n, 1, p_po)
  # Czasy (s): strony przed bodźcem, strona bodźca, reszta ankiety; zaangażowani czytają dłużej
  tempo <- ifelse(uwazny, 0.45 * zaang + rnorm(n, 0, 0.25), rnorm(n, 0, 0.3))
  d$czas_przed  <- round(exp(ifelse(uwazny, log(120), log(45)) + tempo))
  d$czas_bodziec <- round(exp(ifelse(uwazny, ifelse(d$warunek == 1, log(150), log(30)),
                                     ifelse(d$warunek == 1, log(15), log(8))) + tempo))
  d$czas_calosc <- d$czas_przed + d$czas_bodziec + round(exp(ifelse(uwazny, log(120), log(45)) + tempo))
  # Zmienna zależna: efekt bodźca 0.45 punktu u uważnych, 0 u nieuważnych (nie czytają tekstu)
  efekt <- ifelse(uwazny, 0.45, 0)
  y_uw <- 3.8 + 0.7 * zaang + rnorm(n)
  y_nu <- 4 + rnorm(n, 0, 1.6)
  y0 <- ifelse(uwazny, y_uw, y_nu)
  d$zamiar <- round(3 * pmin(pmax(y0 + efekt * d$warunek, 1), 7)) / 3
  d$efekt_prawdziwy <- pmin(pmax(y0 + efekt, 1), 7) - pmin(pmax(y0, 1), 7)   # znany tylko w symulacji
  if (ubytek) {   # przerwanie ankiety tuż po bodźcu: wspólna skłonność u, długi tekst dokłada odpadanie
    u <- runif(n)
    p_k <- plogis(-3.0 - 0.3 * zaang)
    p_b <- 1 - (1 - p_k) * (1 - plogis(-2.4 - 1.0 * zaang))
    d$zostal_k <- u > p_k; d$zostal_b <- u > p_b                                # stałby w kontroli / w bodźcu
    d$ukonczyl <- ifelse(d$warunek == 1, d$zostal_b, d$zostal_k)
    d$zamiar_obs <- ifelse(d$ukonczyl, d$zamiar, NA)                          # to widzi badacz
  }
  d
}

set.seed(4109)
d <- symuluj(1600)
write.csv(d[, c("id", "warunek", "zainteresowanie", "kontrola_przed", "kontrola_po", "czas_przed",
                "czas_bodziec", "czas_calosc", "zamiar")], "wykluczenia-eksperyment.csv", row.names = FALSE)

# Reguły wykluczeń (TRUE = osoba zostaje w analizie)
reguly <- list(
  "A. wszyscy wylosowani"            = rep(TRUE, nrow(d)),
  "B. kontrola przed bodźcem"        = d$kontrola_przed == 0,
  "C. kontrola po bodźcu"            = d$kontrola_po == 0,
  "D. czas całej ankiety"            = d$czas_calosc >= 0.5 * median(d$czas_calosc),
  "E. czas stron przed bodźcem"      = d$czas_przed >= 0.5 * median(d$czas_przed))

smd <- function(x, g) (mean(x[g == 1]) - mean(x[g == 0])) / sqrt((var(x[g == 1]) + var(x[g == 0])) / 2)
wynik <- t(sapply(reguly, function(z) {
  s <- d[z, ]
  tt <- t.test(zamiar ~ factor(warunek, levels = 1:0), data = s)
  c(n_kontrola = sum(s$warunek == 0), n_bodziec = sum(s$warunek == 1),
    wykl_kontrola_proc = 100 * mean(!z[d$warunek == 0]), wykl_bodziec_proc = 100 * mean(!z[d$warunek == 1]),
    roznica = unname(diff(rev(tt$estimate))), dolna = tt$conf.int[1], gorna = tt$conf.int[2],
    SMD_zainteresowanie = smd(s$zainteresowanie, s$warunek))
}))
wynik <- round(wynik, 2); wynik[, 3:4] <- round(wynik[, 3:4], 1)
wynik

# Czy odsetek wykluczonych zależy od warunku? (test dwóch proporcji dla reguł C i D)
for (r in c("C. kontrola po bodźcu", "D. czas całej ankiety")) {
  tab <- table(warunek = d$warunek, wykluczony = !reguly[[r]])
  cat(r, ": p =", format.pval(prop.test(tab)$p.value, digits = 3, eps = 0.001), "\n")
}

# Wartości prawdziwe (znane tylko w symulacji): efekt wśród wszystkich i wśród osób bez błędów przed bodźcem
round(c(efekt_wszyscy = mean(d$efekt_prawdziwy), efekt_bez_bledow_przed = mean(d$efekt_prawdziwy[reguly[[2]]])), 2)
Wynik w R
                            n_kontrola n_bodziec wykl_kontrola_proc
A. wszyscy wylosowani              800       800                0.0
B. kontrola przed bodźcem          630       620               21.2
C. kontrola po bodźcu              692       560               13.5
D. czas całej ankiety              584       660               27.0
E. czas stron przed bodźcem        657       659               17.9
                            wykl_bodziec_proc roznica dolna gorna
A. wszyscy wylosowani                     0.0    0.35  0.23  0.48
B. kontrola przed bodźcem                22.5    0.42  0.28  0.55
C. kontrola po bodźcu                    30.0    0.53  0.39  0.67
D. czas całej ankiety                    17.5    0.36  0.22  0.49
E. czas stron przed bodźcem              17.6    0.43  0.30  0.57
                            SMD_zainteresowanie
A. wszyscy wylosowani                     -0.01
B. kontrola przed bodźcem                  0.01
C. kontrola po bodźcu                      0.19
D. czas całej ankiety                     -0.13
E. czas stron przed bodźcem               -0.03
C. kontrola po bodźcu : p = <0.001
D. czas całej ankiety : p = <0.001
         efekt_wszyscy efekt_bez_bledow_przed
                  0.36                   0.43
2. Przerwania po bodźcu i granice Lee
R
# Krok 2. Ubytek po bodźcu: przerwania w warunkach, porównanie osób, które ukończyły, i granice Lee (wymaga funkcji symuluj z kroku 1)
set.seed(4064)
du <- symuluj(1600, ubytek = TRUE)

# 1. Przepływ uczestników: ilu wylosowano i ilu ukończyło ankietę w każdym warunku
tab <- table(warunek = factor(du$warunek, 0:1, c("kontrola", "bodziec")),
             ukonczyl = factor(du$ukonczyl, c(TRUE, FALSE), c("tak", "nie")))
tab
round(100 * prop.table(tab, 1), 1)
format.pval(prop.test(tab)$p.value, digits = 3, eps = 0.001)

# 2. Kto ukończył: zainteresowanie tematem (zmierzone przed bodźcem) wśród osób, które zostały
uk <- du[du$ukonczyl, ]
round(tapply(uk$zainteresowanie, uk$warunek, mean), 2)
round(smd(uk$zainteresowanie, uk$warunek), 2)

# 3. Efekt wśród osób, które ukończyły (porównanie już nie jest losowe)
tt <- t.test(zamiar_obs ~ factor(warunek, levels = 1:0), data = uk)
round(c(roznica = unname(diff(rev(tt$estimate))), tt$conf.int), 2)

# 4. Granice Lee (2009): przycinamy grupę z wyższym odsetkiem ukończeń do udziału grupy z niższym
lee <- function(y, w, r) {           # y – wynik, w – warunek 0/1, r – czy ukończył
  q <- c(mean(r[w == 0]), mean(r[w == 1]))
  wiecej <- which.max(q) - 1         # warunek z wyższym odsetkiem ukończeń (tu: kontrola)
  p <- (max(q) - min(q)) / max(q)    # odsetek do przycięcia
  y_w <- sort(y[w == wiecej & r]); k <- length(y_w); m <- round(k * (1 - p))
  dol <- mean(y_w[1:m]); gor <- mean(y_w[(k - m + 1):k])
  y_inny <- mean(y[w != wiecej & r])
  granice <- if (wiecej == 0) c(y_inny - gor, y_inny - dol) else c(dol - y_inny, gor - y_inny)
  c(przyciecie_proc = 100 * p, dolna = granice[1], gorna = granice[2])
}
round(lee(du$zamiar_obs, du$warunek, du$ukonczyl), c(1, 2, 2))

# Wartość prawdziwa (znana tylko w symulacji): efekt wśród osób, które ukończyłyby w obu warunkach
round(mean(du$efekt_prawdziwy[du$zostal_k & du$zostal_b]), 2)
Wynik w R
          ukonczyl
warunek    tak nie
  kontrola 758  42
  bodziec  675 125
          ukonczyl
warunek     tak  nie
  kontrola 94.8  5.2
  bodziec  84.4 15.6
[1] "<0.001"
   0    1
4.06 4.16
[1] 0.08
roznica
   0.43    0.29    0.56
przyciecie_proc           dolna           gorna
          10.90            0.15            0.69
[1] 0.37
3. Symulacja: 1000 powtórzeń
R
# Krok 3. 1000 powtórzeń eksperymentu: średnie oszacowanie każdej reguły i jego cel (wymaga funkcji symuluj i lee z kroków 1–2)
jedna <- function(n = 1600) {
  d <- symuluj(n, ubytek = TRUE)
  z <- list(A = rep(TRUE, n), B = d$kontrola_przed == 0, C = d$kontrola_po == 0,
            D = d$czas_calosc >= 0.5 * median(d$czas_calosc), E = d$czas_przed >= 0.5 * median(d$czas_przed))
  # A–E: wyniki wszystkich osób (wariant bez przerwań); F: tylko osoby, które ukończyły ankietę z przerwaniami
  roz <- sapply(z, function(k) mean(d$zamiar[k & d$warunek == 1]) - mean(d$zamiar[k & d$warunek == 0]))
  r <- d$ukonczyl
  F_uk <- mean(d$zamiar_obs[r & d$warunek == 1]) - mean(d$zamiar_obs[r & d$warunek == 0])
  g <- lee(d$zamiar_obs, d$warunek, r)
  c(roz, F = F_uk, lee_dolna = g[["dolna"]], lee_gorna = g[["gorna"]],
    cel_wszyscy = mean(d$efekt_prawdziwy), cel_bez_bledow_przed = mean(d$efekt_prawdziwy[z$B]),
    cel_czas_przed = mean(d$efekt_prawdziwy[z$E]), cel_ukonczyliby = mean(d$efekt_prawdziwy[d$zostal_k & d$zostal_b]))
}
set.seed(4013)
sym <- as.data.frame(t(replicate(1000, jedna())))
write.csv(sym, "symulacja-wykluczen.csv", row.names = FALSE)

# Średnie oszacowanie, jego rozrzut i cel, z którym je porównujemy
cele <- c(A = "cel_wszyscy", B = "cel_bez_bledow_przed", C = "cel_bez_bledow_przed",
          D = "cel_czas_przed", E = "cel_czas_przed", F = "cel_ukonczyliby")
podsum <- t(sapply(names(cele), function(k) c(srednia = mean(sym[[k]]), SD = sd(sym[[k]]),
                                               cel = mean(sym[[cele[[k]]]]),
                                               obciazenie = mean(sym[[k]] - sym[[cele[[k]]]]))))
round(podsum, 3)
# Granice Lee: średnie granice i odsetek powtórzeń, w których obejmują efekt wśród osób, które ukończyłyby w obu warunkach
round(c(dolna = mean(sym$lee_dolna), gorna = mean(sym$lee_gorna),
        pokrycie = mean(sym$lee_dolna <= sym$cel_ukonczyliby & sym$cel_ukonczyliby <= sym$lee_gorna)), 3)
# Błąd Monte Carlo średniej (największe SD / pierwiastek z liczby powtórzeń)
round(max(podsum[, "SD"]) / sqrt(nrow(sym)), 3)
Wynik w R
  srednia    SD   cel obciazenie
A   0.364 0.062 0.362      0.002
B   0.429 0.066 0.427      0.002
C   0.546 0.068 0.427      0.119
D   0.354 0.065 0.418     -0.063
E   0.418 0.064 0.418      0.001
F   0.418 0.066 0.367      0.051
   dolna    gorna pokrycie
   0.150    0.691    0.997
[1] 0.002
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje pakietów base i stats, m.in. t.test() i prop.test()); rysunki przygotowano w pakietach ggplot2, patchwork i svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Pytanie kontrolne po bodźcu jako kryterium wykluczenia. Bodziec może zmienić to, kto je zdaje. W przykładzie odsetek błędów wzrósł z 13.5% do 30.0%, a efekt został zawyżony.
- Usuwanie osób, które „nie zaliczyły” sprawdzenia manipulacji. To selekcja po bodźcu (Aronow i in., 2019). Pokaż wynik sprawdzenia w warunkach, a analizuj wszystkich.
- Wspólny próg czasu dla całej ankiety przy bodźcach różnej długości. Krótszy warunek traci więcej osób. Licz czas ze stron sprzed bodźca.
- Analiza samych ukończonych ankiet bez porównania przerwań w warunkach. Różny ubytek zmienia skład grup. Podaj odsetki w warunkach, SMD zmiennych sprzed bodźca i przy wyraźnej różnicy – granice Lee.
- Reguła ustalona po obejrzeniu wyników. Różne rozsądnie brzmiące reguły dają różne efekty. Zapisz jedną przed startem.
- Brak informacji, jak zmieniła się estymanda. Wykluczenie przed bodźcem jest bezpieczne, ale zawęża populację. Napisz, czy wynik dotyczy wszystkich wylosowanych, czy uważnych.
Przed uruchomieniem eksperymentu sprawdź
- Czy pytania kontrolne, na podstawie których wykluczasz, stoją przed losowaniem albo przed bodźcem?
- Czy próg czasu liczysz ze stron sprzed bodźca, a nie z całej ankiety?
- Czy żadne kryterium wykluczenia nie korzysta z pytań po bodźcu, sprawdzenia manipulacji ani czasu czytania bodźca?
- Czy eksport zawiera warunek także u osób, które przerwały po bodźcu, i stronę, na której przerwały?
- Czy masz zmienną sprzed bodźca, której SMD sprawdzisz w próbie po wykluczeniach?
- Czy prerejestracja wskazuje analizę główną (wszyscy wylosowani albo uważni), analizę wrażliwości i plan na różny ubytek?
- Czy liczebność uwzględnia zapas na wykluczenia i przerwania?
Najczęstsze pytania
Czy można wykluczyć respondentów, którzy nie zaliczyli pytania kontrolnego po bodźcu?
Lepiej nie. Bodziec może zmienić to, kto zdaje pytanie kontrolne, więc po wykluczeniu w warunkach zostają różne osoby. W przykładzie na tej stronie odsetek błędów wyniósł 13.5% w kontroli i 30.0% w warunku z bodźcem, a efekt został zawyżony. Pytanie po bodźcu traktuj jako diagnozę: podaj odsetek błędów w każdym warunku.
Gdzie umieścić pytania kontrolne uwagi w eksperymencie ankietowym?
Przed bodźcem, najlepiej przed losowaniem warunku, jeśli zamierzasz na ich podstawie wykluczać osoby. Wtedy wykluczenie nie zależy od warunku, a osoby wykluczone w ogóle nie trafiają do grup. Pamiętaj, że zmienia się populacja, której dotyczy wynik: szacujesz efekt wśród osób uważnych.
Czy wykluczać z eksperymentu osoby, które zbyt szybko wypełniły ankietę?
Tak, ale licz czas tylko ze stron sprzed bodźca. Gdy bodźce mają różną długość, wspólny próg dla całej ankiety wyklucza więcej osób w krótszym warunku. W symulacji taka reguła wykluczyła 27.0% osób w kontroli i 17.5% w warunku z bodźcem, a próg liczony ze stron sprzed bodźca – po równo.
Co to są granice Lee w eksperymencie z przerwaniami ankiety?
To przedział, w którym mieści się efekt wśród osób, które ukończyłyby ankietę w każdym warunku. W grupie z wyższym odsetkiem ukończeń przycina się najwyższe albo najniższe wyniki o nadwyżkę ukończeń i porównuje z drugą grupą. Procedura zakłada, że bodziec może tylko zniechęcać do dokończenia ankiety. Granice są zwykle szerokie, ale nie wymagają znajomości wyników osób, które przerwały.
Analizować wszystkich wylosowanych czy tylko uważnych respondentów?
To dwa różne pytania. Wszyscy wylosowani mówią, jak bodziec działa w realnych warunkach, w których część osób czyta nieuważnie; uważni przed bodźcem – jak działa przekaz, który ktoś przeczytał. Jedną analizę wskaż w prerejestracji jako główną, drugą podaj jako analizę wrażliwości.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikKolejność pytań i post-treatment bias
Co mierzyć przed bodźcem, gdzie dać sprawdzenie manipulacji i dlaczego kontrola zmiennej po bodźcu może odwrócić znak efektu.
Czytaj →PoradnikNieuważne odpowiedzi w ankietach online
Jak wykryć straightlining, losowe klikanie i speeding: longstring, IRV, D² Mahalanobisa i pytania kontrolne w R, reguła wykluczeń i opis w APA.
Czytaj →Recenzent kwestionuje wykluczenia w Twoim eksperymencie?
Pomożemy ustalić kryteria wykluczeń przed zebraniem danych, sprawdzić różny ubytek w warunkach, policzyć analizę wrażliwości i granice Lee oraz opisać decyzje tak, żebyś mógł(a) samodzielnie obronić je przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Aronow, P. M., Baron, J., & Pinson, L. (2019). A note on dropping experimental subjects who fail a manipulation check. Political Analysis, 27(4), 572–589. https://doi.org/10.1017/pan.2019.5
- Berinsky, A. J., Margolis, M. F., & Sances, M. W. (2014). Separating the shirkers from the workers? Making sure respondents pay attention on self-administered surveys. American Journal of Political Science, 58(3), 739–753. https://doi.org/10.1111/ajps.12081
- Kane, J. V., & Barabas, J. (2019). No harm in checking: Using factual manipulation checks to assess attentiveness in experiments. American Journal of Political Science, 63(1), 234–249. https://doi.org/10.1111/ajps.12396
- Kane, J. V., Velez, Y. R., & Barabas, J. (2023). Analyze the attentive and bypass bias: Mock vignette checks in survey experiments. Political Science Research and Methods, 11(2), 293–310. https://doi.org/10.1017/psrm.2023.3 ● Otwarty dostęp: pełny tekst
- Lee, D. S. (2009). Training, wages, and sample selection: Estimating sharp bounds on treatment effects. Review of Economic Studies, 76(3), 1071–1102. https://doi.org/10.1111/j.1467-937x.2009.00536.x
- Leiner, D. J. (2019). Too fast, too straight, too weird: Non-reactive indicators for meaningless data in internet surveys. Survey Research Methods, 13(3), 229–248. https://doi.org/10.18148/srm/2019.v13i3.7403 ● Otwarty dostęp
- Montgomery, J. M., Nyhan, B., & Torres, M. (2018). How conditioning on posttreatment variables can ruin your experiment and what to do about it. American Journal of Political Science, 62(3), 760–775. https://doi.org/10.1111/ajps.12357 ● Otwarty dostęp
- Zhou, H., & Fishbach, A. (2016). The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions. Journal of Personality and Social Psychology, 111(4), 493–504. https://doi.org/10.1037/pspa0000056
Cytowania BibTeX
@article{aronow2019note, author={Aronow, Peter M. and Baron, Jonathon and Pinson, Lauren}, title={{A note on dropping experimental subjects who fail a manipulation check}}, journal={Political Analysis}, year={2019}, volume={27}, number={4}, pages={572--589}, doi={10.1017/pan.2019.5}}@article{berinsky2014separating, author={Berinsky, Adam J. and Margolis, Michele F. and Sances, Michael W.}, title={{Separating the shirkers from the workers? Making sure respondents pay attention on self-administered surveys}}, journal={American Journal of Political Science}, year={2014}, volume={58}, number={3}, pages={739--753}, doi={10.1111/ajps.12081}}@article{kane2019no, author={Kane, John V. and Barabas, Jason}, title={{No harm in checking: Using factual manipulation checks to assess attentiveness in experiments}}, journal={American Journal of Political Science}, year={2019}, volume={63}, number={1}, pages={234--249}, doi={10.1111/ajps.12396}}@article{kane2023analyze, author={Kane, John V. and Velez, Yamil R. and Barabas, Jason}, title={{Analyze the attentive and bypass bias: Mock vignette checks in survey experiments}}, journal={Political Science Research and Methods}, year={2023}, volume={11}, number={2}, pages={293--310}, doi={10.1017/psrm.2023.3}}@article{lee2009training, author={Lee, David S.}, title={{Training, wages, and sample selection: Estimating sharp bounds on treatment effects}}, journal={Review of Economic Studies}, year={2009}, volume={76}, number={3}, pages={1071--1102}, doi={10.1111/j.1467-937x.2009.00536.x}}@article{leiner2019too, author={Leiner, Dominik Johannes}, title={{Too fast, too straight, too weird: Non-reactive indicators for meaningless data in internet surveys}}, journal={Survey Research Methods}, year={2019}, volume={13}, number={3}, pages={229--248}, doi={10.18148/srm/2019.v13i3.7403}}@article{montgomery2018how, author={Montgomery, Jacob M. and Nyhan, Brendan and Torres, Michelle}, title={{How conditioning on posttreatment variables can ruin your experiment and what to do about it}}, journal={American Journal of Political Science}, year={2018}, volume={62}, number={3}, pages={760--775}, doi={10.1111/ajps.12357}}@article{zhou2016pitfall, author={Zhou, Haotian and Fishbach, Ayelet}, title={{The pitfall of experimenting on the web: How unattended selective attrition leads to surprising (yet false) research conclusions}}, journal={Journal of Personality and Social Psychology}, year={2016}, volume={111}, number={4}, pages={493--504}, doi={10.1037/pspa0000056}}