Kolejność analizy ustal przed otwarciem danych
Eksperyment w ankiecie online ma prostą logikę: losowanie tworzy porównywalne grupy, więc różnica w wyniku między warunkami szacuje efekt bodźca. Mimo to analiza takich danych często zaczyna się od testów t dla każdej cechy, a kończy na modelu z kowariantami dobranymi po obejrzeniu wyników. Ten wpis pokazuje, jak przejść od surowego pliku do wyniku, który da się obronić przed recenzentem. Cały proces projektowania (bodziec, układ ankiety, randomizacja) opisuje wpis eksperyment w ankiecie online krok po kroku; tutaj zaczynamy w chwili, gdy dane są już zebrane.
Kolejność, którą zapisz w planie analizy przed zebraniem danych:
- Przepływ uczestników: ilu wylosowano do każdego warunku, ilu przerwało po bodźcu, ilu analizujesz.
- Zrównoważenie warunków: opis cech sprzed bodźca i standaryzowane różnice, bez testów istotności.
- Sprawdzenie manipulacji: czy bodziec zmienił to, co miał zmienić.
- Efekt główny: różnica średnich (albo odsetków) z 95% CI i wielkością efektu.
- Model z kowariantem sprzed bodźca: to samo porównanie z większą precyzją.
- Kilka warunków: kontrasty zaplanowane zamiast wszystkich par.
- Moderacja i podgrupy: tylko zapisane wcześniej, testem interakcji.
Cumming (2014) zaleca, by zamiast samego testowania istotności opierać wnioski na estymacji: wielkościach efektów i przedziałach ufności. Ta zasada prowadzi przez cały wpis. Każdy krok kończy się liczbą z przedziałem, a nie samym „istotne / nieistotne”.
Przykład: trzy komunikaty o oszczędzaniu energii
Przykład (dane symulowane). Respondenci panelu internetowego najpierw podawali wiek, płeć i postawę proekologiczną (skala 1–7). Potem ankieta losowo pokazywała jeden z trzech tekstów: neutralną informację o sezonie grzewczym (kontrola), informację o kosztach ogrzewania (koszty) albo informację, że większość sąsiadów obniżyła temperaturę w domu (norma społeczna). Po bodźcu padało pytanie sprawdzające manipulację, a następnie trzy pozycje o gotowości do oszczędzania energii (średnia, skala 1–7; wynik główny). Na końcu respondent mógł zapisać się na bezpłatny poradnik (tak/nie; wynik dodatkowy).
| Etap | Kontrola | Koszty | Norma | Razem |
|---|---|---|---|---|
| Wylosowani (doszli do bodźca) | 442 | 416 | 432 | 1290 |
| Przerwali po bodźcu | 15 (3.4%) | 20 (4.8%) | 9 (2.1%) | 44 |
| Ukończyli (analiza główna) | 427 | 396 | 423 | 1246 |
Liczebności warunków nie są równe, bo narzędzie losowało każdą osobę niezależnie. To nie jest błąd. Sprawdź natomiast, czy odsetek przerwań nie różni się wyraźnie między warunkami. Tu wynosił od 2.1% do 4.8% (test χ², p = .092), więc trudno mówić o selektywnym ubytku. Ten test dotyczy procedury, a nie cech grup. Gdy jeden bodziec częściej zniechęca do dokończenia ankiety, osoby, które ją ukończyły, przestają być grupami z losowania. Co wtedy robić i dlaczego nie wolno wykluczać osób według kryteriów mierzonych po bodźcu, omawia wpis wykluczanie respondentów w eksperymencie.
Zrównoważenie warunków: SMD zamiast testów
Tabela charakterystyk według warunków służy do opisu, a nie do weryfikacji losowania. W poprawnie zrandomizowanych danych każda różnica wyjściowa jest z definicji przypadkowa. Senn (1994) nazywa testy jednorodności wyjściowej nieuzasadnionymi i potencjalnie mylącymi. Zaleca wskazać zmienne prognostyczne w planie i uwzględnić je w analizie niezależnie od tego, jak się rozłożyły. Mutz i in. (2019) pokazują, że rutynowe testy równowagi w danych z czystą randomizacją prowadzą do błędnych decyzji analitycznych. Wpis o eksperymencie split-ballot omawia ten problem na przykładzie dwóch wersji pytania.
Zamiast testów policz standaryzowaną różnicę średnich (SMD): różnicę średnich podzieloną przez wspólne odchylenie standardowe. Ta miara nie zależy od liczebności, w przeciwieństwie do p. Austin (2009) opisuje ją wraz z innymi metodami porównywania rozkładów cech między grupami. W naszych danych największa różnica dotyczyła postawy proekologicznej w warunku „koszty” (SMD = −0.113). Średnia postawy wyniosła tam 4.59 wobec 4.70 w kontroli (rysunek 1).
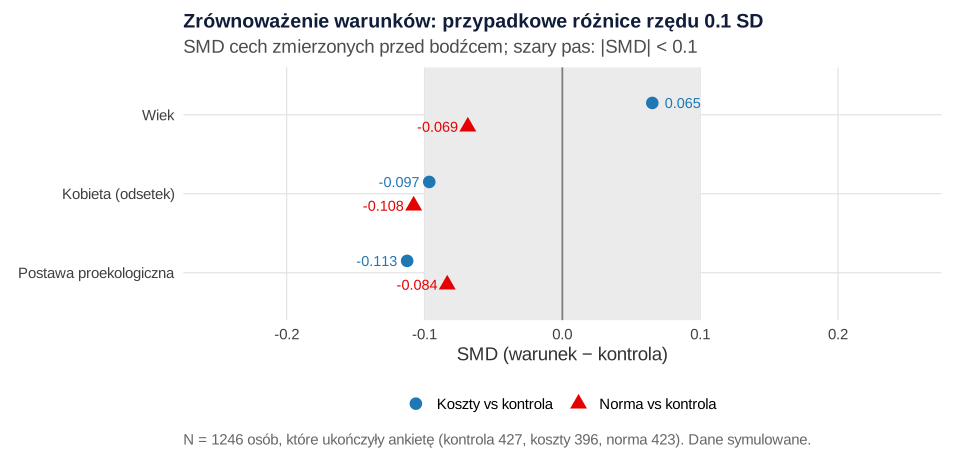
Wartość 0.1 jako próg „dobrego” zrównoważenia to powszechna reguła kciuka, ale w eksperymencie nie służy do decyzji. Nawet SMD = −0.113 nie oznacza, że losowanie zawiodło. Oznacza tylko, że warto było z góry zaplanować korektę o postawę, bo silnie przewiduje wynik. Mutz (2011) zalicza sprawdzanie randomizacji testami i nadużywanie kowariantów do częstych problemów analizy eksperymentów sondażowych.
Sprawdzenie manipulacji: osobny wynik, nie filtr
Sprawdzenie manipulacji pytało, czy tekst wspominał, co robią inni mieszkańcy. Odpowiedź „tak” wybrało 11.0% osób w kontroli, 17.7% w warunku „koszty” i 84.2% w warunku „norma”. Bodziec normy był więc zauważony, a dwa pozostałe teksty nie sugerowały normy. Tak właśnie analizuj to pytanie: jako osobną zmienną zależną, z odsetkami (lub średnimi) w warunkach i różnicą z przedziałem ufności.
Nie usuwaj osób, które „nie zdały” sprawdzenia, i nie wstawiaj tej zmiennej do modelu efektu. Jest mierzona po bodźcu, więc sama od niego zależy. Usunięcie lub kontrola takiej zmiennej niszczy porównywalność grup stworzoną przez losowanie. Mechanizm ten szerzej opisuje wpis o kolejności pytań i błędzie kontrolowania zmiennych po bodźcu. Ta sama zasada dotyczy kowariantów: do modelu trafiają tylko cechy zmierzone przed bodźcem.
Efekt główny: różnica średnich z CI i d
Gotowość do oszczędzania wyniosła M = 4.91 (SD = 1.25) w kontroli, 4.94 (1.27) w warunku „koszty” i 5.08 (1.34) w warunku „norma”. Najprostsze porównanie każdego bodźca z kontrolą to test Welcha z różnicą średnich i przedziałem ufności oraz d Cohena:
| Porównanie | Różnica (95% CI) | Test Welcha | d (95% CI) |
|---|---|---|---|
| Koszty − kontrola | 0.03 [−0.14, 0.21] | t(814.7) = 0.37, p = .709 | 0.03 [−0.11, 0.16] |
| Norma − kontrola | 0.18 [0.00, 0.35] | t(843.0) = 1.97, p = .049 | 0.14 [0.00, 0.27] |
Bez kowariantów efekt normy jest na granicy: przedział ufności dotyka zera. Efekt kosztów jest bliski zera, ale przedział sięga 0.21 punktu, więc nie wyklucza małej korzyści. To uczciwy wynik analizy nieskorygowanej. Ta analiza powinna zawsze znaleźć się w raporcie, bo jest najbardziej przejrzysta. Przy skali punktowej podawaj różnicę w punktach skali, a d traktuj jako uzupełnienie do porównań między badaniami.
ANCOVA z kowariantem sprzed bodźca i estymator Lina
Postawa proekologiczna została zmierzona przed bodźcem i silnie wiąże się z gotowością. Model z kowariantami (ANCOVA) wyjaśniał 37.3% wariancji wyniku. Każda część wariancji wyjaśniona przez kowarianty znika z błędu, więc oszacowanie efektu staje się dokładniejsze. W eksperymencie to jest jedyny cel kowariantów: precyzja, a nie „kontrola nierówności” grup, bo losowanie już zapewniło nieobciążone porównanie.
Kowariant w tym wpisie to inna zmienna niż wynik. Gdy kowariantem jest pomiar tej samej zmiennej przed interwencją, dochodzi wybór między ANCOVA a wynikiem różnicowym. Opisują go wpisy ANCOVA w badaniu przed i po oraz paradoks Lorda.
Freedman krytykował korektę regresyjną w eksperymentach. Wskazywał, że może ona pogorszyć precyzję, dać nieprawidłowe błędy standardowe i obciążenie w małych próbach. Lin (2013) pokazał, że w dostatecznie dużych próbach te problemy są niewielkie albo łatwe do usunięcia. Wystarczą dwa elementy:
- Interakcje warunek × kowariant. Wycentruj kowarianty (odejmij średnią) i dodaj ich interakcje z warunkiem. Tak skorygowana regresja nie pogarsza asymptotycznej precyzji, a współczynnik przy warunku to efekt przy średnich kowariantów.
- Odporny błąd standardowy. Asymptotycznie poprawne przedziały daje estymator kanapkowy Hubera–White’a. W eksperymentach często używa się wersji HC2. Przy małych próbach (N ≤ 250) Long i Ervin (2000) zalecają wersję HC3 (zob. odporne błędy standardowe). Odporny błąd stosuj z góry, a nie po teście heteroskedastyczności.
| Model | Koszty − kontrola | Norma − kontrola |
|---|---|---|
| Bez kowariantów | 0.033 (SE 0.088) [−0.140, 0.206] | 0.176 (SE 0.089) [0.001, 0.350] |
| ANCOVA (postawa, wiek, płeć) | 0.119 (SE 0.072) [−0.023, 0.261] | 0.245 (SE 0.069) [0.110, 0.379] |
| Lin (te same kowarianty + interakcje) | 0.114 (SE 0.073) [−0.028, 0.257] | 0.248 (SE 0.069) [0.113, 0.383] |
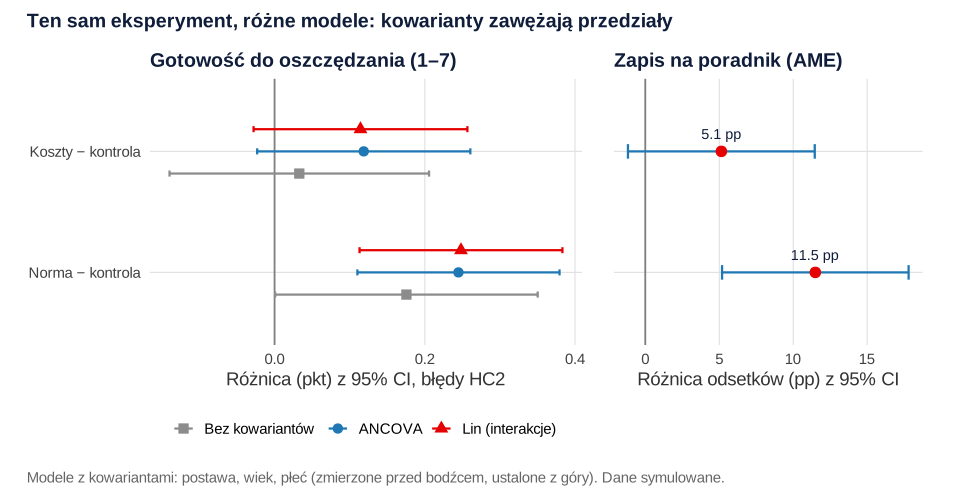
Błąd standardowy efektu normy spadł z 0.089 do 0.069, czyli o około 23%. Oszacowania przesunęły się w górę, bo w warunkach z bodźcem postawa była przypadkowo nieco niższa niż w kontroli (SMD od −0.084 do −0.113). Model skorygował tę przypadkową różnicę. Właśnie dlatego zestaw kowariantów musi być ustalony przed analizą. Gdy wybierasz model po obejrzeniu, który daje mniejsze p, wchodzisz w ogród rozwidlających się ścieżek. Lin (2013) wymienia to ryzyko poszukiwania specyfikacji, obok przejrzystości, jako najmocniejszy argument za analizą bez korekty. Dlatego podawaj obie analizy, a za główną uznaj tę zapisaną w planie.
Jednego badania nie należy traktować jako dowodu, że korekta „zawsze daje większy efekt”. W tym przykładzie przesunęła oszacowania w górę, w innej próbie mogłaby je obniżyć. Pokazuje to symulacja 2000 eksperymentów z prawdziwym efektem 0.35 punktu (rysunek 3). Średnie oszacowanie wyniosło 0.349 w każdej metodzie, ale odchylenie standardowe oszacowań spadło z 0.096 do 0.077 (o 19.7%). Moc wzrosła z .947 do .996. Pokrycie 95% CI z błędami HC2 wyniosło .954 we wszystkich trzech modelach (błąd Monte Carlo .005). ANCOVA i model Lina dały tu praktycznie to samo, bo efekt prawie nie zależał od postawy. Interakcje są zabezpieczeniem na wypadek, gdyby zależał, zwłaszcza przy nierównych liczebnościach warunków.
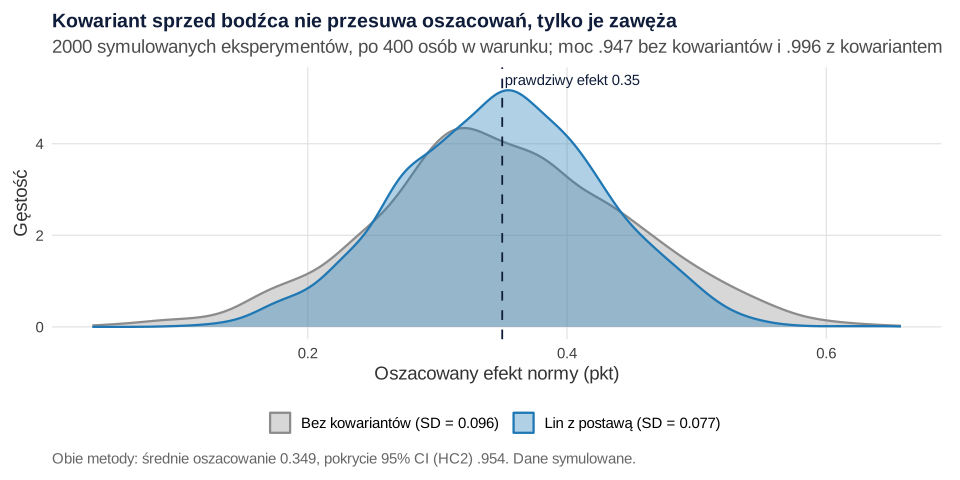
Zysk z kowariantu można zaplanować już przy wyznaczaniu liczebności: im silniej kowariant przewiduje wynik, tym mniejszej próby potrzebujesz. Rachunek pokazuje wpis liczebność próby w eksperymencie ankietowym.
Kilka warunków: kontrasty zaplanowane zamiast wszystkich par
Przy trzech warunkach odruch podpowiada ANOVA i testy post hoc dla wszystkich par. Hipotezy tego badania dotyczyły jednak dwóch porównań: każdego bodźca z kontrolą. Zapisz je jako kontrasty planowane i testuj tylko je, z poprawką Holma na dwa testy. Pakiet emmeans liczy je bezpośrednio z modelu Lina, z macierzą kowariancji HC2:
- norma − kontrola: 0.248 pkt, 95% CI [0.113, 0.383], t(1234) = 3.60, p < .001 (po korekcie Holma);
- koszty − kontrola: 0.114 pkt, 95% CI [−0.028, 0.257], t(1234) = 1.58, p = .116 (po korekcie Holma).
Pełny zestaw par metodą Tukeya dodaje porównanie „koszty − norma” (−0.134, p = .157) i podnosi skorygowane p dla pozostałych. Jeśli porównania między bodźcami nie było w hipotezach, podaj je jako eksploracyjne. Więcej o budowie wag kontrastów i analizie trendu piszemy we wpisie kontrasty planowane i analiza trendu.
Moderacja i podgrupy: tylko zaplanowane
W planie zapisano jeden moderator: postawę proekologiczną. Hipoteza mówiła, że norma działa silniej na osoby o wyższej postawie. Test łączny obu interakcji warunek × postawa (błędy HC2) dał F(2, 1238) = 1.97, p = .139. Interakcja dla normy wyniosła 0.013 pkt na punkt postawy (p = .826), więc dane nie wspierają tej hipotezy. Nie szukaj wtedy innej cechy, przy której „wyjdzie” różnica. Każda dodatkowa podgrupa to kolejna szansa na fałszywy wynik. Wpis analiza podgrup – kiedy jej wierzyć pokazuje w symulacji, jak szybko to ryzyko rośnie, i omawia kryteria wiarygodności.
Wynik tak/nie albo porządkowy: przeciętny efekt krańcowy
Na poradnik zapisało się 30.7% osób w kontroli, 34.8% w warunku „koszty” i 41.6% w warunku „norma”. Bez kowariantów różnica odsetków dla normy to 10.9 punktu procentowego, 95% CI [4.5, 17.4], p = .001. Model logistyczny z tymi samymi kowariantami daje ilorazy szans 1.27 (koszty) i 1.68 (norma). Ilorazy szans z modelu z kowariantami są jednak warunkowe: zmieniają się zależnie od tego, jakie kowarianty trafiły do modelu, nawet gdy grupy są zrównoważone. Do opisu efektu eksperymentu lepiej nadaje się różnica odsetków.
Taką różnicę z modelu z kowariantami daje przeciętny efekt krańcowy (AME). To średnia, po wszystkich respondentach, różnicy przewidywanego prawdopodobieństwa „tak” w warunku z bodźcem i w kontroli. Hanmer i Kalkan (2013) zalecają właśnie to podejście wartości obserwowanych zamiast efektu dla „przeciętnego przypadku”. Funkcja avg_comparisons() z pakietu marginaleffects dała AME dla normy 11.5 pp, 95% CI [5.2, 17.8], p < .001, a dla kosztów 5.1 pp, 95% CI [−1.2, 11.5], p = .110. Przy wyniku binarnym zysk precyzji z kowariantów był tu niewielki (SE 0.0322 wobec 0.0328).
Wynik porządkowy, np. pojedynczą pozycję Likerta, możesz analizować regresją porządkową i tak samo przeliczyć na różnice prawdopodobieństw kategorii. Jedna liczba (iloraz szans) rzadko wystarcza czytelnikowi, który chce wiedzieć, o ile procent więcej osób wybrało odpowiedź „zdecydowanie tak”.
Jak opisać wynik
Najpierw nazwij estymandę, czyli to, co szacujesz: przeciętny efekt bodźca wśród osób, które ukończyły ankietę. Zacznij od analizy nieskorygowanej, potem podaj model zapisany w planie, kontrasty i wynik dodatkowy. Gerber i Green (2012) to dobry podręcznik do szerszego kontekstu planowania, analizy i interpretacji eksperymentów randomizowanych. Pełny schemat sekcji metody i wyników opisuje wpis jak opisać eksperyment ankietowy. Wzór akapitu wyników:
Przykład w R
Przepisy 1–3 uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z obiektu a). Przepis 4 jest niezależny. Pierwszy zapisuje dane analizowane w tekście do pliku eksperyment-ankietowy.csv (możesz go pobrać).
1. Dane, przepływ, zrównoważenie i sprawdzenie manipulacji
R
# Krok 1. Dane, przepływ uczestników, zrównoważenie (SMD) i sprawdzenie manipulacji (dane symulowane)
# Eksperyment w ankiecie online: czy informacja o kosztach albo o normie społecznej zwiększa
# deklarowaną gotowość do oszczędzania energii w domu (średnia 3 pozycji, skala 1–7)?
# Przed bodźcem: wiek, płeć, postawa proekologiczna (1–7). Po bodźcu: sprawdzenie manipulacji,
# gotowość (wynik główny), zapis na bezpłatny poradnik (wynik binarny).
options(width = 110)
set.seed(4031)
n <- 1290                                                     # osoby, które wyraziły zgodę i doszły do bodźca
d <- data.frame(id = 1:n,
                warunek = factor(sample(c("kontrola", "koszty", "norma"), n, replace = TRUE),
                                 levels = c("kontrola", "koszty", "norma")),
                wiek = round(pmin(pmax(rnorm(n, 41, 13), 18), 75)),
                kobieta = rbinom(n, 1, .55),
                postawa = round(pmin(pmax(rnorm(n, 4.6, 1.1), 1), 7), 2))
efekt <- c(kontrola = 0, koszty = 0.15, norma = 0.35)[as.character(d$warunek)]
pc <- d$postawa - 4.6
d$gotowosc <- round(pmin(pmax(1.6 + 0.7 * d$postawa + efekt + 0.12 * pc * (d$warunek == "norma") +
                              rnorm(n, 0, 1.1), 1), 7), 2)
d$sprawdzenie <- rbinom(n, 1, c(kontrola = .12, koszty = .18, norma = .81)[as.character(d$warunek)])
d$poradnik <- rbinom(n, 1, plogis(-0.9 + 0.5 * pc + c(kontrola = 0, koszty = 0.15, norma = 0.45)[as.character(d$warunek)]))
d$ukonczyl <- rbinom(n, 1, c(kontrola = .965, koszty = .955, norma = .96)[as.character(d$warunek)])

# Przepływ: wylosowani, przerwania po bodźcu, ukończyli (analiza główna)
przeplyw <- rbind(wylosowani = table(d$warunek), przerwali = table(d$warunek[d$ukonczyl == 0]),
                  ukonczyli = table(d$warunek[d$ukonczyl == 1]))
print(addmargins(przeplyw, 2))
round(prop.table(table(d$warunek, d$ukonczyl), 1)[, "0"], 3)  # odsetek przerwań w warunkach
chisq.test(table(d$warunek, d$ukonczyl))$p.value             # kontrola ubytku różnicowego (procedura, nie równowaga)

a <- subset(d, ukonczyl == 1)
write.csv(a, "eksperyment-ankietowy.csv", row.names = FALSE)

# Zrównoważenie cech sprzed bodźca: standaryzowana różnica średnich (SMD) względem kontroli, bez testów
smd <- function(x, g, ref = "kontrola") {
  sapply(setdiff(levels(g), ref), function(k) {
    x1 <- x[g == k]; x0 <- x[g == ref]
    (mean(x1) - mean(x0)) / sqrt((var(x1) + var(x0)) / 2)
  })
}
opis <- aggregate(cbind(wiek, kobieta, postawa) ~ warunek, data = a, FUN = mean)
print(cbind(opis[1], round(opis[-1], 2)), row.names = FALSE)
round(sapply(c("wiek", "kobieta", "postawa"), function(v) smd(a[[v]], a$warunek)), 3)

# Sprawdzenie manipulacji: „Czy tekst wspominał, co robią inni mieszkańcy?” (odsetek odpowiedzi „tak”)
round(tapply(a$sprawdzenie, a$warunek, mean), 3)
Wynik w R
           kontrola koszty norma  Sum
wylosowani      442    416   432 1290
przerwali        15     20     9   44
ukonczyli       427    396   423 1246
kontrola   koszty    norma
   0.034    0.048    0.021
[1] 0.09185902
  warunek  wiek kobieta postawa
 kontrola 41.34    0.58    4.70
   koszty 42.17    0.53    4.59
    norma 40.47    0.53    4.61
         wiek kobieta postawa
koszty  0.065  -0.097  -0.113
norma  -0.069  -0.108  -0.084
kontrola   koszty    norma
   0.110    0.177    0.842
2. Różnica średnich, ANCOVA, estymator Lina, kontrasty i moderacja
R
# Krok 2. Efekt główny: różnica średnich z CI i d, ANCOVA, estymator Lina z błędami HC2,
# kontrasty zaplanowane (emmeans) i prerejestrowany test moderacji (wymaga obiektu a z kroku 1)
suppressPackageStartupMessages({library(sandwich); library(lmtest); library(emmeans); library(effectsize)})
options(width = 110)
a$warunek <- factor(a$warunek, levels = c("kontrola", "koszty", "norma"))
round(cbind(n = table(a$warunek), M = tapply(a$gotowosc, a$warunek, mean),
            SD = tapply(a$gotowosc, a$warunek, sd)), 2)

# 1. Bez kowariantów: różnica średnich (test Welcha) i d Cohena z 95% CI, każdy warunek wobec kontroli
for (k in c("koszty", "norma")) {
  x <- a$gotowosc[a$warunek == k]; y <- a$gotowosc[a$warunek == "kontrola"]
  tt <- t.test(x, y)                                          # test Welcha: warunek − kontrola
  dd <- cohens_d(x, y)                                        # d z SD połączonym, 95% CI
  cat(sprintf("%s − kontrola: różnica = %.3f, 95%% CI [%.3f, %.3f], t(%.1f) = %.2f, p = %s, d = %.2f [%.2f, %.2f]\n",
              k, mean(x) - mean(y), tt$conf.int[1], tt$conf.int[2], tt$parameter, tt$statistic,
              sub("^0", "", sprintf("%.3f", tt$p.value)),
              dd$Cohens_d, dd$CI_low, dd$CI_high))
}

# 2. Trzy modele regresji z błędami HC2: bez kowariantów, ANCOVA, Lin (interakcje z wycentrowanymi kowariantami)
a$postawa_c <- a$postawa - mean(a$postawa); a$wiek_c <- a$wiek - mean(a$wiek); a$kobieta_c <- a$kobieta - mean(a$kobieta)
m0 <- lm(gotowosc ~ warunek, data = a)
m1 <- lm(gotowosc ~ warunek + postawa_c + wiek_c + kobieta_c, data = a)
m2 <- lm(gotowosc ~ warunek * (postawa_c + wiek_c + kobieta_c), data = a)
hc2 <- function(m) coeftest(m, vcov. = vcovHC(m, type = "HC2"))[c("warunekkoszty", "waruneknorma"), 1:2]
tab <- do.call(rbind, lapply(list(bez_kowariantow = m0, ANCOVA = m1, Lin = m2), function(m) {
  x <- hc2(m); data.frame(kontrast = c("koszty", "norma"), b = x[, 1], SE_HC2 = x[, 2],
                         dolna = x[, 1] - qnorm(.975) * x[, 2], gorna = x[, 1] + qnorm(.975) * x[, 2])
}))
print(round(tab[-1], 3))
write.csv(cbind(model = sub("\\..*$", "", rownames(tab)), tab), "efekty-modele.csv", row.names = FALSE)
round(c(R2_ANCOVA = summary(m1)$r.squared, SE_Lin_do_bez_norma = tab["Lin.waruneknorma", "SE_HC2"] / tab["bez_kowariantow.waruneknorma", "SE_HC2"]), 3)

# 3. Kontrasty zaplanowane w modelu Lina: średnie przy średnich wszystkich kowariantów (wycentrowane = 0), macierz HC2
#    (emmeans ostrzega przed interakcjami – tu są zamierzone, a średnie liczymy przy średnich kowariantów)
emm <- emmeans(m2, ~ warunek, at = list(postawa_c = 0, wiek_c = 0, kobieta_c = 0), vcov. = vcovHC(m2, type = "HC2"))
emm
plan <- list(`koszty − kontrola` = c(-1, 1, 0), `norma − kontrola` = c(-1, 0, 1))
summary(contrast(emm, plan), infer = TRUE, adjust = "holm")  # p z poprawką Holma na 2 kontrasty
confint(contrast(emm, plan), adjust = "none")                # 95% CI bez poprawki
pairs(emm, adjust = "tukey")                                 # dla porównania: wszystkie pary post hoc

# 4. Prerejestrowany moderator: czy efekt zależy od postawy? Łączny test obu interakcji warunek × postawa (HC2)
m3 <- lm(gotowosc ~ warunek * postawa_c + wiek_c + kobieta_c, data = a)
waldtest(lm(gotowosc ~ warunek + postawa_c + wiek_c + kobieta_c, data = a), m3, vcov = vcovHC(m3, type = "HC2"))
round(coeftest(m3, vcov. = vcovHC(m3, type = "HC2"))[c("warunekkoszty:postawa_c", "waruneknorma:postawa_c"), ], 3)
Wynik w R
           n    M   SD
kontrola 427 4.91 1.25
koszty   396 4.94 1.27
norma    423 5.08 1.34
koszty − kontrola: różnica = 0.033, 95% CI [-0.140, 0.206], t(814.7) = 0.37, p = .709, d = 0.03 [-0.11, 0.16]
norma − kontrola: różnica = 0.176, 95% CI [0.001, 0.351], t(843.0) = 1.97, p = .049, d = 0.14 [0.00, 0.27]
                                  b SE_HC2  dolna gorna
bez_kowariantow.warunekkoszty 0.033  0.088 -0.140 0.206
bez_kowariantow.waruneknorma  0.176  0.089  0.001 0.350
ANCOVA.warunekkoszty          0.119  0.072 -0.023 0.261
ANCOVA.waruneknorma           0.245  0.069  0.110 0.379
Lin.warunekkoszty             0.114  0.073 -0.028 0.257
Lin.waruneknorma              0.248  0.069  0.113 0.383
          R2_ANCOVA SE_Lin_do_bez_norma
              0.373               0.773
NOTE: Results may be misleading due to involvement in interactions
 warunek  emmean     SE   df lower.CL upper.CL
 kontrola   4.86 0.0486 1234     4.76     4.95
 koszty     4.97 0.0539 1234     4.86     5.08
 norma      5.10 0.0488 1234     5.01     5.20

Confidence level used: 0.95
 contrast          estimate     SE   df lower.CL upper.CL t.ratio p.value
 koszty − kontrola    0.114 0.0726 1234  -0.0486    0.277   1.575  0.1155
 norma − kontrola     0.248 0.0689 1234   0.0936    0.403   3.602  0.0007

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 2 estimates
P value adjustment: holm method for 2 tests
 contrast          estimate     SE   df lower.CL upper.CL
 koszty − kontrola    0.114 0.0726 1234  -0.0281    0.257
 norma − kontrola     0.248 0.0689 1234   0.1130    0.383

Confidence level used: 0.95
 contrast          estimate     SE   df t.ratio p.value
 kontrola - koszty   -0.114 0.0726 1234  -1.575  0.2568
 kontrola - norma    -0.248 0.0689 1234  -3.602  0.0010
 koszty - norma      -0.134 0.0728 1234  -1.839  0.1574

P value adjustment: tukey method for comparing a family of 3 estimates
Wald test

Model 1: gotowosc ~ warunek + postawa_c + wiek_c + kobieta_c
Model 2: gotowosc ~ warunek * postawa_c + wiek_c + kobieta_c
  Res.Df Df      F Pr(>F)
1   1240
2   1238  2 1.9732 0.1394
                        Estimate Std. Error t value Pr(>|t|)
warunekkoszty:postawa_c   -0.111      0.069  -1.614    0.107
waruneknorma:postawa_c     0.013      0.060   0.219    0.826
3. Wynik tak/nie: odsetki, ilorazy szans i AME
R
# Krok 3. Wynik binarny (zapis na poradnik): różnica odsetków i przeciętny efekt krańcowy (AME)
# z regresji logistycznej z kowariantami (wymaga obiektu a z kroku 2)
suppressPackageStartupMessages(library(marginaleffects))
options(width = 110)
round(tapply(a$poradnik, a$warunek, mean), 3)                # odsetek zapisów w warunkach
g <- glm(poradnik ~ warunek + postawa_c + wiek_c + kobieta_c, family = binomial, data = a)
round(exp(coef(g)[c("warunekkoszty", "waruneknorma")]), 2)   # ilorazy szans (warunkowe, zależne od kowariantów)
ame <- avg_comparisons(g, variables = list(warunek = "reference"), vcov = "HC2")
print(ame)
round(ame$p.value, 3)                                       # p z trzema miejscami po przecinku
g0 <- glm(poradnik ~ warunek, family = binomial, data = a)   # bez kowariantów: AME = surowa różnica odsetków
ame0 <- avg_comparisons(g0, variables = list(warunek = "reference"), vcov = "HC2")
print(ame0)
round(ame0$p.value, 3)
ame_df <- data.frame(kontrast = c("koszty", "norma"), b = ame$estimate, dolna = ame$conf.low, gorna = ame$conf.high)
write.csv(ame_df, "efekty-ame.csv", row.names = FALSE)
Wynik w R
kontrola   koszty    norma
   0.307    0.348    0.416
warunekkoszty  waruneknorma
         1.27          1.68

          Contrast Estimate Std. Error    z Pr(>|z|)    S   2.5 % 97.5 %
 koszty - kontrola   0.0514     0.0322 1.60     0.11  3.2 -0.0117  0.115
 norma - kontrola    0.1149     0.0322 3.57   <0.001 11.5  0.0519  0.178

Term: warunek
Type: response

[1] 0.11 0.00

          Contrast Estimate Std. Error    z Pr(>|z|)    S   2.5 % 97.5 %
 koszty - kontrola   0.0417     0.0328 1.27    0.203  2.3 -0.0225  0.106
 norma - kontrola    0.1093     0.0328 3.33   <0.001 10.2  0.0450  0.174

Term: warunek
Type: response

[1] 0.203 0.001
4. Symulacja: precyzja i pokrycie przedziałów
R
# Krok 4. Monte Carlo: precyzja i pokrycie 95% CI (HC2) bez kowariantów, w ANCOVA i w estymatorze Lina
# 2000 eksperymentów: kontrola vs norma, po 400 osób, prawdziwy efekt 0.35 pkt (dane symulowane)
suppressPackageStartupMessages(library(sandwich))
set.seed(4034)
R <- 2000; n <- 800; efekt <- 0.35
jeden <- function() {
  w <- sample(rep(0:1, n / 2)); postawa <- rnorm(n, 4.6, 1.1); pc <- postawa - mean(postawa)
  y <- 1.6 + 0.7 * postawa + efekt * w + 0.12 * (postawa - 4.6) * w + rnorm(n, 0, 1.1)
  mods <- list(bez_kowariantow = lm(y ~ w), ANCOVA = lm(y ~ w + pc), Lin = lm(y ~ w * pc))
  unlist(lapply(mods, function(m) c(b = coef(m)[["w"]], se = sqrt(vcovHC(m, type = "HC2")["w", "w"]))))
}
wyn <- t(replicate(R, jeden()))
mc <- t(sapply(c("bez_kowariantow", "ANCOVA", "Lin"), function(k) {
  b <- wyn[, paste0(k, ".b")]; se <- wyn[, paste0(k, ".se")]
  c(srednia = mean(b), SD_oszacowan = sd(b), sredni_SE_HC2 = mean(se),
    pokrycie_95 = mean(abs(b - efekt) <= qnorm(.975) * se), moc = mean(abs(b / se) > qnorm(.975)))
}))
round(mc, 3)
round(c(redukcja_SD_proc = 100 * (1 - mc["Lin", "SD_oszacowan"] / mc["bez_kowariantow", "SD_oszacowan"]),
        blad_MC_pokrycia = sqrt(.95 * .05 / R)), 3)
write.csv(data.frame(model = rep(c("bez_kowariantow", "ANCOVA", "Lin"), each = R),
                     b = c(wyn[, "bez_kowariantow.b"], wyn[, "ANCOVA.b"], wyn[, "Lin.b"])),
          "symulacja-oszacowania.csv", row.names = FALSE)
Wynik w R
                srednia SD_oszacowan sredni_SE_HC2 pokrycie_95   moc
bez_kowariantow   0.349        0.096         0.098       0.954 0.947
ANCOVA            0.349        0.077         0.078       0.954 0.996
Lin               0.349        0.077         0.078       0.954 0.996
redukcja_SD_proc blad_MC_pokrycia
          19.736            0.005
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 (funkcje pakietów base i stats) z pakietami sandwich, lmtest, emmeans, effectsize i marginaleffects; rysunki przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- emmeans (wersja 2.0.2): Lenth, R. V. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://CRAN.R-project.org/package=emmeans
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- marginaleffects (wersja 1.0.0): Arel-Bundock, V., Greifer, N., & Heiss, A. (2024). How to interpret statistical models using marginaleffects for R and Python. Journal of Statistical Software, 111(9), 1–32. https://doi.org/10.18637/jss.v111.i09
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://CRAN.R-project.org/package=patchwork
Najczęstsze błędy
- Testy istotności w tabeli charakterystyk. W danych z losowania sprawdzają przypadek, a nie jakość randomizacji. Opisuj różnice SMD, a testem sprawdzaj procedurę (proporcje przydziału, przerwania).
- Kowarianty dobrane po obejrzeniu wyników. Model „z tą zmienną, bo wyrównała grupy” to poszukiwanie specyfikacji. Zestaw kowariantów zapisz w planie.
- Kowariant zmierzony po bodźcu. Ocena wiarygodności tekstu, sprawdzenie manipulacji czy nastrój po bodźcu mogą zależeć od warunku. Ich kontrola zniekształca efekt.
- Klasyczne błędy standardowe przy nierównych liczebnościach i wariancjach. Użyj błędów odpornych (HC2, a przy małej próbie HC3) i zapisz to z góry.
- Wszystkie pary post hoc zamiast hipotez. Przy trzech warunkach i dwóch hipotezach testowanie trzech par osłabia moc i miesza wyniki konfirmacyjne z eksploracyjnymi.
- Sam iloraz szans przy wyniku binarnym. Podaj różnicę odsetków albo AME w punktach procentowych.
- Raport tylko modelu skorygowanego. Bez analizy nieskorygowanej czytelnik nie oceni, ile wnosi korekta.
Lista kontrolna: przed uruchomieniem eksperymentu sprawdź…
- czy plan analizy wymienia wynik główny i wyniki dodatkowe oraz sposób liczenia skali;
- czy kowarianty (2–4 cechy silnie przewidujące wynik) są mierzone przed bodźcem i zapisane w planie wraz z modelem (np. Lin, błędy HC2);
- czy hipotezy przełożono na konkretne kontrasty i ustalono poprawkę na ich liczbę;
- czy moderatory ograniczono do jednego lub dwóch z kierunkiem i uzasadnieniem;
- czy dla wyniku binarnego lub porządkowego zaplanowano miarę na skali prawdopodobieństwa (różnica odsetków, AME);
- czy eksport zawiera zmienną z wylosowanym warunkiem, a ankieta rejestruje przerwania po bodźcu, żeby dało się zbudować tabelę przepływu;
- czy na danych testowych przeszedł cały kod analizy, łącznie z tabelą SMD i kontrastami.
Najczęstsze pytania
Po co dodawać kowariant do analizy eksperymentu, skoro grupy są wylosowane?
Dla precyzji, nie dla usunięcia zakłóceń. Losowanie daje nieobciążone porównanie także bez kowariantów, ale cecha zmierzona przed bodźcem i silnie związana z wynikiem zmniejsza wariancję reszt. W przykładzie z tego wpisu błąd standardowy efektu spadł o około 23%, a w symulacji moc wzrosła z .947 do .996. Kowarianty wybierz i zapisz przed zebraniem danych.
Co to jest estymator Lina w analizie eksperymentu?
To regresja wyniku na warunek, wycentrowane kowarianty i wszystkie interakcje warunek × kowariant. Współczynnik przy warunku jest wtedy efektem przy średnich kowariantów. Lin (2013) pokazał, że w dużych próbach taka korekta nie pogarsza asymptotycznej precyzji, a poprawne przedziały ufności daje odporny błąd standardowy typu kanapkowego (np. HC2).
Kontrasty zaplanowane czy testy post hoc przy trzech warunkach eksperymentu?
Jeśli hipotezy dotyczą konkretnych porównań, np. każdego bodźca z kontrolą, zapisz je jako kontrasty przed zebraniem danych i testuj tylko je, z poprawką Holma na ich liczbę. Wszystkie pary post hoc (Tukey) to analiza eksploracyjna. Kontrasty zaplanowane mają większą moc, bo testujesz mniej porównań.
Jak policzyć efekt eksperymentu, gdy wynik ma postać tak/nie?
Podaj różnicę odsetków między warunkami z 95% CI. Gdy model logistyczny zawiera kowarianty, przelicz go na przeciętny efekt krańcowy (AME) w punktach procentowych, np. funkcją avg_comparisons() z pakietu marginaleffects. Iloraz szans z modelu z kowariantami ma inną interpretację niż iloraz bez nich, dlatego słabo nadaje się do porównań między badaniami.
Jak traktować wynik sprawdzenia manipulacji w analizie?
Jako osobny wynik: porównaj odsetek poprawnych odpowiedzi (albo średnią oceny) między warunkami i podaj różnicę z CI. Nie używaj go do usuwania respondentów ani jako zmiennej kontrolnej w modelu efektu, bo jest mierzony po bodźcu i sam od bodźca zależy.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikJak opisać eksperyment ankietowy
Co napisać w metodzie i wynikach eksperymentu online: bodziec, losowanie, sprawdzenie manipulacji, schemat przepływu, efekt z CI i gotowe zdania APA.
Czytaj →PoradnikWykluczanie respondentów w eksperymencie
Pytania kontrolne przed i po bodźcu, czas wypełniania, przerwania i granice Lee: które wykluczenia zachowują losowe porównanie.
Czytaj →PoradnikPre-test kreacji reklamowych w ankiecie
Cztery spoty lodów: plan monadyczny i sekwencyjny, efekt kolejności i przeniesienia, model mieszany, 1000 symulacji i liczebność – z kodem R.
Czytaj →Masz dane z eksperymentu ankietowego i nie wiesz, który model wybrać?
Pomożemy ustalić kowarianty i kontrasty przed analizą, policzyć efekty z odpornymi błędami standardowymi i efektami krańcowymi oraz przygotować opis wyników, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C. (2009). Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples. Statistics in Medicine, 28(25), 3083–3107. https://doi.org/10.1002/sim.3697 ● Otwarty dostęp
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Gerber, A. S., & Green, D. P. (2012). Field experiments: Design, analysis, and interpretation. W. W. Norton.
- Hanmer, M. J., & Kalkan, K. O. (2013). Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models. American Journal of Political Science, 57(1), 263–277. https://doi.org/10.1111/j.1540-5907.2012.00602.x
- Lin, W. (2013). Agnostic notes on regression adjustments to experimental data: Reexamining Freedman’s critique. The Annals of Applied Statistics, 7(1), 295–318. https://doi.org/10.1214/12-aoas583 ● Otwarty dostęp
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- Mutz, D. C. (2011). Population-based survey experiments. Princeton University Press. https://doi.org/10.23943/princeton/9780691144511.001.0001
- Mutz, D. C., Pemantle, R., & Pham, P. (2019). The perils of balance testing in experimental design: Messy analyses of clean data. The American Statistician, 73(1), 32–42. https://doi.org/10.1080/00031305.2017.1322143 ● Otwarty dostęp: pełny tekst
- Senn, S. (1994). Testing for baseline balance in clinical trials. Statistics in Medicine, 13(17), 1715–1726. https://doi.org/10.1002/sim.4780131703
Cytowania BibTeX
@article{austin2009balance, author={Austin, Peter C.}, title={{Balance diagnostics for comparing the distribution of baseline covariates between treatment groups in propensity-score matched samples}}, journal={Statistics in Medicine}, year={2009}, volume={28}, number={25}, pages={3083--3107}, doi={10.1002/sim.3697}}@article{cumming2014new, author={Cumming, Geoff}, title={{The new statistics: Why and how}}, journal={Psychological Science}, year={2014}, volume={25}, number={1}, pages={7--29}, doi={10.1177/0956797613504966}}@book{gerber2012field, author={Gerber, Alan S. and Green, Donald P.}, title={{Field experiments: Design, analysis, and interpretation}}, year={2012}, publisher={W. W. Norton}}@article{hanmer2013behind, author={Hanmer, Michael J. and Kalkan, Kerem Ozan}, title={{Behind the curve: Clarifying the best approach to calculating predicted probabilities and marginal effects from limited dependent variable models}}, journal={American Journal of Political Science}, year={2013}, volume={57}, number={1}, pages={263--277}, doi={10.1111/j.1540-5907.2012.00602.x}}@article{lin2013agnostic, author={Lin, Winston}, title={{Agnostic notes on regression adjustments to experimental data: Reexamining Freedman’s critique}}, journal={The Annals of Applied Statistics}, year={2013}, volume={7}, number={1}, pages={295--318}, doi={10.1214/12-aoas583}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@book{mutz2011population, author={Mutz, Diana C.}, title={{Population-based survey experiments}}, year={2011}, publisher={Princeton University Press}, doi={10.23943/princeton/9780691144511.001.0001}}@article{mutz2019perils, author={Mutz, Diana C. and Pemantle, Robin and Pham, Philip}, title={{The perils of balance testing in experimental design: Messy analyses of clean data}}, journal={The American Statistician}, year={2019}, volume={73}, number={1}, pages={32--42}, doi={10.1080/00031305.2017.1322143}}@article{senn1994testing, author={Senn, Stephen}, title={{Testing for baseline balance in clinical trials}}, journal={Statistics in Medicine}, year={1994}, volume={13}, number={17}, pages={1715--1726}, doi={10.1002/sim.4780131703}}