Split-ballot: jedna ankieta, dwie wersje pytania
Eksperyment split-ballot (ankieta podzielona) to najprostszy eksperyment w badaniu sondażowym. Każdy respondent dostaje losowo jedną z dwóch wersji tego samego pytania, a reszta kwestionariusza jest identyczna. Różnica w odpowiedziach między wersjami jest więc efektem samej wersji, a nie tego, kto odpowiadał. Schuman i Presser (1981) zebrali w klasycznej monografii serię takich eksperymentów nad formą, brzmieniem i kontekstem pytań o postawy. Krosnick (1999) w przeglądzie metodologii sondaży omawia m.in. wpływ słownych etykiet skali i to, że respondenci interpretują pytania według norm zwykłej rozmowy.
Wersje mogą się różnić:
- sformułowaniem: inne słowo, dopisany argument, inna nazwa problemu (zob. pytanie sugerujące);
- kolejnością kafeterii albo kolejnością pytań (zob. efekt kolejności odpowiedzi i efekt kolejności pytań);
- formatem skali: liczba punktów, etykiety, „zgadzam się / nie zgadzam się” zamiast kategorii dopasowanych do treści;
- obecnością opcji „nie wiem” (zob. odpowiedź „nie wiem”).
Efekty brzmienia bywają duże nawet przy drobnych zmianach. Rasinski (1989) analizował eksperymenty z brzmieniem pytań o wydatki publiczne w General Social Survey. Efekty sformułowania powtarzały się w trzech kolejnych latach, a interakcje z cechami respondentów nie układały się w spójny wzór. Ten wpis pokazuje, jak taki eksperyment zaplanować, przeanalizować i opisać. Gdy manipulujesz kilkoma cechami naraz, sięgnij po eksperyment czynnikowy. Gdy respondent ocenia wiele opisów sytuacji, właściwym narzędziem jest eksperyment conjoint lub winietowy.
Plan przed startem: hipoteza, miara i miejsce w ankiecie
Split-ballot wygląda na drobny dodatek do ankiety, ale wymaga tych samych decyzji co każdy schemat eksperymentalny. Zapisz je przed zbieraniem danych, najlepiej w planie analizy.
| Decyzja | Co ustalić |
|---|---|
| Hipoteza | Kierunek efektu wersji, np. „dopisany argument zwiększy odsetek poparcia” |
| Miara główna | Jedna: rozkład odpowiedzi, odsetek poparcia, odsetek „nie wiem”, średnia albo czas odpowiedzi; pozostałe jako drugorzędne |
| Kryterium trafności | Zmienna, z którą odpowiedź powinna się wiązać, zmierzona przed pytaniem eksperymentalnym |
| Miejsce w ankiecie | Wcześniejsze pytania identyczne w obu wersjach; pytania zależne od wersji tylko po eksperymencie |
| Kilka eksperymentów | Każdy losowany niezależnie; zapisz, czy wcześniejszy eksperyment może wpływać na późniejsze pytania |
| Liczebność | Na najmniejszy efekt, który ma znaczenie, osobno dla każdej miary głównej |
Kryterium mierzone po pytaniu eksperymentalnym może już zależeć od wersji. Wtedy przestaje być niezależnym punktem odniesienia.
Losowanie w narzędziu i kontrola przydziału
Większość programów ankietowych ma moduł losowania bloków lub pytań (zob. narzędzia do ankiet online). Sprawdź przed startem trzy rzeczy. Po pierwsze, czy wylosowana wersja trafia do eksportu jako osobna zmienna. Po drugie, czy losowanie działa niezależnie od urządzenia i od wcześniejszych odpowiedzi. Po trzecie, czy w testowych przejściach obie wersje pojawiają się mniej więcej po równo. Losowanie proste daje nierówne liczebności. Jeśli zależy Ci na równych grupach, użyj losowania zbalansowanego, jeśli narzędzie je oferuje (zob. randomizacja w praktyce).
Po zebraniu danych kontroluj dwie różne rzeczy. Procedurę losowania sprawdza test dwumianowy: czy proporcja wersji zgadza się z planem 1:1. W przykładzie niżej wersję A dostało 519 osób, a wersję B 481 osób, p = .242. Taki test wykrywa błąd techniczny, np. wersję, która nie wyświetla się na telefonach. Równowagę grup pokaż opisowo, np. standaryzowaną różnicą średnich. Mutz i in. (2019) pokazują, że testy istotności równowagi w danych z poprawnym losowaniem prowadzą do błędnych decyzji analitycznych i zalecają z nich rezygnować. Mutz (2011) zalicza rutynowe sprawdzanie randomizacji testami do częstych błędów analizy eksperymentów sondażowych. Testy mają sens dopiero wtedy, gdy losowanie mogło zostać zepsute, np. przez błąd wykonania albo różny ubytek respondentów w wersjach. Dlatego porównaj też odsetek przerwań ankiety w obu wersjach. Jeśli jedna wersja częściej zniechęca do dokończenia, grupy, które ukończyły ankietę, nie są już porównywalne.
Przykład: badanie nastroju na pierwszym roku
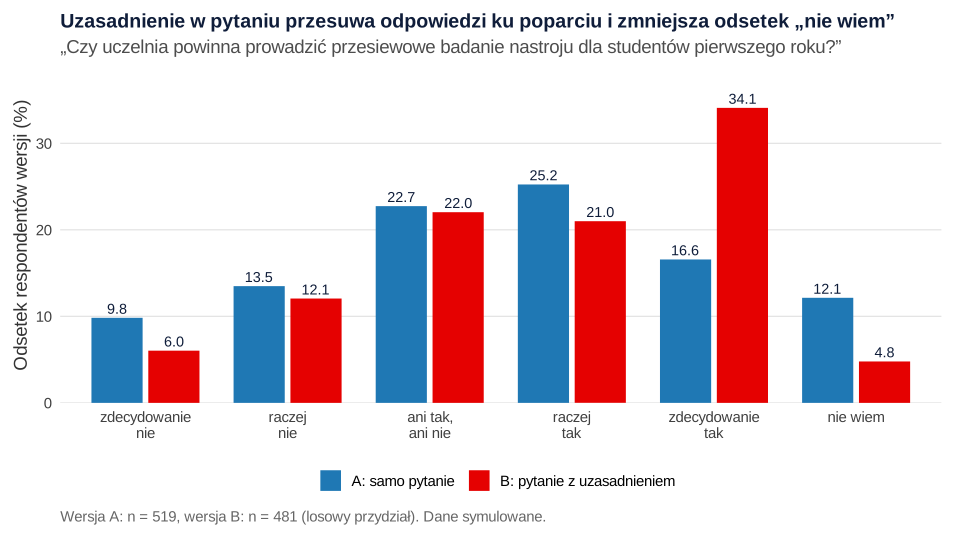
W symulowanym badaniu 1000 studentów odpowiada na pytanie: „Czy uczelnia powinna prowadzić przesiewowe badanie nastroju dla studentów pierwszego roku?”. Wersja A to samo pytanie. Wersja B ma dopisek „…, aby wcześniej docierać do osób, które potrzebują pomocy?”. Skala ma pięć kategorii od „zdecydowanie nie” do „zdecydowanie tak” i osobną opcję „nie wiem” (kod 9). Wcześniej w ankiecie studenci wypełniają skalę postaw wobec pomocy psychologicznej (1–7), która służy jako kryterium trafności. W danych dopisany argument przesuwa odpowiedzi ku poparciu i dodaje reakcję na sam argument, niezwiązaną z postawą.
Wersje są dobrze zrównoważone. Standaryzowane różnice średnich wieku, płci, roku studiów i kryterium mieściły się w zakresie od −0.077 do 0.024. Rozkłady odpowiedzi wyraźnie się różniły, χ²(5) = 53.27, p < .001 (Rysunek 1). W wersji B „zdecydowanie tak” wybrało 34.1% osób wobec 16.6% w wersji A, a „nie wiem” – 4.8% wobec 12.1%.
Analiza: „nie wiem”, poparcie i regresja porządkowa
Test chi-kwadrat niezależności na całej tabeli odpowiada tylko na pytanie, czy rozkłady się różnią. Do opisu efektu potrzebne są miary z przedziałami ufności. Rozdziel analizę na trzy części.
1. Odsetek „nie wiem”. To osobny wynik eksperymentu, a nie brak danych do usunięcia. Różnica B − A wyniosła −7.4 punktu procentowego, 95% CI [−10.8, −3.9]. Przedział policzono metodą łączącą przedziały Wilsona dla obu proporcji, którą Newcombe (1998) wskazał jako dobrze działającą w porównaniu jedenastu metod (zob. przedział Newcombe’a).
2. Odsetek poparcia (odpowiedzi 4–5). Tu pojawia się pułapka. Jeśli policzysz go tylko wśród odpowiedzi merytorycznych, porównujesz grupy, które przestały być losowe, bo wersja zmieniła, kto wybiera „nie wiem”. Dlatego jako analizę główną licz poparcie wśród wszystkich wylosowanych, z „nie wiem” jako brakiem poparcia. Wtedy poparcie wyniosło 41.8% w wersji A i 55.1% w wersji B, różnica 13.3 punktu procentowego, 95% CI [7.1, 19.3]. Wśród odpowiedzi merytorycznych było to 47.6% wobec 57.9%, różnica 10.3 punktu, 95% CI [3.8, 16.6]. Wniosek jest ten sam, ale wielkość efektu zależy od definicji mianownika.
3. Cały rozkład. Odpowiedzi na skali porządkowej modeluj regresją porządkową z wersją jako predyktorem (ordinal::clm). Wersja B zwiększała szanse wyższej odpowiedzi, OR = 1.78, 95% CI [1.41, 2.26], p < .001. Model przewiduje „zdecydowanie tak” u 21.8% osób w wersji A i 33.3% w wersji B. Kowarianty ustalone z góry (płeć, rok studiów, wiek) prawie nie zmieniły oszacowania: OR = 1.85, 95% CI [1.46, 2.34]. W eksperymencie służą one do zwiększenia precyzji, a nie do usuwania zakłóceń.
Warto też sprawdzić założenie proporcjonalnych szans. Test efektów nominalnych je odrzucił, χ²(3) = 12.69, p = .005. Osobne ilorazy szans dla kolejnych progów wyniosły 1.86, 1.54, 1.51 i 2.40. Argument najsilniej zwiększał szanse odpowiedzi „zdecydowanie tak” względem wszystkich niższych. Takie zmiany kształtu rozkładu są w eksperymentach z brzmieniem częste i same są wynikiem, który warto opisać. Jeden OR traktuj wtedy jako podsumowanie.
Różnica wersji nie mówi, która jest prawdziwa
Eksperyment pokazuje, że wersje dają różne odpowiedzi. Nie pokazuje, która wersja lepiej mierzy postawę. Wyższe poparcie w wersji B może oznaczać, że argument przypomniał coś ważnego. Może też oznaczać, że sugerował odpowiedź. Gaines i in. (2007) przypominają, że eksperymenty sondażowe omijają część trudności wnioskowania z danych sondażowych, ale wymagają ostrożnej interpretacji i uzupełniających strategii badawczych. Wersję lepszą wskazują dopiero kryteria jakości pomiaru:
- związek z kryterium zmierzonym niezależnie od wersji (trafność kryterialna);
- stabilność odpowiedzi przy powtórnym pomiarze (rzetelność test–retest);
- jakość pomiaru w modelu: Saris i in. (2010) połączyli losowy przydział formatów z podejściem wielocechowo-wielometodowym i wykazali, że pytania „zgadzam się / nie zgadzam się” dawały odpowiedzi znacznie gorszej jakości niż pytania z kategoriami dopasowanymi do treści;
- odsetek „nie wiem” i przerwań, ale tylko jako sygnał pomocniczy, bo mniej „nie wiem” nie oznacza automatycznie lepszych odpowiedzi.
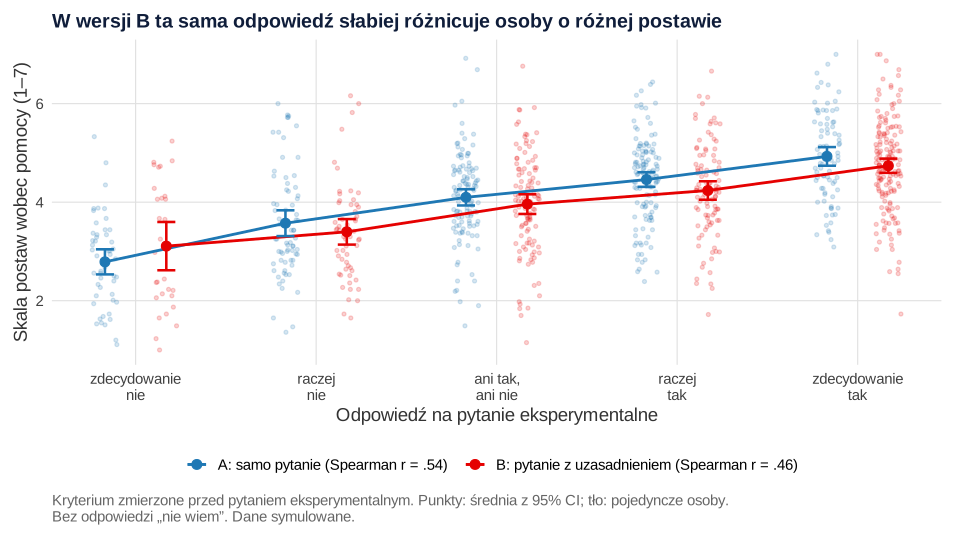
W przykładzie korelacja Spearmana odpowiedzi z kryterium wyniosła .54, 95% CI [.47, .60], w wersji A i .46, 95% CI [.38, .53], w wersji B (Rysunek 2). Różnica korelacji nie była istotna, z = 1.75, p = .081. Wersja B ma więc mniej odpowiedzi „nie wiem”, ale jej odpowiedzi nie wiążą się z kryterium silniej, a raczej słabiej. Rozstrzygnięcie wymagałoby większej próby (zob. niżej).
Moc: ile osób na wersję
Liczebność planuj osobno dla każdej miary głównej. Dla różnicy proporcji wystarczy wzór z h Cohena (pwr::pwr.2p.test). Przy α = .05 i mocy .80 wykrycie spadku „nie wiem” z 10% do 5% wymaga 424 osób na wersję, a różnicy poparcia 50% wobec 40% – 388 osób na wersję.
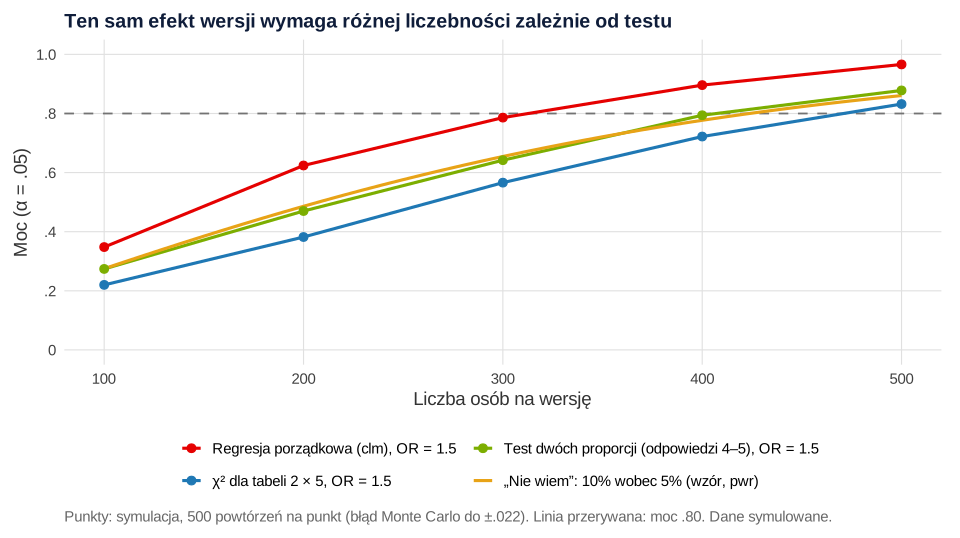
Dla całego rozkładu użyj symulacji (Rysunek 3). Przy przesunięciu o OR = 1.5 regresja porządkowa osiągnęła moc .786 przy 300 osobach na wersję i .896 przy 400. Test χ² dla tabeli 2 × 5 przy tych samych liczebnościach miał moc .566 i .722, a test dwóch proporcji po zsumowaniu odpowiedzi 4–5 – .642 i .794. Test, który wykorzystuje porządek kategorii, daje tu wyraźnie większą moc. Najwięcej osób wymaga porównanie trafności wersji. Wykrycie różnicy korelacji z kryterium .55 wobec .45 (q Cohena = 0.134) wymaga 443 osób na wersję.
Przy kilku miarach głównych albo kilku eksperymentach w jednej ankiecie zaplanuj korektę na wielokrotne porównania.
Jak opisać eksperyment split-ballot w artykule
Podaj brzmienie obu wersji, sposób losowania, liczebności, kontrolę przydziału, miarę główną ustaloną z góry, sposób traktowania „nie wiem” i miarę efektu z przedziałem ufności.
Jeśli planujesz eksperyment w ankiecie albo recenzent pyta o interpretację różnicy wersji, możemy wspólnie przygotować plan, analizę mocy i analizę w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi korzysta z danych z pierwszego, trzeci jest niezależny). Pierwszy zapisuje dane do pliku split-ballot.csv (możesz go pobrać tutaj). Potrzebne pakiety: DescTools, ordinal i pwr.
1. Losowanie wersji, kontrola przydziału i rozkład odpowiedzi
R
# Krok 1. Eksperyment split-ballot: losowanie wersji pytania, kontrola przydziału i rozkład odpowiedzi (dane symulowane)
# Pytanie: „Czy uczelnia powinna prowadzić przesiewowe badanie nastroju dla studentów pierwszego roku?”
# Wersja A: samo pytanie. Wersja B: to samo pytanie z dopiskiem „…, aby wcześniej docierać do osób, które potrzebują pomocy?”
# Odpowiedzi: 1 = zdecydowanie nie … 5 = zdecydowanie tak, 9 = „nie wiem”.
set.seed(3681)
n <- 1000
d <- data.frame(id = 1:n,
                wiek = round(pmin(pmax(rnorm(n, 22.5, 2.5), 19), 32)),
                kobieta = rbinom(n, 1, 0.62),
                rok = sample(1:5, n, replace = TRUE, prob = c(.26, .22, .20, .18, .14)))
postawa <- 0.25 * d$kobieta - 0.08 * (d$rok - 3) + rnorm(n, 0, 0.95)       # prawdziwa postawa (badacz jej nie widzi)
# Kryterium zmierzone PRZED pytaniem eksperymentalnym: skala postaw wobec pomocy psychologicznej (1–7)
d$kryterium <- round(pmin(pmax(4 + 0.9 * postawa + rnorm(n, 0, 0.6), 1), 7), 2)

# Losowanie jak w narzędziu ankietowym: każda osoba niezależnie, z prawdopodobieństwem 1/2
d$wersja <- factor(sample(c("A", "B"), n, replace = TRUE), levels = c("A", "B"))
B <- d$wersja == "B"
# Wersja B przesuwa odpowiedzi ku poparciu i dodaje reakcję na sam argument, niezwiązaną z postawą
y_lat <- postawa + ifelse(B, 0.45 + rnorm(n, 0, 0.8), 0) + rnorm(n)
odp <- as.integer(cut(y_lat, c(-Inf, -1.6, -0.6, 0.4, 1.4, Inf)))
nie_wiem <- rbinom(n, 1, plogis(ifelse(B, -2.5, -1.6) - 0.9 * abs(postawa))) == 1   # „nie wiem” częściej przy słabej postawie
d$odp <- ifelse(nie_wiem, 9L, odp)
write.csv(d, "split-ballot.csv", row.names = FALSE)

# 1. Kontrola przydziału: czy proporcja wersji zgadza się z planem 1:1 (test procedury losowania, nie równowagi grup)
table(d$wersja)
round(binom.test(sum(B), n, p = 1/2)$p.value, 3)

# 2. Równowaga cech opisowo: standaryzowana różnica średnich (B − A), bez testów istotności
smd <- function(x) (mean(x[B]) - mean(x[!B])) / sqrt((var(x[B]) + var(x[!B])) / 2)
cechy <- c("wiek", "kobieta", "rok", "kryterium")
round(cbind(A = sapply(d[!B, cechy], mean), B = sapply(d[B, cechy], mean), SMD = sapply(d[cechy], smd)), 3)

# 3. Rozkład odpowiedzi w wersjach (liczebności i odsetki od wszystkich, którzy dostali daną wersję)
etyk <- c("1" = "zdecydowanie nie", "2" = "raczej nie", "3" = "ani tak, ani nie", "4" = "raczej tak",
          "5" = "zdecydowanie tak", "9" = "nie wiem")
tab <- table(wersja = d$wersja, odp = factor(d$odp, levels = names(etyk), labels = etyk))
tab
round(100 * prop.table(tab, 1), 1)
chisq.test(tab)
Wynik w R
  A   B
519 481
[1] 0.242
               A      B    SMD
wiek      22.582 22.570 -0.005
kobieta    0.667  0.630 -0.077
rok        2.663  2.682  0.014
kryterium  4.133  4.158  0.024
      odp
wersja zdecydowanie nie raczej nie ani tak, ani nie raczej tak zdecydowanie tak
     A               51         70              118        131               86
     B               29         58              106        101              164
      odp
wersja nie wiem
     A       63
     B       23
      odp
wersja zdecydowanie nie raczej nie ani tak, ani nie raczej tak zdecydowanie tak
     A              9.8       13.5             22.7       25.2             16.6
     B              6.0       12.1             22.0       21.0             34.1
      odp
wersja nie wiem
     A     12.1
     B      4.8

	Pearson's Chi-squared test

data:  tab
X-squared = 53.271, df = 5, p-value = 2.959e-10
2. „Nie wiem”, poparcie, regresja porządkowa i kryterium trafności
R
# Krok 2. Analiza: „nie wiem”, poparcie, regresja porządkowa i kryterium trafności (wymaga obiektu d z kroku 1)
suppressPackageStartupMessages({library(DescTools); library(ordinal)})
B <- d$wersja == "B"

# 1. Odsetek „nie wiem”: różnica B − A z przedziałem Newcombe'a (method = "score")
nw <- d$odp == 9
round(100 * c(A = mean(nw[!B]), B = mean(nw[B])), 1)
round(100 * BinomDiffCI(sum(nw[B]), sum(B), sum(nw[!B]), sum(!B), method = "score"), 1)

# 2. Poparcie (odpowiedzi 4–5): (a) wśród wszystkich wylosowanych, „nie wiem” = brak poparcia; (b) tylko odpowiedzi merytoryczne
pop <- d$odp %in% 4:5
m <- !nw
round(100 * c(A_wszyscy = mean(pop[!B]), B_wszyscy = mean(pop[B]), A_merytoryczne = mean(pop[!B & m]), B_merytoryczne = mean(pop[B & m])), 1)
round(100 * BinomDiffCI(sum(pop[B]), sum(B), sum(pop[!B]), sum(!B), method = "score"), 1)
round(100 * BinomDiffCI(sum(pop[B & m]), sum(B & m), sum(pop[!B & m]), sum(!B & m), method = "score"), 1)

# 3. Regresja porządkowa (model proporcjonalnych szans) na odpowiedziach merytorycznych, wersja jako predyktor
dm <- subset(d, odp != 9)
dm$odp <- factor(dm$odp, levels = 1:5, ordered = TRUE)
m1 <- clm(odp ~ wersja, data = dm)
round(c(OR = exp(coef(m1)[["wersjaB"]]), exp(confint(m1)["wersjaB", ]), p = summary(m1)$coefficients["wersjaB", 4]), 3)
round(predict(m1, newdata = data.frame(wersja = c("A", "B")), type = "prob")$fit, 3)   # prawdopodobieństwa kategorii 1–5
nominal_test(m1)                                                                          # założenie proporcjonalnych szans
m_nom <- clm(odp ~ 1, nominal = ~ wersja, data = dm)                                      # osobny efekt wersji dla każdego progu
round(exp(-coef(m_nom)[grep("wersjaB", names(coef(m_nom)))]), 3)                          # OR odpowiedzi powyżej progu: B wobec A
m2 <- clm(odp ~ wersja + kobieta + rok + wiek, data = dm)                                 # z kowariantami ustalonymi z góry
round(c(OR = exp(coef(m2)[["wersjaB"]]), exp(confint(m2)["wersjaB", ])), 3)

# 4. Trafność: związek odpowiedzi z kryterium zmierzonym wcześniej (korelacja Spearmana, CI z transformacji Fishera)
kor <- function(x, y) { r <- cor(x, y, method = "spearman"); n <- length(x); z <- atanh(r)
  c(r = r, dolna = tanh(z - 1.96 / sqrt(n - 3)), gorna = tanh(z + 1.96 / sqrt(n - 3)), n = n) }
rA <- with(subset(dm, wersja == "A"), kor(as.integer(odp), kryterium))
rB <- with(subset(dm, wersja == "B"), kor(as.integer(odp), kryterium))
round(rbind(A = rA, B = rB), 3)
z <- (atanh(rA[["r"]]) - atanh(rB[["r"]])) / sqrt(1 / (rA[["n"]] - 3) + 1 / (rB[["n"]] - 3))
round(c(z = z, p = 2 * pnorm(-abs(z))), 3)
Wynik w R
   A    B
12.1  4.8
      est lwr.ci upr.ci
[1,] -7.4  -10.8   -3.9
     A_wszyscy      B_wszyscy A_merytoryczne B_merytoryczne
          41.8           55.1           47.6           57.9
      est lwr.ci upr.ci
[1,] 13.3    7.1   19.3
      est lwr.ci upr.ci
[1,] 10.3    3.8   16.6
    OR  2.5 % 97.5 %      p
 1.784  1.414  2.255  0.000
      1     2     3     4     5
1 0.110 0.167 0.264 0.240 0.218
2 0.065 0.112 0.221 0.269 0.333
Tests of nominal effects

formula: odp ~ wersja
       Df  logLik    AIC    LRT Pr(>Chi)
<none>    -1391.7 2793.5
wersja  3 -1385.4 2786.8 12.693  0.00535 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
1|2.wersjaB 2|3.wersjaB 3|4.wersjaB 4|5.wersjaB
      1.863       1.540       1.512       2.400
    OR  2.5 % 97.5 %
 1.845  1.460  2.335
      r dolna gorna   n
A 0.543 0.474 0.604 456
B 0.456 0.380 0.525 458
    z     p
1.748 0.081
3. Moc: wzór dla proporcji i symulacja dla rozkładu
R
# Krok 3. Moc eksperymentu split-ballot: wzór dla dwóch proporcji (pwr) i symulacja dla odpowiedzi porządkowych
suppressPackageStartupMessages({library(pwr); library(ordinal)})

# 1. Liczebność na wersję dla różnicy proporcji (h Cohena), alfa = .05, moc = .80
n_nw  <- pwr.2p.test(h = ES.h(0.10, 0.05), sig.level = 0.05, power = 0.80)$n   # „nie wiem”: 10% wobec 5%
n_pop <- pwr.2p.test(h = ES.h(0.50, 0.40), sig.level = 0.05, power = 0.80)$n   # poparcie: 50% wobec 40%
ceiling(c(nie_wiem_10_vs_5 = n_nw, poparcie_50_vs_40 = n_pop))

# 2. Symulacja: przesunięcie rozkładu pięciu kategorii o OR = 1.5 (model proporcjonalnych szans)
p_A <- c(0.11, 0.15, 0.26, 0.28, 0.20)                       # rozkład w wersji A (zbliżony do pilotażu)
alfa <- qlogis(cumsum(p_A)[1:4])                              # progi
losuj <- function(k, beta) {                                  # k osób, przesunięcie beta na skali logitu
  u <- rlogis(k) + beta
  factor(findInterval(u, alfa) + 1, levels = 1:5, ordered = TRUE)
}
jedna <- function(k, beta = log(1.5)) {
  y <- c(losuj(k, 0), losuj(k, beta)); w <- factor(rep(c("A", "B"), each = k))
  m <- clm(y ~ w)
  c(clm = summary(m)$coefficients["wB", 4],
    chi2 = suppressWarnings(chisq.test(table(w, y))$p.value),
    poparcie_4_5 = prop.test(table(w, as.integer(y) >= 4))$p.value)
}
set.seed(3683)
siatka <- c(100, 200, 300, 400, 500)
moc <- t(sapply(siatka, function(k) rowMeans(replicate(500, jedna(k)) < 0.05)))
moc <- data.frame(n_na_wersje = siatka, round(moc, 3))
moc
write.csv(moc, "moc-symulacja.csv", row.names = FALSE)

# 3. Porównanie trafności wersji: ile osób na wersję, by wykryć korelacje z kryterium .55 wobec .45 (q Cohena)
q <- atanh(0.55) - atanh(0.45)
round(c(q = q, n_na_wersje = ceiling(((qnorm(0.975) + qnorm(0.80)) / q)^2 + 3)), 3)
# Błąd Monte Carlo mocy przy 500 powtórzeniach (najgorszy przypadek, moc = .50)
round(sqrt(0.5 * 0.5 / 500), 3)
Wynik w R
 nie_wiem_10_vs_5 poparcie_50_vs_40
              424               388
  n_na_wersje   clm  chi2 poparcie_4_5
1         100 0.348 0.220        0.274
2         200 0.624 0.382        0.470
3         300 0.786 0.566        0.642
4         400 0.896 0.722        0.794
5         500 0.966 0.832        0.878
          q n_na_wersje
      0.134     443.000
[1] 0.022
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (funkcje binom.test(), chisq.test(), prop.test() i cor() z pakietu stats) z pakietami DescTools, ordinal i pwr; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data (R package version 2026.7-26) [Computer software]. https://CRAN.R-project.org/package=ordinal
- pwr (wersja 1.3.0): Champely, S. (2020). pwr: Basic functions for power analysis (R package version 1.3-0) [Computer software]. https://doi.org/10.32614/CRAN.package.pwr
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Usunięcie „nie wiem” przed porównaniem wersji. Wersja zmienia, kto wybiera „nie wiem”, więc grupy odpowiedzi merytorycznych nie są już losowe. Analizuj odsetek „nie wiem” jako wynik, a poparcie licz także wśród wszystkich wylosowanych.
- Testy istotności równowagi grup. W poprawnie zrandomizowanych danych różnice cech są z definicji przypadkowe. Pokaż je opisowo, a testem sprawdzaj procedurę losowania.
- „Wersja B daje mniej braków, więc jest lepsza”. O jakości pytania decyduje związek z kryterium, stabilność i jakość pomiaru, a nie sam odsetek odpowiedzi merytorycznych.
- Kryterium zmierzone po eksperymencie. Jeśli wersja mogła je zmienić, porównanie trafności traci podstawę.
- Dobór kowariantów po obejrzeniu wyników. Kowarianty ustal z góry. W eksperymencie służą precyzji, a nie ratowaniu efektu.
- Dychotomizacja skali bez potrzeby. Regresja porządkowa wykorzystuje cały rozkład i w symulacji miała wyraźnie większą moc niż porównanie odsetków odpowiedzi 4–5.
Najczęstsze pytania
Czym różni się eksperyment split-ballot od testu A/B?
Logika jest ta sama: losowy przydział jednej z dwóch wersji i porównanie wyników. W split-ballot wersjami są warianty pytania w ankiecie, a wynikiem jest rozkład odpowiedzi, odsetek „nie wiem” albo związek odpowiedzi z innymi zmiennymi. Dlatego poza testem proporcji potrzebna jest zwykle regresja porządkowa i ocena trafności wersji.
Czy w eksperymencie split-ballot usuwać odpowiedzi „nie wiem”?
Nie przed porównaniem wersji. Wersja pytania może zmieniać to, kto wybiera „nie wiem”, więc po usunięciu tych osób grupy przestają być losowe. Odsetek „nie wiem” analizuj jako osobny wynik, a odsetek poparcia licz także wśród wszystkich wylosowanych, z „nie wiem” jako brakiem poparcia.
Jak sprawdzić, czy narzędzie ankietowe dobrze wylosowało wersje pytania?
Sprawdź, czy wersja jest zapisana w eksporcie, i porównaj proporcję wersji z planem testem dwumianowym. Porównaj też odsetek przerwań ankiety w wersjach. Cechy respondentów pokaż opisowo, np. standaryzowaną różnicą średnich, bez testów istotności.
Ile osób potrzeba do eksperymentu z dwiema wersjami pytania?
To zależy od miary głównej. Przy α = .05 i mocy .80 wykrycie spadku odsetka „nie wiem” z 10% do 5% wymaga 424 osób na wersję, a różnicy poparcia 50% wobec 40% – 388. Dla przesunięcia rozkładu pięciu kategorii o OR = 1.5 regresja porządkowa osiągnęła w symulacji moc .80 przy około 300 osobach na wersję.
Skąd wiadomo, która wersja pytania jest lepsza?
Sam eksperyment tego nie rozstrzyga, bo pokazuje tylko, że wersje dają różne odpowiedzi. Lepszą wersję wskazują kryteria jakości pomiaru: silniejszy związek z kryterium zmierzonym niezależnie od wersji, stabilność przy powtórnym pomiarze i jakość pomiaru w modelach takich jak MTMM. Mniejszy odsetek „nie wiem” to tylko sygnał pomocniczy.
Powiązane hasła
Przeczytaj też
Eksperyment w ankiecie online krok po kroku
Dziewięć kroków od hipotezy do wyniku: bodziec i kontrola, układ ankiety, losowanie, liczebność, prerejestracja, test techniczny i analiza z d Cohena.
Czytaj →PoradnikEksperyment conjoint i winietowy
Atrybuty i zadania, AMCE z błędami klastrowanymi, średnie brzegowe w podgrupach i winiety w modelu mieszanym – na danych w R.
Czytaj →PoradnikRegresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikRandomizacja w praktyce
Bloki o losowej długości, warstwy, minimalizacja Pococka–Simona i ukrycie przydziału – lista przydziału w R, symulacja i wzór opisu CONSORT.
Czytaj →Testujesz wersje pytań i nie wiesz, jak opisać różnicę?
Pomożemy zaplanować eksperyment w ankiecie, policzyć moc, przeanalizować rozkłady i odpowiedzi „nie wiem” oraz przygotować opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Gaines, B. J., Kuklinski, J. H., & Quirk, P. J. (2007). The logic of the survey experiment reexamined. Political Analysis, 15(1), 1–20. https://doi.org/10.1093/pan/mpl008
- Krosnick, J. A. (1999). Survey research. Annual Review of Psychology, 50(1), 537–567. https://doi.org/10.1146/annurev.psych.50.1.537
- Mutz, D. C. (2011). Population-based survey experiments. Princeton University Press. https://doi.org/10.23943/princeton/9780691144511.001.0001
- Mutz, D. C., Pemantle, R., & Pham, P. (2019). The perils of balance testing in experimental design: Messy analyses of clean data. The American Statistician, 73(1), 32–42. https://doi.org/10.1080/00031305.2017.1322143 ● Otwarty dostęp: pełny tekst
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Rasinski, K. A. (1989). The effect of question wording on public support for government spending. Public Opinion Quarterly, 53(3), 388. https://doi.org/10.1086/269158
- Saris, W., Revilla, M., Krosnick, J. A., & Shaeffer, E. M. (2010). Comparing questions with agree/disagree response options to questions with item-specific response options. Survey Research Methods, 4(1), 61–79. https://doi.org/10.18148/srm/2010.v4i1.2682 ● Otwarty dostęp
- Schuman, H., & Presser, S. (1981). Questions and answers in attitude surveys: Experiments on question form, wording, and context. Academic Press.
Cytowania BibTeX
@article{gaines2007logic, author={Gaines, Brian J. and Kuklinski, James H. and Quirk, Paul J.}, title={{The logic of the survey experiment reexamined}}, journal={Political Analysis}, year={2007}, volume={15}, number={1}, pages={1--20}, doi={10.1093/pan/mpl008}}@article{krosnick1999survey, author={Krosnick, Jon A.}, title={{Survey research}}, journal={Annual Review of Psychology}, year={1999}, volume={50}, number={1}, pages={537--567}, doi={10.1146/annurev.psych.50.1.537}}@book{mutz2011population, author={Mutz, Diana C.}, title={{Population-based survey experiments}}, year={2011}, publisher={Princeton University Press}, doi={10.23943/princeton/9780691144511.001.0001}}@article{mutz2019perils, author={Mutz, Diana C. and Pemantle, Robin and Pham, Philip}, title={{The perils of balance testing in experimental design: Messy analyses of clean data}}, journal={The American Statistician}, year={2019}, volume={73}, number={1}, pages={32--42}, doi={10.1080/00031305.2017.1322143}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{rasinski1989effect, author={Rasinski, Kenneth A.}, title={{The effect of question wording on public support for government spending}}, journal={Public Opinion Quarterly}, year={1989}, volume={53}, number={3}, pages={388}, doi={10.1086/269158}}@article{saris2010comparing, author={Saris, Willem and Revilla, Melanie and Krosnick, Jon A. and Shaeffer, Eric M.}, title={{Comparing questions with agree/disagree response options to questions with item-specific response options}}, journal={Survey Research Methods}, year={2010}, volume={4}, number={1}, pages={61--79}, doi={10.18148/srm/2010.v4i1.2682}}@book{schuman1981questions, author={Schuman, Howard and Presser, Stanley}, title={{Questions and answers in attitude surveys: Experiments on question form, wording, and context}}, year={1981}, publisher={Academic Press}}