Pięć składników, jeden budżet
Projektujesz internetowy program redukcji stresu dla studentów. Masz pięć kandydatów na składniki: psychoedukację (A), trening relaksacji (B), przypomnienia SMS (C), kontakt z coachem (D) i dziennik stresu (E). Klasyczna ścieżka to zbudować pakiet ze wszystkich pięciu i porównać go z grupą kontrolną w RCT. Taki test powie, czy pakiet działa, ale nie powie, który składnik działa, który jest zbędny i czy dwa składniki się nie dublują. Jeśli pakiet zawiedzie, nie wiesz, co poprawić. Jeśli zadziała, nie wiesz, co można wyciąć, żeby był tańszy.
Na takie pytania odpowiada eksperyment czynnikowy: każdy składnik jest osobną zmienną niezależną z dwoma poziomami (włączony albo wyłączony), a uczestników losowo przydziela się do kombinacji składników. Podstawy, czyli dwa czynniki, cztery komórki, efekty główne i interakcja, opisuje hasło schemat czynnikowy 2 × 2. Ten wpis dotyczy sytuacji, w której czynników jest pięć i więcej, a pełny plan robi się za duży. Wtedy pomaga plan frakcyjny.
Skąd ten pomysł: optymalizacja przed RCT
Collins i in. (2007) opisali strategię optymalizacji wielofazowej MOST (multiphase optimization strategy). Najpierw w fazie przesiewowej sprawdza się, które składniki warto włączyć, a które odrzucić. Potem w fazie dopracowania dobiera się ich poziomy. Dopiero na końcu zoptymalizowaną interwencję testuje się w standardowym RCT. Wszystkie fazy opierają się na randomizowanym eksperymencie. Pełny opis podejścia zawiera podręcznik Collins (2018).
Collins, Dziak i in. (2014) podkreślają, że eksperyment czynnikowy nie zastępuje RCT, tylko odpowiada na inne pytanie. RCT porównuje pakiet z kontrolą. Eksperyment czynnikowy szacuje wkład każdego składnika i ich wspólne działanie. Pokrewnym narzędziem dla interwencji adaptacyjnych jest badanie SMART, opisane w tym samym artykule z 2007 roku.
Przykład z praktyki: Piper i in. (2016) zbadali sześć składników leczenia uzależnienia od tytoniu w randomizowanym eksperymencie frakcyjnym z udziałem 637 palaczy. Poradnictwo przygotowawcze działało samodzielnie. Przygotowawcza nikotynowa terapia zastępcza wzmacniała intensywne poradnictwo osobiste (interakcja synergiczna). Intensywne poradnictwo osobiste i telefoniczne razem działały słabiej niż każde z nich osobno (interakcja antagonistyczna). Tego nie pokazałoby żadne porównanie „pakiet a kontrola”.
Pełny plan 2k a plan frakcyjny 2k−p
Pięć składników dwupoziomowych daje 25 = 32 kombinacje. Każda to osobna wersja programu, którą trzeba przygotować, przetestować i utrzymać. Collins i in. (2009) proponują patrzeć na wybór planu jak na zarządzanie zasobami: liczy się nie tylko liczba osób, ale też liczba warunków i koszt każdego z nich. Porównali cztery opcje: pełny plan czynnikowy, osobne eksperymenty dla każdego czynnika, plan jednoczynnikowy (kontrola i kilka ramion) oraz plan frakcyjny. Pełne i frakcyjne plany czynnikowe były zwykle bardziej ekonomiczne niż osobne eksperymenty.
Plan frakcyjny 25−1 realizuje połowę kombinacji, czyli 16. Wybiera się je tak, żeby piąty czynnik był iloczynem czterech pierwszych: E = ABCD. Ceną jest aliasowanie. Niektóre efekty mają w planie identyczne kolumny, więc oszacowany „efekt” jest sumą dwóch efektów. Mechanikę generatora, relacji definiującej i aliasów krok po kroku omawia hasło frakcyjny schemat czynnikowy.
Nie myl planu frakcyjnego z innymi oszczędnymi planami. Kwadrat łaciński kontroluje dwa źródła zakłóceń przy jednym czynniku badanym. Schemat split-plot dotyczy sytuacji, w której jeden czynnik da się zmieniać tylko w większych jednostkach. Plan frakcyjny zmniejsza liczbę kombinacji wielu czynników badanych naraz.
Rozdzielczość i aliasy w FrF2
Najważniejsza decyzja to rozdzielczość planu. W rozdzielczości III efekty główne są aliasowane z interakcjami dwuczynnikowymi. W IV efekty główne są czyste, ale interakcje dwuczynnikowe mieszają się ze sobą. W V efekty główne i wszystkie interakcje dwuczynnikowe są od siebie oddzielone, a mieszają się dopiero z interakcjami wyższego rzędu.
Pakiet FrF2 (Grömping, 2014) tworzy regularne plany frakcyjne o czynnikach dwupoziomowych i pozwala sprawdzić ich strukturę. W przykładzie FrF2(nruns = 16, nfactors = 5) zwrócił generator E = ABCD. Pole design.info()$catlg.entry podało rozdzielczość V i 10 „czystych” interakcji dwuczynnikowych. Funkcja aliasprint() potwierdziła: brak aliasów wśród efektów głównych i interakcji dwuczynnikowych. Każdy składnik jest włączony w 8 z 16 warunków, a kolumny wszystkich 15 efektów są ortogonalne.
Ten sam zestaw w 8 warunkach (25−2, generatory D = AB i E = AC) ma już tylko rozdzielczość III. aliasprint() pokazuje A = BD = CE, B = AD, C = AE, D = AB i E = AC. Oszacowany „efekt psychoedukacji” byłby więc sumą jej efektu i interakcji relaksacji z coachem.
| Plan | Warunki | Co jest aliasowane | Kiedy wybrać |
|---|---|---|---|
| Pełny 25 | 32 | nic | gdy interesują Cię też interakcje trzech i więcej składników, a warunki są tanie |
| Frakcyjny 25−1, rozdzielczość V | 16 | efekty główne i interakcje 2-czynnikowe z interakcjami wyższego rzędu | typowy wybór w fazie przesiewowej |
| Frakcyjny 25−2, rozdzielczość III | 8 | efekty główne z interakcjami 2-czynnikowymi | tylko gdy masz mocne podstawy, by przyjąć brak interakcji |
Analiza: kodowanie −1/+1 i jeden model
Dane symulowane: 448 studentów losowo przydzielono do 16 warunków, po 28 osób. Wynikiem jest stres po 8 tygodniach w skali PSS-10 (0–40, mniej znaczy lepiej). Każdy składnik zakodowano −1 (wyłączony) i +1 (włączony), czyli kodowaniem efektów. Do danych dopasowano jedną regresję z pięcioma efektami głównymi i dziesięcioma interakcjami dwuczynnikowymi (lm(stres ~ (A + B + C + D + E)^2)). Na błąd pozostały 432 stopnie swobody.
Przy kodowaniu −1/+1 współczynnik efektu głównego to połowa różnicy średnich brzegowych „włączony − wyłączony”. Średnia brzegowa to średnia ze wszystkich warunków z danym poziomem składnika. Relaksacja (B) miała b = −1.18, 95% CI [−1.74, −0.62], p < .001, czyli obniżała stres średnio o 2.36 punktu, 95% CI [1.24, 3.49]. Średnie brzegowe wyniosły 21.07 bez relaksacji i 18.71 z nią. Coach (D) obniżał stres o 1.60 punktu, b = −0.80, 95% CI [−1.36, −0.24], p = .005, a dziennik (E) o 1.46 punktu, b = −0.73, 95% CI [−1.29, −0.17], p = .011. Psychoedukacja (b = −0.23, p = .431) i przypomnienia SMS (b = 0.34, p = .234) nie miały wyraźnego efektu.
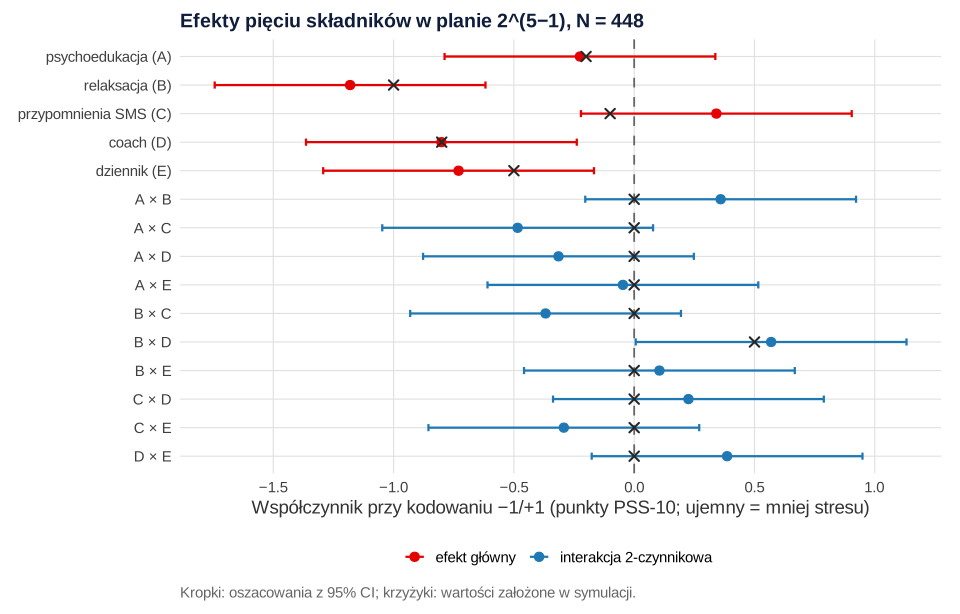
lm() (dane symulowane).Interakcja relaksacji z coachem była dodatnia: b = 0.57, 95% CI [0.01, 1.13], p = .047. Znak dodatni przy wyniku „mniej znaczy lepiej” oznacza antagonizm. Efekt prosty relaksacji wynosił −3.50 punktu bez coacha i tylko −1.22 przy coachu, bo oba składniki uczą w dużej mierze tego samego. Pozostałe interakcje miały p od .091 do .870. Jak czytać i opisać taki wzór, wyjaśnia wpis interakcja w ANOVA.
Dlaczego −1/+1, a nie 0/1? Przy kodowaniu 0/1 i interakcjach w modelu współczynnik B oznacza efekt relaksacji wtedy, gdy wszystkie pozostałe składniki są wyłączone. W przykładzie wyniósł −3.69 (SE = 1.28), a efekt główny przy kodowaniu −1/+1 wyrażony jako różnica −2.36 (SE = 0.57). To dwie różne wielkości z różną precyzją. W fazie przesiewowej pytasz o efekt składnika uśredniony po pozostałych, czyli o efekt główny. Temat szerzej omawiają Kugler i in. (2018). W planie zrównoważonym z kodowaniem −1/+1 wynik nie zależy od typu sum kwadratów, więc tę samą analizę zrobisz jako wieloczynnikową ANOVA (zob. ANOVA dwuczynnikowa w SPSS, z większą liczbą czynników).
Ile osób: każdy uczestnik pracuje pięć razy
Najbardziej zaskakująca cecha eksperymentu czynnikowego dotyczy liczebności. Efekt główny relaksacji porównuje 224 osoby z relaksacją z 224 osobami bez niej. Efekt coacha porównuje inny podział tych samych 448 osób, też 224 na 224. Każdy uczestnik „pracuje” przy oszacowaniu każdego składnika. Collins, Dziak i in. (2014) piszą, że eksperyment czynnikowy przy właściwej analizie bardzo efektywnie wykorzystuje uczestników i może mieć wysoką moc nawet przy niewielu osobach na warunek.
Policzmy to. Przyjmijmy jako najmniejszy interesujący efekt różnicę 1.6 punktu przy SD = 6 (d = 0.27), α = .05 i moc .80. Zwykłe porównanie dwóch grup wymaga 222 osób w grupie. Pięć osobnych eksperymentów potrzebuje 2220 osób, a plan „kontrola + 5 ramion” – 1332. Pełny plan 25 i oba plany frakcyjne potrzebują 448 osób, bo każdy efekt główny opiera się na wszystkich uczestnikach.
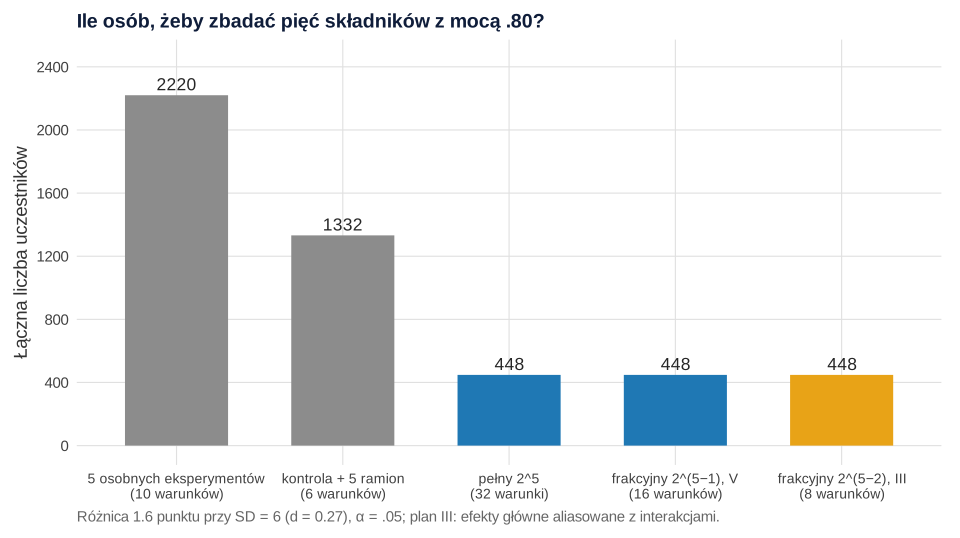
power.t.test().Symulacja to potwierdza. W 1000 powtórzeniach planu 25−1 z 448 osobami moc dla coacha, którego efekt równał się najmniejszemu interesującemu, wyniosła .789. Przy 1000 powtórzeniach błąd Monte Carlo dla mocy .80 to .013, więc wynik zgadza się z założonym .80. Dla relaksacji moc wyniosła .934, a dla dziennika (efekt mniejszy od progu) .421. Dla interakcji zerowej odsetek wyników istotnych wyniósł .057, czyli tyle, ile wynosi nominalny błąd I rodzaju.
Uwaga na interakcje. Przy kodowaniu −1/+1 każdy współczynnik ma ten sam błąd standardowy (w przykładzie 0.29), więc interakcja B × D o współczynniku 0.5 miała moc .425, prawie taką jak dziennik. Ale współczynnik interakcji 0.5 oznacza różnicę efektów prostych aż o 2 punkty (4 × 0.5). W prawdziwych badaniach interakcje bywają mniejsze, dlatego ich wykrycie wymaga zwykle większej próby. Wyjaśnia to wpis moc testu dla interakcji. Ogólne zasady planowania mocy przez symulację opisuje hasło symulacyjna analiza mocy.
Za niska rozdzielczość: składnik, który „szkodzi”
Plan 25−2 też potrzebuje 448 osób, a ma tylko 8 warunków, więc kusi. Sprawdziliśmy go na tych samych założeniach: prawdziwy efekt psychoedukacji wynosi −0.20, a interakcja relaksacji z coachem 0.5. W planie III A = BD, więc model z samymi efektami głównymi szacuje sumę A + BD.
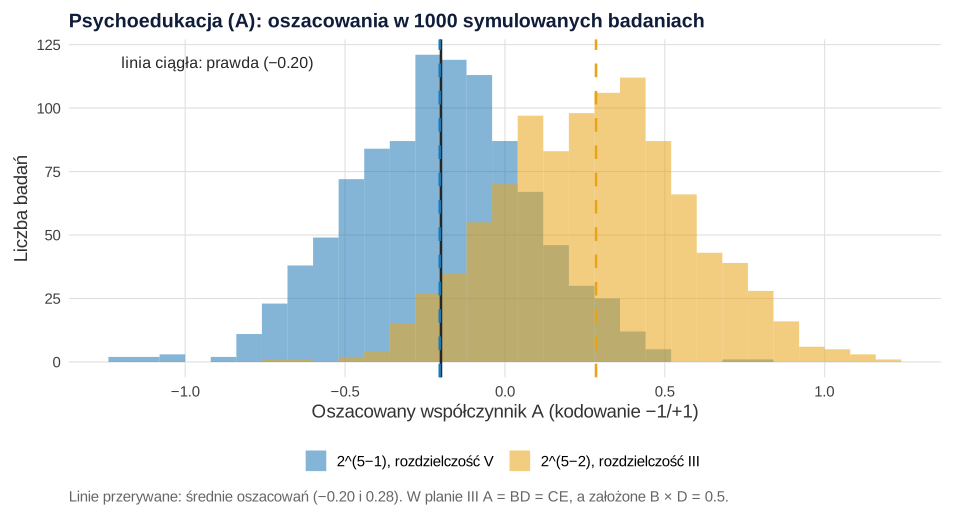
lm(), plany z pakietu FrF2 (dane symulowane).W planie V średnie oszacowanie wyniosło −0.204, czyli prawie dokładnie prawdę. W planie III wyniosło 0.285: znak się odwrócił, bo interakcja „przeszła” na psychoedukację. W 17.5% badań w planie III psychoedukacja wychodziła jako istotnie szkodliwa (b > 0, p < .05), w planie V tylko w 0.2%. Zespół, który odrzuciłby ten składnik, nie miałby jak się zorientować, że winna jest interakcja dwóch innych. Dlatego plan rozdzielczości III wybieraj tylko wtedy, gdy masz mocne podstawy, by założyć, że interakcje dwuczynnikowe są pomijalne. Collins, Dziak i in. (2014) zalecają wręcz, by przy wyborze składników interakcje badać, a nie zakładać, że ich nie ma.
Od wyników do decyzji o składnikach
Eksperyment przesiewowy kończy się decyzją, a nie samą tabelą p. Collins, Trail i in. (2014) opisali procedurę podejmowania takich decyzji na podstawie czynnikowego eksperymentu przesiewowego. Zilustrowali ją na danych sztucznych i sami zaznaczyli, że jej uogólnialność jest ograniczona. Niezależnie od wybranej procedury zapisz regułę decyzyjną przed zebraniem danych, w planie analizy. Przykładowa reguła dla naszego programu:
- Efekty główne. Włącz składnik, jeśli 95% CI dla różnicy leży poniżej zera, a oszacowanie jest co najmniej tak duże jak najmniejszy interesujący efekt albo składnik jest tani. Tu: relaksacja (2.36) i coach (1.60) tak; dziennik (1.46) tak, bo kosztuje niewiele.
- Interakcje. Sprawdź, czy któraś zmienia decyzję. Antagonizm relaksacji i coacha oznacza, że przy coachu relaksacja daje 1.22 punktu zamiast 3.50. Jeśli coach jest drogi, rozważ wariant bez niego i porównaj przewidywane wyniki obu pakietów.
- Odrzuć składniki bez efektu: psychoedukację i przypomnienia SMS.
- Potwierdź wybrany pakiet w RCT. Interakcję z p = .047, jedną z dziesięciu testowanych, traktuj jako hipotezę do sprawdzenia, a nie pewny wynik.
Kilka spraw praktycznych. Przydział do 16 warunków najlepiej losować blokami, żeby liczebności były równe (zob. randomizacja w praktyce). Przy utracie uczestników kolumny przestają być idealnie ortogonalne, ale model z kodowaniem −1/+1 nadal szacuje to samo.
Jak opisać eksperyment czynnikowy w artykule
Opis powinien pozwolić odtworzyć plan: liczba czynników i poziomów, frakcja, generator, rozdzielczość, aliasy, liczba warunków i osób, kodowanie, model i reguła decyzyjna.
Jeśli chcesz, żeby ktoś sprawdził plan frakcyjny, aliasy i analizę mocy przed złożeniem wniosku, zajrzyj do oferty analiz statystycznych dla badaczy.
Przykład w R
Trzy przepisy uruchamiasz po kolei w jednej sesji R, bo kolejne korzystają z obiektów z poprzednich (plan16, plan8, X, b, b_BD). Drugi zapisuje dane do pliku eksperyment-frakcyjny-5-skladnikow.csv (możesz go pobrać tutaj). Symulacje w trzecim przepisie trwają kilkadziesiąt sekund. Potrzebny pakiet: FrF2 (z zależnością DoE.base).
1. Plan 2^(5−1), rozdzielczość i aliasy
R
# Krok 1. Plan 2^(5-1): 5 składników interwencji w 16 warunkach (FrF2)
# A = psychoedukacja, B = trening relaksacji, C = przypomnienia SMS,
# D = wsparcie coacha, E = dziennik stresu; każdy składnik: wyłączony (-1) / włączony (+1)
suppressPackageStartupMessages(library(FrF2))

plan16 <- FrF2(nruns = 16, nfactors = 5, randomize = FALSE)
plan16                                  # 16 kombinacji zamiast 32
generators(plan16)                      # generator piątego czynnika
design.info(plan16)$catlg.entry         # rozdzielczość i liczba "czystych" interakcji
aliasprint(plan16)                      # czy efekty główne i interakcje 2-czynnikowe mają aliasy?

# Dla porównania: ten sam zestaw składników w 8 warunkach, plan 2^(5-2)
plan8 <- FrF2(nruns = 8, nfactors = 5, randomize = FALSE)
generators(plan8)
design.info(plan8)$catlg.entry
aliasprint(plan8)

# Ile warunków z danym składnikiem? Każdy składnik jest włączony w połowie warunków
X <- sapply(as.data.frame(plan16), function(x) as.numeric(as.character(x)))
colSums(X == 1)
# Kolumny są ortogonalne: iloczyny skalarne efektów głównych i interakcji 2-czynnikowych
M <- model.matrix(~ (A + B + C + D + E)^2, data = as.data.frame(X))
range(crossprod(M)[upper.tri(crossprod(M))])
Wynik w R
    A  B  C  D  E
1  -1 -1 -1 -1  1
2   1 -1 -1 -1 -1
3  -1  1 -1 -1 -1
4   1  1 -1 -1  1
5  -1 -1  1 -1 -1
6   1 -1  1 -1  1
7  -1  1  1 -1  1
8   1  1  1 -1 -1
9  -1 -1 -1  1 -1
10  1 -1 -1  1  1
11 -1  1 -1  1  1
12  1  1 -1  1 -1
13 -1 -1  1  1  1
14  1 -1  1  1 -1
15 -1  1  1  1 -1
16  1  1  1  1  1
class=design, type= FrF2
$generators
[1] "E=ABCD"

Design:  5-1.1
   16  runs,  5  factors,
   Resolution  V
   Generating columns:  15
   WLP (3plus):  0 0 1 0 0 ,  10  clear 2fis
$legend
[1] A=A B=B C=C D=D E=E

[[2]]
[1] no aliasing among main effects and 2fis

$generators
[1] "D=AB" "E=AC"

Design:  5-2.1
   8  runs,  5  factors,
   Resolution  III
   Generating columns:  3 5
   WLP (3plus):  2 1 0 0 0 ,  0  clear 2fis
$legend
[1] A=A B=B C=C D=D E=E

$main
[1] A=BD=CE B=AD    C=AE    D=AB    E=AC

$fi2
[1] BC=DE BE=CD

A B C D E
8 8 8 8 8
[1] 0 0
2. Dane symulowane i model z kodowaniem −1/+1
R
# Krok 2. Symulowane badanie: 448 studentów losowo przydzielonych do 16 warunków (po 28)
# Wynik: stres po 8 tygodniach, skala PSS-10 (0-40, mniej = lepiej); dane symulowane
set.seed(3424)
X <- sapply(as.data.frame(plan16), function(x) as.numeric(as.character(x)))
n_war <- 28
dane <- as.data.frame(X[rep(1:16, each = n_war), ])
dane$warunek <- rep(1:16, each = n_war)
# Założone współczynniki (kodowanie -1/+1): różnica "włączony - wyłączony" = 2 x współczynnik
b <- c(A = -0.2, B = -1.0, C = -0.1, D = -0.8, E = -0.5)
b_BD <- 0.5                                            # relaksacja i coach częściowo się dublują
mu <- 20 + as.matrix(dane[, names(b)]) %*% b + b_BD * dane$B * dane$D
dane$stres <- round(pmin(pmax(rnorm(nrow(dane), mu, 6), 0), 40))
write.csv(dane, "eksperyment-frakcyjny-5-skladnikow.csv", row.names = FALSE)

table(table(dane$warunek))                             # 16 warunków po 28 osób
sapply(dane[, c("A", "B", "C", "D", "E")], function(x) table(x))   # każdy składnik: 224 vs 224

# Model: efekty główne i wszystkie interakcje 2-czynnikowe (plan V je rozdziela)
m <- lm(stres ~ (A + B + C + D + E)^2, data = dane)
wsp <- cbind(b = coef(m), SE = coef(summary(m))[, 2], confint(m),
             p = coef(summary(m))[, 4])[-1, ]
round(wsp, 3)
df.residual(m)
# Różnice "włączony - wyłączony" dla efektów głównych (2 x b) z 95% CI
round(2 * wsp[1:5, c("b", "2.5 %", "97.5 %")], 2)
# Średnie brzegowe dla relaksacji (B) - to samo z danych bez modelu
round(tapply(dane$stres, dane$B, mean), 2)
# Efekty proste B przy D = -1 i D = +1 (różnice średnich)
round(sapply(c(-1, 1), function(d) with(subset(dane, D == d), mean(stres[B == 1]) - mean(stres[B == -1]))), 2)

# To samo z kodowaniem 0/1: współczynnik B to efekt prosty przy pozostałych składnikach wyłączonych
d01 <- dane; d01[, names(b)] <- (d01[, names(b)] + 1) / 2
m01 <- lm(stres ~ (A + B + C + D + E)^2, data = d01)
round(rbind(efekt_glowny_B = 2 * coef(m)["B"], kodowanie_01_B = coef(m01)["B"],
            SE_efekt = 2 * coef(summary(m))["B", 2], SE_01 = coef(summary(m01))["B", 2]), 3)
Wynik w R
28
16
     A   B   C   D   E
-1 224 224 224 224 224
1  224 224 224 224 224
         b    SE  2.5 % 97.5 %     p
A   -0.225 0.286 -0.788  0.337 0.431
B   -1.181 0.286 -1.744 -0.618 0.000
C    0.342 0.286 -0.221  0.904 0.234
D   -0.801 0.286 -1.364 -0.239 0.005
E   -0.730 0.286 -1.293 -0.167 0.011
A:B  0.359 0.286 -0.203  0.922 0.210
A:C -0.484 0.286 -1.047  0.078 0.091
A:D -0.315 0.286 -0.877  0.248 0.272
A:E -0.047 0.286 -0.610  0.516 0.870
B:C -0.368 0.286 -0.931  0.194 0.199
B:D  0.569 0.286  0.006  1.132 0.047
B:E  0.105 0.286 -0.458  0.668 0.714
C:D  0.225 0.286 -0.337  0.788 0.431
C:E -0.292 0.286 -0.855  0.270 0.308
D:E  0.386 0.286 -0.177  0.949 0.178
[1] 432
      b 2.5 % 97.5 %
A -0.45 -1.58   0.67
B -2.36 -3.49  -1.24
C  0.68 -0.44   1.81
D -1.60 -2.73  -0.48
E -1.46 -2.59  -0.33
   -1     1
21.07 18.71
[1] -3.50 -1.22
                    B
efekt_glowny_B -2.362
kodowanie_01_B -3.692
SE_efekt        0.573
SE_01           1.280
3. Liczebność, moc i skutki za niskiej rozdzielczości
R
# Krok 3. Ile osób? Porównanie planów i "recykling" uczestników
# Najmniejsza interesująca różnica: 1.6 punktu PSS przy SD = 6 (d = 0.27), alfa = .05, moc .80
n_gr <- ceiling(power.t.test(delta = 1.6, sd = 6, power = .80)$n)
n_gr                                                    # osób w grupie w zwykłym porównaniu 2 grup
do_wielokrotnosci <- function(N, k) k * ceiling(N / k)
plany <- data.frame(
  plan = c("5 osobnych eksperymentów (2 grupy)", "jednoczynnikowy: kontrola + 5 ramion",
           "pełny czynnikowy 2^5", "frakcyjny 2^(5-1), rozdz. V", "frakcyjny 2^(5-2), rozdz. III"),
  warunki = c(10, 6, 32, 16, 8),
  N = c(5 * 2 * n_gr, 6 * n_gr, do_wielokrotnosci(2 * n_gr, 32),
        do_wielokrotnosci(2 * n_gr, 16), do_wielokrotnosci(2 * n_gr, 8)))
plany$na_warunek <- plany$N / plany$warunki
plany

# Symulacja: moc w planie 2^(5-1) przy N = 448 (28 osób na warunek), 1000 powtórzeń
symuluj <- function(Xplan, n_war, R = 1000, model = ~ (A + B + C + D + E)^2) {
  d <- as.data.frame(Xplan[rep(seq_len(nrow(Xplan)), each = n_war), ])
  mu <- 20 + as.matrix(d[, names(b)]) %*% b + b_BD * d$B * d$D
  t(replicate(R, {
    d$stres <- rnorm(nrow(d), mu, 6)
    cf <- coef(summary(lm(update(model, stres ~ .), data = d)))
    c(cf[-1, 1], p = cf[-1, 4])
  }))
}
set.seed(3413)
s16 <- symuluj(X, n_war = 28)
moc16 <- colMeans(s16[, grep("^p\\.", colnames(s16))] < .05)
round(moc16[c("p.B", "p.D", "p.E", "p.B:D", "p.A:C")], 3)   # A:C - interakcja zerowa (błąd I rodzaju)
round(sqrt(.8 * .2 / 1000), 3)                                # błąd Monte Carlo mocy .80

# Plan 2^(5-2) (rozdz. III) przy tym samym N = 448: tylko efekty główne, bo innych nie da się rozdzielić
X8 <- sapply(as.data.frame(plan8), function(x) as.numeric(as.character(x)))
set.seed(3414)
s8 <- symuluj(X8, n_war = 56, model = ~ A + B + C + D + E)
round(rbind(prawda = b["A"],
            srednia_V = mean(s16[, "A"]), srednia_III = mean(s8[, "A"])), 3)
# Jak często psychoedukacja (A) "istotnie szkodzi" (b > 0, p < .05), a jak często "pomaga"?
round(c(szkodzi_V = mean(s16[, "A"] > 0 & s16[, "p.A"] < .05),
        szkodzi_III = mean(s8[, "A"] > 0 & s8[, "p.A"] < .05),
        pomaga_V = mean(s16[, "A"] < 0 & s16[, "p.A"] < .05),
        pomaga_III = mean(s8[, "A"] < 0 & s8[, "p.A"] < .05)), 3)
write.csv(data.frame(plan = rep(c("2^(5-1), rozdzielczość V", "2^(5-2), rozdzielczość III"), each = 1000),
                     A = c(s16[, "A"], s8[, "A"])), "oszacowania-A.csv", row.names = FALSE)
Wynik w R
[1] 222
                                  plan warunki    N na_warunek
1   5 osobnych eksperymentów (2 grupy)      10 2220        222
2 jednoczynnikowy: kontrola + 5 ramion       6 1332        222
3                 pełny czynnikowy 2^5      32  448         14
4          frakcyjny 2^(5-1), rozdz. V      16  448         28
5        frakcyjny 2^(5-2), rozdz. III       8  448         56
  p.B   p.D   p.E p.B:D p.A:C
0.934 0.789 0.421 0.425 0.057
[1] 0.013
                 A
prawda      -0.200
srednia_V   -0.204
srednia_III  0.285
  szkodzi_V szkodzi_III    pomaga_V  pomaga_III
      0.002       0.175       0.109       0.002
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 z pakietem FrF2 (który korzysta z pakietu DoE.base); liczebność i modele policzono funkcjami power.t.test() i lm() pakietu stats. Rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- FrF2 (wersja 2.3-5): Grömping, U. (2014). R package FrF2 for creating and analyzing fractional factorial 2-level designs. Journal of Statistical Software, 56(1). https://doi.org/10.18637/jss.v056.i01
- DoE.base (wersja 1.2-5): Grömping, U. (2018). R package DoE.base for factorial experiments. Journal of Statistical Software, 85(5). https://doi.org/10.18637/jss.v085.i05
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Liczenie próby „na warunek”. 28 osób na warunek wygląda na mało, ale efekt główny porównuje 224 z 224 osobami. Moc licz dla efektu, a nie dla komórki.
- Kodowanie 0/1 przy modelu z interakcjami. Współczynniki stają się efektami prostymi przy wszystkich pozostałych składnikach wyłączonych, mają większe błędy i odpowiadają na inne pytanie.
- Analiza komórek zamiast czynników. Porównywanie 16 warunków parami testem post hoc marnuje zaletę planu. Analizuj efekty główne i interakcje.
- Rozdzielczość III „bo tańsza”. Gdy interakcje istnieją, przechodzą na efekty główne. Przed wyborem planu wypisz aliasy funkcją
aliasprint(). - Interpretacja aliasu jako jednego efektu. W planie V interakcja AB to formalnie suma AB i interakcji trzech pozostałych składników. Zakładasz, że ta druga jest pomijalna, i piszesz to wprost.
- Brak reguły decyzyjnej. Bez niej wybór składników po obejrzeniu wyników łatwo dopasować do oczekiwań.
Najczęstsze pytania
Ile osób potrzeba do eksperymentu czynnikowego z kilkoma składnikami?
Licz moc dla efektu głównego, a nie dla komórki. Każdy efekt główny porównuje połowę próby z drugą połową, więc liczebność odpowiada zwykłemu porównaniu dwóch grup. W przykładzie dla d = 0.27 i mocy .80 pięć składników wymagało 448 osób łącznie (po 28 na każdy z 16 warunków), a pięć osobnych eksperymentów – 2220.
Czym różni się plan frakcyjny rozdzielczości III, IV i V?
W rozdzielczości III efekty główne są aliasowane z interakcjami dwuczynnikowymi, w IV są od nich wolne, ale interakcje dwuczynnikowe mieszają się ze sobą, a w V efekty główne i interakcje dwuczynnikowe są od siebie oddzielone. Do wyboru składników interwencji zwykle wybiera się co najmniej IV, a gdy interesują Cię interakcje par – V.
Jak sprawdzić aliasy planu frakcyjnego w R?
Utwórz plan funkcją FrF2() z pakietu FrF2, np. FrF2(nruns = 16, nfactors = 5), a potem wywołaj aliasprint() i design.info()$catlg.entry. Dostaniesz generator, rozdzielczość i listę aliasów efektów głównych i interakcji dwuczynnikowych.
Dlaczego w eksperymencie czynnikowym koduje się czynniki −1 i +1?
Przy kodowaniu −1/+1 współczynnik to połowa różnicy średnich brzegowych, czyli efekt główny uśredniony po pozostałych składnikach, a wszystkie efekty mają ten sam błąd standardowy. Przy kodowaniu 0/1 i interakcjach w modelu współczynnik oznacza efekt przy wyłączonych pozostałych składnikach: w przykładzie −3.69 (SE = 1.28) zamiast −2.36 (SE = 0.57).
Czym jest MOST w badaniach interwencji?
MOST (multiphase optimization strategy) to strategia, w której przed RCT sprawdza się w randomizowanych eksperymentach, które składniki interwencji włączyć i na jakim poziomie. Eksperyment czynnikowy lub frakcyjny jest typowym narzędziem fazy przesiewowej, a zoptymalizowany pakiet potwierdza się potem w RCT.
Powiązane hasła
Przeczytaj też
Statystyka w pracy inżynierskiej z badaniem
Co jest powtórzeniem, porównanie wariantów, plan 2^3, krzywa kalibracyjna, niepewność pomiaru i Weibull: analizy, zdania do pracy i kod R.
Czytaj →PoradnikMoc testu dla interakcji
Dlaczego test interakcji wymaga 4–16 razy większej próby: kształt interakcji, rzetelność iloczynu, symulacja w R i opis analizy mocy.
Czytaj →PoradnikInterakcja w ANOVA – jak ją opisać
Co zrobić po istotnej interakcji: wykres, efekty proste na średnich brzegowych, interakcja porządkująca i krzyżowa oraz gotowy wzór opisu APA.
Czytaj →PoradnikEksperyment conjoint i winietowy
Atrybuty i zadania, AMCE z błędami klastrowanymi, średnie brzegowe w podgrupach i winiety w modelu mieszanym – na danych w R.
Czytaj →PoradnikEksperyment czynnikowy w mailingu
Marketplace z rękodziełem: temat, godzina i personalizacja w kostce 2³, interakcje w punktach procentowych, plan frakcyjny i trzy testy A/B – pięć rysunków z kodem R.
Czytaj →Planujesz eksperyment z kilkoma składnikami interwencji?
Pomożemy dobrać plan czynnikowy lub frakcyjny, sprawdzić aliasy, policzyć liczebność i przygotować analizę tak, żebyś mógł(a) samodzielnie uzasadnić wybór planu przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Collins, L. M. (2018). Optimization of behavioral, biobehavioral, and biomedical interventions: The multiphase optimization strategy (MOST). Springer. https://doi.org/10.1007/978-3-319-72206-1
- Collins, L. M., Dziak, J. J., & Li, R. (2009). Design of experiments with multiple independent variables: A resource management perspective on complete and reduced factorial designs. Psychological Methods, 14(3), 202–224. https://doi.org/10.1037/a0015826 ● Otwarty dostęp: pełny tekst
- Collins, L. M., Dziak, J. J., Kugler, K. C., & Trail, J. B. (2014). Factorial experiments: Efficient tools for evaluation of intervention components. American Journal of Preventive Medicine, 47(4), 498–504. https://doi.org/10.1016/j.amepre.2014.06.021 ● Otwarty dostęp: pełny tekst
- Collins, L. M., Murphy, S. A., & Strecher, V. (2007). The multiphase optimization strategy (MOST) and the sequential multiple assignment randomized trial (SMART): New methods for more potent eHealth interventions. American Journal of Preventive Medicine, 32(5), S112–S118. https://doi.org/10.1016/j.amepre.2007.01.022 ● Otwarty dostęp: pełny tekst
- Collins, L. M., Trail, J. B., Kugler, K. C., Baker, T. B., Piper, M. E., & Mermelstein, R. J. (2014). Evaluating individual intervention components: Making decisions based on the results of a factorial screening experiment. Translational Behavioral Medicine, 4(3), 238–251. https://doi.org/10.1007/s13142-013-0239-7 ● Otwarty dostęp
- Grömping, U. (2014). R package FrF2 for creating and analyzing fractional factorial 2-level designs. Journal of Statistical Software, 56(1). https://doi.org/10.18637/jss.v056.i01 ● Otwarty dostęp
- Kugler, K. C., Dziak, J. J., & Trail, J. (2018). Coding and interpretation of effects in analysis of data from a factorial experiment. Optimization of behavioral, biobehavioral, and biomedical interventions: Advanced topics. https://doi.org/10.1007/978-3-319-91776-4_6
- Piper, M. E., Fiore, M. C., Smith, S. S., Fraser, D., Bolt, D. M., Collins, L. M., Mermelstein, R., Schlam, T. R., Cook, J. W., Jorenby, D. E., Loh, W.-Y., & Baker, T. B. (2016). Identifying effective intervention components for smoking cessation: A factorial screening experiment. Addiction, 111(1), 129–141. https://doi.org/10.1111/add.13162 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@book{collins2018optimization, author={Collins, Linda M.}, title={{Optimization of behavioral, biobehavioral, and biomedical interventions: The multiphase optimization strategy (MOST)}}, year={2018}, publisher={Springer}, doi={10.1007/978-3-319-72206-1}}@article{collins2009design, author={Collins, Linda M. and Dziak, John J. and Li, Runze}, title={{Design of experiments with multiple independent variables: A resource management perspective on complete and reduced factorial designs}}, journal={Psychological Methods}, year={2009}, volume={14}, number={3}, pages={202--224}, doi={10.1037/a0015826}}@article{collins2014factorial, author={Collins, Linda M. and Dziak, John J. and Kugler, Kari C. and Trail, Jessica B.}, title={{Factorial experiments: Efficient tools for evaluation of intervention components}}, journal={American Journal of Preventive Medicine}, year={2014}, volume={47}, number={4}, pages={498--504}, doi={10.1016/j.amepre.2014.06.021}}@article{collins2007multiphase, author={Collins, Linda M. and Murphy, Susan A. and Strecher, Victor}, title={{The multiphase optimization strategy (MOST) and the sequential multiple assignment randomized trial (SMART): New methods for more potent eHealth interventions}}, journal={American Journal of Preventive Medicine}, year={2007}, volume={32}, number={5}, pages={S112--S118}, doi={10.1016/j.amepre.2007.01.022}}@article{collins2014evaluating, author={Collins, Linda M. and Trail, Jessica B. and Kugler, Kari C. and Baker, Timothy B. and Piper, Megan E. and Mermelstein, Robin J.}, title={{Evaluating individual intervention components: Making decisions based on the results of a factorial screening experiment}}, journal={Translational Behavioral Medicine}, year={2014}, volume={4}, number={3}, pages={238--251}, doi={10.1007/s13142-013-0239-7}}@article{gromping2014r, author={Grömping, Ulrike}, title={{R package FrF2 for creating and analyzing fractional factorial 2-level designs}}, journal={Journal of Statistical Software}, year={2014}, volume={56}, number={1}, doi={10.18637/jss.v056.i01}}@misc{kugler2018coding, author={Kugler, Kari C. and Dziak, John J. and Trail, Jessica}, title={{Coding and interpretation of effects in analysis of data from a factorial experiment}}, howpublished={Optimization of behavioral, biobehavioral, and biomedical interventions: Advanced topics}, year={2018}, pages={175--205}, publisher={Springer}, doi={10.1007/978-3-319-91776-4_6}}@article{piper2016identifying, author={Piper, Megan E. and Fiore, Michael C. and Smith, Stevens S. and Fraser, David and Bolt, Daniel M. and Collins, Linda M. and Mermelstein, Robin and Schlam, Tanya R. and Cook, Jessica W. and Jorenby, Douglas E. and Loh, Wei-Yin and Baker, Timothy B.}, title={{Identifying effective intervention components for smoking cessation: A factorial screening experiment}}, journal={Addiction}, year={2016}, volume={111}, number={1}, pages={129--141}, doi={10.1111/add.13162}}