/EMMEANS=TABLES(A*B) COMPARE(B) ADJ(BONFERRONI), a okna Post Hoc używaj tylko dla efektów głównych. Opcja Estimates of effect size daje η² cząstkowe.Do czego służy GLM Univariate
Dwuczynnikową ANOVA w SPSS liczysz w procedurze GLM Univariate. To analiza wariancji dla jednej zmiennej zależnej, w której jest kilka czynników i ich interakcje, przy równych albo nierównych liczebnościach komórek (IBM Corp., b.d.-g). Wcześniej opisaliśmy ANOVA jednoczynnikową w SPSS i ANOVA z powtarzanymi pomiarami i mieszaną w SPSS. Logikę schematu czynnikowego, założenia i obliczenia w R omawia poradnik ANOVA krok po kroku, a znaczenie interakcji – wpis interakcja w ANOVA – jak ją zinterpretować. Tutaj zajmujemy się tylko SPSS: oknami, składnią i tym, co przepisać z wydruku.
Ścieżki menu i nazwy opcji sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 i podajemy po angielsku. Procedura należy do wersji Statistics Base (IBM Corp., b.d.-g, b.d.-j). Polska dokumentacja podaje ścieżkę Analizuj → Ogólny model liniowy → Jednoczynnikowy i nazwę okna „Analiza OML jednej zmiennej” (IBM Corp., b.d.-g). „Jednoczynnikowy” oznacza tu jedną zmienną zależną, a nie jeden czynnik. Inne polskie etykiety w programie mogą brzmieć inaczej. Ogólne zasady czytania wydruku opisuje wpis jak czytać wyniki z SPSS.
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 126 osób studiujących rozwiązało test uwagi (wynik 0–60). Pierwszy czynnik to chronotyp: poranny albo wieczorny. Drugi to pora testu, losowo przydzielona: 8:00, 12:00 albo 18:00. To schemat 2 × 3 z nierównymi komórkami (18–24 osoby). Pytanie badawcze dotyczy interakcji: czy przewaga jednego chronotypu zależy od pory testu?
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS opisuje hasło plik .sav.
Przygotowanie danych
Dane mają format długi: jeden wiersz to jedna osoba. Zmienna zależna wynik jest ilościowa. Czynniki chronotyp (1 = poranny, 2 = wieczorny) i pora (1 = 8:00, 2 = 12:00, 3 = 18:00) mają kody liczbowe z etykietami wartości. Dokumentacja wymaga, by czynniki były kategorialne, a zmienna zależna ilościowa (IBM Corp., b.d.-g). Etykiety, poziom pomiaru i braki danych ustawisz według wpisu przygotowanie danych w SPSS.
Okna procedury krok po kroku
- Analyze → General Linear Model → Univariate (IBM Corp., b.d.-g). Przenieś
wynikdo pola Dependent Variable, achronotypiporado pola Fixed Factor(s). - Model. Zostaw Full factorial, czyli wszystkie efekty główne i interakcję czynników (IBM Corp., b.d.-c). Typ sum kwadratów zostaw na Type III. Według dokumentacji jest najczęściej stosowany w modelach bez pustych komórek, zrównoważonych i niezrównoważonych (IBM Corp., b.d.-c). W składni typ III jest domyślny (IBM Corp., b.d.-j).
- Plots. Przenieś
porana oś poziomą, achronotypdo Separate Lines i kliknij Add. Możesz dodać słupki błędów z przedziałem ufności (IBM Corp., b.d.-f). Powstanie wykres interakcji. - Post Hoc. Testy post hoc dotyczą tylko czynników, nie interakcji (IBM Corp., b.d.-e). Przenieś
porado listy Post Hoc Tests for i zaznacz Tukey. - EM Means. Przenieś
chronotyp*porado listy Display Means For i zaznacz Compare simple main effects z korektą Bonferroni. Pole efektów prostych jest aktywne tylko dla interakcji (IBM Corp., b.d.-b). - Options. Zaznacz Descriptive statistics, Estimates of effect size i Homogeneity tests (IBM Corp., b.d.-d). Kliknij Paste, żeby zobaczyć składnię
UNIANOVA, albo OK.
Drugi kierunek efektów prostych dopiszesz w składni (przepis 1 niżej).
Jak czytać wydruk
Tabele niżej mają układ tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Dokumentacja IBM potwierdza w tekście nazwy Tests of Between-Subjects Effects, test Levene’a, Multiple Comparisons i η² cząstkowe (IBM Corp., b.d.-k). Pozostałe nazwy tabel, wierszy i kolumn odtworzyliśmy z typowego wydruku. Pogrubiono liczby, które trafią do pracy.
| chronotyp | pora | Mean | Std. Deviation | N |
|---|---|---|---|---|
| poranny | 8:00 | 43.68 | 6.395 | 22 |
| 12:00 | 39.60 | 5.082 | 20 | |
| 18:00 | 39.00 | 5.421 | 24 | |
| Total | 40.74 | 5.967 | 66 | |
| wieczorny | 8:00 | 37.16 | 4.311 | 19 |
| 12:00 | 41.74 | 5.047 | 23 | |
| 18:00 | 40.94 | 4.795 | 18 | |
| Total | 40.05 | 5.084 | 60 | |
| Total | 8:00 | 40.66 | 6.378 | 41 |
| 12:00 | 40.74 | 5.118 | 43 | |
| 18:00 | 39.83 | 5.193 | 42 | |
| Total | 40.41 | 5.553 | 126 |
Wiersze Total są średnimi ważonymi liczebnościami, więc przy nierównych komórkach różnią się od średnich brzegowych z modelu (o nich niżej).
Test Levene’a
| Levene Statistic | df1 | df2 | Sig. | |
|---|---|---|---|---|
| Based on Mean | .720 | 5 | 120 | .610 |
| Based on Median | .607 | 5 | 120 | .695 |
| Based on trimmed mean | .683 | 5 | 120 | .637 |
Test Levene’a porównuje wariancje błędu we wszystkich sześciu komórkach, stąd df1 = 5 (IBM Corp., b.d.-i). W modelu pełnym bez kowariant SPSS podaje wersje od średniej, od mediany (także z poprawionymi df) i od średniej obciętej (IBM Corp., b.d.-i). Wersja od mediany jest odporniejsza na nienormalność (Brown i Forsythe, 1974). Wiersz od średniej obciętej liczyliśmy z 5% obcięcia w R i jego ostatnia cyfra może się różnić. Tu żadna nie jest istotna. Nie traktuj jednak testu jak bramki: wstępne testy wariancji słabo chronią przed błędem I rodzaju (Zimmerman, 2004). Ważniejsze jest, czy odchylenia w komórkach są podobne.
Tests of Between-Subjects Effects
| Source | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared |
|---|---|---|---|---|---|---|
| Corrected Model | 543.061 | 5 | 108.612 | 3.936 | .002 | .141 |
| Intercept | 203000.018 | 1 | 203000.018 | 7356.232 | .000 | .984 |
| chronotyp | 20.622 | 1 | 20.622 | .747 | .389 | .006 |
| pora | 10.433 | 2 | 5.216 | .189 | .828 | .003 |
| chronotyp * pora | 503.854 | 2 | 251.927 | 9.129 | .000 | .132 |
| Error | 3311.478 | 120 | 27.596 | |||
| Total | 209636.000 | 126 | ||||
| Corrected Total | 3854.540 | 125 |
Pod tabelą SPSS podaje R Squared = .141 i Adjusted R Squared = .105. Najpierw czytaj wiersz interakcji, bo od niego zależy reszta opisu. Interakcja jest istotna: F(2, 120) = 9.13, p < .001, η²p = .13. Oba efekty główne są nieistotne. Nie znaczy to, że chronotyp i pora „nie działają”. Ich wpływ ma przeciwny kierunek w różnych komórkach i w średnich się znosi. Taką interakcję definiują Rosnow i Rosenthal (1989): to reszta po usunięciu efektów głównych, a nie same różnice między komórkami. Kim (2014) dodaje, że wykryje ją tylko model z oboma czynnikami.
Wierszy Intercept, Total i Corrected Model zwykle nie raportujesz. Stopnie swobody bierzesz z wiersza efektu i z wiersza Error. Kolumna Partial Eta Squared to η² cząstkowe: suma kwadratów efektu podzielona przez sumę tej wartości i SS błędu (503.854 / (503.854 + 3311.478) = .132). Dokumentacja zaznacza, że zawyża ono rzeczywistą wielkość efektu (IBM Corp., b.d.-i). Opisuj je jako η²p, bo bywa mylone ze zwykłym η² (Richardson, 2011).
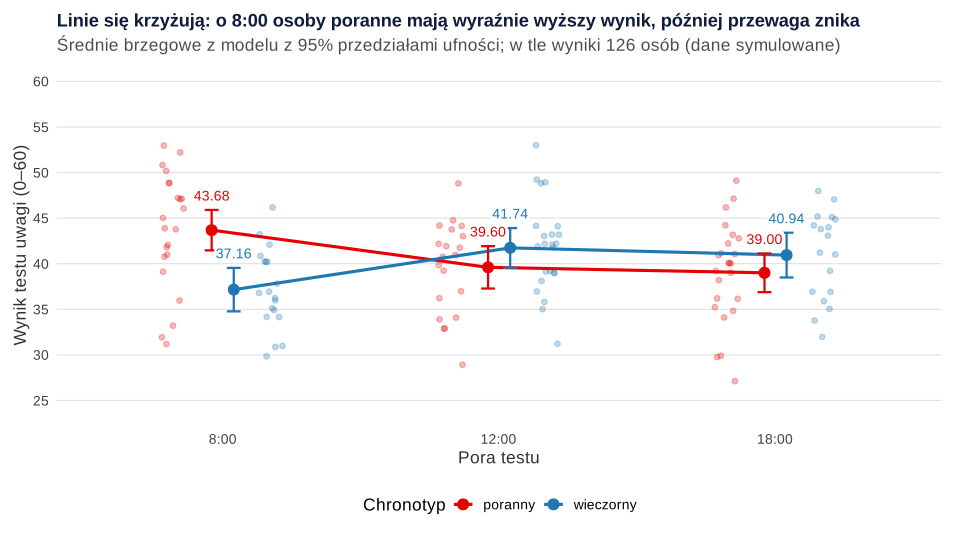
Wykres profilowy SPSS pokazuje średnie brzegowe z modelu (IBM Corp., b.d.-f). Linie nierównoległe sugerują interakcję, ale jej istotność potwierdza dopiero tabela efektów (IBM Corp., b.d.-k).
Typ III sum kwadratów przy nierównych komórkach
Przy równych komórkach typy sum kwadratów dają ten sam wynik. Przy nierównych różnią się efekty główne. W przykładzie typ II daje dla chronotypu SS = 17.91 i p = .422, a dla pory SS = 24.14 i p = .647. Typ III daje 20.62 i 10.43. Interakcja ma w obu typach tę samą sumę kwadratów. Langsrud (2003) oraz Smith i Cribbie (2014) zalecają typ II do testowania efektów głównych, gdy interakcji nie ma. Gdy interakcja jest istotna, jak tutaj, i tak opisujesz efekty proste. Typ wybierz przed analizą i nazwij go w metodzie. Więcej o nierównych liczebnościach mówi wpis nierówne grupy w analizie.
Efekty proste: EMMEANS z COMPARE
Istotną interakcję rozkładasz na efekty proste. W składni służy do tego /EMMEANS=TABLES(chronotyp*pora) COMPARE(pora) ADJ(BONFERRONI). Według Command Syntax Reference poziomy wskazanego czynnika są porównywane w obrębie każdego poziomu pozostałych. Dla każdej pary SPSS podaje różnicę, błąd standardowy, istotność i przedział ufności oraz test zbiorczy efektu (IBM Corp., b.d.-a). Błąd standardowy pochodzi z całego modelu (MS Error = 27.596, df = 120).
| chronotyp | Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared | |
|---|---|---|---|---|---|---|---|
| poranny | Contrast | 289.037 | 2 | 144.518 | 5.237 | .007 | .080 |
| Error | 3311.478 | 120 | 27.596 | ||||
| wieczorny | Contrast | 238.923 | 2 | 119.462 | 4.329 | .015 | .067 |
| Error | 3311.478 | 120 | 27.596 |
| chronotyp | (I) pora | (J) pora | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| poranny | 8:00 | 12:00 | 4.082* | 1.623 | .040 | .141 | 8.022 |
| 8:00 | 18:00 | 4.682* | 1.551 | .009 | .917 | 8.447 | |
| 12:00 | 18:00 | .600 | 1.591 | 1.000 | −3.262 | 4.462 | |
| wieczorny | 8:00 | 12:00 | −4.581* | 1.629 | .017 | −8.535 | −.627 |
| 8:00 | 18:00 | −3.787 | 1.728 | .091 | −7.982 | .409 | |
| 12:00 | 18:00 | .795 | 1.653 | 1.000 | −3.219 | 4.809 | |
Pora ma znaczenie w obu grupach, ale w przeciwnym kierunku. Osoby poranne o 8:00 wypadły lepiej niż o 12:00 i 18:00. Osoby wieczorne o 8:00 wypadły gorzej niż o 12:00. Różnica 8:00–18:00 u osób wieczornych nie przekroczyła progu po korekcie (p = .091). SPSS wypisuje każdą parę w obu kierunkach, my zostawiliśmy po jednym wierszu.
| pora | (I) chronotyp | (J) chronotyp | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| 8:00 | poranny | wieczorny | 6.524* | 1.645 | .000 | 3.267 | 9.781 |
| 12:00 | poranny | wieczorny | −2.139 | 1.606 | .185 | −5.319 | 1.041 |
| 18:00 | poranny | wieczorny | −1.944 | 1.638 | .238 | −5.188 | 1.299 |
Przy dwóch poziomach jest jedna para, więc korekta nic nie zmienia, a test zbiorczy daje to samo p: o 8:00 F(1, 120) = 15.72, p < .001, η²p = .12. O 12:00 i 18:00 chronotypy nie różnią się istotnie. Wybierz jeden kierunek rozkładu, zgodny z pytaniem badawczym. Raportowanie obu podwaja liczbę testów.
Post hoc dla efektu głównego
Okno Post Hoc działa tylko dla czynników. Porównania liczy na wartościach nieskorygowanych, czyli na średnich obserwowanych poziomu bez podziału na drugi czynnik (IBM Corp., b.d.-e). Studium przypadku IBM ostrzega, że takie wyniki nie uwzględniają poziomów innych czynników (IBM Corp., b.d.-k). Dlatego testy post hoc mają sens dla efektu głównego czynnika z co najmniej trzema poziomami, gdy interakcji nie ma.
| (I) pora | (J) pora | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval | |
|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | |||||
| 8:00 | 12:00 | −.086 | 1.147 | .997 | −2.807 | 2.636 |
| 8:00 | 18:00 | .825 | 1.153 | .755 | −1.912 | 3.562 |
| 12:00 | 18:00 | .911 | 1.140 | .704 | −1.794 | 3.615 |
Tu test Tukeya nie znajduje różnic między porami, bo efekt pory zależy od chronotypu. Tę tabelę pokazujemy jako przestrogę, a nie wynik do pracy. Zwróć też uwagę na średnie. Post hoc porównuje średnie obserwowane (40.66, 40.74 i 39.83), a EM Means – nieważone średnie brzegowe z modelu (40.42, 40.67 i 39.97). Przy nierównych komórkach to nie są te same liczby. Wersje dla nierównych wariancji, np. Games-Howell, SPSS pomija, gdy w modelu jest kilka czynników (IBM Corp., b.d.-e, b.d.-j). Zasady wyboru testu opisuje wpis testy post hoc – który wybrać, a ogólne zasady porównań wielokrotnych – Lee i Lee (2018).
Zapis wyników w stylu APA
Podaj schemat, typ sum kwadratów, wynik interakcji z η²p, efekty główne i efekty proste z przedziałami ufności. Wzór do dostosowania:
Wzór tabeli do pracy pokazuje hasło tabela ANOVA w APA, a więcej gotowych zdań – wpis jak opisać wyniki w stylu APA. Zdania do innych testów przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS (tym, który otwiera przycisk Paste). Napisaliśmy ją według opisu polecenia UNIANOVA i jego podkomend EMMEANS, PLOT i PRINT w Command Syntax Reference (IBM Corp., b.d.-a, b.d.-h, b.d.-i, b.d.-j), ale nie uruchamialiśmy jej w SPSS. W PROFILE(pora*chronotyp) pierwszy czynnik trafia na oś poziomą, a drugi tworzy osobne linie (IBM Corp., b.d.-h). Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel: test Levene’a, sumy kwadratów typu III, η² cząstkowe, efekty proste z poprawką Bonferroniego i test Tukeya (pakiety car i emmeans).
1. Składnia SPSS: UNIANOVA z EMMEANS i POSTHOC
SPSS
* Składnia zgodna z opisem UNIANOVA w Command Syntax Reference; nie była uruchamiana w SPSS.
* ANOVA dwuczynnikowa 2 x 3: model pełny, typ III, Levene, eta kwadrat cząstkowe, wykres profilowy,
* efekty proste w obu kierunkach z korektą Bonferroniego i Tukey dla efektu głównego pory.
UNIANOVA wynik BY chronotyp pora
  /METHOD=SSTYPE(3)
  /INTERCEPT=INCLUDE
  /POSTHOC=pora(TUKEY)
  /PLOT=PROFILE(pora*chronotyp) TYPE=LINE ERRORBAR=CI
  /EMMEANS=TABLES(chronotyp*pora) COMPARE(pora) ADJ(BONFERRONI)
  /EMMEANS=TABLES(chronotyp*pora) COMPARE(chronotyp) ADJ(BONFERRONI)
  /PRINT=DESCRIPTIVE HOMOGENEITY ETASQ
  /CRITERIA=ALPHA(.05)
  /DESIGN=chronotyp pora chronotyp*pora.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B307 – ANOVA dwuczynnikowa (GLM Univariate): liczby do tabel w układzie SPSS
# Dane symulowane, set.seed(3071): wynik testu uwagi (0–60) u 126 osób studiujących,
# czynnik A – chronotyp (poranny, wieczorny), czynnik B – pora testu (8:00, 12:00, 18:00),
# nierówne liczebności komórek (18–24 osoby).
# Metody jak w UNIANOVA w SPSS: sumy kwadratów typu III (kontrasty sumujące się do zera),
# test Levene'a (od średniej, mediany i średniej obciętej 5%), cząstkowe eta kwadrat,
# EMMEANS z COMPARE i korektą Bonferroniego (błąd z całego modelu), Tukey dla efektu głównego.
suppressPackageStartupMessages({ library(haven); library(car); library(emmeans) })
set.seed(3071)
n_kom <- c(22, 20, 24, 19, 23, 18)                   # poranny 8/12/18, wieczorny 8/12/18
sr_kom <- c(44, 41, 37, 36, 40, 43)
chrono <- rep(rep(1:2, each = 3), n_kom)
pora <- rep(rep(1:3, 2), n_kom)
wynik <- round(rnorm(sum(n_kom), rep(sr_kom, n_kom), 6.5))
wynik <- pmin(60, pmax(0, wynik))
dane <- data.frame(id = seq_along(wynik), chronotyp = chrono, pora = pora, wynik = wynik)

# Krok 1. Plik .sav z etykietami zmiennych i wartości – i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$chronotyp <- labelled(sav$chronotyp, labels = c("poranny" = 1, "wieczorny" = 2), label = "Chronotyp")
sav$pora <- labelled(sav$pora, labels = c("8:00" = 1, "12:00" = 2, "18:00" = 3), label = "Pora testu")
sav$wynik <- labelled(sav$wynik, label = "Wynik testu uwagi (0–60)")
write_sav(sav, "../anova-dwuczynnikowa-spss-dane.sav")
write.csv(dane, "../anova-dwuczynnikowa-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

dane$chronotyp <- factor(dane$chronotyp, levels = 1:2, labels = c("poranny", "wieczorny"))
dane$pora <- factor(dane$pora, levels = 1:3, labels = c("8:00", "12:00", "18:00"))

# Krok 2. Descriptive Statistics: średnia, SD i N w komórkach oraz wiersze Total
opis <- function(d) data.frame(M = mean(d$wynik), SD = sd(d$wynik), N = nrow(d))
wiersze_opisu <- list()
for (a in c(levels(dane$chronotyp), "Total")) for (b in c(levels(dane$pora), "Total")) {
  d <- dane[(a == "Total" | dane$chronotyp == a) & (b == "Total" | dane$pora == b), ]
  wiersze_opisu[[length(wiersze_opisu) + 1]] <- cbind(chronotyp = a, pora = b, opis(d))
}
print(do.call(rbind, wiersze_opisu), digits = 4, row.names = FALSE)

# Krok 3. Levene's Test of Equality of Error Variances (opcja Homogeneity tests):
# grupy = 6 komórek planu; od średniej, od mediany i od średniej obciętej 5%
komorka <- interaction(dane$chronotyp, dane$pora)
lev <- rbind("Based on Mean" = unlist(leveneTest(wynik ~ komorka, dane, center = mean)[1, 1:3]),
             "Based on Median" = unlist(leveneTest(wynik ~ komorka, dane, center = median)[1, 1:3]),
             "Based on trimmed mean" = unlist(leveneTest(wynik ~ komorka, dane, center = mean, trim = 0.05)[1, 1:3]))
lev <- cbind(lev, df2 = nrow(dane) - nlevels(komorka)); print(round(lev, 3))

# Krok 4. Tests of Between-Subjects Effects: typ III przy kontrastach sumujących się do zera
model <- lm(wynik ~ chronotyp * pora, dane, contrasts = list(chronotyp = "contr.sum", pora = "contr.sum"))
a3 <- Anova(model, type = 3)
SSE <- a3["Residuals", "Sum Sq"]; dfE <- a3["Residuals", "Df"]
SST_kor <- sum((dane$wynik - mean(dane$wynik))^2)
tab <- data.frame(SS = c(SST_kor - SSE, a3[c("(Intercept)", "chronotyp", "pora", "chronotyp:pora"), "Sum Sq"], SSE,
                         sum(dane$wynik^2), SST_kor),
                  df = c(5, a3[c("(Intercept)", "chronotyp", "pora", "chronotyp:pora"), "Df"], dfE, nrow(dane), nrow(dane) - 1),
                  row.names = c("Corrected Model", "Intercept", "chronotyp", "pora", "chronotyp * pora", "Error", "Total", "Corrected Total"))
tab$MS <- tab$SS / tab$df
tab$F <- c(tab$MS[1:5] / (SSE / dfE), NA, NA, NA)
tab$p <- pf(tab$F, tab$df, dfE, lower.tail = FALSE)
tab$eta2p <- c(tab$SS[1:5] / (tab$SS[1:5] + SSE), NA, NA, NA)
print(tab, digits = 6)
round(c(R2 = summary(model)$r.squared, R2_adj = summary(model)$adj.r.squared), 3)
# dla porównania: typ II (efekty główne bez interakcji w modelu porównawczym)
print(Anova(model, type = 2), digits = 6)

# Krok 5. Estimated Marginal Means: średnie nieważone z modelu (EMMEANS=TABLES(...))
em <- emmeans(model, ~ chronotyp * pora)
print(summary(em), digits = 5)
print(summary(emmeans(model, ~ pora)), digits = 5)

# Krok 6. Efekty proste: EMMEANS=TABLES(chronotyp*pora) COMPARE(pora) i COMPARE(chronotyp) ADJ(BONFERRONI)
# Univariate Tests (test zbiorczy efektu prostego, błąd z całego modelu) i Pairwise Comparisons
ut <- function(by) {
  j <- as.data.frame(joint_tests(model, by = by))
  j$SS <- j$F.ratio * j$df1 * (SSE / dfE); j$eta2p <- j$SS / (j$SS + SSE); j
}
print(ut("chronotyp"), digits = 5)
print(ut("pora"), digits = 5)
print(summary(pairs(emmeans(model, ~ pora | chronotyp), adjust = "bonferroni"), infer = TRUE), digits = 5)
print(summary(pairs(emmeans(model, ~ chronotyp | pora), adjust = "bonferroni"), infer = TRUE), digits = 5)

# Krok 7. Post Hoc Tests dla efektu głównego pory: Tukey HSD na średnich obserwowanych
# (bez podziału na chronotyp), z błędem MS Error z całego modelu i poprawką Tukeya–Kramera dla nierównych n
m_obs <- tapply(dane$wynik, dane$pora, mean); n_obs <- tapply(dane$wynik, dane$pora, length)
pary <- combn(3, 2)
tk <- do.call(rbind, lapply(seq_len(ncol(pary)), function(k) {
  i <- pary[1, k]; j <- pary[2, k]
  r <- m_obs[i] - m_obs[j]; se <- sqrt(SSE / dfE * (1 / n_obs[i] + 1 / n_obs[j]))
  q <- abs(r) / (se / sqrt(2)); kr <- qtukey(.95, 3, dfE) * se / sqrt(2)
  data.frame(I = names(m_obs)[i], J = names(m_obs)[j], roznica = r, SE = se,
             p = ptukey(q, 3, dfE, lower.tail = FALSE), lo = r - kr, hi = r + kr) }))
print(tk, digits = 5, row.names = FALSE)
round(c(MS_Error = SSE / dfE, df_Error = dfE), 3)
Wynik:
 chronotyp  pora     M    SD   N
   poranny  8:00 43.68 6.395  22
   poranny 12:00 39.60 5.082  20
   poranny 18:00 39.00 5.421  24
   poranny Total 40.74 5.967  66
 wieczorny  8:00 37.16 4.311  19
 wieczorny 12:00 41.74 5.047  23
 wieczorny 18:00 40.94 4.795  18
 wieczorny Total 40.05 5.084  60
     Total  8:00 40.66 6.378  41
     Total 12:00 40.74 5.118  43
     Total 18:00 39.83 5.193  42
     Total Total 40.41 5.553 126
                      Df F value Pr(>F) df2
Based on Mean          5   0.720  0.610 120
Based on Median        5   0.607  0.695 120
Based on trimmed mean  5   0.683  0.637 120
                          SS  df          MS           F            p      eta2p
Corrected Model     543.0614   5 1.08612e+02    3.935848  2.43572e-03 0.14088878
Intercept        203000.0179   1 2.03000e+05 7356.231919 1.56606e-109 0.98394913
chronotyp            20.6218   1 2.06218e+01    0.747285  3.89062e-01 0.00618883
pora                 10.4329   2 5.21646e+00    0.189032  8.28006e-01 0.00314064
chronotyp * pora    503.8539   2 2.51927e+02    9.129226  2.03879e-04 0.13206030
Error              3311.4783 120 2.75957e+01          NA           NA         NA
Total            209636.0000 126 1.66378e+03          NA           NA         NA
Corrected Total    3854.5397 125 3.08363e+01          NA           NA         NA
    R2 R2_adj
 0.141  0.105
Anova Table (Type II tests)

Response: wynik
                Sum Sq  Df F value     Pr(>F)
chronotyp        17.91   1 0.64890 0.42210087
pora             24.14   2 0.43737 0.64675747
chronotyp:pora  503.85   2 9.12923 0.00020388 ***
Residuals      3311.48 120
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 chronotyp pora  emmean     SE  df lower.CL upper.CL
 poranny   8:00  43.682 1.1200 120   41.464   45.899
 wieczorny 8:00  37.158 1.2052 120   34.772   39.544
 poranny   12:00 39.600 1.1746 120   37.274   41.926
 wieczorny 12:00 41.739 1.0954 120   39.570   43.908
 poranny   18:00 39.000 1.0723 120   36.877   41.123
 wieczorny 18:00 40.944 1.2382 120   38.493   43.396

Confidence level used: 0.95
NOTE: Results may be misleading due to involvement in interactions
 pora  emmean      SE  df lower.CL upper.CL
 8:00  40.420 0.82261 120   38.791   42.049
 12:00 40.670 0.80306 120   39.080   42.260
 18:00 39.972 0.81898 120   38.351   41.594

Results are averaged over the levels of: chronotyp
Confidence level used: 0.95
chronotyp = poranny:
 model term df1 df2 F.ratio p.value       SS      eta2p
 pora         2 120   5.237  0.0066 289.0369 0.08027653

chronotyp = wieczorny:
 model term df1 df2 F.ratio p.value       SS      eta2p
 pora         2 120   4.329  0.0153 238.9232 0.06729469

pora = 8:00:
 model term df1 df2 F.ratio p.value       SS      eta2p
 chronotyp    1 120  15.724  0.0001 433.9140 0.11585276

pora = 12:00:
 model term df1 df2 F.ratio p.value       SS      eta2p
 chronotyp    1 120   1.774  0.1854  48.9547 0.01456797

pora = 18:00:
 model term df1 df2 F.ratio p.value       SS      eta2p
 chronotyp    1 120   1.409  0.2375  38.8823 0.01160540

chronotyp = poranny:
 contrast      estimate     SE  df lower.CL upper.CL t.ratio p.value
 8:00 - 12:00   4.08182 1.6230 120  0.14117  8.02247   2.515  0.0397
 8:00 - 18:00   4.68182 1.5505 120  0.91711  8.44653   3.019  0.0093
 12:00 - 18:00  0.60000 1.5905 120 -3.26167  4.46167   0.377  1.0000

chronotyp = wieczorny:
 contrast      estimate     SE  df lower.CL upper.CL t.ratio p.value
 8:00 - 12:00  -4.58124 1.6286 120 -8.53539 -0.62708  -2.813  0.0172
 8:00 - 18:00  -3.78655 1.7279 120 -7.98180  0.40870  -2.191  0.0910
 12:00 - 18:00  0.79469 1.6531 120 -3.21917  4.80854   0.481  1.0000

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 3 estimates
P value adjustment: bonferroni method for 3 tests
pora = 8:00:
 contrast            estimate     SE  df lower.CL upper.CL t.ratio p.value
 poranny - wieczorny   6.5239 1.6452 120   3.2665   9.7813   3.965  0.0001

pora = 12:00:
 contrast            estimate     SE  df lower.CL upper.CL t.ratio p.value
 poranny - wieczorny  -2.1391 1.6061 120  -5.3191   1.0409  -1.332  0.1854

pora = 18:00:
 contrast            estimate     SE  df lower.CL upper.CL t.ratio p.value
 poranny - wieczorny  -1.9444 1.6380 120  -5.1875   1.2986  -1.187  0.2375

Confidence level used: 0.95
     I     J   roznica     SE       p      lo     hi
  8:00 12:00 -0.085649 1.1467 0.99693 -2.8068 2.6355
  8:00 18:00  0.825203 1.1533 0.75481 -1.9118 3.5622
 12:00 18:00  0.910853 1.1396 0.70421 -1.7937 3.6154
MS_Error df_Error
  27.596  120.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakiecie ggplot2. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Dwie osobne ANOVA jednoczynnikowe zamiast jednego modelu. Tak nie przetestujesz interakcji (Kim, 2014).
- Opis efektów głównych przy istotnej interakcji bez efektów prostych. Brak efektu głównego nie oznacza braku wpływu czynnika.
- Post hoc „dla interakcji”. Okno Post Hoc nie porównuje komórek. Do tego służy EM Means z Compare simple main effects.
- η² cząstkowe opisane jako η² albo sumowane między efektami.
- „Sig. = .000” przepisane dosłownie. Pisz p < .001.
Gdy dochodzi zmienna ilościowa do kontroli, zobacz ANCOVA w SPSS. Przy silnie nienormalnych resztach rozważ aligned rank transform (zob. też normalność reszt czy zmiennych). Liczebność do wykrycia interakcji oszacujesz w kalkulatorze mocy, a analizę dobierzesz w kreatorze doboru testu.
Najczęstsze pytania
Gdzie w SPSS jest dwuczynnikowa ANOVA?
W menu Analyze → General Linear Model → Univariate. Zmienną zależną przenosisz do pola Dependent Variable, a oba czynniki do Fixed Factor(s). Procedura wkleja składnię UNIANOVA i należy do wersji Statistics Base (IBM Corp., b.d.-g). W polskiej dokumentacji ścieżka brzmi Analizuj → Ogólny model liniowy → Jednoczynnikowy.
Czy w SPSS zostawić typ III sum kwadratów przy nierównych grupach?
Typ III jest domyślny i według dokumentacji IBM najczęściej stosowany w modelach bez pustych komórek (IBM Corp., b.d.-c). Interakcja ma w typie II i III tę samą sumę kwadratów, różnią się efekty główne. Langsrud (2003) oraz Smith i Cribbie (2014) zalecają typ II, gdy interakcji nie ma. Typ wybierz przed analizą i podaj go w metodzie.
Jak zrobić efekty proste w dwuczynnikowej ANOVA w SPSS?
W oknie EM Means przenieś interakcję, np. chronotyp*pora, zaznacz Compare simple main effects i korektę Bonferroni. Drugi kierunek dopisz w składni: /EMMEANS=TABLES(chronotyp*pora) COMPARE(chronotyp) ADJ(BONFERRONI). SPSS poda test zbiorczy efektu prostego i porównania par z przedziałami ufności (IBM Corp., b.d.-a).
Dlaczego okno Post Hoc w SPSS nie porównuje komórek interakcji?
Testy post hoc działają tylko dla czynników i liczą porównania na średnich nieskorygowanych o drugi czynnik (IBM Corp., b.d.-e). Do porównań w obrębie interakcji służy EM Means z Compare simple main effects. Wersje dla nierównych wariancji, np. Games-Howell, SPSS pomija, gdy w modelu jest kilka czynników.
Który test Levene’a z SPSS podać w dwuczynnikowej ANOVA?
W modelu pełnym bez kowariant SPSS podaje test Levene’a od średniej, od mediany, od mediany z poprawionymi df i od średniej obciętej (IBM Corp., b.d.-i). Wersja od mediany jest odporniejsza na nienormalność (Brown i Forsythe, 1974). Podaj jedną wersję i nazwij ją; wstępny test wariancji nie powinien sam decydować o analizie (Zimmerman, 2004).
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikInterakcja w ANOVA – jak ją opisać
Co zrobić po istotnej interakcji: wykres, efekty proste na średnich brzegowych, interakcja porządkująca i krzyżowa oraz gotowy wzór opisu APA.
Czytaj →Masz wydruk GLM Univariate i nie wiesz, jak opisać interakcję?
Sprawdzimy model, typ sum kwadratów, efekty proste i opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- IBM Corp. (b.d.-a). EMMEANS Subcommand (UNIANOVA command). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova_emmeans.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). GLM Estimated Marginal Means. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glm_emmeans.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). GLM Model. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glmu_mod.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). GLM Options. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_glmu_opt.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). GLM Post Hoc Comparisons. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glmu_post.html ● Otwarty dostęp
- IBM Corp. (b.d.-f). GLM Profile Plots. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glmu_plot.html ● Otwarty dostęp
- IBM Corp. (b.d.-g). GLM Univariate Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_glmu.html ● Otwarty dostęp
- IBM Corp. (b.d.-h). PLOT Subcommand (UNIANOVA command). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova_plot.html ● Otwarty dostęp
- IBM Corp. (b.d.-i). PRINT Subcommand (UNIANOVA command). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova_print.html ● Otwarty dostęp
- IBM Corp. (b.d.-j). UNIANOVA. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova.html ● Otwarty dostęp
- IBM Corp. (b.d.-k). Using GLM Univariate to Perform a Two-Factor Analysis of Variance. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/glmu_gr1mo_intro.html ● Otwarty dostęp
- Kim, H.-Y. (2014). Statistical notes for clinical researchers: Two-way analysis of variance (ANOVA)-exploring possible interaction between factors. Restorative Dentistry & Endodontics, 39(2), 143–147. https://doi.org/10.5395/rde.2014.39.2.143 ● Otwarty dostęp
- Langsrud, Ø. (2003). ANOVA for unbalanced data: Use Type II instead of Type III sums of squares. Statistics and Computing, 13(2), 163–167. https://doi.org/10.1023/A:1023260610025
- Lee, S., & Lee, D. K. (2018). What is the proper way to apply the multiple comparison test? Korean Journal of Anesthesiology, 71(5), 353–360. https://doi.org/10.4097/kja.d.18.00242 ● Otwarty dostęp
- Richardson, J. T. E. (2011). Eta squared and partial eta squared as measures of effect size in educational research. Educational Research Review, 6(2), 135–147. https://doi.org/10.1016/j.edurev.2010.12.001
- Rosnow, R. L., & Rosenthal, R. (1989). Definition and interpretation of interaction effects. Psychological Bulletin, 105(1), 143–146. https://doi.org/10.1037/0033-2909.105.1.143
- Smith, C. E., & Cribbie, R. (2014). Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares. Journal of Data Science, 12(3), 385–404. https://doi.org/10.6339/JDS.201407_12(3).0001 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{brown1974robust, author={Brown, Morton B. and Forsythe, Alan B.}, title={{Robust tests for the equality of variances}}, journal={Journal of the American Statistical Association}, year={1974}, volume={69}, number={346}, pages={364--367}, doi={10.1080/01621459.1974.10482955}}@misc{ibmnd31unianovaemmeans, author={{IBM Corp.}}, title={{EMMEANS Subcommand (UNIANOVA command)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova_emmeans.html}}@misc{ibmnd31glmemmeans, author={{IBM Corp.}}, title={{GLM Estimated Marginal Means}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glm_emmeans.html}}@misc{ibmnd31glmmodel, author={{IBM Corp.}}, title={{GLM Model}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glmu_mod.html}}@misc{ibmnd31glmoptions, author={{IBM Corp.}}, title={{GLM Options}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_glmu_opt.html}}@misc{ibmnd31glmposthoc, author={{IBM Corp.}}, title={{GLM Post Hoc Comparisons}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glmu_post.html}}@misc{ibmnd31glmprofileplots, author={{IBM Corp.}}, title={{GLM Profile Plots}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-f}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/common/idh_glmu_plot.html}}@misc{ibmnd31glmunivariate, author={{IBM Corp.}}, title={{GLM Univariate Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-g}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_glmu.html}}@misc{ibmnd31unianovaplot, author={{IBM Corp.}}, title={{PLOT Subcommand (UNIANOVA command)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-h}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova_plot.html}}@misc{ibmnd31unianovaprint, author={{IBM Corp.}}, title={{PRINT Subcommand (UNIANOVA command)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-i}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova_print.html}}@misc{ibmnd31unianova, author={{IBM Corp.}}, title={{UNIANOVA}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-j}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_unianova.html}}@misc{ibmnd31glmudwaczynniki, author={{IBM Corp.}}, title={{Using GLM Univariate to Perform a Two-Factor Analysis of Variance}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-k}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/glmu_gr1mo_intro.html}}@article{kim2014twoway, author={Kim, Hae-Young}, title={{Statistical notes for clinical researchers: Two-way analysis of variance (ANOVA)-exploring possible interaction between factors}}, journal={Restorative Dentistry \& Endodontics}, year={2014}, volume={39}, number={2}, pages={143--147}, doi={10.5395/rde.2014.39.2.143}}@article{langsrud2003anova, author={Langsrud, Øyvind}, title={{ANOVA for unbalanced data: Use Type II instead of Type III sums of squares}}, journal={Statistics and Computing}, year={2003}, volume={13}, number={2}, pages={163--167}, doi={10.1023/a:1023260610025}}@article{lee2018what, author={Lee, Sangseok and Lee, Dong Kyu}, title={{What is the proper way to apply the multiple comparison test?}}, journal={Korean Journal of Anesthesiology}, year={2018}, volume={71}, number={5}, pages={353--360}, doi={10.4097/kja.d.18.00242}}@article{richardson2011eta, author={Richardson, John T. E.}, title={{Eta squared and partial eta squared as measures of effect size in educational research}}, journal={Educational Research Review}, year={2011}, volume={6}, number={2}, pages={135--147}, doi={10.1016/j.edurev.2010.12.001}}@article{rosnow1989definition, author={Rosnow, Ralph L. and Rosenthal, Robert}, title={{Definition and interpretation of interaction effects}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={143--146}, doi={10.1037/0033-2909.105.1.143}}@article{smith2014factorial, author={Smith, Carrie E. and Cribbie, Robert}, title={{Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares}}, journal={Journal of Data Science}, year={2014}, volume={12}, number={3}, pages={385--404}, doi={10.6339/jds.201407_12(3).0001}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}