Najpierw pytanie, potem test
Istotna ANOVA mówi tylko, że nie wszystkie średnie są równe. Które grupy się różnią, sprawdzają testy post hoc. Każdy z nich kontroluje łączny błąd I rodzaju w całej rodzinie porównań (FWER). Procedury różnią się jednak tym, jaką rodzinę porównań obejmują i co zakładają o wariancjach. Dlatego wybór zaczynasz od dwóch pytań:
- Co chcesz porównać? Wszystkie pary grup, każdą grupę tylko z grupą kontrolną, czy kombinacje grup (np. „obie formy z fantomem razem” wobec pozostałych)?
- Czy wariancje i liczebności grup są podobne? Jeśli nie, potrzebujesz procedury, która nie korzysta ze wspólnej wariancji błędu.
Im mniejsza rodzina porównań, tym mniejsza korekta i większa moc. Jeśli hipotezy wskazują konkretne porównania, nie są to już testy post hoc, tylko kontrasty planowane (zob. kontrasty planowane i analiza trendu). Midway i in. (2020) po przeglądzie literatury i symulacji dziewięciu procedur zalecają właśnie porównania planowane zamiast nieplanowanych. Do porównań parami polecają test HSD Tukeya albo poprawki Bonferroniego i Šidáka, a do dowolnych kombinacji liniowych średnich – test Scheffégo. Opis każdej procedury znajdziesz w haśle testy post hoc. Ten wpis dotyczy decyzji: co wybrać i dlaczego.
Sytuacja → test: tabela wyboru
| Twoja sytuacja | Test | Dlaczego |
|---|---|---|
| Wszystkie pary, wariancje i liczebności zbliżone | HSD Tukeya (przy nierównych n – Tukeya–Kramera) | Dokładna kontrola FWER dla wszystkich par przy wspólnej wariancji (Tukey, 1949; Kramer, 1956) |
| Wszystkie pary, wariancje albo liczebności wyraźnie różne lub nie masz pewności | Games–Howell | Każda para ma własny błąd standardowy i stopnie swobody Welcha (Games i Howell, 1976) |
| Każda grupa tylko z grupą kontrolną | Dunnett | Rodzina to k − 1 porównań, więc próg istotności jest niższy niż w teście Tukeya (Dunnett, 1955) |
| Kilka wybranych par lub porównań, także przy nierównych wariancjach | Testy t Welcha z korektą Holma | Holm kontroluje FWER i ma nie mniejszą moc niż Bonferroni (Holm, 1979) |
| Kombinacje grup wymyślone po obejrzeniu danych | Scheffé | Chroni wszystkie możliwe kontrasty, ale dla samych par jest bardzo zachowawczy (Scheffé, 1953) |
| Po teście Kruskala–Wallisa | Dunn z korektą Holma | Porównuje średnie rangi ze wspólnego rangowania wszystkich grup (Dunn, 1964) |
| ANOVA dwuczynnikowa, mieszana, ANCOVA | Porównania na średnich brzegowych (emmeans) z korektą Tukeya, Holma lub Dunnetta | Porównujesz średnie z modelu, a nie surowe średnie grup |
Kilka uwag do tabeli. Nie wybieraj testu na podstawie wyniku testu Levene’a, tylko na podstawie planu i wiedzy o danych. Sauder i DeMars (2019) porównali w symulacji 18 procedur dostępnych w SPSS. Błąd I rodzaju przy naruszonych założeniach kontrolowały tylko cztery procedury zaprojektowane na taki przypadek, a spośród nich test Gamesa–Howella miał nieco najwyższą moc. Lee i Lee (2018) przy nierównych wariancjach również wskazują test Gamesa–Howella oraz T2 Tamhane’a i T3 lub C Dunnetta. Test ogólny dobierz w ten sam sposób: przy nierównych wariancjach licz ANOVA Welcha.
Przykład: cztery formy szkolenia z resuscytacji
Dziewięćdziesiąt dwie osoby studiujące pielęgniarstwo przydzielono do czterech form szkolenia: wykładu (grupa kontrolna), filmu instruktażowego, ćwiczeń na fantomie i ćwiczeń na fantomie z debriefingiem. Po szkoleniu zdały praktyczny test umiejętności (0–100 punktów). Dane są symulowane i dostępne w pliku CSV.
Średnie wyniosły: wykład M = 61.12 (SD = 11.23, n = 24), film 66.91 (10.69, n = 22), fantom 73.48 (9.64, n = 25), fantom z debriefingiem 73.10 (8.57, n = 21). Największa wariancja była 1.72 raza większa od najmniejszej. ANOVA Welcha była istotna: F(3, 48.52) = 7.33, p < .001.
Pytanie główne: czy nowe formy są lepsze od wykładu?
Hipoteza dotyczyła trzech porównań z wykładem, więc właściwy jest test Dunnetta. Ćwiczenia na fantomie dały wynik wyższy o 12.36 punktu, 95% CI [5.43, 19.28], p < .001. Fantom z debriefingiem dał wynik wyższy o 11.97 punktu, 95% CI [4.73, 19.21], p < .001. Różnica dla filmu (5.78 punktu) była nieistotna: 95% CI [−1.37, 12.94], p = .14.
Pytanie eksploracyjne: wszystkie pary
Jeśli chcesz też porównać formy szkolenia między sobą, rodzina rośnie do sześciu par. Tabela pokazuje, jak zmienia się wynik w zależności od procedury.
| Porównanie | Różnica | 95% CI (Tukey) | p Tukey | p Games–Howell | p Holm (t Welcha) | p Dunnett |
|---|---|---|---|---|---|---|
| Film − wykład | 5.78 | [−2.04, 13.60] | .220 | .292 | .161 | .14 |
| Fantom − wykład | 12.36 | [4.78, 19.93] | < .001 | < .001 | < .001 | < .001 |
| Fantom z debriefingiem − wykład | 11.97 | [4.05, 19.89] | .001 | .001 | .001 | < .001 |
| Fantom − film | 6.57 | [−1.17, 14.32] | .125 | .140 | .133 | – |
| Fantom z debriefingiem − film | 6.19 | [−1.90, 14.27] | .194 | .171 | .133 | – |
| Fantom z debriefingiem − fantom | −0.38 | [−8.23, 7.46] | .999 | .999 | .887 | – |
Wnioski są tu zgodne, bo wariancje są dość podobne. Widać jednak cenę większej rodziny. Przedział Tukeya dla różnicy film − wykład, [−2.04, 13.60], jest szerszy niż przedział Dunnetta, [−1.37, 12.94]. Wartość p rośnie z .14 do .220. Gdyby rozstrzygnięcie zależało od jednej pary, wybór procedury po fakcie zmieniałby wynik. Dlatego procedurę zapisuje się w planie analiz. Dobieranie procedury do wyniku to forma p-hackingu.
Kontrast złożony wymyślony po danych
Po obejrzeniu średnich chcesz sprawdzić, czy obie formy z fantomem razem przewyższają wykład i film. Taki kontrast nie był planowany, więc chroni go test Scheffégo: różnica 9.27 punktu, 95% CI [3.24, 15.30], p < .001. Gdyby kontrast był zapisany przed badaniem, ten sam test bez korekty dałby węższy przedział [5.07, 13.47]. Różnica w szerokości to koszt decyzji podjętej po fakcie.
Co pokazuje symulacja: łączny błąd I rodzaju
Wykonaliśmy 5000 symulacji dla czterech grup w trzech scenariuszach. Na rysunku 1 policzyliśmy, jak często co najmniej jedna para z prawdziwą hipotezą zerową wychodzi istotna. Dobra procedura powinna dawać wartość bliską .05 lub niższą.
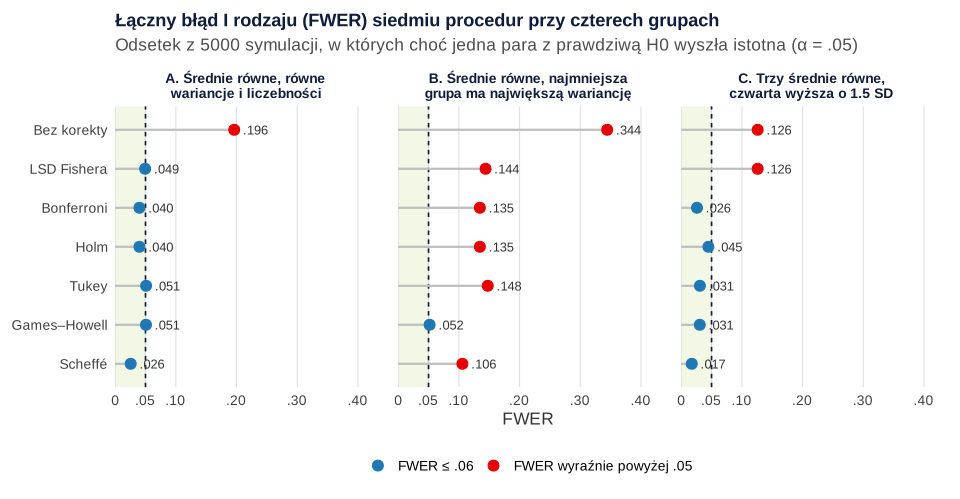
Z rysunku wynikają trzy wnioski:
- Sześć testów t bez korekty to prawie 20% szans na fałszywy alarm (.196), choć każdy test osobno ma α = .05.
- „Najpierw istotne F, potem zwykłe testy t” (procedura LSD Fishera) chroni tylko przy pełnej hipotezie zerowej. W scenariuszu A daje .049. Gdy jedna grupa naprawdę się różni (scenariusz C), test F jest prawie zawsze istotny i dalej działa już jak brak korekty: .126. Istotny test ogólny nie zastępuje więc korekty w porównaniach parami.
- Test Tukeya myli się, gdy najmniejsza grupa ma największą wariancję (scenariusz B): .148. Wspólna wariancja błędu zaniża wtedy błąd standardowy różnic z tą grupą. Bonferroni, Holm i Scheffé też są oparte na wspólnej wariancji i przekraczają .10. Test Gamesa–Howella utrzymał .052.
Scheffé jest najbardziej zachowawczy (.026 i .017 tam, gdzie wariancje są równe). Przy samych parach płacisz za ochronę kontrastów, których nie testujesz.
Moc: mniejsza rodzina, więcej wykrytych różnic
Drugi eksperyment dotyczy mocy. Trzy formy interwencji różnią się od kontroli o d = 0.8, a w każdej grupie jest 20 osób. Rysunek 2 pokazuje, jak często każda procedura wykrywa różnicę z kontrolą.
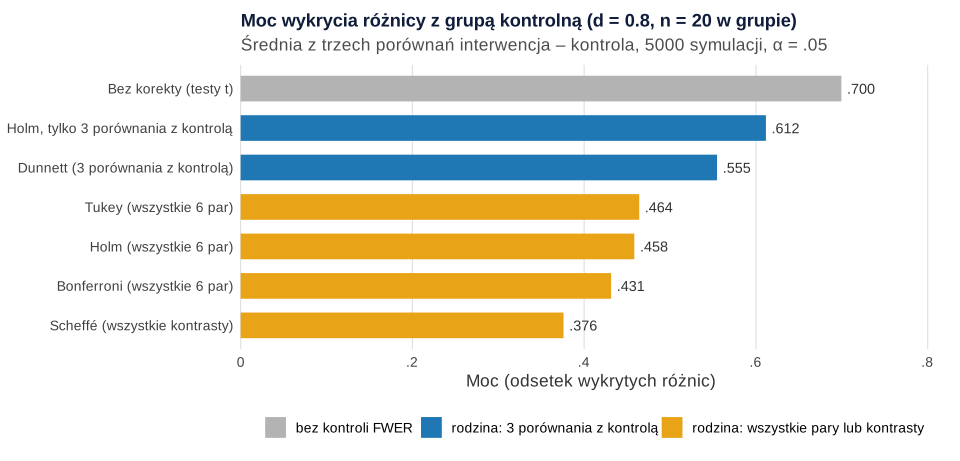
Test Dunnetta wykrył różnicę w 55.5% przypadków, a test Tukeya w 46.4%. Różnica wynika z progu: przy 76 stopniach swobody różnica z kontrolą jest istotna w teście Dunnetta od |t| = 2.40, a w teście Tukeya dopiero od 2.63. Holm ograniczony do tych samych trzech porównań miał tu jeszcze większą moc (.612). To zaleta procedury krokowej, gdy wszystkie trzy efekty istnieją naprawdę. Scheffé wykrył różnicę tylko w 37.6% przypadków.
Post hoc w ANOVA dwuczynnikowej i z pomiarami powtarzanymi
W schematach złożonych porównujesz średnie brzegowe (EMM) z modelu, a nie surowe średnie grup. W R robi to pakiet emmeans. Funkcja pairs() stosuje domyślnie korektę Tukeya, a contrast(..., method = "trt.vs.ctrl") porównuje grupy z kontrolą. W przykładzie dała ona te same wyniki co klasyczne testy (np. p = .1425 dla filmu wobec wykładu).
Gdy interakcja jest istotna, porównania parami licz osobno w każdym poziomie drugiego czynnika, czyli jako efekty proste. Pokazuje to wpis interakcja w ANOVA. Dla schematu grupa × czas zajrzyj do wpisu ANOVA mieszana krok po kroku, a dla samych pomiarów powtarzanych – do wpisu ANOVA z powtarzanymi pomiarami. W pomiarach powtarzanych porównania parami licz na średnich z modelu albo jako sparowane testy t z korektą Holma. Każda para ma wtedy własny błąd standardowy, co jest bezpieczniejsze, gdy sferyczność jest wątpliwa.
Po teście Kruskala–Wallisa: test Dunna
Jeśli analizujesz rangi, test ogólny to test Kruskala–Wallisa. W przykładzie: χ²(3) = 18.76, p < .001. Pary sprawdza test Dunna. Nie rób w zamian serii testów Manna–Whitneya, bo każdy z nich rangowałby dane od nowa. Po korekcie Holma istotne były różnice wykład − fantom (z = 3.61, pHolm = .002) i wykład − fantom z debriefingiem (z = 3.46, pHolm = .003). Para film − fantom miała p = .017 bez korekty, ale .070 po korekcie. Medianę, IQR i wielkość efektu dla testów rangowych omawia wpis testy nieparametryczne krok po kroku.
Jak opisać testy post hoc w pracy
Podaj nazwę procedury i powód jej wyboru, różnice z przedziałami ufności oraz skorygowane wartości p. Układ tabeli znajdziesz w haśle tabela ANOVA w APA.
Testy post hoc w R: przykład i symulacja
Pierwszy skrypt odtwarza liczby z przykładu i zapisuje plik CSV do pobrania. Test Dunnetta liczy pakiet multcomp, test Gamesa–Howella i test Dunna – rstatix, test Scheffégo – DescTools, a średnie brzegowe – emmeans. Drugi skrypt to symulacja z rysunków 1 i 2. Procedury liczy ze wzorów, żeby 5000 powtórzeń trwało kilkanaście sekund.
Przykład: cztery formy szkolenia
R
# B185 – testy post hoc po ANOVA: Dunnett, Tukey, Games–Howell, Holm, Scheffé, emmeans i Dunn
# (dane symulowane, set.seed(1851)). 92 osoby studiujące pielęgniarstwo, cztery formy szkolenia z resuscytacji:
# wykład (grupa kontrolna), film instruktażowy, ćwiczenia na fantomie, fantom z debriefingiem.
# Wynik: test praktyczny umiejętności resuscytacji (0–100 punktów).
suppressPackageStartupMessages({ library(rstatix); library(DescTools); library(multcomp); library(emmeans) })
set.seed(1851)
n <- c(24, 22, 25, 21)
grupy <- c("wykład", "film", "fantom", "fantom + debriefing")
srednie <- c(63, 66, 71, 76); sd_pop <- c(11, 10, 10, 9)
dane <- data.frame(grupa = factor(rep(grupy, n), levels = grupy),
                   wynik = round(unlist(Map(function(k, m, s) rnorm(k, m, s), n, srednie, sd_pop))))
dane$wynik <- pmin(pmax(dane$wynik, 0), 100)
write.csv(dane, "../post-hoc-dane-przyklad.csv", row.names = FALSE)

# Krok 1. Statystyki opisowe i test ogólny (F Welcha oraz klasyczne F do porównania)
aggregate(wynik ~ grupa, dane, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
round(max(tapply(dane$wynik, dane$grupa, var)) / min(tapply(dane$wynik, dane$grupa, var)), 2)  # iloraz wariancji
oneway.test(wynik ~ grupa, dane)                       # F Welcha
fit <- aov(wynik ~ grupa, dane)
summary(fit)
round(sigma(fit)^2, 2)                                 # wspólna wariancja błędu (MSE)

# Krok 2. Pytanie główne: każda forma szkolenia a wykład – test Dunnetta (3 porównania)
dun <- glht(fit, linfct = mcp(grupa = "Dunnett"))
s_dun <- summary(dun); ci_dun <- confint(dun)
cbind(round(ci_dun$confint, 3), p = signif(s_dun$test$pvalues, 2))

# Krok 3. Pytanie eksploracyjne: wszystkie 6 par – Tukey (wspólna wariancja) i Games–Howell (osobne wariancje)
tk <- TukeyHSD(fit)$grupa
round(tk, 3)
gh <- games_howell_test(dane, wynik ~ grupa)
as.data.frame(gh[, c("group1", "group2", "estimate", "conf.low", "conf.high", "p.adj")])

# Krok 4. Holm na testach t Welcha (bez wspólnej wariancji) – dla porównania
pairwise.t.test(dane$wynik, dane$grupa, p.adjust.method = "holm", pool.sd = FALSE)

# Krok 5. Kontrast złożony wymyślony po obejrzeniu danych: obie formy z fantomem vs wykład i film – Scheffé
ScheffeTest(fit, contrasts = matrix(c(-0.5, -0.5, 0.5, 0.5), ncol = 1,
                                    dimnames = list(levels(dane$grupa), "fantom_vs_reszta")))
em <- emmeans(fit, ~ grupa)
ct <- contrast(em, list(fantom_vs_reszta = c(-0.5, -0.5, 0.5, 0.5)))
with(summary(ct, infer = TRUE), round(c(roznica = estimate, lo = lower.CL, hi = upper.CL, t = t.ratio), 2))  # bez korekty (kontrast planowany)

# Krok 6. emmeans: te same porównania jedną funkcją (działa też w ANOVA wieloczynnikowej i mieszanej)
pairs(em, adjust = "tukey")
contrast(em, method = "trt.vs.ctrl", ref = 1, adjust = "dunnett")

# Krok 7. Wersja rangowa: test Kruskala–Wallisa i test Dunna z korektą Holma
kruskal.test(wynik ~ grupa, dane)
as.data.frame(dunn_test(dane, wynik ~ grupa, p.adjust.method = "holm")[, c("group1", "group2", "statistic", "p", "p.adj")])
Wynik w R
                grupa wynik.n wynik.M wynik.SD
1              wykład   24.00   61.12    11.23
2                film   22.00   66.91    10.69
3              fantom   25.00   73.48     9.64
4 fantom + debriefing   21.00   73.10     8.57
[1] 1.72

	One-way analysis of means (not assuming equal variances)

data:  wynik and grupa
F = 7.3258, num df = 3.000, denom df = 48.523, p-value = 0.0003802

            Df Sum Sq Mean Sq F value   Pr(>F)
grupa        3   2424   807.9   7.894 0.000101 ***
Residuals   88   9006   102.3
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 102.35
                             Estimate    lwr    upr       p
film - wykład                   5.784 -1.368 12.936 0.14000
fantom - wykład                12.355  5.430 19.280 0.00014
fantom + debriefing - wykład   11.970  4.730 19.211 0.00041
                             diff    lwr    upr p adj
film-wykład                 5.784 -2.036 13.604 0.220
fantom-wykład              12.355  4.784 19.926 0.000
fantom + debriefing-wykład 11.970  4.054 19.887 0.001
fantom-film                 6.571 -1.174 14.316 0.125
fantom + debriefing-film    6.186 -1.896 14.269 0.194
fantom + debriefing-fantom -0.385 -8.227  7.457 0.999
  group1              group2   estimate  conf.low conf.high    p.adj
1 wykład                film  5.7840909 -2.850563 14.418745 0.292000
2 wykład              fantom 12.3550000  4.363479 20.346521 0.000878
3 wykład fantom + debriefing 11.9702381  4.056090 19.884386 0.001000
4   film              fantom  6.5709091 -1.412614 14.554432 0.140000
5   film fantom + debriefing  6.1861472 -1.720579 14.092873 0.171000
6 fantom fantom + debriefing -0.3847619 -7.560080  6.790556 0.999000

	Pairwise comparisons using t tests with non-pooled SD

data:  dane$wynik and dane$grupa

                    wykład  film    fantom
film                0.16113 -       -
fantom              0.00094 0.13302 -
fantom + debriefing 0.00109 0.13302 0.88679

P value adjustment method: holm

  Posthoc multiple comparisons of means: Scheffe Test
    95% family-wise confidence level

$grupa
                                           diff  lwr.ci  upr.ci    pval
fantom,fantom + debriefing-wykład,film 9.270574 3.24355 15.2976 0.00056 ***

---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

roznica      lo      hi       t
   9.27    5.07   13.47    4.38
 contrast                       estimate   SE df t.ratio p.value
 wykład - film                    -5.784 2.99 88  -1.937  0.2203
 wykład - fantom                 -12.355 2.89 88  -4.274  0.0003
 wykład - (fantom + debriefing)  -11.970 3.02 88  -3.960  0.0009
 film - fantom                    -6.571 2.96 88  -2.222  0.1253
 film - (fantom + debriefing)     -6.186 3.09 88  -2.004  0.1942
 fantom - (fantom + debriefing)    0.385 2.99 88   0.128  0.9992

P value adjustment: tukey method for comparing a family of 4 estimates
 contrast                       estimate   SE df t.ratio p.value
 film - wykład                      5.78 2.99 88   1.937  0.1425
 fantom - wykład                   12.36 2.89 88   4.274  0.0001
 (fantom + debriefing) - wykład    11.97 3.02 88   3.960  0.0004

P value adjustment: dunnettx method for 3 tests

	Kruskal-Wallis rank sum test

data:  wynik by grupa
Kruskal-Wallis chi-squared = 18.755, df = 3, p-value = 0.0003072

  group1              group2   statistic            p       p.adj
1 wykład                film 1.141035915 0.2538549775 0.507709955
2 wykład              fantom 3.609307794 0.0003070152 0.001842091
3 wykład fantom + debriefing 3.457253555 0.0005457111 0.002728556
4   film              fantom 2.376298302 0.0174873191 0.069949276
5   film fantom + debriefing 2.282225232 0.0224760462 0.069949276
6 fantom fantom + debriefing 0.005427183 0.9956697558 0.995669756
Symulacja: FWER i moc
R
# B185 – symulacja: łączny błąd I rodzaju (FWER) i moc procedur post hoc przy 4 grupach (set.seed(1852), 5000 powtórzeń)
# Procedury liczone ze wzorów, żeby symulacja trwała kilkanaście sekund; wyniki zgadzają się z TukeyHSD() i games_howell_test().
set.seed(1852)
R <- 5000; k <- 4
pary <- combn(k, 2)
procedury <- c("Bez korekty", "LSD Fishera", "Bonferroni", "Holm", "Tukey", "Games–Howell", "Scheffé")

post_hoc <- function(y, g, n) {
  m <- tapply(y, g, mean); v <- tapply(y, g, var); N <- sum(n); df <- N - k
  mse <- sum((n - 1) * v) / df
  F_p <- pf(sum(n * (m - mean(y))^2) / (k - 1) / mse, k - 1, df, lower.tail = FALSE)
  i <- pary[1, ]; j <- pary[2, ]
  t_w <- (m[i] - m[j]) / sqrt(mse * (1 / n[i] + 1 / n[j]))            # wspólna wariancja
  se_gh <- sqrt(v[i] / n[i] + v[j] / n[j])                               # osobne wariancje (Welch)
  df_gh <- se_gh^4 / ((v[i] / n[i])^2 / (n[i] - 1) + (v[j] / n[j])^2 / (n[j] - 1))
  p_t <- 2 * pt(abs(t_w), df, lower.tail = FALSE)
  list(p = cbind("Bez korekty" = p_t,
                 "LSD Fishera" = if (F_p < .05) p_t else rep(1, ncol(pary)),
                 "Bonferroni" = p.adjust(p_t, "bonferroni"),
                 "Holm" = p.adjust(p_t, "holm"),
                 "Tukey" = ptukey(abs(t_w) * sqrt(2), k, df, lower.tail = FALSE),
                 "Games–Howell" = ptukey(abs((m[i] - m[j]) / se_gh) * sqrt(2), k, df_gh, lower.tail = FALSE),
                 "Scheffé" = pf(t_w^2 / (k - 1), k - 1, df, lower.tail = FALSE)),
       t = t_w, df = df)
}

# FWER: odsetek powtórzeń z co najmniej jednym fałszywym alarmem wśród par, w których H0 jest prawdziwa
fwer <- function(mu, sdv, n) {
  prawdziwe_h0 <- mu[pary[1, ]] == mu[pary[2, ]]
  g <- factor(rep(1:k, n))
  wyn <- replicate(R, {
    y <- rnorm(sum(n), rep(mu, n), rep(sdv, n))
    colSums(post_hoc(y, g, n)$p[prawdziwe_h0, , drop = FALSE] < .05) > 0
  })
  rowMeans(wyn)
}
scen <- list(
  "A: równe średnie, równe wariancje, n = 20" = list(mu = c(0, 0, 0, 0), sdv = c(1, 1, 1, 1), n = c(20, 20, 20, 20)),
  "B: równe średnie, najmniejsza grupa ma największą wariancję" = list(mu = c(0, 0, 0, 0), sdv = c(2, 1.5, 1, 1), n = c(10, 15, 25, 30)),
  "C: trzy równe średnie, czwarta wyższa o 1.5 SD" = list(mu = c(0, 0, 0, 1.5), sdv = c(1, 1, 1, 1), n = c(20, 20, 20, 20)))
tab_fwer <- t(sapply(scen, function(s) fwer(s$mu, s$sdv, s$n)))
colnames(tab_fwer) <- procedury
round(tab_fwer, 3)

# Moc: kontrola (średnia 0) i trzy formy interwencji (d = 0.8), n = 20 w grupie.
# Średnia moc dla trzech porównań z kontrolą; Dunnett i Holm (3) testują tylko te trzy porównania.
n <- rep(20, k); g <- factor(rep(1:k, n)); df <- sum(n) - k
kor <- matrix(0.5, 3, 3); diag(kor) <- 1                      # korelacja statystyk Dunnetta przy równych n
kryt_dunnett <- mvtnorm::qmvt(0.95, tail = "both.tails", df = df, corr = kor)$quantile
round(c(kryt_dunnett = kryt_dunnett, kryt_tukey = qtukey(0.95, k, df) / sqrt(2), kryt_t = qt(0.975, df)), 3)
z_kontrola <- which(pary[1, ] == 1)
moc <- replicate(R, {
  y <- rnorm(sum(n), rep(c(0, 0.8, 0.8, 0.8), n), 1)
  ph <- post_hoc(y, g, n)
  p6 <- ph$p[z_kontrola, ]
  c(p6[, c("Bez korekty", "Bonferroni", "Holm", "Tukey", "Scheffé")] < .05,
    "Holm (3 porównania)" = p.adjust(ph$p[z_kontrola, "Bez korekty"], "holm") < .05,
    "Dunnett" = abs(ph$t[z_kontrola]) > kryt_dunnett)
})
nazwy <- c(rep(c("Bez korekty", "Bonferroni (6)", "Holm (6)", "Tukey", "Scheffé"), each = 3), rep("Holm (3)", 3), rep("Dunnett", 3))
round(tapply(rowMeans(moc), nazwy, mean)[c("Bez korekty", "Dunnett", "Holm (3)", "Holm (6)", "Tukey", "Bonferroni (6)", "Scheffé")], 3)
Wynik w R
                                                            Bez korekty LSD Fishera Bonferroni
A: równe średnie, równe wariancje, n = 20                         0.196       0.049      0.040
B: równe średnie, najmniejsza grupa ma największą wariancję       0.344       0.144      0.135
C: trzy równe średnie, czwarta wyższa o 1.5 SD                    0.126       0.126      0.026
                                                             Holm Tukey Games–Howell Scheffé
A: równe średnie, równe wariancje, n = 20                   0.040 0.051        0.051   0.026
B: równe średnie, najmniejsza grupa ma największą wariancję 0.135 0.148        0.052   0.106
C: trzy równe średnie, czwarta wyższa o 1.5 SD              0.045 0.031        0.031   0.017
kryt_dunnett   kryt_tukey       kryt_t
       2.398        2.627        1.992
   Bez korekty        Dunnett       Holm (3)       Holm (6)          Tukey Bonferroni (6)
         0.700          0.555          0.612          0.458          0.464          0.431
       Scheffé
         0.376
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- multcomp (wersja 1.4-30): Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346–363. https://doi.org/10.1002/bimj.200810425
- rstatix (wersja 0.7.3): Kassambara, A. (2025). rstatix: Pipe-friendly framework for basic statistical tests [R package]. https://doi.org/10.32614/CRAN.package.rstatix
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- mvtnorm (wersja 1.3-6): Genz, A., & Bretz, F. (2009). Computation of multivariate normal and t probabilities. Springer. ISBN 978-3-642-01688-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy wyborze testu post hoc
- Seria testów t bez korekty, „bo ANOVA wyszła istotna”. Symulacja pokazuje, że przy częściowej hipotezie zerowej FWER rośnie do .126.
- Tukey przy wyraźnie różnych wariancjach i liczebnościach. Wybierz test Gamesa–Howella, tak jak test Welcha zamiast klasycznego testu t.
- Wszystkie pary, gdy hipoteza dotyczyła grupy kontrolnej. Tracisz moc. Test Dunnetta odpowiada na to samo pytanie mniejszym kosztem.
- Zmiana procedury po zobaczeniu wyników, aż któraś da p < .05.
- Same gwiazdki zamiast różnic z przedziałami ufności. Nieistotna para z szerokim przedziałem nie dowodzi braku różnicy.
- Poprawka na wszystko naraz. Korekta dotyczy rodziny porównań odpowiadającej jednemu pytaniu badawczemu. Kiedy jej potrzebujesz, wyjaśnia wpis czy muszę stosować poprawkę na wielokrotne porównania, a przegląd metod – poprawki na wielokrotne porównania.
Cały tok jednoczynnikowej analizy, od założeń po wielkość efektu, pokazuje ANOVA krok po kroku, a dobór testu do hipotezy – przewodnik po testach statystycznych. Jeśli chcesz, żeby ktoś sprawdził wybór procedury i opis wyników w Twojej pracy, możesz skorzystać z konsultacji w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy procedura LSD Fishera wystarczy po istotnej ANOVA?
Chroni tylko wtedy, gdy wszystkie średnie są naprawdę równe. W symulacji z czterema grupami, z których jedna się różniła, istotny test F przepuszczał zwykłe testy t prawie zawsze, a łączny błąd I rodzaju dla par bez różnicy wyniósł .126 zamiast .05. Wybierz raczej test Tukeya, Gamesa–Howella albo korektę Holma.
Co zrobić, gdy ANOVA jest istotna, a żadna para w teście post hoc nie?
To możliwe, bo test F dotyczy wszystkich kontrastów naraz, a nie tylko par grup. Istotna może być np. różnica między średnią dwóch grup a trzecią grupą. Opisz wtedy wynik testu ogólnego i różnice par z przedziałami ufności. Nie zmieniaj procedury na łagodniejszą, żeby uzyskać istotną parę.
Który test post hoc ma największą moc?
Ten, który obejmuje najmniejszą rodzinę porównań zgodną z pytaniem. W symulacji porównań z kontrolą (d = 0.8, n = 20) test Dunnetta wykrył różnicę w 55.5% przypadków, test Tukeya w 46.4%, a test Scheffégo w 37.6%. Największą moc dają kontrasty zaplanowane przed badaniem.
Czy korekta Bonferroniego może zastąpić test Tukeya?
Może, bo kontroluje łączny błąd I rodzaju, ale przy wszystkich parach jest bardziej zachowawcza. Korekta Holma kontroluje ten sam błąd i nigdy nie ma mniejszej mocy niż Bonferroni (Holm, 1979). Bonferroni lub Holm na testach t Welcha sprawdzają się, gdy porównujesz tylko kilka wybranych par.
Jaki test post hoc wybrać w ANOVA dwuczynnikowej?
Porównuj średnie brzegowe z modelu, np. funkcją pairs() z pakietu emmeans z korektą Tukeya, Holma lub Dunnetta. Gdy interakcja jest istotna, porównania parami licz osobno w każdym poziomie drugiego czynnika, czyli jako efekty proste.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikKontrasty planowane i analiza trendu
Od hipotez do wag kontrastów: trend liniowy i kwadratowy, kontrast interakcyjny, korekty, moc i tabela APA – na danych do pobrania, z kodem R.
Czytaj →Nie wiesz, który test post hoc pasuje do Twoich hipotez?
Sprawdzimy plan porównań, dobór procedury i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001469
- Lee, S., & Lee, D. K. (2018). What is the proper way to apply the multiple comparison test? Korean Journal of Anesthesiology, 71(5), 353–360. https://doi.org/10.4097/kja.d.18.00242 ● Otwarty dostęp
- Midway, S., Robertson, M., Flinn, S., & Kaller, M. (2020). Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test. PeerJ, 8, Article e10387. https://doi.org/10.7717/peerj.10387 ● Otwarty dostęp
- Sauder, D. C., & DeMars, C. E. (2019). An updated recommendation for multiple comparisons. Advances in Methods and Practices in Psychological Science, 2(1), 26–44. https://doi.org/10.1177/2515245918808784 ● Otwarty dostęp
- Scheffé, H. (1953). A method for judging all contrasts in the analysis of variance. Biometrika, 40(1–2), 87–110. https://doi.org/10.1093/biomet/40.1-2.87
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
Cytowania BibTeX
@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{dunnett1955multiple, author={Dunnett, Charles W.}, title={{A multiple comparison procedure for comparing several treatments with a control}}, journal={Journal of the American Statistical Association}, year={1955}, volume={50}, number={272}, pages={1096--1121}, doi={10.1080/01621459.1955.10501294}}@article{games1976pairwise, author={Games, Paul A. and Howell, John F.}, title={{Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={2}, pages={113--125}, doi={10.3102/10769986001002113}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{kramer1956extension, author={Kramer, Clyde Young}, title={{Extension of multiple range tests to group means with unequal numbers of replications}}, journal={Biometrics}, year={1956}, volume={12}, number={3}, pages={307--310}, doi={10.2307/3001469}}@article{lee2018what, author={Lee, Sangseok and Lee, Dong Kyu}, title={{What is the proper way to apply the multiple comparison test?}}, journal={Korean Journal of Anesthesiology}, year={2018}, volume={71}, number={5}, pages={353--360}, doi={10.4097/kja.d.18.00242}}@article{midway2020comparing, author={Midway, Stephen and Robertson, Matthew and Flinn, Shane and Kaller, Michael}, title={{Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test}}, journal={PeerJ}, year={2020}, volume={8}, eid={e10387}, doi={10.7717/peerj.10387}}@article{sauder2019updated, author={Sauder, Derek C. and DeMars, Christine E.}, title={{An updated recommendation for multiple comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={26--44}, doi={10.1177/2515245918808784}}@article{scheffe1953method, author={Scheff{\'e}, Henry}, title={{A method for judging all contrasts in the analysis of variance}}, journal={Biometrika}, year={1953}, volume={40}, number={1–2}, pages={87--110}, doi={10.1093/biomet/40.1-2.87}}@article{tukey1949comparing, author={Tukey, John W.}, title={{Comparing individual means in the analysis of variance}}, journal={Biometrics}, year={1949}, volume={5}, number={2}, pages={99--114}, doi={10.2307/3001913}}