Kiedy potrzebujesz ANOVA mieszanej
ANOVA mieszana (ang. mixed ANOVA, split-plot ANOVA) łączy dwa rodzaje czynników. Czynnik międzyobiektowy dzieli osoby na grupy, np. interwencja i kontrola. Czynnik wewnątrzobiektowy to kolejne pomiary tych samych osób, np. przed, po i w obserwacji odroczonej. To najczęstszy schemat w pracach magisterskich z interwencją: kilka grup, ten sam kwestionariusz kilka razy.
Gdy grupa jest tylko jedna, wystarczy ANOVA z powtarzanymi pomiarami. Gdy każdą osobę mierzysz raz, wystarczy zwykła ANOVA międzygrupowa. Ten wpis dotyczy sytuacji pośredniej i pokazuje całą analizę na jednym przykładzie.
| Efekt | Pytanie | Czy to test skuteczności? |
|---|---|---|
| Grupa | Czy grupy różnią się średnio, po uśrednieniu wszystkich pomiarów? | Nie – miesza pomiar wyjściowy z pomiarami po treningu |
| Czas | Czy wyniki zmieniają się w czasie, po uśrednieniu grup? | Nie – spadek może wystąpić także w grupie kontrolnej |
| Grupa × czas | Czy zmiana w czasie przebiega inaczej w różnych grupach? | Tak – to główny test hipotezy |
W badaniu interwencyjnym hipoteza dotyczy więc interakcji. Efekty główne raportujesz, ale nie na nich opierasz wnioski.
Przykład: trening VR, relaksacja i grupa kontrolna
W badaniu symulowanym 90 osób studiujących z lękiem przed wystąpieniami publicznymi przydzielono losowo do trzech grup: treningu ekspozycji w wirtualnej rzeczywistości (VR, n = 28), treningu relaksacji (n = 31) i grupy kontrolnej (n = 31). Lęk mierzono skalą 10–50 przed treningiem, po 6 tygodniach i po 3 miesiącach. Dane w formacie szerokim są w pliku CSV.
| Grupa | Przed M (SD) | Po 6 tygodniach M (SD) | Po 3 miesiącach M (SD) |
|---|---|---|---|
| Kontrola (n = 31) | 33.71 (5.87) | 31.58 (5.65) | 32.00 (6.06) |
| Relaksacja (n = 31) | 34.32 (5.77) | 30.94 (5.07) | 32.35 (5.05) |
| Ekspozycja VR (n = 28) | 33.18 (6.82) | 26.14 (6.16) | 27.79 (6.23) |
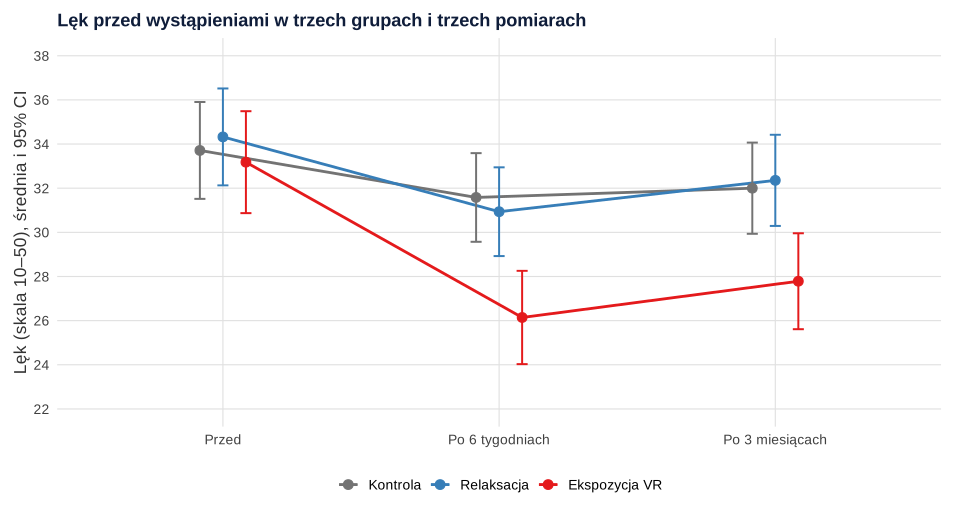
Na starcie grupy są podobne, co przy randomizacji jest oczekiwane. Po treningu linia grupy VR wyraźnie odchodzi od pozostałych. Taki wykres interakcji zrób przed testami. Pokazuje, czego szukać w efektach prostych.
Krok 1. Ułóż dane w formacie długim
Większość funkcji w R wymaga formatu długiego: jeden wiersz to jedna osoba w jednym pomiarze. 90 osób × 3 pomiary daje 270 wierszy z kolumnami id, grupa, czas i lek. Sprawdź tabelą krzyżową, czy każda osoba ma komplet trzech pomiarów. ANOVA mieszana usuwa całą osobę, jeśli brakuje jej choćby jednego pomiaru. Przy brakach przejdź do modelu mieszanego (niżej).
Krok 2. Sprawdź założenia
ANOVA mieszana ma założenia obu swoich części. Wyniki dla przykładu zebraliśmy w tabeli.
| Założenie | Jak sprawdzić | Wynik w przykładzie |
|---|---|---|
| Niezależność osób | Wynika ze schematu badania | Spełnione (losowy przydział, osoby badane indywidualnie) |
| Normalność reszt | Wykres Q-Q, test Shapiro–Wilka na resztach | W = .996, p = .645 |
| Równe wariancje grup w każdym pomiarze | Test Levene’a osobno dla każdego pomiaru | p = .503, .554 i .271 |
| Równe macierze kowariancji w grupach | Test M Boxa | χ²(12) = 14.29, p = .283 |
| Sferyczność | Test Mauchly’ego i współczynniki ε | W = .852, p = .001; εGG = .871, εHF = .887 |
Normalność dotyczy reszt, a nie surowych wyników (zob. normalność reszt czy zmiennych). Test M Boxa sprawdza, czy wariancje pomiarów i korelacje między nimi są podobne w grupach. Jego statystyka opiera się na przybliżeniu rozkładu ilorazu wiarygodności opisanym przez Boxa (1949). Wynik testu interpretuj razem z liczebnością. Przy dużych grupach test wychwytuje drobne różnice, a przy małych łatwo je przeoczy. Problem jest najpoważniejszy wtedy, gdy różnią się zarówno macierze, jak i liczebności grup. Tutaj grupy są niemal równe, a test jest nieistotny.
Sferyczność oznacza równe wariancje różnic między każdą parą pomiarów. Test Mauchly’ego (1940) wskazał jej naruszenie: lęk przed treningiem i po 3 miesiącach korelował słabiej niż pomiary sąsiednie. Nie zmienia to analizy, tylko stopnie swobody. Poprawka Greenhouse’a–Geissera (Greenhouse i Geisser, 1959) i poprawka Huynha–Feldta (Huynh i Feldt, 1976) mnożą je przez ε. Blanca i in. (2023) w symulacji zalecają domyślnie poprawkę Greenhouse’a–Geissera. Gdy obie poprawki prowadzą do różnych wniosków, a ε mieści się między .60 a .90, wskazują Huynha–Feldta. Takie postępowanie może zastąpić wstępny test Mauchly’ego, który bywa mało czuły. Przy dwóch pomiarach (przed i po) sferyczność jest zawsze spełniona, bo jest tylko jedna różnica.
Krok 3. Odczytaj test interakcji
Model dopasowaliśmy funkcją aov_ez() z pakietu afex z sumami kwadratów typu III. Tabela pokazuje wynik z poprawką Greenhouse’a–Geissera i uogólnionym η² (η²G). Bakeman (2005) zaleca η²G w schematach z powtarzanymi pomiarami. Za Olejnikiem i Alginą (2003) wskazuje, że jest porównywalne między schematami międzyobiektowymi i wewnątrzobiektowymi, czego nie zapewnia cząstkowe eta kwadrat.
| Efekt | df | F | p | η²G |
|---|---|---|---|---|
| Grupa | 2, 87 | 4.46 | .014 | .071 |
| Czas | 1.74, 151.51 | 32.65 | < .001 | .086 |
| Grupa × czas | 3.48, 151.51 | 4.21 | .005 | .024 |
Interakcja jest istotna, więc zmiana lęku zależała od grupy. Z poprawką Huynha–Feldta wynik jest prawie taki sam, F(3.55, 154.35) = 4.21, p = .004. Istotny efekt grupy nie oznacza tu, że grupy różniły się na starcie. To średnia z trzech pomiarów, w tym dwóch po treningu. Na tym etapie wiesz tylko, że profile nie są równoległe. Gdzie leży różnica, pokażą efekty proste. Jak czytać interakcję ogólnie, wyjaśnia wpis interakcja w ANOVA.
Krok 4. Rozłóż interakcję na efekty proste
Efekty proste liczysz w pakiecie emmeans na średnich brzegowych z modelu afex. Dla czynnika wewnątrzobiektowego emmeans korzysta domyślnie z modelu wielowymiarowego. Każdy kontrast ma wtedy własny błąd standardowy, więc nie zależy od sferyczności. Masz do wyboru trzy pytania.
Czy lęk zmieniał się w każdej grupie?
Efekt czasu był wyraźny w grupie VR, F(2, 87) = 28.60, p < .001, i w grupie relaksacji, F(2, 87) = 8.01, p < .001. W grupie kontrolnej był nieistotny, F(2, 87) = 2.88, p = .062. Rysunek 2 pokazuje, o ile spadł lęk względem pomiaru wyjściowego.
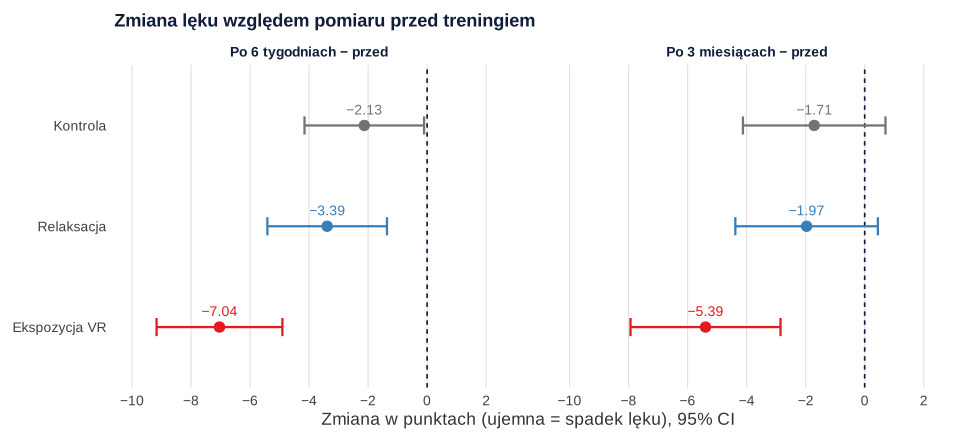
Zwróć uwagę na grupę kontrolną. Także w niej lęk spadł po 6 tygodniach o 2.13 punktu, 95% CI [−4.15, −0.10]. Taki spadek może wynikać z regresji do średniej albo z oswojenia z kwestionariuszem. Dlatego sam spadek w grupie VR nie dowodzi skuteczności treningu. Dowodem jest różnica zmian między grupami.
Czy zmiana była większa niż w grupie kontrolnej?
To kontrast interakcji, czyli „różnica różnic”. Po 6 tygodniach lęk w grupie VR spadł o 4.91 punktu bardziej niż w kontroli, 95% CI [−8.20, −1.62], t(87) = −3.81, p = .001. Po 3 miesiącach różnica zmian wyniosła −3.68 punktu, 95% CI [−7.60, 0.24], t(87) = −2.40, p = .075. Relaksacja nie różniła się od kontroli ani po 6 tygodniach (−1.26 punktu, p = 1.000), ani po 3 miesiącach (−0.26 punktu, p = 1.000). Cztery porównania skorygowano metodą Bonferroniego. Wybór poprawki omawia wpis testy post hoc – który wybrać.
Czy grupy różniły się w danym pomiarze?
Przed treningiem żadna para grup się nie różniła (wszystkie p = 1.000 po korekcie). Po 6 tygodniach grupa VR miała lęk niższy o 5.44 punktu niż kontrola, t(87) = 3.71, p = .001, i o 4.79 punktu niższy niż grupa relaksacji, t(87) = 3.27, p = .005. Po 3 miesiącach różnice wyniosły 4.21 punktu, p = .019, oraz 4.57 punktu, p = .010. W badaniu randomizowanym takie porównania są czytelne, bo grupy startują z podobnego poziomu. Gdy na starcie się różnią, porównuj zmiany, a nie same wyniki końcowe.
Wybierz te efekty proste, które odpowiadają hipotezom, i zapowiedz je w planie analizy. Liczenie wszystkich możliwych porównań mnoży testy i zwiększa ryzyko fałszywego alarmu.
ANOVA mieszana, ANCOVA czy model mieszany?
Ten sam schemat da się przeanalizować inaczej. W badaniu randomizowanym z pomiarem wyjściowym ANCOVA z pomiarem „przed” jako kowariantem ma większą moc niż analiza zmian (Van Breukelen, 2006). W przykładzie ANCOVA lęku po 3 miesiącach dała efekt grupy F(2, 86) = 6.12, p = .003. Grupa VR miała skorygowany wynik niższy niż kontrola o 3.96 punktu, 95% CI [−6.90, −1.01], p = .006 (korekta Dunnetta). Kontrast interakcji dla tego samego pomiaru był nieistotny (p = .075). W grupach nierandomizowanych ANCOVA może być jednak obciążona. Szczegóły i paradoks Lorda opisuje wpis ANCOVA w badaniu przed i po.
| Sytuacja | Wybór |
|---|---|
| Komplet pomiarów, pytanie o przebieg zmian we wszystkich pomiarach | ANOVA mieszana |
| Badanie randomizowane, pytanie o wynik po interwencji przy kontroli pomiaru wyjściowego | ANCOVA |
| Braki pomiarów, nierówne odstępy, czas jako zmienna ciągła | Model mieszany (porównanie z ANOVA, modele wzrostu) |
Wybierz analizę przed zebraniem danych i trzymaj się jej. Przegląd całej ścieżki badań przed i po znajdziesz w przewodniku po badaniach przed i po.
Krok 5. Opisz wynik w stylu APA
Keselman i in. (2001) zwracają uwagę, że sama nazwa „ANOVA z powtarzanymi pomiarami” nie mówi, którą wersję testu policzono. Podaj więc poprawkę, ε i miarę wielkości efektu. Wzór możesz skopiować i podmienić liczby. Tabelę wyników przygotujesz według hasła tabela ANOVA w APA.
W tekście nie powtarzaj wszystkich średnich z tabeli. Wskaż tylko te, które ilustrują interakcję.
ANOVA mieszana w R: afex i emmeans
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Na początku symuluje dane i zapisuje plik CSV do pobrania; ze swoimi danymi zacznij od wczytania pliku (read.csv()) i kroku 1. Potrzebne pakiety: afex, emmeans, car, heplots i MASS.
Od danych do efektów prostych
R
# B183 – ANOVA mieszana 3 (grupa) × 3 (czas): opis, założenia, interakcja, efekty proste, opis APA
# (dane symulowane, set.seed(1183)). 90 osób studiujących z lękiem przed wystąpieniami publicznymi
# losowo przydzielono do treningu ekspozycji w wirtualnej rzeczywistości (VR), treningu relaksacji
# albo grupy kontrolnej. Lęk (skala 10–50) mierzono przed, po 6 tygodniach i po 3 miesiącach.
suppressPackageStartupMessages({ library(afex); library(emmeans); library(car); library(heplots) })
set.seed(1183)
n_gr <- c(VR = 28, relaksacja = 31, kontrola = 31)
mu <- rbind(VR = c(34, 26, 27), relaksacja = c(34, 30, 32), kontrola = c(34, 33, 33))
S <- 6^2 * matrix(c(1, .70, .50,
                    .70, 1, .72,
                    .50, .72, 1), 3)              # korelacje słabną z odstępem w czasie
szerokie <- do.call(rbind, lapply(names(n_gr), function(g) {
  y <- MASS::mvrnorm(n_gr[[g]], mu[g, ], S)
  data.frame(grupa = g, przed = y[, 1], po = y[, 2], po_3_mies = y[, 3])
}))
szerokie[, 2:4] <- round(pmin(pmax(szerokie[, 2:4], 10), 50))
szerokie <- data.frame(id = seq_len(nrow(szerokie)), szerokie)
szerokie$grupa <- factor(szerokie$grupa, levels = c("kontrola", "relaksacja", "VR"))
write.csv(szerokie, "../anova-mieszana-dane-przyklad.csv", row.names = FALSE)

# Krok 1. Format długi: jeden wiersz = jedna osoba w jednym pomiarze
dlugie <- reshape(szerokie, direction = "long", varying = c("przed", "po", "po_3_mies"),
                  v.names = "lek", timevar = "czas", times = c("przed", "po", "po_3_mies"), idvar = "id")
dlugie$czas <- factor(dlugie$czas, levels = c("przed", "po", "po_3_mies"))
table(dlugie$grupa, dlugie$czas)

# Krok 2. Statystyki opisowe w komórkach grupa × czas
aggregate(lek ~ grupa + czas, dlugie, function(v) round(c(M = mean(v), SD = sd(v)), 2))

# Krok 3. Założenia
# a) jednorodność wariancji między grupami w każdym pomiarze (test Levene'a, mediana)
sapply(c("przed", "po", "po_3_mies"), function(v)
  round(unlist(leveneTest(szerokie[[v]] ~ szerokie$grupa)[1, c("F value", "Pr(>F)")]), 3))
# b) test M Boxa: równość macierzy kowariancji pomiarów w trzech grupach
boxM(szerokie[, c("przed", "po", "po_3_mies")], szerokie$grupa)
# c) ANOVA mieszana (afex, sumy kwadratów typu III) + test Mauchly'ego i poprawki epsilon
model <- aov_ez(id = "id", dv = "lek", data = dlugie, between = "grupa", within = "czas", type = 3)
round(summary(model)$sphericity.tests, 3)
round(summary(model)$pval.adjustments[, c("GG eps", "HF eps")], 3)
# d) normalność reszt (Shapiro–Wilk na resztach modelu w trzech pomiarach)
shapiro.test(as.vector(residuals(model$lm)))

# Krok 4. Tabela ANOVA: poprawka Greenhouse'a–Geissera i uogólnione eta kwadrat
nice(model, es = "ges", correction = "GG")
anova(model, es = "ges", correction = "HF")[, c("num Df", "den Df", "F", "Pr(>F)")]

# Krok 5. Efekty proste z emmeans
# a) efekt czasu w każdej grupie (osobny błąd dla każdej grupy – model wielowymiarowy)
joint_tests(model, by = "grupa")
# b) różnice między grupami w każdym pomiarze (Bonferroni w obrębie pomiaru)
em_gc <- emmeans(model, ~ grupa | czas)
pairs(em_gc, adjust = "bonferroni")
# c) kontrasty interakcji: zmiana od pomiaru „przed” w każdej grupie porównana z grupą kontrolną
em <- emmeans(model, ~ czas | grupa)
zmiana <- contrast(em, method = "trt.vs.ctrl", ref = 1)    # po − przed, po_3_mies − przed
summary(zmiana, infer = TRUE, adjust = "bonferroni")
roznica_zmian <- contrast(emmeans(model, ~ czas * grupa),
                          interaction = c(czas = "trt.vs.ctrl", grupa = "trt.vs.ctrl"), adjust = "bonferroni")
summary(roznica_zmian, infer = TRUE)
# d) VR a relaksacja: różnica zmian od „przed” (kolejność komórek: czas zmienia się najszybciej)
summary(contrast(emmeans(model, ~ czas * grupa),
                 list(VR_vs_relaks_po = c(0, 0, 0, 1, -1, 0, -1, 1, 0),
                      VR_vs_relaks_3mies = c(0, 0, 0, 1, 0, -1, -1, 0, 1)), adjust = "bonferroni"), infer = TRUE)

# Krok 6. Dla porównania: ANCOVA wyniku po 3 miesiącach z pomiarem „przed” jako kowariantem
anc <- lm(po_3_mies ~ przed + grupa, data = szerokie)
Anova(anc, type = 3)
summary(emmeans(anc, trt.vs.ctrl ~ grupa)$contrasts, infer = TRUE)
Wynik w R
             przed po po_3_mies
  kontrola      31 31        31
  relaksacja    31 31        31
  VR            28 28        28
       grupa      czas lek.M lek.SD
1   kontrola     przed 33.71   5.87
2 relaksacja     przed 34.32   5.77
3         VR     przed 33.18   6.82
4   kontrola        po 31.58   5.65
5 relaksacja        po 30.94   5.07
6         VR        po 26.14   6.16
7   kontrola po_3_mies 32.00   6.06
8 relaksacja po_3_mies 32.35   5.05
9         VR po_3_mies 27.79   6.23
        przed    po po_3_mies
F value 0.694 0.595     1.327
Pr(>F)  0.503 0.554     0.271

 Box's M-test for Homogeneity of Covariance Matrices

data:  szerokie[, c("przed", "po", "po_3_mies")] by szerokie$grupa
Chi-Sq (approx.) = 14.2912, df = 12, p-value = 0.2825

Contrasts set to contr.sum for the following variables: grupa
           Test statistic p-value
czas                0.852   0.001
grupa:czas          0.852   0.001
           GG eps HF eps
czas        0.871  0.887
grupa:czas  0.871  0.887

	Shapiro-Wilk normality test

data:  as.vector(residuals(model$lm))
W = 0.99561, p-value = 0.6452

Anova Table (Type 3 tests)

Response: lek
      Effect           df   MSE         F  ges p.value
1      grupa        2, 87 77.26    4.46 * .071    .014
2       czas 1.74, 151.51 14.73 32.65 *** .086   <.001
3 grupa:czas 3.48, 151.51 14.73   4.21 ** .024    .005
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
           num Df den Df       F    Pr(>F)
grupa      2.0000  87.00  4.4562  0.014372 *
czas       1.7741 154.35 32.6522 1.363e-11 ***
grupa:czas 3.5482 154.35  4.2073  0.004261 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
grupa = kontrola:
 model term df1 df2 F.ratio p.value
 czas         2  87   2.881  0.0615

grupa = relaksacja:
 model term df1 df2 F.ratio p.value
 czas         2  87   8.005  0.0006

grupa = VR:
 model term df1 df2 F.ratio p.value
 czas         2  87  28.600 <0.0001

czas = przed:
 contrast              estimate   SE df t.ratio p.value
 kontrola - relaksacja   -0.613 1.56 87  -0.393  1.0000
 kontrola - VR            0.531 1.60 87   0.331  1.0000
 relaksacja - VR          1.144 1.60 87   0.714  1.0000

czas = po:
 contrast              estimate   SE df t.ratio p.value
 kontrola - relaksacja    0.645 1.43 87   0.451  1.0000
 kontrola - VR            5.438 1.47 87   3.707  0.0011
 relaksacja - VR          4.793 1.47 87   3.267  0.0047

czas = po_3_mies:
 contrast              estimate   SE df t.ratio p.value
 kontrola - relaksacja   -0.355 1.47 87  -0.241  1.0000
 kontrola - VR            4.214 1.51 87   2.794  0.0192
 relaksacja - VR          4.569 1.51 87   3.029  0.0097

P value adjustment: bonferroni method for 3 tests
grupa = kontrola:
 contrast          estimate    SE df lower.CL upper.CL t.ratio p.value
 po - przed           -2.13 0.888 87    -4.15   -0.103  -2.397  0.0373
 po_3_mies - przed    -1.71 1.060 87    -4.12    0.706  -1.615  0.2200

grupa = relaksacja:
 contrast          estimate    SE df lower.CL upper.CL t.ratio p.value
 po - przed           -3.39 0.888 87    -5.41   -1.361  -3.813  0.0005
 po_3_mies - przed    -1.97 1.060 87    -4.38    0.447  -1.858  0.1330

grupa = VR:
 contrast          estimate    SE df lower.CL upper.CL t.ratio p.value
 po - przed           -7.04 0.935 87    -9.17   -4.904  -7.528 <0.0001
 po_3_mies - przed    -5.39 1.110 87    -7.93   -2.852  -4.840 <0.0001

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 2 estimates
P value adjustment: bonferroni method for 2 tests
 czas_trt.vs.ctrl  grupa_trt.vs.ctrl     estimate   SE df lower.CL upper.CL t.ratio p.value
 po - przed        relaksacja - kontrola   -1.258 1.26 87    -4.46    1.946  -1.002  1.0000
 po_3_mies - przed relaksacja - kontrola   -0.258 1.50 87    -4.08    3.562  -0.172  1.0000
 po - przed        VR - kontrola           -4.907 1.29 87    -8.20   -1.618  -3.806  0.0011
 po_3_mies - przed VR - kontrola           -3.683 1.54 87    -7.60    0.237  -2.396  0.0748

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 4 estimates
P value adjustment: bonferroni method for 4 tests
 contrast           estimate   SE df lower.CL upper.CL t.ratio p.value
 VR_vs_relaks_po       -3.65 1.29 87    -6.59  -0.7078  -2.830  0.0116
 VR_vs_relaks_3mies    -3.43 1.54 87    -6.93   0.0808  -2.228  0.0569

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 2 estimates
P value adjustment: bonferroni method for 2 tests
Anova Table (Type III tests)

Response: po_3_mies
             Sum Sq Df F value    Pr(>F)
(Intercept)  653.91  1 26.2154 1.843e-06 ***
przed        766.66  1 30.7359 3.191e-07 ***
grupa        305.43  2  6.1224  0.003267 **
Residuals   2145.15 86
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 contrast              estimate   SE df lower.CL upper.CL t.ratio p.value
 relaksacja - kontrola   0.0588 1.27 86    -2.81     2.93   0.046  0.9966
 VR - kontrola          -3.9578 1.30 86    -6.90    -1.01  -3.038  0.0062

Confidence level used: 0.95
Conf-level adjustment: dunnettx method for 2 estimates
P value adjustment: dunnettx method for 2 tests
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- heplots (wersja 1.8.1): Friendly, M., Fox, J., & Monette, G. (2025). heplots: Visualizing tests in multivariate linear models [R package]. https://CRAN.R-project.org/package=heplots
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w ANOVA mieszanej
- Wniosek z efektu czasu. „Lęk istotnie spadł” nie świadczy o skuteczności, bo w przykładzie spadł także w grupie kontrolnej.
- Dwa osobne testy t dla zależnych zamiast interakcji. Wynik istotny w jednej grupie i nieistotny w drugiej to jeszcze nie różnica między grupami.
- Interpretacja efektu grupy jak różnicy po treningu. To średnia ze wszystkich pomiarów, także wyjściowego.
- Brak informacji o poprawce. Ułamkowe stopnie swobody bez nazwy poprawki i ε są dla czytelnika zagadką.
- Wszystkie możliwe porównania bez korekty. Zaplanuj kontrasty wynikające z hipotez.
- Usuwanie osób z brakami bez komentarza. Podaj, ile osób odpadło. Przy większych brakach użyj modelu mieszanego.
Jeśli Twoje dane mają inny układ, np. więcej grup albo braki w pomiarach, i chcesz skonsultować wybór analizy, sprawdź analizy statystyczne dla studentów. Wyniki i tak musisz rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Który efekt w ANOVA mieszanej pokazuje skuteczność interwencji?
Interakcja grupa × czas. Pyta, czy zmiana wyniku w czasie różni się między grupami. Sam efekt czasu może wynikać ze spadku także w grupie kontrolnej, a efekt grupy uśrednia pomiar wyjściowy z pomiarami po interwencji.
Co zrobić, gdy test M Boxa jest istotny w ANOVA mieszanej?
Sprawdź, czy grupy mają podobną liczebność. Przy zbliżonych liczebnościach ANOVA mieszana zwykle znosi umiarkowane różnice macierzy kowariancji, a przy dużych próbach test wychwytuje nawet drobne odchylenia. Jeśli grupy są wyraźnie nierówne i macierze się różnią, rozważ model mieszany z osobną strukturą kowariancji w grupach.
Czy przy pomiarze przed i po trzeba sprawdzać sferyczność?
Nie. Przy dwóch pomiarach istnieje tylko jedna różnica, więc założenie sferyczności jest spełnione automatycznie, a test Mauchly’ego nie ma czego testować. Sferyczność sprawdzasz od trzech pomiarów.
Jak rozłożyć interakcję grupa × czas na efekty proste?
Najczęściej porównuje się zmianę od pomiaru wyjściowego między grupami (kontrast interakcji), efekt czasu w każdej grupie albo różnice grup w każdym pomiarze. W R policzysz je w emmeans: joint_tests(model, by = "grupa") i contrast(..., interaction = ...). Wybierz porównania wynikające z hipotez i zastosuj korektę na wielokrotne porównania.
Czym różni się ANOVA mieszana od ANCOVA z pomiarem wyjściowym?
ANOVA mieszana testuje, czy przebieg zmian we wszystkich pomiarach różni się między grupami. ANCOVA porównuje wynik po interwencji przy kontroli pomiaru wyjściowego. W badaniu randomizowanym ANCOVA ma zwykle większą moc (Van Breukelen, 2006), ale przy grupach nierandomizowanych może dawać obciążone wyniki.
Powiązane hasła
Przeczytaj też
ANOVA z powtarzanymi pomiarami krok po kroku
Cztery warunki, te same osoby: sferyczność i poprawka GG, η²G, porównania parami w emmeans, wykres z CI wewnątrzosobowymi, schemat mieszany i opis APA.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →Masz kilka grup i kilka pomiarów, a interakcja nie chce się ułożyć w jasny wniosek?
Sprawdzimy dobór analizy, założenia i efekty proste oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best? Frontiers in Psychology, 14, Article 1192453. https://doi.org/10.3389/fpsyg.2023.1192453 ● Otwarty dostęp
- Box, G. E. P. (1949). A general distribution theory for a class of likelihood criteria. Biometrika, 36(3–4), 317–346. https://doi.org/10.1093/biomet/36.3-4.317
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Keselman, H. J., Algina, J., & Kowalchuk, R. K. (2001). The analysis of repeated measures designs: A review. British Journal of Mathematical and Statistical Psychology, 54(1), 1–20. https://doi.org/10.1348/000711001159357
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731915 ● Otwarty dostęp
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{blanca2023repeated, author={Blanca, María J. and Arnau, Jaume and García-Castro, F. Javier and Alarcón, Rafael and Bono, Roser}, title={{Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best?}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1192453}, doi={10.3389/fpsyg.2023.1192453}}@article{box1949general, author={Box, George E. P.}, title={{A general distribution theory for a class of likelihood criteria}}, journal={Biometrika}, year={1949}, volume={36}, number={3–4}, pages={317--346}, doi={10.1093/biomet/36.3-4.317}}@article{greenhouse1959methods, author={Greenhouse, Samuel W. and Geisser, Seymour}, title={{On methods in the analysis of profile data}}, journal={Psychometrika}, year={1959}, volume={24}, number={2}, pages={95--112}, doi={10.1007/bf02289823}}@article{huynh1976estimation, author={Huynh, Huynh and Feldt, Leonard S.}, title={{Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={1}, pages={69--82}, doi={10.3102/10769986001001069}}@article{keselman2001analysis, author={Keselman, H. J. and Algina, James and Kowalchuk, Rhonda K.}, title={{The analysis of repeated measures designs: A review}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2001}, volume={54}, number={1}, pages={1--20}, doi={10.1348/000711001159357}}@article{mauchly1940significance, author={Mauchly, John W.}, title={{Significance test for sphericity of a normal n-variate distribution}}, journal={The Annals of Mathematical Statistics}, year={1940}, volume={11}, number={2}, pages={204--209}, doi={10.1214/aoms/1177731915}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}