Do czego służy ANCOVA w SPSS
Analiza kowariancji (ANCOVA) porównuje średnie grup po uwzględnieniu zmiennej ilościowej, która wiąże się z wynikiem. W pracach dyplomowych najczęściej jest to badanie przed i po z grupą kontrolną: wynik po interwencji to zmienna zależna, grupa to czynnik, a pomiar wyjściowy to kowarianta. Dlaczego w takim schemacie ANCOVA zwykle wygrywa z analizą zmian i ANOVA mieszaną, wyjaśnia wpis ANCOVA w badaniu przed i po. Kiedy ANCOVA prowadzi na manowce przy grupach nierandomizowanych, opisuje wpis paradoks Lorda. Tutaj zajmujemy się tylko SPSS: oknami, składnią i tym, co przepisać z wydruku.
W SPSS ANCOVA to procedura GLM Univariate z kowariantą. Ścieżki menu, nazwy okien i opcji sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 (IBM, b.d.; IBM Corp., b.d.-a, b.d.-b) i podajemy je po angielsku. Polska dokumentacja podaje ścieżkę Analizuj → Ogólny model liniowy → Jednoczynnikowy, a kowarianty nazywa „współzmiennymi” (IBM Corp., b.d.-a). Etykiety w polskim interfejsie programu mogą brzmieć inaczej. Ogólne zasady czytania wydruku są we wpisie jak czytać wyniki z SPSS. Ten wpis to trzecia część serii o SPSS – wcześniej były m.in. ANOVA jednoczynnikowa w SPSS (część 1) i ANOVA z powtarzanymi pomiarami i mieszana w SPSS (część 2).
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. 80 osób studiujących wylosowano do dwóch wersji ćwiczeń ze statystyki: z cotygodniowymi quizami (n = 40) albo standardowych, czyli grupy kontrolnej (n = 40). Przed kursem i po nim wszyscy rozwiązali test wiedzy (0–40 pkt). Czy grupa z quizami ma po kursie wyższy wynik niż osoby, które zaczynały z tego samego poziomu?
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV. Format SPSS opisuje hasło plik .sav.
Przygotowanie danych
Jeden wiersz to jedna osoba. Pomiar przed (pre) i po (post) to dwie osobne kolumny, a grupa ma kody 1 (quizy) i 2 (kontrolna) z etykietami wartości. Czynnik jest jakościowy, a zmienna zależna i kowarianta – ilościowe, jak wymaga dokumentacja procedury (IBM, b.d.). Etykiety i braki danych ustawisz według wpisu przygotowanie danych w SPSS.
Kowarianta musi być zmierzona przed interwencją. Zmienna zmierzona po interwencji może sama zależeć od przydziału do grupy i wtedy korekta zniekształca efekt (Miller i Chapman, 2001).
Okna procedury krok po kroku
- Analyze → General Linear Model → Univariate (IBM Corp., b.d.-a).
- Okno główne. Jako zmienną zależną wybierz
post,grupaprzenieś do pola Fixed Factor(s), apredo pola Covariate(s) (IBM Corp., b.d.-a). - Model. Domyślny model pełny zawiera efekty główne czynników i kowariant, ale nie ich interakcje (IBM, b.d.). Do sprawdzenia nachyleń wybierz Custom i zbuduj model
grupa,pre,grupa*pre. Typ sum kwadratów zostaw Type III – to ustawienie domyślne. - Options. Zaznacz Descriptive statistics, Estimates of effect size (η² cząstkowe), Parameter estimates i Homogeneity tests (IBM, b.d.).
- EM Means. Przenieś
grupana listę Display Means For, zaznacz Compare main effects i korektę Bonferroni. Te średnie są skorygowane o kowarianty (IBM, b.d.).
Przycisku Post Hoc w ANCOVA nie używaj. Według dokumentacji testy post hoc w GLM porównują średnie nieskorygowane (IBM, b.d.), czyli pomijają kowariantę.
Wyniki pokazujemy w tabelach o układzie tabel wynikowych SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Dokumentacja IBM nie wypisuje nazw kolumn wydruku, więc nagłówki i stopki tabel odtworzyliśmy z typowego wydruku SPSS. Pogrubiono liczby, które trafią do pracy.
Krok 1: jednorodność nachyleń regresji
ANCOVA zakłada, że związek pretestu z posttestem jest w obu grupach taki sam (równoległe linie regresji). Sprawdzasz to modelem z interakcją grupa × kowarianta. W oknie Model wybierasz Custom, a w składni piszesz /DESIGN=grupa pre grupa*pre. Dokumentacja dopuszcza łączenie czynnika z kowariantą tylko gwiazdką (IBM Corp., b.d.-b).
| Source | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared |
|---|---|---|---|---|---|---|
| Corrected Model | 2292.352 | 3 | 764.117 | 44.519 | .000 | .637 |
| Intercept | 101.664 | 1 | 101.664 | 5.923 | .017 | .072 |
| grupa | 2.692 | 1 | 2.692 | .157 | .693 | .002 |
| pre | 2184.584 | 1 | 2184.584 | 127.279 | .000 | .626 |
| grupa * pre | 32.725 | 1 | 32.725 | 1.907 | .171 | .024 |
| Error | 1304.448 | 76 | 17.164 | |||
| Total | 39892.000 | 80 | ||||
| Corrected Total | 3596.800 | 79 |
W tej tabeli patrzysz tylko na wiersz grupa * pre: F(1, 76) = 1.91, p = .171. Nachylenia nie różnią się istotnie (w R: 1.01 w grupie z quizami i 0.79 w kontrolnej). Wiersza grupa w tym modelu nie interpretuj. Przy interakcji w modelu porównuje on grupy dla pretestu równego zero, którego nikt nie uzyskał. Stąd absurdalne p = .693.
Nieistotna interakcja nie dowodzi równości nachyleń – test ma zwykle małą moc. Gdy interakcja jest wyraźna, efekt grupy zależy od poziomu wyjściowego i jedna liczba go nie opisze. Zostaw wtedy interakcję, wycentruj pretest i opisz efekt dla kilku wartości wyjściowych (zob. proste nachylenia). W naszym przykładzie usuwamy interakcję i wracamy do modelu bez niej.
Krok 2: właściwa ANCOVA
Model główny zawiera kowariantę i grupę bez interakcji. W oknie Model wróć do domyślnego ustawienia albo zostaw w Custom tylko grupa i pre.
| grupa | Mean | Std. Deviation | N |
|---|---|---|---|
| quizy | 22.43 | 6.441 | 40 |
| kontrolna | 20.18 | 6.939 | 40 |
| Total | 21.30 | 6.748 | 80 |
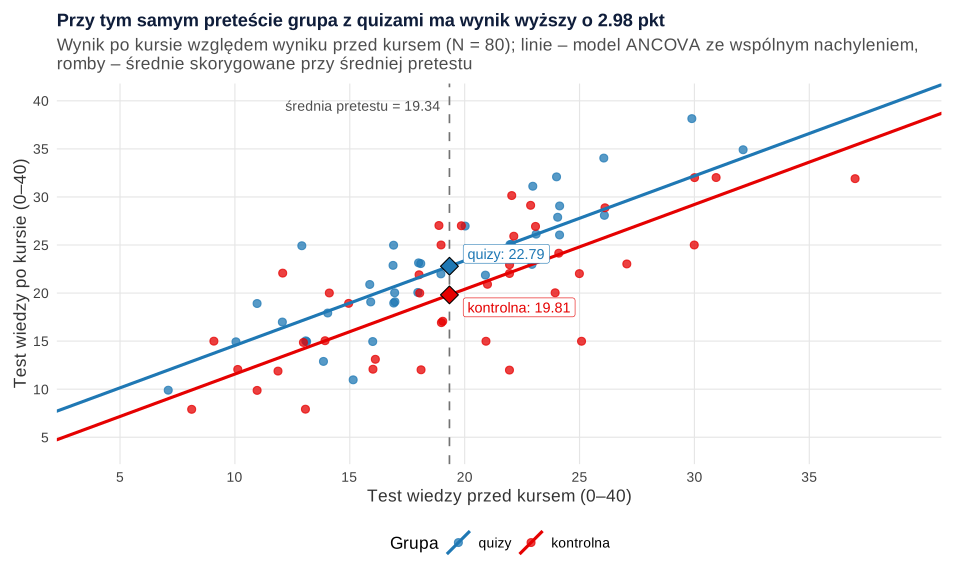
To średnie surowe. Grupa z quizami ma po kursie o 2.25 pkt więcej, ale zaczynała nieco niżej: średni pretest 18.93 (SD = 5.41) wobec 19.75 (SD = 6.47). Korelacja pre–post wynosi r = .76. Średnie pretestu policzysz osobno, np. w Descriptives, bo tabela GLM opisuje tylko zmienną zależną.
Test Levene’a z opcji Homogeneity tests nie wykazał różnic wariancji: F(1, 78) = 0.52, p = .473. Dokumentacja nie opisuje, czy w modelu z kowariantą SPSS liczy go na resztach. Odtworzyliśmy go na resztach modelu ANCOVA. Na surowych wynikach po kursie wniosek jest ten sam (p = .376).
| Source | Type III Sum of Squares | df | Mean Square | F | Sig. | Partial Eta Squared |
|---|---|---|---|---|---|---|
| Corrected Model | 2259.627 | 2 | 1129.814 | 65.059 | .000 | .628 |
| Intercept | 122.261 | 1 | 122.261 | 7.040 | .010 | .084 |
| pre | 2158.377 | 1 | 2158.377 | 124.288 | .000 | .617 |
| grupa | 176.466 | 1 | 176.466 | 10.162 | .002 | .117 |
| Error | 1337.173 | 77 | 17.366 | |||
| Total | 39892.000 | 80 | ||||
| Corrected Total | 3596.800 | 79 |
Pod tabelą typowy wydruk podaje R² = .628 (skorygowane .619). Wiersz grupa to efekt kursu przy wyrównanym preteście: F(1, 77) = 10.16, p = .002, η²p = .12. Wiersz pre pokazuje, że pretest silnie przewiduje posttest. Nie jest to hipoteza, ale warto go podać. Wierszy Intercept, Total i Corrected Model zwykle nie raportujesz. Typ III oznacza, że każdy efekt jest skorygowany o pozostałe (IBM, b.d.), więc kolejność pre i grupa nie zmienia wyników.
| Parameter | B | Std. Error | t | Sig. | 95% Confidence Interval | Partial Eta Squared | |
|---|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | ||||||
| Intercept | 2.755 | 1.696 | 1.624 | .108 | −.622 | 6.131 | .033 |
| pre | .882 | .079 | 11.148 | .000 | .724 | 1.040 | .617 |
| [grupa=1] | 2.978 | .934 | 3.188 | .002 | 1.118 | 4.838 | .117 |
| [grupa=2] | 0a | . | . | . | . | . | . |
Ostatnia kategoria czynnika jest kategorią odniesienia. Jej parametr ma wartość 0 ze stopką „a. This parameter is set to zero because it is redundant” (treść stopki odtworzona z typowego wydruku). Dlatego [grupa=1] = 2.98 to przewaga grupy z quizami nad kontrolną przy tym samym preteście. Współczynnik pre = 0.88 mówi, że każdy punkt więcej na starcie to średnio 0.88 pkt więcej po kursie. Przy dwóch grupach t² = 3.188² = 10.16, czyli to samo F co w wierszu grupa wyżej.
Średnie skorygowane: EMMEANS
Średnie brzegowe (ang. estimated marginal means) to średnie przewidywane przez model, a nie obserwowane. Searle i in. (1980) zaproponowali tę nazwę zamiast „średnich najmniejszych kwadratów”. W ANCOVA SPSS liczy je przy kowariancie ustalonej na jej średniej. W składni zapiszesz to jawnie: /EMMEANS=TABLES(grupa) WITH(pre=MEAN) COMPARE ADJ(BONFERRONI) (IBM Corp., b.d.-b).
| grupa | Mean | Std. Error | 95% Confidence Interval | |
|---|---|---|---|---|
| Lower Bound | Upper Bound | |||
| quizy | 22.789a | .660 | 21.475 | 24.102 |
| kontrolna | 19.811a | .660 | 18.498 | 21.125 |
Stopka „a” informuje, przy jakiej wartości kowarianty liczono średnie, tu pre = 19.34 (treść stopki odtworzona z typowego wydruku). Różnica surowa wynosiła 2.25 pkt, a skorygowana 2.98 pkt. Korekta zwiększyła różnicę, bo grupa z quizami zaczynała niżej.
| (I) grupa | (J) grupa | Mean Difference (I-J) | Std. Error | Sig. | 95% Confidence Interval for Difference | |
|---|---|---|---|---|---|---|
| Lower Bound | Upper Bound | |||||
| quizy | kontrolna | 2.978* | .934 | .002 | 1.118 | 4.838 |
Przy dwóch grupach korekta Bonferroniego niczego nie zmienia, a wynik pokrywa się z [grupa=1]. Przy trzech i więcej grupach ta tabela jest właściwym zamiennikiem testów post hoc. Pokazuje różnice średnich skorygowanych z przedziałami ufności. Rysunek 1 pokazuje, skąd biorą się te liczby.
Wielkość efektu i zysk z kowarianty
Opcja Estimates of effect size daje η² cząstkowe (IBM, b.d.). W ANCOVA to odsetek wariancji wyjaśnionej przez grupę po odjęciu wariancji związanej z pretestem. Richardson (2011) przypomina, że η² cząstkowe i zwykłe łatwo pomylić, więc nazwij miarę dokładnie. Dokumentacja składni zaznacza też, że η² cząstkowe przeszacowuje rzeczywistą wielkość efektu (IBM Corp., b.d.-b). Najczytelniejszą miarą jest skorygowana różnica w punktach testu z 95% przedziałem ufności. Wersję standaryzowaną opisuje wpis ANCOVA w badaniu przed i po.
Ile dała kowarianta? Ta sama ANOVA bez pretestu daje F(1, 78) = 2.26, p = .137, η²p = .03. Pretest wyjaśnił dużą część różnic indywidualnych, więc błąd spadł z 3496 do 1337, a przedział dla efektu się zawęził. Van Breukelen (2006) pokazał, że w badaniach randomizowanych ANCOVA ma większą moc niż analiza zmian. Analizę główną zapisz jednak w planie przed zebraniem danych. Wybór „tej, która wyszła istotna” to błąd, nie zaleta.
Zapis wyników w stylu APA
Podaj sprawdzenie nachyleń, wynik ANCOVA z η² cząstkowym, średnie skorygowane z przedziałami ufności i skorygowaną różnicę. Wzór do dostosowania:
W tabeli wyników pokaż obok siebie średnie surowe przed i po oraz średnie skorygowane (zob. tabela ANOVA w APA). Zdania do innych analiz przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni GLM i opisu podkomend DESIGN, PRINT i EMMEANS w Command Syntax Reference (IBM Corp., b.d.-b), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy wszystkie liczby z tabel: sumy kwadratów typu III, η² cząstkowe, test Levene’a, oszacowania parametrów i średnie skorygowane (pakiety car i emmeans).
1. Składnia SPSS: GLM z kowariantą (WITH), DESIGN i EMMEANS
SPSS
* Składnia zgodna z opisem GLM: Univariate w Command Syntax Reference; nie była uruchamiana w SPSS.
* Krok 1. Jednorodność nachyleń: model z interakcją grupa*pre.
GLM post BY grupa WITH pre
  /METHOD=SSTYPE(3)
  /PRINT=ETASQ
  /DESIGN=grupa pre grupa*pre.

* Krok 2. ANCOVA bez interakcji ze średnimi skorygowanymi przy średniej kowarianty.
GLM post BY grupa WITH pre
  /METHOD=SSTYPE(3)
  /EMMEANS=TABLES(grupa) WITH(pre=MEAN) COMPARE ADJ(BONFERRONI)
  /PRINT=DESCRIPTIVE ETASQ HOMOGENEITY PARAMETER
  /DESIGN=pre grupa.
2. Te same liczby w R i pliki .sav oraz CSV
R
# B308 – ANCOVA w SPSS: liczby do tabel w układzie GLM Univariate
# Dane symulowane, set.seed(3093): test wiedzy ze statystyki (0–40 pkt) przed i po kursie,
# 80 osób losowo przydzielonych do zajęć z quizami (n = 40) albo zajęć standardowych (n = 40).
# Metody jak w GLM Univariate w SPSS: sumy kwadratów typu III, model jednorodności nachyleń
# z interakcją grupa*pre, cząstkowe eta kwadrat, średnie skorygowane (EMMEANS) przy średniej
# kowarianty i porównanie par z korektą Bonferroniego, oszacowania parametrów z ostatnią
# kategorią grupy jako odniesieniem.
suppressPackageStartupMessages({ library(haven); library(car); library(emmeans) })
set.seed(3093)
n <- 40
pre <- round(pmin(40, pmax(0, rnorm(2 * n, 20, 6))))
grupa <- rep(1:2, each = n)                       # 1 = quizy, 2 = kontrolna
post <- round(pmin(40, pmax(0, 5 + 0.75 * pre + 3 * (grupa == 1) + rnorm(2 * n, 0, 3.6))))
dane <- data.frame(id = 1:(2 * n), grupa = grupa, pre = pre, post = post)

# Krok 1. Plik .sav z etykietami zmiennych i wartości – i ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$grupa <- labelled(sav$grupa, labels = c("quizy" = 1, "kontrolna" = 2), label = "Grupa")
sav$pre <- labelled(sav$pre, label = "Test wiedzy przed kursem (0–40)")
sav$post <- labelled(sav$post, label = "Test wiedzy po kursie (0–40)")
write_sav(sav, "../ancova-spss-dane.sav")
write.csv(dane, "../ancova-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

gr <- factor(dane$grupa, levels = 1:2, labels = c("quizy", "kontrolna"))
d <- data.frame(gr = gr, pre = dane$pre, post = dane$post)

# Krok 2. Statystyki opisowe (opcja Descriptive statistics) i średnie pretestu
opis <- rbind(data.frame(grupa = levels(gr), M_post = tapply(d$post, gr, mean), SD_post = tapply(d$post, gr, sd),
                         N = as.vector(table(gr)), M_pre = tapply(d$pre, gr, mean), SD_pre = tapply(d$pre, gr, sd)),
              data.frame(grupa = "Total", M_post = mean(d$post), SD_post = sd(d$post), N = nrow(d),
                         M_pre = mean(d$pre), SD_pre = sd(d$pre)))
print(opis, digits = 4, row.names = FALSE)
cat("korelacja pre–post:", round(cor(d$pre, d$post), 3), "\n")

# Tabela Tests of Between-Subjects Effects z typu III: Corrected Model, Intercept, efekty, Error, Total
tabela_spss <- function(m) {
  a <- Anova(m, type = 3)
  SSE <- a["Residuals", "Sum Sq"]; dfe <- a["Residuals", "Df"]
  SSm <- sum((fitted(m) - mean(d$post))^2); dfm <- length(coef(m)) - 1
  wiersz <- function(nazwa, SS, df) data.frame(Source = nazwa, SS = SS, df = df, MS = SS / df,
    F = (SS / df) / (SSE / dfe), Sig = pf((SS / df) / (SSE / dfe), df, dfe, lower.tail = FALSE), eta2p = SS / (SS + SSE))
  efekty <- setdiff(rownames(a), "Residuals")
  out <- rbind(wiersz("Corrected Model", SSm, dfm),
               do.call(rbind, lapply(efekty, function(e) wiersz(e, a[e, "Sum Sq"], a[e, "Df"]))),
               data.frame(Source = "Error", SS = SSE, df = dfe, MS = SSE / dfe, F = NA, Sig = NA, eta2p = NA),
               data.frame(Source = "Total", SS = sum(d$post^2), df = nrow(d), MS = NA, F = NA, Sig = NA, eta2p = NA),
               data.frame(Source = "Corrected Total", SS = sum((d$post - mean(d$post))^2), df = nrow(d) - 1,
                          MS = NA, F = NA, Sig = NA, eta2p = NA))
  print(out, digits = 6, row.names = FALSE)
  s <- summary(m); cat(sprintf("R Squared = %.3f (Adjusted R Squared = %.3f)\n", s$r.squared, s$adj.r.squared))
  invisible(out)
}

# Krok 3. Jednorodność nachyleń: model grupa, pre, grupa*pre (Model → Custom)
m_int <- lm(post ~ gr + pre + gr:pre, data = d, contrasts = list(gr = "contr.sum"))
t_int <- tabela_spss(m_int)
nach <- sapply(split(d, d$gr), function(z) coef(lm(post ~ pre, data = z))[["pre"]])
round(nach, 3)

# Krok 4. Właściwa ANCOVA: grupa i pre bez interakcji
m <- lm(post ~ gr + pre, data = d, contrasts = list(gr = "contr.sum"))
t_anc <- tabela_spss(m)
# Levene (opcja Homogeneity tests): na wartościach bezwzględnych reszt modelu ANCOVA, od średniej,
# a dla porównania na surowych wynikach po kursie
leveneTest(abs(resid(m)) ~ gr, center = mean)
leveneTest(post ~ gr, center = mean)

# Krok 5. Parameter Estimates: SPSS ustawia ostatnią kategorię czynnika (kontrolna) jako odniesienie
m_par <- lm(post ~ pre + relevel(gr, ref = "kontrolna"), data = d)
pe <- cbind(summary(m_par)$coefficients, confint(m_par))
pe <- cbind(pe, eta2p = pe[, "t value"]^2 / (pe[, "t value"]^2 + df.residual(m_par)))
print(round(pe, 3))

# Krok 6. EMMEANS: średnie skorygowane przy średniej kowarianty (WITH(pre=MEAN)) i porównanie par
cat("średnia pre:", round(mean(d$pre), 4), "\n")
em <- emmeans(m, ~ gr, at = list(pre = mean(d$pre)))
print(summary(em), digits = 5)
print(summary(pairs(em, adjust = "bonferroni"), infer = TRUE), digits = 5)
# Univariate Tests z EMMEANS ... COMPARE: przy dwóch grupach F = t² i to samo p co wiersz grupa
print(test(pairs(em), joint = TRUE))

# Krok 7. Dla porównania: ANOVA tylko na wynikach po kursie (bez kowarianty)
m0 <- lm(post ~ gr, data = d, contrasts = list(gr = "contr.sum"))
a0 <- Anova(m0, type = 3)
print(a0)
cat(sprintf("eta2p grupa bez kowarianty = %.3f; różnica surowa = %.3f\n",
            a0["gr", "Sum Sq"] / (a0["gr", "Sum Sq"] + a0["Residuals", "Sum Sq"]), diff(rev(tapply(d$post, gr, mean)))))
Wynik:
     grupa M_post SD_post  N M_pre SD_pre
     quizy  22.43   6.441 40 18.93  5.413
 kontrolna  20.18   6.939 40 19.75  6.468
     Total  21.30   6.748 80 19.34  5.941
korelacja pre–post: 0.761
          Source          SS df         MS         F         Sig     eta2p
 Corrected Model  2292.35246  3  764.11749  44.51918 1.03111e-16 0.6373311
     (Intercept)   101.66436  1  101.66436   5.92319 1.72915e-02 0.0723018
              gr     2.69179  1    2.69179   0.15683 6.93202e-01 0.0020593
             pre  2184.58417  1 2184.58417 127.27871 6.63640e-18 0.6261291
          gr:pre    32.72546  1   32.72546   1.90666 1.71382e-01 0.0244736
           Error  1304.44754 76   17.16378        NA          NA        NA
           Total 39892.00000 80         NA        NA          NA        NA
 Corrected Total  3596.80000 79         NA        NA          NA        NA
R Squared = 0.637 (Adjusted R Squared = 0.623)
    quizy kontrolna
    1.012     0.791
          Source        SS df        MS         F         Sig     eta2p
 Corrected Model  2259.627  2 1129.8135  65.05937 2.85394e-17 0.6282326
     (Intercept)   122.261  1  122.2607   7.04028 9.67648e-03 0.0837727
              gr   176.466  1  176.4662  10.16166 2.07304e-03 0.1165840
             pre  2158.377  1 2158.3770 124.28835 9.80642e-18 0.6174642
           Error  1337.173 77   17.3659        NA          NA        NA
           Total 39892.000 80        NA        NA          NA        NA
 Corrected Total  3596.800 79        NA        NA          NA        NA
R Squared = 0.628 (Adjusted R Squared = 0.619)
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1  0.5205 0.4728
      78
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1  0.7919 0.3763
      78
                                    Estimate Std. Error t value Pr(>|t|)  2.5 % 97.5 % eta2p
(Intercept)                            2.755      1.696   1.624    0.108 -0.622  6.131 0.033
pre                                    0.882      0.079  11.148    0.000  0.724  1.040 0.617
relevel(gr, ref = "kontrolna")quizy    2.978      0.934   3.188    0.002  1.118  4.838 0.117
średnia pre: 19.3375
 gr        emmean      SE df lower.CL upper.CL
 quizy     22.789 0.65971 77   21.475   24.102
 kontrolna 19.811 0.65971 77   18.498   21.125

Confidence level used: 0.95
 contrast          estimate      SE df lower.CL upper.CL t.ratio p.value
 quizy - kontrolna   2.9777 0.93411 77   1.1176   4.8377   3.188  0.0021

Confidence level used: 0.95
 df1 df2 F.ratio p.value
   1  77  10.162  0.0021

Anova Table (Type III tests)

Response: post
            Sum Sq Df  F value Pr(>F)
(Intercept)  36295  1 809.8942 <2e-16 ***
gr             101  1   2.2593 0.1369
Residuals     3496 78
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
eta2p grupa bez kowarianty = 0.028; różnica surowa = 2.250
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek wykonano w pakiecie ggplot2. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy
- Pretest jako drugi czynnik albo w polu Random Factor(s). Kowarianta trafia do pola Covariate(s).
- Brak sprawdzenia nachyleń albo interpretacja wiersza grupa z modelu z interakcją.
- Interakcja grupa * pre zostawiona w modelu głównym bez opisu efektu dla różnych poziomów pretestu.
- Testy z przycisku Post Hoc zamiast porównań w EM Means. Te pierwsze pomijają kowariantę.
- Średnie surowe w opisie efektu. Wynik ANCOVA dotyczy średnich skorygowanych.
- Kowarianta zmierzona po interwencji albo ANCOVA, która ma „wyrównać” grupy nierandomizowane (Miller i Chapman, 2001; zob. paradoks Lorda).
- „Sig. = .000” przepisane dosłownie. Pisz p < .001.
Gdy pomiarów jest więcej niż dwa, zobacz ANOVA mieszaną w SPSS. Gdy masz dwa czynniki bez kowarianty – ANOVA dwuczynnikową w SPSS. Analizę dobierzesz w kreatorze doboru testu, a o regresji do średniej w badaniach przed i po przeczytasz w słowniku.
Najczęstsze pytania
Jak sprawdzić w SPSS założenie jednorodności nachyleń regresji?
W oknie Model wybierz Custom i zbuduj model z trzema członami: grupa, pre i grupa*pre (w składni /DESIGN=grupa pre grupa*pre). Odczytaj tylko wiersz interakcji w tabeli Tests of Between-Subjects Effects; w przykładzie F(1, 76) = 1.91, p = .171. Domyślny model pełny tej interakcji nie zawiera, bo nie łączy czynników z kowariantami (IBM, b.d.).
Dlaczego średnie z EM Means różnią się od średnich w Descriptive Statistics?
Descriptive Statistics podaje średnie obserwowane, a EM Means – średnie przewidywane przez model przy kowariancie ustalonej na jej średniej, czyli skorygowane (IBM Corp., b.d.-b). Jeśli grupy zaczynały z różnego poziomu, korekta przesuwa średnie: w przykładzie różnica surowa wynosi 2.25 pkt, a skorygowana 2.98 pkt.
Czy w ANCOVA w SPSS można użyć testów post hoc?
Przycisk Post Hoc w GLM porównuje średnie nieskorygowane, więc pomija kowariantę (IBM, b.d.). Porównania średnich skorygowanych uzyskasz w oknie EM Means: przenieś czynnik na listę Display Means For, zaznacz Compare main effects i korektę Bonferroni albo Sidak.
Który wiersz tabeli Tests of Between-Subjects Effects przepisać do pracy?
Wiersz czynnika grupy z modelu bez interakcji: F, df efektu i df błędu (wiersz Error), p i Partial Eta Squared, np. F(1, 77) = 10.16, p = .002, η²p = .12. Warto dodać wiersz kowarianty. Wierszy Intercept, Total i Corrected Model zwykle nie raportujesz.
Co zrobić, gdy interakcja grupy z kowariantą jest istotna?
Wtedy efekt grupy zależy od wyniku wyjściowego i jedna średnia skorygowana go nie opisze. Zostaw interakcję w modelu, wycentruj kowariantę i opisz różnicę grup dla kilku wartości wyjściowych, np. przez /EMMEANS=TABLES(grupa) WITH(pre=…) z różnymi wartościami (IBM Corp., b.d.-b). Pamiętaj, że test interakcji ma zwykle małą moc.
Powiązane hasła
Przeczytaj też
Jak czytać wyniki z SPSS
Osiem najczęstszych tabel SPSS: co odczytać, który wiersz wybrać, co znaczy Sig. = .000 i jak przepisać wynik w stylu APA.
Czytaj →PoradnikANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikParadoks Lorda: ANCOVA czy wynik różnicowy?
Kiedy obie analizy badania przed–po się zgadzają, kiedy myli się każda z nich, regresja do średniej, graf przyczynowy i symulacja w R.
Czytaj →Masz badanie przed i po i nie wiesz, jak opisać ANCOVA z SPSS?
Sprawdzimy model, założenie jednorodności nachyleń, średnie skorygowane i opis wyników oraz wyjaśnimy je tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- IBM Corp. (b.d.-a). GLM Univariate Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_glmu.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). GLM: Univariate (Command Syntax Reference). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_glm_univariate.html ● Otwarty dostęp
- IBM. (b.d.). IBM SPSS Statistics Base 31. Pobrano 1 listopada 2026 z https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Base.pdf ● Otwarty dostęp
- Miller, G. A., & Chapman, J. P. (2001). Misunderstanding analysis of covariance. Journal of Abnormal Psychology, 110(1), 40–48. https://doi.org/10.1037/0021-843X.110.1.40
- Richardson, J. T. E. (2011). Eta squared and partial eta squared as measures of effect size in educational research. Educational Research Review, 6(2), 135–147. https://doi.org/10.1016/j.edurev.2010.12.001
- Searle, S. R., Speed, F. M., & Milliken, G. A. (1980). Population marginal means in the linear model: An alternative to least squares means. The American Statistician, 34(4), 216–221. https://doi.org/10.1080/00031305.1980.10483031
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
Cytowania BibTeX
@misc{ibmndglmunivariate31, author={{IBM Corp.}}, title={{GLM Univariate Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_glmu.html}}@misc{ibmndglmunivariatesyntax31, author={{IBM Corp.}}, title={{GLM: Univariate (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/advanced/syn_glm_univariate.html}}@misc{ibmspssbase31, author={{IBM}}, title={{IBM SPSS Statistics Base 31}}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Base.pdf}}@article{miller2001misunderstanding, author={Miller, Gregory A. and Chapman, Jean P.}, title={{Misunderstanding analysis of covariance}}, journal={Journal of Abnormal Psychology}, year={2001}, volume={110}, number={1}, pages={40--48}, doi={10.1037/0021-843x.110.1.40}}@article{richardson2011eta, author={Richardson, John T. E.}, title={{Eta squared and partial eta squared as measures of effect size in educational research}}, journal={Educational Research Review}, year={2011}, volume={6}, number={2}, pages={135--147}, doi={10.1016/j.edurev.2010.12.001}}@article{searle1980population, author={Searle, S. R. and Speed, F. M. and Milliken, G. A.}, title={{Population marginal means in the linear model: An alternative to least squares means}}, journal={The American Statistician}, year={1980}, volume={34}, number={4}, pages={216--221}, doi={10.1080/00031305.1980.10483031}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}