Dwóch statystyków, jedne dane, dwa wnioski
Lord (1967) opisał sytuację, którą zna każdy, kto analizował badanie przed–po z grupami nierandomizowanymi. W jego przykładzie uczelnia mierzy masę ciała studentów i studentek na początku i na końcu roku akademickiego. Pierwszy statystyk porównuje średnie zmiany i stwierdza, że grupy nie różnią się przyrostem masy. Drugi stosuje ANCOVA z masą wyjściową jako kowariantem i stwierdza, że przy tej samej masie wyjściowej mężczyźni przytyli więcej. Obaj policzyli poprawnie. Lord pokazał, że przy porównywaniu naturalnych, nierównych na starcie grup statystyka sama nie rozstrzyga, który wniosek jest właściwy.
Ten problem nazywa się paradoksem Lorda. Pearl (2016) traktuje go formalnie jako odmianę paradoksu Simpsona i rozwiązuje narzędziami analizy przyczynowej. Wainer (1991) pokazał ten sam spór na danych o tętnie zwierząt w różnym wieku: odjęcie poziomu wyjściowego, podzielenie przez niego i kowariancja dają trzy różne odpowiedzi. Wybór zależy od założeń o tym, co działo się bez interwencji.
We wpisie ANCOVA w badaniu przed i po omawiamy cztery strategie analizy na danych z badania randomizowanego i jeden przykład paradoksu. Tutaj idziemy dalej. Porównujemy trzy sposoby powstania grup i pokazujemy, że w jednym z nich myli się ANCOVA, a w innym wynik różnicowy. Na końcu przekładamy to na graf przyczynowy i na decyzję, którą trzeba uzasadnić w artykule.
Dwie analizy odpowiadają na dwa różne pytania
Obie analizy porównują grupy, ale inaczej definiują, co by się stało bez interwencji.
| Analiza | Model | Pytanie | Założenie: bez interwencji… |
|---|---|---|---|
| Wynik różnicowy | (post − pre) ~ grupa | Czy średnia zmiana różni się między grupami? | …obie grupy zmieniłyby się średnio o tyle samo (wspólny trend) |
| ANCOVA | post ~ pre + grupa | Czy osoby z tym samym wynikiem wyjściowym różnią się wynikiem końcowym? | …osoby z tym samym pretestem miałyby ten sam oczekiwany posttest, niezależnie od grupy |
Różnicę między obiema odpowiedziami da się zapisać jednym wzorem. Jeśli b to nachylenie pretestu w ANCOVA, a Δpre to różnica średnich w preteście (grupa z programem minus grupa bez programu), to:
Analizy zgadzają się więc w dwóch przypadkach: gdy grupy startują z tego samego poziomu (Δpre ≈ 0) albo gdy nachylenie wynosi 1. W badaniu randomizowanym pierwszy warunek spełnia losowanie. W grupach istniejących zwykle nie jest spełniony żaden z nich, bo przy b < 1 część różnicy wyjściowej „rozpływa się” w regresji do średniej. Wtedy obie liczby się rozchodzą i trzeba zdecydować, które założenie jest bardziej wiarygodne. Wzór obowiązuje dokładnie w każdej próbie, co sprawdzamy w kodzie.
Symulacja: trzy badania przed–po
Żeby wiedzieć, która analiza ma rację, potrzebujemy danych, w których znamy prawdziwy efekt. Symulujemy wynik testu z matematyki u 300 uczniów, mierzony we wrześniu i w czerwcu. Każdy uczeń ma stały poziom umiejętności (SD = 10 pkt), a każdy pomiar dodaje do niego błąd (SD = 6 pkt). Rzetelność jednego pomiaru wynosi więc 100 / 136 ≈ .74. Między pomiarami wszyscy zyskują średnio 5 pkt. Grupy powstają na trzy sposoby:
- Scenariusz 1 – randomizacja. Losujemy 150 uczniów do programu zajęć dodatkowych, który podnosi wynik o 4 pkt.
- Scenariusz 2A – istniejące szkoły. Program wdrożono w szkole, której uczniowie mają średnio niższy poziom (50 wobec 60 pkt). Program nie działa.
- Scenariusz 2B – skierowanie według pretestu. Jedna populacja; nauczyciele kierują na zajęcia tym częściej, im słabszy był wynik wrześniowy. Skierowano 148 uczniów. Program nie działa.
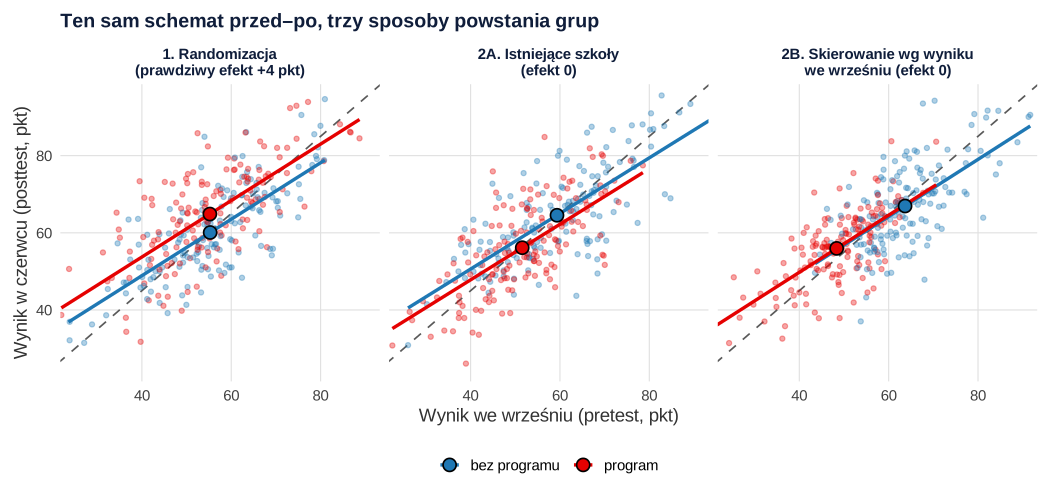
W obu scenariuszach drugiego typu grupa z programem startuje niżej. Badacz, który widzi tylko dane, nie wie, jak powstały grupy. Wyniki jednego badania w każdym scenariuszu (set.seed(2340)) zebraliśmy w tabeli.
| Scenariusz | Prawdziwy efekt | Δpre | b | Wynik różnicowy [95% CI] | ANCOVA [95% CI] |
|---|---|---|---|---|---|
| 1. Randomizacja | 4 | −0.07 | 0.73 | 4.86 [2.79, 6.93], p < .001 | 4.84 [2.91, 6.77], p < .001 |
| 2A. Istniejące szkoły | 0 | −7.78 | 0.72 | −0.63 [−2.68, 1.43], p = .550 | −2.80 [−4.80, −0.80], p = .006 |
| 2B. Skierowanie według pretestu | 0 | −15.31 | 0.74 | 4.33 [2.51, 6.16], p < .001 | 0.35 [−1.94, 2.65], p = .762 |
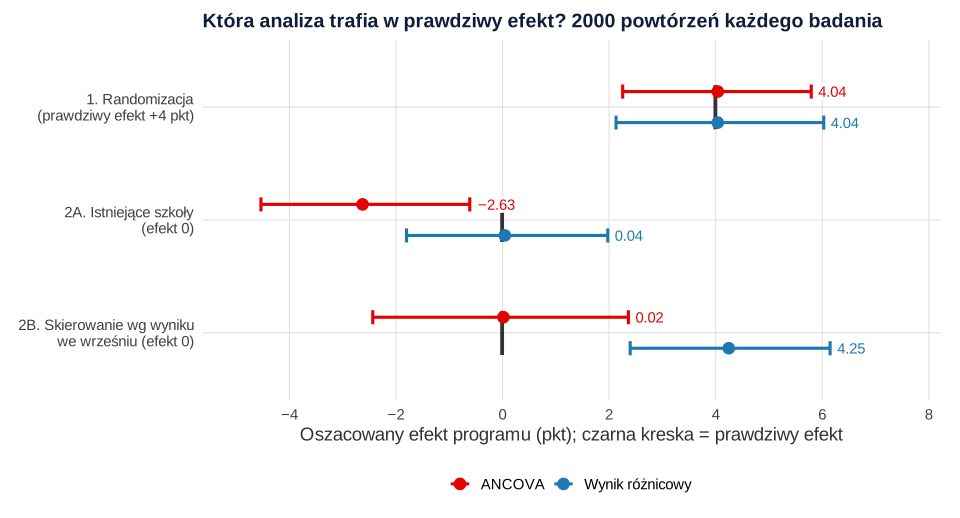
Jedno badanie może wyjść przypadkowo. Dlatego każdy scenariusz powtórzyliśmy 2000 razy (set.seed(2312)). Rysunek 2 pokazuje średnie oszacowanie i zakres, w którym mieści się 95% wyników.
Randomizacja: obie analizy celują w ten sam efekt
W scenariuszu 1 losowanie wyrównało grupy na starcie (Δpre = −0.07), więc oba oszacowania prawie się pokrywają: 4.86 i 4.84 pkt. W 2000 powtórzeń średnia obu analiz wyniosła 4.04 pkt, czyli obie są nieobciążone. ANCOVA była nieco precyzyjniejsza (SD oszacowań 0.92 wobec 0.99 pkt) i wykrywała efekt w 99.3% badań, a wynik różnicowy w 98.6%. To zgadza się z wnioskiem Van Breukelena (2006): w badaniach randomizowanych obie metody są nieobciążone, a ANCOVA ma większą moc. Szczegółowe porównanie mocy przy różnej korelacji pomiarów jest we wpisie o ANCOVA, więc go tu nie powtarzamy.
W pojedynczym RCT obie liczby też mogą się rozejść, ale tylko przypadkowo. Odchylenie standardowe różnicy między nimi wyniosło 0.35 pkt i wynikało wyłącznie z losowej nierównowagi w preteście. Paradoks Lorda w ścisłym sensie nie dotyczy więc badań z randomizacją. Tam wybierasz analizę ze względu na precyzję i zapisujesz ją w planie analizy przed zebraniem danych.
Grupy nierandomizowane: rację ma ta analiza, której założenie jest prawdziwe
Scenariusz 2A: istniejące szkoły. Uczniowie obu szkół różnią się stałym poziomem, a każdy z nich zyskuje te same 5 pkt. Wynik różnicowy daje −0.63 pkt, 95% CI [−2.68, 1.43], i trafnie nie wykrywa efektu. ANCOVA daje −2.80 pkt, 95% CI [−4.80, −0.80], p = .006, czyli „program szkodzi”. W 2000 powtórzeń średnie oszacowanie ANCOVA wyniosło −2.63 pkt, a fałszywie istotny wynik pojawił się w 75.6% badań. Wynik różnicowy miał średnią 0.04 pkt i 4.6% wyników istotnych, zgodnie z poziomem α = .05.
Skąd błąd ANCOVA? Pretest mierzy poziom ucznia z błędem, więc nachylenie wynosi tylko b = 0.72, blisko rzetelności pomiaru. ANCOVA usuwa zatem około 72% różnicy wyjściowej między szkołami, a resztę, (1 − 0.72) × (−7.78) = −2.18 pkt, przypisuje programowi. Mechanizm opisali Glymour i in. (2005): gdy grupa wiąże się z poziomem wyjściowym, a pomiar jest nierzetelny, korekta o pretest tworzy pozorny związek grupy ze zmianą. Eriksson i Häggström (2014) pokazali ten sam artefakt dla ciągłego predyktora poprawy. Błąd pomiaru i rzetelność pretestu są więc w paradoksie Lorda kluczowe.
Scenariusz 2B: skierowanie według pretestu. Tu jest odwrotnie. Wynik różnicowy daje 4.33 pkt, 95% CI [2.51, 6.16], p < .001. To prawie tyle, ile wynosi prawdziwy efekt w scenariuszu 1, choć zajęcia nie działają. ANCOVA daje 0.35 pkt, 95% CI [−1.94, 2.65], p = .762. W 2000 powtórzeń wynik różnicowy był fałszywie istotny w 99.3% badań (średnia 4.25 pkt), a ANCOVA w 4.6% (średnia 0.02 pkt). Uczniów kierowano na zajęcia za słaby wynik wrześniowy, często zaniżony przez przypadkowy błąd. W czerwcu ten błąd losuje się od nowa, więc grupa „poprawia się” sama. ANCOVA porównuje uczniów z tym samym wynikiem wrześniowym i ten artefakt usuwa, bo o przydziale decydował wyłącznie zmierzony pretest. Wright (2006, 2020) pokazał w symulacjach właśnie tę regułę. Gdy pretest wpływa na przydział do grup, lepsza jest ANCOVA, a w przeciwnym razie właściwy może być wynik różnicowy. Zwróć uwagę na cenę: przy silnie rozdzielonych grupach ANCOVA jest mniej precyzyjna (SD oszacowań 1.24 pkt).
Najważniejsza lekcja dotyczy tego, czego dane nie powiedzą. W obu scenariuszach grupa z programem startuje niżej. Zmniejszenie różnicy między grupami w scenariuszu 2B wygląda dokładnie tak, jak wyglądałby prawdziwy efekt zajęć wyrównawczych. Żaden test nie odróżni regresji do średniej od działania programu bez wiedzy o tym, jak uczniowie trafili do grup.
Ujęcie przyczynowe: narysuj, skąd się wzięły grupy
Regułę „ANCOVA albo wynik różnicowy” najłatwiej uzasadnić grafem przyczynowym (DAG). Oznaczmy: G – grupa, U – stały poziom ucznia, pre i post – pomiary.
| Scenariusz | Graf | Ścieżka tylnymi drzwiami | Co robi kontrola pretestu | Nieobciążona analiza |
|---|---|---|---|---|
| 2A. Istniejące szkoły | G ← U → pre; U → post | G ← U → post | pre jest tylko niedokładnym wskaźnikiem U, więc ścieżka zostaje częściowo otwarta | wynik różnicowy, jeśli U podnosi pre i post o tyle samo |
| 2B. Skierowanie według pretestu | U → pre → G; U → post | G ← pre ← U → post | pre leży na ścieżce i nie jest zderzaczem, więc kontrola zamyka ją całkowicie | ANCOVA |
W scenariuszu 2B zbiór {pre} spełnia kryterium tylnych drzwi. W 2A takiego zbioru wśród zmierzonych zmiennych nie ma, bo nie mierzymy U, czyli zmiennej zakłócającej. Wynik różnicowy działa wtedy inaczej niż kontrola. Kim i Steiner (2021) pokazują, że różnicowanie nie blokuje ścieżek przez warunkowanie, tylko je znosi przez odejmowanie. Dlatego jest odporne na błąd pomiaru pretestu i błąd zderzacza. Opiera się jednak na założeniu wspólnego trendu, które trudno uzasadnić, gdy pretest sam wpływa na przydział. To ta sama logika co w metodzie różnicy w różnicach.
Graf wyjaśnia też oryginalny przykład Lorda. Płci nie przydziela się na podstawie masy wyjściowej. Masa wyjściowa jest raczej skutkiem płci, więc leży na ścieżce płeć → masa wyjściowa → masa końcowa. Kontrola takiej zmiennej usuwa część efektu, podobnie jak kontrola mediatora. Wynik różnicowy odpowiada wtedy na pytanie o efekt całkowity płci na przyrost masy. ANCOVA porównuje osoby o tej samej masie wyjściowej, a więc odpowiada na inne pytanie, bliższe efektowi bezpośredniemu. Pearl (2016) wychodzi właśnie od tego przykładu i pyta, kiedy korekta o warunki wyjściowe jest w ogóle uzasadniona. Ogólną zasadę doboru zmiennych kontrolnych omawiamy we wpisie czy kontrolować wiek i płeć.
Jak wybrać analizę w badaniu nierandomizowanym
| Jak powstały grupy | Analiza główna | Uwagi |
|---|---|---|
| Losowanie | ANCOVA | obie analizy nieobciążone, ANCOVA precyzyjniejsza |
| Przydział według zmierzonego pretestu (próg, skierowanie) | ANCOVA z tym samym pomiarem, który decydował o przydziale | przy ostrym progu rozważ regresję nieciągłą (RDD) |
| Naturalne grupy różniące się stabilnym poziomem | wynik różnicowy | uzasadnij wspólny trend; pomogą wcześniejsze pomiary |
| Grupy różnią się wieloma zmierzonymi cechami | model z cechami innymi niż pretest, np. propensity score albo wagi IPW | niezmierzone różnice nadal mogą obciążać wynik |
| Mechanizm nieznany albo mieszany | obie analizy jako analiza wrażliwości | wniosek tylko wtedy, gdy obie wskazują to samo |
Wright (2006) zastrzega, że często żadna z dwóch prostych analiz nie wystarcza. Gdy przydział zależał od innego pomiaru niż pretest użyty w modelu (np. od opinii nauczyciela), ANCOVA nie zamyka ścieżki w całości. Gdy masz kilka pomiarów przed interwencją, sprawdź, czy trendy grup były równoległe, albo użyj modelu wzrostu. Unikaj też dzielenia przez poziom wyjściowy. Zmiana procentowa to trzecia korekta z przykładu Wainera (1991) z własnymi, rzadko spełnionymi założeniami. Ogólnie o planowaniu takich badań piszemy w haśle schemat quasi-eksperymentalny.
Jak opisać wybór analizy
Recenzent zapyta, dlaczego wybrano tę, a nie inną analizę. Odpowiedź musi dotyczyć mechanizmu przydziału, a nie tego, która analiza dała istotny wynik. Wzór dla scenariusza 2A:
Jeśli przygotowujesz artykuł z quasi-eksperymentem i nie wiesz, którą analizę obronić przed recenzentem, możemy wspólnie przejść przez mechanizm przydziału i plan analizy w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji: drugi korzysta z funkcji zdefiniowanych w pierwszym. Wystarczą funkcje podstawowego R.
1. Trzy scenariusze, dwie analizy
R
# Trzy symulowane badania przed–po (wynik testu z matematyki w pkt, pomiar we wrześniu i w czerwcu)
# W każdym: wynik = stały poziom ucznia + błąd pomiaru; między pomiarami wszyscy zyskują średnio 5 pkt
set.seed(2340)
n <- 300
symuluj <- function(scenariusz, n = 300, efekt = 0) {
  if (scenariusz == "1. Randomizacja") {
    poziom <- rnorm(n, 56, 10)
    program <- rep(0:1, each = n / 2)[sample(n)]          # losowy przydział
    pre <- poziom + rnorm(n, 0, 6)
  } else if (scenariusz == "2A. Istniejące grupy") {
    program <- rep(0:1, each = n / 2)                      # program w szkole o niższym poziomie
    poziom <- rnorm(n, ifelse(program == 1, 50, 60), 10)
    pre <- poziom + rnorm(n, 0, 6)
  } else {                                                 # "2B. Przydział według pretestu"
    poziom <- rnorm(n, 56, 10)
    pre <- poziom + rnorm(n, 0, 6)
    program <- rbinom(n, 1, plogis(-(pre - 56) / 4))       # słabszy wynik we wrześniu = częstsze skierowanie
  }
  post <- poziom + 5 + efekt * program + rnorm(n, 0, 6)
  data.frame(program, pre, post)
}
dwie_analizy <- function(d) {
  zmiana <- lm(I(post - pre) ~ program, data = d)         # wynik różnicowy (test t na zmianach)
  ancova <- lm(post ~ pre + program, data = d)           # ANCOVA z pretestem jako kowariantem
  wsp <- function(m) summary(m)$coefficients["program", c(1, 2, 4)]
  c(roznica_pre = mean(d$pre[d$program == 1]) - mean(d$pre[d$program == 0]),
    nachylenie_b = unname(coef(ancova)["pre"]),
    setNames(wsp(zmiana), c("zmiana_est", "zmiana_SE", "zmiana_p")),
    setNames(wsp(ancova), c("ancova_est", "ancova_SE", "ancova_p")))
}
scenariusze <- c("1. Randomizacja", "2A. Istniejące grupy", "2B. Przydział według pretestu")
efekty <- c(4, 0, 0)                                       # prawdziwy efekt programu (pkt)
dane <- Map(symuluj, scenariusze, efekt = efekty)

# Średnie w grupach (0 = bez programu, 1 = program)
for (s in scenariusze) {
  cat("\n", s, "\n")
  srednie <- aggregate(cbind(pre, post) ~ program, data = dane[[s]], FUN = mean)
  print(data.frame(n = as.vector(table(dane[[s]]$program)), round(srednie, 2)), row.names = FALSE)
}

# Wynik różnicowy i ANCOVA na tych samych danych: oszacowanie, 95% CI i p
wyniki <- t(sapply(dane, dwie_analizy))
ci <- function(est, se, df) sprintf("[%.2f, %.2f]", est - qt(.975, df) * se, est + qt(.975, df) * se)
print(data.frame(prawdziwy = efekty, roznica_pre = round(wyniki[, "roznica_pre"], 2), b = round(wyniki[, "nachylenie_b"], 3),
                 zmiana = round(wyniki[, "zmiana_est"], 2), zmiana_CI = ci(wyniki[, "zmiana_est"], wyniki[, "zmiana_SE"], n - 2),
                 zmiana_p = formatC(wyniki[, "zmiana_p"], format = "f", digits = 3),
                 ancova = round(wyniki[, "ancova_est"], 2), ancova_CI = ci(wyniki[, "ancova_est"], wyniki[, "ancova_SE"], n - 3),
                 ancova_p = formatC(wyniki[, "ancova_p"], format = "f", digits = 3)))

# Rozbieżność obu analiz = (1 − b) × różnica w preteście
round(cbind(ancova_minus_zmiana = wyniki[, "ancova_est"] - wyniki[, "zmiana_est"],
            z_wzoru = (1 - wyniki[, "nachylenie_b"]) * wyniki[, "roznica_pre"]), 3)
Wynik w R
 1. Randomizacja
   n program   pre  post
 150       0 55.28 60.07
 150       1 55.22 64.86

 2A. Istniejące grupy
   n program   pre  post
 150       0 59.34 64.54
 150       1 51.56 56.14

 2B. Przydział według pretestu
   n program   pre  post
 152       0 63.68 66.94
 148       1 48.36 55.96
                              prawdziwy roznica_pre     b zmiana     zmiana_CI
1. Randomizacja                       4       -0.07 0.731   4.86  [2.79, 6.93]
2A. Istniejące grupy                  0       -7.78 0.720  -0.63 [-2.68, 1.43]
2B. Przydział według pretestu         0      -15.31 0.740   4.33  [2.51, 6.16]
                              zmiana_p ancova      ancova_CI ancova_p
1. Randomizacja                  0.000   4.84   [2.91, 6.77]    0.000
2A. Istniejące grupy             0.550  -2.80 [-4.80, -0.80]    0.006
2B. Przydział według pretestu    0.000   0.35  [-1.94, 2.65]    0.762
                              ancova_minus_zmiana z_wzoru
1. Randomizacja                            -0.018  -0.018
2A. Istniejące grupy                       -2.176  -2.176
2B. Przydział według pretestu              -3.980  -3.980
2. 2000 powtórzeń każdego scenariusza
R
# 2000 powtórzeń każdego scenariusza (korzysta z funkcji symuluj() i dwie_analizy() z przepisu 1)
set.seed(2312)
R <- 2000
mc <- do.call(rbind, lapply(seq_along(scenariusze), function(i) {
  w <- t(replicate(R, dwie_analizy(symuluj(scenariusze[i], efekt = efekty[i]))))
  data.frame(scenariusz = scenariusze[i], prawdziwy = efekty[i], w)
}))
podsum <- function(x) c(srednia = mean(x$zmiana_est), SD = sd(x$zmiana_est), odsetek_p05 = mean(x$zmiana_p < .05),
                        srednia = mean(x$ancova_est), SD = sd(x$ancova_est), odsetek_p05 = mean(x$ancova_p < .05),
                        roznica_analiz_SD = sd(x$ancova_est - x$zmiana_est))
tab <- t(sapply(split(mc, mc$scenariusz), podsum))
colnames(tab) <- c("zmiana_M", "zmiana_SD", "zmiana_p05", "ancova_M", "ancova_SD", "ancova_p05", "SD_rozbieznosci")
round(cbind(prawdziwy = efekty, tab), 3)
Wynik w R
                              prawdziwy zmiana_M zmiana_SD zmiana_p05 ancova_M
1. Randomizacja                       4    4.039     0.987      0.986    4.040
2A. Istniejące grupy                  0    0.043     0.966      0.046   -2.627
2B. Przydział według pretestu         0    4.246     0.963      0.993    0.015
                              ancova_SD ancova_p05 SD_rozbieznosci
1. Randomizacja                   0.919      0.993           0.354
2A. Istniejące grupy              0.991      0.756           0.534
2B. Przydział według pretestu     1.244      0.046           0.898
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), rnorm(), rbinom(), replicate()); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- ANCOVA jako „wyrównanie” grup istniejących. Kowariant nie zamienia quasi-eksperymentu w eksperyment, jeśli grupy różnią się poziomem, który pretest mierzy z błędem.
- Wynik różnicowy po kwalifikacji za skrajny wynik. Grupa wybrana za słaby pretest poprawi się bez żadnej interwencji.
- Wybór analizy po obejrzeniu wyników. Gdy obie dają różne wnioski, raportowanie tylko istotnej to p-hacking.
- Test różnic wyjściowych jako kryterium wyboru. Liczy się mechanizm przydziału, a nie istotność Δpre.
- Traktowanie interakcji czas × grupa jako trzeciej, niezależnej analizy. Przy dwóch pomiarach to wynik różnicowy (zob. ANOVA mieszana).
- Brak wykresu rozrzutu pre–post dla grup. Rysunek 1 pokazuje więcej niż sama tabela wyników.
Najczęstsze pytania
Na czym polega paradoks Lorda w badaniu przed–po?
To sytuacja, w której porównanie średnich zmian i ANCOVA z pomiarem wyjściowym, policzone na tych samych danych o grupach nierandomizowanych, prowadzą do różnych wniosków o różnicy między grupami. Lord (1967) pokazał, że sama statystyka nie rozstrzyga, który wniosek jest właściwy. Decyduje założenie o tym, co działoby się bez interwencji.
Kiedy ANCOVA i wynik różnicowy dają ten sam wynik?
Gdy grupy mają tę samą średnią w preteście albo gdy nachylenie pretestu w ANCOVA wynosi 1. Rozbieżność równa się (1 − b) × różnica w preteście. W badaniu randomizowanym obie analizy są nieobciążone i różnią się tylko przypadkowo; ANCOVA jest precyzyjniejsza (Van Breukelen, 2006).
Kiedy w quasi-eksperymencie wybrać ANCOVA, a kiedy wynik różnicowy?
ANCOVA wybierz, gdy o przydziale do grup decydował zmierzony pretest, np. skierowanie za słaby wynik. Wynik różnicowy jest właściwy, gdy grupy różnią się stałym poziomem, który bez interwencji wpływałby jednakowo na oba pomiary (Wright, 2020). Gdy mechanizm jest nieznany, pokaż obie analizy jako analizę wrażliwości.
Dlaczego ANCOVA może wykazać efekt w grupach istniejących, gdy go nie ma?
Pretest mierzy prawdziwy poziom z błędem, więc nachylenie jest mniejsze od 1 i ANCOVA usuwa tylko część różnicy wyjściowej. Resztę przypisuje grupie. W symulacji z rzetelnością pretestu około .74 ANCOVA dawała fałszywie istotny wynik w 75.6% badań, a wynik różnicowy w 4.6%.
Czy wynik różnicowy rozwiązuje problem regresji do średniej?
Nie, gdy grupy wybrano na podstawie pretestu. Osoby skierowane za słaby wynik poprawiają się bez interwencji, bo ich błąd pomiaru losuje się od nowa. W symulacji wynik różnicowy wskazał wtedy pozorny efekt 4.25 pkt w 99.3% badań, a ANCOVA trafnie go nie wykazywała.
Powiązane hasła
Przeczytaj też
ANCOVA w badaniu przed i po
ANOVA mieszana, różnice wyników, ANCOVA i model mieszany na jednych danych: moc w RCT, paradoks Lorda, założenia, średnie skorygowane i wzór raportu.
Czytaj →PoradnikGrafy przyczynowe (DAG)
Zakłócacz, mediator i zderzacz, kryterium tylnych drzwi i zbiór dostosowujący – z symulacją w R, która pokazuje koszt złej kontroli.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →Recenzent pyta, dlaczego ANCOVA, a nie analiza zmian?
Pomożemy opisać mechanizm przydziału do grup, wybrać i uzasadnić analizę główną, przygotować analizę wrażliwości i odpowiedź dla recenzenta.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Eriksson, K., & Häggström, O. (2014). Lord's paradox in a continuous setting and a regression artifact in numerical cognition research. PLoS ONE, 9(4), Article e95949. https://doi.org/10.1371/journal.pone.0095949 ● Otwarty dostęp
- Glymour, M. M., Weuve, J., Berkman, L. F., Kawachi, I., & Robins, J. M. (2005). When is baseline adjustment useful in analyses of change? An example with education and cognitive change. American Journal of Epidemiology, 162(3), 267–278. https://doi.org/10.1093/aje/kwi187 ● Otwarty dostęp
- Kim, Y., & Steiner, P. M. (2021). Gain scores revisited: A graphical models perspective. Sociological Methods & Research, 50(3), 1353–1375. https://doi.org/10.1177/0049124119826155
- Lord, F. M. (1967). A paradox in the interpretation of group comparisons. Psychological Bulletin, 68(5), 304–305. https://doi.org/10.1037/h0025105
- Pearl, J. (2016). Lord’s paradox revisited – (Oh Lord! Kumbaya!). Journal of Causal Inference, 4(2), Article 20160021. https://doi.org/10.1515/jci-2016-0021 ● Otwarty dostęp: pełny tekst
- Van Breukelen, G. J. P. (2006). ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies. Journal of Clinical Epidemiology, 59(9), 920–925. https://doi.org/10.1016/j.jclinepi.2006.02.007
- Wainer, H. (1991). Adjusting for differential base rates: Lord's paradox again. Psychological Bulletin, 109(1), 147–151. https://doi.org/10.1037/0033-2909.109.1.147
- Wright, D. B. (2006). Comparing groups in a before–after design: When t test and ANCOVA produce different results. British Journal of Educational Psychology, 76(3), 663–675. https://doi.org/10.1348/000709905x52210
- Wright, D. B. (2020). Allocation to groups: Examples of Lord's paradox. British Journal of Educational Psychology, 90(S1), 35–49. https://doi.org/10.1111/bjep.12300
Cytowania BibTeX
@article{eriksson2014lord, author={Eriksson, Kimmo and H{\"a}ggstr{\"o}m, Olle}, title={{Lord's paradox in a continuous setting and a regression artifact in numerical cognition research}}, journal={PLoS ONE}, year={2014}, volume={9}, number={4}, eid={e95949}, doi={10.1371/journal.pone.0095949}}@article{glymour2005when, author={Glymour, M. Maria and Weuve, Jennifer and Berkman, Lisa F. and Kawachi, Ichiro and Robins, James M.}, title={{When is baseline adjustment useful in analyses of change? An example with education and cognitive change}}, journal={American Journal of Epidemiology}, year={2005}, volume={162}, number={3}, pages={267--278}, doi={10.1093/aje/kwi187}}@article{kim2021gain, author={Kim, Yongnam and Steiner, Peter M.}, title={{Gain scores revisited: A graphical models perspective}}, journal={Sociological Methods \& Research}, year={2021}, volume={50}, number={3}, pages={1353--1375}, doi={10.1177/0049124119826155}}@article{lord1967paradox, author={Lord, Frederic M.}, title={{A paradox in the interpretation of group comparisons}}, journal={Psychological Bulletin}, year={1967}, volume={68}, number={5}, pages={304--305}, doi={10.1037/h0025105}}@article{pearl2016lord, author={Pearl, Judea}, title={{Lord’s paradox revisited – (Oh Lord! Kumbaya!)}}, journal={Journal of Causal Inference}, year={2016}, volume={4}, number={2}, eid={20160021}, doi={10.1515/jci-2016-0021}}@article{vanbreukelen2006ancova, author={Van Breukelen, Gerard J. P.}, title={{ANCOVA versus change from baseline had more power in randomized studies and more bias in nonrandomized studies}}, journal={Journal of Clinical Epidemiology}, year={2006}, volume={59}, number={9}, pages={920--925}, doi={10.1016/j.jclinepi.2006.02.007}}@article{wainer1991adjusting, author={Wainer, Howard}, title={{Adjusting for differential base rates: Lord's paradox again}}, journal={Psychological Bulletin}, year={1991}, volume={109}, number={1}, pages={147--151}, doi={10.1037/0033-2909.109.1.147}}@article{wright2006comparing, author={Wright, Daniel B.}, title={{Comparing groups in a before–after design: When t test and ANCOVA produce different results}}, journal={British Journal of Educational Psychology}, year={2006}, volume={76}, number={3}, pages={663--675}, doi={10.1348/000709905x52210}}@article{wright2020allocation, author={Wright, Daniel B.}, title={{Allocation to groups: Examples of Lord's paradox}}, journal={British Journal of Educational Psychology}, year={2020}, volume={90}, number={S1}, pages={35--49}, doi={10.1111/bjep.12300}}