Kiedy nierówne grupy są problemem, a kiedy nie
Test t, ANOVA i regresja nie wymagają równych liczebności. W ankiecie do pracy dyplomowej grupy prawie nigdy nie są równe: kobiet jest więcej niż mężczyzn, osób bez dzieci więcej niż rodziców, studentów stacjonarnych więcej niż zaocznych. Sama różnica liczebności nie unieważnia wyniku. Kłopot pojawia się dopiero w połączeniu z kilkoma innymi okolicznościami:
| Sytuacja | Problem? | Co zrobić |
|---|---|---|
| Dwie lub więcej grup, podobne wariancje, każda grupa ma kilkadziesiąt osób | Nie | Analizuj normalnie. Tracisz tylko trochę mocy w porównaniu z równym podziałem. |
| Nierówne liczebności i nierówne wariancje | Tak | Test t Welcha zamiast Studenta, ANOVA Welcha zamiast klasycznego testu F, test Gamesa–Howella zamiast Tukeya. |
| Jedna grupa bardzo mała (np. 12 osób) | Tak | Licz się z niską mocą i szerokim przedziałem ufności. Napisz o tym w ograniczeniach. |
| ANOVA z dwoma czynnikami lub więcej | Częściowo | Efekty przestają być niezależne, więc wynik zależy od typu sum kwadratów. Podaj, którego użyto. |
| Grupy różnią się, bo ludzie sami się do nich wybrali albo z jednej częściej rezygnowali | Tak, ale nie statystyczny | Porównywalność grup jest wątpliwa. Opisz to, sprawdź różnice w zmiennych demograficznych. |
Najważniejszy jest drugi wiersz. Przy równych grupach klasyczny test jest dość odporny na różne wariancje, ale przy nierównych już nie. Gdy większy rozrzut ma mniejsza grupa, test Studenta częściej daje fałszywe alarmy, niż obiecuje α. Delacre i in. (2017) zalecają więc test Welcha jako wybór domyślny, bo przy równych wariancjach traci niewiele. Zimmerman (2004) pokazał, że wybieranie testu na podstawie wstępnego testu Levene’a nie chroni poziomu istotności. Przy nierównych liczebnościach najlepiej od razu stosować test dla oddzielnych wariancji. Dla ANOVA Blanca i in. (2018) proponują regułę kciuka: przy nierównych grupach iloraz największej i najmniejszej wariancji powyżej 1.5 to już potencjalne zagrożenie dla testu F. Symulacje tych zjawisk znajdziesz w hasłach test Welcha i homogeniczność wariancji, a pełny przebieg analizy – w poradniku test t Studenta krok po kroku.
Przy porównaniach parami po ANOVA wybierz test Gamesa–Howella. W symulacji Gamesa i Howella (1976) przy nierównych liczebnościach lub wariancjach zadowalająco kontrolował błąd I rodzaju tylko ten wariant, który nie łączy wariancji grup.
W ANOVA czynnikowej nierówne komórki sprawiają, że efekty główne i interakcja dzielą część wariancji. Wtedy wynik zależy od typu sum kwadratów. Większość programów domyślnie liczy typ III. Langsrud (2003) oraz Smith i Cribbie (2014) uważają, że do testowania efektów głównych lepszy jest typ II, gdy interakcji nie ma. Nie musisz rozstrzygać tego sporu. Wystarczy, że napiszesz, który typ zastosowano. Szczegóły są w poradniku ANOVA krok po kroku.
Ile mocy tracisz przy nierównym podziale?
Dla mocy testu liczy się nie suma osób, tylko coś w rodzaju średniej harmonicznej obu grup, czyli „efektywna” liczebność grupy. Przy 60 i 60 osobach wynosi ona 60, przy 90 i 30 osobach już tylko 45, choć łącznie badanych jest wciąż 120. Policzyliśmy w R moc dwustronnego testu t dla efektu d = 0.5 przy α = .05:
- 60 i 60 osób: moc .78;
- 80 i 40 osób: .73;
- 90 i 30 osób: .65;
- 108 i 12 osób: .37.
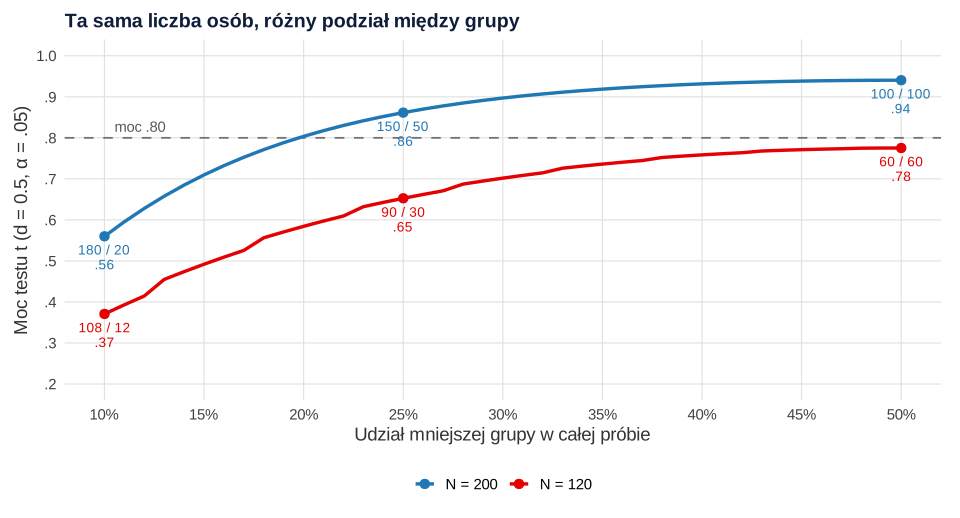
Wniosek praktyczny: podział 60 : 40 albo nawet 2 : 1 to niewielki koszt. Problem zaczyna się wtedy, gdy mniejsza grupa liczy kilkanaście osób. Jeśli planujesz badanie i wiesz, że grupy będą nierówne, uwzględnij to w obliczeniach. Do mocy .80 przy d = 0.5 potrzeba 128 osób przy podziale 1 : 1, 144 przy 2 : 1 (96 i 48) i 172 przy 3 : 1 (129 i 43). Liczebność dla innych założeń sprawdzisz w kalkulatorze liczebności próby.
Nie wyrównuj grup, usuwając osoby
Częsty odruch to losowe usunięcie części osób z większej grupy, „żeby było po równo”. To zły pomysł. Gdy z grup liczących 90 i 30 osób zostawisz 30 i 30, moc spada z .65 do .48. Wyrzucasz dane i nie zyskujesz nic, czego nie dałby test Welcha. Do tego wynik zależy od tego, kogo akurat wylosowałeś. Lepiej przeanalizuj wszystkie osoby metodą, która nie zakłada równych wariancji.
Inna sprawa, gdy nierówność jest objawem. Jeśli w badaniu z randomizacją z jednej grupy zrezygnowała połowa osób, a z drugiej nikt, problemem nie jest liczebność, tylko to, kto został. Opisz odpadanie i sprawdź, czy osoby, które zostały, różnią się od tych, które zrezygnowały. Takie pytania omawia przewodnik testy statystyczne – przewodnik po wyborze.
Jak to opisać w pracy
W metodach podaj liczebność każdej grupy i test, który nie zakłada równych wariancji. W ograniczeniach – co nierówny podział oznacza dla mocy. Wzór dla grup liczących 90 i 30 osób:
Jeśli nie wiesz, czy różnice wariancji w Twoich danych wymagają zmiany testu, albo promotor pyta, dlaczego grupy nie są równe, możesz przejrzeć analizę ze statystykiem w ramach analiz statystycznych dla studentów. Wybór testu musisz jednak rozumieć i umieć uzasadnić sam(a).
Moc przy nierównych grupach w R
Kod liczy moc dwustronnego testu t z niecentralnego rozkładu t dla dowolnego podziału osób, sprawdza wynik funkcją power.t.test() dla grup równych i podaje liczebność potrzebną do mocy .80 przy podziale 1 : 1, 2 : 1 i 3 : 1. Wystarczy pakiet stats. Rysunek 1 powstał z tych samych obliczeń w pakiecie ggplot2.
Moc testu t a podział osób między grupy
R
# B144 – nierówne grupy: ile mocy tracisz przy tej samej łącznej liczbie osób?
# Uruchomienie: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b144-moc.R > b144-moc-wynik.txt
# Moc dwustronnego testu t dla prób niezależnych (α = .05) przy d = 0.5, liczona z niecentralnego rozkładu t.
moc_t <- function(n1, n2, d, alfa = .05) {
  df  <- n1 + n2 - 2
  ncp <- d * sqrt(n1 * n2 / (n1 + n2))
  kr  <- qt(1 - alfa / 2, df)
  pt(kr, df, ncp, lower.tail = FALSE) + pt(-kr, df, ncp)
}
n_efekt <- function(n1, n2) 2 / (1 / n1 + 1 / n2)   # średnia harmoniczna = „efektywna” liczebność grupy

# 1. Ta sama łączna liczba osób (N = 120), różny podział
podzial <- data.frame(n1 = c(60, 70, 80, 90, 100, 108), n2 = c(60, 50, 40, 30, 20, 12))
podzial$proporcja <- with(podzial, paste0(round(n1 / n2, 1), " : 1"))
podzial$n_efektywne <- round(with(podzial, n_efekt(n1, n2)), 1)
podzial$moc <- round(with(podzial, moc_t(n1, n2, d = 0.5)), 3)
podzial

# 2. Sprawdzenie wzoru funkcją z pakietu stats (tylko dla grup równych)
round(power.t.test(n = 60, delta = 0.5, sd = 1)$power, 3)

# 3. Czy „wyrównać” grupy, losowo usuwając osoby z większej? 90 i 30 → 30 i 30
round(c(grupy_90_30 = moc_t(90, 30, 0.5), grupy_30_30 = moc_t(30, 30, 0.5)), 3)

# 4. Ile osób potrzeba do mocy .80 (d = 0.5) przy podziale 1 : 1, 2 : 1 i 3 : 1?
potrzeba <- function(k, d = 0.5, cel = .80) {        # k = n1 / n2
  for (n2 in 5:500) if (moc_t(ceiling(k * n2), n2, d) >= cel) return(c(n1 = ceiling(k * n2), n2 = n2, N = ceiling(k * n2) + n2))
}
rbind(`1:1` = potrzeba(1), `2:1` = potrzeba(2), `3:1` = potrzeba(3))

# 5. Dane do rysunku: moc przy N = 120 i N = 200 zależnie od udziału mniejszej grupy
siatka <- expand.grid(N = c(120, 200), udzial = seq(.10, .50, by = .01))
siatka$n2 <- round(siatka$N * siatka$udzial); siatka$n1 <- siatka$N - siatka$n2
siatka$moc <- with(siatka, moc_t(n1, n2, d = 0.5))
round(siatka[siatka$udzial %in% c(.10, .20, .25, .30, .40, .50), c("N", "udzial", "n1", "n2", "moc")], 3)
Wynik w R
   n1 n2 proporcja n_efektywne   moc
1  60 60     1 : 1        60.0 0.775
2  70 50   1.4 : 1        58.3 0.764
3  80 40     2 : 1        53.3 0.726
4  90 30     3 : 1        45.0 0.653
5 100 20     5 : 1        33.3 0.526
6 108 12     9 : 1        21.6 0.371
[1] 0.775
grupy_90_30 grupy_30_30
      0.653       0.478
     n1 n2   N
1:1  64 64 128
2:1  96 48 144
3:1 129 43 172
     N udzial  n1  n2   moc
1  120   0.10 108  12 0.371
2  200   0.10 180  20 0.560
21 120   0.20  96  24 0.584
22 200   0.20 160  40 0.804
31 120   0.25  90  30 0.653
32 200   0.25 150  50 0.861
61 120   0.40  72  48 0.758
62 200   0.40 120  80 0.932
81 120   0.50  60  60 0.775
82 200   0.50 100 100 0.940
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pt(), qt() i power.t.test() z pakietu stats); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czy grupy w badaniu muszą być równoliczne?
Nie. Test t, ANOVA i regresja działają przy nierównych liczebnościach. Równy podział daje tylko największą moc przy danej łącznej liczbie osób. W przykładzie na tej stronie 120 osób podzielonych na 90 i 30 dało moc .65, a podzielonych po równo – .78.
Czy można losowo usunąć osoby z większej grupy, żeby wyrównać liczebności?
Nie warto. Tracisz dane i moc: z grup liczących 90 i 30 osób po zostawieniu 30 i 30 moc spada z .65 do .48. Zamiast tego przeanalizuj wszystkie osoby testem Welcha, który nie zakłada równych wariancji.
Jaki test post hoc wybrać przy nierównych grupach?
Test Gamesa–Howella. Nie łączy wariancji grup, więc dobrze kontroluje błąd I rodzaju przy nierównych liczebnościach lub wariancjach (Games i Howell, 1976). Test Tukeya zakłada równe wariancje.
Od jakiej różnicy liczebności grupy są „za bardzo” nierówne?
Nie ma jednej granicy. Przy podobnych wariancjach i kilkudziesięciu osobach w każdej grupie nawet podział 2 : 1 kosztuje niewiele mocy. Kłopot zaczyna się, gdy mniejsza grupa liczy kilkanaście osób albo wariancje wyraźnie się różnią. Przy ANOVA iloraz wariancji powyżej 1.5 w nierównych grupach to już sygnał ostrzegawczy (Blanca i in., 2018).
Powiązane hasła
Przeczytaj też
Test t Studenta krok po kroku
Jedna próba, próby niezależne i zależne na jednym przykładzie: założenia, test Welcha, d Cohena i d_z z 95% CI, wykres, zapis APA, R, SPSS i JASP.
Czytaj →PoradnikANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikKalkulator liczebności próby
Ile osób do testu t, korelacji albo ankiety z marginesem błędu? Kalkulator zgodny z R, wzory, przykład i gotowy opis analizy mocy.
Czytaj →Masz nierówne grupy i nie wiesz, który test wybrać?
Sprawdzimy wariancje i liczebności w Twoich danych, dobierzemy test i wyjaśnimy wyniki tak, żebyś umiał(a) uzasadnić wybór przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Blanca, M. J., Alarcón, R., Arnau, J., Bono, R., & Bendayan, R. (2018). Effect of variance ratio on ANOVA robustness: Might 1.5 be the limit? Behavior Research Methods, 50(3), 937–962. https://doi.org/10.3758/s13428-017-0918-2 ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Langsrud, Ø. (2003). ANOVA for unbalanced data: Use Type II instead of Type III sums of squares. Statistics and Computing, 13(2), 163–167. https://doi.org/10.1023/A:1023260610025
- Smith, C. E., & Cribbie, R. (2014). Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares. Journal of Data Science, 12(3), 385–404. https://doi.org/10.6339/JDS.201407_12(3).0001 ● Otwarty dostęp
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222
Cytowania BibTeX
@article{blanca2018effect, author={Blanca, María J. and Alarcón, Rafael and Arnau, Jaume and Bono, Roser and Bendayan, Rebecca}, title={{Effect of variance ratio on ANOVA robustness: Might 1.5 be the limit?}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={3}, pages={937--962}, doi={10.3758/s13428-017-0918-2}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{games1976pairwise, author={Games, Paul A. and Howell, John F.}, title={{Pairwise multiple comparison procedures with unequal N’s and/or variances: A Monte Carlo study}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={2}, pages={113--125}, doi={10.3102/10769986001002113}}@article{langsrud2003anova, author={Langsrud, Øyvind}, title={{ANOVA for unbalanced data: Use Type II instead of Type III sums of squares}}, journal={Statistics and Computing}, year={2003}, volume={13}, number={2}, pages={163--167}, doi={10.1023/a:1023260610025}}@article{smith2014factorial, author={Smith, Carrie E. and Cribbie, Robert}, title={{Factorial ANOVA with unbalanced data: A fresh look at the types of sums of squares}}, journal={Journal of Data Science}, year={2014}, volume={12}, number={3}, pages={385--404}, doi={10.6339/jds.201407_12(3).0001}}@article{zimmerman2004note, author={Zimmerman, Donald W.}, title={{A note on preliminary tests of equality of variances}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2004}, volume={57}, number={1}, pages={173--181}, doi={10.1348/000711004849222}}